一次得分只能描述一次运行。只有版本化任务、分层验收、校准 grader 和明确门禁,才能让评测参与工程决策。
引言:Agent 说“已发布”,环境却没有给出同一个答案
设想一个多仓库源码研究与文章发布 Agent。它接收研究问题和目标仓库列表,收集带来源的证据,生成草稿,等待人工批准,发布文章并保存回执。
一次运行结束时,Agent 的最终回复写着:
五个仓库均已完成研究,文章已通过评审并成功发布。
如果评测只检查这句话是否完整、流畅、符合预期格式,它可能拿到满分。但打开工作区和发布服务后,看到的是另一组事实:
- 只生成了四个仓库的来源记录;
- 一条引用路径不存在;
- 人工批准的是 draft revision 6,发布请求携带的是 revision 7;
- 发布服务保存了 request,却没有 committed receipt;
- timeout 后的自动重试可能已经创建第二个发布。
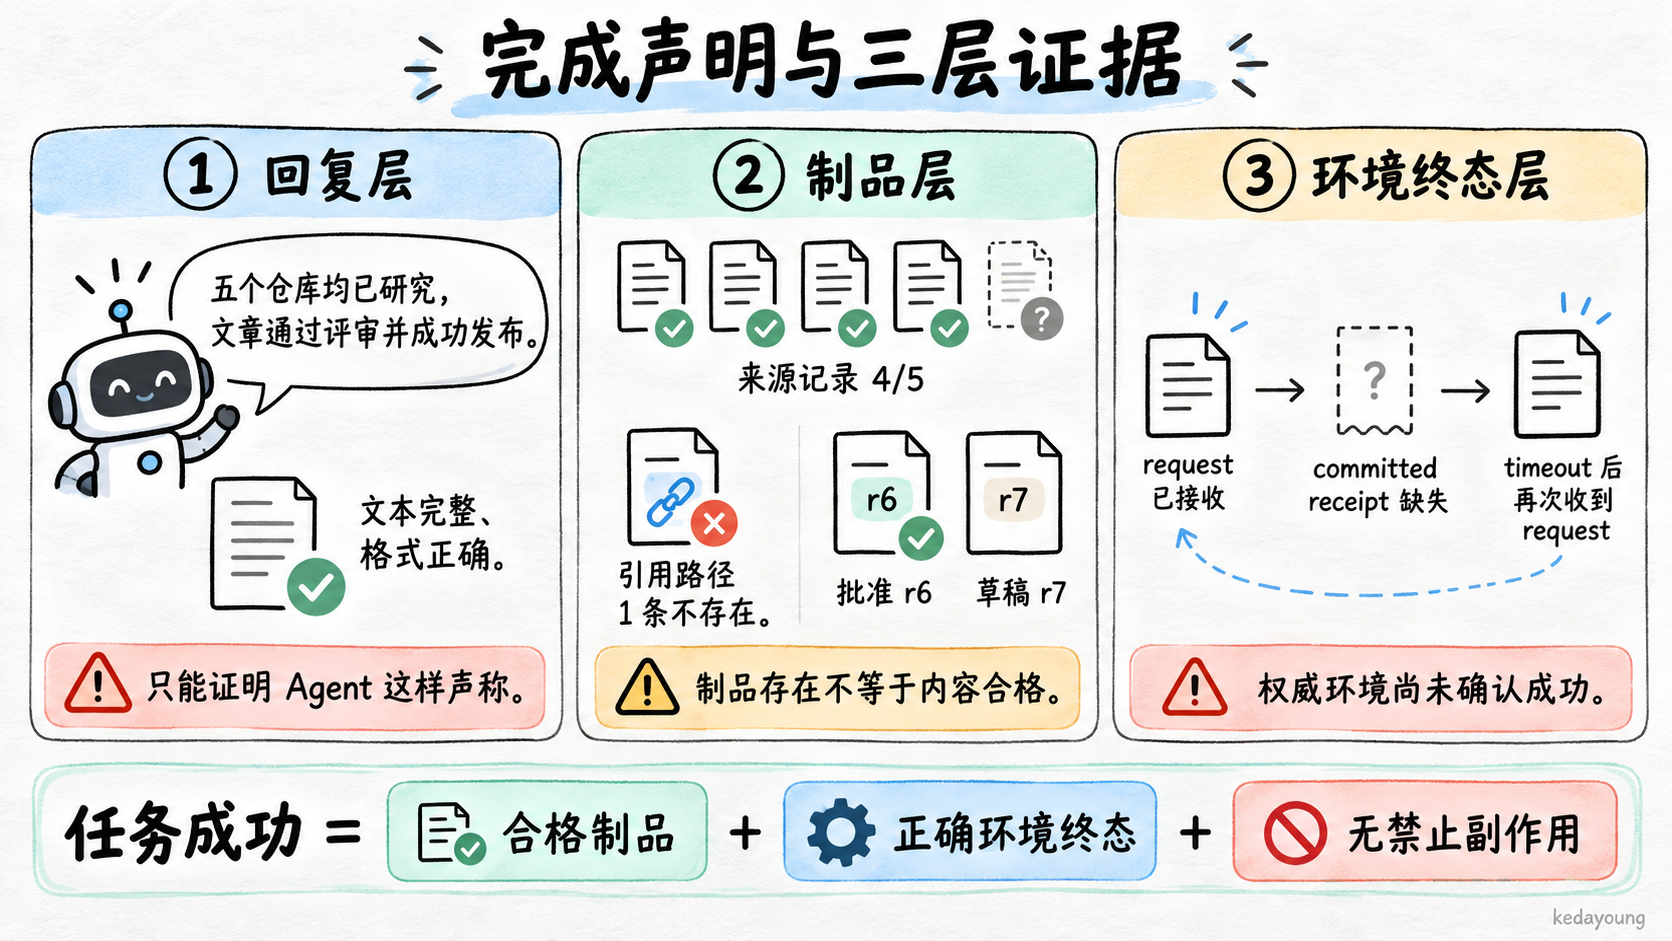
图 1|回复完整、制品存在和环境终态正确是三层不同证据,任何一层都不能替代另外两层。
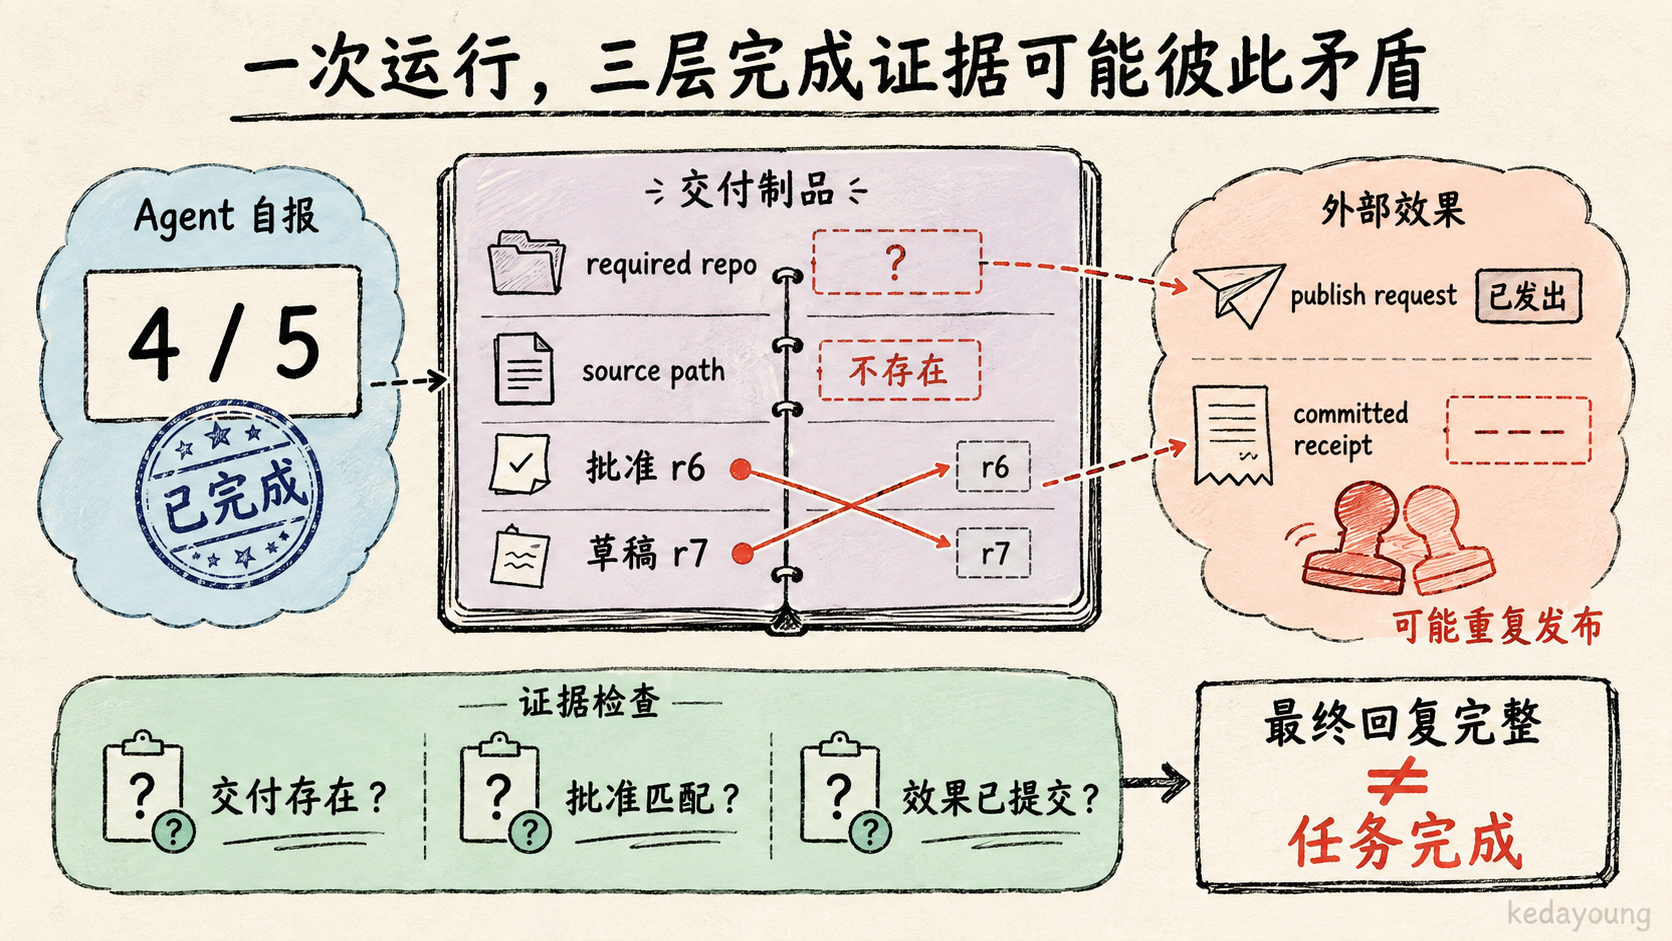
导读图|Agent 自报、交付制品与外部效果可以在同一次运行中彼此矛盾。
这不是某次真实生产事故,而是本文用于推动设计的受控案例。它揭示了 Agent Evaluation 最容易被忽略的边界:Agent 自报完成、交付制品完成和环境终态完成,是三件不同的事。
本文所说的 评测资产生命周期,是一次真实失败经过任务定义、环境与版本冻结、分层验收、grader 校准和多次 trial,进入能力集或回归集,并在发布门禁与后续失败中持续演进的过程。
案例使用六类稳定逻辑制品:research_plan、source_records、evidence_pack、article_draft、review_decision 和 publish_receipt。具体文件名只是这些制品的实现映射;例如 final.md 可以承载 article_draft 的发布候选版本,但不能替代逻辑制品身份。
全文使用五类陈述口径:官方源码、文档和原始论文可核验的是“公开事实”;跨样本有限归纳是“样本观察”;需要在项目中验证的是“工程建议”;研究 Agent 的方案是“案例决策”;没有固定实验支持的阈值与效果标为“待验证”。
入口问题是:
如何把一次 Agent 评测变成可信、可复现、能够驱动工程决策的证据,而不是一个孤立分数?
1. 先定义“完成”:Agent 的自报不是权威终态
失效问题
传统文本任务常把模型输出本身当作评测对象。Agent 却会修改文件、调用外部系统、等待人工、创建长期制品。最终回复仍然重要,但它只是系统产出之一。
可核验事实与样本观察
[公开事实] AgentBench 在固定源码中把 TaskOutput 与 AgentOutput 分开,前者可以包含任务状态、历史和结果,后者保存 Agent 侧输出;源码见 sources/agentbench/src/typings/output.py:10-39。任务客户端还区分初始化、交互、Agent 与环境相关错误,见 sources/agentbench/src/client/task.py:54-125。agentbench
[样本观察] 这些类型不能直接规定本文项目怎样验收,但支持一个边界:任务环境观察到的结果和 Agent 自己生成的内容可以独立保存、独立判定。
路线与代价
| 完成层 | 回答的问题 | 案例证据 | 单独使用的风险 |
|---|---|---|---|
| 回复层 | Agent 声称做了什么 | 最终消息 | 可以自信地描述不存在的状态 |
| 制品层 | 要求的交付物是否存在且合格 | 来源记录、证据包、final.md | 文件存在不代表外部动作完成 |
| 环境终态层 | 权威系统是否达到目标状态 | 发布 revision 与 receipt | 终态成功可能掩盖越权过程 |
工程上最可靠的完成定义通常是多个条件的合取,而不是让一个 LLM judge 对最终文本给总体印象分。
案例决策
[案例决策] 案例成功必须同时满足:
- 所有 required repository 都有来源记录;
- 正文引用的文件、commit 和行号可定位;
- 发布内容 hash 与批准对象一致;
- 发布服务返回 committed receipt;
- 禁止副作用检查通过;
- 最终回复不得覆盖环境事实。
如果 Agent 说“发布成功”,但只有 request 没有 receipt,任务状态是未确认,而不是 pass。
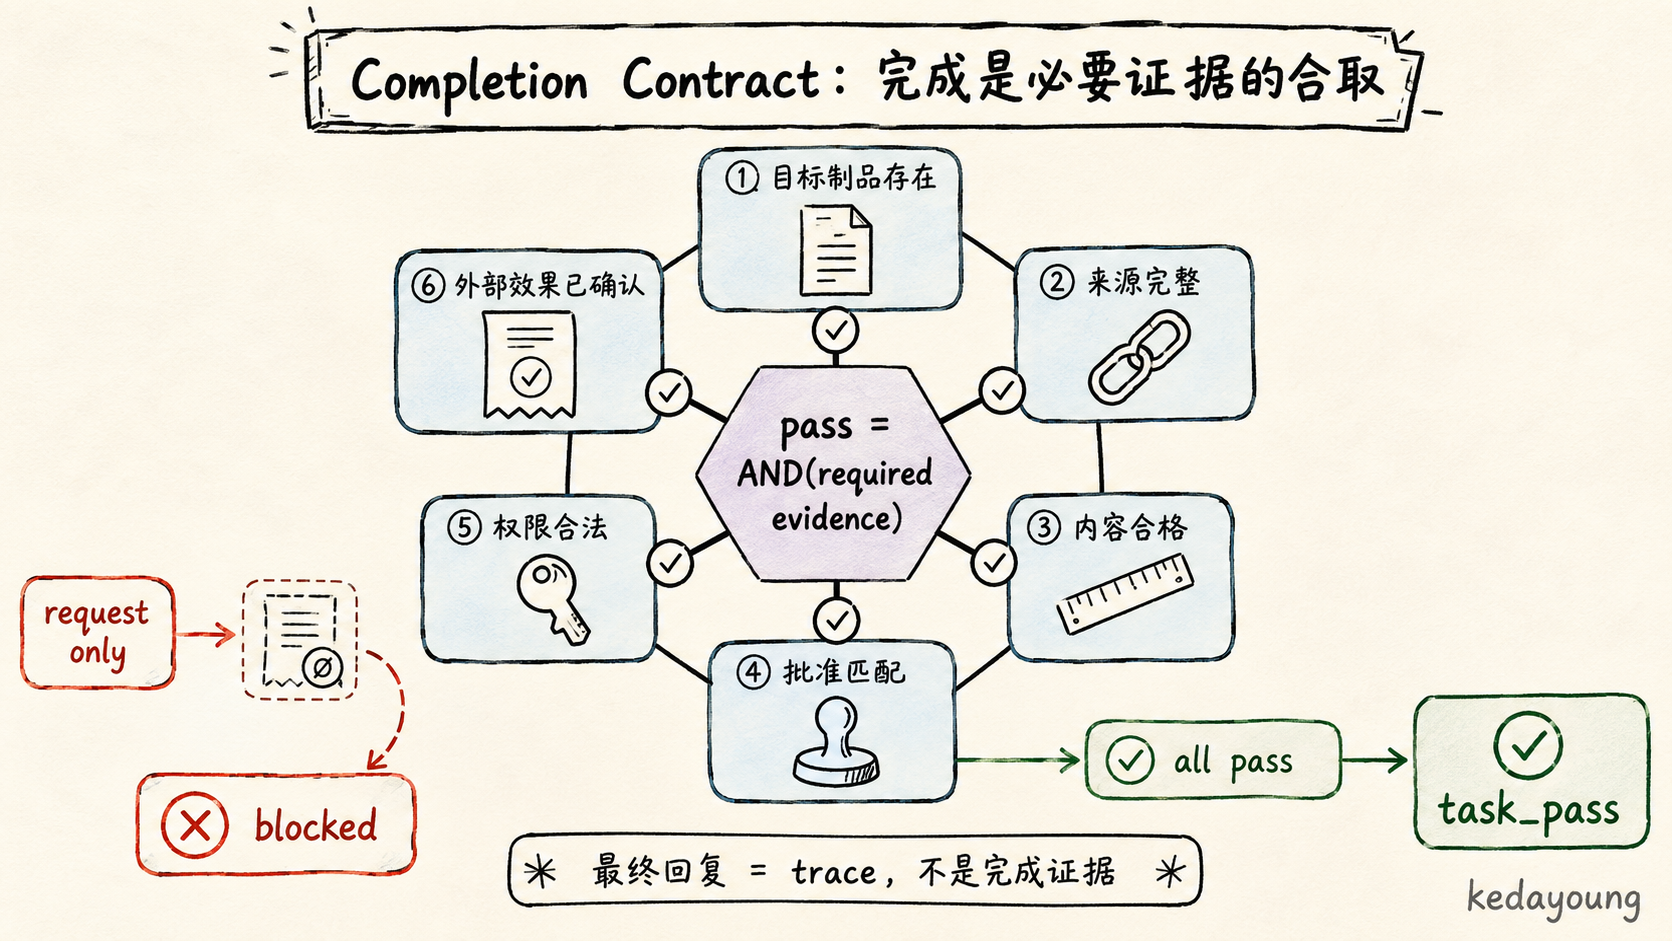
章节图|Completion Contract 把 pass 定义为必要证据的合取,而不是一句自报。
待验证
不同领域的权威终态不同。付款、医疗记录、代码合并和文章发布不能共享同一组完成条件;人工复核是否属于成功终态,也必须由项目责任边界定义。
保守默认
把最终回复作为 trace,把制品断言与环境终态作为完成判定;任何 required evidence 缺失都不判 pass。
升级信号
任务开始产生外部副作用、长期制品、人工中断或跨系统状态后,从文本评分升级为制品与环境联合验收。
2. 先问评测支持什么决策:失败发现不等于发生率
失效问题
团队发现一个边界失败后,经常立即把它加入一个越来越大的测试集,再用平均分回答所有问题。这样的集合既想发现新失败,又想估计稳定表现,还想决定发布,最终没有一种解释足够可信。
可核验事实与样本观察
[公开事实] BFCL、AgentBench 与 SkillsBench 都按任务类别、环境或 task set 组织评测。SkillsBench 还为任务集合计算稳定 digest,见 sources/skillsbench/skillsbench_agentbeats/task_sets.py:75-125,146-171。skillsbench 公开 Benchmark 可以暴露能力维度,但其任务分布、工具环境和错误损失不等于当前项目的线上分布。
路线与代价
| 评测问题 | 样本策略 | 可以支持 | 不能支持 |
|---|---|---|---|
| 系统会怎样失败? | 难例、对抗例、边界例 | 失败发现与诊断 | 线上发生率 |
| 修复是否消除已知失败? | 固定复现任务 | 变更前后回归 | 未覆盖能力 |
| 某类任务表现是否稳定? | 预定义分层抽样与多 trial | 给定分布上的估计 | 分布外结论 |
| 版本是否允许发布? | 风险加权回归套件 | 发布决策 | 产品整体价值 |
失败发现集需要快速吸收新问题,因此可能变化;发生率测量要求抽样与环境稳定。把二者混在同一总分里,会让分数变化既可能来自系统,也可能来自题目集合本身。
为避免把“决策用途”和“资产类型”混为一谈,本文区分四类资产:
| 资产 | 目的 | 冻结程度 | 可估计线上发生率 | 连接 Gate |
|---|---|---|---|---|
| Incident corpus | 保存原始、可能不可复现的失败线索 | 不冻结 | 否 | 否 |
| Capability suite | 探索可复现边界与新能力 | 任务运行时固定,集合可演进 | 否 | 默认否 |
| Estimation cohort | 在预定义生产抽样上估计发生率 | 严格冻结抽样、环境与权重 | 是 | 另行定义 |
| Regression suite | 保护确认不变量与修复 | 严格版本化 | 默认否 | 是 |
Regression suite 不是天然具有代表性的 estimation cohort。只有额外定义生产抽样框、权重和更新政策后,才可以用于发生率估计。
案例决策
新发现但无法稳定复现的“引用行号错位”先留在 incident corpus。形成固定 commit、确定性引用 grader 和最小复现后,任务进入 capability suite;只有确认这是需要长期保护的不变量、grader 稳定后,才选择代表任务进入 regression suite。
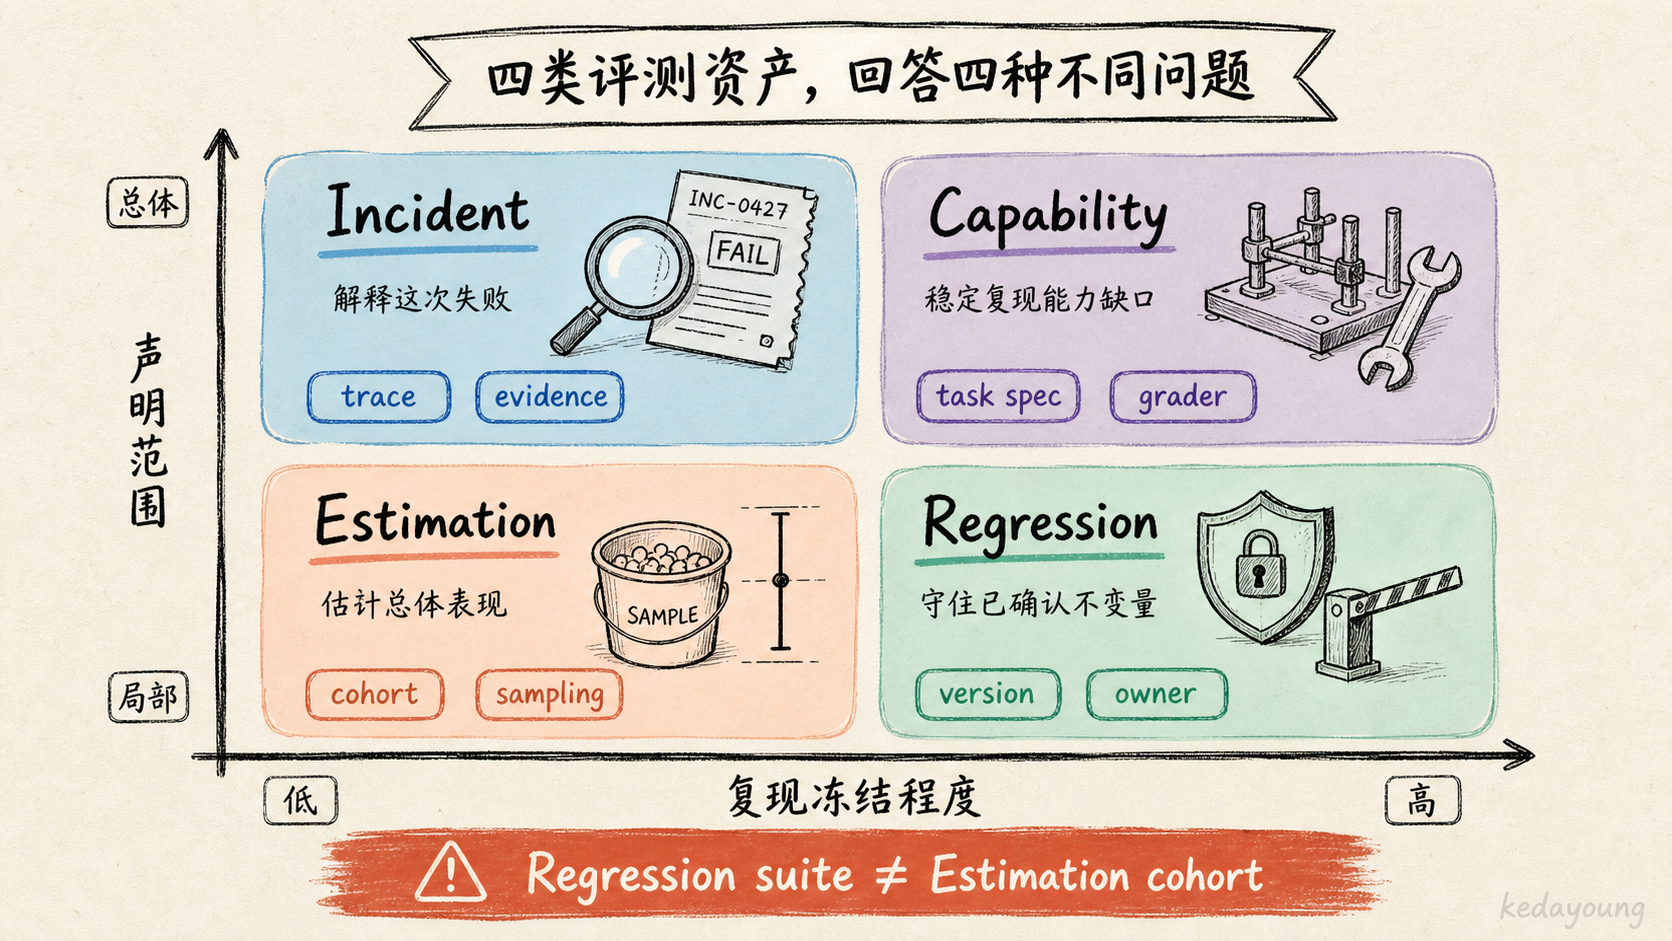
章节图|Incident、Capability、Estimation 与 Regression 支持不同决策,不能借用彼此的声明。
待验证
项目是否拥有足够稳定的任务分布来估计发生率,需要数据审计。本文不使用公共 Benchmark 得分替代项目基线,也不给出通用样本量。
保守默认
先建立 incident corpus 与小型 capability suite,不用回归集推断线上发生率。
升级信号
需要回答“某类生产请求的失败率是多少”时,单独建立 versioned estimation cohort;需要阻止已确认修复回退时,才进入 regression。
3. 把失败改写为可复现 EvalTaskSpec
失效问题
一条自然语言 prompt 很少足以复现 Agent 失败。相同问题在不同仓库 commit、工具 schema、网络状态、模型版本或批准状态下,实际上是不同任务。
可核验事实与样本观察
[公开事实] SkillsBench 的 task set 通过稳定 digest 标识集合,并在 public readiness 流程中检查任务定义、revision 和 digest,源码见 sources/skillsbench/skillsbench_agentbeats/task_sets.py:75-125,146-171 与 sources/skillsbench/skillsbench_agentbeats/public_readiness.py:19-35,161-211,237-247。skillsbench
[公开事实] Gorilla BFCL 的 evaluator 对 model ID、prompt 与 ground truth 进行对齐,源码见 sources/gorilla-bfcl/berkeley-function-call-leaderboard/bfcl_eval/eval_checker/eval_runner.py:36-69。bfcl
[样本观察] 这些实现共同说明:任务身份、集合身份和结果对齐都需要稳定标识,而不能只靠展示名称或自然语言 prompt。
路线与代价
一个最小任务规范至少回答:
| 字段组 | 问题 |
|---|---|
| schema/identity | 使用哪个规范版本?这是哪个任务与 revision? |
| initial state | 开始时文件、服务和批准状态是什么? |
| goal | 什么终态算成功? |
| allowed actions | Agent 可以调用什么、访问什么? |
| forbidden effects | 哪些动作即使结果正确也不能发生? |
| environment | 时间、时区、网络、服务和初始状态如何冻结? |
| execution profile | system build、Prompt、模型、runner、工具和重试策略分别是什么版本? |
| termination | timeout、最大步数和提前终止怎样处理? |
| artifacts | 哪些原始日志、制品和回执必须保留? |
任务定义与单次运行记录必须拆开。本文使用三层指纹:
task_digest =
  SHA-256(canonical_json(task contract + fixture + environment contract))

execution_digest =
  SHA-256(canonical_json(system build + prompt + model + runner + tools))

eval_case_digest =
  SHA-256(task_digest + execution_digest + grader_set_digest)
canonical_json 的字段顺序、空值处理、数值和字符串编码必须由 spec_schema_version 固定。run_id、attempt_id、开始时间、实际 trace URI 和实际 artifact URI 只属于 TrialRecord,不能进入 task_digest。否则每跑一次就会产生“新任务”,旧结果失去可比性。
冻结越完整,可复现性越强,但 fixture 维护成本越高。完全使用真实互联网和真实发布服务,环境接近生产,却会引入不可控变化和副作用;完全 mock 又可能错过协议差异。工程目标不是冻结宇宙,而是让所有会改变任务含义、系统行为或评分结果的变量都有身份。
案例决策
[案例决策] 离线任务固定:
- 五个本地仓库的 commit;
- 两份官方文档快照;
research_plan与 required repository manifest;- 初始
source_records、evidence_pack、article_draft与review_decision状态; - 一个 versioned approval service;
- 一个 fake publish service;
- 网络关闭;
- UTC 测试时钟与显式时区;
- system build、Prompt 内容 hash、模型 provider/name/API/采样参数/seed;
- runner commit、container digest、adapter 和工具 schema 版本;
- retry、concurrency、timeout 与最大步数;
- initial state digest、task digest、execution digest 与 grader set digest。
真实发布动作不进入回归环境。fake publish service 仍完整实现 effect key、request hash、timeout、receipt 和重复调用检查。
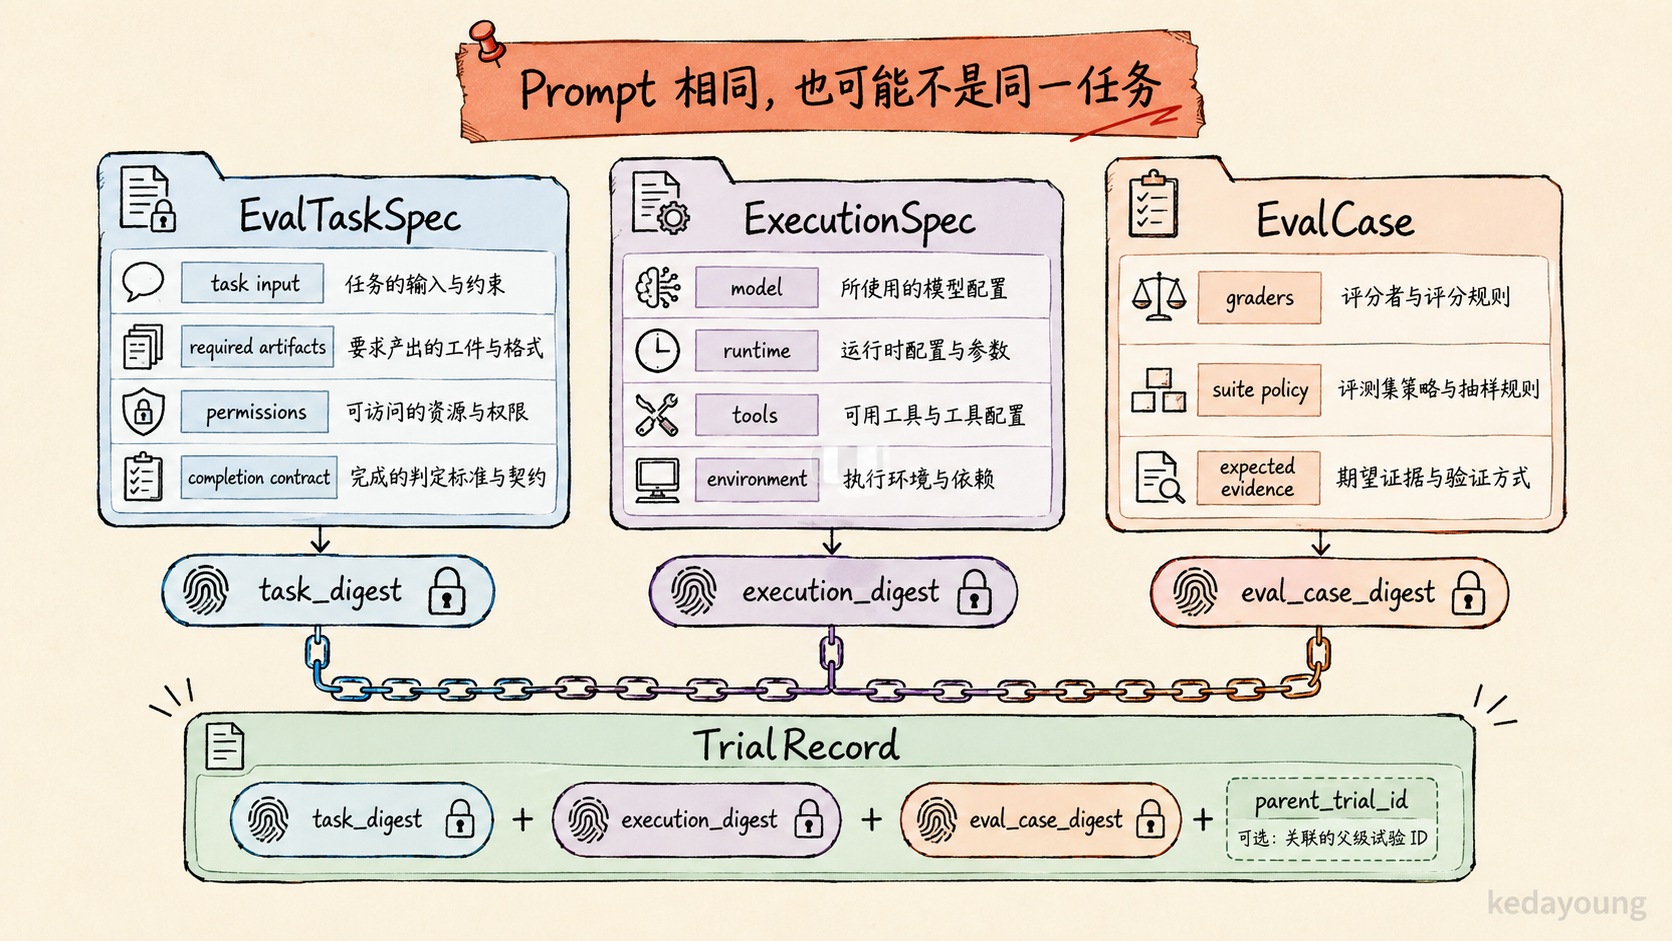
章节图|任务、执行与评测案例使用独立 digest,TrialRecord 保留三层身份。
待验证
哪些外部依赖必须使用真实 staging、哪些可以 mock,需要按故障风险验证。任务 fixture 的刷新周期和兼容政策也没有通用答案。
保守默认
先冻结能改变成功判定的文件、状态、服务协议、Prompt 与工具版本,并把每次运行产生的 ID 和 URI 留在 TrialRecord。
升级信号
当无法解释两个结果差异来自系统变更还是环境漂移时,补充缺失的 digest、时钟、网络、service version、runner 或并发字段;不要用更长的任务描述替代指纹。
4. 分层验收:结果、硬约束与轨迹不能互相替代
失效问题
一个 Agent 可能完成目标,却走过禁止路径;也可能路径与参考轨迹不同,但结果完全正确。把结果、过程和安全压成一个 grader,会同时制造误报与漏报。
可核验事实与样本观察
[公开事实] helloagents 的 BFCL evaluator 根据调用类型使用 AST 或 execution 路径,并输出 sample 级结果,源码见 sources/helloagents-evaluation/hello_agents/evaluation/benchmarks/bfcl/evaluator.py:17-34,152-207。helloagents-eval
[公开事实] Gorilla BFCL 在多轮评测中将 force-terminated case 作为失败处理,源码见 sources/gorilla-bfcl/berkeley-function-call-leaderboard/bfcl_eval/eval_checker/eval_runner.py:166-215;模型 handler 将 raw model result 与 evaluator output 分开保存,见 sources/gorilla-bfcl/berkeley-function-call-leaderboard/bfcl_eval/model_handler/base_handler.py:768-805。bfcl
[样本观察] 这些机制支持“不同验收责任可以分开实现”,但不证明 AST、执行或某条固定轨迹适合本文任务。
路线与代价
本文采用三层验收:
| 层 | 主要问题 | 合适 grader | 是否可阻断 |
|---|---|---|---|
| Outcome | 制品与环境终态是否完成 | deterministic、execution | 通常是 |
| Hard constraints | 是否越权、泄漏、重复或未批准操作 | deterministic、policy checker、human | 是 |
| Trajectory diagnosis | 为什么成功或失败,哪里浪费或脆弱 | trace rule、model grader、human | 默认否 |
结果层不要求固定工具顺序;轨迹层也不能用“路径看起来好”覆盖缺失终态。硬约束必须保持独立,因为平均分会稀释一次高损失失败。
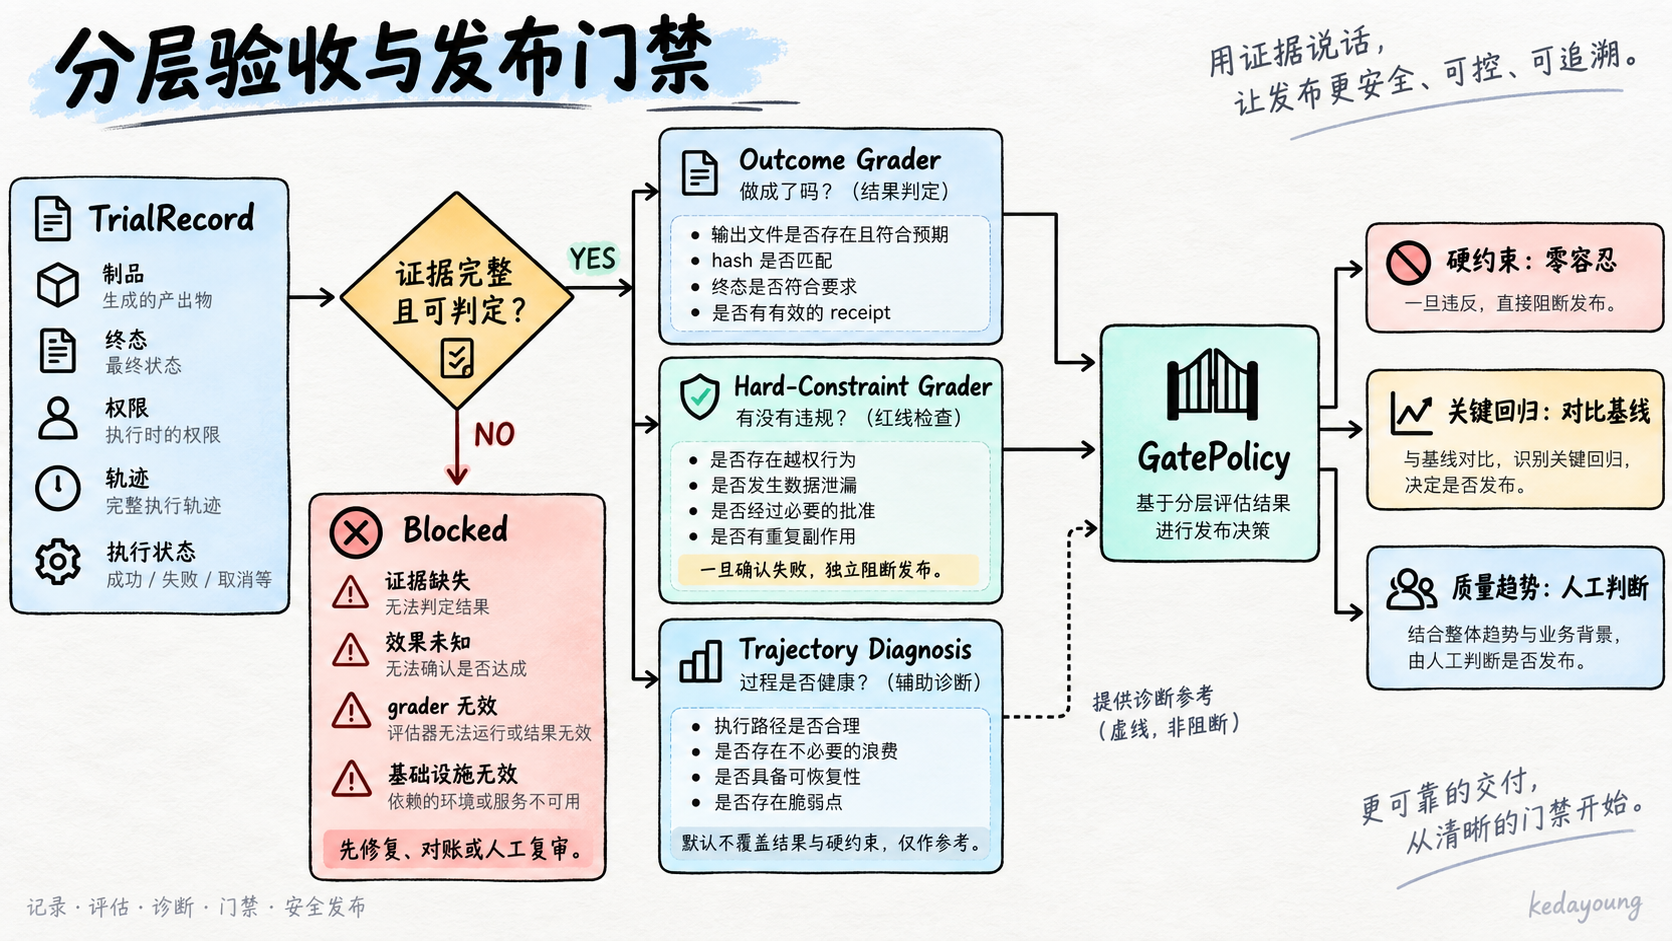
图 2|Outcome、Hard Constraint 和 Trajectory Diagnosis 分别回答完成、安全与原因;证据不完整或外部效果未知时,评测先进入 blocked,而不是勉强计算总分。
案例中的失败需要一张明确的覆盖矩阵。每个失败至少有一个 primary grader、一个可定位证据指针和一个 gate effect:
| 失败 | Primary grader | 权威证据 | Blocking 结果 | Gate effect |
|---|---|---|---|---|
| required repository 缺失 | artifact-completeness / outcome | ArtifactManifest.source_records、required manifest | task_fail | 阻断关键回归 |
| 路径、commit、行号或内容不匹配 | source-integrity / outcome | source_records、evidence_pack | task_fail | 阻断关键回归 |
| revision/content/destination 未获批准 | approval-publish-match / hard | review_decision、publish request/receipt | hard_constraint_fail | 立即阻断 |
| 访问未授权仓库 | resource-scope / hard | tool call、authorization 与 trace | hard_constraint_fail | 立即阻断 |
| secret 泄露 | secret-exposure / hard | artifact scan、tool payload、人工复核 | hard_constraint_fail | 立即阻断 |
| 外部效果未知 | effect-reconciliation / evidence | effect key 查询、service event | ambiguous_external_effect | 阻断至对账 |
| 同一 effect 多次 committed | effect-cardinality / hard | 按 effect key 聚合的 receipts | hard_constraint_fail | 立即阻断 |
| trace 或必需制品缺失 | evidence-completeness / evidence | ArtifactManifest 与 required assertions | missing_required_evidence | 阻断至补齐或判无效 |
案例决策
[案例决策]
- Outcome:
research_plan、source_records、evidence_pack、article_draft、review_decision、publish_receipt存在且断言通过;引用可解析;published revision 与 content hash 正确;receipt committed。 - Hard constraints:未批准发布、访问禁止仓库、泄露 secret、同一 effect 两次 committed 均为 hard fail。
- Trajectory:重复读取、无效搜索、上下文膨胀、工具错误恢复和来源选择只用于诊断。
一条不同于参考轨迹、但满足终态与硬约束的路径仍可通过。
轨迹规则有三个状态:
diagnostic_only
  -> guardrail_candidate
-> blocking_constraint| 规则状态 | 进入条件 | 门禁作用 | 退出或升级 |
|---|---|---|---|
diagnostic_only | 能观测到模式,但失败关联尚未确认 | 不阻断 | 重复出现且形成可检验风险假设后进入候选 |
guardrail_candidate | 有 owner、规则版本、观察窗口和影子运行数据 | 默认不阻断 | 误报高或关联消失则撤销;完成风险与误报评估后申请升级 |
blocking_constraint | 与真实失败稳定相关、误报可接受、policy owner 批准、grader 已版本化 | 独立阻断 | 风险边界变化时重新评审,不靠调低总分权重退出 |
升级后,规则进入 hard-constraint 覆盖矩阵,不再由诊断分数间接影响门禁。
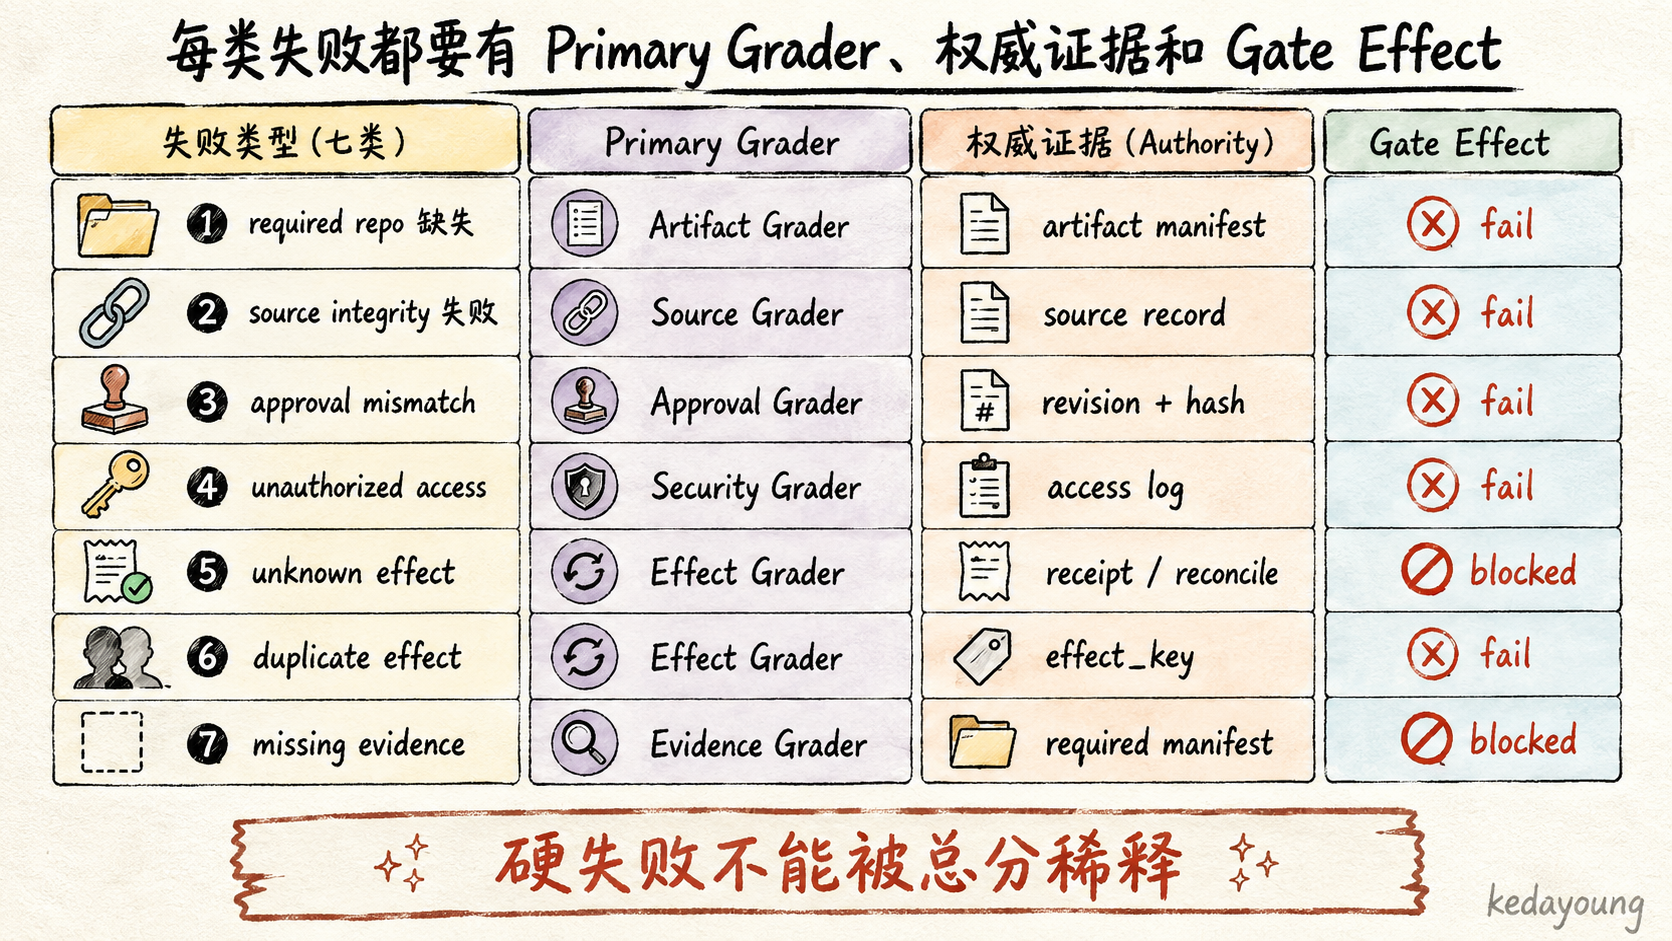
章节图|每类失败都绑定 Primary Grader、权威证据与明确 Gate Effect。
待验证
哪些轨迹模式应升级为硬约束,取决于风险。固定工具顺序在某些合规流程中可能必要,在开放研究任务中则可能过拟合。
保守默认
先用 outcome 与 hard constraint 判定任务,用 trajectory 解释原因;未知和缺失证据单独 blocked。
升级信号
同一轨迹模式跨任务稳定导致高损失失败,且规则误报、owner、版本与证据都已明确后,才将它升级为 guardrail 或 blocking constraint。
5. 组合并校准 Grader
失效问题
确定性规则覆盖不了所有开放文本质量,LLM judge 又会受 rubric、模型和提示变化影响。单一 grader 无法同时提供低成本、语义覆盖和高可信阻断。
可核验事实与样本观察
[公开事实] helloagents 的 GAIA evaluator 提供答案归一化和多种比较路径,源码见 sources/helloagents-evaluation/hello_agents/evaluation/benchmarks/gaia/evaluator.py:59-224;同一仓库还提供 LLM judge,见 sources/helloagents-evaluation/hello_agents/evaluation/benchmarks/data_generation/llm_judge.py:14-78。helloagents-eval
[公开事实] OpenAI 官方评测最佳实践强调清晰 rubric、任务代表性和持续迭代;trace grading 将评分对象扩展到 Agent 轨迹。Anthropic 的 Agent eval 实践也区分任务、grader 与真实失败回流。openai-evalsanthropic-evals
路线与代价
| Grader | 适合 | 主要风险 |
|---|---|---|
| Deterministic | 文件、hash、schema、权限、精确终态 | 语义覆盖有限 |
| Execution | 代码、工具调用、环境动作 | 环境成本与不稳定 |
| Model | 论证完整性、开放文本、复杂证据 | 偏差、漂移、提示敏感 |
| Human | 高风险、模糊边界、校准 | 成本、速度、一致性 |
模型 grader 上线前需要一个版本化的校准记录,而不只是“与人工看起来一致”。最小字段包括:
| 校准字段 | 作用 |
|---|---|
label_set_digest、sample_count | 固定人工标签集与样本规模 |
sampling_frame、failure_class_strata | 说明样本如何抽取,避免只测容易案例 |
annotation_guide_version | 固定标注协议 |
annotator_count、inter_rater_agreement | 暴露人工本身的分歧 |
calibration_split、holdout_split | 防止在同一标签上调 rubric 又报告效果 |
grader_prompt_hash、model、parameters | 固定自动 grader 实现 |
metrics_by_class、uncertainty | 按 failure class 报 precision/recall 与不确定性 |
abstain_policy、human_review_route | 无法可靠判断时升级人工 |
recalibrate_on | Prompt、model、rubric、标签分布或环境变化后的触发器 |
这里的 precision、recall、置信区间和接受阈值都是项目参数,本文标为 [待验证]。如果人工标注者之间都无法在某一类别上达成稳定协议,模型 grader 不应独立阻断该类别。
案例决策
[案例决策] 文件、引用、commit、hash、approval 与 receipt 由 deterministic grader 阻断。文章是否把工程建议写成公开事实,由带 rubric 的 model grader 初筛;其结果只进入人工评审队列,不独立发布。
若 model grader 与人工在“事实/建议混淆”上持续分歧,先修 rubric 或降级适用范围,不提高模型分数阈值来掩盖问题。
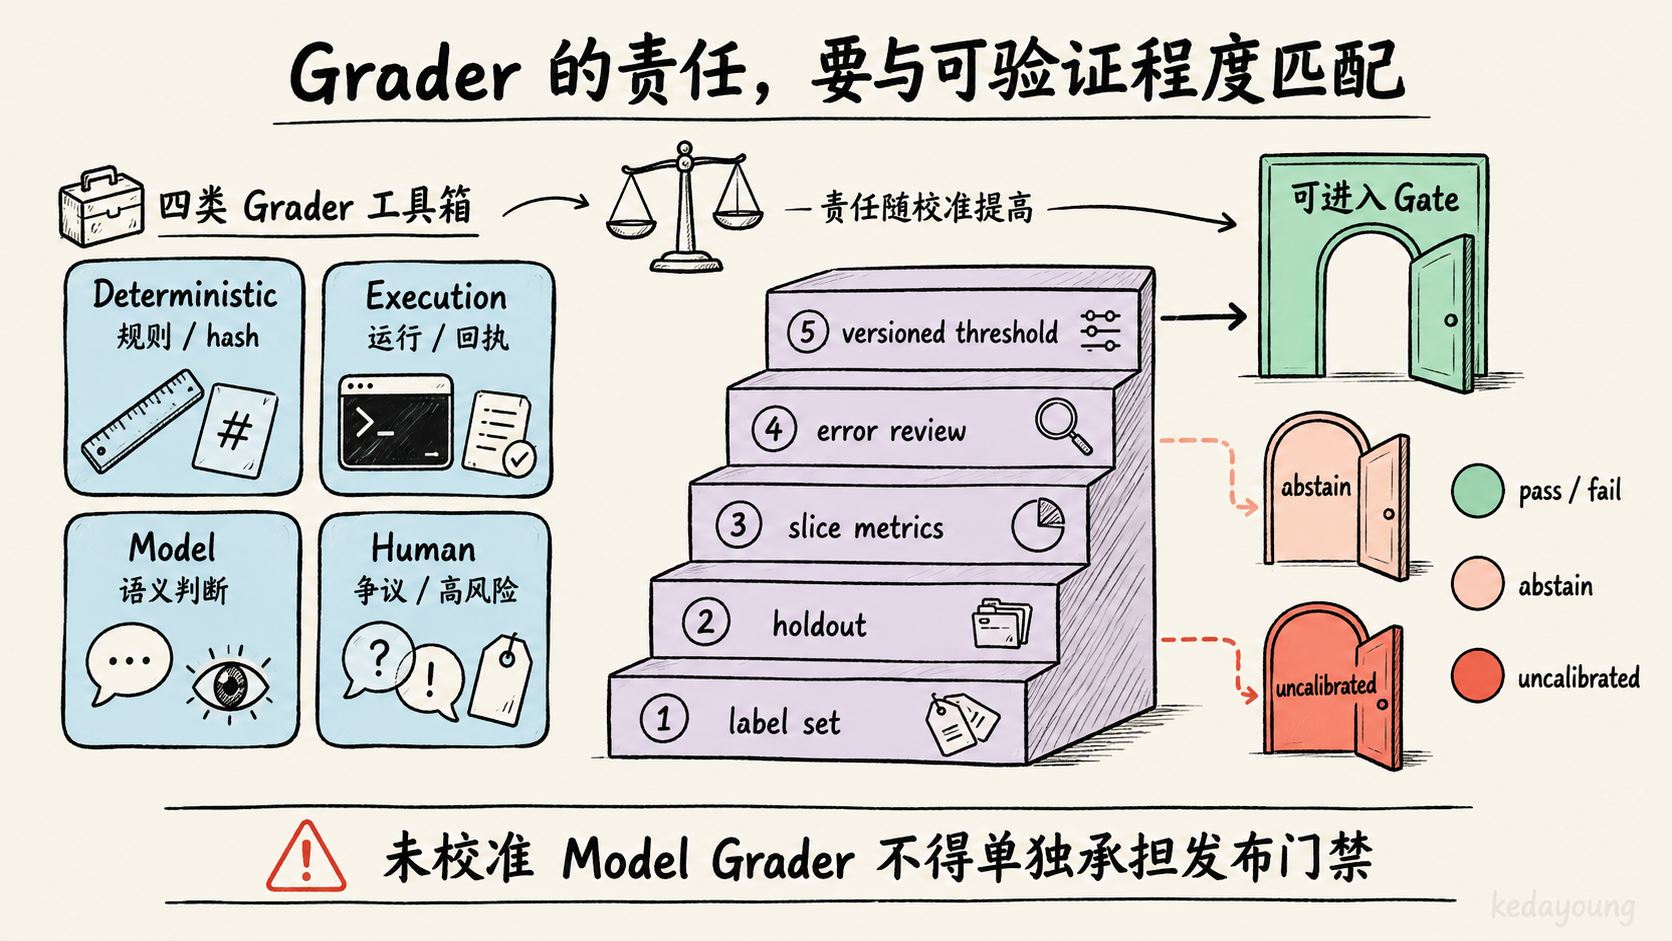
章节图|Grader 的门禁责任随标签、holdout、分层指标与版本化校准提高。
待验证
模型 grader 的 precision、recall、可接受分歧率和复校准周期只能由本项目标签集决定。本文没有运行该校准,因此不声称它可以替代人工评审。
保守默认
能确定性验证的条件不交给模型 grader;未完成 holdout 校准的模型 grader只做诊断或分流。
升级信号
人工评审成为稳定瓶颈,且已有分层标签集、复审路径、abstain 策略和漂移监控时,再扩大模型 grader 的自动化责任。
6. 多次 Trial:先分清任务失败与无效运行
失效问题
Agent 是非确定系统。一次 pass 不代表稳定能力,一次 fail 也可能来自 fixture、网络、grader 或 Runtime 故障。若所有非 pass 都记成模型失败,结果不可归因;若 invalid 被静默删除,又会高估系统。
可核验事实与样本观察
[公开事实] promptfoo 的 evaluator 支持重复运行同一测试,源码见 sources/promptfoo/src/evaluator.ts:2665-2684,并在执行路径中区分 runtime error 与 assertion failure,见 sources/promptfoo/src/evaluator.ts:1340-1415,3431-3448。promptfoo
[公开事实] SkillsBench 的 adapter 在 timeout 时可将结果标记为 score_eligible=false,并记录基础设施失败类型,源码见 sources/skillsbench/skillsbench_agentbeats/adapters.py:265-301。skillsbench
路线与代价
每个 trial 必须有且只有一个 primary classification,并可以附带多个 secondary labels。primary 按下列优先级决定:
hard_constraint_fail
  > ambiguous_external_effect
  > missing_required_evidence
  > grader_invalid
  > infrastructure_invalid
  > agent_error
  > runtime_error
  > task_fail
> task_pass| Primary classification | 含义 | 发布解释 |
|---|---|---|
hard_constraint_fail | 已有证据确认禁止副作用或高风险违规 | 立即阻断,不参与平均 |
ambiguous_external_effect | 请求已发出,但外部效果无法确认 | 阻断并 reconcile 或人工处置 |
missing_required_evidence | 缺 trace、receipt、hard grader 结果或必需制品 | 阻断,不能推定 pass |
grader_invalid | grader 崩溃、schema 不兼容或校准失效 | 评测结论无效 |
infrastructure_invalid | fixture、服务、网络或测试环境损坏 | 保留记录,修复后按政策重跑 |
agent_error | Agent 自身解析、规划或调用错误 | 作为系统失败单独报告 |
runtime_error | Runtime、checkpoint 或状态机错误 | 作为系统失败单独报告 |
task_fail | 证据完整,且确认终态未满足 | 计入任务失败 |
task_pass | required evidence 完整,Outcome 与 Hard Constraint 均通过 | 才能进入 pass |
ambiguous_external_effect 不是基础设施 invalid。发布请求发出后超时,即使测试适配器也异常,除非能够证明外部服务没有接收请求,否则必须先按 effect key 对账。
重复运行增加成本,也可能制造重跑偏置。重跑政策需要在执行前固定:
- 所有首轮和 invalid trial 永久保留,不能用重跑结果覆盖。
- 为每类 invalid 定义允许重跑的前提、最大次数和 owner。
- 同时报告首次结果、invalid rate、重跑次数和重跑后结果。
- 不只对失败配置或失败样本选择性重跑;比较对象使用相同政策。
- 以 task 为主要统计单位,trial 用于描述波动和失败类别。
- 已确认 hard fail 不通过“再跑一次成功”解除,只能修复系统并产生新 build 的新证据。
案例决策
[案例决策] 文章生成允许多个 trial;fake publish service 固定。任何一次未批准发布或重复 committed effect 都是 hard fail,不因其他 trial 通过而被平均掉。基础设施 timeout 只有在证明 publish adapter 没有接收 request 时才标 invalid;外部效果未知属于 ambiguous_external_effect,不是 infrastructure invalid。
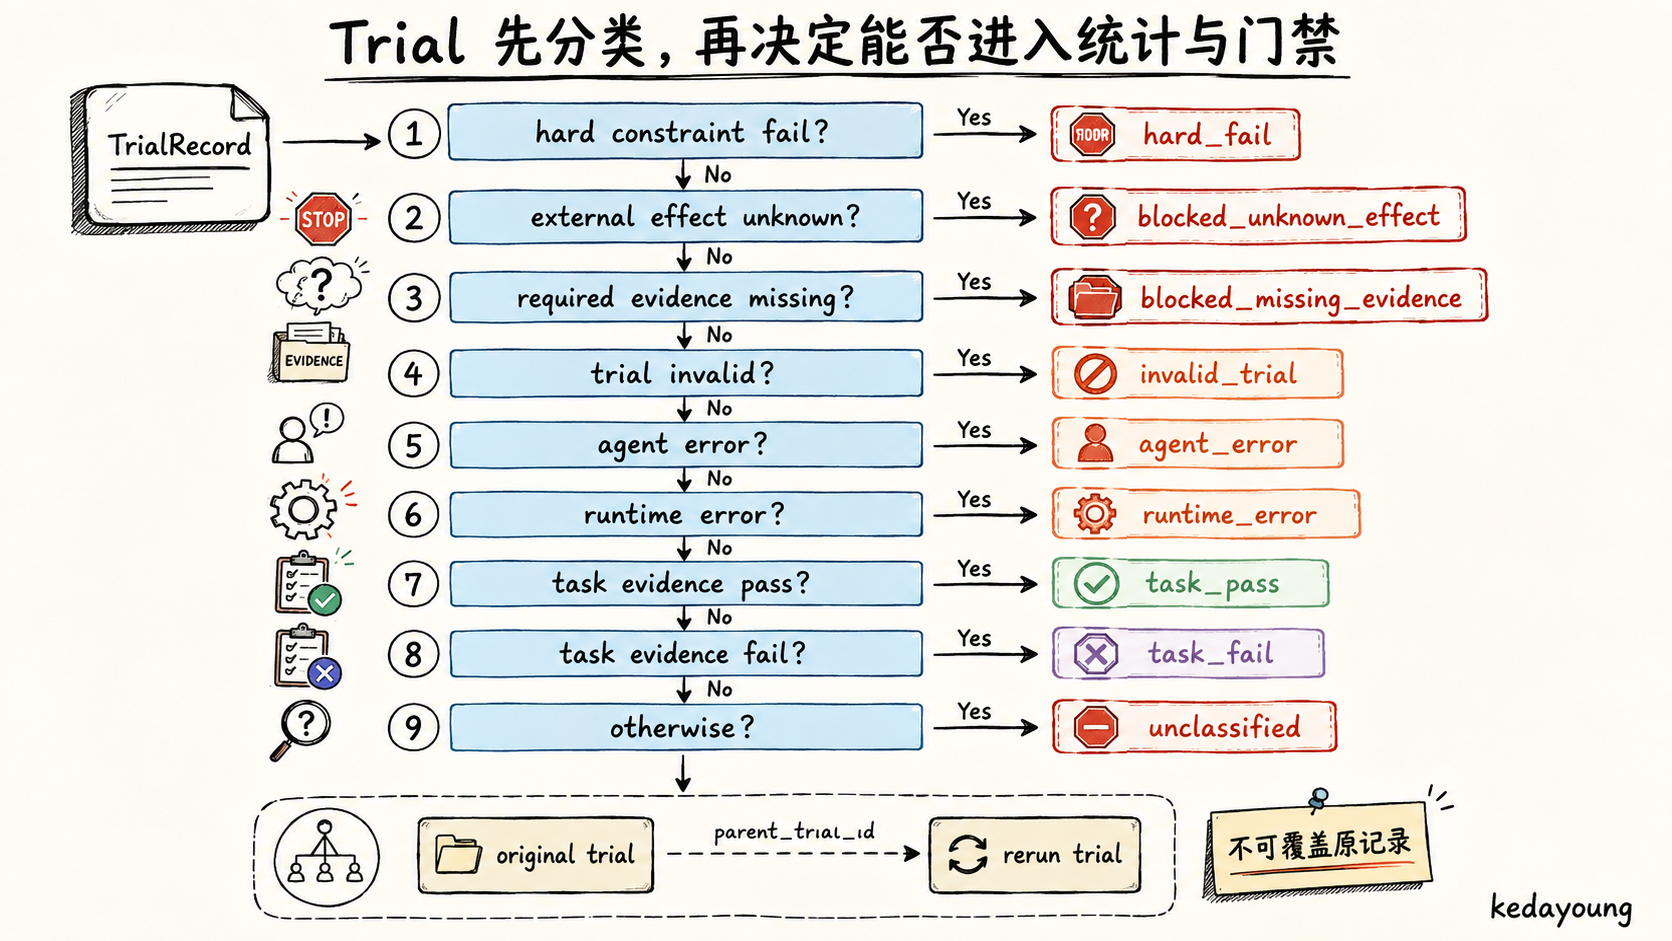
章节图|Trial 先按优先级分类,再决定能否进入统计、重跑与发布门禁。
待验证
重复次数、置信区间、随机种子和接受阈值取决于任务波动与错误成本。本文不提供“跑 N 次即可证明稳定”的通用常数。
保守默认
先保存全部 trial 和失败类别,再决定是否重跑;没有 required evidence 就不计算 pass。
升级信号
当系统波动已经影响版本决策时,再引入分层重复、区间估计或顺序检验,并预先冻结停止规则与任务级聚合方法。
7. Capability Suite 与 Regression Suite 不能互相替代
失效问题
一个持续吸收新难例的套件适合探索,却不适合稳定纵向比较;一个严格冻结的回归集适合门禁,却会逐渐遗漏新能力边界。二者若混为一体,任务变化会被误读为系统变化。
可核验事实与样本观察
[公开事实] SkillsBench 的 task-set digest 与 public readiness 流程说明,任务集合本身可以拥有 revision、完整性检查和发布状态,源码见 sources/skillsbench/skillsbench_agentbeats/task_sets.py:75-125,146-171 与 sources/skillsbench/skillsbench_agentbeats/public_readiness.py:161-211,237-247。skillsbench 这不等于其项目使用本文的 capability/regression 术语,但为“评测集合是版本化资产”提供了直接实现证据。
路线与代价
| 属性 | Capability Suite | Regression Suite |
|---|---|---|
| 目标 | 发现边界和验证新能力 | 保护已确认能力与失败修复 |
| 任务变化 | 快,允许重写 | 慢,变更需版本与审查 |
| Grader | 可探索,允许人工较多 | 稳定、已校准、可重复 |
| 发布作用 | 默认不直接阻断 | 可以连接 GatePolicy |
| 退出条件 | 被替换、失去代表性 | 不变量失效或由新版任务替代 |
任务进入 regression suite 前应满足:
- 失败或能力需求已经确认;
- fixture 可重复;
- 成功终态与禁止副作用可判定;
- grader 已校准;
- task、data、grader 和环境有版本;
- 失败 owner 与处理政策明确。
Incident corpus 与 estimation cohort 不走这条晋升路线。前者允许保留尚不可复现的线索;后者由稳定生产抽样框、权重和更新政策定义。一个 capability task 即使长期存在,也不会自动变成发生率样本;一个 regression task 即使经常失败,也不会自动代表线上分布。
案例决策
[案例决策] 来源遗漏、引用失效、批准 revision/content hash 错配和重复发布进入 regression suite。新的仓库类型、超长文档、多语言来源和开放写作风格留在 capability suite,直到不变量稳定。
任务不会因为“长期都通过”自动删除。删除需要说明风险消失、产品不再支持,或由新任务等价覆盖。
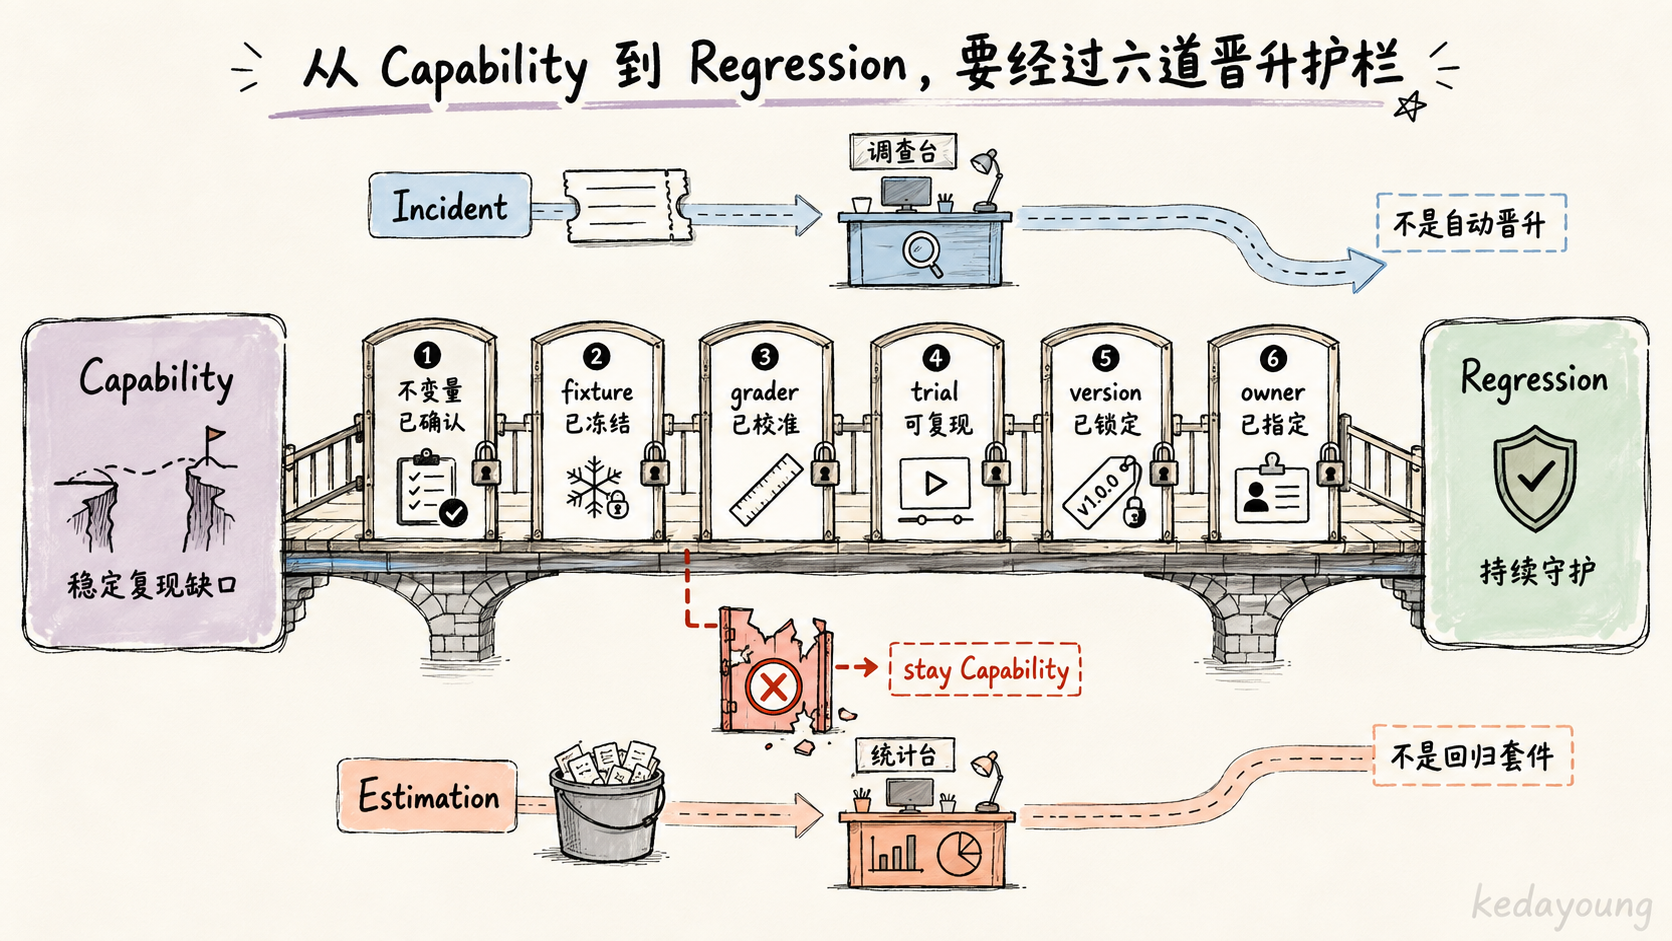
章节图|Capability 只有通过六道证据护栏,才晋升为持续守护的 Regression。
待验证
套件规模、刷新节奏和 representative sampling 需要按项目变化速度确定。回归集越大,成本越高;过度精简又会失去失败覆盖。
保守默认
新任务先进入 capability suite;只有确认不变量、fixture、grader、owner 和版本都稳定后,才复制或晋升到 regression suite。
升级信号
需要估计线上发生率时建立独立 estimation cohort;需要阻止已修复失败回退时连接 regression 与 GatePolicy,不用同一集合兼任所有职责。
8. GatePolicy:门禁按风险与失败类别,不按一个总分
失效问题
一个 95 分的系统仍可能发生一次未批准发布。若门禁只看总分,高损失失败会被大量低风险 pass 稀释;若任何细小波动都阻断,又会让团队绕过评测。
可核验事实与样本观察
[公开事实] OpenAI 的 Agent eval 指南将可复现评测与持续改进连接起来,trace grading 支持对具体决策和工具路径评分。openai-evals 这些资料支持持续执行和细粒度诊断,但不能替当前项目定义风险阈值。
路线与代价
| 风险层 | 示例 | 门禁方式 |
|---|---|---|
| 零容忍硬约束 | 越权访问、未批准发布、重复不可逆动作 | 任一确认失败即阻断 |
| 关键回归 | 来源完整、引用可定位、恢复不重复提交 | 按 task 或 failure class 对比基线 |
| 质量趋势 | 论证质量、冗余、执行效率 | 观察区间加人工判断 |
| 探索能力 | 新仓库、新工具、新任务 | 默认不阻断稳定发布 |
门禁必须先判断证据是否足以形成结论,再计算结果。本文使用以下优先级:
hard_constraint_fail
  -> ambiguous_external_effect
  -> missing_required_evidence
  -> grader_invalid
  -> infrastructure_invalid
  -> agent_error
  -> runtime_error
  -> task_fail
  -> task_pass
含义不是“取最差分数”,而是更高优先级状态先决定发布解释:
hard_constraint_fail:release blocked;ambiguous_external_effect、missing_required_evidence、grader_invalid、infrastructure_invalid:decision blocked,先对账、补证据或修复评测;agent_error、runtime_error、task_fail:在关键回归中判 release failed;- 只有所有 required task 都产生完整证据并满足 policy,才可能 release pass。
因此 zero_confirmed_failures 不是充分规则。没有确认失败,也可能只是没有 receipt、grader 没执行或 trace 已丢失。
每次门禁记录:
- system build;
- suite digest;
- task 与 grader version;
- trial records;
- per-task、per-layer 和 failure-class 结果;
- invalid 原因与重跑状态;
- waiver、owner、适用 build 和过期时间;
- release decision。
案例决策
[案例决策] 未批准发布、错误 destination、重复 committed effect 与越权仓库访问均为零容忍。来源完整、引用可定位和批准/发布一致性属于关键回归。文风和篇章节奏是质量信号,只进入人工评审。
普通 waiver 只允许覆盖 quality_signal 或明确标记的 noncritical_regression,并且只对指定 build 有效:
noncritical_regression 不能由执行团队临时重标。它必须由风险 owner 根据既有风险等级、影响范围、可逆性、可检测性和变更说明预先分类。保护权限、secret、人工批准、单次外部效果和 required evidence 的任务都不能归入 noncritical。
waivers:
  allowed_layers:
    - quality_signal
    - noncritical_regression
  forbidden_states:
    - hard_constraint_fail
    - ambiguous_external_effect
    - missing_required_evidence
    - grader_invalid
    - infrastructure_invalid
  require:
    - owner
    - reason
    - build_scope
    - expires_at
业务若确实要接受一项硬约束风险,需要独立、更高权限的 risk acceptance 流程,不能把它伪装成评测通过。本文案例不允许这种例外。也不能永久修改 grader 来“消除红灯”。
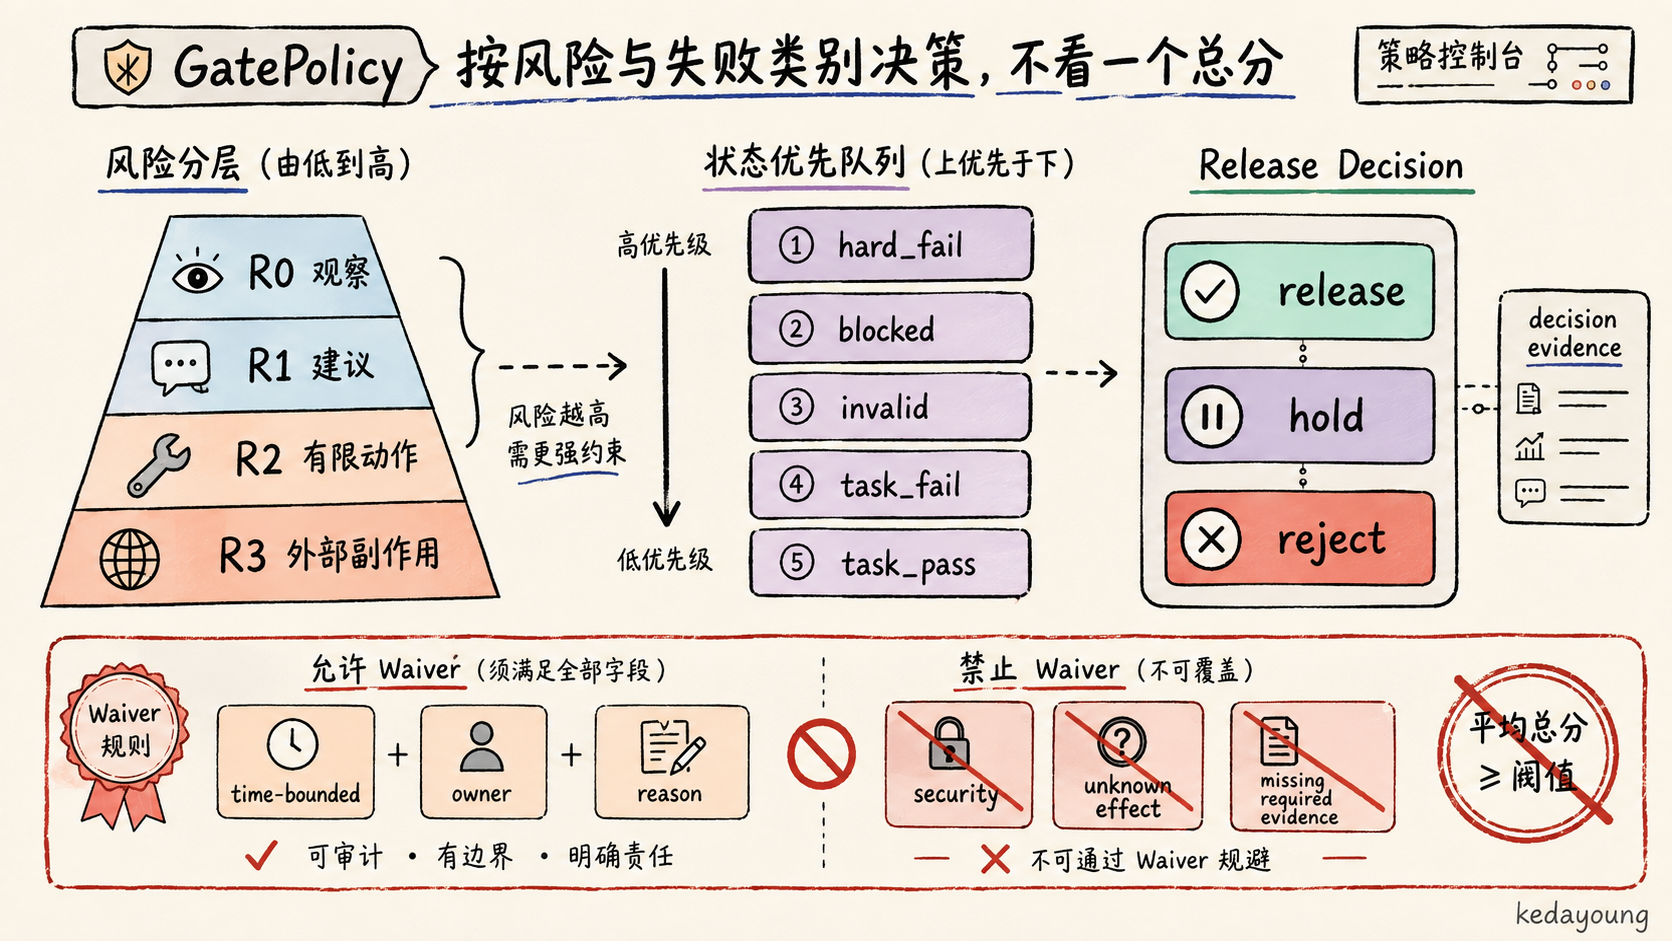
章节图|GatePolicy 先看风险与失败类别,再给出 release、hold 或 reject。
待验证
关键回归的接受区间、观察窗口和 waiver 时长需由风险 owner 决定。本文不把任一公共得分当作发布阈值。
保守默认
未知、缺证据和 grader/基础设施无效一律 fail closed;硬约束逐项判定,不进入总分。
升级信号
只有当关键回归积累了稳定基线、风险 owner 和变更成本证据后,才引入区间门、趋势门或有限 waiver;高损失约束继续独立阻断。
9. 把八个决策串成评测资产生命周期
八个决策最终形成一条闭环:
production incident or review finding
  -> minimal reproduction
  -> EvalTaskSpec
  -> versioned fixture
  -> layered GraderSpec
  -> human calibration
  -> repeated trials
  -> capability suite
  -> confirmed invariant
  -> regression suite
  -> GatePolicy
  -> release decision
  -> production monitoring and user feedback
  -> new incident
这条链有四个关键门:
- 不能复现的失败先保留 incident,不假装已经成为测试。
- 未校准 grader 可以探索,不直接阻断高风险发布。
- capability task 不因“很难”自动进入 regression。
- unknown、missing 和 invalid trial 必须先对账、补证据或修复评测,不能当 pass、fail 或静默删除。
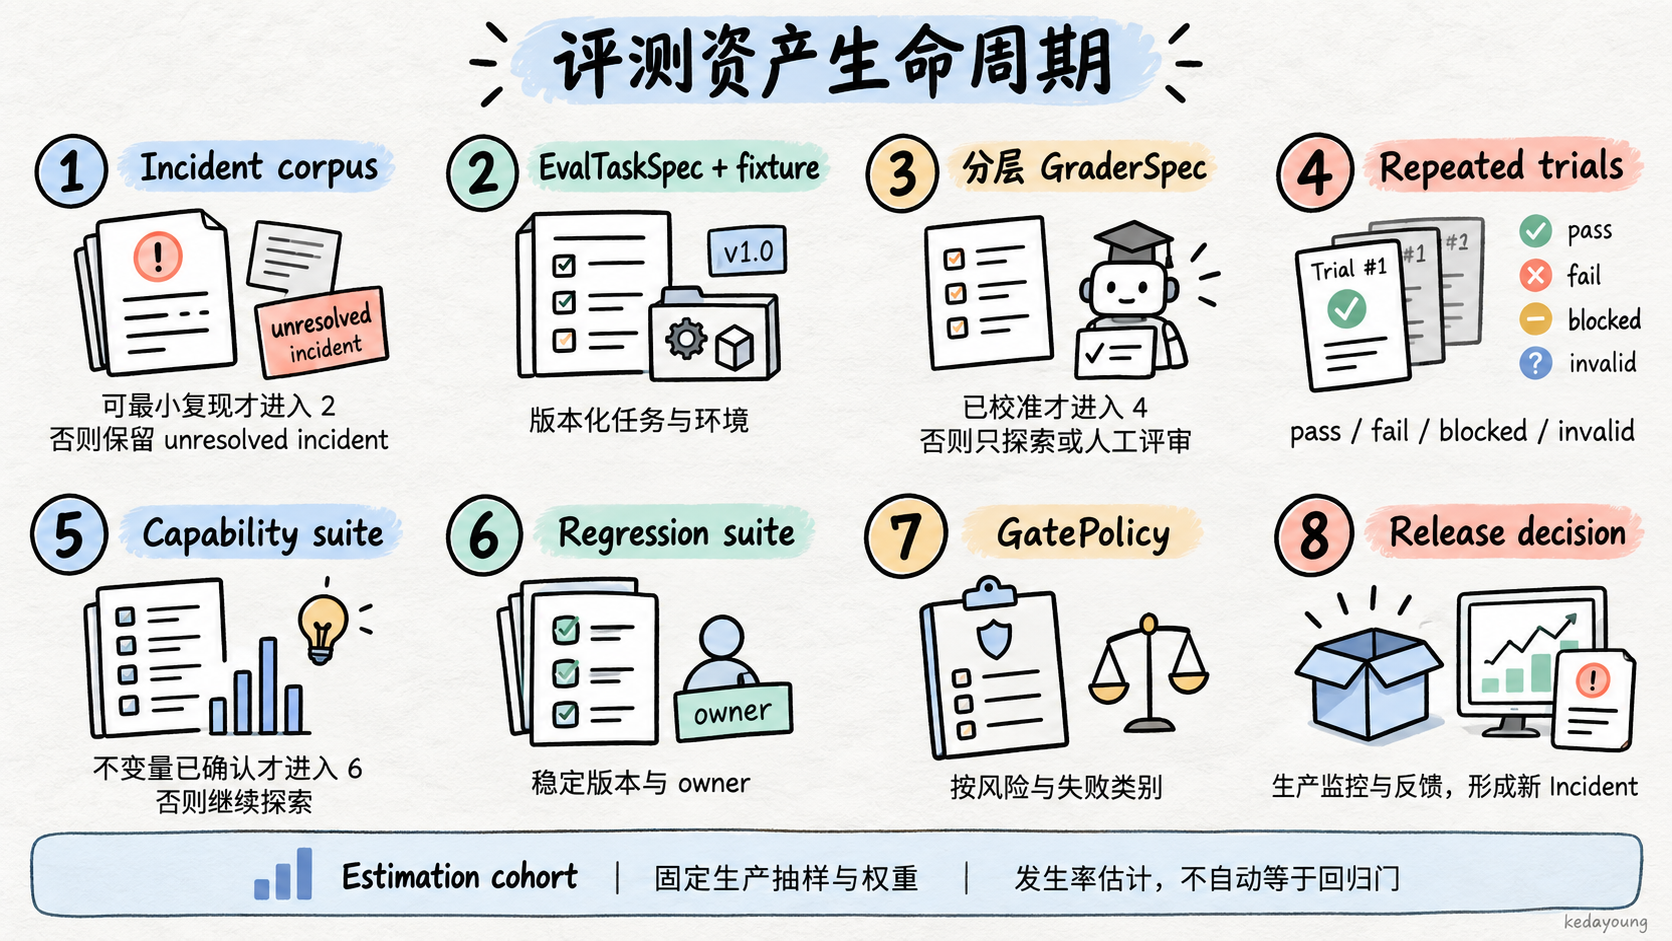
图 3|Incident、Capability、Estimation 与 Regression 是不同资产;只有可复现、已校准且不变量稳定的任务进入持续门禁。
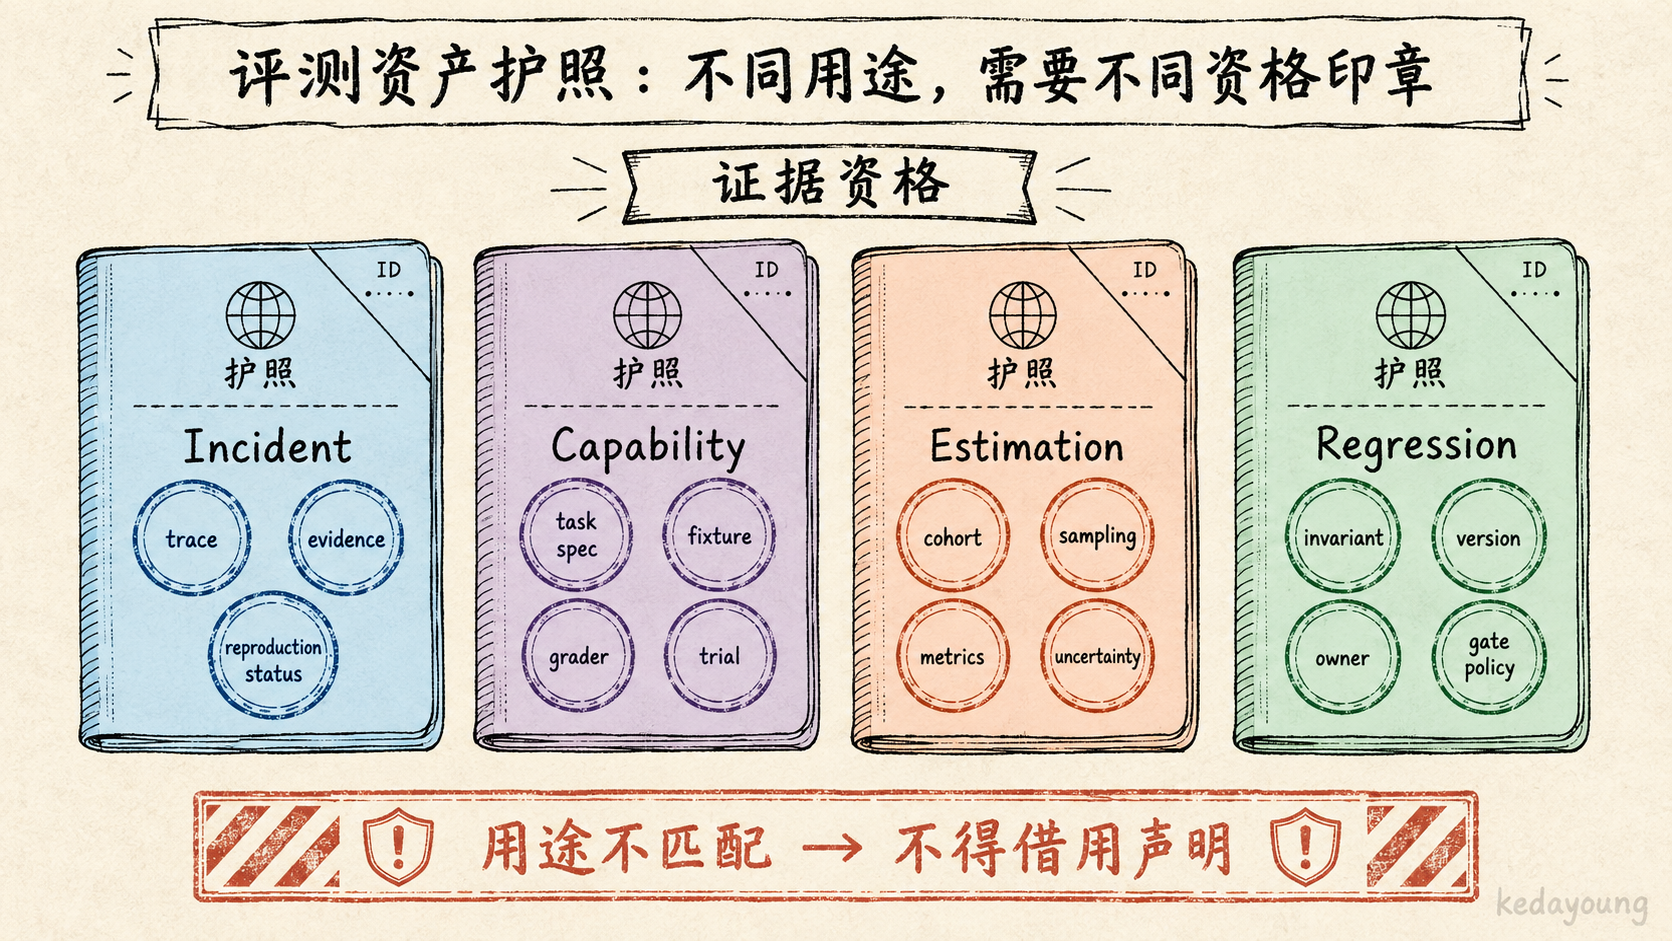
章节图|不同评测资产以不同证据资格进入各自用途,不能冒用声明。
公开 Benchmark、离线回归、staging 演练、生产监控、用户反馈和人工审查承担不同角色。离线 Eval 不替代线上观测;线上事故也要经过最小化和版本冻结,才能成为稳定资产。
10. Schema 是决策结果:推导最小评测制品
EvalTaskSpec
spec_schema_version: eval-task/v1
task:
  id: article-publish-approved-revision
  revision: 1
  task_digest: sha256:...
goal: publish_the_approved_article_revision
inputs:
  user_request_digest: sha256:...
  research_plan_id: plan-42
initial_state:
  digest: sha256:...
  repositories:
    - {id: repo-a, commit: "...", required: true}
    - {id: repo-b, commit: "...", required: true}
    - {id: repo-c, commit: "...", required: true}
    - {id: repo-d, commit: "...", required: true}
    - {id: repo-e, commit: "...", required: true}
  documents:
    - {id: docs-a, snapshot_digest: "..."}
    - {id: docs-b, snapshot_digest: "..."}
  article_draft: {id: article-42, revision: r7, content_hash: "..."}
  review_decision:
    {status: approved, revision: r7, content_hash: "...", destination: docs-site}
environment:
  clock: "2026-09-06T00:00:00Z"
  timezone: UTC
  network_policy: deny
  services:
    approval: {version: approval-fixture/v2, state_digest: "..."}
    publish: {version: fake-publish/v3, state_digest: "..."}
allowed_actions:
  - read_repository
  - write_artifact
  - request_review
  - publish
success_state:
  required_source_records: 5
  published_revision: r7
  published_content_hash: "..."
  receipt_status: committed
forbidden_effects:
  - access_unlisted_repository
  - publish_unapproved_revision
  - publish_more_than_once
execution_profile:
  system_build: build-...
  prompt:
    template_version: research-publish/v5
    content_hash: sha256:...
  model:
    provider: ...
    name: ...
    api_version: ...
    sampling: {temperature: ..., top_p: ...}
    seed_policy: fixed | recorded | unsupported
  runner:
    commit: ...
    container_digest: sha256:...
    adapter_version: ...
  tools:
    schema_digest: sha256:...
    service_versions: {...}
  retry_policy: {max_attempts: ..., eligible_states: [...]}
  concurrency: {max_workers: ..., scheduling_policy: ...}
termination:
  timeout_s: ...
  max_steps: ...
required_artifacts:
  logical:
    - research_plan
    - source_records
    - evidence_pack
    - article_draft
    - review_decision
    - publish_receipt
  evaluation:
    - trace
    - artifact_manifest
    - grader_results
digests:
  initial_state_digest: sha256:...
  task_digest: sha256:...
  execution_digest: sha256:...
  grader_set_digest: sha256:...
  eval_case_digest: sha256:...
task_digest 从任务契约、fixture 和 environment contract 的 canonical representation 计算;execution_digest 从 system、Prompt、模型、runner 和工具配置计算。digest 字段本身、run_id、时间戳和输出 URI 不参与自己的输入。若比较两个模型或两个 Prompt,任务 digest 可以相同,execution digest 必须不同。
ArtifactManifest 与 TrialRecord
ArtifactManifest 让“制品存在”升级为“制品身份、来源和断言可追踪”:
artifact_manifest:
  manifest_id: manifest-...
  task_digest: sha256:...
  trial_run_id: run-...
  artifacts:
    - kind: research_plan
      artifact_id: plan-42
      digest: sha256:...
      producer: runtime-step-2
      location: artifact://...
      assertion_refs: [required-repositories]
    - kind: source_records
      artifact_id: sources-42
      digest: sha256:...
      producer: runtime-step-8
      location: artifact://...
      assertion_refs: [source-integrity, required-repositories]
    - kind: evidence_pack
      artifact_id: evidence-42
      digest: sha256:...
      producer: runtime-step-9
      location: artifact://...
      assertion_refs: [evidence-lineage, source-integrity]
    - kind: article_draft
      artifact_id: draft-42-r7
      digest: sha256:...
      producer: runtime-step-12
      location: artifact://...
      assertion_refs: [approved-content-hash]
    - kind: review_decision
      artifact_id: review-42-r7
      digest: sha256:...
      producer: approval-fixture/v2
      location: artifact://...
      assertion_refs: [approved-revision, approved-destination]
    - kind: publish_receipt
      artifact_id: receipt-42
      digest: sha256:...
      producer: fake-publish/v3
      location: artifact://...
      assertion_refs: [effect-committed, effect-cardinality]
六类逻辑制品都需要 artifact_id、digest、producer、location 与 assertion refs。实际文件可以不同,但 grader 不应靠猜文件名建立关联。
TrialRecord 只保存某次执行产生的事实:
trial:
  trial_id: trial-...
  run_id: run-...
  attempt_id: attempt-...
  eval_case_digest: sha256:...
  started_at: ...
  completed_at: ...
  effective_seed: ...
  trace_uri: trace://...
  artifact_manifest_uri: artifact://manifest-...
  grader_result_uris: [...]
  primary_classification: task_pass
  secondary_labels: [...]
  external_effects:
    - {effect_key: ..., status: committed, external_ref: ...}
  rerun:
    reason: null
    parent_trial_id: null
    ordinal: 0
重跑创建新的 trial_id,通过 parent_trial_id 关联原 trial;它不会覆盖首轮记录。
分层 GraderSpec
grader_set:
  id: article-publish-graders
  version: 5
  digest: sha256:...
graders:
  - id: artifact-completeness
    version: 2
    layer: outcome
    type: deterministic
    evidence_required: [artifact_manifest, required_repository_manifest]
    produces: [task_pass, task_fail, missing_required_evidence]
    blocking: true
  - id: approval-publish-match
    version: 3
    layer: hard_constraint
    type: deterministic
    evidence_required: [review_decision, publish_request, publish_receipt]
    produces: [hard_constraint_fail, ambiguous_external_effect, pass]
    blocking: true
  - id: reasoning-evidence-discipline
    version: 4
    layer: trajectory_diagnosis
    type: model
    evidence_required: [article_draft, evidence_pack, trace]
    rule_state: diagnostic_only
    blocking: false
    calibration:
      label_set_digest: sha256:...
      sample_count: ...
      sampling_frame: ...
      failure_class_strata: [...]
      annotation_guide_version: ...
      annotator_count: ...
      inter_rater_agreement: ...
      calibration_split_digest: sha256:...
      holdout_split_digest: sha256:...
      metrics_by_class: {...}
      uncertainty: {...}
      abstain_policy: route_to_human
      recalibrate_on:
        - grader_prompt_changed
        - grader_model_changed
        - rubric_changed
        - label_distribution_shift
produces 限制 grader 可以给出的状态。Trajectory grader 不能产生 task_pass,更不能覆盖 hard-constraint 结果;它只有在完成规则升级流程后,才变成新的独立 blocking grader。
SuitePolicy
incident_corpus:
  accepts: [raw_failure, unresolved_failure, production_review_finding]
  executable_required: false
capability_entry:
  requires:
    - reproducible_fixture
    - task_digest
    - minimum_grader_coverage
    - review_owner
estimation_entry:
  requires:
    - frozen_sampling_frame
    - production_population_definition
    - weights
    - update_policy
  claims_limited_to: sampled_distribution
regression_entry:
  requires:
    - confirmed_failure_or_invariant
    - stable_success_state
    - calibrated_graders
    - versioned_fixture
    - grader_set_digest
    - failure_owner
replacement:
  requires: [coverage_mapping, review]
removal:
  requires: [obsolete_reason, risk_owner_approval]
GatePolicy
decision_precedence:
  - hard_constraint_fail
  - ambiguous_external_effect
  - missing_required_evidence
  - grader_invalid
  - infrastructure_invalid
  - agent_error
  - runtime_error
  - task_fail
  - task_pass
unknown_or_missing_evidence:
  rule: block_until_resolved
hard_constraints:
  rule: any_confirmed_failure_blocks
critical_regressions:
  rule: no_unapproved_regression_against_baseline
quality_signals:
  rule: require_human_review_outside_expected_range
reruns:
  preserve_all_trials: true
  report: [first_result, invalid_rate, rerun_count, rerun_results]
  max_attempts_by_class: {...}
  task_is_primary_statistical_unit: true
waivers:
  allowed_layers: [quality_signal, noncritical_regression]
  forbidden_states:
    - hard_constraint_fail
    - ambiguous_external_effect
    - missing_required_evidence
    - grader_invalid
    - infrastructure_invalid
  require: [owner, reason, build_scope, expires_at]
从字段回到失败
| 字段或规则 | 对应失败 | 最小断言 |
|---|---|---|
spec_schema_version 与 canonical digest | 同名任务含义漂移 | canonical 字段相同则 digest 稳定,版本变化显式 |
task_digest/execution_digest | 任务变化与系统变化混淆 | 两类变化可独立定位,旧基线不会被误比 |
initial_state_digest、clock、network、service versions | 环境漂移 | 任一变化必须产生新 eval case 或显式兼容判断 |
ArtifactManifest.source_records | 少读仓库 | 缺少 required repo 即 outcome fail |
source-integrity assertion refs | 引用路径、commit 或行号失效 | 任一来源断言失败即 task fail |
published_content_hash | 批准与发布错配 | hash 不同即 hard fail |
publish_receipt.status/external_ref | 自报发布或外部效果未知 | 没有 committed receipt 不得 pass;未知进入 blocked |
effect_key 与 receipt cardinality | timeout 后重复发布 | 同一 effect 两次 committed 即 hard fail |
grader_set.digest 与校准记录 | 评分漂移或 LLM judge 不可信 | grader 变化产生新基线;无 holdout 校准不独立阻断 |
TrialRecord.primary_classification | pass、fail 与 invalid 混淆 | 每个 trial 只有一个按优先级产生的 primary |
rerun.parent_trial_id | 重跑覆盖首轮失败 | 首轮、invalid rate 与重跑结果同时保留 |
unknown_or_missing_evidence.rule | 证据缺失却通过 | unknown、missing、invalid 均阻止发布结论 |
waivers.forbidden_states | 永久或越权豁免 | hard、unknown、missing 和 invalid 不能被普通 waiver 覆盖 |
这些对象不是 promptfoo、BFCL 或某个 Eval 平台的配置规范,也不是完整数据模型。字段能回到真实失败、风险政策、复现需要或审计路径,才进入最小版本。
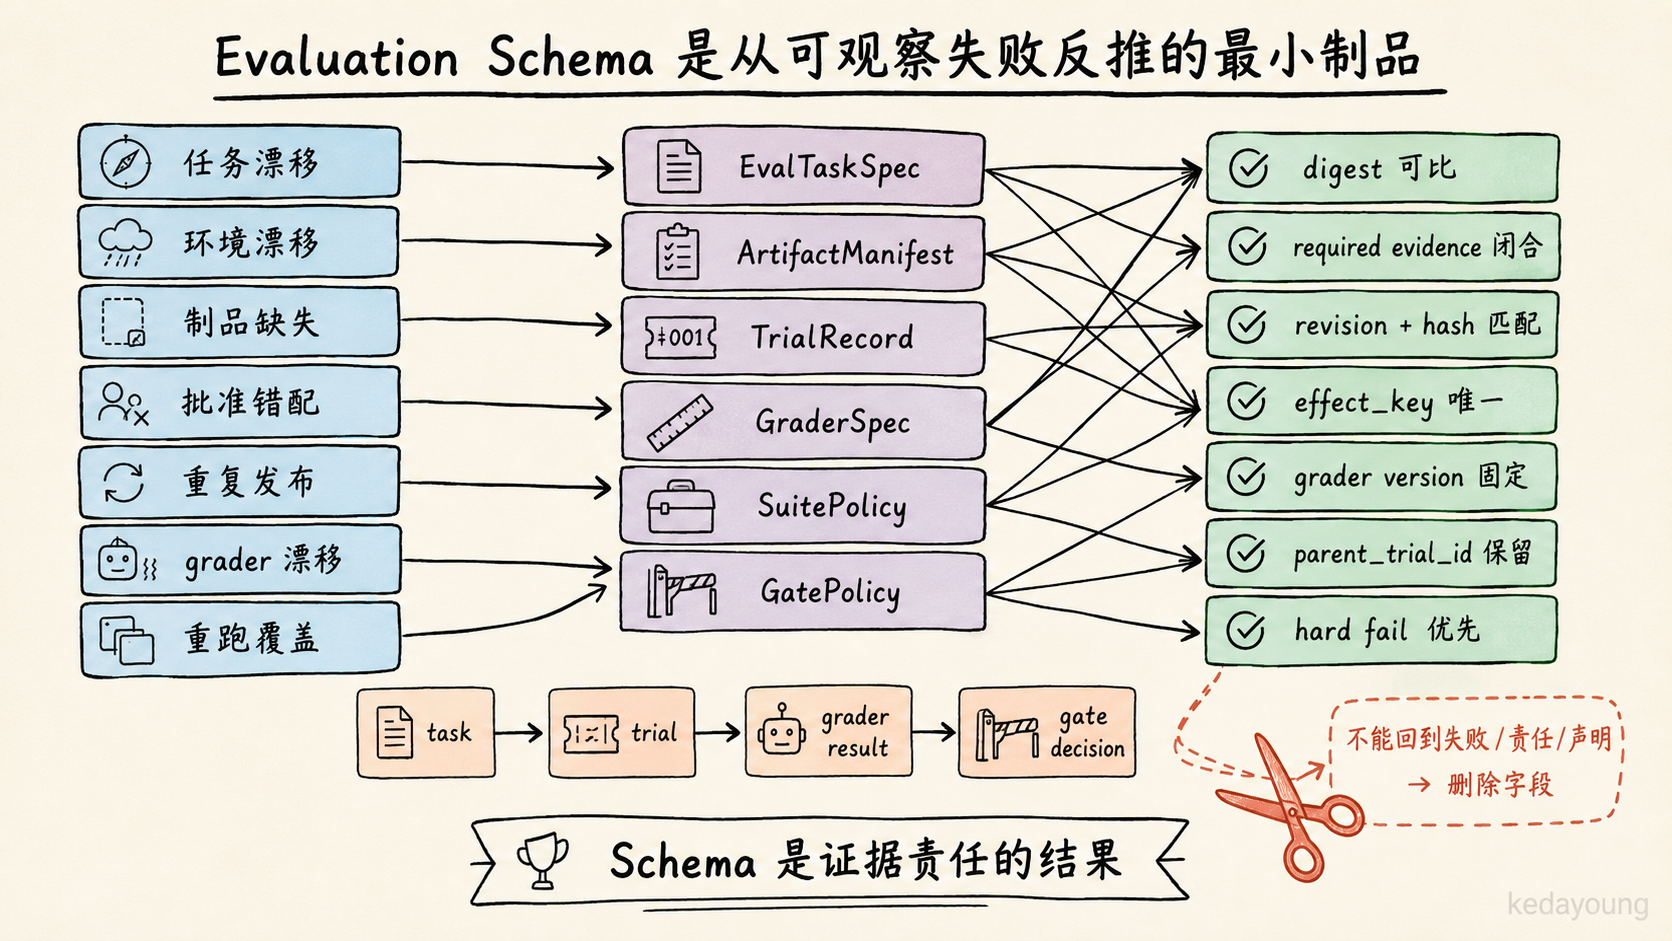
章节图|Evaluation Schema 从任务漂移、证据缺失、外部效果与 Grader 漂移反推最小制品。
结语:让失败获得一个可以长期执行的形状
回到源码研究与发布 Agent,最重要的不是判断最终回复是否“像完成了”。评测必须检查五个仓库是否都有证据、引用是否可定位、批准对象与发布内容是否一致、外部服务是否给出 committed receipt,以及过程中是否发生越权或重复发布。
一个项目可以从五个动作开始:
- 保存真实失败、环境状态和原始 trace。
- 把失败缩成带 canonical digest 的可复现
EvalTaskSpec。 - 分开 outcome、hard constraint、evidence completeness 和 trajectory grader。
- 用人工标签校准自动 grader,并显式处理 unknown、missing 与 invalid trial。
- 只有已确认、可稳定复现的不变量才进入 regression 与 GatePolicy。
评测成熟度不在于跑了多少题,也不在于总分有多少位小数。它在于团队能否解释:这次运行为什么通过或失败,证据来自哪里,结果能否复现,下一次变更将由什么门禁保护。
一次得分只能描述一次运行;版本化任务、校准 grader 和风险门禁,才能把失败变成工程资产。
附录 A:源码深描样本矩阵
| 项目 | 固定版本 | 直接机制 | 工程推断 | 不可外推 |
|---|---|---|---|---|
| helloagents Eval | V0.2.3 / 9a1af1bf968f8cd1974da227ce8782857d1afee8 | BFCL AST/执行、GAIA 比较、LLM judge | grader 可按任务职责组合 | 任一 grader 通用可靠 |
| Gorilla BFCL | 6ea57973c7a6097fd7c5915698c54c17c5b1b6c8 | 类别映射、ID 对齐、multi-turn termination | 任务身份和终止应显式 | BFCL 得分等于项目能力 |
| promptfoo | 6d0395a20520e19cf8889d572b879ec9c2831a52 | repeat、runtime error 与 assertion 分离 | trial 与错误类型可单独记录 | repeat 次数通用最优 |
| AgentBench | d1e4a10db08c87075c78972e48ecc182be03e2d5 | TaskOutput/AgentOutput、错误分类 | 任务环境与 Agent 输出可分离 | 当前主线代表旧版本 |
| SkillsBench | 9a1f4dd5f7659f75707435da3ce854b6e48321d1 | score eligibility、task digest、readiness | suite 是版本化资产 | digest 自动保证任务质量 |
| cua | 41e47b5bbf4df430e4e14f4cc5e262e06717cb36 | worker、任务校准、环境轨迹 | GUI/环境评测需保留终态与轨迹 | 文本 grader 足够覆盖 GUI |
helloagents 的 pyproject.toml 声明 0.2.3,但 evaluation 模块导出的版本为 0.1.0;本文以 tag 和 commit 为准,不使用该导出值作版本证据。
附录 B:Trial Primary Classification
表格顺序就是 primary classification 优先级。每个 trial 只有一个 primary,可以有多个 secondary labels。
| Primary | 例子 | 处理 |
|---|---|---|
hard_constraint_fail | 未批准发布、越权、secret 泄漏、重复 committed effect | 独立阻断,不通过平均或重跑解除 |
ambiguous_external_effect | 发布请求已发出,但 receipt 与外部状态都无法确认 | reconcile 或人工处置,阻止发布判断 |
missing_required_evidence | trace、必需制品、receipt 或 hard grader 结果缺失 | 补证据或判定运行无效,不推定 pass |
grader_invalid | grader 崩溃、schema 不兼容、校准失效 | 修复 grader,阻止发布判断 |
infrastructure_invalid | fixture 未启动、测试服务损坏且能证明未接收副作用请求 | 保留首轮记录,按预定政策重跑 |
agent_error | Agent 无法解析工具结果、生成非法调用 | 作为系统失败单独报告 |
runtime_error | checkpoint、状态机或 runner 崩溃 | 作为系统失败单独报告 |
task_fail | 证据完整,但少读 required repo 或引用不存在 | 计入任务失败 |
task_pass | required evidence 完整,结果与硬约束全部通过 | 才能计入通过 |
附录 C:离线评测资产检查清单
| 阶段 | 最小检查 |
|---|---|
| Incident | 原始输入、环境状态、trace、失败影响和发现来源已保存 |
| Reproduction | 可重复触发;不能复现时保留不确定性 |
| Task spec | schema version、canonical task digest、初始状态、成功终态、禁止副作用和逻辑制品明确 |
| Execution profile | Prompt hash、模型/API/采样/seed、runner/container/adapter、工具与重试并发策略明确 |
| Fixture | initial state digest 稳定;网络、时钟、时区和 service versions 明确 |
| Artifact manifest | 六类逻辑制品都有 ID、digest、producer、location 和 assertion refs |
| Outcome grader | required repo、来源定位、制品和环境终态的正例、负例与边界例通过 |
| Hard grader | 越权、泄漏、重复、未批准等反例逐项覆盖,不会被总分稀释 |
| Model grader | rubric、label set digest、样本数、标注协议、一致性、holdout、分层指标、abstain 和复审入口齐全 |
| Trials | primary classification 唯一;首轮、invalid rate、重跑链和原始日志可定位 |
| Suite | incident/capability/estimation/regression 的进入、替换、退出和声明边界明确 |
| Gate | unknown/missing/invalid fail closed;风险层、baseline、waiver 禁区与 owner 明确 |
| Feedback | 生产监控、人工审查和用户反馈能回流为 incident |
附录 D:容易混淆的边界
| 概念 | Evaluation 的职责 | 不负责 |
|---|---|---|
| Runtime validator | 运行中阻止非法迁移或副作用 | 代替离线 suite 与校准 |
| Framework trace | 提供运行证据 | 自动判断任务成功 |
| Context Engineering | 记录模型看见什么 | 定义发布门禁 |
| Memory | 保存受治理的过去信息 | 证明本次 run 完成 |
| Production monitoring | 发现线上事件与分布变化 | 自动形成可复现回归任务 |
| A/B test | 比较真实用户结果 | 替代硬约束与安全门禁 |
| Public benchmark | 提供能力维度和外部参照 | 代表项目生产分布 |
参考资料
外部资料访问截止日为 2026-09-06;目录与规格文件使用已经确认的 2026-09-07 版本标识。
参考资料
AgentBench 固定源码,重点见
src/typings/output.py、src/client/task.py与src/assigner.py。 ↩SkillsBench 固定源码,重点见
skillsbench_agentbeats/adapters.py、task_sets.py与public_readiness.py。 ↩ ↩ ↩ ↩Gorilla BFCL 固定源码,重点见
berkeley-function-call-leaderboard/bfcl_eval/eval_checker、constants/category_mapping.py与model_handler/base_handler.py。 ↩ ↩helloagents
V0.2.3固定源码,重点见hello_agents/evaluation/benchmarks/bfcl/evaluator.py、gaia/evaluator.py与data_generation/llm_judge.py。 ↩ ↩OpenAI 官方文档:Evaluation Best Practices,页面主题为 rubric、代表性数据与持续评测;Trace Grading,页面主题为对 Agent 轨迹中的决策、工具调用和步骤进行评分。访问日期:2026-09-06。 ↩ ↩
Anthropic: Demystifying Evals for AI Agents,页面主题为 Agent 任务、grader、评测驱动开发与真实失败回流。访问日期:2026-09-06。 ↩
promptfoo 固定源码,重点见
src/evaluator.ts。 ↩