Agent Memory 设计的起点,不是“选向量库还是图数据库”,而是回答一个更严格的问题:哪一类过去的信息,在满足什么证据门槛后,可以影响哪个实体的下一次决策?
引言:一道不能靠“记住答案”解决的金融题
BigFinanceBench 的公开任务 bf-b0926059cd 要求研究 Agent 回答:截至 2025 年 10 月 30 日,PayPal 与 Shopify 每 100 美元交易量实际保留多少收入?公开参考答案分别是 PYPL 的 $0.79 和 SHOP 的 $0.88。这两个结果看起来很适合被“记住”,下次有人再问时直接取出来即可。
但只保存答案,恰好跳过了这道题最难也最重要的部分。
Agent 要先确定截止日期前已经公开的材料,再分别构造两家公司的最近十二个月(LTM,Last Twelve Months)窗口。PayPal 当时可用的是 2024 年第四季度到 2025 年第三季度,Shopify 可用的是 2024 年第三季度到 2025 年第二季度。随后还要对齐 transaction volume、transaction revenue、支付给第三方的费用、单位和公式。最终的两个数字,只是来源、期间、定义、假设、调整和计算共同产出的最后一行。bigfinancebench
如果 Agent 把 $0.79 和 $0.88 当成永久事实,下一次查询换了截止日期,它就可能非常自信地复用一条已经过期的答案。如果它只记住一段自然语言摘要,期间和公式又可能在压缩中消失。真正值得复用的,可能不是这两个数,而是带来源和业务时间的派生链,或者“不同公司的 LTM 截止季度必须分别判断”这条经过多任务验证的程序性经验。
公开研究已经记录下金融 Agent 的任务缺口。FinanceBench 收录了 10,231 个带答案和证据片段的问题;在其 150 题、16 种配置的人工审阅实验中,GPT-4-Turbo 加 retrieval 仍对 81% 的问题答错或拒答。BigFinanceBench 则用 928 个专家任务、36,241 个评分点检查完整推导,首轮十个系统中最佳 rubric score 为 58.8%。financebenchbigfinancebench
任务扩展到端到端流程和动态偏好后,缺口仍然存在。FinGAIA 的 407 个任务覆盖七个金融子域,最佳 Agent 得分 48.9%,比金融专家低 35 个百分点以上。FinPerMA 在 276 个投资者 persona 和 2,994 个问题上发现:即使保留 full context,总体准确率也没有超过约 0.47;摘要经常保留事实,却丢失偏好信号。fingaiafinperma
这些数字的任务和指标不同,不能拿来横向排名。它们也不能证明错误由长期 Memory 引起,更不能证明加一个 Memory 框架就能解决问题。它们建立的是本文的现实背景:即使 Agent 已经拥有搜索、长上下文和工具,仍会在来源、期间、定义、流程和更新上失败;一旦再引入 Memory,还会增加错误写入、过期召回、跨作用域污染和历史知识泄漏。
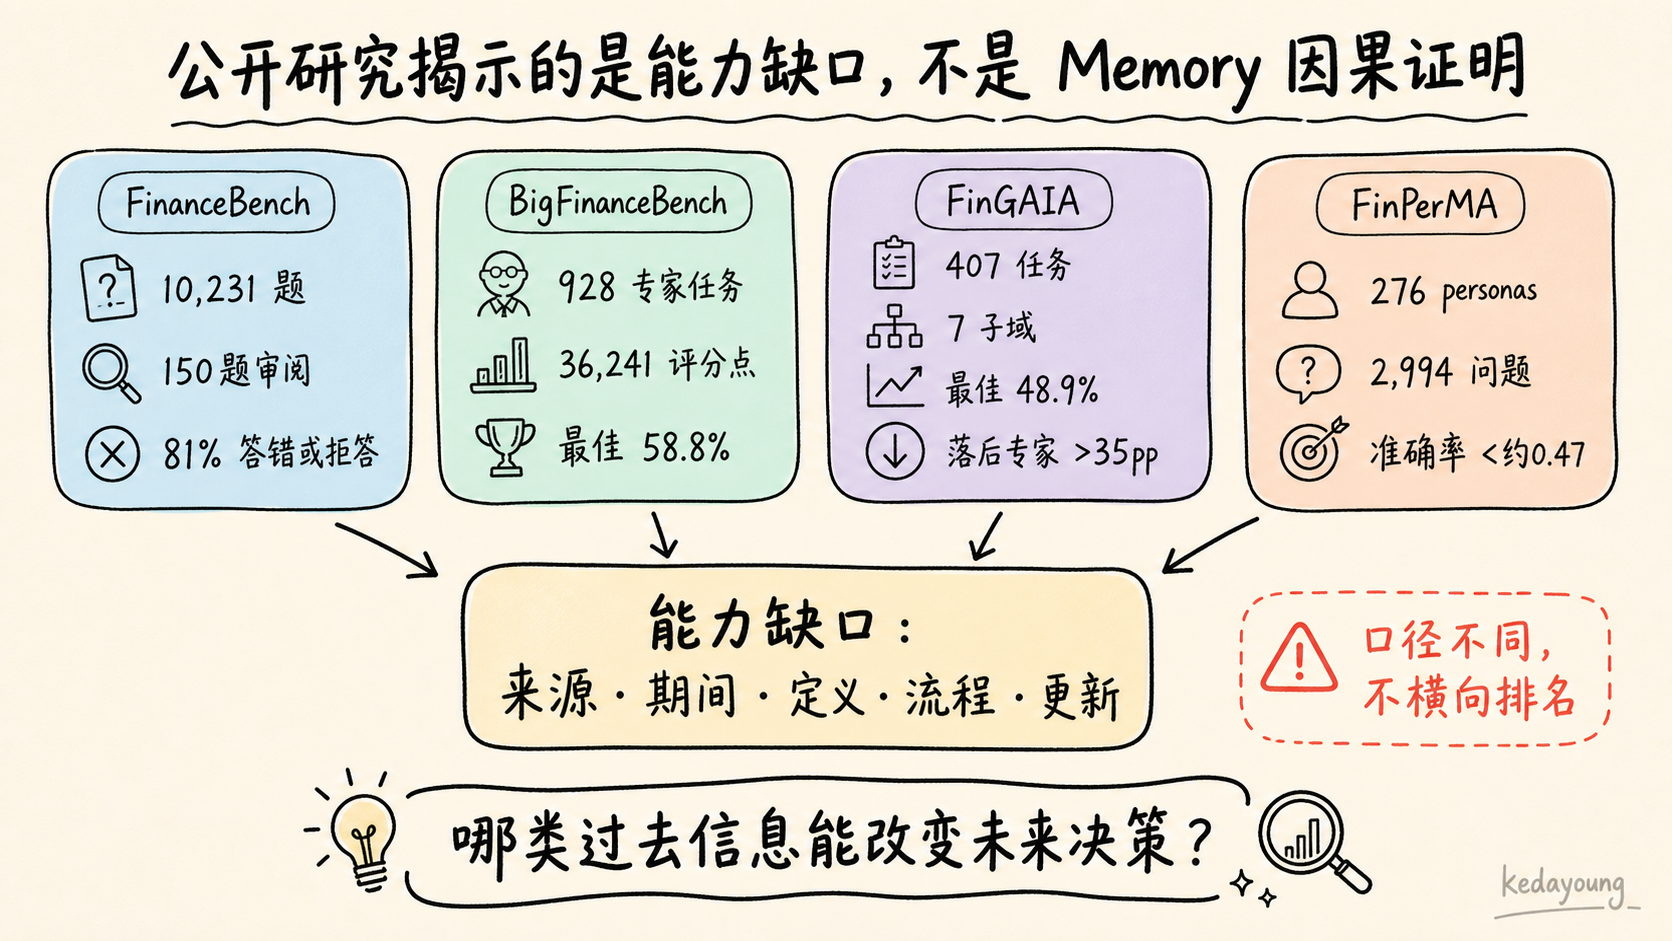
图 1|公开实验建立的是能力缺口,不是 Memory 的因果证明。 图中四项研究口径不同,只能分别解释。
本文因此不从“主流框架有什么组件”出发,而是从真实失败出发,依次回答八个决策问题:是否需要、记什么、如何确定身份边界(权威、作用域、时间与权限)、何时能写、怎样存和找、怎样进入上下文、怎样纠错退出、怎样评测升级。
本文最终给出的不是虚构生产收益,而是一张选型表、一组可执行的评测断言,以及由前述决策推导出的最小 Schema。
为了不把事实和建议混为一谈,本文以五类证据口径约束陈述强度:公开论文与仓库可核验的内容是“公开事实”;对 46 个 Agent 实践样本的归纳是“样本观察”;可迁移但仍需项目验证的是“工程建议”;金融 Agent 只承担“案例决策”;阈值和效果未知时明确标为“待验证”。
全文最重要的入口问题只有一句:
Agent 在什么未来决策上失败了,而哪一类过去信息可能改变这次决策?
如果答不出来,先不要设计 Memory。
1. 先诊断:这真的是一个 Memory 问题吗?
工程团队很容易把所有“Agent 忘了”的现象归到 Memory。模型没有使用刚刚返回的工具结果,叫“短期记忆差”;不知道最新财报,叫“长期记忆缺失”;长任务中断后不能继续,也叫“没有记忆”。这三个问题表面相似,责任边界却完全不同。
Memory 真正解决的是:让本来不在当前输入中的过去信息,在未来决策时有条件地重新参与。 如果信息已经在本轮上下文里,但模型没有正确使用,优先检查 Prompt、工具输出结构、上下文位置和验证器。如果缺的是最新外部事实,优先修数据源、RAG、时间过滤和工具调用。如果缺的是流程当前位置,先补事件日志和 checkpoint。只有当某类过去信息将跨越当前输入边界,并且它确实能改变未来决策时,才进入跨 session Memory 设计。
| 观察到的失败 | 优先检查 | 何时才进入 Memory 设计 |
|---|---|---|
| 本轮不会使用刚取回的数据 | Prompt、工具结果结构、上下文位置、验证器 | 已确认信息会在后续 session 再次需要 |
| 不知道最新财报数字 | 外部知识源、数据 API、截止日期过滤 | 需要复用上次如何寻找、对齐和验证的过程 |
| 长任务中断后无法继续 | event log、session、checkpoint | 需要恢复跨 session 的任务状态 |
| 重复犯同一个操作错误 | 工具约束、测试、workflow | 存在经过结果验证且可泛化的程序性经验 |
| 使用旧偏好或旧状态 | 当前权威源、更新流程 | 需要同时保留历史并判断当前有效版本 |
这一步最有价值的产物不是技术清单,而是一组可复现失败。团队应先保存原始 event、工具调用、上下文快照和结果,建立“无长期 Memory”基线。然后做最小消融:只把一种候选过去信息加入同一任务,观察端到端结果是否改善。如果失败仍然存在,就不要用更复杂的存储掩盖诊断不清。
四个通用框架给出的不是四种同义 API,而是四条可以用来定位故障的边界:
- LangGraph 用 checkpointer 保存某个 thread 的 graph state,跨 thread 对象则进入带 namespace、key 和 filter 的 store。前者回答“这条执行链如何继续”,后者才回答“另一条执行链可以复用什么”。
- Google ADK 让 SessionService 管理 event 与 state,由 MemoryService 接收 session 内容并提供 search。它允许应用把一次会话摄取为可查询材料,但是否提炼、以什么粒度复用,仍由具体实现决定。
- OpenAI Agents SDK 的 Sessions 负责在一次会话前后取回和追加 items,也支持最近 N 条和 compaction;这能减少应用手动传历史的工作,却没有默认把对话判断为跨 thread 的稳定事实。
- Langflow 把消息持久化与 Agent 是否启用 chat memory 明确分开:数据库里“有这条消息”,不代表模型下一轮“看到了这条消息”。session-memory-boundary
因此,诊断时不要先问“应该选择哪个框架”,而要先定位断裂发生在哪个边界:是 run 无法恢复、conversation 没有续上、跨 thread 对象不可查询,还是历史已经保存却没有进入模型上下文。四类故障若被统称为“缺少 Memory”,后续选型就会从错误的问题出发。
回到金融例子,财报原文和最新季度数据属于外部知识;当前已经取到哪些季度、还缺什么,属于任务状态;带来源和公式的中间值是派生事实候选;“LTM 窗口要按公司分别构造”在一次任务后最多是待验证经验。把四者都写进一个“长期记忆库”,不仅没有减少设计,反而丢掉了各自的权威和生命周期。
保守默认
先留 trace,再做 checkpoint;先证明跨 session 的过去信息有增益,再增加长期 Memory。
升级信号
同类失败稳定复现,且受控消融证明某类过去信息能改善未来任务,而不是“对话变长”或“向量库已经接好”。
2. 再决定“记什么”:从未来查询反推记忆对象
“短期记忆”和“长期记忆”适合描述保留时间,却不足以指导实现。一个保存三个月的审计日志和一个保存三个月的用户偏好,虽然都叫长期,写入门、检索方式、注入位置和删除语义完全不同。
更稳妥的方法是先写未来查询,再决定 Memory object。
| 未来问题 | 候选对象 | 默认载体 | 不应混入 |
|---|---|---|---|
| 这个任务做到哪了? | 任务状态/checkpoint | event log、结构化 checkpoint | 用户长期画像 |
| 用户或项目已确认什么? | 稳定事实或约束 | key/value、Markdown、SQL | 未验证推断 |
| 上次怎样成功完成同类任务? | 带条件和结果的经验/procedure | 文件、SQL、可检索 skill | 失败轨迹的无差别摘要 |
| 截止某日的外部事实是什么? | 权威知识与派生事实 | RAG/DB + provenance | 脱离来源的最终答案 |
| 为什么当时这样做? | 审计事件与决策证据 | append-only trace | 默认注入的全部日志 |
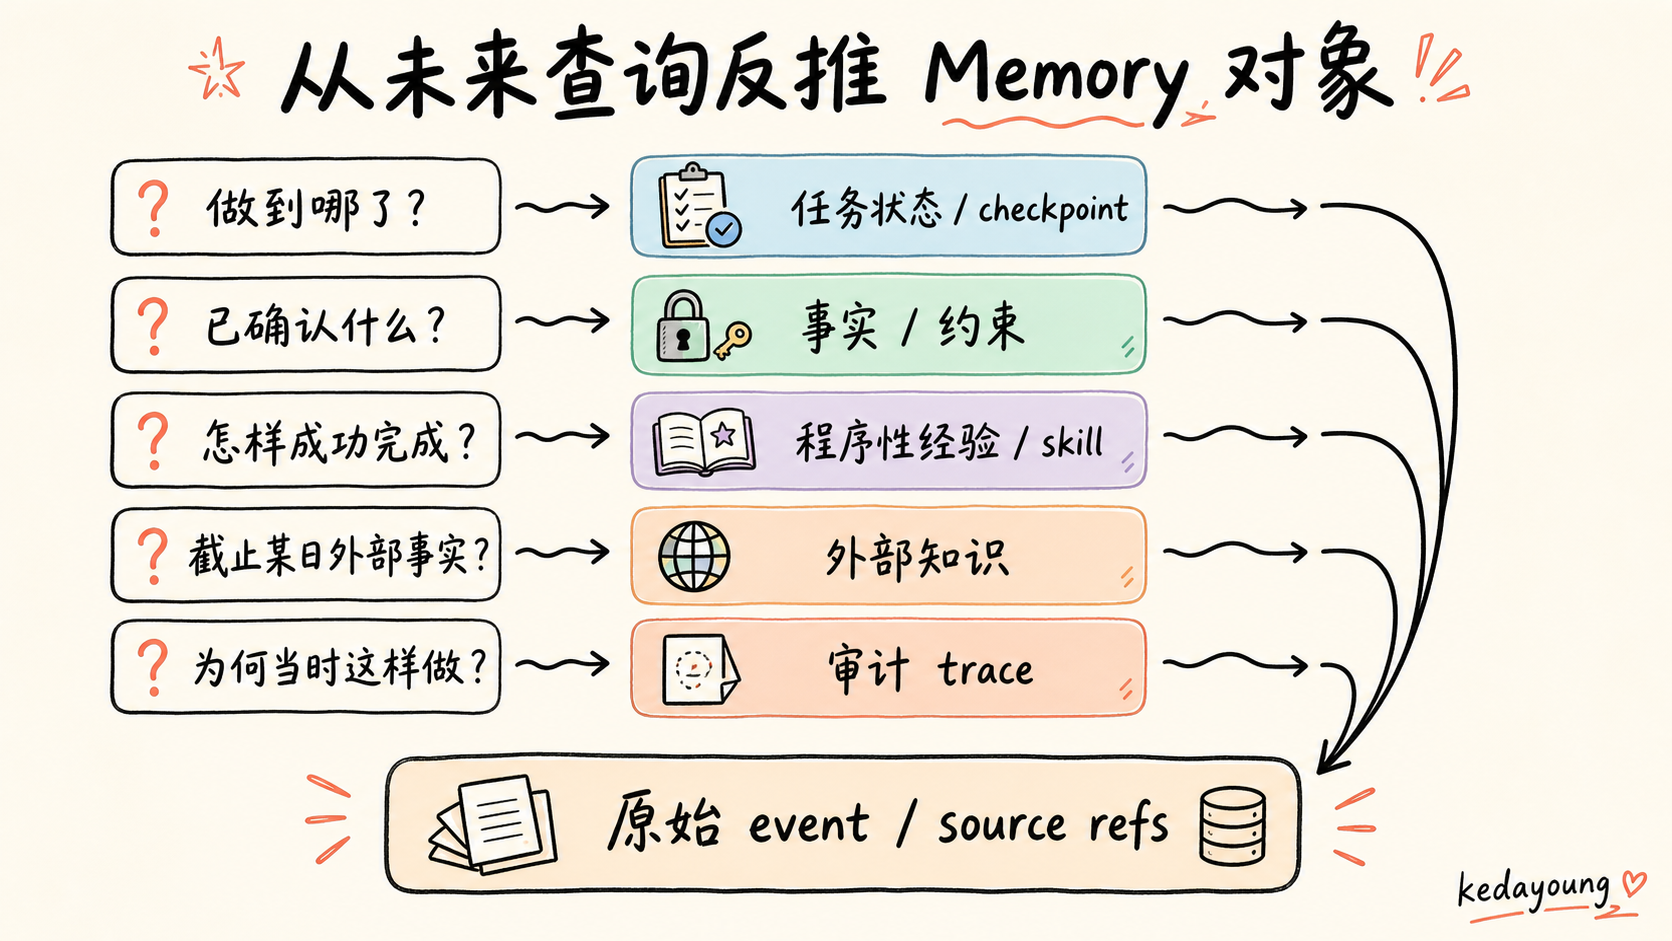
图 2|从未来查询反推记忆对象。 长短期只描述保留时间,不能替代状态、事实、经验、知识和审计对象的职责划分。
对象越接近原始 event,保真度越高,但查找和上下文成本越大;对象越抽象,越适合直接影响决策,但越容易丢失证据、忽略条件或固化错误。这个矛盾不应通过“选一种粒度”消除,而应通过分层解决:原始证据保持可回放,派生对象负责高效使用,二者用 lineage 相连。
46 个实践样本中,不同领域对“过去”的最小可复用单元并不相同。正文在每个决策点只展开能构成最小证据链的 2-4 个项目,完整样本与选样边界放在附录 A:
| 样本 | 真正保存的对象 | 未来怎样使用 | 不能把它误写成什么 |
|---|---|---|---|
| pi | JSONL 会话树、checkpoint 摘要、项目上下文 | 沿分支恢复一次工作,或用摘要替代过长历史 | 自动提炼的跨 session 事实库 |
| STORM | 带来源的资料、访谈问题、层级 outline 和 references | 写作阶段沿制品链生成可追溯文章 | 一段脱离引用的“研究结论记忆” |
| Voyager | critic 验证成功的 JavaScript 代码、技能描述和索引 | 为新任务召回可执行 skill | 对所有历史动作的语义摘要 |
| PentestGPT | goal、allowed targets、task、attempt、observation、evidence revision | 校验 run identity 后恢复有授权边界的执行状态 | 可跨目标自由复用的攻击经验库 |
这四个样本分别把 Memory 的主对象落在 session、research artifact、procedure 和 durable run state 上。它们支持的不是“Memory 可以保存任何东西”,而是一个更严格的推论:对象类型由未来要恢复的决策能力决定;对象一旦不同,权威来源、写入门、检索方式和退出条件也必须随之变化。memory-objects
这也解释了为什么“把所有消息做 embedding”通常是一个过早决定。原始消息里同时包含事实、推测、失败动作、模型复述和临时状态。相似度无法自动判断其中哪一段有资格跨任务复用。摘要也不是事实层:它可以减少 token,却可能丢掉路径、数字、版本、未完成事项和证据指针。外部知识库更不等于用户经验;审计 trace 应可查,却不应默认全部注入模型。
金融案例可以拆成五层:财报和公告是外部权威知识;搜索、工具调用和计算是 trace;“已经取到 PYPL 四个季度,SHOP 还缺一个季度”是 task state;带来源、期间、单位和公式的数值是派生事实;“不同实体的 LTM 终点不能机械对齐”是程序性经验候选。只有最后两类可能跨任务复用,而且写入条件不同。
保守默认
event 与派生 Memory 分层,任何派生对象都能回到来源。
升级信号
真实的未来查询无法用当前粒度回答,再把对象拆得更细、增加 episode 层或引入关系结构。
3. 先防串记与过期:权威、作用域和时间是身份的一部分
确定了“记什么”,还不能立刻写入。相同的一句话,因为来源、归属和时间不同,可能是三条完全不同的 Memory。
“PayPal 的每 100 美元交易量保留收入是 0.79 美元”,如果来自公开任务参考答案,它是特定截止日期、特定指标定义下的派生结果;如果来自模型在对话中的猜测,只是一条未验证候选;如果来自用户修正,还需要知道用户在修正哪一个任务、哪个定义。给它们同一个 embedding,再按相似度选最高分,并没有完成身份判断。
权威:来源决定它能承担什么责任
可以把信息按职责分成四层:原始证据,如用户原话、工具返回、财报与公告;标准化事实,即实体、期间、单位和定义已对齐的值;派生结论,即公式、假设与计算产生的结果;程序性经验,即对未来过程的建议。
权威不是一个抽象的 confidence=0.9。用户显式修正通常应高于模型旧推断,确定性工具确认的业务状态通常应高于对话摘要,派生结果不能反向覆盖原始证据。两个来源冲突而又无法确定权威时,正确状态是“conflicted,需要确认”,而不是让 LLM 选一个读起来更顺的答案。
作用域:先确定属于谁,再谈相似度
通用框架常见 tenant、user、agent、project 和 thread;垂直 Agent 则说明,真正决定隔离边界的往往是业务主键。
AI Hospital 的 history 和结构化诊断都按 patient_id 读取、修订和清空,因此它证明的是患者工作状态必须隔离,而不是“系统拥有跨患者医学知识”。TradingAgents 同时使用 ticker 与 decision time:下一次分析同一标的时可以提供最近完整决策,跨标的时只迁移抽象 reflection,避免把具体仓位机械复用。
PentestGPT 更进一步把 allowed targets、run identity、revision 和 lease 纳入恢复条件;即使一段历史高度相似,只要不属于当前授权目标或当前 revision,就没有资格参与执行。elizaOS 的 room、entity 与 agent scope 则说明,在多角色交互中,“谁观察到这条信息”和“谁可以再次使用它”也可能不同。scope-time-practices
这些样本共同把 scope 从一个检索标签提升为合法性条件:缺少 tenant、patient、ticker、target、room 或 project 等关键条件时,读路径应 fail closed,而不是先做全局向量搜索,再在应用层删除不该出现的结果。多 Agent 场景同样应先保持私有工作状态,只共享经过验证、标明来源与权限的对象。
时间:事件发生、被观察和被写入是三件事
“用户去年搬到上海”在今天说出,事件时间、Agent 观察到它的时间和系统写入时间不同。只保存 created_at,既无法回答“去年住在哪里”,也可能把旧事实误判为新状态。
point-in-time 任务还多一层限制:截止日期之后公开的信息必须被排除。KTD-Fin 通过 ticker/date masking 控制模型已有历史市场知识,提醒我们评测时不只要约束工具数据和外部 Memory,还要防止模型参数中的历史知识泄漏。该研究中的 “memory-controlled” 指这一类模型知识控制,并不是应用长期 Memory 方案。ktdfin
因此,针对给定 cutoff 的读路径至少要同时验证 event_time <= cutoff 与 information_available_by <= cutoff:前者回答“事情何时发生”,后者回答“这条证据何时已经公开可得”。随后还要独立检查 status=active,不能用生命周期状态替代时点资格。
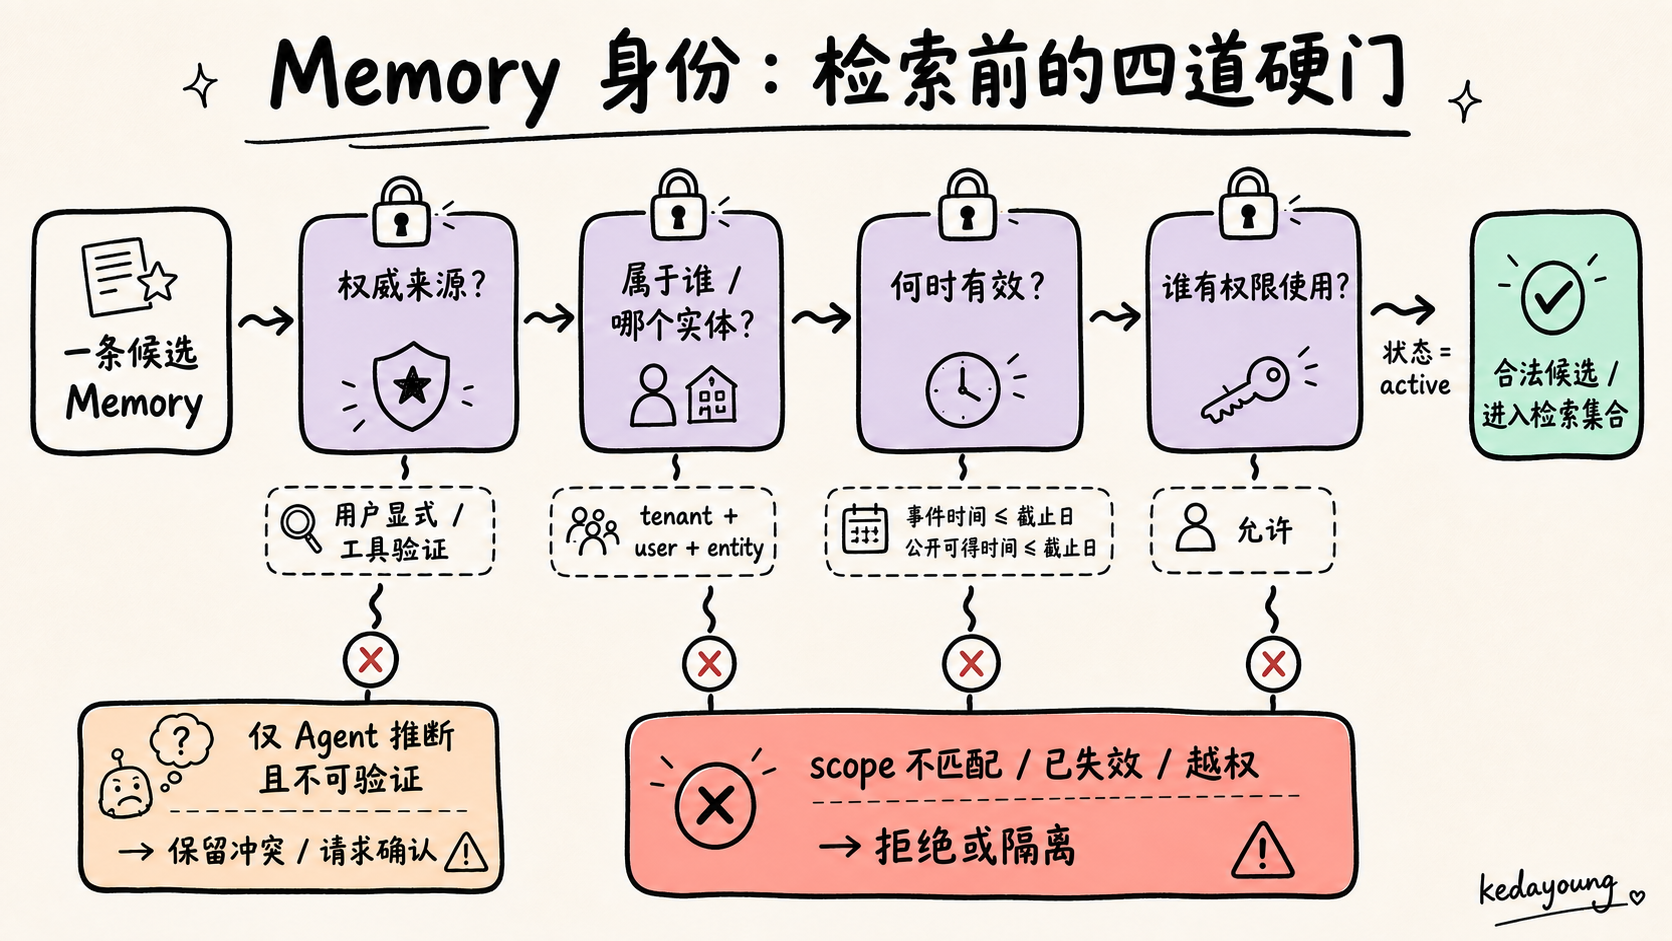
图 3|权威、作用域、时间和权限共同构成 Memory 身份;当前状态是进入合法候选集前的独立条件。 这些都是相似度排序前的硬门。
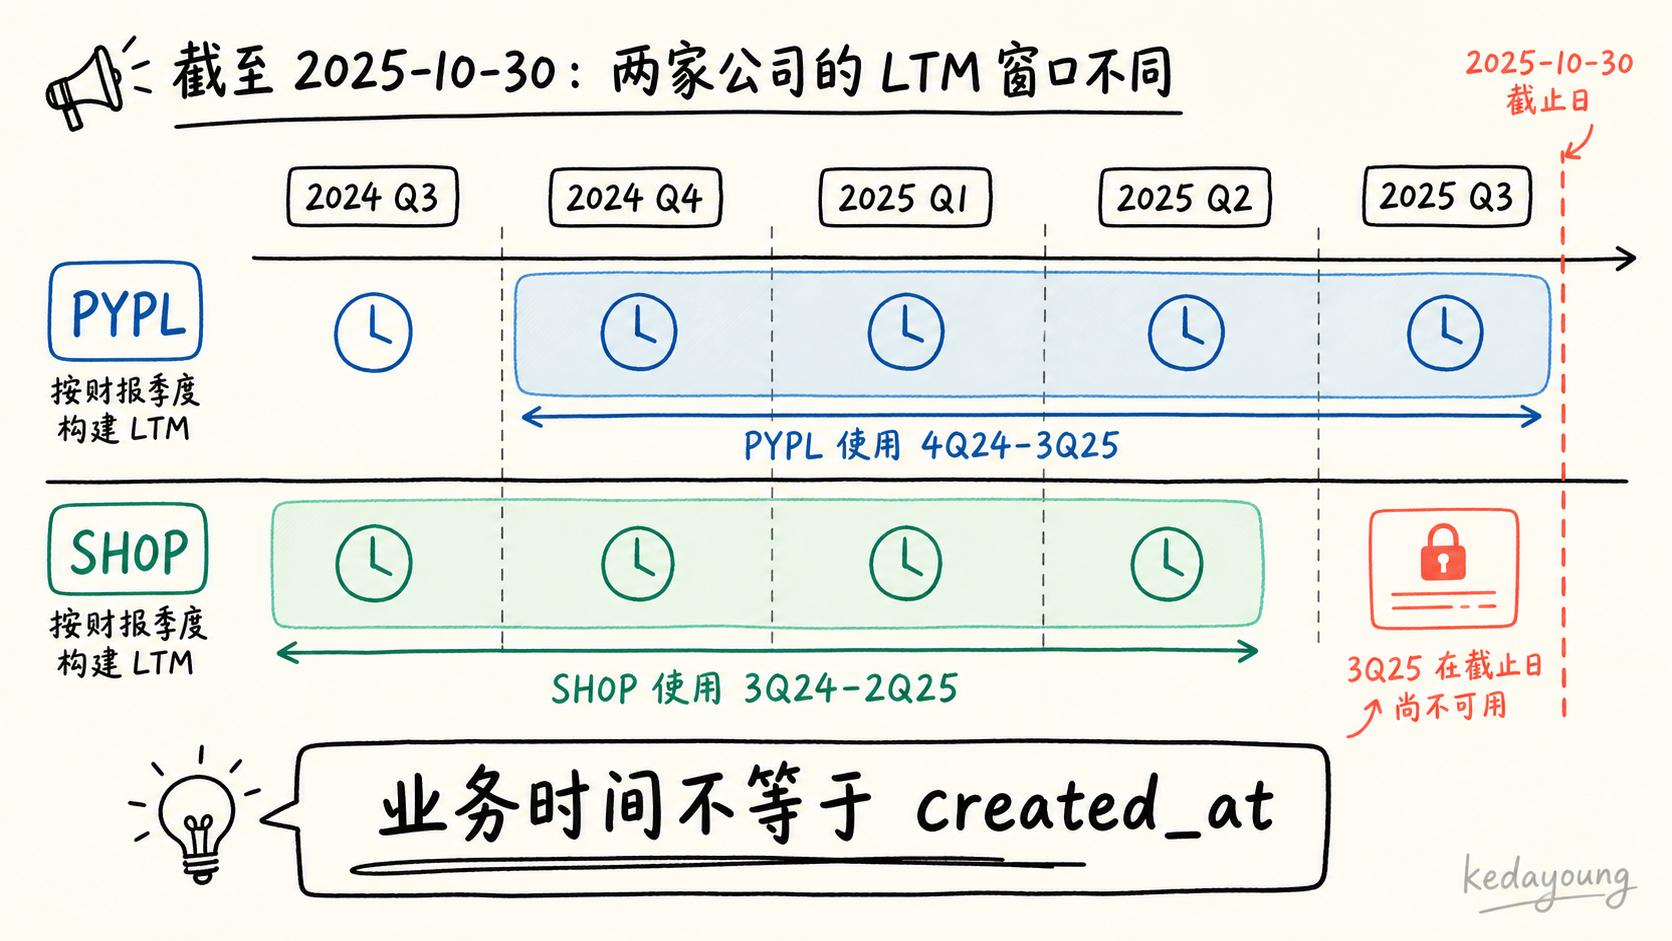
图 4|业务时间不是一个 created_at。 同一截止日期下,不同实体可用的最新期间不同。
在这个金融案例里,scope 不能只有 domain=finance 或 entity=PayPal。它至少要约束公司、指标定义、期间和截止日期;原始季度数据、标准化 LTM 组成、公式与最终比较也应属于不同证据层。下一次查询时,系统要判断是复用旧 derivation 回答旧时点问题,还是按新截止日期重新取证。
保守默认
每个可复用对象至少能回答来源、scope、业务时间和当前状态;不要用置信度代替权威,也不要让相似度越过 scope 和时间硬约束。
升级信号
出现 as-of 查询、关系变化、多实体共享或合规删除,再增加有效区间、关系边和更细权限。
4. 决定“何时能写”:写入门比数据库选型更重要
Memory 的风险通常不是从 search 开始,而是从一次过于宽松的 write 开始。错误内容只要取得了“可影响未来决策”的资格,就可能在之后被反复召回、摘要、合并,最终看起来越来越可信。
不同对象需要不同写入门。任务状态只有在状态迁移已经发生且 event 可回放时才写;稳定事实或偏好应由用户显式确认,或由工具与权威来源验证;派生结论必须保留来源、期间、定义、公式与计算;程序性经验则要等结果已经验证,并说明适用条件。一次任务结束,只能证明任务结束,不能统一证明其中所有内容值得长期保存。
| 对象 | 保守写入条件 | 常见错误 |
|---|---|---|
| 任务状态 | 状态迁移已发生,event 可回放 | 用自然语言摘要覆盖权威状态 |
| 稳定事实/偏好 | 用户显式确认或工具/权威源验证 | 把 Agent 推测写成用户事实 |
| 派生结论 | 来源、期间、定义、公式与计算可复核 | 只存最终答案 |
| 程序性经验 | 结果已验证,适用条件明确,可跨任务泛化 | 任务结束就把轨迹总结成“最佳实践” |
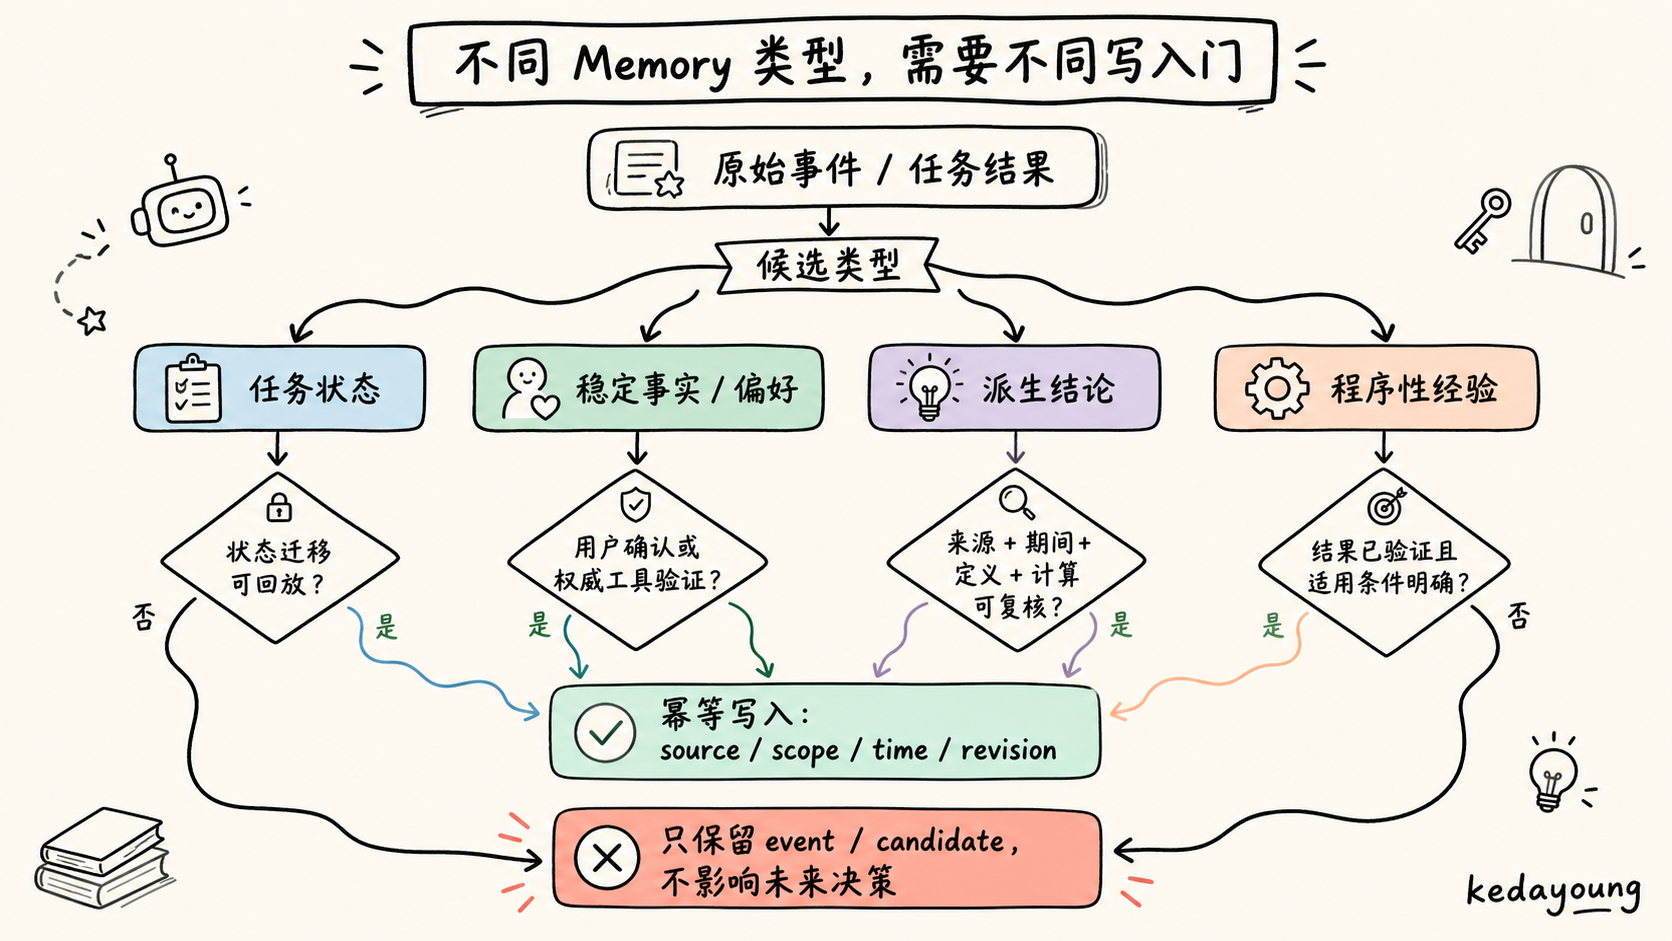
图 5|不同 Memory 类型需要不同写入门。 “任务结束”不是统一触发器,结果证据决定候选是否能影响未来。
写入路线本身也在分配风险。人工维护准确、可审计,但容易过期;显式 API 控制清晰,但调用方可能漏写;Agent 自编辑灵活,却增加误删、自我污染和并发覆盖;同步自动提取及时,却把延迟和提取错误放到主请求;异步 consolidation 降低前台延迟,又引入最终一致性、重试与 read-your-writes 问题。
垂直实践能更清楚地说明为什么不能使用统一触发器。四个项目都在“任务完成后保存经验”,但它们对“完成”的定义完全不同:
| 样本 | 先保留的候选 | 获得长期复用资格的证据 | 通过后写入什么 | 它防止的错误 |
|---|---|---|---|---|
| TradingAgents | pending 决策、标的与决策时间 | 持有期结束,实际收益与相对 SPY 的 alpha 已可计算 | 带 outcome 的 reflection;同标的可带完整决策,跨标的只带反思 | 在结果尚未兑现时把观点误判为成功经验 |
| EHRAgent | 当前问题的 Question/Knowledge/Solution 轨迹 | 答案被判定正确 | 后续可召回的 few-shot demonstration | 错误 EHR 查询或代码轨迹进入示例库后自我强化 |
| Voyager | 新任务生成的 JavaScript 技能与描述 | 环境任务完成且 critic 判定成功 | 可按新任务召回的可执行 skill | 把偶然成功、环境副作用或失败动作固化为程序性记忆 |
| UFO | screenshot/action/result/error 组成的短期 GUI trace | 成功检测通过,并由用户确认是否保存 | experience DB 中的任务摘要,供相似任务生成 plan | 视觉误判或不符合用户意图的轨迹被自动长期复用 |
这张对照表揭示的是四种证据形态:延迟产生的外部结果、可判定的正确答案、环境与 critic 的联合验证、以及成功检测后的人工确认。它们不是四档成熟度,也不能互相替换。金融交易无法在模型说“分析完成”时知道策略结果;GUI 自动化即使技术上执行成功,也可能仍不符合用户意图。write-gates
因此写入门不应写成统一的 on_task_end -> summarize -> save,而应是按 Memory 类型定义的资格谓词,例如 fact_verified、outcome_observed、environment_success 或 user_approved。样本只能证明这些路线在真实 Agent 中存在,不能证明某个门槛已经足以满足另一领域的生产安全要求。
无论选择哪条路线,都需要四个底层约束:
- 候选与事实分离:自动提取先生成带 evidence IDs 的 candidate,不把“模型提取到”直接等同于“事实成立”。
- 幂等写入:使用 source event ID、业务幂等键或内容 hash,防止断线重试制造重复 Memory。
- 阻断自激复制:区分原始用户/工具事件和已经注入的 Memory,避免 Agent 复述旧内容后,后台又把复述当作新证据。
- 并发有版本语义:多 worker 或多 Agent 编辑同一对象时,使用 revision、CAS、lease 或可审计合并,不让最后写入者静默覆盖。
金融数据“被搜到”不构成写入资格。公司、期间、定义、单位和来源通过校验后,中间值才可成为标准化事实;公式和计算可回放后,结果才可成为派生事实候选;“这套步骤有效”更不能由一道题证明,应在多道同类任务上验证后才成为 experience。
保守默认
显式写入优先,自动提炼先进入 candidate 层。
升级信号
人工维护量已经成为瓶颈,并且团队已有写入 precision/recall 测试集、回滚路径和成本预算,再把自动提炼接到长期对象的 active 路径。
5. 从真实查询选择存储与检索,而不是从产品名倒推需求
到了这一步,团队才真正需要讨论文件、SQL、全文索引、向量和图。但问题仍不应该是“哪一种更先进”,而是“固定查询集为什么被当前机制答错”。
已知 memory_id、用户和项目,要读取一个当前值,文件、KV 或 SQL 精确查询已经足够。要找错误码、路径、ticker 或专有名词,FTS/BM25 往往比纯向量更稳定。只有当真实用户经常用不同表述表达相同语义,embedding 才直接解决漏召回;当精确 token 和语义都重要时,再做 hybrid 与 rerank。图或时序结构的直接收益,则来自多跳关系、关系演化和 as-of 查询,而不是来自数据量大。
| 真实查询 | 首选机制 | 何时升级 | 它不负责解决什么 |
|---|---|---|---|
| 已知 ID/key/scope 的当前值 | 文件、KV、SQL | 数据规模、并发或历史版本需要 | 语义改写 |
| 错误码、路径、专有名词 | FTS/BM25 | 同时存在语义改写 | 权威、过期与权限 |
| 表述不同但语义接近 | embedding | 精确 token 同样重要 | scope、时间和权限 |
| 先找主题/场景再取证 | 层级索引/导航 | 自然层级和规模稳定出现 | 自动证明摘要正确 |
| 多跳关系、关系演化、as-of | 图/时序结构 | 固定查询集证明必要 | 写入消歧与运维成本 |
无论使用哪种索引,检索顺序都不应颠倒:先按实体、scope、权限、业务时间、状态和证据要求形成合法候选集;再在其中做 key、关键词、语义、新近度或重要性排序;然后做冲突、过期与重复检查;最后根据上下文预算裁剪。关键词或语义分数不能“救回”越权、过期、被撤回或没有必要证据的对象。
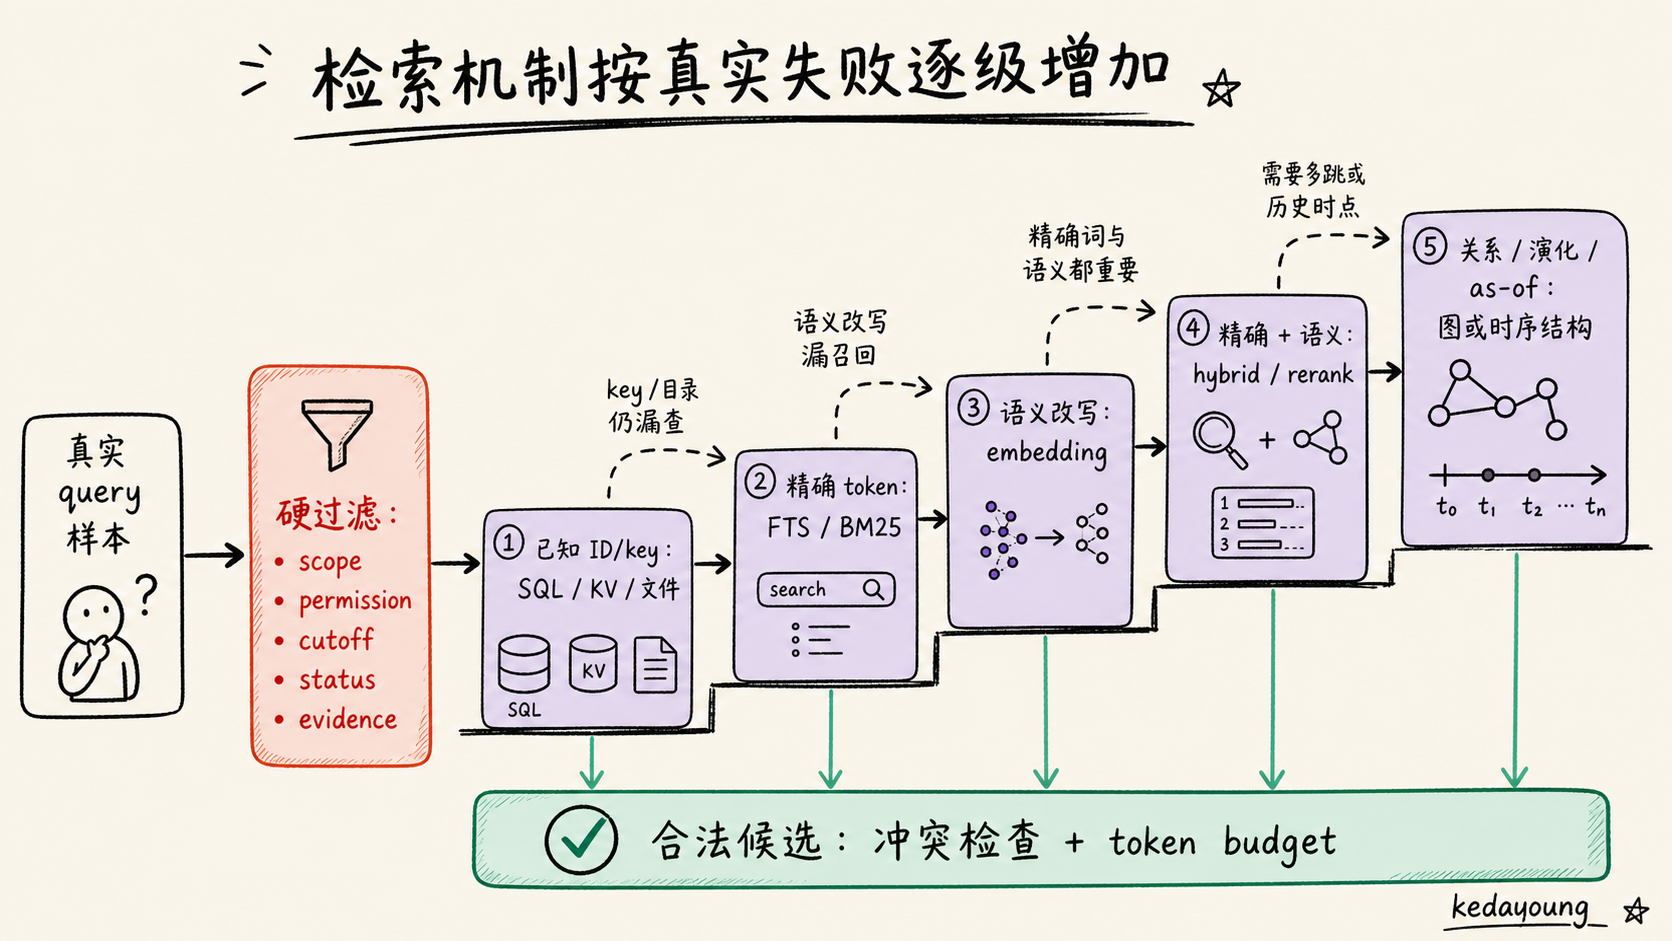
图 6|检索机制按真实失败逐级增加。 向量和图不是成熟度徽章,前一级满足固定查询集时就应停止升级。
样本也没有指向一个统一检索公式,因为“相关”在不同任务中并不是同一个目标。
FinMem 面对的是快速过期的股票信息。它不仅计算相似度,还结合 importance、recency、access counter 和后续反馈,让内容随时间衰减、清理并在短中长期层间迁移。这里的新近度不是通用排序技巧,而是在回答“旧市场信息是否仍可能影响当前标的”。反馈调整 importance 也不等于验证来源正确,它只改变一条记录在后续决策中的使用权重。
Generative Agents 的检索服务于 persona 的行为计划:同一 observation 对不同角色的 relevance、recency 与 importance 不同,reflection 还会从原始观察生成更高层 thought。该方案说明多信号排序可以表达角色认知,却不能直接作为企业事实检索公式,因为 persona 的“重要”不等于业务来源更权威。
CrewAI 作为通用框架,会让 LLM 推断 scope、category 和 importance,再把语义、新近度和重要性组合起来。它提供的是可配置的自动化路线,也把新的评测责任交给应用:scope 推错、importance 虚高或提取事实不忠实时,组合分数并不会自动修正这些上游错误。
MetaGPT 的 LongTermMemory 更接近角色消息的 novelty filter:现有源码表明,它用 FAISS 查找相似历史,帮助判断新的 observation 是否已经见过;这些证据不足以支持“它会把检索到的旧事实统一注入模型”这一更强结论。retrieval-practices
四条路线共同暴露的选择原则只有一条:排序信号必须对应真实查询目标。反馈与衰减、角色重要性、框架自动分类、历史去重分别解决不同问题,不能因为底层都出现 embedding,就把它们归纳成同一种“向量 Memory 架构”。
金融检索尤其不能压成一次全局相似搜索。FinAgentBench 用 3,429 个 S&P 100 专家标注样本,将 SEC 文档检索明确拆成两个阶段:先在 10-K、10-Q、8-K、Earnings、DEF 14A 等类型中选择文档,再在单文档内定位 chunk。它支持把“选哪类披露”和“找哪段证据”分开观测,却不能证明跨 session Memory 有效。finagentbench
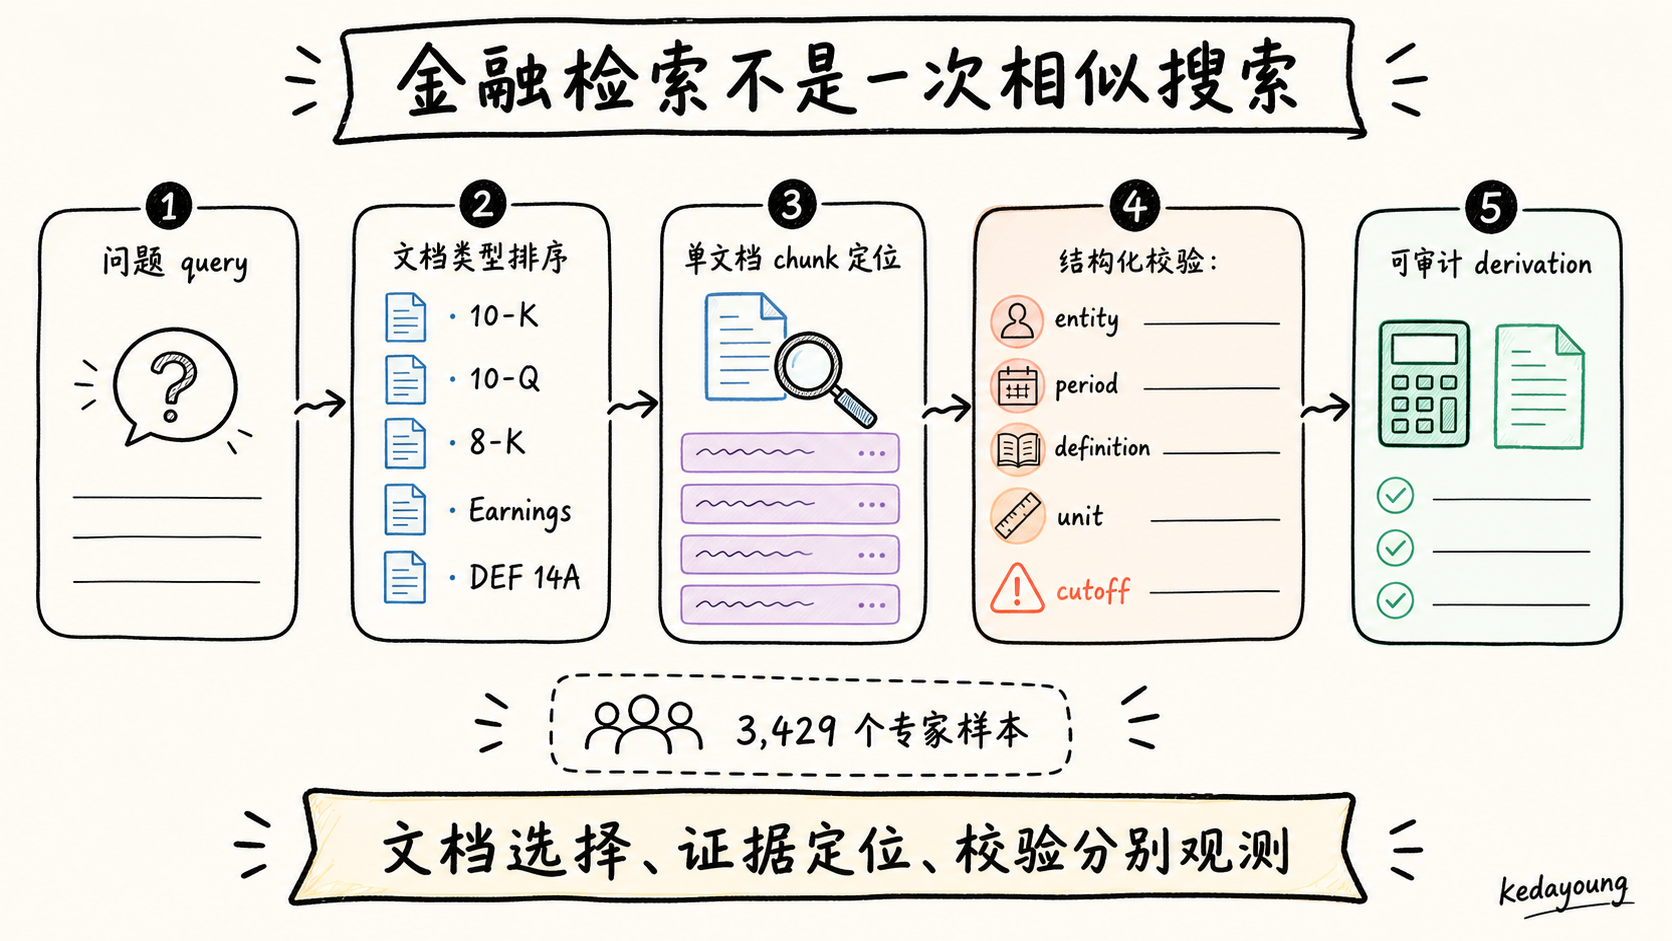
图 7|金融检索不是一次相似搜索。 文档选择、证据定位和结构化校验应分别观测。
对 PayPal/Shopify 任务,一个合理路径是先按公司、截止日期、文档类型和期间过滤,再定位具体段落。指标定义、季度值和 source ID 适合结构化精确查询,自然语言改写可以叠加 hybrid retrieval。单道题不需要时序图;只有大量 as-of、关系演化或 derivation traversal 查询稳定出现,图结构的复杂度才有直接回报。
保守默认
沿 key/scope -> SQL/FTS -> hybrid -> relation/time specialization 逐级增加能力,每一级都由真实查询失败驱动。
升级信号
固定查询集证明当前机制无法满足准确性、延迟、成本或治理要求。存储选型不是架构成熟度考试;停在最简单的达标层级,本身就是有效结果。
6. 检索到不等于记住:设计 Memory 如何进入上下文
许多 Memory 方案在“search 返回了 top-k”处结束,仿佛结果出现在后端日志里,模型就已经记住了。实际上,Memory 是否进入上下文、以什么结构进入、占多少 token、放在什么位置、是否保留冲突和来源,是一套独立决策。
最常见的注入方式各有适用面。全量常驻适合极少量、高权威、低变化的约束,代价是持续占用 token 和长期污染;最近窗口适合会话连续性,却无法在跨 session 历史中选择;checkpoint 和 summary 能恢复长任务,但可能丢精确值和证据;索引常驻、内容按需读取能稳定预算,却要求 Agent 主动下钻;查询后动态注入适合较大事实库,但增加检索时延和误召回;稳定前缀加动态尾部能兼顾 prompt cache 与相关性,却要求分区规则保持稳定。
四个框架把 Memory 注入暴露在不同接口位置,也由此暴露出不同失败面:
| 样本 | Memory 怎样进入模型可见区域 | 这一设计解决什么 | 仍需单独验证什么 |
|---|---|---|---|
| AutoGen | Memory 协议通过 update_context 修改 model context | 让“存储/查询”和“怎样呈现给模型”成为两个可替换步骤 | 多个 Memory 实现同时更新 context 时的顺序、去重和预算 |
| CAMEL | ContextCreator 在 token limit 内从 chat/vector blocks 选择内容 | 在统一预算下组合最近历史和语义结果 | 截断是否保留关键来源、冲突和精确值 |
| Mastra | history、working memory、semantic recall、observational memory 分别进入 “What the model sees” 的不同位置 | 让不同对象拥有不同注入职责,而不是拼成一个长字符串 | 多路 Memory 叠加后的重复、位置效应和总 token 成本 |
| AgentScope | 有界 MEMORY.md 索引常驻 system prompt,相关 topic 文件再按需注入 | 用渐进披露控制大型文件 Memory 的常驻成本 | Agent 是否会下钻、选错 topic,以及异步加载是否赶得上当前决策 |
四个接口都把 context injection 暴露为独立步骤,而不是 search 的副作用。它们并未共同证明某一种消息角色、top-k 或 token 比例最佳;恰恰相反,每种接口都要求项目记录最终 context snapshot,才能知道正确 Memory 是否真的以可用形式到达模型。context-injection
保守做法是把常驻区缩到极少量稳定约束,动态对象通过独立 Memory block 或工具结果注入。高风险结论必须带 source pointer、业务时间、状态和下钻入口。先确定 Memory token budget,再决定 top-k;预算不足时优先保留关键事实、冲突和来源,不要对所有候选平均截断。
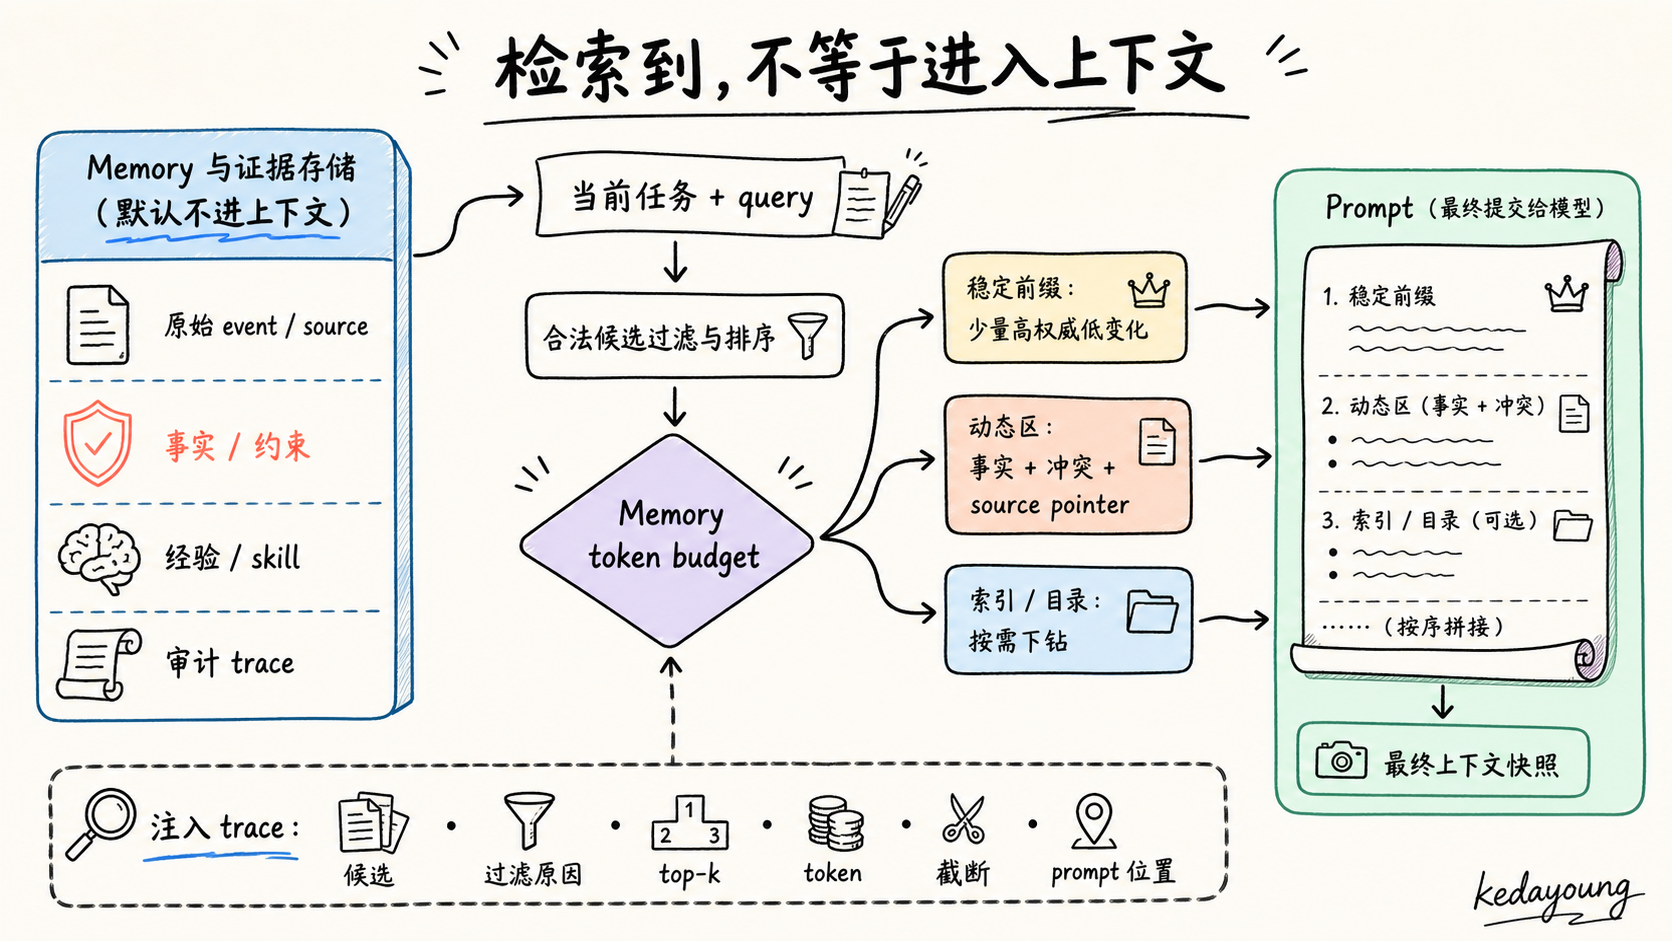
图 8|Memory 存在于存储中,不等于进入上下文。 build_context 需要独立预算、呈现策略和注入 trace。
注入链应记录:初始候选数、硬过滤原因、各排序信号、最终 top-k、注入 token、截断、来源覆盖、prompt 位置,以及模型是否实际引用或使用。否则一次错误发生后,团队无法区分“没有保存”“没有搜到”“搜到但被过滤”“注入时被截断”和“模型看到了却用错”。
Lost in the Middle 说明,相关信息即使位于长上下文中,也会因位置不同而被不同程度地利用。它不能指定某种消息角色是通用最佳,却足以推翻“窗口足够长就等于信息可用”的假设。lost-middle
金融案例中,注入对象不应只有 $0.79/$0.88,而应是本轮需要的公司、期间、定义、标准化值、公式和 source pointers。两家公司的数据要以可比较的结构并排呈现,同时明确各自 LTM 窗口不同。这样,模型面对的是可检查的证据包,而不是一段已经把差异压平的总结。
保守默认
使用少量稳定前缀和有预算的结构化动态注入,并保留最终注入快照。
升级信号
固定任务显示 Agent 经常忘记主动搜索,再增加自动 retrieval;常驻区频繁变化、破坏 cache 或污染推理,再调整稳定与动态分区。
7. 记忆会变错:修订、冲突、遗忘和退出
一个只会 add 和 search 的 Memory 还没有生命周期。用户会修改偏好,文档会重述,任务会结束,授权会撤销,来源会被删除。新信息出现时,系统必须知道它是在追加事件、替代当前值、声明旧结论失效,还是与另一个来源并存冲突。
| 语义 | 操作 | 典型场景 |
|---|---|---|
| 只关心当前值 | 新版本 + 当前指针 | 用户当前偏好 |
| 需要完整事件历史 | append-only | task trace、审计日志 |
| 需要回答“当时是什么” | 有效区间或失效事件 | 地址、组织关系、财务期间 |
| 多来源共同支持 | merge + source set | 标准化事实 |
| 权威不明或定义不同 | conflict set + 降级 | 冲突披露、指标口径 |
| 临时状态自然退出 | TTL/expiry | 授权、临时任务偏好 |
| 用户或策略要求遗忘 | tombstone + lineage 级联 | 隐私删除 |
更新不能只靠语义相似度。“我住在北京”和“我已经搬到上海”很相似,但关系是替代;两份报告中的 “revenue” 也可能因为定义不同而只能并存。更新至少要结合实体、属性、时间、否定或变化语义、来源权威。无法判断时,保留 conflict set 并询问,比自动覆盖更可信。
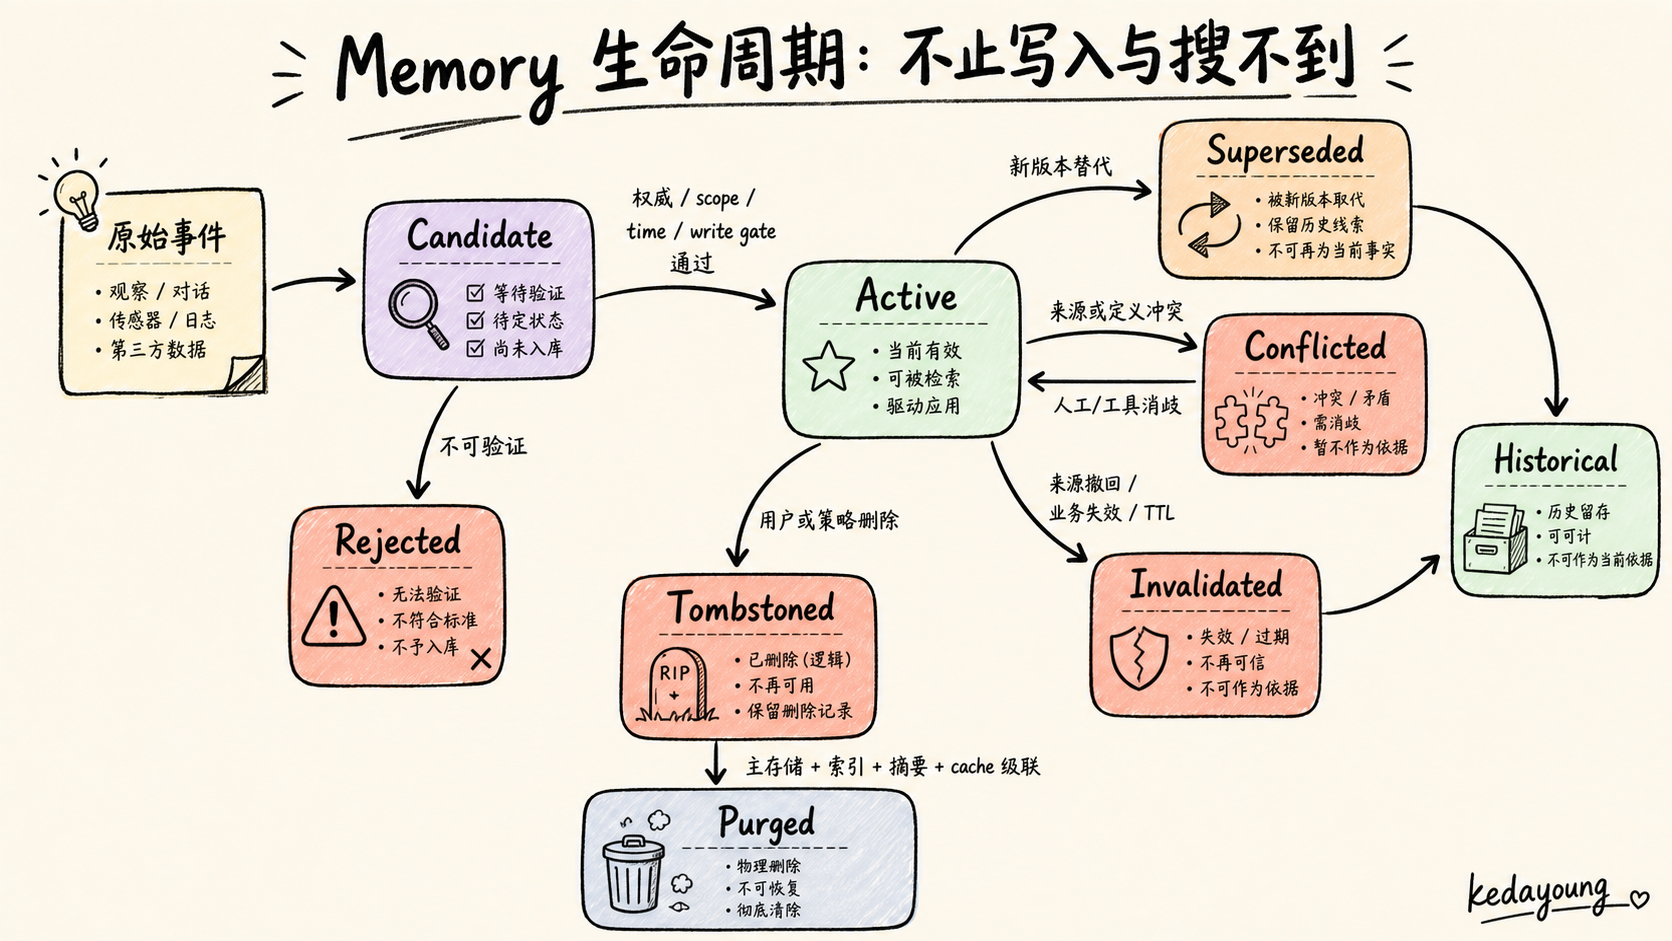
图 9|Memory 生命周期不是“写入/搜不到”两种状态。 替代、冲突、失效、历史保留与级联删除需要不同语义。
删除也不是“向量检索不返回”。一条原始事件可能已经派生出事实、profile、summary、embedding 和 graph edge,还可能进入 prompt cache 或正在执行的 context。没有 lineage,系统既找不到需要失效的派生物,也无法在源数据修正后重新提炼。多 Agent 共同修订时,还要保留 revision、写入者和并发语义。
四个项目都提供了治理入口,却分别处理不同含义的“遗忘”。
Qwen Code 把 pin、forget、Dream 整理和 secret scan 放到同一套用户/项目 Memory 路径中。pin 保护显式重要内容,forget 提供退出入口,Dream 负责后台整理,secret scan 则在写入前限制敏感内容。它说明自动提炼如果没有用户可见的控制面,错误很难被发现和撤销。
nanobot 把 SOUL.md、USER.md 和 MEMORY.md 纳入 Git 版本。文件 diff 能帮助审计“这次 Dream 改了什么”,也提供回滚基础,但 Git 本身不会判断两次并发更新应如何合并,更不会替应用完成权限隔离。
FinMem 通过反馈修改 importance,并让记录衰减、清理和在时间层级间迁移。它解决的是信息使用价值随市场变化而下降,不等于原始事件从历史中消失,也不能用低 importance 代替来源撤回或隐私删除。
AutoGPT 的 Graphiti 路线在 Memory envelope 中保留 source、scope、status 和 provenance,再由 Dream 子系统处理 ratification、staleness、demotion 与 invalidation。这适合需要时序变化和来源追踪的对象,但也意味着后台任务、状态机和派生关系都进入运维范围。revision-practices
放在一起看,“退出”至少包含四种不同动作:用户主动忘记、版本回滚、相关性衰减、来源或事实失效。它们不能被统一实现成“从向量索引删一条记录”;项目必须先说明退出的业务语义,再决定主记录、派生物、索引和 cache 各自怎样响应。
FinPerMA 进一步提醒:摘要可能保留显式事实,却在外部冲击后丢失更细的偏好变化。因此动态状态不能只剩一个不可追溯 summary;原始事件、当前结构化状态与派生摘要至少要在职责上分开。finperma
金融数据同样不能把“新季度发布”理解为覆盖旧季度。旧值对旧截止日仍然有效;真正需要变更的是当前可用窗口和派生结论。财报重述、指标定义变化或来源撤回时,要使受影响的 derivation 失效,并沿 source lineage 找到所有结果。新截止日期下的查询则重新判断当时可得材料,而不是把旧 LTM 数字当当前值。
保守默认
保留 append-only 证据,并为派生对象提供显式版本、状态和 lineage;修订、失效和删除语义从第一版就存在。
升级信号
真实业务需要历史时点、复杂关系变化或多来源合并,再扩展更完整的时序结构。
8. 先评测再升级:证明 Memory 改善了任务,而不是只让系统更复杂
案例来自公开材料,而不是已上线金融 Agent 的生产复盘,因此这里不声称“准确率提升 20%”或“研究时间下降一半”。可验证的结果应是一套判断 Memory 是否值得引入的协议。
第一步是固定任务、模型、工具、数据截止时间和随机性设置,然后逐级消融:无 Memory;只有 session/event 和 checkpoint;少量显式稳定事实或经验;结构化精确检索/FTS;hybrid retrieval;自动提炼;最后才是有真实关系或时间查询支撑的专用机制。每增加一层,都同时报告任务收益、新增错误和总成本。前一层达到验收,就停止升级。
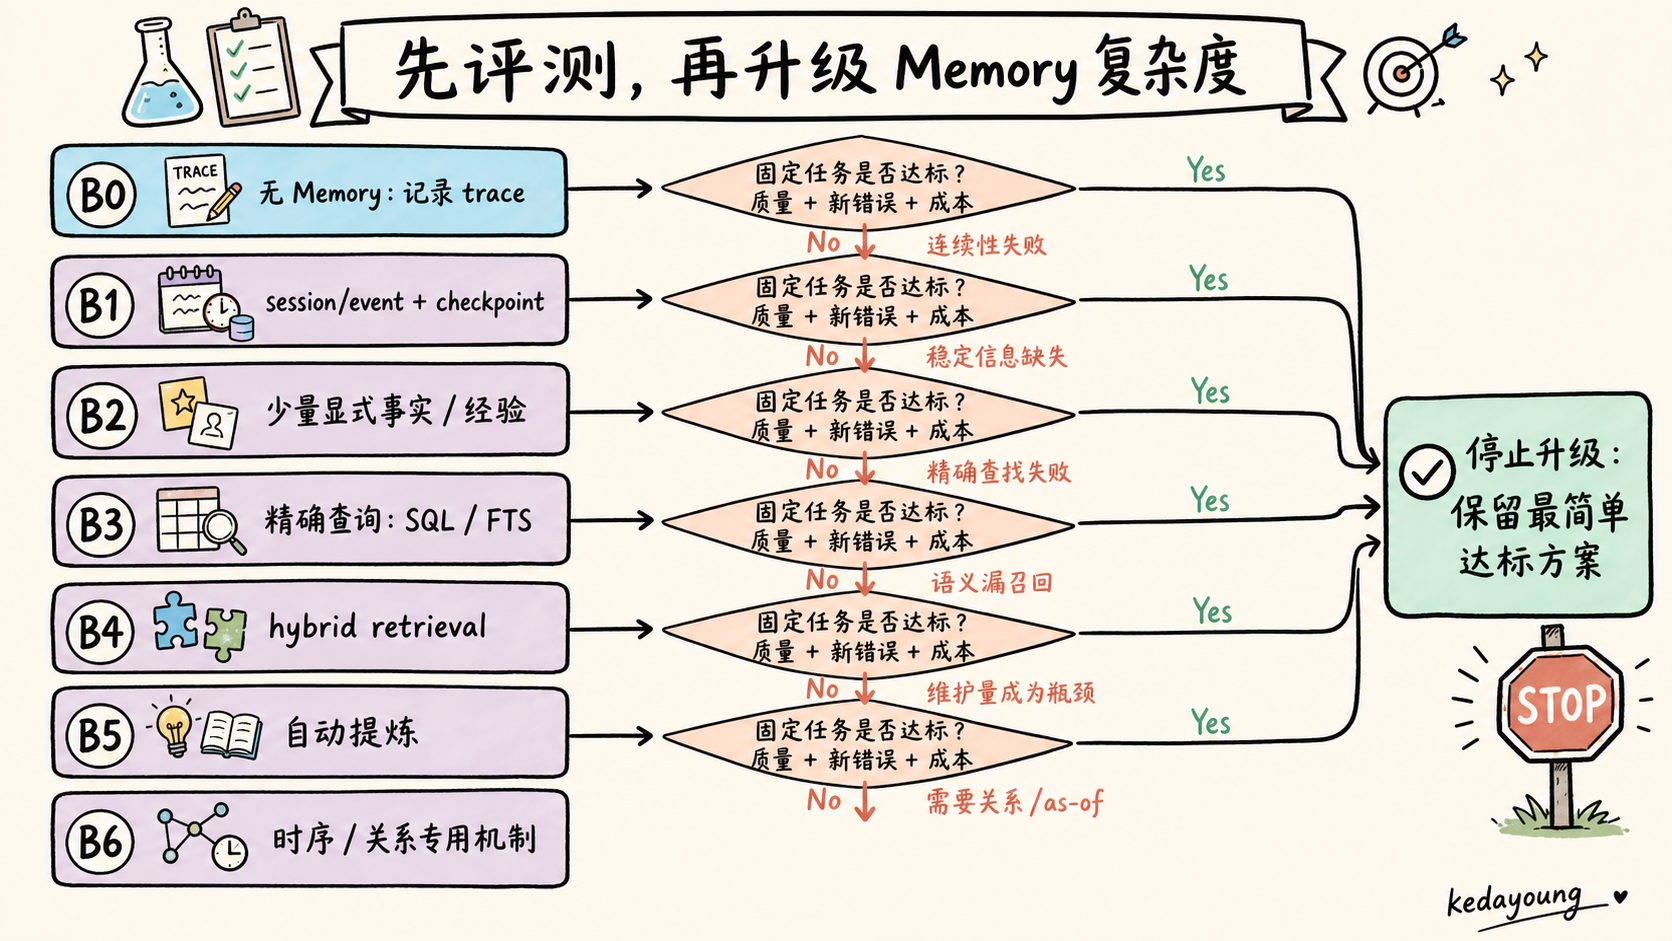
图 10|复杂度由消融失败驱动。 每一级都回到同一固定任务,前一级达标就停止。
评测不能只看最终回答,也不能只看 recall@k。至少拆成四层:
- 写入层:该不该记,是否忠于来源,type/scope/time 是否正确,重复与冲突是否被处理。
- 检索层:目标是否进入合法候选,跨 scope、过期、越权和已失效内容是否被排除。
- 上下文与使用层:注入是否在预算内,来源是否完整,关键项是否被截断,Agent 是否正确使用或在证据不足时拒答。
- 任务与治理层:端到端结果、memory-caused error、权限隔离、删除、投毒、并发和故障恢复。
| 维度 | 建议记录的指标 |
|---|---|
| 任务 | end-to-end success、grounded answer、abstention accuracy |
| 写入 | false positive/false negative、unsupported memory、duplicate、scope/time error |
| 检索 | legal-candidate recall/precision、stale retrieval、scope leakage |
| 使用 | correct-use rate、memory-caused error、冲突处理结果 |
| 上下文 | memory tokens/turn、来源覆盖、截断率、prompt cache hit rate |
| 成本 | 写入/检索 p50/p95、存储、LLM/embedding 调用、每个合格任务成本 |
| 治理 | 删除完成时延、权限泄漏、poisoning、积压、重复消费、并发冲突 |
具体阈值必须标作 [待验证],由项目的错误损失函数和现有基线决定。医疗 patient scope 泄漏可能是零容忍项,低风险个人助手中的语义漏召回则可能允许重试;不存在一套通用的“95% 即上线”标准。
最小反例集至少应包括:两个用户或项目说过相似但不同的事实;同一事实被后续修正;从未提供的信息必须拒答;明确历史时点;精确错误码与语义改写各一组;来源撤回或删除;已注入 Memory 被回答复述但不得自激再写;后台写入失败、重试、重复事件和并发更新;恶意来源尝试污染未来检索。
AgentPoison 已在 Agent-Driver、ReAct 和 EHRAgent 的 memory/knowledge-base 检索链展示定向投毒风险。这不能给出充分的生产防护方案,却足以说明:Memory 是输入供应链和权限边界的一部分,benign utility 指标正常也不能代替 poisoning 测试。agentpoison
对金融案例,可以用 BigFinanceBench 的 rubric 检查 source、period、definition、assumption、adjustment 和 calculation,而不只比较最后两个数字。对照组分别使用无 Memory、仅 checkpoint、复用带来源中间事实、复用程序性经验,观察哪些步骤减少重复,哪些引入 stale、错 scope 或前视泄漏。
公共 benchmark 的总分还会掩盖一件事:不同 Memory 对象需要绑定不同形态的结果证据。
- AI Scientist 为每轮实验保存代码副本与
final_info.json,并把真实执行结果返回给 coder 决定是否重规划;notes.txt只是后续绘图和论文写作的交接,不应覆盖原始数值。 - Agent Laboratory 把文献、research plan、实验代码、结果和 insights 作为阶段对象传递,并约束论文阶段只报告实际日志中的结果。这里要验收的是 artifact contract 是否完整,而不只是最终论文看起来是否合理。
- Cradle 同时保存 screenshot、action、result、error、success detection 和 reflection。GUI/game 任务若只评文本答案,就无法判断经验是否遗漏了视觉前置状态或把错误动作当成成功。
- PyRIT 的 CentralMemory 保留 conversation、prompt、转换、score、attack/scenario result 和标识符。它把 Memory 当作红队实验账本,因此评测还要检查同一攻击链是否可回放、评分是否能追溯到具体输入输出。evaluation-practices
因此,“经验必须绑定可验证结果”并不意味着所有对象共享一个成功指标。实验运行、阶段制品、多模态环境状态和攻击评分不能被压成一个 success=true;项目的评测协议必须与写入对象保持同样的结构粒度。
LongMemEval 可以补充跨 session 信息提取、时间推理、知识更新和拒答,MemoryAgentBench 可以补充准确检索、test-time learning、长程理解与选择性遗忘;但公共 benchmark 只能覆盖能力维度,不能代替项目自己的查询分布、权限模型和失败成本。memory-benchmarks
保守默认
用同一任务集逐层消融,同时记录收益、新错误和成本。
停止条件
前一层已经满足验收要求。最简单的达标方案,就是当前正确的选型。
9. 把八个问题串成一条读写闭环
八个问题不是一次性架构评审表,而是一条持续运行的治理闭环。失败决定对象,对象决定写入门与身份边界;合法对象进入检索与上下文;使用结果反过来产生修订、退出和下一轮评测证据。数据库只承载其中一段,框架只实现其中若干接口。
| 决策问题 | 必须输入的证据 | 保守默认 | 升级信号 | 产生的实现约束 |
|---|---|---|---|---|
| 是否需要 | 可复现失败、未来决策 | 无长期 Memory + trace | 加入特定过去信息能改善任务 | baseline、评测用例 |
| 记什么 | 未来 query、错误损失 | event 与派生对象分层 | 当前粒度无法回答 | type/payload/source |
| 谁能写 | 权威和验证方式 | 显式/规则写入 | 维护量超标且有写入评测 | writer、gate、status |
| 属于谁、何时有效 | scope、业务时间、权限 | 硬隔离 + 当前状态 | as-of、共享、关系查询 | scope、time、version |
| 怎样找 | 固定 query 样本 | key/SQL/FTS | 语义漏召回或关系查询 | index、filter、rank |
| 怎样注入 | token/时延预算 | 少量结构化动态注入 | 主动搜索遗漏或预算冲突 | context builder、trace |
| 怎样纠错退出 | 变化与删除语义 | 版本/失效 + lineage | 历史点、级联删除 | revision、tombstone |
| 是否升级 | 消融结果与成本 | 达标即停止 | 固定失败仍未解决 | eval、version plan |
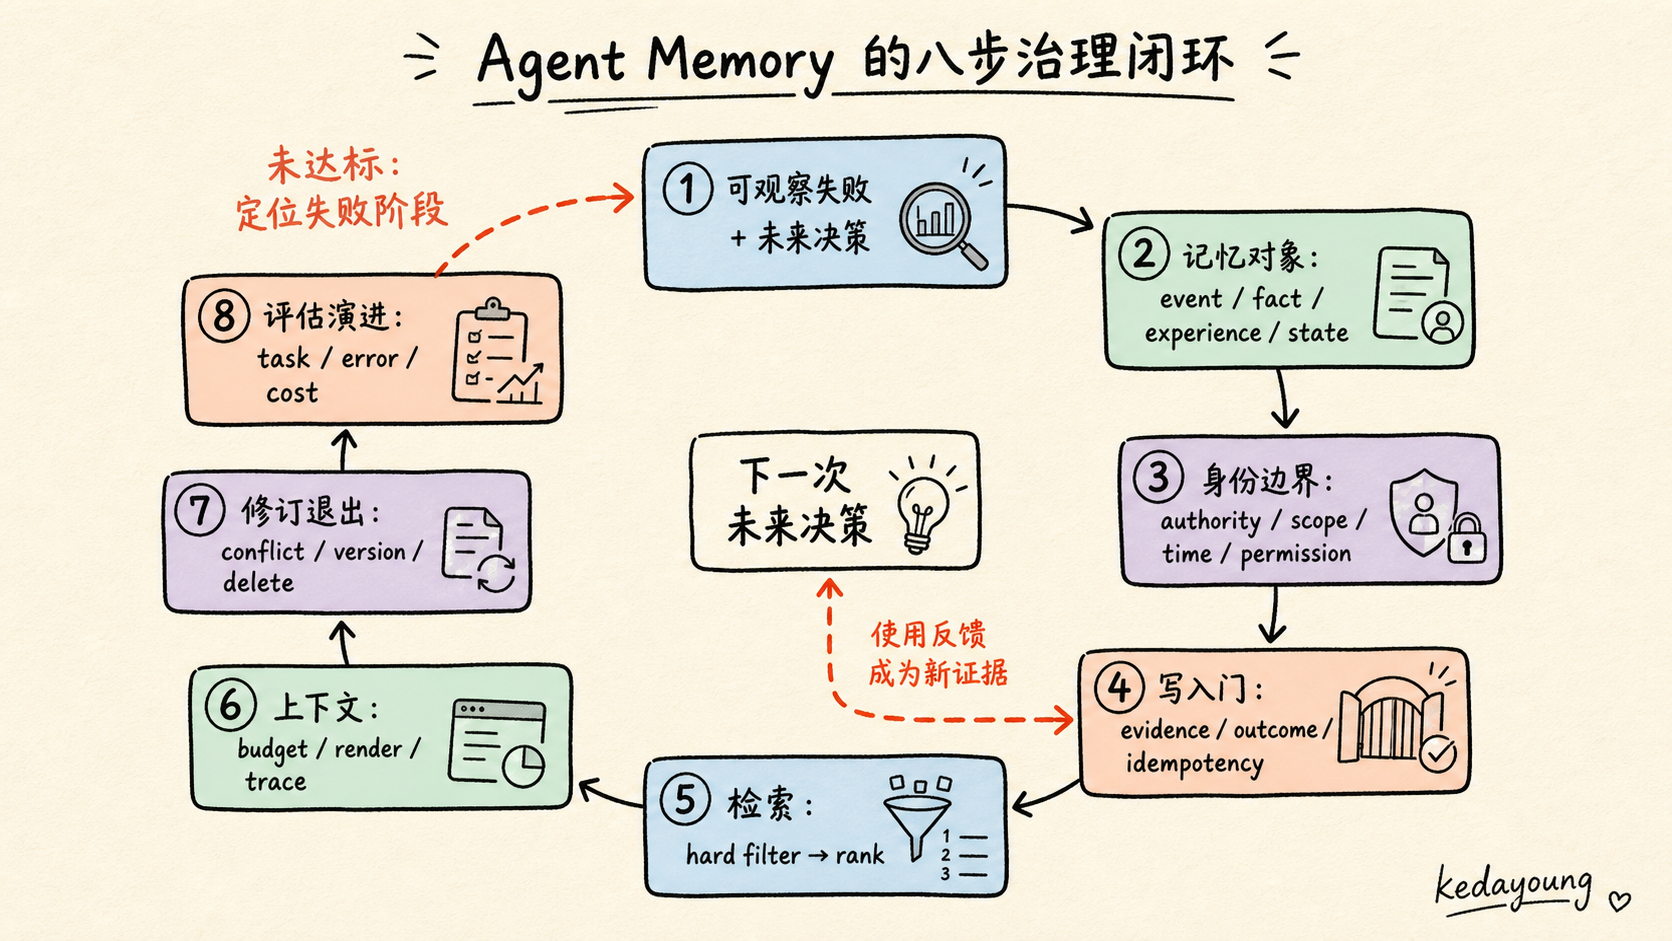
图 11|Agent Memory 的完整治理闭环。 任一阶段缺失,都可能让正确的过去以错误方式影响未来。
落到代码时,可以先把责任边界写成三段伪代码,而不是立即绑定某个 SDK:
write_memory(event, policy):
  candidate = policy.extract(event)
  if candidate is empty:
    return keep_event_only(event)

  assert candidate.source_refs include event.id
  assert candidate.type matches policy.write_gate
  verify authority, scope, permission, effective_time
  verify outcome when candidate.type is experience

  if any verification fails:
    return save_candidate_for_review(candidate)

  key = idempotency_key(event.id, candidate.type, candidate.scope)
  return append_revision(key, candidate, lineage=event.id)

search_memory(query, runtime_context):
  legal = hard_filter(
    scope=runtime_context.scope,
    permission=runtime_context.permission,
    cutoff=query.cutoff,
    status=active,
    evidence_required=query.risk_level
  )
  ranked = retrieve_and_rank(query, legal)
  return dedupe_mark_conflicts_and_explain(ranked)

build_context(task, memories, token_budget):
  selected = choose_by_decision_relevance(memories)
  preserve(selected, fields=[source, effective_time, status, conflict])
  rendered = render_with_budget(selected, token_budget)
  record_injection_trace(task.id, memories, selected, rendered)
return stable_prefix(task) + rendered这里有三个不可交换的顺序。write_memory 先提取候选,再验证资格,不能把提取当写入;search_memory 先形成合法候选集,再排序,不能让相似度决定权限;build_context 重新根据决策相关性和 token budget 选择,不能把 top-k 原文直接拼接。
对应的实施路径也很朴素:
无 Memory 基线 → append-only session/checkpoint → 少量显式稳定信息 → 精确 query/scope filter → 有评测后再自动提炼 → 真实查询证明必要后再上 hybrid、时序或关系机制。
这条路径并不假设所有项目最终都会走到最后。停在 session、文件或 SQL,可能正是正确结果。
10. Schema 是决策结果:从字段回看它解决了什么问题
八个决策完成后,Schema 才有推导依据。它不是文章的前置假设,不是通用行业标准,也不是一套已经设计完成的金融 Agent 数据模型。每个字段都必须能回溯到前文的查询、写入门、边界、修订或评测需求。
一个不绑定数据库的最小元数据骨架可以从下面开始:
memory_id: ...
memory_type: fact | experience | task_state
scope: {...}
payload: {...}
source_refs: [...]
effective_time: {...}
status: candidate | active | superseded | invalidated | conflicted
revision: ...
recorded_at: ...
如果 candidate 使用独立审核队列,主表的 status 可以不包含它。embedding、图边、importance、confidence、TTL 和 permission tags 也都不是无条件必选项;只有实际查询、风险或生命周期决策需要时才扩展。
| 字段组 | 来自哪项设计决策 | 缺失后的失败 |
|---|---|---|
memory_id/revision | 幂等、修订、并发 | 重复写,无法定向纠错或检测覆盖 |
memory_type | 事实、经验、任务状态使用不同写入门和注入方式 | 用同一生命周期处理所有对象 |
scope | 身份、领域实体、权限硬过滤 | 跨用户、项目或实体串记 |
payload | 未来 query 所需的最小内容 | 只存一段无法稳定查询的摘要 |
source_refs | 权威、溯源、删除 lineage | 无法验证、撤回或重建 |
effective_time/recorded_at | 业务时间与写入时间分离 | 旧事实当当前值,或发生前视泄漏 |
status | 候选、冲突、替代、失效和退出 | 过期内容继续影响未来决策 |
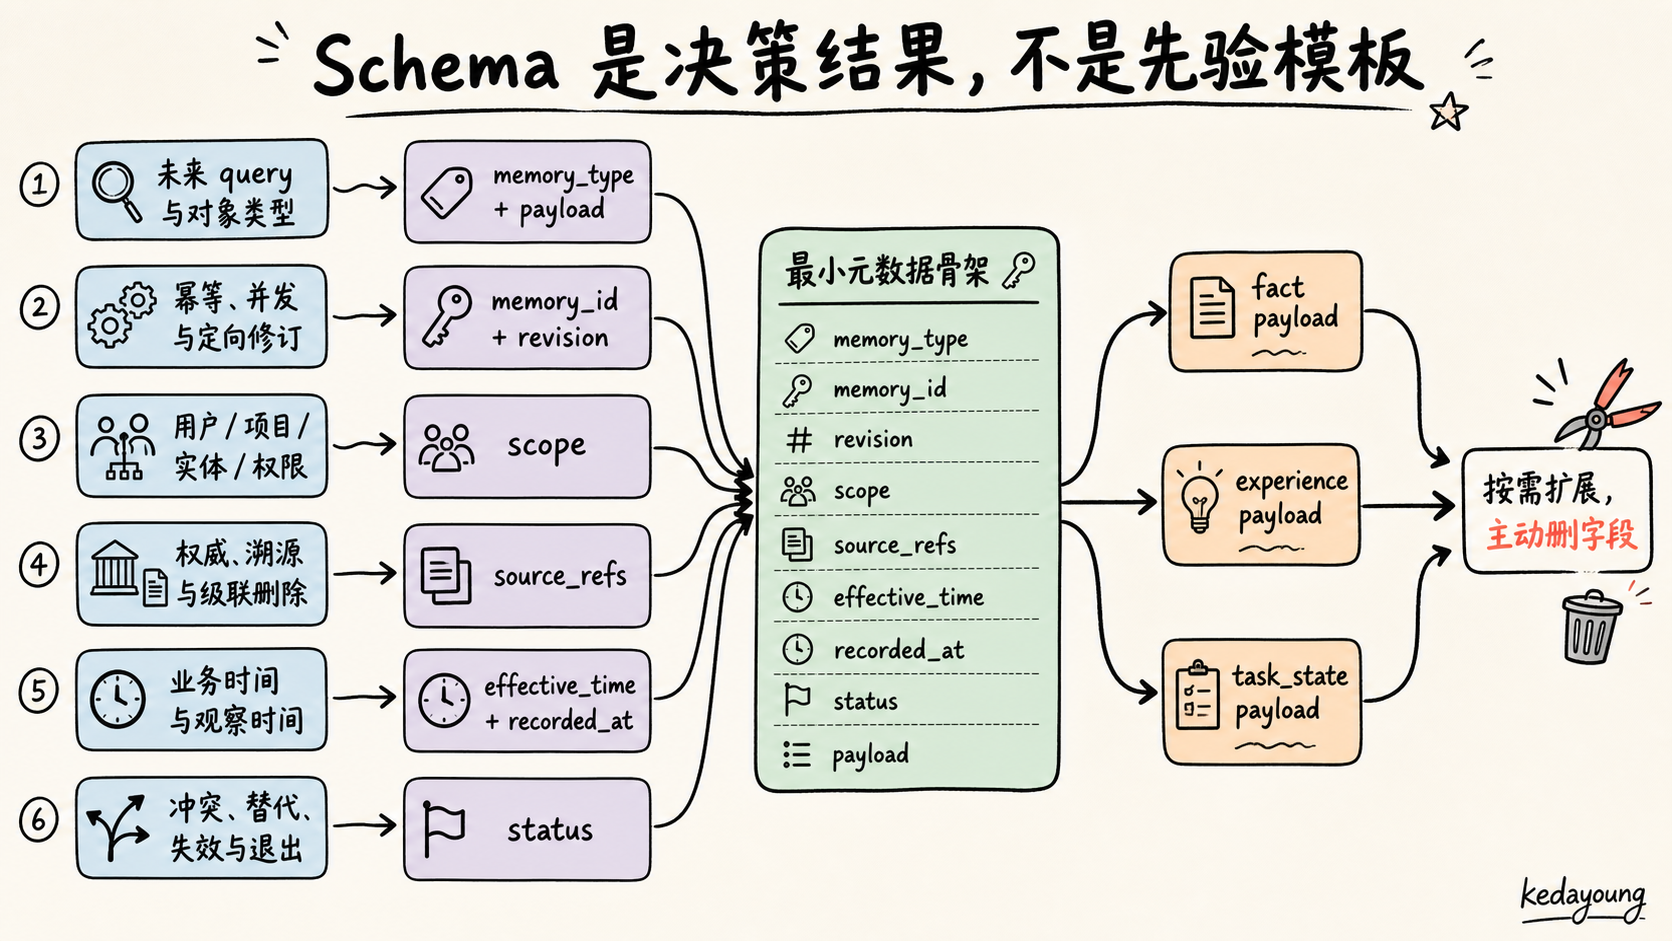
图 12|Schema 由设计问题推导,而不是先验模板。 字段要能解释自己解决了什么,类型按需扩展,最后还要主动删减。
三类 payload 怎样扩展
事实类需要回答实体、属性、值、单位和定义;需要当前/历史查询时,再增加有效区间与 supersedes。经验类需要 trigger、preconditions、procedure、outcome 和 validation evidence;没有结果门,就不能标为 active。任务状态需要 goal、checkpoint、open items 和 artifact refs,通常跟 task/thread 生命周期走,不应自动升级成用户长期事实。
# fact payload
entity: {type: company, id: PYPL}
attribute: retained_revenue_per_100_tpv
value: 0.79
unit: USD_per_100_USD
definition: (transaction_revenue - transaction_expense) / TPV * 100

# experience payload
trigger: compare_LTM_metrics_across_companies
preconditions: [point_in_time_cutoff_is_explicit]
procedure: [resolve_latest_available_quarter_per_entity, build_each_LTM_window]
outcome: {...}
validation_evidence: [...]

# task_state payload
goal: compare_PYPL_SHOP_retained_revenue
checkpoint: source_and_period_validation
open_items: [verify_SHOP_quarterly_source]
artifact_refs: [...]
这三类扩展不是一个大而全的联合表:如果对象的写入门、查询方式和生命周期不同,就不要为了“统一”而把所有字段塞进同一个自然语言 content。
用金融案例填写一条记录
下面这条 [案例决策] 只用于展示字段为什么存在。公开 BigFinanceBench 行给出了结果、公式步骤和数值 rubric;由于实际 SEC filing accession 尚未逐一复核,记录保持 candidate,不能作为已上线系统中的权威 active fact。
memory_id: fact:bf-b0926059cd:PYPL:retained-per-100:2025-10-30
memory_type: fact
scope:
  domain: financial_research
  task_id: bf-b0926059cd
  entity: {type: company, ticker: PYPL}
  metric: retained_processing_revenue_per_100_tpv
  cutoff: 2025-10-30
payload:
  period: {from: 2024-Q4, to: 2025-Q3, basis: LTM}
  transaction_volume_usd_m: 1756679
  transaction_revenue_usd_m: 29567
  transaction_expense_usd_m: 15732
  net_processing_revenue_usd_m: 13835
  formula: (transaction_revenue - transaction_expense) / transaction_volume * 100
  value: 0.79
  unit: USD_per_100_USD
source_refs:
  - kind: benchmark_rubric
    uri: https://huggingface.co/datasets/RogoAI/big-finance-benchmark
    row_id: bf-b0926059cd
  - kind: filing_manifest
    required_periods: [2024-Q4, 2025-Q1, 2025-Q2, 2025-Q3]
    accession_urls: []  # 原始申报文件待逐项复核
effective_time:
  as_of: 2025-10-30
  information_available_by: 2025-10-30
status: candidate
revision: 1
recorded_at: <write-time>
如果生产需求只允许有原始 filing 证据的派生事实进入未来决策,那么 accession_urls 为空就应触发写入门失败。这个例子也说明,Schema 不能替系统做决定:字段只能承载已经明确的资格规则。
最后,按自己的决策结果删字段:
如果一个字段无法对应真实查询、写入门、边界、修订或评测需求,就先删除;如果一个必要决策没有字段或外部机制承载,再补回来。
只做单任务 checkpoint,可能不需要 profile、embedding、importance 或关系字段;只保留当前显式偏好,也可能只需 key、scope、source 和 revision,不需要时序图。最小 Schema 的价值不在“字段少”,而在每个留下的字段都有可验证的职责。
结语:先定义过去进入未来的资格,再选择技术
回到 PayPal 与 Shopify 的问题,重要的不是让 Agent 永久记住 $0.79 和 $0.88。重要的是让它知道:哪些来源在截止日期前可用,两个实体各自对应什么期间,指标采用什么定义,计算如何复核,旧结论在什么查询下仍有效,以及哪一条过程经验经过验证后可以跨任务复用。
这也是 Agent Memory 与普通“保存历史”的分界。保存让过去仍然存在;Memory 设计决定过去何时有资格重新影响未来。资格制度越宽松,Agent 越容易把旧推断、错误轨迹和越权信息带进新任务;资格制度越复杂,系统的写入、检索、上下文、治理和成本责任也越重。
一个新项目可以从五个动作开始:
- 选择一个可复现失败,以及一个希望改善的未来决策。
- 明确哪类过去信息可能改变这次决策。
- 用最简单的机制做受控消融。
- 只有评测证明当前机制不足时,才增加复杂度。
- 让 Schema 记录已经做出的决策,而不是替团队做决策。
Memory 设计的成熟度,不在于 Agent 保存了多少过去,而在于团队能否解释:为什么这一条过去,此刻有资格进入未来。
附录 A:46 个实践样本矩阵
这 46 个项目采用分层目的抽样,而不是统计学随机样本。32 个通用样本用于观察公共实现路线,14 个垂直样本用于检查领域对象、反馈和风险如何改变设计。正文用其中的最小证据集合解释“为什么做出这一选择”,本附录只负责保留覆盖面与核验入口,不再从项目数量推出新的架构结论。
GitHub stars 只在 2026 年 8 月 13 日快照中作为公开采用度与初筛条件:通用样本均超过 1,000 stars;垂直样本优先沿用这一条件,但保留 FinMem、EHRAgent、AI Hospital 三个能补足关键领域机制的例外。纳入不代表方案已经满足生产、医疗、投资或攻防安全要求。
A.1 通用基础样本:32 个
| 类别 | 项目 | Memory 定位与读写闭环 | 可支持的设计判断 |
|---|---|---|---|
| Coding | OpenCode | session 持久化、compaction、旧 tool output pruning | 压缩主要解决当前上下文预算,不自动形成长期事实 |
| Coding | Gemini CLI | 全局、项目与扩展级 Markdown,后续 session 自动加载 | 少量稳定项目知识适合文件与层级作用域 |
| Coding | OpenAI Codex | 有界 summary 常驻,Memory 明细按 list/search/read 渐进披露 | 索引常驻、内容下钻可以控制上下文预算 |
| Coding | OpenHands | conversation 保存、恢复与服务端 condense | conversation continuity 不等于跨 conversation 事实层 |
| Coding | Cline | Auto Compact;Rules/Memory Bank 由用户或规则维护 | 显式项目知识与自动会话压缩是两条路径 |
| Coding | goose | session summarize;Memory MCP 显式 remember/retrieve/remove | 文件 Memory 可提供可见、可改、可删除的保守基线 |
| Coding | Aider | chat history 文件、显式恢复、超限摘要与 RepoMap | 历史恢复、摘要和代码索引承担不同职责 |
| Coding | nanobot | append-only history → Dream 整理长期 Markdown → Git 版本 | 异步 consolidation 需要 cursor、版本与失败语义 |
| Coding | Continue | session history/summary;Rules 按 always/glob/description 注入 | 条件式注入比所有稳定知识全量常驻更可控 |
| Coding | Qwen Code | 人工 QWEN.md + Auto Memory,含 pin/forget/Dream/secret scan | 自动记忆必须同时提供修订、退出和敏感信息保护 |
| Framework/SDK | AutoGen | Memory 协议统一 add/query/update_context,多种后端 | context update 是独立于存储和搜索的一等接口 |
| Framework/SDK | CrewAI | 自动推断 scope/category/importance,语义+新近度+重要性排序 | 自动写入和组合排序需要项目级评测,不是默认真相 |
| Framework/SDK | LlamaIndex | FIFO + static/fact/vector blocks,按优先级和 token budget 注入 | 不同对象可共存,但必须共享明确的上下文预算 |
| Framework/SDK | Agno | 跨 run/session/agent 的 user memory 与管理策略 | 长期对象需要显式用户边界与生命周期管理 |
| Framework/SDK | LangGraph | checkpointer 保存 thread state;store 保存跨 thread 对象 | 可恢复状态与长期可查询对象应分开建模 |
| Framework/SDK | Semantic Kernel | AIContextProvider 提供 context 与生命周期,可组合不同 provider | 应稳定抽象 provider 边界,而不是绑定单一存储 |
| Framework/SDK | OpenAI Agents SDK | Sessions 取回/追加会话 items,支持后端、窗口与 compaction | session backend 不默认等于跨 thread 事实提炼 |
| Framework/SDK | AgentScope | MEMORY.md 索引常驻,topic Markdown 按需注入并可自编辑 | 渐进披露需要同时考虑 Agent 不下钻与自编辑风险 |
| Framework/SDK | smolagents | 单次 run 的 plan/action/error/observation steps,可 replay/callback | run 内步骤 Memory 首先服务执行连续性与调试 |
| Framework/SDK | Mastra | history、working memory、semantic recall、observational memory 组合 | 组合机制应区分保存内容与模型实际看到的内容 |
| Framework/SDK | Google ADK | SessionService 管 event/state;MemoryService ingest/search | session、user/app/temp scope 和长期查询职责不同 |
| Framework/SDK | PydanticAI | 应用传回 message_history,processor/provider 负责压缩 | history 的持久化与信任边界属于应用责任 |
| Framework/SDK | CAMEL | ChatHistoryBlock + VectorDBBlock;ContextCreator 受 token limit 约束 | 检索结果还需上下文选择与预算裁剪 |
| Framework/SDK | MetaGPT | role message + FAISS 长期索引,用相似历史做 novelty filtering | 使用向量不必然意味着把旧事实直接注入 prompt |
| Framework/SDK | Microsoft Agent Framework | history search 与 file memory;索引常驻,正文按工具下钻 | 会话搜索与可编辑文件 Memory 可并行而非互相替代 |
| Framework/SDK | BeeAI Framework | sliding/token/summarize message memory,持久化由应用扩展 | 上下文管理能力不能冒充默认长期对象治理 |
| Platform | Hermes Agent | Mem0/Hindsight/Honcho/本地 store 等 provider 插件 | 稳定 provider 边界可避免过早绑定一种后端 |
| Platform | AutoGPT | Graphiti 时序事实/episode;hybrid warm context;Dream 治理 | 时序与图适合有关系、变化、来源需求的专门查询 |
| Platform | Langflow | Message 按 session 保存;Agent 可开启 chat memory、换后端 | 保存进数据库不表示已经注入模型 |
| Platform | Dify | conversation 分支内取最近消息并按 token 从旧端裁剪 | 最近窗口是会话策略,不是跨 conversation 事实层 |
| Platform | elizaOS | 持久 Memory + 每轮重组 State,含 room/entity/agent scope | 持久对象与瞬时执行上下文应在接口上分离 |
| Platform | Agent Zero | 后台提取/合并,向量召回后 LLM 过滤,Dashboard 查改删 | 自动提炼必须配套观察、人工修订和删除入口 |
这 32 个样本中,23 个能确认存在跨 thread、project、user 或 role 的文件、事实层、外部 provider 或长期 store 路径;另 9 个主要解决 conversation/run 的保存、恢复或压缩。这里的长期路径包括可选 provider 与用户显式维护文件,只表示“提供实现路径”,不表示默认开启,更不表示通过统一 benchmark。
A.2 垂直领域样本:14 个
| 领域 | 项目 | Memory 定位与读写闭环 | 领域约束带来的设计变化 |
|---|---|---|---|
| 金融交易 | TradingAgents | pending 决策在收益、alpha、持有期产生后补 reflection;同标的与跨标的差异注入 | 延迟结果决定经验何时可写,具体仓位不能跨标的迁移 |
| 金融交易 | FinMem | 按股票保存文本、日期、importance/recency/访问与向量,反馈后衰减迁移 | 高速变化信息需要反馈、衰减和 ticker 隔离 |
| 医疗/EHR | EHRAgent | 只把答案正确的 Question/Knowledge/Solution 追加为后续示例 | 成功判定是防止错误示例自我强化的写入门 |
| 医疗协作 | AI Hospital | history 与结构化诊断按 patient_id 隔离,并可修订或清空 | patient scope 是先于语义召回的硬边界 |
| 科研写作 | STORM | 带来源资料、访谈问题、outline 与 references 跨阶段传递 | 科研 Memory 必须保留引用链,而非只记结论 |
| 自动科研 | AI Scientist | 保存实验代码副本、final_info.json、反馈和 notes.txt | 实验制品与原始指标比自然语言总结更权威 |
| 自动科研 | Agent Laboratory | 文献、plan、代码、真实结果和 insights 作为阶段契约 | 跨 Agent 交接应保留结构化 artifact,防止虚构实验 |
| 自动渗透 | PentestGPT | SQLite 保存 goal、allowed target、task、attempt、trace evidence、revision/lease | run identity 与授权目标决定历史能否参与当前执行 |
| 网络安全 | CAI | JSONL 执行日志由操作者 /load 到指定 Agent | 高风险历史可采用人工显式装载,避免自动污染新目标 |
| AI 红队 | PyRIT | CentralMemory 保存 conversation、prompt、score、attack/scenario result | Memory 是可复现实验账本,必须保留转换链和归属 |
| 具身/游戏 | Voyager | critic 验证成功后保存技能代码、描述与向量索引 | 程序性 Memory 必须可执行、结果已验证且前提明确 |
| 游戏/GUI | Cradle | 有界保存 screenshot/action/result/error/reflection/skill 并可恢复 | 多模态轨迹不能压成脱离视觉前提的文本结论 |
| 社会模拟 | Generative Agents | persona 分别保存 event/thought/chat,联合 recency/relevance/importance | 观察与反思要分层,角色认知不能全局共享 |
| 桌面自动化 | UFO | 短期 screenshot/action/result trace;成功且用户确认后写 experience | app/version/界面状态与用户确认共同构成写入资格 |
垂直样本增加了四条通用样本不容易暴露的约束:领域反馈决定写入时机;业务对象决定 scope 主键;权威证据与派生经验必须分层;失败成本越不对称,自动写入和自动召回越应保守。MedMemoryBench 与 AgentPoison 分别补充纵向患者更新和检索投毒测试,但它们是评测/安全证据,不计入 46 个实践 Agent。
附录 B:离线评测清单
开始每轮实验前,固定任务版本、模型版本与参数、工具版本、外部数据快照、数据截止时间、随机种子或重复次数,并为每个用例保存原始 trace 和最终上下文注入快照。
| 层级 | 最小断言 | 失败时优先定位 |
|---|---|---|
| Baseline | 无长期 Memory 时的结果可重复,失败原因可定位 | Prompt、工具、workflow、外部知识、验证器 |
| 写入 | 应写对象进入 candidate/active;不应写对象只留 event;source/scope/time/type 正确 | extractor、write gate、幂等与验证器 |
| 检索 | 目标进入合法 top-k;越权、未来、失效对象为零;排序原因可解释 | hard filter、index、rank、threshold |
| 上下文 | 关键事实、冲突和来源未被截断;token 不超预算;注入位置可追踪 | context builder、render、budget |
| 使用 | Agent 正确引用 Memory;无证据时拒答;不会把冲突随机合并 | Prompt、tool contract、result validator |
| 治理 | 修改、撤回、删除、并发和后台重试都有确定结果 | revision、lineage、tombstone、cursor/lease |
| 安全 | 跨 scope 泄漏、恶意写入、注入复述自激均被阻断 | permission、source trust、extractor input policy |
| 成本 | 记录单个合格任务的 token、时延、存储和模型调用 | 常驻内容、top-k、提炼频率、rerank |
建议每次只改变一个机制层,并记录:解决了哪个已知失败;新增了哪些 memory-caused errors;p50/p95 时延与 token 成本变化;是否达到项目自己的 [待验证] 阈值。无法归因的“整体升级”不能提供下一次选型依据。
附录 C:容易混淆的边界
| 概念 | 本文中的边界 |
|---|---|
| session/checkpoint | 可恢复状态;只有在未来任务中被选择性使用时,才进入广义 Memory 讨论 |
| RAG | 访问外部知识的机制,不等于用户事实、任务状态或经验 Memory |
| audit trace | Memory 的证据来源和回放材料,不应默认全部注入 |
| prompt cache | 对稳定输入前缀的成本优化,不是持久化 Memory |
| context window | Memory 最终呈现的目标之一,不是持久存储层 |
| summary/compaction | 上下文压缩策略,不自动获得事实权威或跨 session 生命周期 |
| parameter memory | 模型训练中形成的知识,本文不讨论其实现,但 point-in-time 评测要控制其泄漏 |
参考资料
参考资料
BigFinanceBench 论文与公开 50 题数据子集。任务
bf-b0926059cd的 reference answer、LTM 期间、公式步骤和数值来自公开 rubric。 ↩ ↩FinanceBench 论文与官方数据仓库。10,231 是数据集规模;81% 来自论文中 150 题实验的特定系统配置,不能全部归因于 retrieval 或 Memory。 ↩
FinGAIA 论文与官方仓库。其失败还涉及跨模态、术语和工作流,不能由 Memory 单独解释。 ↩
LangGraph checkpoint/store、Google ADK MemoryService、OpenAI Agents SDK Sessions、Langflow Memory。 ↩
pi session 文档、STORM、Voyager SkillManager、PentestGPT MemoryKernel。 ↩
AI Hospital doctor agent、TradingAgents decision memory、PentestGPT MemoryKernel、elizaOS Memory and State。 ↩
TradingAgents reflection、EHRAgent、Voyager success gate、UFO experience learning。 ↩
FinMem、Generative Agents retrieval、CrewAI Memory、MetaGPT LongTermMemory。 ↩
FinAgentBench。该工作评测 retrieval 的两阶段选择,不提供跨 session 写入或遗忘证据。 ↩
AutoGen Memory protocol、CAMEL Memory、Mastra Memory、AgentScope agentic memory middleware。 ↩
Lost in the Middle。该研究支持长上下文利用存在位置效应,不指定某种 Memory 注入角色为通用最佳。 ↩
Qwen Code Memory、nanobot Memory、FinMem、AutoGPT Graphiti/Dream。 ↩
AgentPoison。攻击研究证明检索链存在投毒风险,不代表其中措施足以覆盖具体生产威胁模型。 ↩
AI Scientist experiment loop、Agent Laboratory、Cradle LocalMemory、PyRIT CentralMemory。 ↩
LongMemEval与MemoryAgentBench。公共 benchmark 用于补充能力类型,项目验收仍需自己的任务、权限和成本分布。 ↩