证据源:本地克隆
0-agent-evaluation/20260810-agentbench/repo/(main 分支快照,2026-08-11 克隆)。文中所有文件:行号锚点均指向该快照。 版本约定:当前 HEAD 是 AgentBench 的 Function-Calling(FC)版(基于 AgentRL,README.md:13-16);论文对应的 v0.2 旧版代码(src/assigner.py、src/client/、src/analysis.py、src/configs.py等)部分保留在同一仓库。成文严格区分两者,涉及外部包agentrl的行为只描述本仓库的调用面,不猜测其内部实现。判定细节取自 FC 版src/server/tasks/*/(见第 4 节版本说明)。
中心论点
AgentBench 用「多环境 + 异构指标 + 统一调度」构建 LLM-as-Agent 的学术评测:v0.2 框架里 Task Server 托管环境、Agent Server 托管模型、Client 用最大流调度并发跑样本;FC 版把判定做成完全确定性(精确匹配/正则/检查脚本/表哈希/F1,无 LLM-as-judge),保证结果可复现可比。这与 promptfoo 的「工具化(可组合断言)」、hello-agents 的「教学化(一键管线)」形成三条不同路线。
1. 综合基准的定位:从 8 环境矩阵到 FC 版演进
一个数字先摆在这里:AgentBench v0.2 的测试集,要求被测模型合计生成约 1.3 万次(13k)环境交互(README.md:127-128)。但真正值得拆解的并不是这 1.3 万次交互本身——而是支撑它们的那套工程:怎么让多个模型 × 多个环境并发跑完、跑到一半崩了怎么续、每份结果怎么判对错、怎么保证换个模型重跑还能得出同样的分数。AgentBench 的意义,就是把「评测」从一张 leaderboard 变成一套可复现、可审计的工程系统——本文用源码逐层拆解这套系统。
AgentBench 自述为第一个把「LLM 作为智能体(LLM-as-Agent)」跨多环境系统化评测的学术基准(ICLR'24,论文 arXiv:2308.03688,README.md:99)。它的原始设计(论文对应的 v0.2 版本)回答一个问题:大模型不只是会聊天、会补全,还会不会在真实交互环境里自主完成任务? 单点能力测试(如知识问答、代码生成)测的是「模型知道什么」,而 Agent 评测测的是「模型能做什么」——后者必须放进环境里,让模型反复观察、决策、行动。
要测「能做什么」,单个环境是不够的。v0.2 的定义是 8 个环境矩阵(README.md:99-113):5 个自建域——操作系统(OS)、数据库(DB)、知识图谱(KG)、数字卡牌游戏(DCG)、横向思维谜题(LTP);以及 3 个从公开数据集重组的环境——家务(ALFWorld)、网购(WebShop)、网页浏览(Mind2Web)。这 8 个环境横跨了文本交互、结构化查询、多跳检索、博弈推理、具身规划等完全不同的能力维度。多环境的含义是:评测的不是单点能力,而是跨任务泛化——一个 agent 在 OS 上表现好不算数,得在 DB、KG、游戏里都站得住,才算「综合」。
v0.2 在规模上的设计是直接奔着「压力测试」去的:每个数据集分 Dev / Test 两个 split,多轮交互要求模型合计生成约 4k 次(Dev)与 13k 次(Test)动作(README.md:127-128)——这 1.3 万次交互就是开头那个数字的出处。
但仓库的当前 HEAD(2026-08-11 快照)已经不是这个形态了。README.md:13-26 的开头公告(2025.10.10)写得很直接:本仓库现在是 AgentBench FC(Function Calling)版,基于 THUDM 自家的 AgentRL(end-to-end 多任务多轮 LLM Agent RL 框架),任务交互改为函数调用(function-calling)风格,并加了全容器化部署支持;任务从 8 个收缩为 5 个:alfworld / dbbench / knowledgegraph / os_interaction / webshop。
旧的 v0.1 / v0.2 被推到独立 tag 分支,但 v0.2 的调度、客户端、汇总代码并没有从 main 分支删除——它们和 FC 版的新代码并存在同一个仓库里。
这个「新旧混合」本身就是一个值得记录的观察:开源基准的演进不是重写,而是叠加。v0.2 的框架层(src/assigner.py、src/client/、src/analysis.py)是论文时代的工程遗产;FC 版则把 server 端整个换成了 AgentRL 的容器化实现(src/server/tasks/*/ + extra/docker-compose.yml)。这个仓库同时保留了两代设计——「调度怎么并发跑样本」看 v0.2,「判定怎么判对错」看 FC 版。本文正是沿着这两条线索展开:第 2–3 节讲 v0.2 的三段式框架与调度主流程,第 4 节讲 FC 版的确定性判定,第 5 节把两代工程细节合并讨论。
图 1|环境矩阵演进(两列对照,README.md:21-25 vs README.md:99-113)
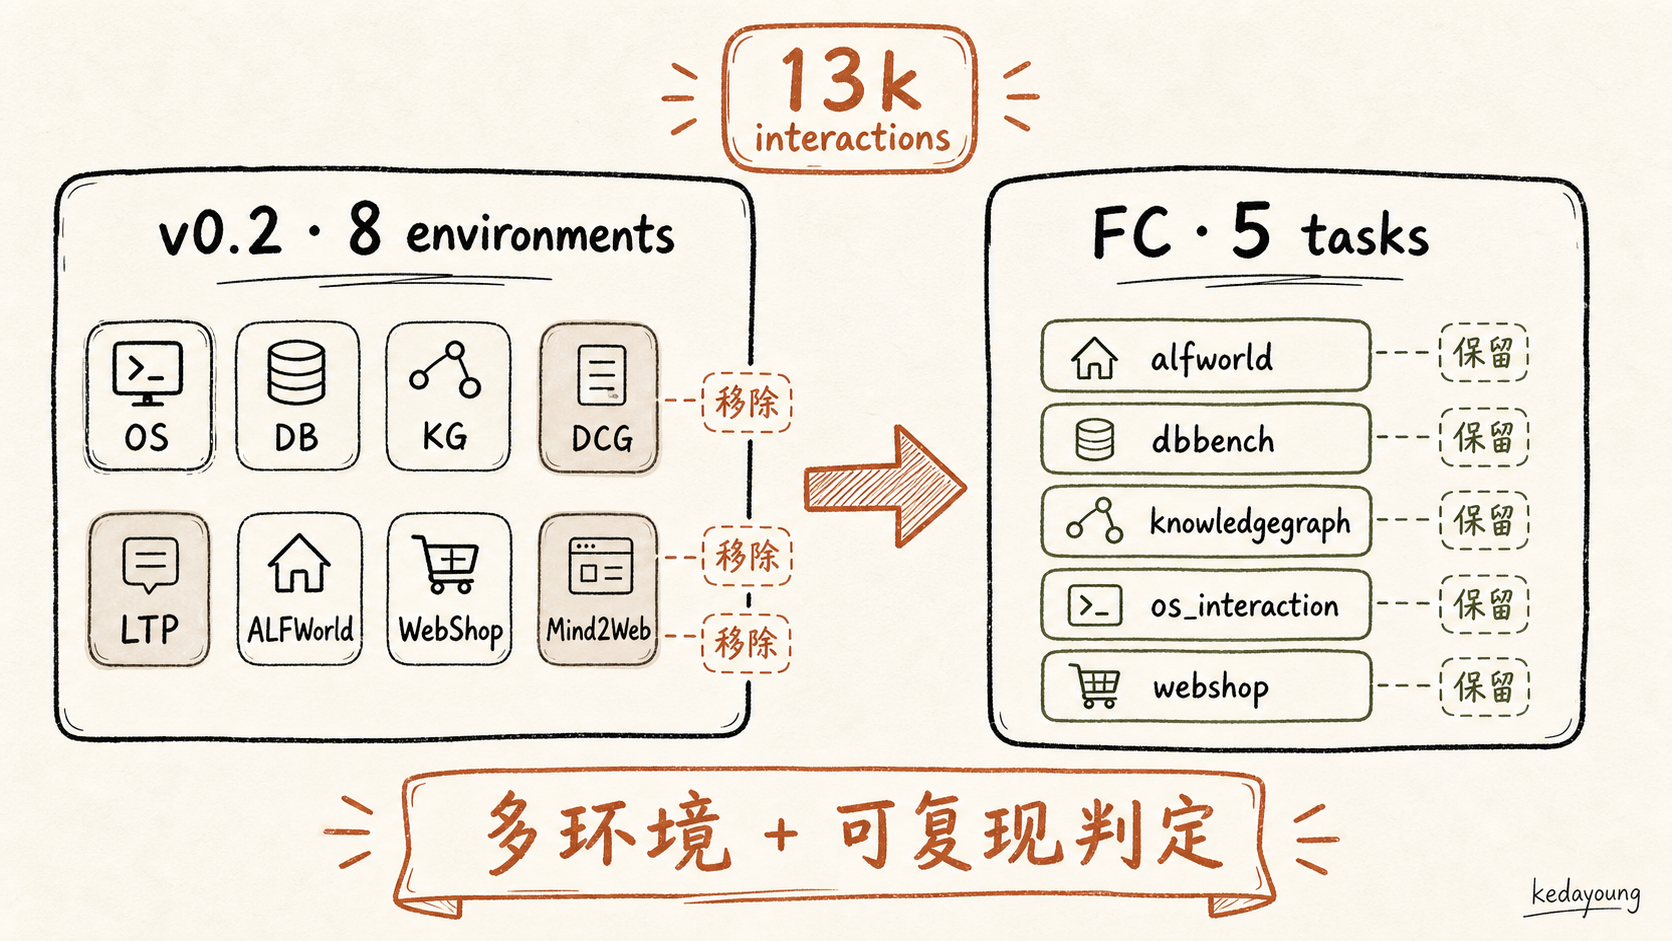
| 任务 | v0.2(8 环境) | FC 版(5 任务) |
|---|---|---|
| OS 操作系统 | ✅ 自建 | ✅ 保留 |
| DB 数据库 | ✅ 自建 | ✅ 保留 |
| KG 知识图谱 | ✅ 自建 | ✅ 保留 |
| DCG 卡牌游戏 | ✅ 自建 | ❌ 未包含(仅存配置残留) |
| LTP 谜题 | ✅ 自建 | ❌ 未包含(仅存配置残留) |
| ALFWorld 家务 | ✅ 重组 | ✅ 保留 |
| WebShop 网购 | ✅ 重组 | ✅ 保留 |
| Mind2Web 网页浏览 | ✅ 重组 | ❌ 未包含(仅存配置残留) |
2. 框架三段式:Task Server / Agent Server / Client
版本说明:本节架构、配置系统与 agent 接入均来自 v0.2 框架(
docs/Introduction_en.md、src/configs.py、src/client/);FC 版 server 端已由 AgentRL 取代,部署形态见本节末尾。
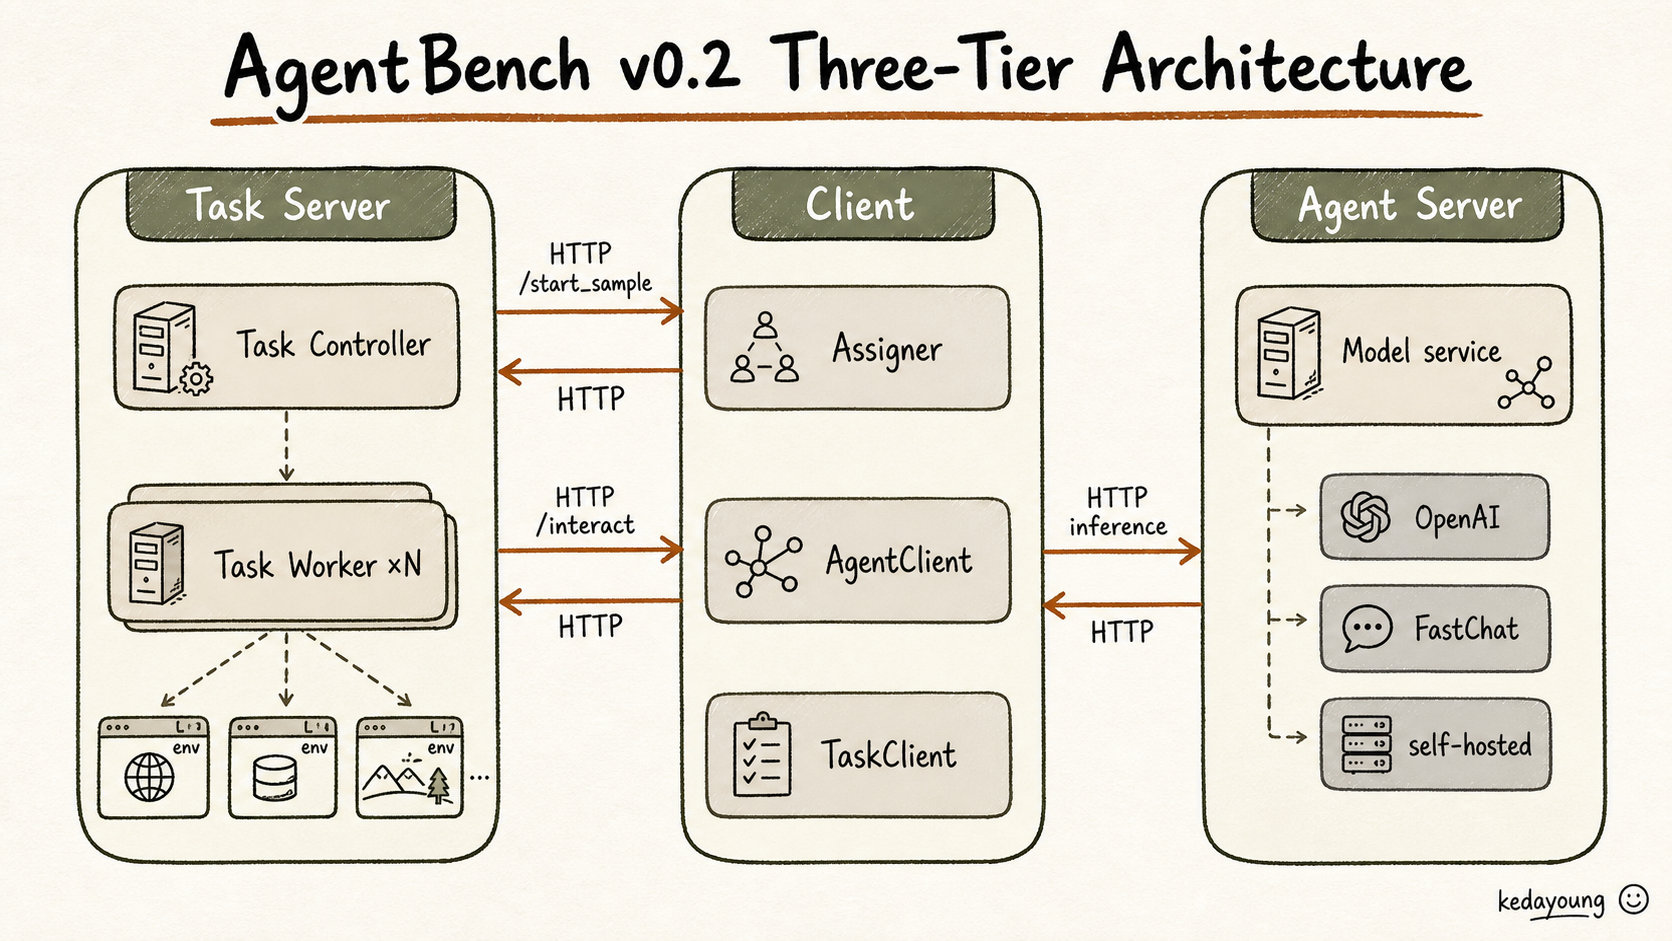
AgentBench v0.2 的架构是教科书式的三段解耦(docs/Introduction_en.md:110-184):
- Task Server(环境侧):托管评测环境,内部再分 Task Controller(任务控制器,负责接收请求、分配样本)与 Task Worker(任务工作进程,每个 worker 对应一个具体任务环境实例)。环境是「被测对象」的宿主。
- Agent Server(模型侧):托管被测模型。模型可以是 OpenAI API、本地部署的 FastChat 服务,或任何暴露 HTTP 接口的推理后端。
- Client(调度侧):由 Assigner(分配器)、AgentClient(模型客户端)与 TaskClient(任务客户端)组成。Assigner 决定「哪个模型 × 哪个任务 × 哪个样本」,AgentClient 负责与模型对话,TaskClient 负责与环境交互。
三段之间全部走 HTTP 通信(Introduction_en.md:116):Client 向 Task Server POST /start_sample 开样本、POST /interact 回环境;向 Agent Server POST 推理请求。环境、模型、调度三者物理上可以各跑各的机器,这是「换模型不碰评测代码」的架构前提。
图 2|三段式架构(v0.2,docs/Introduction_en.md:110-184)
这段架构里最值得学的不是分层本身,而是两个配套机制:
配置即声明
configs/ 下按 assignments/(评测任务指派)、agents/(模型定义)、tasks/(任务定义)三个子目录组织,加上入口 start_task.yaml。配置加载器(src/configs.py:25-115)实现了三层扩展语法:import 支持合并其它配置文件(parse_imports,:56-86,带循环 import 检测)、default / overwrite 支持声明式覆盖(parse_default_and_overwrite,:88-115,基于 deep_merge,:9-22)。于是「加一个新任务」在配置层的成本趋近于零:写一个 yaml,import 进来,覆盖默认值——不用碰任何 Python 代码。
可插拔工厂
InstanceFactory.create(src/typings/general.py:10-35)按配置里的 module + parameters 字符串,把 module 按点号切分后逐级 __import__(:32-35),拿到类对象再用 parameters 实例化。这意味着配置文件里写 src.client.agents.http_agent.HTTPAgent + 一段参数,框架就能造出对应的 agent 对象——模型接入是纯配置行为。
配置完 agent 后还有一个自检入口:python -m src.client.agent_test(README.md:184)会实际调用一次配置好的模型,验证「agent 能通、key 有效、格式对」,再进正式评测。这个「先自检再开跑」的习惯,在动辄几小时的大规模评测里能省掉一整轮返工。
Agent 侧的实际实现(src/client/agents/)有 http_agent.py(HTTPAgent)、fastchat_client.py(FastChatAgent)、claude_agent.py 等,统一继承 src/client/agent.py 里的 AgentClient 抽象基类(:4-9,inference 抛 NotImplementedError)。第三方模型只要实现一个 inference(history) -> response 的 HTTP 后端,就能进评测,不用改框架一行。
FC 版的部署形态则完全不同——不再手动起 controller/worker,而是 docker compose 一键拉起(extra/docker-compose.yml:5-89):一个 AgentRL Controller(:5-10)+ 五个任务 worker(alfworld-std / dbbench-std / knowledgegraph-std / os_interaction-std / webshop-std,:12-76,均指向 controller 的 http://172.17.0.1:5020/api)+ 一个 freebase 服务(KG 任务依赖,:78-84)+ 一个 Redis(容器分配用,:86-89)。任务 worker 的入口是 extra/worker-entrypoint.sh,跑 python -m agentrl.worker 并按 configs/tasks/*.yaml 动态导入本仓库里的 Task 子类(见第 4 节)。框架的「解耦」理念在两代里是一致的,只是载体从「进程内自管服务」变成了「容器编排」。
3. 评测主流程:从启动到出分
本节基于 v0.2 遗留框架代码(
src/assigner.py、src/client/、src/utils/max_flow.py)。README.md:220-228的python -m src.assigner启动说明位于 v0.2 的 Quick Start 段落(README.md:143起)。
一次评测要回答的核心调度问题是:有 M 个模型、T 个任务、每任务 N 个样本,怎么并发地把它们跑完,同时不违反任何一方的资源上限? AgentBench v0.2 的答案分三层:入口、调度循环、单样本循环。
前置:起任务服务器
跑 Assigner 之前,环境侧要先就位。v0.2 的启动方式是 python -m src.start_task -a(README.md:199-204):脚本自动起五个任务 worker(默认配置下 dbbench-std / os-std 各五个),并让它们自动注册到端口 5000 的 Task Controller 上——README 特别提醒「启动后等约 1 分钟,看到 terminal 打出 .... 200 OK 再继续」。资源紧张的机器还有 lite 预设(--config configs/start_task_lite.yaml,每任务一个 worker)。
入口
python -m src.assigner(main 在 src/assigner.py:407-425;对应 README v0.2 Quick Start 的 :220-228)。Assigner 启动时读取配置,实例化所有 agent 与 task(assigner.py:156),然后进入 start(:238-272)。
调度循环
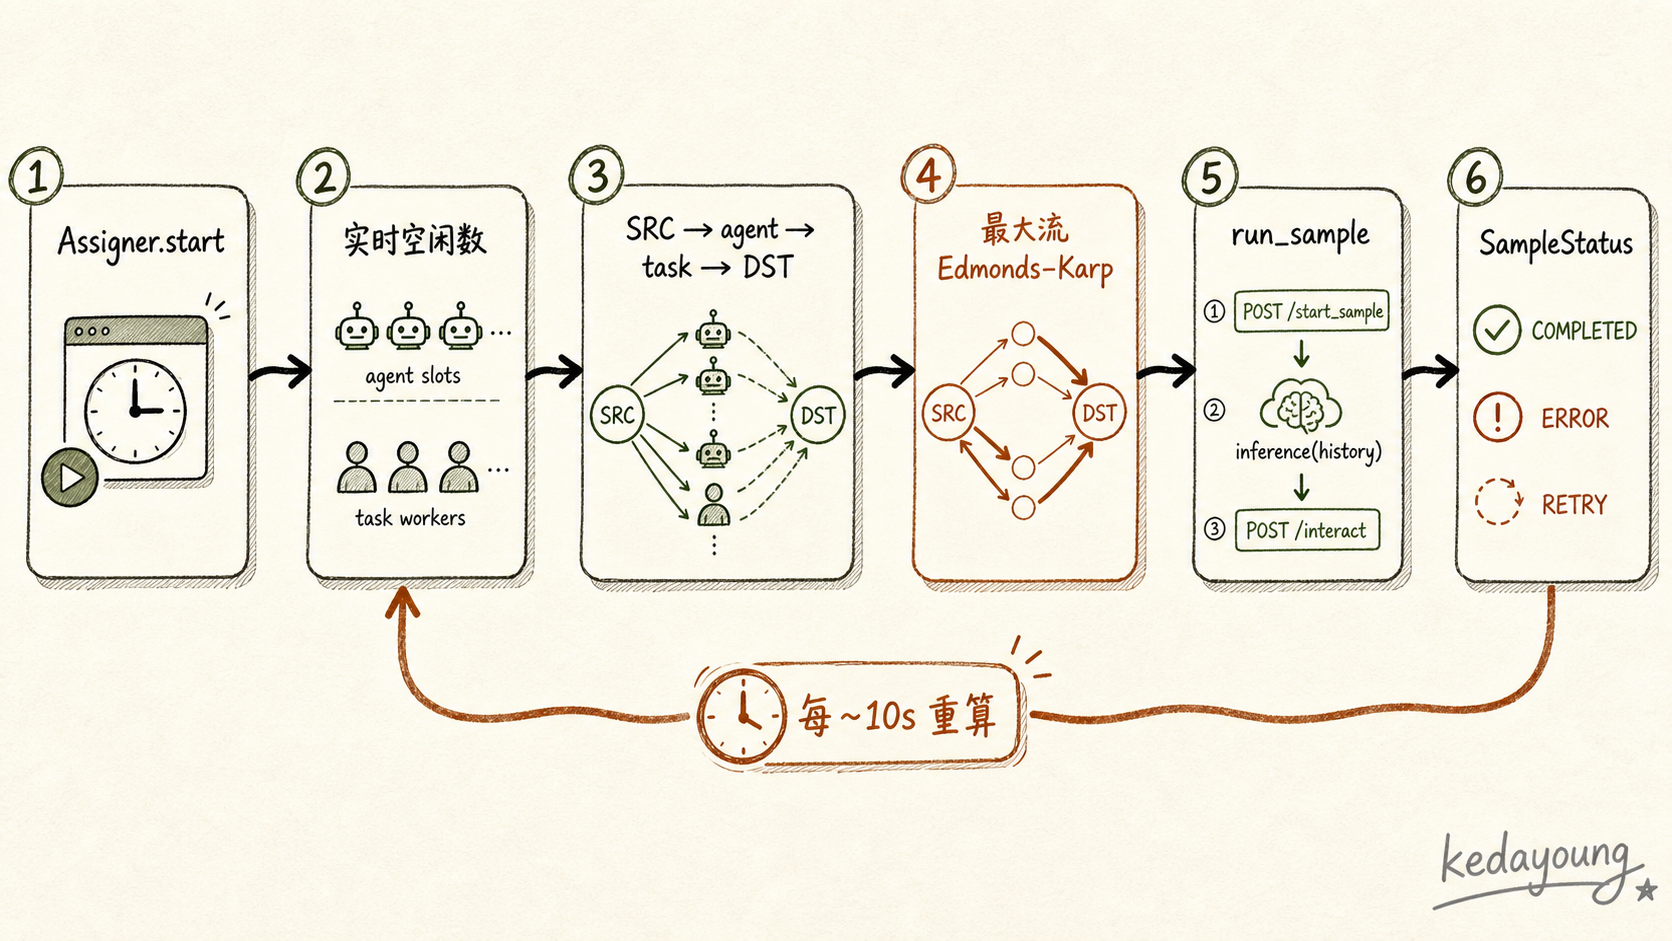
Assigner.start 消费一个 worker_generator(assigner.py:161-236)产出的 (agent, task, index) 三元组,每拿到一个就 start_worker 起一个线程跑样本。worker_generator 是个无限循环,每轮间隔约 10 秒:
- 采集实时空闲数:每个任务通过
get_concurrency()上报当前空闲 worker 数(:179-182); - 构建容量图:节点是
SRC → agent → task → DST,边容量分别是「该 agent 的空闲槽位」「该 task 的空闲 worker 数」「该 agent×task 的剩余样本数」(:184-198); - 求最大流:在这张二分图上跑最大流(
:206-213,src/utils/max_flow.py:26-96),得到「在当前容量约束下最多能同时派多少样本」; - 按流值派发:把流经 agent→task 边的流量翻译成具体样本,逐个
yield(:215-233),派发后同步扣减空闲槽位; - 所有样本派完且无在跑任务时退出(
:199-204)。
最大流算法是 Edmonds-Karp 式的 BFS 增广(max_flow.py:60-71 循环找增广路径,:73-96 的 find_augmenting_path 用 BFS 搜索、回溯路径)。用最大流而不是简单队列的差别在第 5 节展开,这里先记住结论:调度是一个每 10 秒重算一次的实时容量问题,而不是一次性排程。
单样本循环
一个 (agent, task, index) 三元组对应一次完整的「agent 与环境博弈」(TaskClient.run_sample,src/client/task.py:54-125):
POST /start_sample            # 向 Task Server 申请一个样本,拿到 session_id(:56-59)
while SampleStatus == RUNNING:
    response = agent.inference(history)   # 让模型基于当前历史出招(:73-75)
    POST /interact            # 把模型动作送回环境,拿新观测(:98-104)
exit # 状态不再是 RUNNING 即结束(:122-123)模型侧是无状态推理——Client 攒着完整的 history 每次全量发给模型,模型只负责输出动作;环境侧按 session_id 保持状态。这个「对话历史在客户端、环境状态在服务端」的切分,让任意无状态 API 模型都能接入。
可恢复性
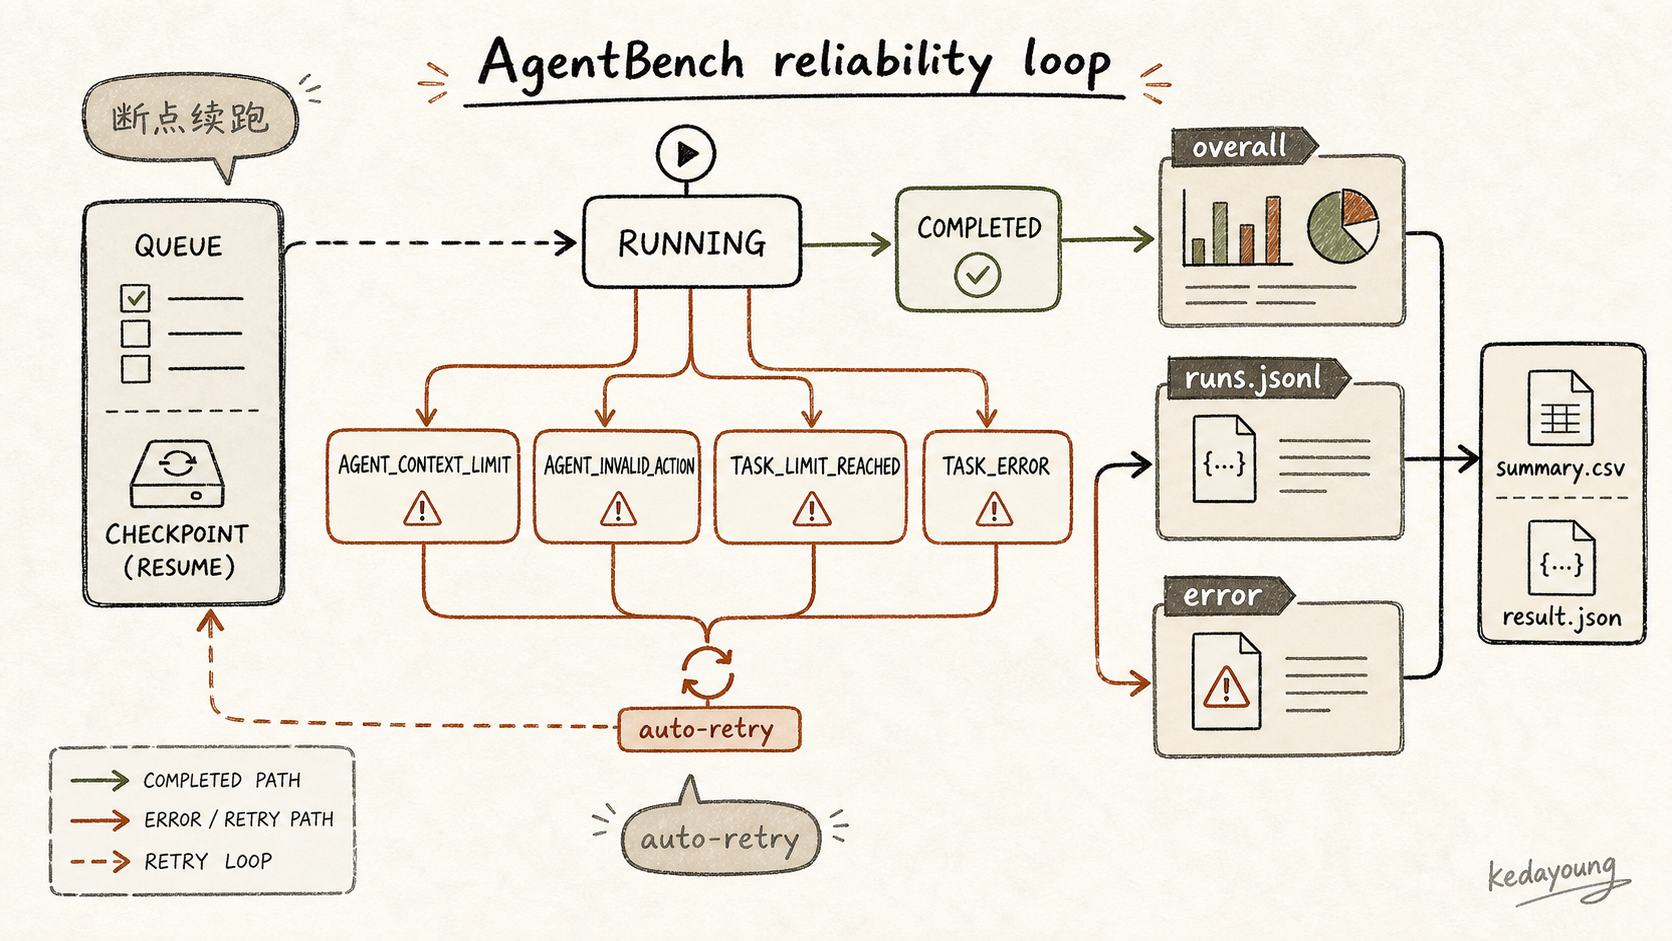
跑一半崩了是常态——大规模评测(v0.2 文档说测试集要模型生成约 1.3 万次交互)里尤其如此。Assigner 启动时读取已有输出目录的 runs.jsonl,把已完成样本从 remaining_tasks 里剔除(assigner.py:77-128);运行中失败的样本可通过 --auto-retry 重新入队(:345-350)。断点续跑是「能跑完几千样本」的第一块工程基石。
状态机
样本的结束必须有明确的分类,而不是笼统的「出错」。SampleStatus(src/typings/status.py:4-12)枚举了 RUNNING / COMPLETED / AGENT_CONTEXT_LIMIT(模型上下文耗尽)/ AGENT_VALIDATION_FAILED / AGENT_INVALID_ACTION(动作非法)/ TASK_LIMIT_REACHED(环境轮次上限)/ TASK_ERROR / UNKNOWN 等状态。评测结束后,每个样本落在一个明确的退出原因上——这直接支撑了第 5 节的错误分类审计。
图 3|assigner 调度与样本循环(v0.2,src/assigner.py:161-272、src/client/task.py:54-125)
4. 判定设计:异构指标、全确定性
版本说明(重要):本节判定逻辑全部来自 FC 版当前代码。
src/server/tasks/*/下的 5 个任务(alfworld/dbbench/knowledgegraph/os_interaction/webshop)都继承外部 pip 包agentrl-worker的Task/Session基类(如os_interaction/task.py:14-20、dbbench/task.py:8-14),本仓库不含 agentrl 源码(各Dockerfile里pip install agentrl-worker,worker 入口python -m agentrl.worker)。判定逻辑本身(JudgeConfig、compare_results、表哈希、F1、reward 注入、success_rate 汇总)是这些 FC 版本地类的实现,在 agentrl 的生命周期回调(如_evaluate_answer、calculate_overall、sync_start_sample)中被调用。所谓「v0.2 遗留判定代码」并不存在于src/server/tasks/——这里只有 FC 版实现;v0.2 的真正残留物在src/analysis.py、configs/与data/中。
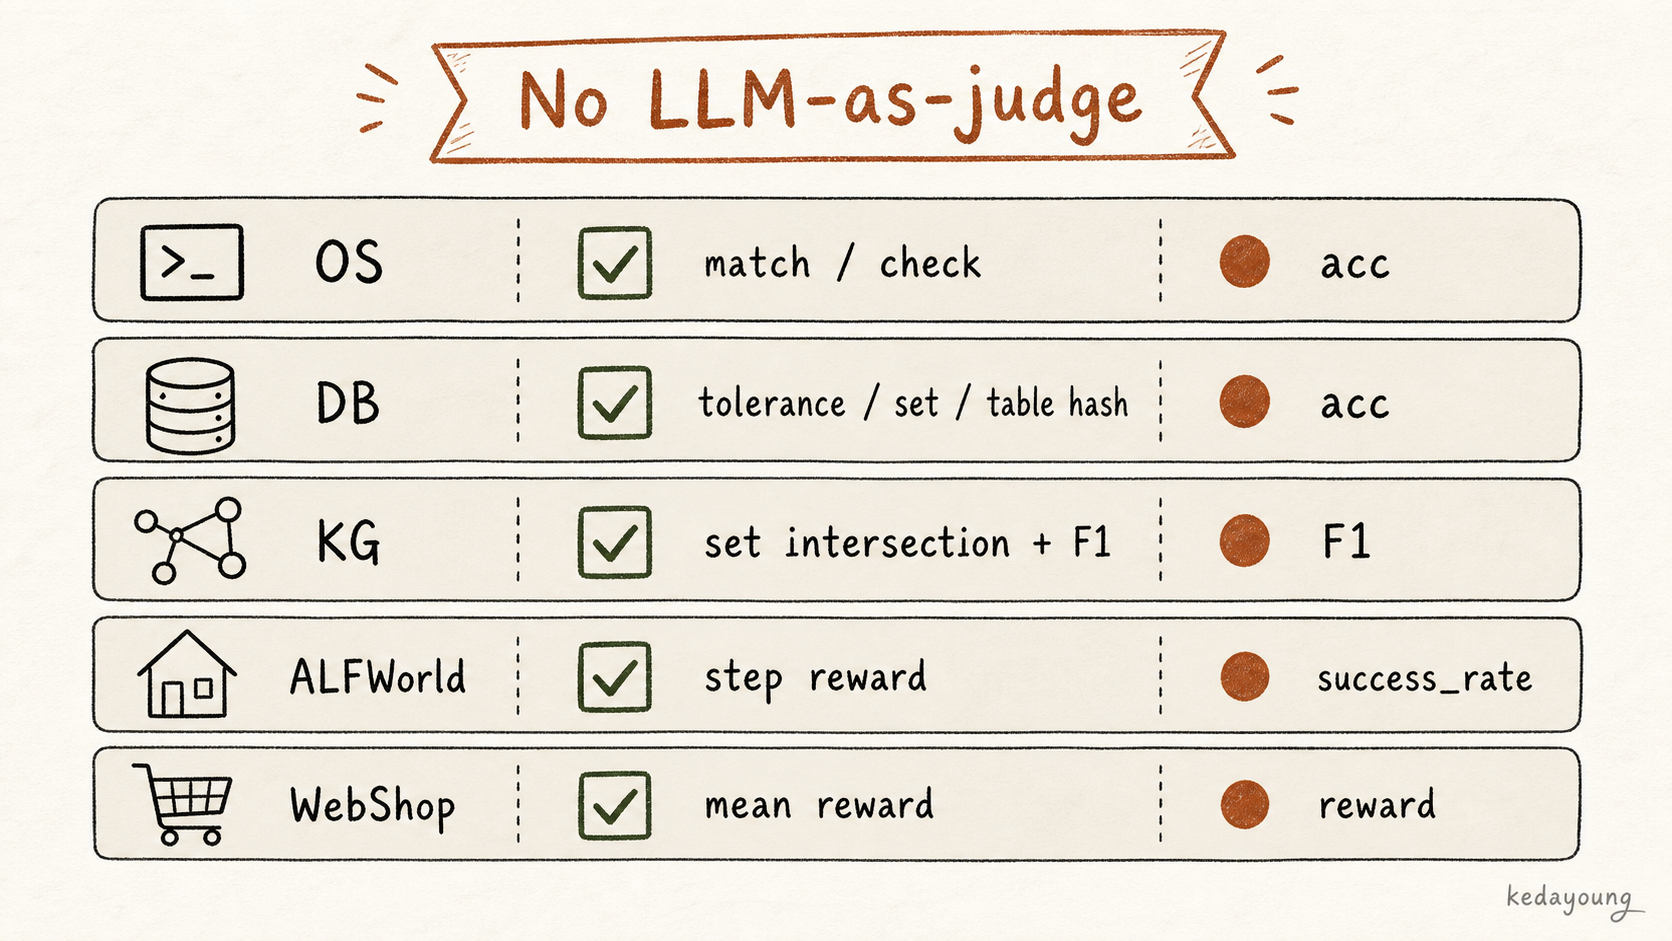
每个任务环境千差万别,「判对错」的方式也必须跟着环境走。AgentBench 的答案是把判定做成每任务独立的确定性规则,全部可复现、可审计,没有任何一处用 LLM 打分(no LLM-as-judge)。
判定的两种形态,在 OS 任务的 JudgeConfig 里定义得最清楚(os_interaction/task.py:127-143):match 与 check 二选一,由 get_evaluation_type() 分派(:671-687 的 _evaluate_answer)——
- match(字符串/正则):
_evaluate_by_match(:700-712)把模型最终答案与config.match["answer"]做字符串相等,或与config.match["regex"]做re.search。适合答案形态固定、能写成字面量或模式的任务。 - check(执行判分脚本):
_evaluate_by_check_scripts(:714-736)在评测容器里执行判分脚本(container.execute_independent(script, *params)),退出码非零即判失败。适合「过程比答案重要」的任务——比如要在文件系统里留下特定状态,直接跑个 shell 脚本验状态。
各任务的指标,横向看是一张异构表:
| 任务 | 判定方式 | 指标 | 证据位置(FC 版) |
|---|---|---|---|
| OS 操作系统 | 字符串相等 / 正则(match)或容器检查脚本(check) | 准确率 acc | os_interaction/task.py:127-143、:700-736 |
| DB 数据库 | 数值容差、集合比较;改库类任务用全表行哈希 | acc(v0.2 汇总口径 cat_accuracy) | dbbench/result_processor.py:10-78、:102-112、:275;dbbench/task.py:182-199 |
| KG 知识图谱 | 答案集合交集相等 + F1 | F1 | knowledgegraph/task.py:113-122、:216-232 |
| ALFWorld 家务 | 每步环境 reward,成功=到达目标 | success_rate | alfworld/task.py:79-92、:184-194 |
| WebShop 网购 | 每步环境 reward 的平均 | reward | webshop/task.py:179-201 |
图 4|异构指标判定表(FC 版当前代码)
细节里藏着三个值得展开的机制:
(1)DB 任务的「数值容差 + 集合比较 + 表哈希」三层判定(dbbench/result_processor.py:10-78)。compare_results 先清洗答案,然后按 SQL 类型分路:INSERT/DELETE/UPDATE 直接字符串相等(:27-28);SELECT 单值走特殊比较——浮点值用 _float_equal 带 1e-2 容差(:45-46 是浮点分支,容差本体在 :275 的 def _float_equal(a, b, tol=1e-2)),字符串按语义比较。多值结果先尝试逐项匹配,否则转成集合比较(:74,set(processed_answer) == set(processed_ground_truth))——顺序无关的结果(比如查询出来的多行)按集合判等,绕开行序噪声。
(2)改库类任务的「全表行 MD5 哈希」(dbbench/task.py:182-199)。对会改动数据库的任务(比如要求「把价格低于 X 的商品折扣 10%」),字符串比对根本无从下手——因为模型输出的是 SQL 语句,同一效果有无数种写法(UPDATE ... WHERE 的子句顺序、等价的过滤条件),判语句必然误杀。AgentBench 的思路是彻底绕开语句,直接判「数据库的最终状态」:跑完后对目标表做全表哈希——每行取 MD5 前 5 位做行哈希,group_concat 后整体再 MD5(result_processor.py:102-112),拿哈希值与 ground truth 比对;若 ground truth 为空,则用任务自带的 std_sql 重建数据库再算哈希(dbbench/task.py:190-199)。判的是「表的最终状态」而不是「模型的 SQL 文本」——这是对「改库」语义最忠实的确定性判定。
(3)KG 的「交集相等 + F1」双判(knowledgegraph/task.py:113-122、:216-232)。知识图谱问答的答案是三元组集合:len(交集) == len(两者) 同时成立才算完全正确(:117-118,is_correct),这要求预测与 gold 恰好一致;同时算 precision/recall/F1(:216-232:TP/FP/FN → P、R → 2PR/(P+R),TP=0 时返回 0)作为部分得分。F1 是这套体系里唯一由判定公式显式计算的「软指标」(WebShop 的 reward 是环境给出的连续得分,不属于判定层公式),但它仍然是确定性的集合运算,不依赖任何模型的判断。
ALFWorld 与 WebShop 走的是环境自带的 reward:ALFWorld 每步从 env.step_env 取 reward(alfworld/task.py:184-194,"Nothing happens" 时置 0),结束时 calculate_overall 统计 total/pass/wrong 得 success_rate = pass/total(:79-92)。WebShop 由外部 web_agent_site 环境的 env.step 产出每步 reward(webshop/task.py:130、:134),最终取平均(:179-201)。reward 来自环境本体,而不是评测框架的模型判断——这一条贯穿所有任务:判定层的确定性来自「判据是代码/脚本/环境状态,不是模型」。
从判定到汇总(作为 v0.2 的对照)。每任务的判定产出指标后,还要统一格式才能进榜单。v0.2 的 src/analysis.py 用 8 个 TaskHandler 子类(:144-263)各自从结果里取主指标:HH 取 custom.overall.success_rate(:188)、OS 取 custom.overall.acc(:200)、DB 取 custom.overall_cat_accuracy(:212)、KG 取 custom.main(F1 类指标,:224)、WS 取 custom.reward(:260)、WB 取 custom.step_sr/100(:248)——每任务的主指标各不相同,但都收敛成 0–1 的分数,这是异构判定能共进一张 leaderboard 的前提。汇总结果写 result.json(:335-336)与 summary.csv(:339-358)。FC 版的指标汇总由 agentrl controller 侧完成(接口定义在外部包,本仓库不展开)。
为什么学术基准要坚持全确定性?三个理由。一是可比性:Leaderboard 的意义在于跨模型、跨时间对比,如果判定本身不稳定(LLM judge 换模型换温度结果就漂移),榜单数字就没有意义;二是可审计:任何结果都能从「判定规则 + 样本输出」重放出来。对学术场景还有一个更硬的要求——论文的可复现性:一篇论文的评测结论必须经得起别人在别处重跑,而「跑一个 LLM judge」本身就是一次不可复现的随机过程(judge 模型的版本、采样参数、prompt 的微小差异都会改变判定)。确定性判定把「评测结果」变成「判定规则的确定性函数」,这才能支撑学术共同体的验证。这恰恰是学术基准与工程工具的分野——promptfoo 把判定做成可组合断言、明确支持 LLM judge(工程迭代要的是灵活),AgentBench 反其道:判定确定性优先,灵活让位给可比。用途决定了取舍。
5. 工程化细节:并发、恢复、错误分类
本节混用两代代码:调度/恢复/错误分类是 v0.2 框架(
src/assigner.py、src/client/、src/typings/),资源钳制是 FC 版(dbbench/environment.py)。已分别标注。
一个学术基准要「跑完几千样本」,工程量从来不在判分——判分是第 4 节那几行确定性规则——而在让大规模评测可恢复、可分类、可复现。AgentBench 提供了四件配套:
(1)最大流调度而不是简单队列(v0.2,机制见第 3 节;代码在 src/assigner.py:161-236、src/utils/max_flow.py)。这里只讲为什么值得这么做:简单队列的并发上限是静态的、不感知资源——要么设低了浪费机器,要么设高了把某个任务的 worker 压垮。容量图把「模型并发槽位、任务实时空闲 worker、剩余样本」放进同一张图,流值自动解出「哪个模型有空、哪个任务有 worker、哪个组合样本最多」三者同时满足的派发。并发是动态平衡出来的,不是拍脑袋配出来的。
(2)结果三通道(v0.2,src/assigner.py:352-378)。输出目录里三个文件各司其职:runs.jsonl(:369)记录每个样本的完整运行轨迹(成功样本的审计依据);error.jsonl(:376)记录失败样本及失败原因(失败样本的审计依据);overall.json(写于 record_completion,:308-311)记录整体统计。成功、失败、汇总三通道分离,是「评测出了岔子能查、跑了半截能续」的文件系统前提——断点续跑(第 3 节)正是靠读 runs.jsonl 才知道哪些样本已完成。
(3)错误分类:评测失败 ≠ agent 失败(v0.2,src/client/task.py:10-15)。TaskError 分五类:START_FAILED(开样本失败)、INTERACT_FAILED(环境交互失败)、AGENT_FAILED(模型调用失败)、NETWORK_ERROR、NOT_AVAILABLE。再加上第 3 节的 SampleStatus 状态码,一个样本失败后能精确回答「是环境崩了、网络断了、模型超时了,还是 agent 本身动作非法」——这是自动重试与人工审计的前提。把「基础设施失败」和「被测对象失败」分开,是评测框架和普通脚本的根本区别。
(4)FC 版的资源钳制(FC 版,dbbench/environment.py:62-66)。容器化之后,环境实例是有成本的资源,必须有上限:get_concurrency_limit() 返回 64(一个任务最多同时 64 个环境实例)、get_reuse_limit() 返回 1024(单个环境实例最多复用 1024 次后回收),这两个方法继承自 agentrl.worker.environment.EnvironmentDelegation。
环境实例的分配由 docker compose 里的 Redis 服务承担(extra/docker-compose.yml:86-89,注释明说 Redis 是「for container allocation」),dbbench 侧通过 dbbench/interaction.py:10 的 EnvironmentController 走 Redis 领取/归还容器。
再加上 compose 里每个任务默认只起一个 worker(:55-59,注释明说「increase as needed」),资源管理从 v0.2 的「进程内自报空闲」变成了 FC 版的「Redis 分配 + 并发/复用配额」。
把这些放在一起,AgentBench 的工程哲学可以概括为一句话:评测框架的价值不是替任务「想清楚怎么判分」,而是保证大规模并发下「每个样本都有确定的去向、每个失败都有明确的归因、每次中断都能续跑」。判定的确定性(第 4 节)负责「结果可信」,调度与恢复(第 3、5 节)负责「规模撑得起」——两者缺一不可。
图 5|结果三通道与状态机(v0.2,src/assigner.py:308-311、:369、:376;src/client/task.py:10-15;src/typings/status.py:4-12)
6. 与其它路线的对照与可迁移经验
AgentBench 不是唯一在「评测 agent」的工程。把评测工作按「用途」切,至少能看到三条平行的路线(本系列评测主题里还有 bfcl-gaia 的教学化、skillsbench 的技能专项、cua 的 GUI 专项,共五条,各自对应不同用途):
| 维度 | hello-agents(教学) | promptfoo(工程工具) | AgentBench(学术基准) |
|---|---|---|---|
| 评测对象 | agent 实例 | prompt / provider / 轨迹 | 多环境下的 LLM-as-Agent |
| 判定 | 外置/内置混合 | 可组合断言 + LLM judge | 全确定性(无 LLM judge) |
| 规模 | 小样本试跑 | 可增量回归 | 大规模并发 + 断点续跑 |
| 工程重点 | 可读性 | 回归与 CI | 调度、恢复、错误分类 |
| 适合 | 理解原理 | 研发流程 | 学术可比、跨模型测评 |
注:hello-agents 与 promptfoo 两列基于本系列仓库的概括,未在本仓库源码逐一验证(本仓库仅含 AgentBench)。
图 6|三条评测路线定位(示意坐标:横轴「判定自由度」确定性 ↔ LLM-judge;纵轴「规模」单机 ↔ 大规模。hello-agents 在左下「确定性 × 小规模」,promptfoo 在右下「高自由度 × 可增量」,AgentBench 在左上「确定性 × 大规模」。)
三条路线的差异根源在用途:hello-agents 要的是「几分钟看懂 agent 怎么跑」,所以牺牲规模换可读性;promptfoo 要的是「研发迭代中快速发现 prompt 退化」,所以判定可以灵活到用 LLM 打分;AgentBench 要的是「跨模型、跨时间的学术可比」,所以判定必须确定性、规模必须能撑起测试集。没有最好的评测框架,只有与用途匹配的取舍——这个对照本身就是选型时的核心判据。
从 AgentBench 的源码里,可以提炼四条可迁移的工程模式(作者判断,非 AgentBench 官方文档结论):
- 环境与模型解耦(三段式):环境、模型、调度分属三个进程/服务,换模型只改 Agent Server 配置,换环境只加 Task Worker——评测框架的复用性来自这个边界。
- 配置声明任务与 agent(import/default/overwrite):新任务 = 新配置,新模型 = 新配置,代码零改动;可插拔工厂(
InstanceFactory)把「字符串配置 → 对象」的桥接做成了通用机制。 - 确定性判定 + 明确失败分类:判据用代码/脚本/环境状态,不用模型判断;失败归因到状态码而非笼统的 error。评测结果因此可审计、可重放。
- 断点续跑 + 结果三通道:
runs/error/overall分离、启动时剔除已完成样本、失败自动重试——这是大规模评测的工程底线,也是任何长跑任务的通用模式。
附一条阅读指引(按依赖顺序):先读 README.md 的开头公告段(:13-77,FC 版)与 v0.2 段(:93- 起,尤其 Quick Start)建立版本感;架构看 docs/Introduction_en.md:110-184(三段式);调度看 src/assigner.py:161-272 + src/utils/max_flow.py:26-96;判定看 src/server/tasks/dbbench/result_processor.py:10-78(最完整的判定样例)+ os_interaction/task.py:671-736(match/check 分派);部署看 extra/docker-compose.yml:5-89。注意每个文件先确认它属于哪一代——同仓库里 v0.2 与 FC 版并存,混读是最大的踩坑点。
回到中心论点:学术基准的可信度来自「确定性判定 + 大规模可复现」,这两点分别由判定层(第 4 节)与调度层(第 3、5 节)保证。理解 AgentBench,本质上是理解「评测规模怎么撑起来、评测结论怎么站得住」——Leaderboard 上的数字只是这两件事的最终投影。
附录 A:证据清单(写作时逐条核对)
| 断言 | 证据位置(0-agent-evaluation/20260810-agentbench/repo/) | 版本 |
|---|---|---|
| FC 版声明与 5 任务 | README.md:13-26 | FC |
| v0.2 八环境矩阵 | README.md:99-113 | v0.2 |
| 配置扩展语法(import/default/overwrite) | src/configs.py:25-115(:56-86、:88-115) | v0.2 |
| 三段式架构(HTTP 通信) | docs/Introduction_en.md:110-184 | v0.2 文档 |
| 入口与调度 | src/assigner.py:238-272、:161-236、src/utils/max_flow.py:26-96 | v0.2 |
| 单样本循环 | src/client/task.py:54-125 | v0.2 |
| 断点续跑与重试 | src/assigner.py:77-128、:345-350 | v0.2 |
| 结果三通道 | src/assigner.py:308-311(overall)、:369(runs)、:376(error) | v0.2 |
| 状态机 | src/typings/status.py:4-12 | v0.2 |
| 错误分类五类 | src/client/task.py:10-15 | v0.2 |
| OS 判定 match/check | src/server/tasks/os_interaction/task.py:127-143、:671-687、:700-736 | FC |
| DB 判定(容差/集合/哈希) | src/server/tasks/dbbench/result_processor.py:10-78、:102-112、:275;dbbench/task.py:182-199 | FC |
| KG 交集相等与 F1 | src/server/tasks/knowledgegraph/task.py:113-122、:216-232 | FC |
| ALFWorld success_rate 与每步 reward | src/server/tasks/alfworld/task.py:79-92、:184-194 | FC |
| WebShop 平均 reward | src/server/tasks/webshop/task.py:179-201 | FC |
| FC 版容器化部署 | extra/docker-compose.yml:5-89、extra/worker-entrypoint.sh、各任务 Dockerfile | FC |
| FC 版资源钳制 | src/server/tasks/dbbench/environment.py:62-66 | FC |
| v0.2 指标汇总(8 环境 TaskHandler) | src/analysis.py:144-263、:326-358 | v0.2 |
| agent 接入(抽象基类 + HTTP 后端) | src/client/agent.py:4-9、src/client/agents/ | v0.2 |
| 可插拔工厂 | src/typings/general.py:10-35 | v0.2 |
附录 B:素材缺口与待办
- [x] 成文前通读 FC 版任务的
task.py:已通读 5 个任务的 import 与类定义,确认均继承外部包agentrl-worker的Task/Session,判定逻辑是本地实现;本仓库不含 agentrl 源码,接口行为未猜测。 - [x] 版本归属修正:原大纲假定
src/server/tasks/*/为 v0.2 遗留、判定细节以 v0.2 为准——核查后修正:这些文件是 FC 版当前代码(第 4 节版本说明已记录);v0.2 残留物是src/analysis.py、configs/tasks/{avalon,card_game,ltp,mind2web}.yaml(指向已删除的模块)、data/部分目录。 - [x] 行号细节修正:DB 容差 1e-2 在
result_processor.py:275(:45-46是浮点调用分支);ALFWorld 每步 reward 在task.py:184-194(:79-92是calculate_overall);overall.json 写于assigner.py:308-311(非:352-378内)。 - [ ] 不实际运行(需 docker + 数据集);机制描述以源码为准。
- [ ] 若引用 v0.2 的 DCG/LTP/Mind2Web 细节,注意当前仓库仅剩
configs/tasks/*.yaml残留配置,模块代码已删除(图 1 已按此标注)。