Codex 与 Claude Code 重度用户的开源提效栈
同一个仓库里同时打开 Codex 和 Claude Code,并不会自动得到两倍生产力。更常见的情况是:你开始维护 AGENTS.md 和 CLAUDE.md 两份规则,在新会话里重复解释架构背景,手动判断哪张任务没有 blocker,再从几个 worktree 中辨认哪一个真的跑过测试。
模型已经很会生成代码。重度用户真正消耗时间的地方,正在从“怎样写出这段代码”转移到另外几件事:怎样让两个 Agent 看到一致的工程事实,怎样让需求不只存在于聊天记录,怎样在上下文被压缩或会话被切换后恢复状态,怎样证明改动经过了真实系统边界,以及怎样阻止一个错误的工具调用接触不该接触的文件与网络。
这也是挑选 Codex、Claude Code 插件与配套工具时最容易走偏的地方。我们很容易安装更多 MCP、更多 Skills、更多子 Agent,然后发现上下文更拥挤、配置源更多、权限面更大,却说不清交付质量到底改善了什么。
我更愿意把一套提效工具按工程责任拆开:规则、规格、状态、检索、验收、并行、预算和隔离。每一层只保留一个事实源,只有出现真实瓶颈时才增加工具。本文调研的项目都提供开源仓库,但“仓库开源”不等于后端、数据与运行边界全部开放;项目自己声称的 token 节省和性能提升,也不会被当成独立事实。
先别装插件:原生 Agent 已经做了什么
截至 2026 年 8 月,Codex 与 Claude Code 都早已不只是一个能调用 Shell 的聊天框。Codex CLI 已提供项目指令、Skills、plugins、MCP、review、会话恢复与分叉,以及多档 sandbox policy;Claude Code 也提供 CLAUDE.md、Skills、plugins、MCP、hooks、subagents、worktree、权限模式和会话能力。1
这意味着,第三方工具若只是再包装一次文件读写、Shell 或对话入口,价值通常有限。真正值得引入的工具,至少要回答下面四个问题之一:
- 它是否保存了模型不应该靠上下文记忆的工程事实?
- 它是否建立了一个原生 Agent 尚未提供的验证或隔离边界?
- 换掉 Codex 或 Claude Code 后,产物是否仍然可读、可用?
- 安装失败、工具停更或团队不再采用时,能否明确退出?
可以把后面的工具栈理解为八个可替换层,而不是八个必装项目。
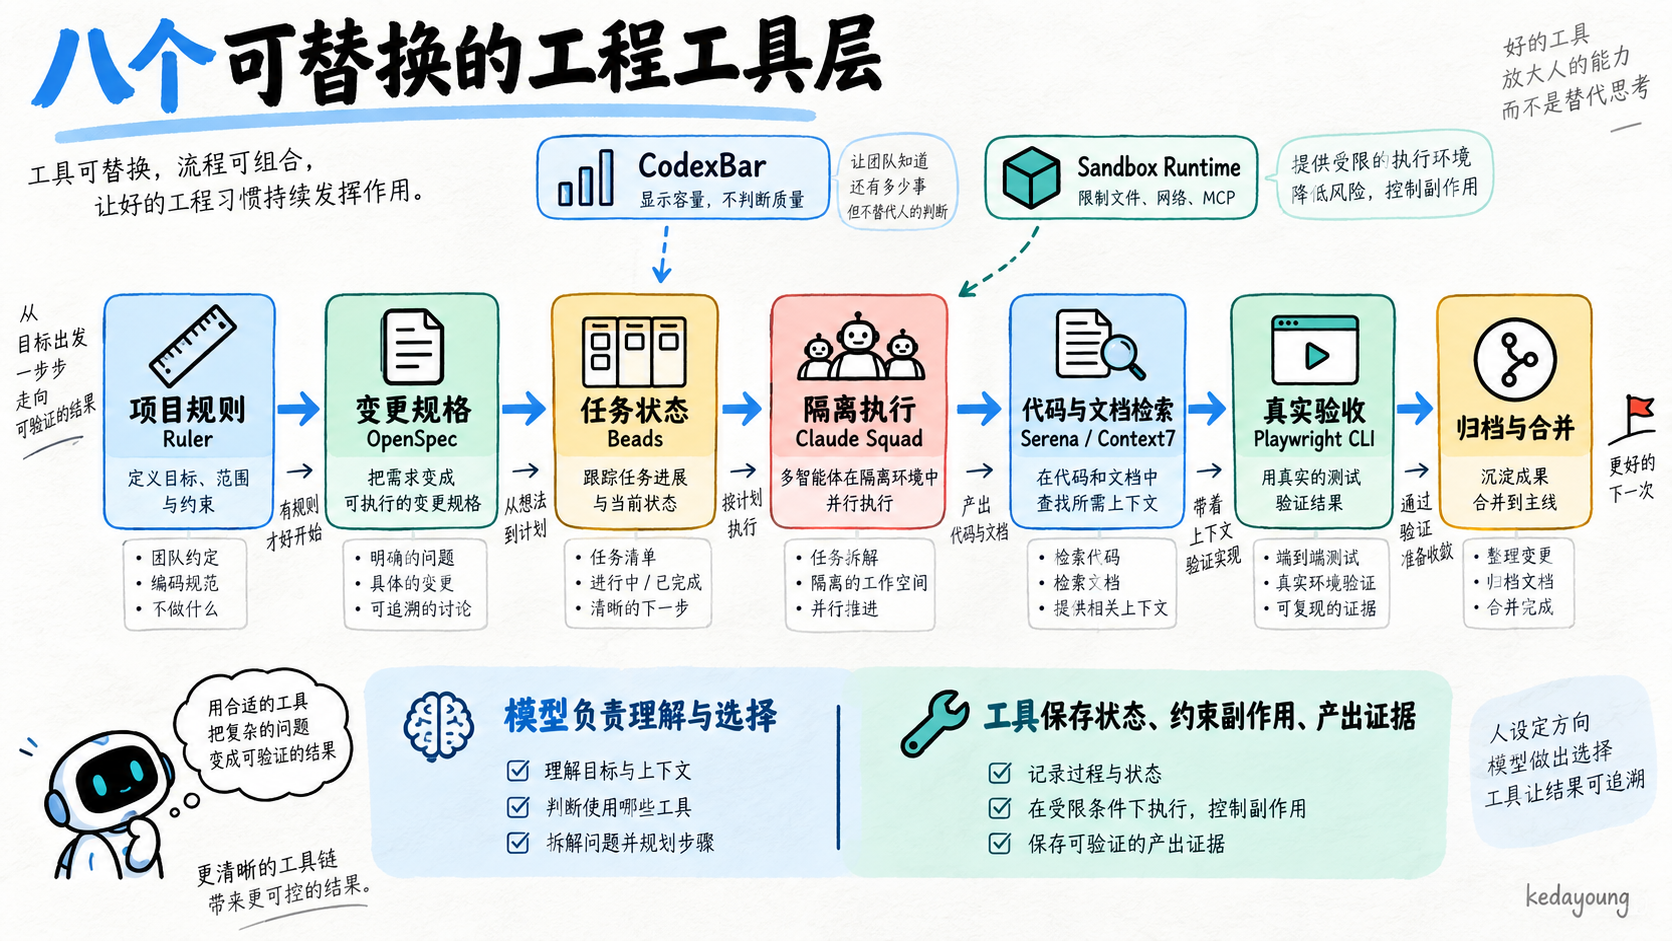
这条链里,模型仍然负责理解问题、选择实现和处理反馈;工具负责保存状态、约束副作用与产出证据。两者不能互相替代。
Ruler:先解决两套客户端的规则漂移
同时使用 Codex 与 Claude Code 时,最先出现的通常不是模型能力问题,而是配置漂移。同一条测试约定在 CLAUDE.md 里更新了,AGENTS.md 仍保留旧版本;Claude 安装了一个 Skill,Codex 只有一段简化后的提示;MCP 在用户级配置能用,换到项目会话却缺少入口。
Ruler 的做法很直接:将 .ruler/ 作为规则源,再生成不同 Agent 需要的文件。当前版本明确支持把规则写入 Claude Code 的 CLAUDE.md 和 Codex 的 AGENTS.md,也能传播项目级 MCP、Skills 和 subagent 配置。它提供 --dry-run、备份与 revert,适合先检查再落盘。2
npx @intellectronica/ruler init
npx @intellectronica/ruler apply --agents claude,codex --dry-run
npx @intellectronica/ruler apply --agents claude,codex
示例沿用项目的即时运行方式;团队落地时应固定已经评估过的 Ruler 版本,并把升级作为一次可审查的配置变更。
这里最重要的不是命令,而是所有权约定:.ruler/ 是唯一手工维护的源,生成后的 CLAUDE.md、AGENTS.md 和 Agent 专属目录不再各自演化。否则 Ruler 只会把两份真相变成三份。
Ruler 目前仍标注为 Beta Research Preview,nested rules、Skills 和 subagents 中也有实验性能力。我的采用顺序是先同步最短的项目规则,再同步 Skills,最后才考虑 MCP。MCP 配置不仅是 JSON 或 TOML,它可能包含命令、网络地址和凭据引用;生成器能避免格式漂移,却不能替你决定哪些 secret 可以进入仓库。
如果只能从本文挑一个工具试用,双客户端用户应先试 Ruler。它消除的是每天真实发生、而且容易验证的重复维护,不要求你先接受一套完整方法论。
OpenSpec:让需求离开聊天记录
规则一致以后,下一个问题是“这次究竟要改什么”。长对话里的需求会被摘要,新的 Agent 只看到被转述的背景,工程师也很难从一次完成声明追溯到最初的验收条件。
OpenSpec 将一次变更写成可版本控制的 change package:proposal.md 解释为什么做,specs/ 写需求与场景,design.md 记录技术方案,tasks.md 承载实施清单;完成后再 archive。它提供 explore、propose、apply、archive 等入口,并明确面向 brownfield 仓库和迭代式修改。3
这层的价值不是生成更多 Markdown,而是建立一个人工 gate:代码出现以前,人和 Agent 先对“范围、非目标、场景、兼容性和完成条件”达成一致。会话可以换,模型可以换,变更包仍然留在 Git 中。
不过,OpenSpec 不是唯一选择,也不应和所有规格工具一起装。
| 选择 | 更适合什么情况 | 主要代价 |
|---|---|---|
| OpenSpec | 已有仓库,希望轻量维护每次 change | 仍需自己定义任务调度与验收 gate |
| GitHub Spec Kit | 需要 constitution、specify、plan、tasks、analyze 等完整阶段治理 | 模板、阶段和产物更多,采用成本更高 |
| Superpowers | 希望直接采用 brainstorming、worktree、计划、TDD、review、分支收尾的强默认方法 | 会改变原有研发流程,不适合只取一个局部能力 |
Spec Kit 当前支持 30 多种 coding agent 集成,并将 constitution、spec、plan、tasks、implement 与可选的 clarify、analyze、checklist 组织为显式阶段;它还提供 extensions、presets 和 bundles。4 Superpowers 则是一套完整的软件开发方法论,明确要求 Agent 在任务前检查相关 Skill,并将设计、worktree、计划、子 Agent 执行、TDD、review 和分支收尾串成默认链路。5
三者都优秀,但不在同一粒度上。成熟 brownfield 项目通常先评估 OpenSpec;组织级合规与模板治理可以评估 Spec Kit;团队希望整体采用一套强工程纪律时,再评估 Superpowers。最差的组合是三套都启用,让 Agent 同时维护三份 plan、三组 tasks 和三种“完成”定义。
还需要注意一个很小但真实的边界:OpenSpec 默认收集命令名与版本的匿名 telemetry,官方说明不包含参数、路径和内容,并支持通过 OPENSPEC_TELEMETRY=0 或 DO_NOT_TRACK=1 关闭。团队在统一安装前应把这个选择写进基线,而不是留给每台机器自行决定。
Beads:把长任务从 Todo 列表变成依赖图
规格解决了“做什么”,没有解决“当前轮到谁”。当任务跨越数天、多个会话或多个 Agent,Markdown checklist 很快暴露三个问题:blocker 只能靠人脑计算,两个人可能同时拿走同一任务,旧会话中的发现很难回到下一次执行入口。
Beads 是面向 Agent 的图式 issue tracker。它用 Dolt 保存任务与关系,bd ready 返回没有开放 blocker 的任务,bd update --claim 原子认领,任务 close 后自动释放后继 frontier;当前还提供 bd setup codex 和 bd setup claude,把对应工作方式接入两个客户端。6
bd init
bd setup codex
bd setup claude
bd ready --json
Beads 与 OpenSpec 同时使用时,必须划清事实源:
- OpenSpec 负责需求、设计与验收场景,也就是“做什么才算对”。
- Beads 负责依赖、状态、认领与阻塞,也就是“现在谁可以做什么”。
tasks.md到 Beads task 应保留稳定映射,不在两边分别改需求文本。
Beads 也不是免费的“长期记忆”。当前实现引入 Dolt,默认 embedded 模式是单 writer,多 writer 需要 server 模式;官方文档专门说明升级备份、schema migration 和旧二进制读取新 schema 的风险。这个成本对多天、多 Agent 的任务是合理的,对一小时内能完成的小修则往往不值。短任务继续使用普通 checklist,并不会显得不够 Agentic。
Serena 与 Context7:把内部代码和外部知识分开找
Agent 在大仓库中浪费的上下文,常来自两种完全不同的检索问题。一种是“这个符号在哪里定义,谁引用它,重命名会影响什么”;另一种是“当前项目锁定的库版本应该怎样调用”。前者属于代码语义,后者属于外部文档,不该由同一个模糊的“记忆”层处理。
Serena 处理仓库内部的符号关系
Serena 通过 MCP 暴露符号级的 find、references、overview、rename 和 symbol body edit 等能力,默认使用 language server 作为语义后端。它明确支持 Claude Code、Codex CLI 等 MCP client,并在这些 harness 中通常关闭重叠的基础文件与 Shell 工具。7
这类能力在大型 Java 服务、TypeScript monorepo 或跨文件重构中很有价值:Agent 不必先读取几个完整文件,再用文本替换猜测引用关系。但它不应替代 rg。小仓库、配置文件、生成代码或语言服务器支持不完整的项目,原生搜索通常更直接。
Serena README 展示的效果评价主要来自项目设计的 Agent 自评。它可以说明值得试验,不能证明所有仓库都更快。更可靠的评估是挑选几项真实任务,对比工具调用次数、错误编辑、总时延和最终 diff,而不是让 Agent 回答“你喜不喜欢这个工具”。
Context7 处理版本敏感的依赖文档
Context7 提供 CLI + Skill 与 MCP 两种入口,根据 library ID 和问题提取版本相关的文档片段。它适合处理快速变化的框架配置、SDK 迁移和模型训练数据容易过期的 API。8
我不会把 Context7 设成所有问题的默认前置步骤。对仓库内已经存在的 API 用法,应先读锁文件、源码和现有调用;只有遇到版本敏感的外部接口时才检索。对于安全、支付、数据库迁移等高风险变更,检索结果只用来定位,最终仍回到依赖项目的官方原文和当前版本源码。
它还有一个容易被“开源工具”四个字掩盖的边界:Context7 仓库开放了 MCP server 源码,但 README 明确说明 API backend、解析与抓取引擎并未开源,社区贡献文档也不保证准确、完整或安全。更准确的称呼是“开放客户端配托管检索服务”,而不是完全本地、完整开源的知识库。
Playwright CLI:把 Agent 的“完成”改成浏览器证据
许多 coding task 在单元测试通过后仍没有真正完成。登录状态没有持久化,SSE 只在 mock 下工作,错误提示被遮住,移动视口按钮不可见,接口返回 200 但页面没有更新。Agent 说“测试通过”时,往往只是它选择的那层反馈通过了。
微软同时维护 Playwright MCP 与 Playwright CLI。当前官方 README 对 coding agent 更推荐 CLI + Skills,理由是 CLI 不需要常驻大量 MCP schema 和 accessibility tree;MCP 仍适合需要持续浏览器状态、丰富结构探索和长期 Agent loop 的场景。9
这个取舍很重要:不是所有能力都应该变成 MCP。当 Shell 已经是稳定、可观察、可脚本化的公共接口时,CLI + Skill 通常更容易按需加载,也更容易在 CI 中复现。
一条可信的浏览器验收至少应包含:
- 从真实入口完成正常用户路径,而不是直接调用内部函数。
- 覆盖至少一个失败路径,例如未授权、超时、空数据或服务错误。
- 检查关键 API、SSE/WebSocket、控制台错误和最终持久化状态。
- 在目标桌面与移动视口检查布局,并为关键状态保留 screenshot 或 trace。
- 把可复现的稳定路径沉淀为项目测试,而不是永远依赖 Agent 临时点击。
Playwright 的 accessibility snapshot 能帮助 Agent 稳定定位元素,却不等于像素级视觉验证。字体错位、遮挡、canvas 空白和响应式裁切仍要结合截图、像素检查或人工审查。真实浏览器也不等于生产验证:本地 mock、测试 API 和线上环境的证据必须分别标注。
Claude Squad:并行的单位是 worktree,不是窗口
当单 Agent 的反馈闭环已经稳定,人们自然会问能否同时跑多个 Codex 或 Claude Code。Claude Squad 用 tmux 管多个终端 Agent,并为每项任务创建独立 git worktree;它支持 Claude Code、Codex 等本地 Agent,提供会话管理与 diff 预览。10
这种工具解决了进程与文件工作区隔离,但没有解决任务设计。两个 worktree 不会发生文件写入竞争,仍可能同时修改同一个公共接口、生成互不兼容的 migration,或者在各自分支通过测试后集成失败。
并行前应满足四个条件:
- 任务位于当前无 blocker 的 frontier。
- 每项任务能在自己的公共 seam 独立验收。
- 共享模块和 schema 的冲突风险已被识别。
- 有明确的合并顺序与最终集成责任人。
Claude Squad 提供实验性的 --autoyes,可以自动接受 Agent 提示。我不会把它作为默认配置。自动确认并没有降低副作用,只是移除了人观察副作用的机会。需要无人值守时,应先用外部 sandbox、最小凭据、独立 worktree 和可重跑验收接住风险。
CodexBar:额度是容量信号,不是质量指标
订阅制 Agent 的一个现实问题是容量窗口。一个长任务在剩余额度很低时启动,可能在最需要 review 或集成验证时中断;多个 Provider 并用时,工程师也很难快速判断哪个当前有容量。
CodexBar 是 macOS 菜单栏应用,并提供 macOS/Linux CLI,可以显示 Codex、Claude 等多个 Provider 的使用窗口、重置时间和部分本地成本估算。11 它适合回答“现在是否适合启动长任务”,不适合回答“哪个 Agent 写出的代码更好”。token 少可能是检索更准,也可能是验证被省略;token 多可能是浪费,也可能是在跑必要的回归。
安装前还要做一次凭据审查。CodexBar 的 Codex 数据源可能读取 ~/.codex/auth.json、调用本地 app-server、扫描 session 日志,或者在用户显式开启后读取浏览器 Cookie;Claude 数据源也可能访问 OAuth、Keychain、CLI、日志或 Web Cookie。“不保存密码”不等于“不接触凭据”。个人 Mac 与受管团队设备应采用不同策略,能用 CLI/RPC 和本地估算解决时,不必默认开放 Cookie 读取。
Sandbox Runtime:真正的安全边界必须在 Agent 之外
Codex 与 Claude Code 都有权限和 sandbox 能力,但第三方 MCP、外部命令、无人值守会话仍可能扩大边界。尤其是 MCP server,它不是一段被动提示词,而是一个会在本机启动、读取文件、访问网络的进程。
Anthropic Sandbox Runtime 可以包装 Agent、MCP server、Bash 或任意进程,限制文件系统、网络和 Unix socket。它在 macOS 使用 Seatbelt,在 Linux 使用 bubblewrap 与 network namespace,在 Windows 使用独立本地账户与 WFP egress fence;网络采用 allow-only,写入默认拒绝。12
{
  "mcpServers": {
    "filesystem": {
      "command": "srt",
      "args": ["npx", "-y", "@modelcontextprotocol/server-filesystem", "."]
    }
  }
}
示例沿用 Sandbox Runtime 文档中的 filesystem MCP 包装方式;实际项目还应固定 MCP 包版本,并在用户级 SRT 配置中明确允许读取、写入与联网的范围。
这类边界比在项目规则里写“不要读取 .env”可靠,因为拒绝发生在进程执行层。但 Sandbox Runtime 仍是 Beta Research Preview,并存在平台差异:Linux glob、Unix socket、嵌套 sandbox、Apple Events 等配置都有特殊语义。允许 Docker socket、Apple Events 或全网络以后,隔离可能被实质放宽。
我的原则是:项目仓库可以声明它需要什么,不能自行决定放宽用户级 sandbox。高风险自动化仍应优先运行在 devcontainer、受控 runner 或 VM 中;轻量 runtime 更适合收紧单个 MCP 与命令,不应被宣传成所有场景下的完整容器替代品。
一条可以落地的日常链路
工具只有串到同一条证据链里才会产生复利。下面是一条适合中型 brownfield 功能的组合方式:
1. 同步规则,但先看 diff
工程师在 .ruler/ 中维护项目边界、测试入口、敏感文件和交付约定,运行 ruler apply --dry-run,确认只生成预期的 Claude/Codex 配置。规则只保存稳定约束,不把本次需求塞进长期上下文。
2. 建立 change package
用 OpenSpec explore/propose 形成 proposal、scenarios、design 和 tasks。人在此处批准范围、非目标、数据迁移、权限和验收 seam。没有批准,Agent 不进入实现。
3. 只有跨会话时才建立任务图
任务若一天内完成,继续用 change package 的 checklist。若跨天、存在依赖或需要多 Agent,将 tasks 映射到 Beads,建立 blocker,并通过 bd ready 计算当前 frontier。
4. 并行只分配 ready task
Claude Squad 为可并行任务创建独立 worktree。每个会话只获得自己的任务、相关规格、验证命令和限制,不复制整段主会话历史。修改公共 schema 的任务保留串行。
5. 分开取上下文
Agent 先用原生搜索探索;跨符号、跨模块时调用 Serena;碰到锁定版本的外部 API 再调用 Context7。检索结果必须指向代码或文档来源,不能直接沉淀成无来源“记忆”。
6. 从局部测试走到真实 seam
每个 worktree 先跑局部测试与静态检查。集成分支再用 Playwright CLI 经过真实应用入口,检查正常/失败路径、关键 API、控制台和视口;保存可诊断但不含 secret 的 trace、截图和结果摘要。
7. 证据通过后才回写状态
只有规格场景和回归测试都通过,任务才 close,OpenSpec change 才 archive,分支才进入合并。Agent 的文字总结不是解除 blocker 的证据,实际测试结果和可检查产物才是。
整个过程里,CodexBar 只提供容量信息;Sandbox Runtime、容器或 VM 负责权限边界。预算与安全贯穿链路,却都不改变“什么叫完成”。
三阶段采用,不要一次装满工具箱
一口气安装十几个 MCP,通常不会建立系统,只会建立一片尚未评估的供应链。更实际的采用顺序是从最便宜、最容易观测的收益开始。
第一阶段:规则一致性与真实验收
先引入 Ruler 和 Playwright CLI。选择一个两个 Agent 都经常修改的仓库,观察规则漂移是否减少、浏览器验收是否抓到原测试未发现的问题。已有测试继续作为主验证,不为了“Agent 原生”重写成新框架。
第二阶段:让变更可追溯
当需求经常跨会话或需要 review 时,引入 OpenSpec。只保留一套 change template,经过几次真实迭代后再决定是否需要 Spec Kit 的更完整治理或 Superpowers 的强默认方法论。
第三阶段:有调度问题后再并行
只有出现长任务、blocker 和可并行 frontier,才引入 Beads 与 Claude Squad。仓库足够大、符号检索确实昂贵时再加 Serena;版本敏感的依赖任务再按需使用 Context7。不要为了证明多 Agent 有用,先把一个本可串行完成的任务拆碎。
每增加一个工具,都应该留下五项记录:要改善的基线、成功指标、权限面、维护 owner、撤回方法。一个月后说不清它减少了什么,就应考虑移除。
三类工具,我不会默认全局开启
自动持久记忆
以 claude-mem 为例,这类工具会捕获工具使用观察、生成摘要,并通过 SQLite、全文/向量检索在未来会话中注入;项目还提供 Web Viewer 和可选 cloud sync。13 这可能缓解跨会话遗忘,也意味着更多项目历史被持续保存。
<private> 标签是一种主动排除机制,不是数据治理。启用前至少要明确:哪些仓库允许采集,secret 与客户数据怎样排除,记忆保留多久,谁能搜索,怎样完整删除或导出。若这些问题没有答案,一份精简、带来源、受版本控制的 handoff 往往更安全。
命令输出压缩
RTK 一类工具通过 hook 或 Agent 指令重写 Shell 命令,把测试、Git、构建输出压缩后再交给模型。项目宣称可显著减少 token,并在失败时保留完整输出文件。14
这条思路有价值,但百分比是项目方口径。过滤器可能同时移除 warning、顺序信息或少见失败细节;Claude Code 可用 hook 拦截,而 Codex 的集成可能主要依赖说明,行为也不完全对称。应先拿团队自己的失败日志、测试框架和 CI 输出做回归,再决定是否全局启用,并核对 telemetry 与完整日志保存位置。
Provider、账号与 Cookie 切换
多 Provider 路由、账号切换和代理工具看起来只是在“充分使用额度”,实际上会同时改变身份、计费、数据驻留、fallback 与凭据路径。个人实验可以在隔离环境中评估;企业代码库不能把它当作普通主题插件。任何自动 fallback 都必须回答:数据发给了谁,失败时是否跨 Provider,哪份凭据被读取,审计记录在哪里。
结语:提效的终点是减少不确定性
对 Codex 与 Claude Code 的重度用户,最有价值的插件通常不是让 Agent 再多一个动作,而是让工程师少做一次重复解释、少维护一份漂移配置、少相信一次没有证据的完成声明。
我的最小推荐顺序是:
规则一致性 -> 变更规格 -> 真实验收 -> 跨会话状态 -> 安全并行
Ruler 先统一两个客户端看到的稳定事实,OpenSpec 让每次 change 可审查,Playwright CLI 将完成声明拉到真实浏览器 seam;只有任务开始跨会话,才加入 Beads;只有依赖图出现可并行 frontier,才加入 Claude Squad。Serena、Context7、CodexBar 与更强 sandbox 都按仓库规模、依赖变化、额度形态和风险等级添加。
判断一套工具栈是否成熟,可以问一个很朴素的问题:明天把 Codex 换成 Claude Code,或者反过来,规则、规格、任务状态和验收证据还在吗?
如果答案是肯定的,提效就不再依赖某个模型刚好记住了什么。模型负责当下的推理,工具负责工程事实,验证负责决定能否交付,权限边界负责保证一次错误不会越过它本应停止的位置。