中心论点:caveman compression 用一条简洁原则做语义压缩——「只移除 LLM 能可靠重建的内容(语法词/连接词/填充词),保留不可预测内容(数字/专名/术语)」;三条实现路径恰好构成「提示词工程 / 概率删除 / 规则删除」的横向对比,是上下文工程里少见的可教学压缩框架。但它的所有效果数字都是作者自报、样本极小、token 统计是字符/4 近似——本文用真实 tokenizer 重算后,声称的 40% 平均节省实为约 36%,「lossless」更未经验证。它作为文章的价值一半在机制、一半在「如何批判性验证压缩方法」的方法论示范。 证据说明:文中「caveman compression」指
wilpel/caveman-compression仓库,证据一律引用本地克隆20260810-caveman-compression/repo/,行号以该克隆当前内容为准;正文引用的 [n] 对应附录 B 的仓库证据位置,独立重算方法见附录 C。
引言:先看数字,再看机制
GitHub 上有这样一个仓库:README 第一行就宣称自己是 Lossless semantic compression for LLM contexts(无损的 LLM 上下文语义压缩),标语只有八个词——Strip grammar. Keep facts. Save tokens.(剥掉语法,留住事实,省下 token)[1]。它给出的示例很直观:一段 70 token 的英文说明,被压成 50 token,标注「29% reduction」[2](数字为仓库自报口径,未附复现)。
如果只看这些数字,这像又一个「省 40% token 的魔法工具」。但把数字拆开看,故事就变得更有意思了:
- 声称 58% 压缩率的 System Prompt 示例,原文 171 token、压缩后 72 token——这两个数字恰好等于字符数除以 4 的整数除法结果(684÷4=171,291÷4=72)[3];
- README 示例小节末尾写着「All examples validated with GPT-4o」,却没有任何脚本或报告佐证这次「validation」[4];
- 「lossless」的验证算法只存在于规范文档 SPEC.md 里,仓库没有任何自动化测试持续跑它[5]。
换句话说:这个项目的机制设计相当漂亮,但它的数字需要打上几个问号。而恰恰是这种「好想法 + 弱验证」的组合,让它成为研究上下文压缩时极有价值的教学样本——本文按「原理 → 三条实现 → 质量自检 → 批判性审视 → 与其它路线对照 → 可迁移经验」的顺序展开,其中第 4 节会用真实 tokenizer 独立重算仓库的示例。
1. 一条原则:可预测性即压缩空间
1.1 核心洞察
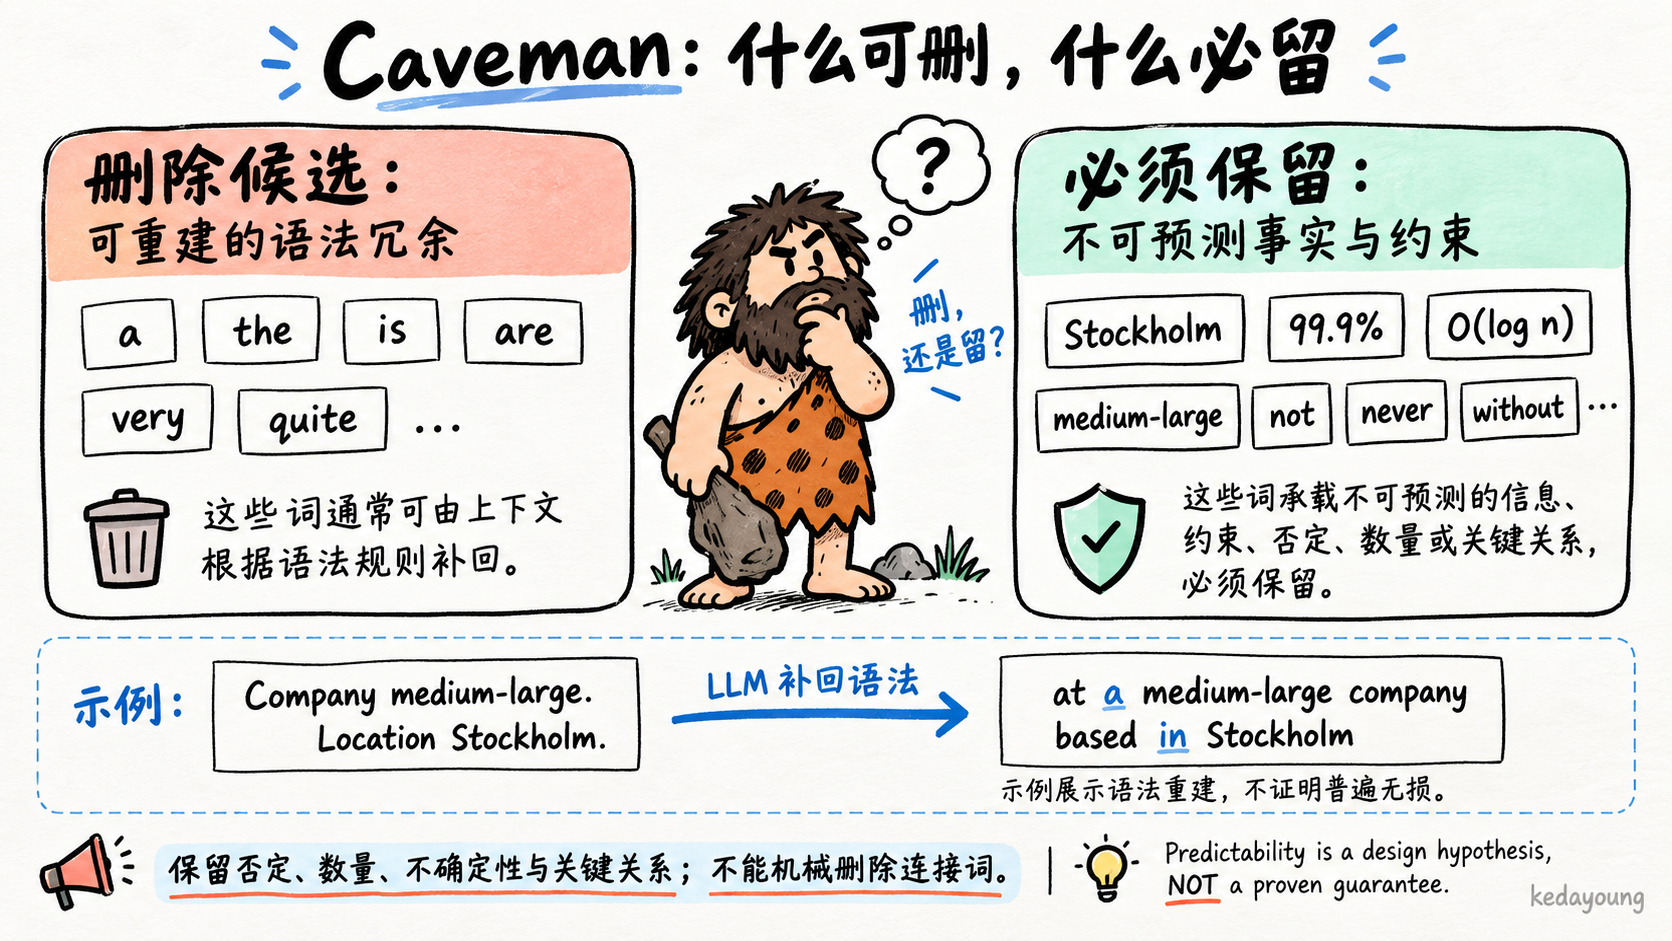
caveman compression 的出发点是一个关于 LLM 的观察(README.md:33-47):这类模型极其擅长「填补语言空缺」——给一段缺了冠词、连接词、被动式的文字,能毫无困难地补回完整语法。于是问题从「怎么压缩」变成「哪些内容删掉之后,LLM 还能可靠地重建?」
答案分为两类:
- 可重建 → 删:语法词(a / the / is / are)、连接词(therefore / however / because)、被动结构(is calculated by)、填充词(very / quite / essentially);
- 不可预测 → 留:数字、人名、日期、技术术语(O(log n)、binary search)、约束条件(medium-large、frequently accessed)、具体细节(Stockholm、99.9% uptime)。
SPEC.md:9 把同一原理写成正式表述:Remove only what LLMs can deterministically reconstruct——只删 LLM 能确定性重建的内容。README 里给了一个生动对照:
Compressed:   "Company medium-large. Location Stockholm."
Decompressed: "at a medium-large company based in Stockholm"
↑ grammar added, facts unchanged ↑语法被补回来了,事实一个没动[6]。这就是「可预测性即压缩空间」:压缩率的来源不是信息的丢弃,而是语言冗余度的让渡——把 LLM 本来就「猜得到」的部分删掉,信息论意义上的熵并没有损失多少。
1.2 两个应用场景(均为作者自报)
README 在 Use Cases 一节给出两个落地场景[7]:
- RAG 知识库压缩(199→118 token,作者自报 41%):把文档压缩后存进向量库,agent 直接消费 caveman 格式的检索结果,「不需要解压,agent 本来就能理解这种格式」,从而「Fits 2-3x more context」;
- Agent 内部推理(196→102 token,作者自报 48%):让 agent 的思维链(CoT)直接用 caveman 格式思考,声称「CoT uses 50% fewer tokens」——注意这与场景标题的 48% 口径略有出入,两处均为作者自报。
两个数字都是仓库自报,没有独立的 token 统计复现,我们在第 4 节会看到这种「自报」的误差量级。
1.3 思想来源
README 末尾注明灵感来自 TOON 与 token-optimization 运动[8];SPEC 的参考文献则把原理锚定到信息论(Shannon entropy)与受控自然语言(Simplified English、ASD-STE100)[9]。这条谱系值得留意:caveman 本质上是把「受控自然语言」的思想从「让人写得更规范」迁移到「让机器压得更狠」——规范是给压缩过程用的,不是给作者用的。
2. 三条实现路径:提示词 / 概率 / 规则
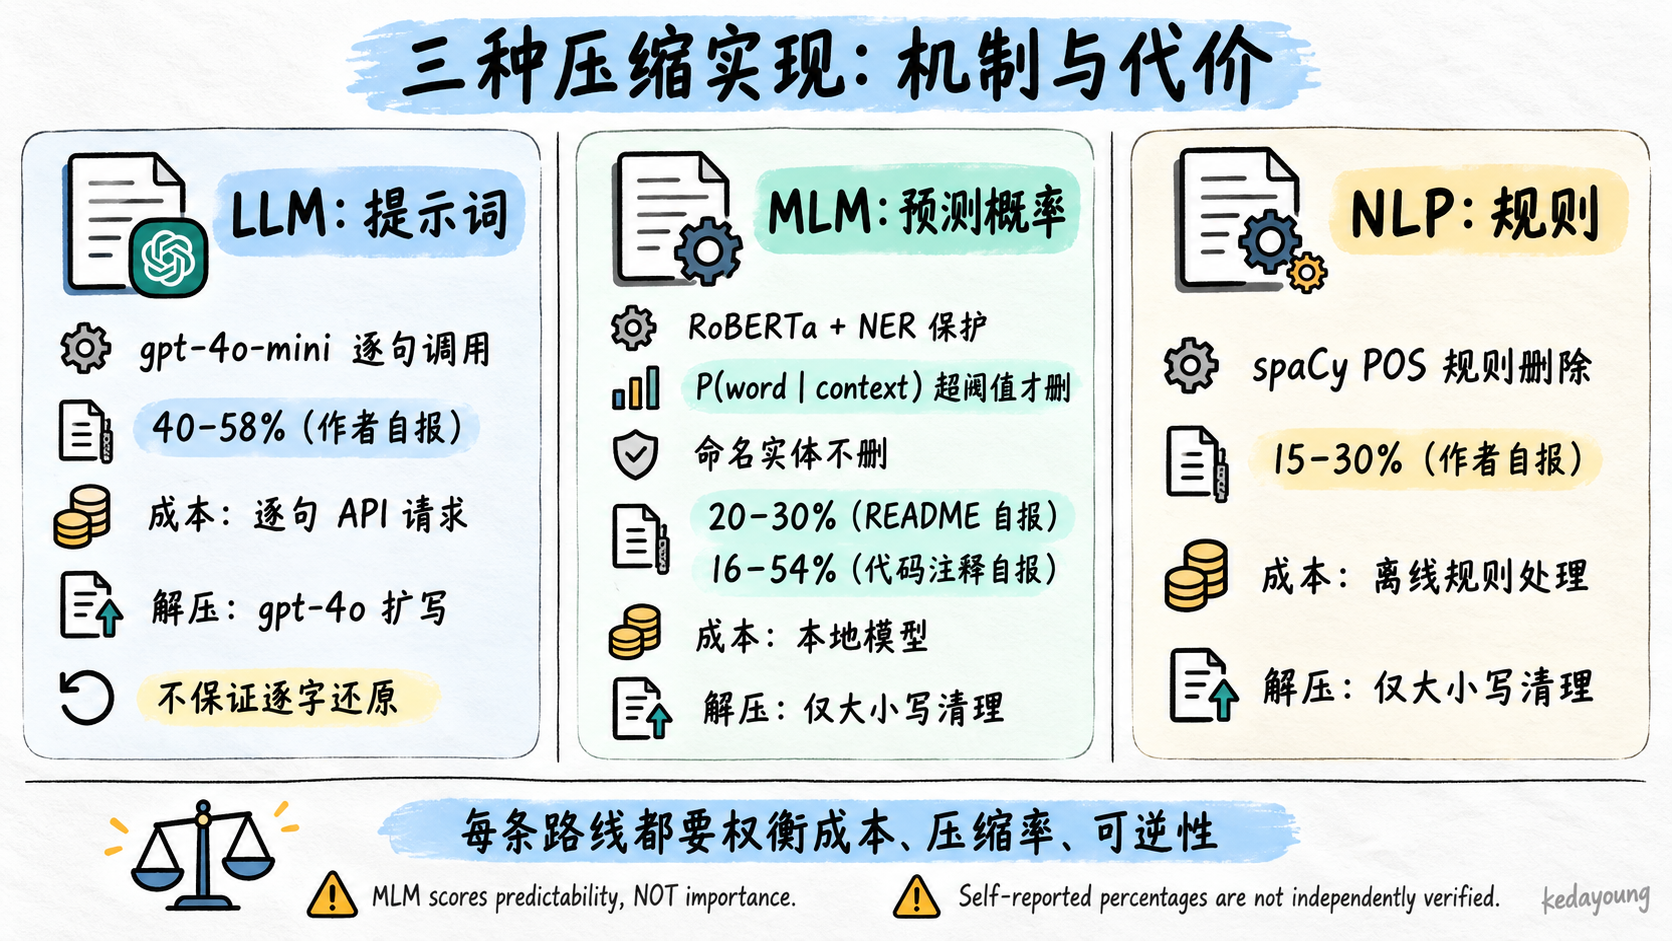
同一句「删可重建、留不可预测」,仓库用三种完全不同的机制实现了三遍。这是本项目最可教学的部分——它把「压缩」从单一手法变成了一个可横向比较的设计空间。
2.1 LLM 版:提示词即压缩器(caveman_compress.py)
这个版本没有词典、没有规则模板,压缩逻辑全部住在提示词里。prompts/compression.txt 的核心是两份清单[10]:
- ALWAYS REMOVE:冠词(a/an/the)、助动词(is/are/was/were/have/has/do/does)、常见介词(of/for/to/in/on/at,语义清晰时)、上下文明确的代词、纯加强词(very/quite/really/extremely);
- ALWAYS KEEP:所有名词、主要动词、有意义的形容词、所有数字与量词(at least / approximately / 15 / many)、不确定性限定词(what sounded like / appears to / seems / might)、改变语义的关键介词(from / with / without)、时间频率词、人名头衔、技术术语。
提示词还要求「BE SMART ABOUT」:介词在表达关系时保留("made from wood" 保留 from,"system for processing" 删 for);否定词(not/no/never/without)永远保留。
执行流程(caveman_compress.py:132-202)[11]:
- 先用启发式判断输入是自然语言还是代码(
:59-83,检测 def/class/import/=> 等代码特征); - 自然语言路径:用 spaCy 分句(
:86-90),逐句调用gpt-4o-mini,temperature=0.3 压缩(:157-175); - 代码路径:若判定为代码/结构化数据,则整段交给
gpt-4o(:144-155),不走逐句路径; - 压缩后用
text-embedding-3-large计算压缩前后 embedding 余弦相似度,做质量自检(:118-129)。
成本与收益:README 自报压缩率 40-58%,速度约 2 秒/请求,需要 OpenAI API key[12]。注意它是「逐句调用」——一段 20 句的文本就是 20 次 gpt-4o-mini 请求,成本结构是「句子数 × 单句费用」;它划算的场景边界,我们在第 6 节再讨论。
2.2 MLM 版:用概率做删词决策(caveman_compress_mlm.py)
这个版本把「可预测性」直接变成可计算量:用 RoBERTa 掩码语言模型算 P(word | context),超过阈值就删[13]。
- 阈值即档位(代码注释自报;其中「准确率」的测量口径未说明):P≥1e-3 保守档 16% 压缩/98% 准确率;P≥1e-4 中档 19%/97%;P≥1e-5 平衡档 32%/92%(默认);P≥1e-6 激进档 54%/83%[14];
- NER 保护:spaCy 识别出的命名实体(PERSON/ORG/GPE/DATE/MONEY/PERCENT/TIME/QUANTITY/CARDINAL/ORDINAL 等)无论概率多高都不删[15]——这是「保留不可预测内容」的规则化表达;
- 可选
--no-adjacent:两个相邻词同时超阈值时只删概率更高的那个,避免连删造成残句[16]。
它的「解压」是诚实的:只做大小写清理,注释里自承「真正的解压需要 LLM 重建被删 token,这只是基础格式化」[17]。这意味着 MLM 版的产物是「给 LLM 看的压缩文本」,不是可逆编码。
2.3 NLP 版:纯规则删除(caveman_compress_nlp.py)
最便宜也最粗的一条路:spaCy 解析后按 POS 标签规则删[18]。删标点(但保留 - / : % $ € £ 等有信息量的)、删停用词、删 AUX(助动词)、删 DET(限定词)、删副词黑名单(very/really/quite/… 16 个)、删部分 CCONJ(and/or);其余名词/动词/形容词/数字/专名一律保留。它支持 15+ 种语言(en/es/de/fr/it/pt/nl/el/nb/lt/ja/zh/pl/ro/ru),自报压缩率 15-30%,速度 <100ms,完全离线[19]。
2.4 设计含义:一个三角权衡样本
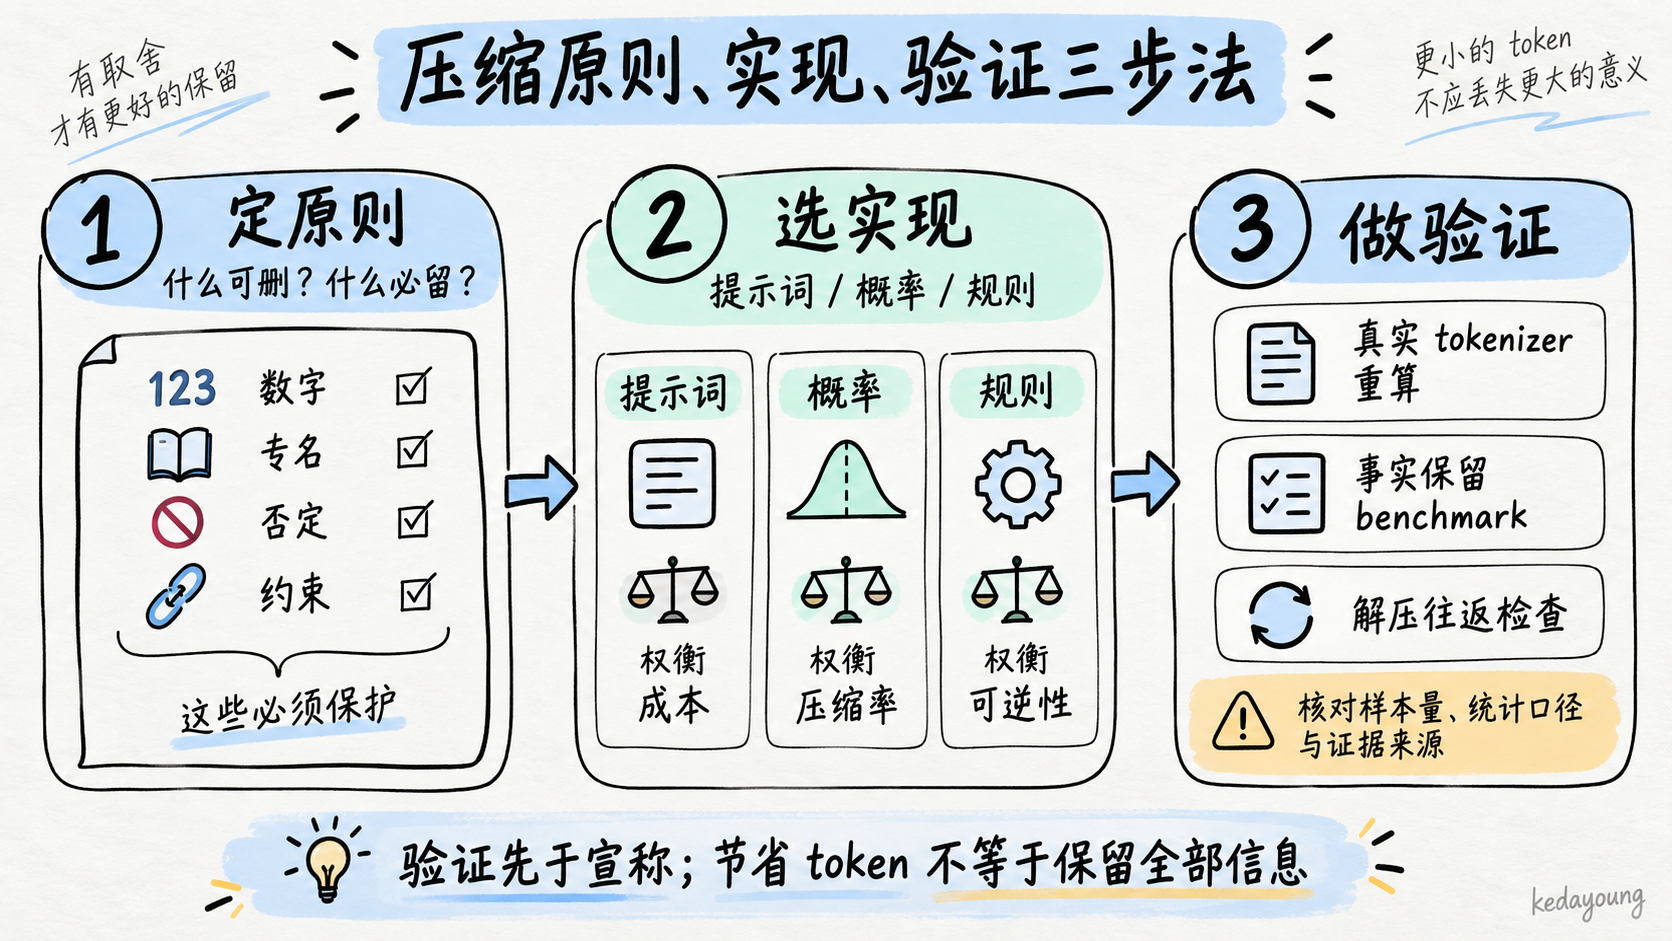
把三条路径放在一起,它们其实是「成本 ↔ 压缩率 ↔ 可逆性」三角的三个采样点:
| 路径 | 机制 | 压缩率(作者自报) | 成本 | 可逆性 |
|---|---|---|---|---|
| LLM 版 | 提示词 + gpt-4o-mini 逐句 | 40-58% | OpenAI API,逐句调用 | 有真解压(gpt-4o 扩写) |
| MLM 版 | RoBERTa 概率阈值 + NER 保护 | 20-30%(README 口径)/ 16-54%(代码注释口径) | 本地模型(~500MB) | 无(仅大小写清理) |
| NLP 版 | spaCy POS 规则删除 | 15-30% | 近乎为零,<100ms | 无(仅大小写清理) |
任何想自己设计压缩方案的人,都可以先在这个三角里选坐标:要极致省 token 且预算充足 → LLM 版;要离线、可预测、能解释每次删除 → 规则版;要在压缩率与成本之间取平衡 → 概率版。这比「用一个黑盒压缩器」可教得多——三种机制对应三种对「什么该删」的不同建模粒度。
3. 质量自检与解压:闭环设计
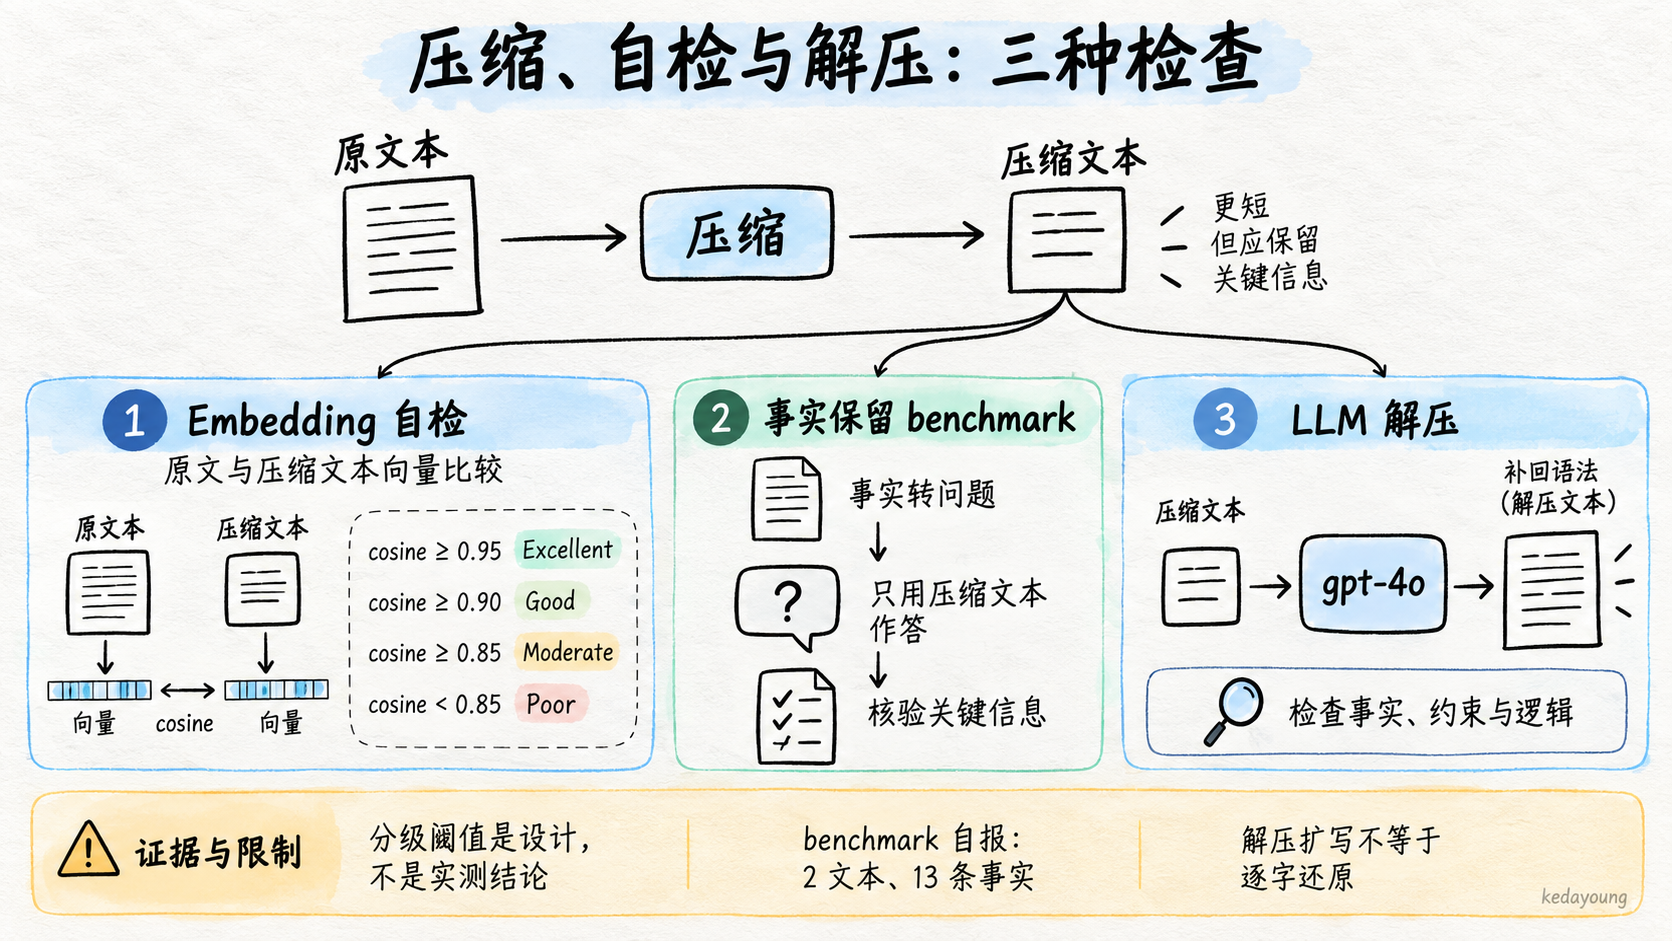
一个压缩工具如果只管压缩、不管「压完有没有丢东西」,在工程上是不完整的。caveman 在这方面做得比大多数同类项目好——它自带两套质量检查和一个解压器,构成了「压缩 → 自检 → 解压」的闭环。
3.1 embedding 相似度自检
compress_text() 压缩完成后,调用 calculate_embedding_loss()[20]:分别对原文和压缩文本生成 text-embedding-3-large 向量,算余弦相似度,loss = 1 − similarity。CLI 按相似度分级输出质量结论[21]:
- ≥0.95:Excellent,语义几乎一致;
- ≥0.90:Good,轻微语义漂移;
- ≥0.85:Moderate,可感知漂移;
- <0.85:Poor,显著漂移。
注意仓库的自承
embedding benchmark 的 README 写的是「Expected Results」——即「高质量压缩应维持 cosine ≥0.90」是一种预期,不是跑出来的实测数据[22]。也就是说,相似度分级是「设计目标」,不是「已证结果」。
3.2 LLM 解压
decompress_text() 用 prompts/decompression.txt 让 gpt-4o 把 caveman 文本扩写成自然英语[23]:补回连词、冠词、句长,同时「保持所有事实、约束与逻辑步骤」。这正是「可预测性即压缩空间」的镜像验证——如果压缩只删了可重建部分,解压就应该能补回来。
3.3 事实保留 benchmark
仓库提供了一个更严格的验证:不是「看起来像不像」,而是「事实能不能被重新取回」[24]。benchmark/factual_preservation/run_factual_benchmark.py 的流程是:把每条事实转成自然问题 → 让 LLM 只用压缩文本作答 → 再用第二个 LLM 严格核验答案是否包含原事实的全部关键信息(数字精确、人名在、引语逐字一致)[25]。
自报结果(benchmark/factual_preservation/README.md:79-98):2 个测试文本、13 条事实,13/13 保留(100%),平均字符压缩 18.6%(用例 comprehensive_report 12.2%、cat_basement_news 25.0%)。注意这个数字结构:样本极小(2 文本),且「压缩率 18.6%」远低于 README 主表声称的 40%——这组口径差异,我们放到第 4 节展开。
3.4 设计含义
压缩工具内置「质量自检 + 解压」闭环,是好实践——它把「压缩质量」从不可验证的口号变成了可观测的度量。但自检的可信度取决于自检的独立性:自检用的 embedding 模型、验证用的 LLM,与压缩用的 LLM 同属 OpenAI 一家;自检标准是作者自己定的;数字是作者自己跑的。这不是说它没价值,而是说它属于「设计合理的自证」,离「独立验证」还有一步。这一步怎么做,是第 4 节的主题。
4. 批判性审视:自报数字如何被验证
一个压缩方法声称「lossless / 省 40% token」,你该怎么检验?本节把 caveman 当案例,走一遍完整的验证流程——这也是本文作为「方法论示范」的核心。
4.1 数字溯源:声称的数字从哪来
先回答一个基础问题:README 表里的 token 数是怎么算出来的?
- README 主表:171→72、137→79、201→156,平均 40% 节省[26];
- 代码里的
count_tokens():return len(text.strip()) // 4,即字符数除以 4 的整数除法[27]——README 和两个压缩脚本用的都是这个近似,不是任何真实 tokenizer; - README 声称「All examples validated with GPT-4o」[4],但示例文件里没有留下任何 validation 记录,且示例文本长度与 token 数的关系恰好与 len//4 吻合。
本文独立重算
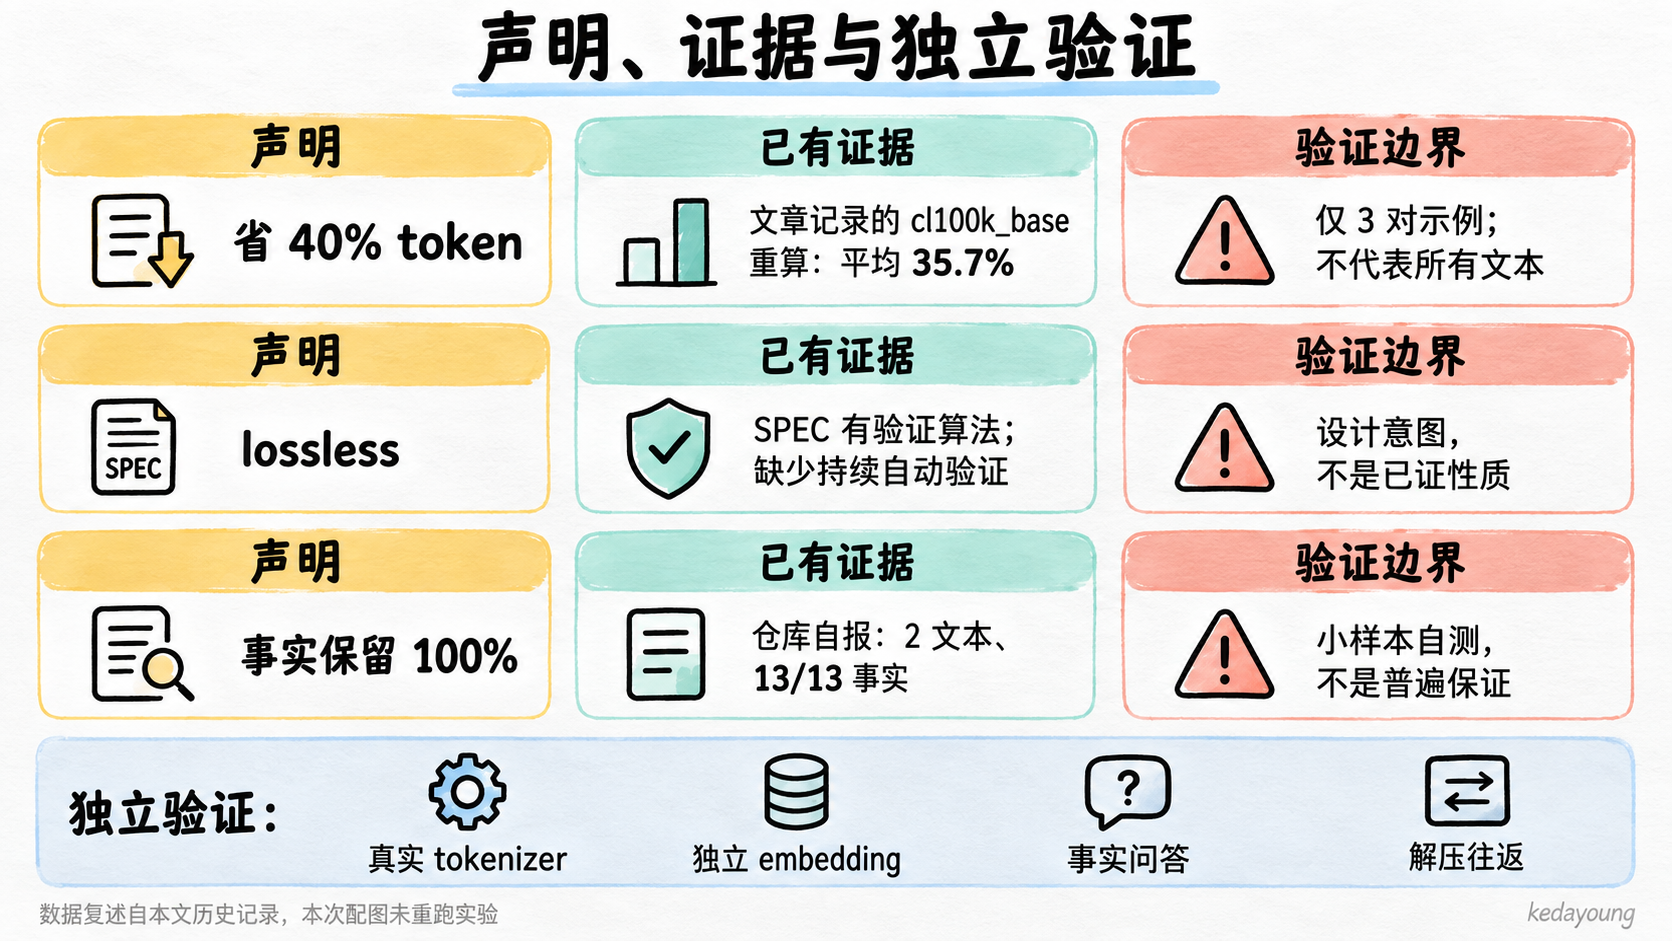
用 OpenAI 官方的 cl100k_base 编码(GPT-4 系列真实 tokenizer)对 examples/ 三个示例重算,结果如下(重算方法见附录 C):
| 案例 | README 声称(字符/4) | 真实 cl100k_base | 声称节省 | 真实节省 |
|---|---|---|---|---|
| System prompt | 171 → 72 | 114 → 52 | 58% | 54.4% |
| API 文档 | 137 → 79 | 98 → 57 | 42% | 41.8% |
| 简历 | 201 → 156 | 152 → 125 | 22% | 17.8% |
| 平均 | 170 → 102 | 121 → 78 | 40% | 35.7% |
(即便换用 gpt-4o 实际使用的 o200k_base 编码重算,方向与量级不变,见附录 C。)
三点结论:
- 方向没错:三个案例用真实 tokenizer 重算,确实都省了 18%–54% 的 token,「压缩有效」这个定性结论站得住;
- 幅度虚高:三个数字全部被高估,简历案例差 4.4 个百分点,平均差约 4 个百分点。原因很直观——字符/4 把 token 数按字符数线性估算,而压缩后的文本以高频短词为主、字符/token 比值更低,同样的估算偏差在更小的数字上被放大;
- README 的「validated with GPT-4o」不可复现:既然数字与 len//4 完全吻合,说明至少示例表的数字就是字符估算,「用 GPT-4o 验证」这句话没有对应的可复现证据。
4.2 「lossless」存疑
「Lossless semantic compression」是仓库的第一卖点,但检查验证设施会发现:
- SPEC.md:233-247 确实给出了验证算法(提取事实 → 对比事实集 → 检查逻辑链 → 测压缩率,接受标准:事实保留完整、逻辑完整、压缩率 ≥30%)——但它只是一份规范性文档;
- 仓库没有任何 CI、没有任何自动化脚本持续跑这个算法;唯一接近的 benchmark(事实保留)也只有 2 个文本、13 条事实的样本量;
- 因此「lossless」是自封口径:是设计意图 + 一次小样本自测,不是被持续验证的性质。
4.3 独立验证路径(可复用的方法论)
从上面的审查里,可以抽出四条任何压缩方法都适用的验证路径:
- 用真实 tokenizer 重算 token 节省——本文即示范:字符/4 近似在短句化压缩上系统性高估节省率,必须用目标模型的真实编码重算;
- 独立复算 embedding 相似度——用与仓库无关的 embedding 配置复算压缩前后相似度,而不是采信「Expected Results」;
- 检验解压可逆性——压缩 → 解压 → 语义保持?事实保留 benchmark 的思路(事实转问题、只用压缩文本作答)可以推广成「压缩-解压往返」的自动测试;
- 检查样本与口径——问三个问题:样本多大?数字是跑出来的还是估出来的?「验证」是可复现脚本还是 README 一句话?
4.4 作者判断
综合来看,本项目的价值不在数字,而在机制:「一条原则 + 三种实现 + 自检设计」是压缩方法设计的完整案例;数字是论证的起点,不是结论。对一个以教学/启发为目的的开源项目,「数字偏乐观」不致命——但对任何要把它搬进生产的人,上面的重算差异(40% vs 35.7%)足以提醒:采信任何压缩率之前,先自己数一遍 token。
5. 与其它压缩路线的对照
caveman(删词)不是上下文压缩的唯一思路。把它放进谱系里看,它的位置才清晰。
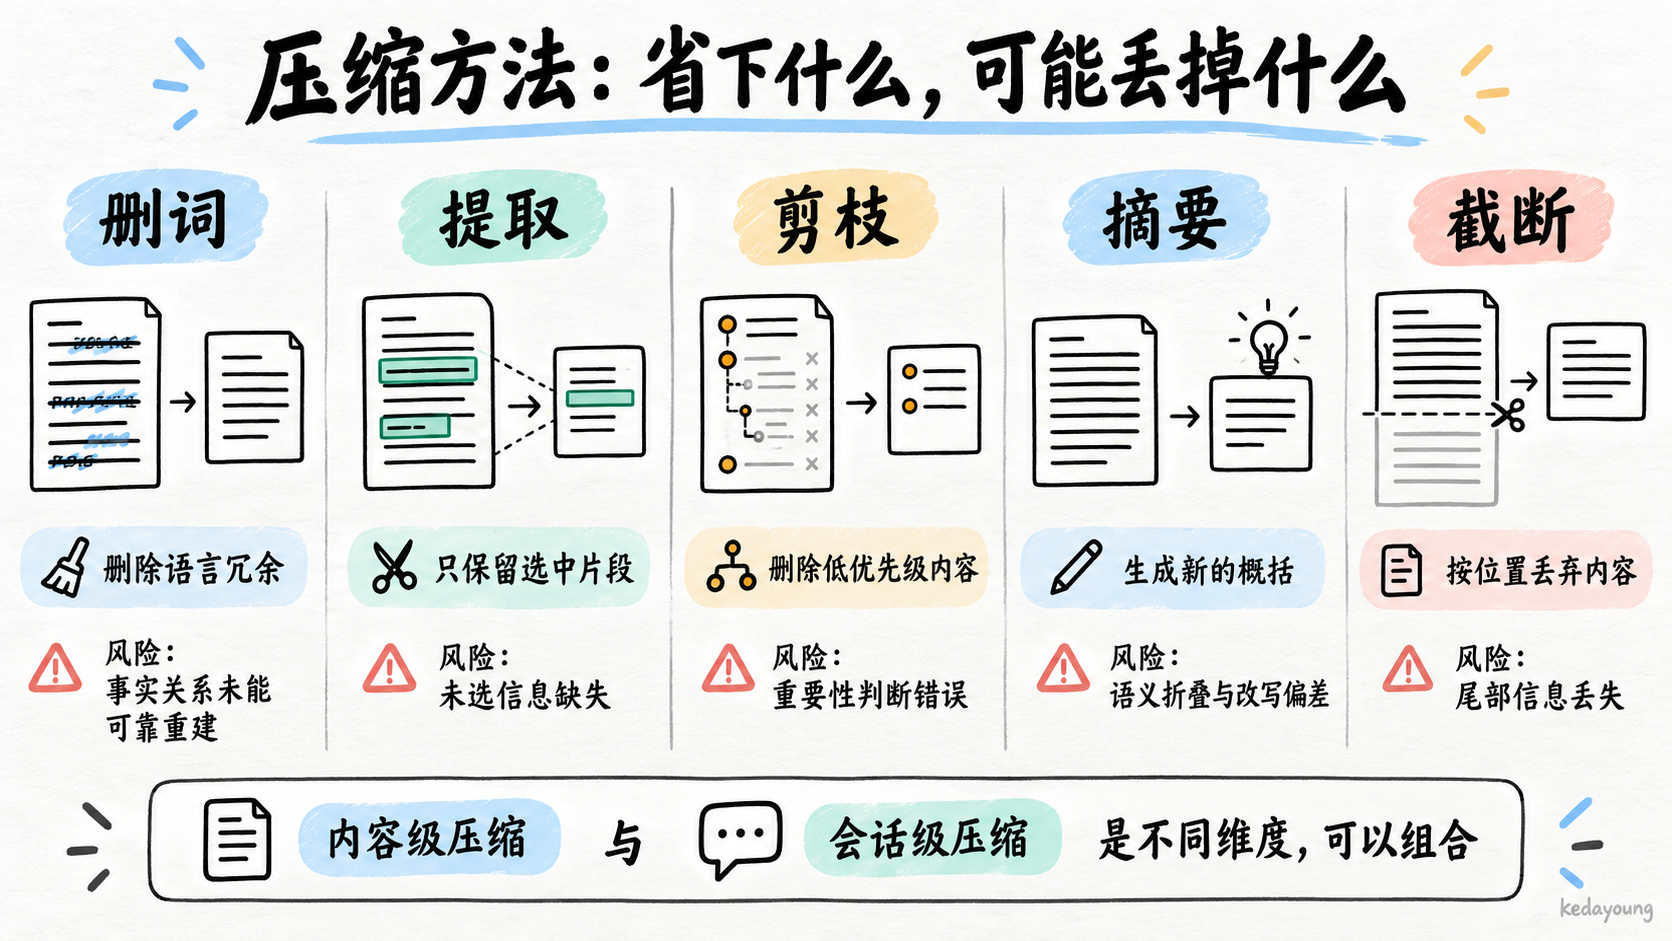
5.1 删词 vs 摘要 vs 截断
以 0-context-engineering 系列里两个相关的压缩实现为例:pi 的会话级压缩(摘要式)与 hello-agents 的 Compress(截断式):
| 维度 | 摘要(pi 压缩) | 截断(hello-agents Compress) | Caveman(删词) |
|---|---|---|---|
| 操作 | 生成新文本 | 丢弃尾部 | 删除可重建词 |
| 信息 | 语义折叠 | 尾部丢失 | 事实保留(声明) |
| 可逆 | 不可逆 | 不可逆 | 设计上可解压 |
| 成本 | LLM 调用 | 零 | LLM 逐句(贵)/NLP(便宜) |
| 验证 | 摘要质量难量化 | 信息损失可预期(尾部丢弃) | 自检 + benchmark(自报) |
三个路线的信息损失模式完全不同:摘要把「语义」折叠成新表述(可能引入改写偏差),截断把「信息」按位置丢弃(尾部信息必然丢失),caveman 把「语言冗余」删掉(声称事实零损失,但依赖 LLM 的重建能力)。caveman 赌的是「冗余可重建」这个假设成立——这也是为什么它只适合机器消费的场景:agent 推理、RAG 内部存储、token 受限上下文,而不适合人读的内容(README 自己也列出 Avoid for:用户面对内容、营销文案、法律文档、情感沟通[28])。
5.2 抽象层级:内容级 vs 会话级
还要注意 caveman 与 pi 的压缩不在同一抽象层:前者压缩单条内容(一段文本、一份文档),后者压缩整个会话(多轮对话的历史折叠)。这是两条正交的压缩轴——会话级压缩器内部完全可以调用内容级压缩器。caveman 定位在「内容级」,它解决的是「单条上下文如何更省」。
5.3 系列内呼应
0-context-engineering 系列的 0-tokenization-context-budget 主题(token 估算)与本文直接相关:caveman 的「字符/4 估算」问题,恰恰是「对 token 的理解不准确会污染整个压缩率测量」的活案例——本系列其它文章里对 token 预算的估算方式,值得用同样的批判眼光复查一遍。
6. 价值、局限与可迁移经验
6.1 可迁移模式(作者判断)
- 「删 LLM 能重建的」是一条可操作、可教学的压缩原则——它把压缩从「怎么改写得短」变成「什么信息天然可省」,并且给出了一组可落地的判别标准(数字/专名/术语/约束必须留,语法/连接/填充可删);
- 三实现对比是设计压缩方案的决策框架——提示词(贵而灵活)/ 概率(中而可解释)/ 规则(廉而确定),按成本、压缩率、可逆性选坐标;
- 压缩工具应内置「质量自检 + 解压」闭环——embedding 相似度分级、事实问答验证、解压器,这三件套值得任何压缩工具借鉴;
- 验证先于宣称——数字必须独立可复现,token 统计用真实 tokenizer。这是所有压缩方案的设计原则,不是事后补救。
6.2 局限(诚实标注)
- 数字层面:所有压缩率/准确率均为作者自报;事实保留 benchmark 样本极小(2 文本/13 事实);「lossless」无自动化持续验证;
- 成本层面:LLM 版逐句调用,20 句文本 = 20 次 API 请求,存在「省下的 token 抵不回 API 费用」的场景边界(对 gpt-4o-mini 的逐句调用,短文本场景尤其不划算);
- 还原层面:NLP/MLM 版的「解压」只是大小写清理,不是语义还原——它们的产物是「给 LLM 看的中间格式」,不是可逆编码;即便 LLM 版,解压也是「扩写」而非「精确还原」,对必须逐字保留的场景(法律、协议文本)不适用。
6.3 系列定位
在 0-context-engineering 的版图里,本项目承担的是「内容级压缩」路线:与 continue(检索侧)、pi(会话级压缩)、planning-with-files(外部化)互补——它处理的是「单条上下文如何更省」,其它路线处理「上下文从哪里来、如何组织、如何持久化」。四者合起来才是完整的上下文工程工具箱。
6.4 收束中心论点
caveman compression 的贡献是「可预测性即压缩空间」的原则,以及三种实现样本;它的数字不可直接采信,但作为「如何设计并验证压缩方法」的案例,教学价值成立。可迁移的有两样:一是那条删留原则(可直接用于自己的 prompt 工程),二是「任何压缩率数字,先自己重算一遍」的验证习惯——本文第 4 节的重算,就是这套习惯的一次演练。
附录 A:证据清单(行号以 20260810-caveman-compression/repo/ 为根)
| 断言 | 证据位置 |
|---|---|
| 定位与原理 | README.md:5、:18、:33-47、SPEC.md:9 |
| 应用场景(RAG/CoT) | README.md:237-257 |
| 示例表与「validated with GPT-4o」 | README.md:211-220 |
| LLM 版流程 | caveman_compress.py:132-202、prompts/compression.txt:7-29 |
| MLM 版阈值与 NER 保护 | caveman_compress_mlm.py:7-12、:98-180、:273-278 |
| MLM 解压局限自承 | caveman_compress_mlm.py:218-222 |
| NLP 版规则 | caveman_compress_nlp.py:76-109、:30-47 |
| token 估算(字符/4) | caveman_compress.py:54-56(同 _mlm.py:50-52、_nlp.py:65-67) |
| 嵌入自检与分级 | caveman_compress.py:118-129、:314-324 |
| 解压 | caveman_compress.py:205-227、prompts/decompression.txt |
| 事实保留 benchmark 流程 | benchmark/factual_preservation/run_factual_benchmark.py:78-185 |
| 事实保留结果(13/13、18.6%、2 文本) | benchmark/factual_preservation/README.md:79-98 |
| embedding 指标为「预期」 | benchmark/embedding_similarity/README.md:45-47 |
| lossless 验证仅为规范 | SPEC.md:233-247 |
| 自报压缩率与避免场景 | README.md:211-284、:288-300 |
| 思想来源 | README.md:332、SPEC.md:337-341 |
附录 B:正文引用索引([n] → 仓库证据位置)
| 编号 | 证据位置(repo/ 为根) | 对应正文断言 |
|---|---|---|
| [1] | README.md:5 | Lossless semantic compression 定位 |
| [2] | README.md:20-25 | 70→50 token、29% 示例 |
| [3] | README.md:213-218、caveman_compress.py:54-56 | 示例 token 数 = 字符/4 |
| [4] | README.md:220 | 「validated with GPT-4o」 |
| [5] | SPEC.md:233-247 | lossless 验证算法仅为规范 |
| [6] | README.md:49-53 | Company medium-large 压缩-解压对照 |
| [7] | README.md:237-257 | RAG/CoT 应用场景 |
| [8] | README.md:332 | 灵感来源 TOON |
| [9] | SPEC.md:337-341 | 信息论与受控自然语言 |
| [10] | prompts/compression.txt:7-29 | ALWAYS REMOVE / ALWAYS KEEP 清单 |
| [11] | caveman_compress.py:132-202 | LLM 版执行流程 |
| [12] | README.md:104、:263-268 | LLM 版 40-58% 自报 |
| [13] | caveman_compress_mlm.py:98-216 | MLM 概率删除机制 |
| [14] | caveman_compress_mlm.py:7-12、:260-264 | 阈值档位自报数字 |
| [15] | caveman_compress_mlm.py:122-124 | PROTECTED_NER |
| [16] | caveman_compress_mlm.py:112-114 | no-adjacent 选项 |
| [17] | caveman_compress_mlm.py:218-222 | MLM 解压局限自承 |
| [18] | caveman_compress_nlp.py:76-109 | NLP 版删除规则 |
| [19] | README.md:278-284 | NLP 版 15-30%、15+ 语言 |
| [20] | caveman_compress.py:118-129 | embedding 相似度自检 |
| [21] | caveman_compress.py:314-324 | 相似度分级阈值 |
| [22] | benchmark/embedding_similarity/README.md:45-47 | 相似度指标是「预期」 |
| [23] | caveman_compress.py:205-227、prompts/decompression.txt | LLM 解压 |
| [24] | benchmark/factual_preservation/README.md:1-11 | 事实保留方法论 |
| [25] | benchmark/factual_preservation/run_factual_benchmark.py:78-185 | 问答-验证流程 |
| [26] | README.md:213-218 | 示例压缩率主表 |
| [27] | caveman_compress.py:54-56 | count_tokens 字符/4 |
| [28] | README.md:288-300 | Avoid for 场景清单 |
附录 C:本文独立验证说明
- 方法:对
examples/下三个示例(normal 与 caveman 各一份),用 OpenAI 官方tiktoken库的cl100k_base编码(即 GPT-4 系列所用 tokenizer)分别编码,计算真实 token 数与真实节省率;同时用len(text)//4复算仓库口径,两者对照。 - 环境:Python 3.9 +
tiktoken(临时安装于/tmp/tiktoken_pkg,未污染项目环境)。 - 结果:见 4.1 表格。System prompt 真实节省 54.4%(声称 58%)、API 文档 41.8%(声称 42%)、简历 17.8%(声称 22%);平均 35.7%(声称 40%)。
- 复现:
PYTHONPATH=/tmp/tiktoken_pkg python3 -c "..."可重复执行;也可直接pip install tiktoken后在任意环境重跑。 - 边界:cl100k_base 与 gpt-4o 实际使用的 o200k_base 编码略有差异(约 1-2%),但方向与量级结论不变;示例文本仅 3 对,统计意义有限,足够说明「字符/4 高估」这一系统性问题。