面向工程团队的技术报告。配套素材:
docs/context-engineering-report/research.md。 源码引用约定:[pi] = pi 0.74.2 源码;[harness] = pi-java-agent-harness 源码;[scratch] = 项目开发记录。
开场:一次"聊崩了"的交接
pi-java-agent-harness 的第一次真实运行暴露了一个非常具体的问题:Research 阶段已经查清了需求相关的仓库事实,并且把它们写进了持久化的阶段产物;但进入下一步 Specification 时,模型却"接不住"——它要么重复研究,要么基于不完整的印象写 spec。两个阶段运行在同一个 Pi session 里,聊天记录里什么都有,可模型偏偏用不上。
问题不在模型,而在上下文。
聊天历史是一种隐式状态:模型从一大段对话里提取什么、忽略什么,是概率行为。而软件交付需要的是显式交接:上一阶段产出的、经过验证的事实,必须确定性地成为下一阶段的输入。把交接押注在"模型能从聊天记录里自行总结出正确结论",本质上是在赌。
这个教训指向一个更大的命题:对不训练基础模型的 Agent 开发者来说,模型权重是冻结的,真正可设计、可审计、可优化的,是"模型读到了什么"。上下文不是 prompt 的附属品,而是一等工程对象——它决定模型看到什么、信任什么、能推进什么。
本文以 pi-java-agent-harness(一个基于 Pi 的 Java 交付 harness)为例,记录一套完整的上下文加载机制设计:如何把上下文从"session 全量历史 + 项目文件全量注入"重构为"显式打包、digest 绑定、按角色裁剪的受控上下文包"。核心结论是四个原则、六种机制,以及它们在真实运行中的验证。
1. Situation:宿主默认的上下文机制,以及它不够用的地方
1.1 基线:pi 默认的上下文组装链
Pi 是一个刻意保持核心小巧的 coding agent harness——它没有内置 MCP、sub-agent、权限弹窗,把工作流能力留给扩展和包(官方 Design Principles)。它的上下文加载机制是"全量叠加"式的,一次请求的上下文由以下几层拼成(图 1):
- 自定义系统提示词:项目的
.pi/SYSTEM.md(替换默认),或APPEND_SYSTEM.md(追加),全局~/.pi/agent/SYSTEM.md兜底; - 项目级上下文:从当前目录向上逐级发现的
AGENTS.md/CLAUDE.md,以<project_context>块注入——全文读入,不截断; - Skills 目录索引:所有可用 skill 的 name/description 以 XML 形式列出,完整指令按需加载;
- 工具清单与 guidelines:按当前可用工具动态生成。
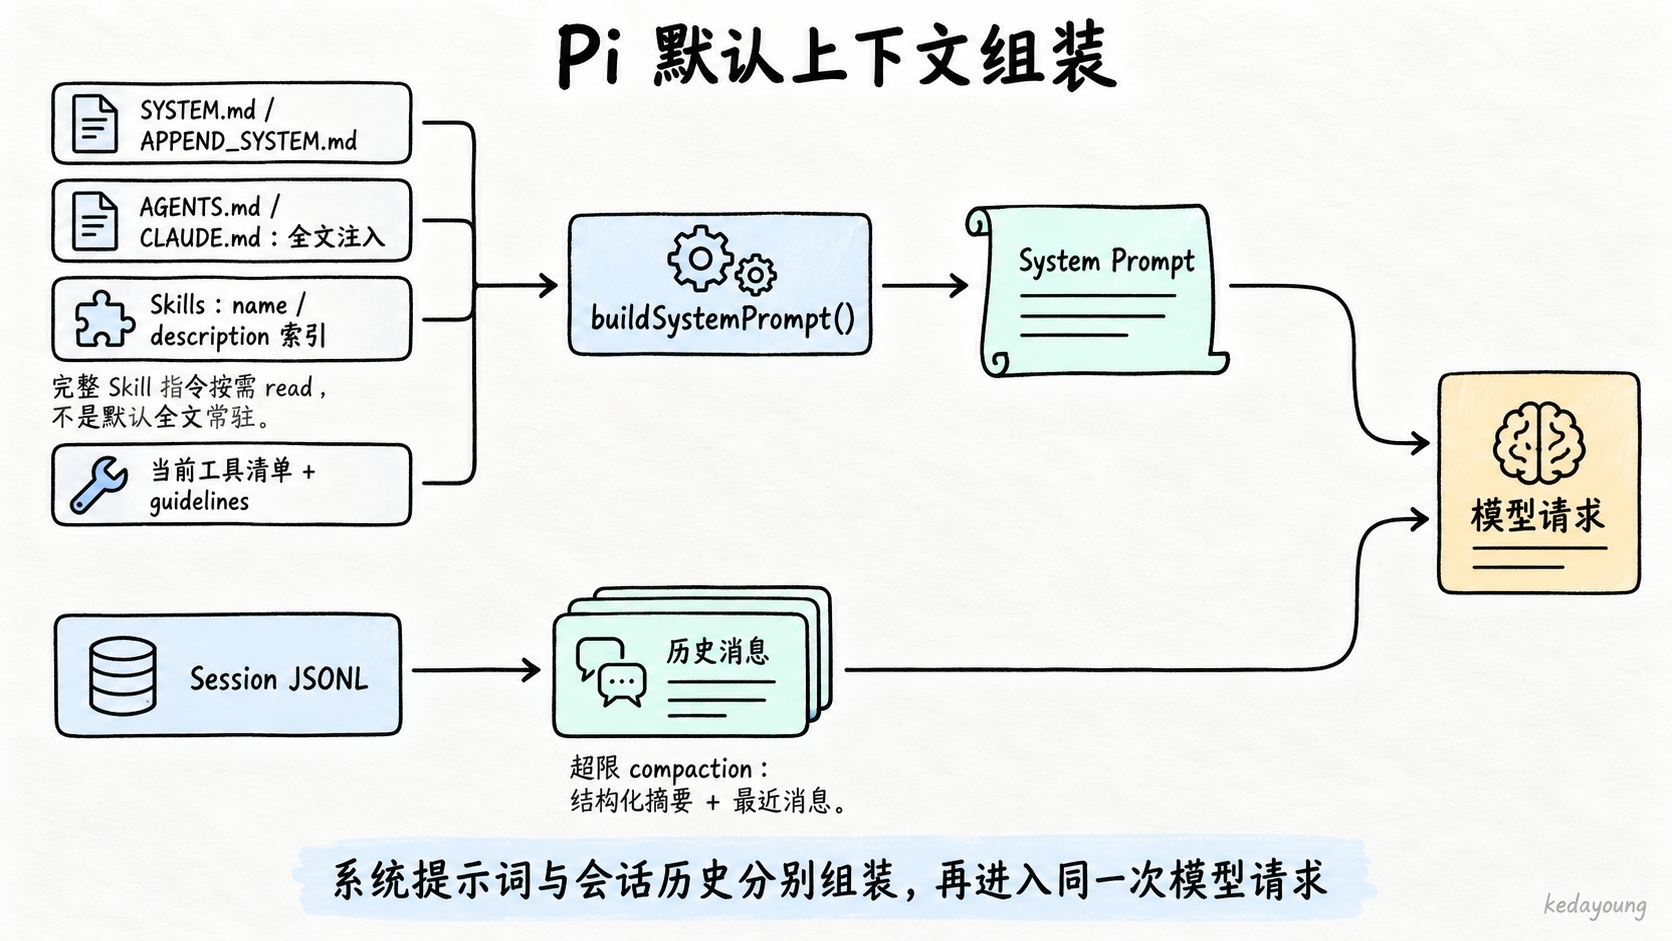
组装入口是 buildSystemPrompt()(packages/coding-agent/src/core/system-prompt.ts:28),项目上下文收集在 resource-loader.ts(loadProjectContextFiles,逐级发现 + worktree 遮蔽去重)。
这套设计对"单人、单任务、长对话"的场景非常合理:AGENTS.md 全文注入保证项目约定永远在场,skills 用"渐进式披露"(progressive disclosure)控制常驻成本——只有描述常驻上下文,完整指令让模型用 read 按需加载(官方文档原文:"only descriptions are always in context, full instructions load on-demand")。
历史的处理同样成熟:session 持久化为 JSONL 文件,上下文超限时触发 compaction——把旧消息交给 LLM 总结成结构化摘要(Goal / Progress / Key Decisions / Next Steps / Critical Context),保留最近 keepRecentTokens(默认 20k)token,并预留 reserveTokens(默认 16k)给模型输出(compaction.ts;官方文档 compaction 页)。
1.2 三个结构性边界
对于日常对话,上述机制够用。但当我们把它当作"多阶段软件交付流程"的执行内核时,三个结构性边界立刻显现:
边界一:项目上下文全量注入,无法按任务裁剪。 AGENTS.md 对"这个仓库怎么编译"的单个问题很有用;但对"只评估这一个 ticket 的 diff"的 review 任务,全量注入既浪费 token,又把无关信息混进判断依据。Pi 的默认机制没有"按阶段/按角色选取上下文"的通道——--no-context-files 只能一刀切禁用,无法细分。
边界二:状态主要承载在聊天历史里,且 compaction 是有损的。 对单人对话,compaction 摘要丢一点细节可以接受;但对交付流程,任何一步的事实偏差都会向下游传播。更根本的问题是:聊天历史是隐式的,它没有"哪些是已验证事实、哪些是推测、哪些已过时"的区分。两个阶段之间真正需要传递的是"验收过的产物",而不是"聊过的天"。
边界三:单会话内角色混用,证据无法隔离。 同一个 session 里,模型既研究又写 spec 又实现又自我 review——它看到自己说过的每一句话。这对"独立 review"是致命的:review 应该基于候选产物本身,而不是基于"作者当时的意图"。要做出可信的独立审查,必须让 review 模型看不到 writer 的对话。
官方文档甚至自己承认了渐进式披露的局限:"models don't always do this [load the full SKILL.md]; use prompting or /skill:name to force it"——对交付流程,我们不能依赖模型的"自觉"去加载正确的东西。
1.3 任务:把 pi 变成可治理的交付内核
我们的需求不是改造 pi 的默认行为,而是在它之上叠加一层"上下文治理"。具体约束来自 pi-java-agent-harness 的定位([idea]、[context]):
- 多阶段:一次需求交付要跑完 Preflight → Research → Clarification → Specification → Spec Gate → Ticket Planning → Ticket Plan Gate → Ticket Execution → Ticket Review → Ticket Verification → Ticket Acceptance → Manual Integration → Reconciliation → Final Checklist → Full Run Verification → Run Acceptance 共 17 个 stage([harness]
requirement-run.tsWORKFLOW_DEFINITION); - 多角色:workflow(推进流程)、writer(实现 ticket)、review(独立审查)三类角色,各自需要不同的模型、工具和上下文边界;
- 可恢复:一次 run 可能跨天、跨进程、跨崩溃,任何时刻中断后要能从持久状态重建,而不是"从头聊";
- 可审计:每一步决策都要能追溯到输入——什么需求、什么产物、什么版本、谁批准的。
这四个约束决定了:上下文机制不能是"模型每次看到什么碰运气",而必须是一个可构造、可校验、可恢复的工程对象。
2. Task:四条设计目标
把上述问题翻译成可验证的设计目标:
| # | 目标 | 可验证判据 |
|---|---|---|
| T1 | 每个阶段/角色只拿到必要且受控的上下文 | 上下文 = 显式打包的 Artifact Pack,而不是 session 历史 |
| T2 | 状态以显式 Artifact 承载,不依赖聊天历史 | 删除全部对话历史后,run 仍可推进 |
| T3 | 跨 session/进程/中断可恢复,且不可被篡改 | resume 前后 digest 校验,任何漂移 → Blocker |
| T4 | 上下文可预算、可审计 | 预算写入 Execution Lock;一切输入带 digest 与 provenance |
T2 是最关键的一条:它把"上下文"从"模型读到的所有东西"(被动、隐含)重新定义为"被显式交付给模型的受控输入"(主动、可管理)。后面 Action 部分的所有机制,都是为了让 T2 成立。
3. Action:把上下文变成受控输入
3.1 四条设计原则
在写任何代码之前,先立四条原则。它们是后面所有机制的"宪法",也是评审时的判断标准:
- Artifact over Conversation(产物优先于对话):流程状态由显式 Artifact 承载,不是由聊天记录承载。对话是产生 Artifact 的手段,不是状态本身。
- Bounded over Complete(宁可少给,不给错):上下文追求"足够完成当前阶段",而不是"完整覆盖所有信息"。缺什么用显式 Gap 声明,而不是用模糊的全量注入兜底。
- Digest-bound Immutability(digest 绑定的不可变性):任何进入上下文的输入,先绑定内容 digest;读到、传递、批准的是"内容本身",验证的是"内容没变"。
- Role-isolated Fresh Session(角色隔离的全新会话):不同角色之间零历史继承——writer 看不到 operator 的对话,review 看不到 writer 的对话。
3.2 机制一:Project Profile——项目级常驻上下文的"受控化"
第一个要处理的是 pi 默认机制里的"全量注入"问题:AGENTS.md 在 pi 里由系统自动发现、全文注入、每次都在。在 harness 里,它变成了受 Profile 声明和校验的受控输入。
Project Profile 是什么
一次性的项目 onboarding(/harness-setup)产出的批准文档 docs/pi-harness/project-profile.md,内容由默认模板([harness] project-profile.ts:982)引导人工填写:仓库边界(repositoryBoundary)、guidance 路径(guidancePaths,默认 ["AGENTS.md"])、验证命令、三类角色的模型/推理/工具/预算(modelPolicy)、数据访问策略(dataPolicy)、能力绑定(capabilityBindings)等。
审批是 digest 绑定的人为决策
setup 生成候选 Profile 后,/harness-approve-profile 先展示生成正文,再原子校验"当前草稿正文 + digest 仍是提交时那一版",然后才发布为 Project Record(approveCurrentProfile,project-profile.ts:1158)。digest 采用规范化比较:CRLF 归一为 LF、去尾部空白、末尾补一个换行——只容忍编辑器传输差异,任何真实内容变更都会在确认前被拒绝(canonicalizeProfileBody,559)。
与 pi 默认机制的关键对比:
| pi 默认 | harness | |
|---|---|---|
| AGENTS.md 的加载 | 启动时自动发现、全文注入 | 作为 Profile 声明的 guidance 路径,每次进入 run 前校验 digest |
| 谁来声明 | 文件存在即生效 | 人工审批的 Profile 声明 |
| 变更处理 | 改了立即生效 | 改了就触发 required_guidance_changed Blocker,run 拒绝继续 |
也就是说,AGENTS.md 从"环境自动注入的既成事实"变成了"经人工批准的、可校验的交付输入"。这一步是后续所有机制的地基:上下文的第一层边界是"哪些项目事实被允许进入流程",而这个集合是显式的、有授权的。
3.3 机制二:Requirement Snapshot + Execution Lock——不可变的上下文底座
第二个问题是"上下文会漂移":一个 run 可能持续几天,期间技能变了、模型换了、AGENTS.md 被改了——如果这些变化悄悄进入上下文,产出的每个后续 Artifact 都建立在不确定的输入上。
harness 的做法是在 run 启动时(/harness-start)固化两份不可变记录(图 2):
- Requirement Snapshot:需求来源身份、来源版本、内容 digest、摘要、目标 Delivery Branch——需求本身被冻结;
- Execution Lock:Harness 包版本与 digest、Workflow 定义、Artifact schema 版本、Capability Pack 版本与 digest、pinned Skills 的整棵目录树 digest、三角色模型配置、Project Profile digest、执行预算——整个执行栈被冻结。
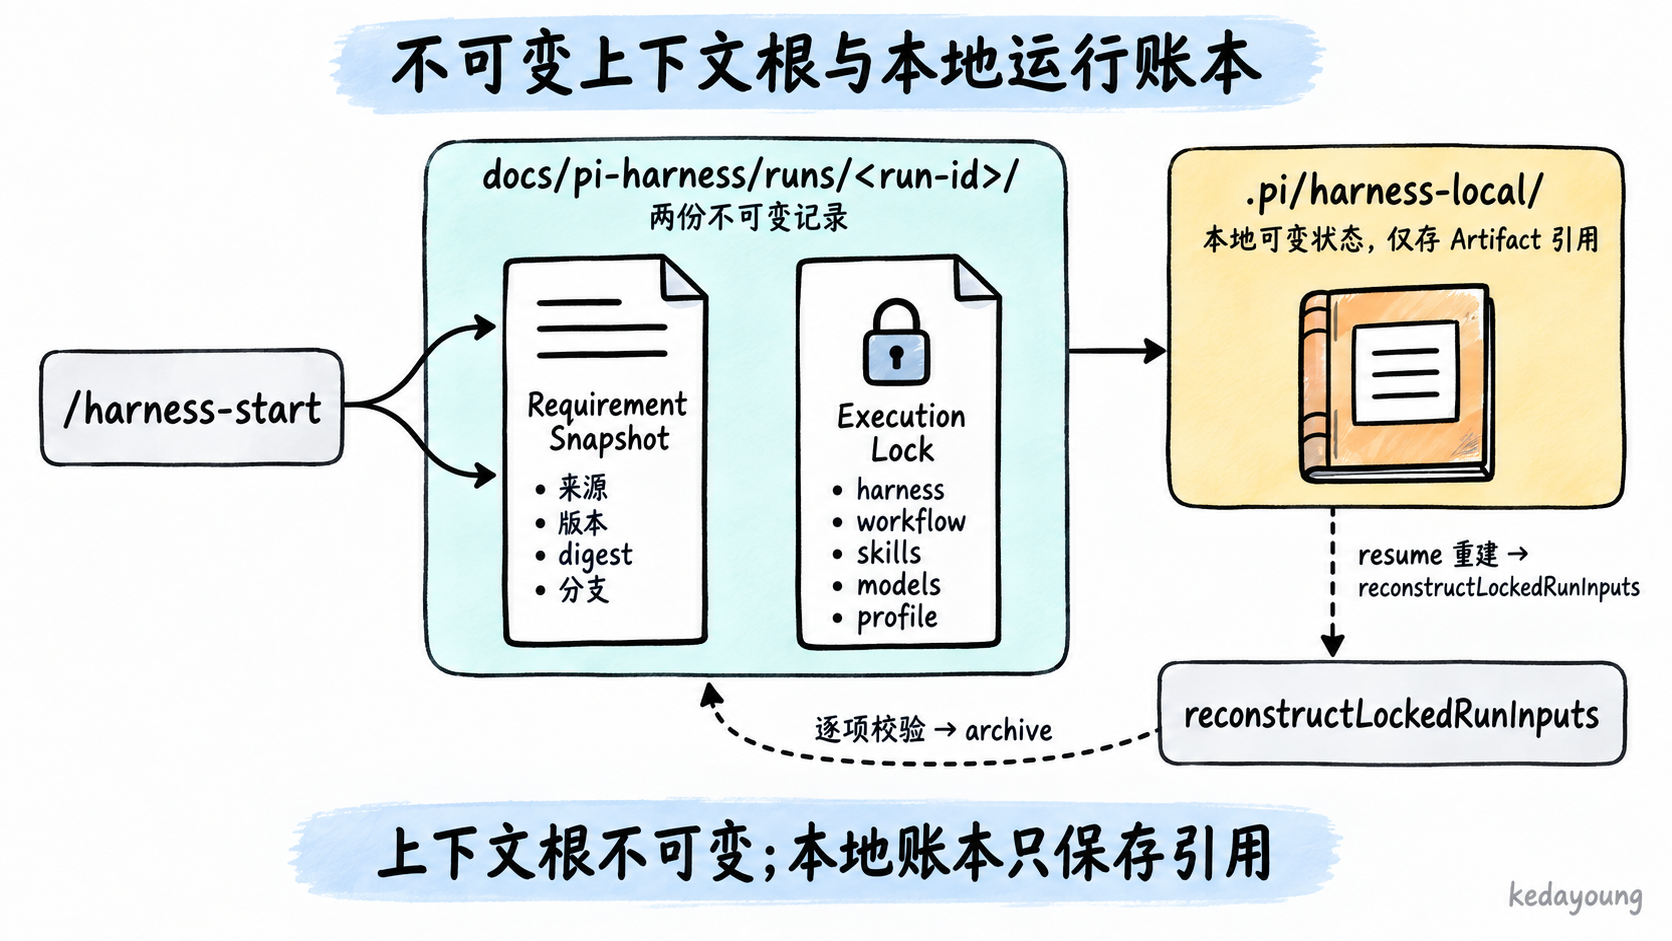
图 2:Snapshot / Execution Lock / Ledger 的关系。Ledger 是本地可变状态,只存 Artifact 引用;真正的上下文根是两份不可变记录。
锁的捕获过程是逐层哈希(captureExecutionLock,requirement-run.ts):安装的 Harness 包 digest 必须等于 Profile 声明的 packageCompatibility.sha256;pinned Skills 目录递归哈希(路径、长度、内容按序喂入 SHA-256);Capability Pack 同理。任何一层对不上,run 直接以 run_harness_package_drift 之类 Blocker 拒绝启动。
关键设计是"校验时机"
/harness-start 前后各跑一次 preflight 并比对两份锁(startRequirementRun,815),/harness-resume 在重建 run 前后也各校验一次(inspectRequirementRun,856)——所以"跑一次 preflight 命令"不可能让需求、分支、guidance 或执行栈悄悄变化而不被发现。guidance 校验(validateLockedGuidance)逐文件比对 digest,这就是机制一中 AGENTS.md 受控化的最终落地。
这套"根不可漂移"的设计带来一个直接后果:fail-closed。上下文根一旦可疑,流程停止并给出恢复选项,而不是带病继续。README 的原话是:"Start, status, and resume reconcile their locked inputs both before and after current Preflight, so a Preflight command cannot change the requirement, Delivery Branch, required guidance, or execution stack undetected."
顺带一提:/harness-status 输出只显示锁定输入的摘要(digest、版本、分支),从不暴露需求正文、prompt、会话内容或机密——上下文治理与信息最小化是同一件事。
3.4 机制三:Artifact Pack——按阶段的受控上下文包(核心)
前两个机制解决了"哪些项目事实允许进入流程"和"流程的根不会漂移",但它们没有回答 T1:每个阶段到底读什么。Artifact Pack 就是答案,也是整个设计的核心创新。
#### 通用形态:引用即契约
一个 Artifact Pack 不是一堆文件的拷贝,而是一组带双重 digest 的引用([harness] stage-progression.ts:16):
type ArtifactReference = { id: string; path: string; digest: string; fileDigest: string };digest:该 Artifact 的语义 digest(正文规范化后的 digest,frontmatter 不算);fileDigest:文件逐字节 digest;- pack 自身也有 digest:
digest(stableJson(references))。
读取时(validateArtifactPack,200)逐项重读文件、重算两个 digest、比对引用表——任何一层不一致,pack 即失效。这保证了"模型看到的内容"和"批准的内容"严格同一。
#### 实例 A:Stage Adapter——研究/规范/拆票的统一上下文
Research、Specification、Ticket Planning 三个 stage 共用同一个 Stage Adapter 模式。进入 stage 时,harness 推导Evidence Gaps(必须澄清的 required 缺口 + 可选的 optional 缺口,来源是 Snapshot + Profile + preflight 的 Unknowns),然后组装 stage prompt(renderStagePrompt,300 行附近),结构如下:
Stage Adapter request for Run <id>
Stage: Research | Specification | Ticket Planning
Stage Attempt: <id>
Pinned Skill: <name>@<revision> tree=<digest> content=<digest>

<pinned-skill>…完整 skill 原文…</pinned-skill>

Evidence Gaps 与有界 Artifact Pack:
- requirement-snapshot: docs/pi-harness/runs/…/requirement-snapshot.md#<digest> file=<digest>
- project-profile: docs/pi-harness/project-profile.md#<digest> file=<digest>
- …

Closed Candidate Contract(JSON schema,限定输出结构)
"Do not use or reconstruct prior conversation history."
"Return <stage> through the harness_stage_result tool. Model completion text alone is not a Stage outcome."
三个值得注意的设计决策:
- Skill 全文直接钉进 pack,不依赖渐进式披露。前面提到 pi 官方文档承认"models don't always do this [load SKILL.md]"——对交付流程,harness 不做这个赌注:把 pinned skill 原文(带 tree digest 与 content digest)直接放进请求,同时声明"They are wrapped by the Harness contract below and have not been modified"。
- 输入边界显式化:Research 明确"Treat only Artifact Pack references as established inputs";Specification/Ticket Planning 更紧——"Read only the repository-relative Artifact Pack inputs"。模型被明确告知:除此之外的东西不算数。
- 输出边界同样显式化(Closed Candidate Contract,机制五详述):模型不能"用对话推进流程",只能通过
harness_stage_result提交契约内 JSON。
#### 实例 B:Ticket Worker Pack——让一个 fresh session 从零开始实现 ticket
Ticket 实现是上下文隔离要求最高的场景:worker 需要知道"这个 ticket 要做什么、spec 怎么说、项目有什么约束、怎么验证",但绝不能看到 operator 或之前任何会话的对话。
renderArtifactPack([harness] ticket-workspace.ts)组装一个自包含的 pack:
| 段 | 内容 | 来源 |
|---|---|---|
| Approved Ticket | 从已批准 Ticket Plan 中提取的该 ticket 段落 | plan(digest 绑定) |
| Applicable Specification | Spec 全文 + digest | spec Artifact |
| Approved Project Facts | Profile 全文 + digest | Project Record |
| Dependency Acceptance Evidence | 前置 ticket 的验收证据 | 已接受 ticket |
| Verification Instructions | 命令、要求级别、证据级别、工作目录 | Profile |
| Required Skill References | implement + tdd skill 全文 + digest | pinned skills |
| Locked Writer Policy | 模型/推理/工具/预算 | Execution Lock |
worker 的 prompt 一句话概括了原则(promptFor,733):"Use only the Ticket Worker Artifact Pack for Ticket context. Work exclusively in the Workspace through the locked Writer tools."
#### 实例 C:Ticket Review Pack——独立的只读审查
review 的隔离要求最高:它要审的是候选产物本身,而不是作者的说辞。renderArtifactPack([harness] ticket-review.ts:337)的 pack 包含:Approved Ticket Contract、Frozen Candidate Identity(digest/HEAD/change digest)、Candidate Artifact 全文、Candidate Git State、Candidate Diff、Writer Verification Provenance——唯独没有 writer 的任何对话。pack 里还写死了一段 Review Isolation Proof,作为审查过程本身的可审计声明:
"The Review Session had only find, grep, ls, read, and the non-mutating Review Artifact submission authority; no Writer transcript was supplied."
且 review 模型被强制与 writer 不同(review_model_must_differ_from_writer,ticket-review.ts:423)——模型不同 + 会话全新 + 上下文只有产物,三重隔离下"独立 review"才成为可主张的事实。
#### 核心概念:上下文闭包(Context Closure)
把三种 pack 放在一起看,它们共享同一个形态:pack 自含完成当前阶段所需的一切,不引用任何历史。这就是"上下文闭包"——一个阶段需要的上下文是它自己声明的、可验证的、完备的闭包。缺什么?显式声明为 Evidence Gap(或者干脆是 Blocker),而不是靠模型从聊天记录里"补"。
闭包的性质让 T2 成立:如果 run 的每一步都从"闭包 + 当前请求"开始,那么删掉全部对话历史,run 依然可以推进——因为状态在 Artifact 里,不在对话里。
3.5 机制四:Context Hook + Fresh Session——运行时的裁剪与角色隔离
Artifact Pack 解决了"每个阶段拿到什么";接下来要解决的是运行时问题:就算 pack 是对的,模型同一个 session 里还会看到之前的对话——harness 怎么保证它看不到?
答案分三层,全部实现在 harness 的 extension 里([harness] extensions/pi-java-agent-harness.ts):
第一层:Fresh Session——每个 attempt 从零开始。 每个 stage attempt、每个 ticket worker、每个 review 都通过 ctx.newSession() 开一个全新 Pi session:新 sessionId、空 entries、无历史继承(pi 的 newSession 语义:全新 SessionManager,parentSession 仅记录血缘)。operator 的会话、上一个 stage 的会话,物理上就不是同一个 session。
第二层:before_agent_start——按角色注入身份与策略。 每个用户 turn 开始时(before_agent_start 事件,pi 在 agent 空闲路径每用户输入触发一次),harness 按 prompt 前缀路由:Stage Adapter request for Run 、Ticket Worker request for Run 、Ticket Review request for Run ,然后:
- 强制 session 策略:模型(
pi.setModel)、推理等级、工具集; - 注入角色 system prompt 覆盖,例如 writer:"You are an isolated Ticket Writer. Use only the current Ticket Worker request and its Artifact Pack. Work only in the declared Workspace. Do not read or rely on operator, reviewer, or other Writer conversation...";review:"You are an independent read-only Ticket Reviewer...Do not read or rely on Writer, operator, or other Review conversation..."
第三层:context hook——把发给模型的消息结构性裁剪。 这是最直接的一刀。context 事件在每次 provider LLM 请求前触发(pi 通过 transformContext 接线,sdk.ts:350),事件携带即将发出的完整 messages。harness 在其中识别角色 session(通过自定义 entry 标记),然后从尾部向前找到最新一次 Stage/Worker/Review request for Run 用户消息,返回 messages.slice(index):
for (let index = event.messages.length - 1; index >= 0; index -= 1) {
  const message = event.messages[index];
  if (message?.role !== "user") continue;
  const text = messageText(message.content);
  if (text.startsWith(prefix)) return { messages: event.messages.slice(index) };
}
return { messages: [] };效果是:模型每次请求只能看到"当前 request + 它之后的工具交互",更早的一切——包括 pack 之前任何残留的对话——都不在输入里。配合 Fresh Session,"历史泄漏"在两层意义上都不存在:物理上无历史(fresh session),逻辑上被裁剪(context hook)。
这里值得强调与 pi 默认机制的对比:pi 的 compaction 是有损的语义压缩——保留摘要、丢掉细节,本质是"把旧内容变薄";harness 的结构性裁剪是零损失的取舍——不压缩任何内容,而是决定"哪些内容根本不存在"。对于交付流程,后者更可审计:要么在(原文、digest 绑定),要么不在(彻底裁剪),没有中间状态。
工具面在运行时也被钉死(tool_call 事件):writer 的 bash 只允许 Profile 审批过的验证命令(ticket_writer_unapproved_bash_command_blocked)、所有路径强制限制在 worktree 内(ticket_writer_workspace_path_escape_blocked);review 的任何变更工具直接 block(ticket_review_mutation_tool_blocked)。上下文边界与工具边界是一致的:能看到的和能做的,同时被约束。
3.6 机制五:Closed Candidate Contract——输出侧的上下文控制
前面五个机制都在管"模型读什么"。但上下文治理的另一半是"模型产出什么"——如果模型可以自由地用一段话"宣布"stage 完成,那么整个受控输入体系就失去了意义,因为流程状态会重新变成"模型说了算"。
harness 的做法是给每个 stage 定义闭式候选契约(Closed Candidate Contract):模型不能"说"完成,只能通过专用工具提交契约内的结构化 JSON:
- Stage:
harness_stage_result——Research 的契约是{ stage, establishedEvidence[], remainingUnknowns[], requiredEvidenceUnavailable[], clarificationQuestions[] },Specification 是{ title, sections, inputReferences },Ticket Planning 是{ tickets: [{ id, specItemIds, dependsOn }] }([harness]stage-progression.tsrenderStagePrompt); - Review:
harness_ticket_review——{ candidateDigest, blockingFindings[], advisoryFindings[], conclusion }; - Ticket Candidate:
harness_ticket_candidate——要求当前 session 身份 + tracked diff + 全部 required 验证命令通过。
提交后的校验链是确定性的(不是模型判断,是代码判断):契约 keys 精确匹配(多一个字段都拒绝)、列表条目数上限(64)、内容大小上限(65KB / 131KB / 2.5MB 视 artifact 而定)、敏感信息扫描、引用必须绑定 pack 内的 reference ID(research_provenance_unbound)。Review 甚至会在提交前后各重读一次 frozen candidate 文件与 Git identity——审查对象在审查期间被换掉会被当场识破(ticket_review_candidate_stale)。
于是闭环成形:输入受控(pack)+ 输出受控(契约)。流程推进的唯一途径是"契约内、校验过、digest 绑定"的产物;模型文本可以解释、可以建议,但不能改变状态。这彻底落实了 CONTEXT.md 词汇表里的一条定义:Artifact ≠ Chat History。
3.7 机制六:预算、中断恢复与 Reconciliation
上下文治理的最后一块拼图是"跑飞了怎么办"和"断了怎么续"。
预算进 lock。 三角色各自的 executionBudget = { modelTurns, tokenAvailability, elapsedTimeMs }(默认 workflow/writer 20 轮 / 120k token / 1 小时,review 减半)写进 Profile 并随 Execution Lock 冻结(project-profile.ts modelPolicy)。ticket worker 每 turn 先 reserve、turn 结束记账,超预算的 candidate 不允许冻结——token 消耗本身成了被治理的输入。
resume 从持久状态重建,不重放对话。 /harness-resume 读取 Run Ledger(只有状态与 Artifact 引用),重建 locked inputs(Snapshot/Lock/Profile),校验后从当前 stage 继续。harness 自己的状态输出明确写道:"Pi Session history is not used"(requirement-run.ts formatRunStatus)——恢复依据是持久化的产物,不是"上次聊到哪"。这直接兑现 T3:跨进程、跨崩溃、跨天恢复,上下文依然完整且未被篡改(任何篡改 = digest 不匹配 = Blocker)。
中断恢复是证据驱动的 Reconciliation,不是盲目重试。 对能力调用(Capability Attempt),中断后先持久化并比对 ledger / Artifact / 外部可查询状态:证明"已成功"就完成原 attempt,证明"未完成"才允许同身份重试(预算内);无法判定的 Unknown Outcome 保持阻塞,绝不自动重试(ADR 0013)。ticket writer 侧有持久化 lease 绑定 session,防止两个进程同时开竞争 worker;只有 owner 被证明死亡才回收 lease(ticket-workspace.ts)。恢复路径本身也是受控的——这与"fail-closed"原则一脉相承:不确定就停,停下来让人决定。
3.8 与 pi 默认机制的对照总表
| 维度 | pi 默认 | pi-java-agent-harness |
|---|---|---|
| 项目上下文 | AGENTS.md 启动自动发现、全文注入 | Profile 声明 + 每次进入 run digest 校验 |
| 状态载体 | session 历史 + compaction 摘要 | 显式 Artifact(Snapshot/Lock/Pack)+ Run Ledger |
| 上下文裁剪 | 语义压缩(有损,保留摘要丢细节) | 结构性裁剪(只留当前 attempt,零损失) |
| 角色隔离 | 单会话,模型看到全部 | fresh session + 角色 systemPrompt + 工具面锁定 |
| Skills 加载 | 渐进式披露,靠模型自觉 read | 全文钉进 pack,digest 绑定 |
| 输出控制 | 自由文本 | Closed Candidate Contract + 确定性校验链 |
| 恢复 | continue/replay 会话 | resume + lock digest 校验 + Reconciliation |
| 预算 | reserveTokens 保护 context window | 显式 budget 进 lock,turn 级记账 |
| 审计 | 对话可导出,无输入指纹 | 一切输入 digest + provenance,决策绑定批准 |
4. Result:真实运行中的验证与代价
4.1 可观测证据
机制不是设计草案,而是有真实运行背书。最直接的是 real-host smoke 的输出串(记录于 [scratch] issues/03,pi 0.74.2 真实进程驱动):
REAL_PI_HOST_SMOKE status=pass host=0.74.2 install=clean package=self-contained
skills=loaded sessions=fresh models=distinct reasoning=recorded review_tools=read-only
host_decision=direct-ui setup=completed profile=typed approval=direct-ui preflight=ready
optional_capability=unknown run=started snapshot=immutable execution_lock=locked
turn=completed restart=reconstructed resume=same-lock
把这段压缩日志翻译成人话:fresh session 确实全新(sessions=fresh)、writer 与 review 确实用不同模型(models=distinct)、review 工具面确实只读(review_tools=read-only)、进程重启后从持久状态重建并在同一把锁下继续(restart=reconstructed resume=same-lock)——T3 的判据被真实进程验证。
第二个证据来自开发档案里一次真实的失败([scratch] handoffs/ticket-10/receipt.md)。它记录了 harness 自己的开发流程(也跑在同一套机制上)中一次上下文加载偏差:客户端把 prompt 传给 create_thread 时,与磁盘文件差了两处内联代码标记和末尾换行。机制如实记录 submission_fidelity: mismatched、prompt_sha256 与 submitted_prompt_sha256 不一致,并且 fail-closed——不声明 exact、不重复创建任务。之后 ticket-11 到 ticket-16 的记录全部回到 exact。这证明机制具有可证伪性:它能区分"逐字节加载"和"差两个标记",并且这种区分被真实触发过。
4.2 收益
- 上下文干净:writer/review/operator 三方互不可见;review 的"独立性"从口头承诺变成可审计声明(Review Isolation Proof + 不同模型 + 只读工具面)。
- 可审计:每个证据带 provenance(artifact id 或 repository file + digest);每个决策绑定批准(Spec Gate / Ticket Plan Gate / Run Acceptance 都是 digest 绑定的人为决策)。
- 可恢复:中断后 resume 校验 lock 重建上下文,不依赖"上次聊到哪";失败路径是 Reconciliation 而非盲目重试。
- token 可控:pack 有大小上限、预算进 lock、turn 级记账;上下文规模是设计出来的,不是累积出来的。
4.3 代价与边界(诚实清单)
- Trusted Execution Boundary:V1 明确假设 operator、仓库、Harness、Skills、Pack 都是非恶意的(ADR 0026)。它不是沙箱——验证命令是"信任的执行边界",不是"对抗代码的隔离"。
- 强人工门禁:Spec / Ticket Plan / Run Acceptance 都要人工批准,吞吐受限于人的节奏;这是有意的(交付质量优先),但不适合"全自动流水线"诉求。
- 不自动交付:Run 完成只到
Delivery Ready(本地分支就绪),不 Push、不 merge、不部署、不验证生产(ADR 0012/0018)——上下文治理管好了"知道什么",交付动作仍由人执行。 - 实现成本:17 个 stage 的 Workflow Definition、24 种 Artifact Contract、每类角色的策略与工具面,都是一等公民,需要持续维护——上下文治理是有维护成本的,不是免费的 prompt 技巧。
5. Conclusion:上下文从副作用变成一等工程对象
回到开场的那个问题。第一次真实运行里,"Research 查清的事实没有自动成为 Specification 的输入"——根因不是模型能力,而是我们把上下文交给了 session 历史这个隐式载体。pi-java-agent-harness 用四个原则、六种机制把它重构为显式工程对象:
把"模型读到的所有东西"变成"显式打包、digest 绑定、按角色裁剪的受控输入"——项目事实要经 Profile 批准(机制一),流程根要不可漂移(机制二),每阶段拿到的是一份自含的 Artifact Pack(机制三),运行时由 fresh session 与 context hook 双重隔离(机制四),产出必须经过闭式契约(机制五),消耗与恢复都有预算和证据约束(机制六)。
这套机制的可迁移性是它真正的价值:它不依赖 Java,不依赖 pi 的特定能力(只用到了 context 事件、newSession、setModel 这些通用 seam),甚至不依赖 Matt Pocock skills——公司内部能力(学城、数据库、Lion 等)已经被 adapter 化,换语言、换宿主、换 skill 集合都可以复用同一套上下文治理逻辑。对任何想把"多阶段 Agent 工作流"做实而不是做 demo 的团队,值得带走的最小结论是三条:状态放 Artifact 不放对话;输入输出都走契约;恢复靠校验不靠重放。
最后,这套机制已经为下一步优化埋好了仪表:run-metrics 记录了 stage 尝试数、验证失败数、review findings、token 用量、恢复类别等指标,且刻意不含 prompt 与内容。上下文治理的下一个阶段不是"更多机制",而是用这些指标回答"哪个 pack 过大、哪个 gap 常空转、哪条路径的裁剪可以再紧一档"——把上下文包本身变成可迭代的优化对象。
(初稿完成。待办:全文术语一致性检查、引用编号统一、Pre-publish checklist)