中心论点:Context7 把「检索增强」做成对 LLM 透明的工具协议而不是 SDK:模型通过
resolve-library-id → query-docs两段式 MCP 工具显式寻址并检索文档库,每次检索成本受控(≤3 次/问题)、每条 snippet 内建 citation(源码 URL + token 数)让模型可溯源;文档的获取/更新由「按流行度分级刷新」的后端异步保证,与查询解耦——它展示的是上下文工程的另一条路线:把上下文来源(最新文档)变成外部托管服务 + 协议化访问,与 Continue 的「本地多路召回」形成对照。 证据说明:文中「Context7」指upstash/context7仓库,本地克隆0-context-engineering/20260810-context7/repo/(main 分支快照,2026-08-11 克隆);客户端侧断言直接引用仓库代码,服务端行为以官方docs/与docs/openapi.json为准(ingest 后端代码未公开)。
1. 一个问题:第三方文档是最容易过期的上下文
如果说上下文工程有一条朴素公理,那就是:模型回答的质量,取决于放进上下文的东西是否真实、新鲜、可核查。而「第三方库的文档」恰恰是这三项里最容易出问题的一类来源。
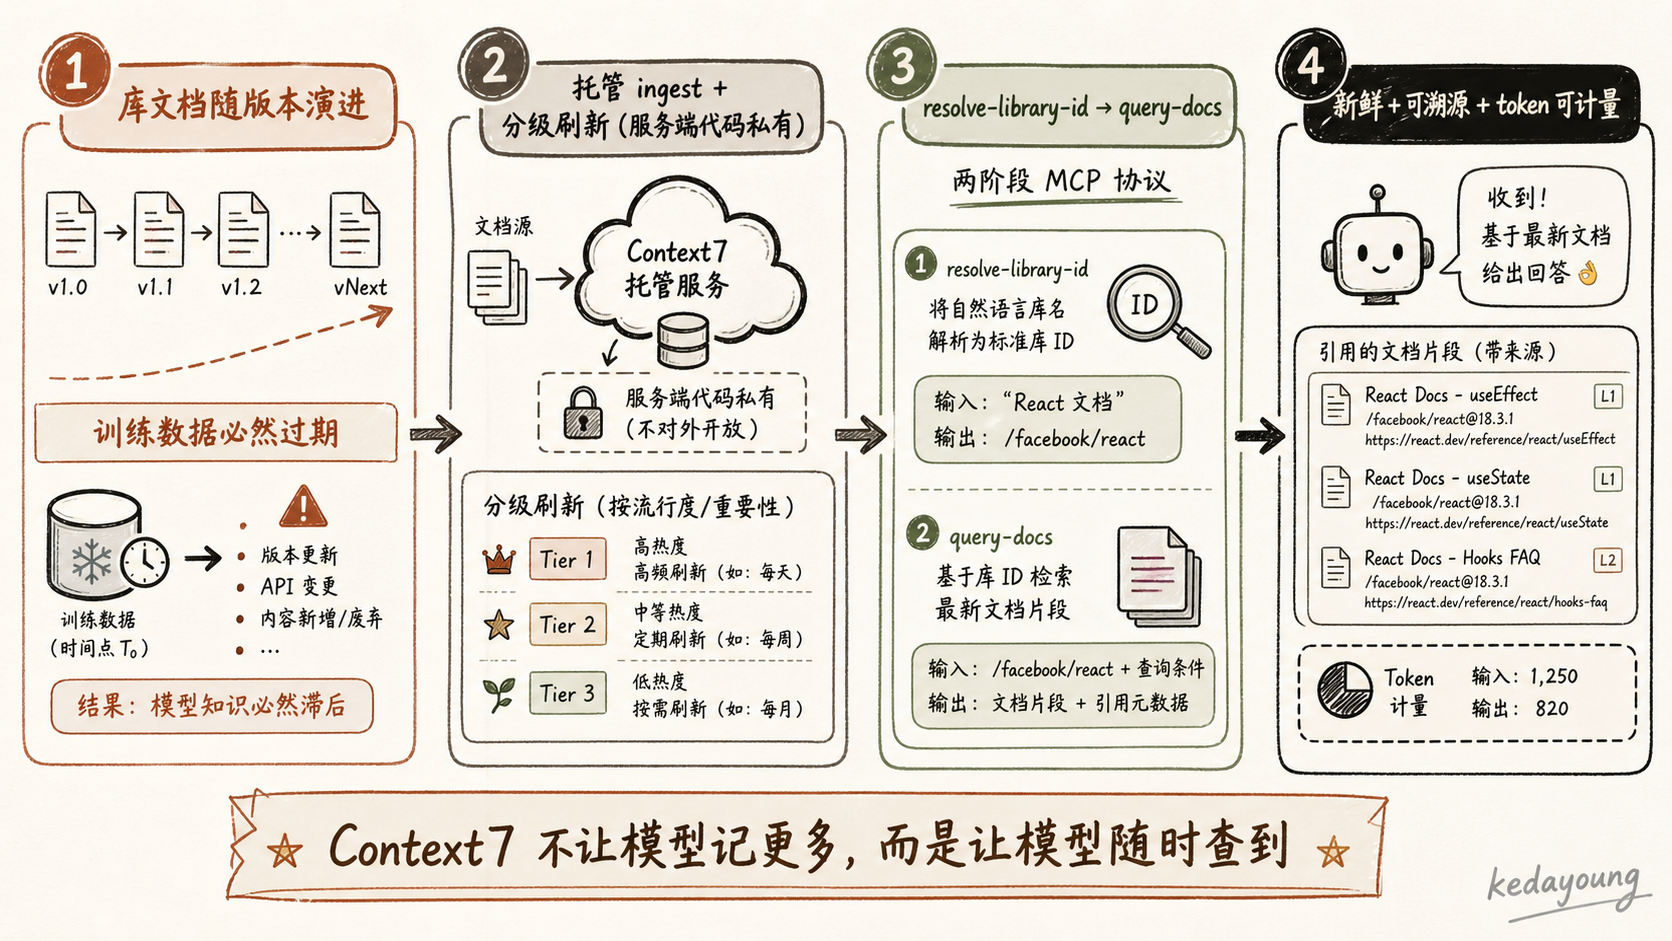
为什么?因为库文档是随版本演进的。一个库每发一个 minor 版本,API 签名、配置项、默认行为都可能变化。而模型训练数据里的知识在训练完成那一刻就冻结了——它记得的是训练截止日期之前的 API。于是出现了上下文工程里最讽刺的一幕:恰恰是「最新的 API 签名」这种代码任务最依赖的事实,恰恰是模型最容易答错的部分。README 里把这种场景描述得很直白:没有 Context7 时,模型会给出「基于一年前训练数据的过期示例」「根本不存在的幻觉 API」「针对旧包版本的通用答案」(README.md:11-18)。你问一个库的新版本 API,模型凭旧版记忆给出早已废弃的写法——这不是模型笨,是它上下文里没有对的那份文档。
Context7 对这个问题的回答方式很特别,值得拆开看:它没有试图让模型「记住更多」,也没有在用户本地建一个文档库,而是把整条「文档流水线」搬到一个托管服务里:
- 服务端:抓取、解析、索引、检索流水线由 Context7 托管维护,并按流行度分级自动刷新,保证「文档是最新的」这件事有人负责;
- 客户端:把「查询文档」暴露成 MCP 工具协议,模型自己决定何时、查哪个库、查什么,拿回来的结果自带出处——模型不关心文档从哪来、是否最新,只关心「查得到 + 有出处」。
用一句大白话概括:Context7 卖的不是「文档」,而是「一份永远新鲜、且模型伸手就能拿到的文档」。
举一个具体场景帮助感受问题有多尖锐:你让模型「用 React 19 的 useActionState 写一个表单提交」。如果你的模型训练数据停在 React 18 时代,它要么不知道这个 hook 存在,要么凭印象编一个签名——而 useActionState 恰恰是 React 19 才引入的。模型不是不努力,是它上下文里根本没有 React 19 的文档。同样的问题发生在 Next.js 的 middleware、Prisma 的 client 初始化、Tailwind 的配置项上——凡是「API 随版本变」的东西,都是重灾区。这也是为什么 Context7 的 MCP server instructions 里写着一句很反直觉的话:「Use even when you think you know the answer — your training data may not reflect recent changes」(index.ts:168)——越觉得自己知道,越值得查一下,因为训练数据的陈旧是确定性的,而「我觉得我知道」只是概率性的。
这里必须诚实标注一个边界,它也是理解这类工具的关键:本仓库只托管客户端侧代码——MCP server、CLI、SDK、插件、文档都在 repo 里,而 ingest 后端(爬虫、解析引擎、API 服务)是私有的,README 明示「The supporting components — API backend, parsing engine, and crawling engine — are private and not part of this repository」(README.md:136)。因此,本文对客户端侧的断言(两段式工具、snippet 结构、agent 适配)直接引用仓库内代码;对服务端的断言(抓取、解析、嵌入、分级刷新)以官方 docs/ 与 docs/openapi.json 为证据,并在文中明确标注「服务端行为以官方文档/OpenAPI 为准,代码未公开」。「客户端开源 + 服务端托管」是这类工具的典型形态,也是本文证据规则的前提。
2. 两段式工具协议:resolve → query
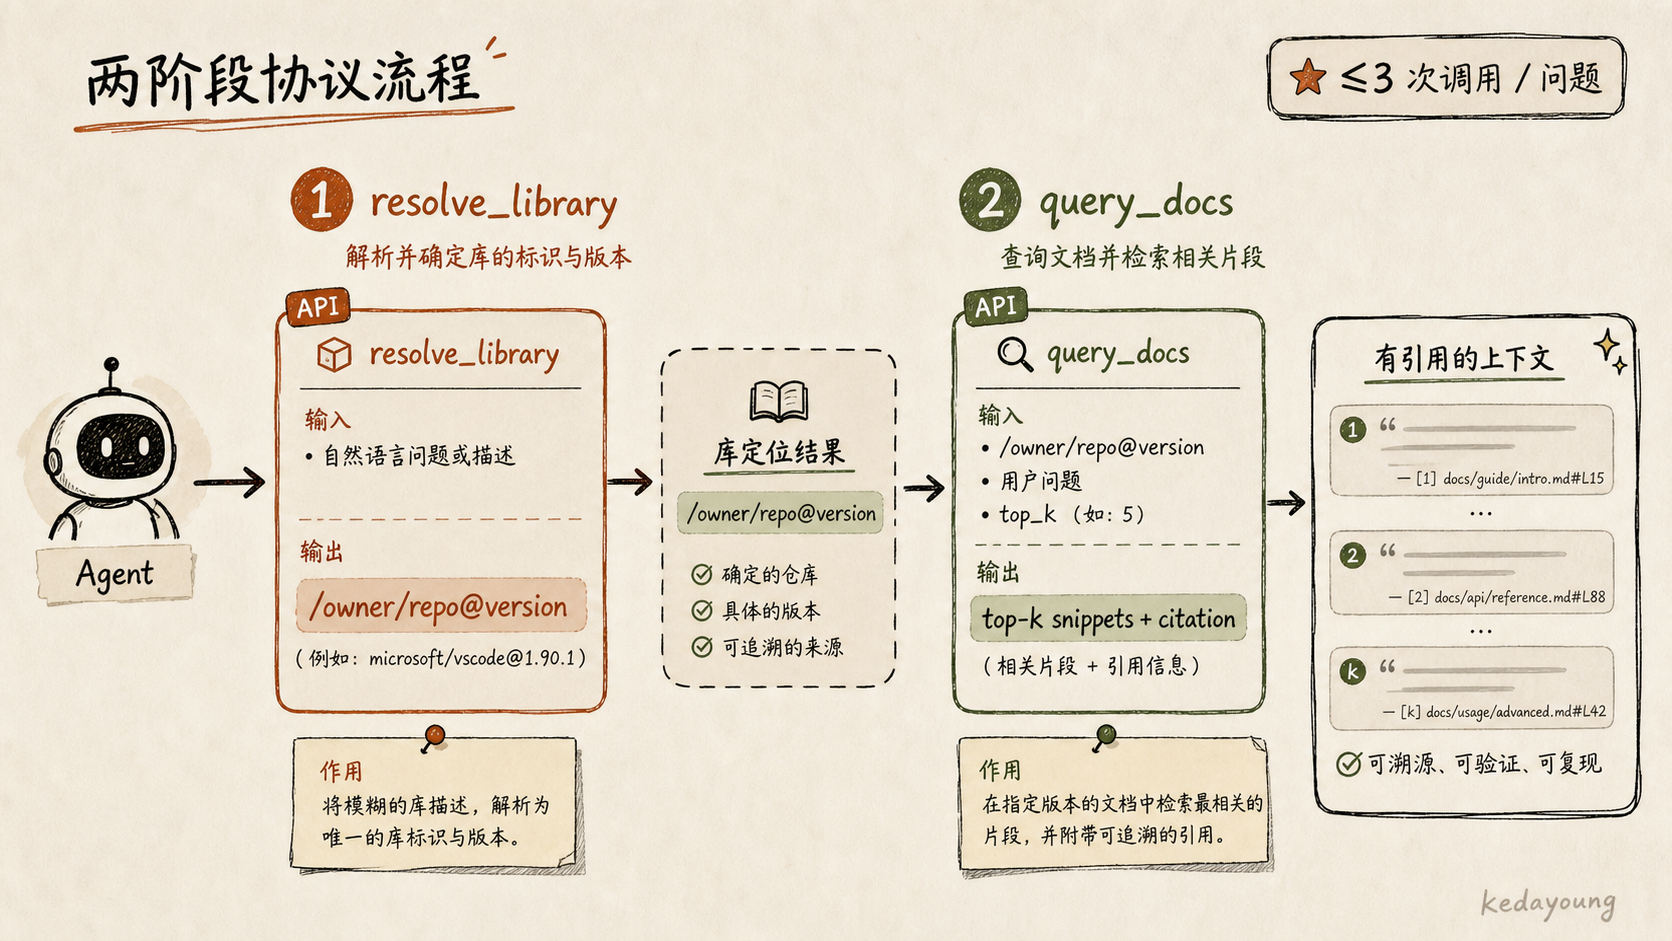
现在进入核心机制。Context7 的 MCP server(packages/mcp/src/index.ts)对外只注册两个工具:resolve-library-id 和 query-docs(index.ts:174-262、264-308)。注意,这里我按代码里的真实命名来写——「resolve → query」是大纲里的抽象概括,实际工具名是带连字符的 resolve-library-id / query-docs。
先看第一段:resolve-library-id。它的输入是用户问题(query)和库名(libraryName),输出是一组候选库,每个候选带 library ID(格式 /org/project)、名称、描述、代码示例数量、来源信誉(Source Reputation:High/Medium/Low/Unknown)、基准评分(Benchmark Score),以及可用的版本列表(index.ts:182-189)。工具 description 甚至给出了完整的「选择流程」:按名称相似度、描述相关性、代码示例覆盖率、来源信誉来选,模糊时先澄清再猜(index.ts:193-208)——一份连「怎么选、何时该澄清」都写好的 description,本质是给模型的决策规则书。
再看第二段:query-docs。它接收一个精确的 library ID 和一个具体问题(query),返回检索到的文档上下文(index.ts:295-307)。library ID 支持 pin 版本:/vercel/next.js/v15.1.8 或 /vercel/next.js@v15.1.8(docs/api-guide.mdx:53-58),OpenAPI 里的正则约束是 ^/[^/]+/[^/]+([/@][^/]+)?$(docs/openapi.json:1487)。
为什么设计成两段?(以下为作者判断)把「寻址(哪份文档)」与「检索(查什么)」拆开,至少带来三个好处:
- 消歧与稳定:库名是含糊的("next" 可能指 Next.js 也可能指别的),但
/vercel/next.js是稳定的标识符。第一段把含糊的库名收敛成精确 ID,第二段就永远拿着确定的目标去查,减少因为「查错库」带来的幻觉。 - 版本可 pin:第一段的返回里带上版本列表,模型可以按用户需求把版本钉死,避免拿到「最新版文档」回答「旧版 API」的问题(或反之)。
- 成本可计量:两段调用是有明确次数上限的——两个工具的 description 里都写着同一句
Do not call this tool more than 3 times per question(index.ts:210 与 index.ts:272)。这等于把「上下文成本」变成了协议的一部分:模型每轮问题最多消耗几次检索调用,预算明确、可审计。这背后是一个更深的判断:上下文不是免费的,检索调用的次数就是最直接的计量单位。
两段式还有一个容易被忽略的工程红利:第一段的产物(library ID)是稳定、可复用、可缓存的中间值。ID 一旦解析出来,它就是一个精确的寻址句柄——用户可以在 prompt 里直接写 use library /supabase/supabase for API and docs,让 agent 跳过第一段直达第二段(README.md:67-73);上层缓存一个「库名 → ID」的映射,就能省掉反复解析的开销。寻址与检索分离,让「花一次代价找到地址、之后反复用地址」成为可能,这跟 DNS 把域名解析成 IP、再复用 IP 连接是同一个思路——稳定的中间标识符是协议设计的经典杠杆。
一个特别值得玩味的工程细节是 aliasArgs 机制(index.ts:109-145)。代码注释写得明明白白:LLM 客户端经常照抄工具 description 里的措辞,而不是字面 schema 键名,导致 Zod 校验失败。于是 server 在 schema 校验前做了一层别名改写:userQuery/question 会被改写成 query,context7CompatibleLibraryID/libraryID/libraryName 会被改写成 libraryId。换句话说,这个服务在协议层就预设了模型会幻觉参数名,并做了防御。这不是 bug 修复,这是对「调用方是 LLM」这一现实的系统性适配——协议设计时就把模型的不可靠当作输入条件。
把这段综合起来,设计含义就浮出来了:这回答了一个更一般的问题——外部知识检索怎么设计成 agent 协议?Context7 的答案是:不是给模型一个万能搜索工具(那会失控),而是给一组「有限次、可寻址、带版本」的专用工具,把检索的边界和语义都写死在工具定义里。模型在这套协议里是被引导的,不是被放飞的。
如果抛开 MCP 外壳,直接看 REST 层,两段式对应的就是两个 API:GET /api/v2/libs/search(按库名找库)和 GET /api/v2/context(按 libraryId + 问题取上下文),官方 API 文档给了完整的端到端调用示例(docs/api-guide.mdx:64-97)。也就是说,无论是 MCP 工具还是 REST 端点,「先寻址、再检索」的结构完全一致——协议在不同接入面上表达的是同一套逻辑。
3. snippet 数据结构:上下文的最小可信单元
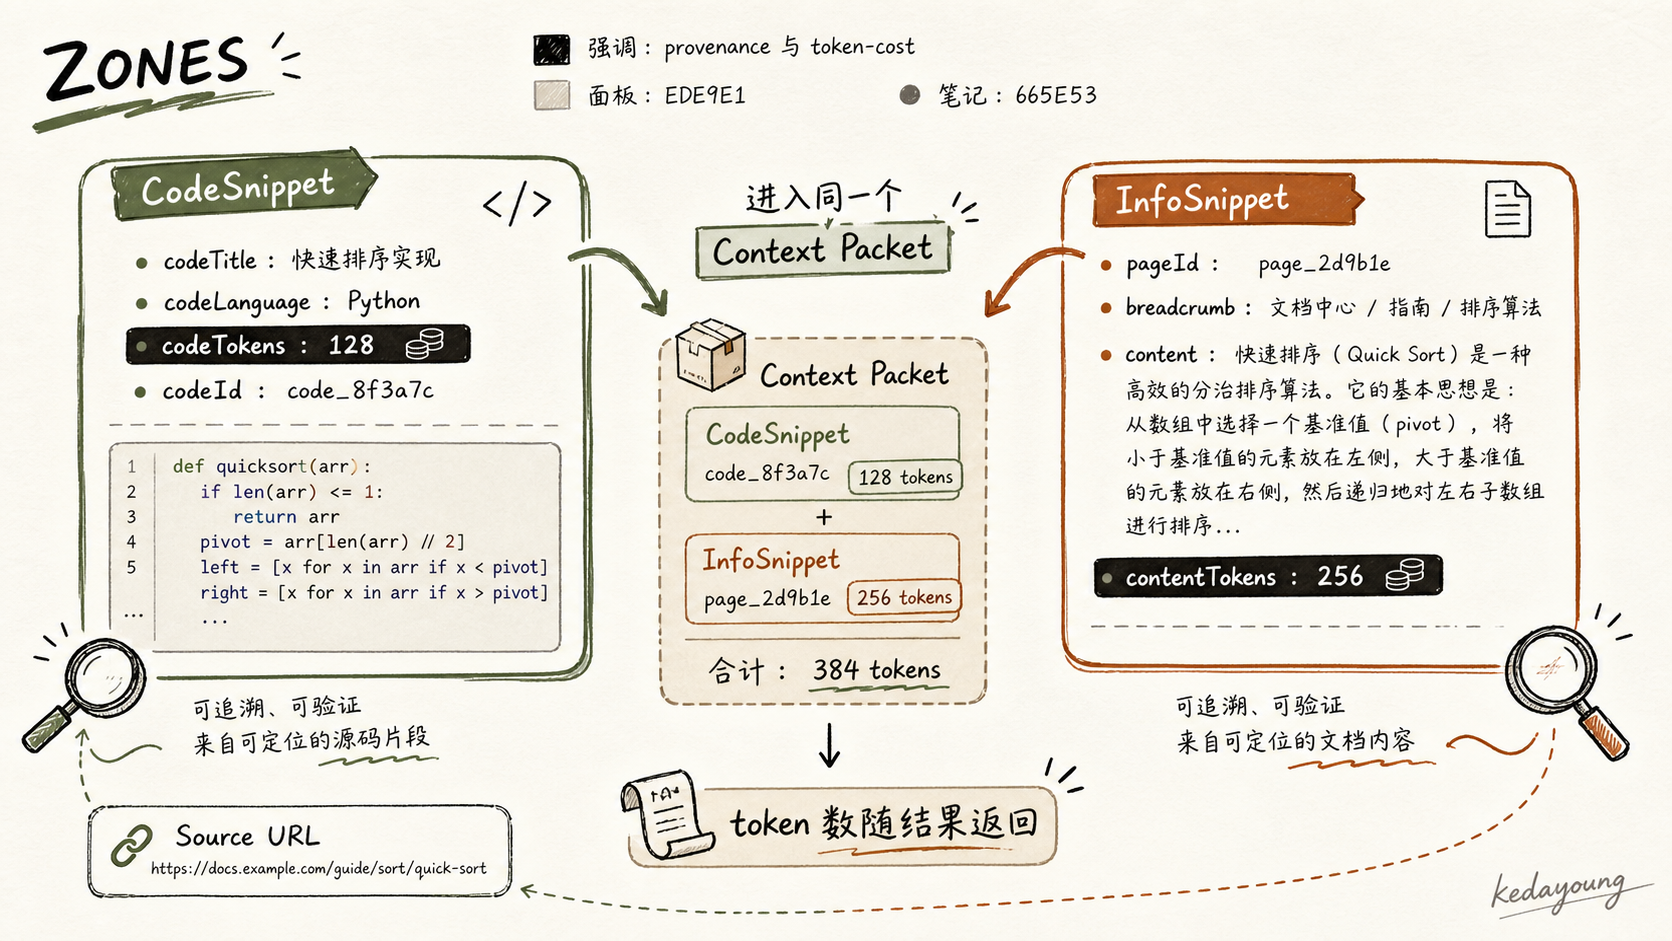
检索结果长什么样?这是协议设计的第二层:数据单元。Context7 的检索响应不是「整页文档」,而是两种精心设计的片段类型,定义在 OpenAPI schema 里(docs/openapi.json:1662-1758):
CodeSnippet(docs/openapi.json:1662-1715)——代码示例片段,字段:
| 字段 | 含义 |
|---|---|
codeTitle / codeDescription | 片段标题与「这段代码做什么」 |
codeLanguage | 主语言 |
codeTokens | 该片段的 token 数 |
codeId | 源码位置的 URL(溯源) |
pageTitle | 所属文档页标题 |
codeList | 多语言的代码示例数组 |
isDynamic / sourceFile | 动态源码索引标记 / 仓库内源码路径(动态片段专用) |
InfoSnippet(docs/openapi.json:1734-1758)——说明性文档片段,字段:
| 字段 | 含义 |
|---|---|
pageId | 来源页面 URL(溯源) |
breadcrumb | 导航面包屑(如 Routing > Middleware) |
content | 文档正文 |
contentTokens | 该片段的 token 数 |
响应体 ContextResponse 把两者并列返回:codeSnippets + infoSnippets 双通道,代码示例与文字说明分开(docs/openapi.json:1760-1777),另外还带一个可选的 rules 字段(团队/库所有者注入的规则)。
看一个具体的文本渲染,能更直观地理解「溯源内建」长什么样。OpenAPI 的 text/plain 响应示例里,返回内容以 ### Middleware Authentication Example 开头,紧跟着一行 Source: https://github.com/vercel/next.js/blob/canary/docs/middleware.mdx,然后是代码块(docs/openapi.json:266-271)。也就是说,模型在 prompt 里看到的不是「一段代码」,而是「这段代码的出处 + 这段代码」。当模型回答时,它可以(也应该)在答案里带上这个 Source——这正是「让模型可以看来源,而不是盲信」的机制化实现。
一个容易被忽略的细节是 CodeSnippet 还有两个「动态」字段:isDynamic(该片段是否来自动态源码索引,而非主文档索引)与 sourceFile(仓库内相对源码路径)(docs/openapi.json:1697-1701)。这意味着检索结果不只是「文档里写了什么」,还可能直接来自源码本身——当文档没覆盖到某个用法时,检索可以从代码仓库里找回真实的调用示例。这是把「文档之外的知识」也纳入上下文的一条通道,也让 sourceFile 成为比页面 URL 更精确的溯源锚点。
还有一个容易被忽略的字段是 ContextResponse.rules(docs/openapi.json:1778 起):响应可以携带库所有者或团队定义的规则,让「这个库应该怎么用」的隐性约定也随检索结果一起进上下文——检索回来的不只是知识,还有规范。
把「溯源」内建进数据单元,是这个设计最狠的一招。每个 snippet 自带来源 URL 和面包屑,text/plain 渲染里那一行 Source: 就是它的直接体现。效果是:模型可以「看来源」而不是盲信——它拿到的不是一段孤零零的代码,而是一段「我知道自己从哪来」的代码。配合第二层,codeTokens/contentTokens 把成本信息随数据一起返回——模型或上层框架拿到 snippet 的那一刻,就知道这段上下文会吃掉多少 token,可以据此做预算决策(裁剪、合并、排序)。这是「最小充分工作集」思想在数据结构层面的落地:上下文单元不是「整页文档」,而是「带出处的代码/说明片段」——给模型的不是一片海洋,而是一勺一勺可以称重的海水。
从上下文工程的角度看,这套结构回答了三个问题,而这三个问题恰恰是「把外部知识喂给模型」时最容易含糊的:
- 可信吗? → 每个片段带 URL + breadcrumb,可溯源。
- 多贵? → 每个片段带 token 数,成本透明。
- 够吗? → 代码与说明分开给,覆盖「照着写」和「理解原理」两种需求。
4. 客户端接入面:MCP / CLI / Skills / agent 适配矩阵
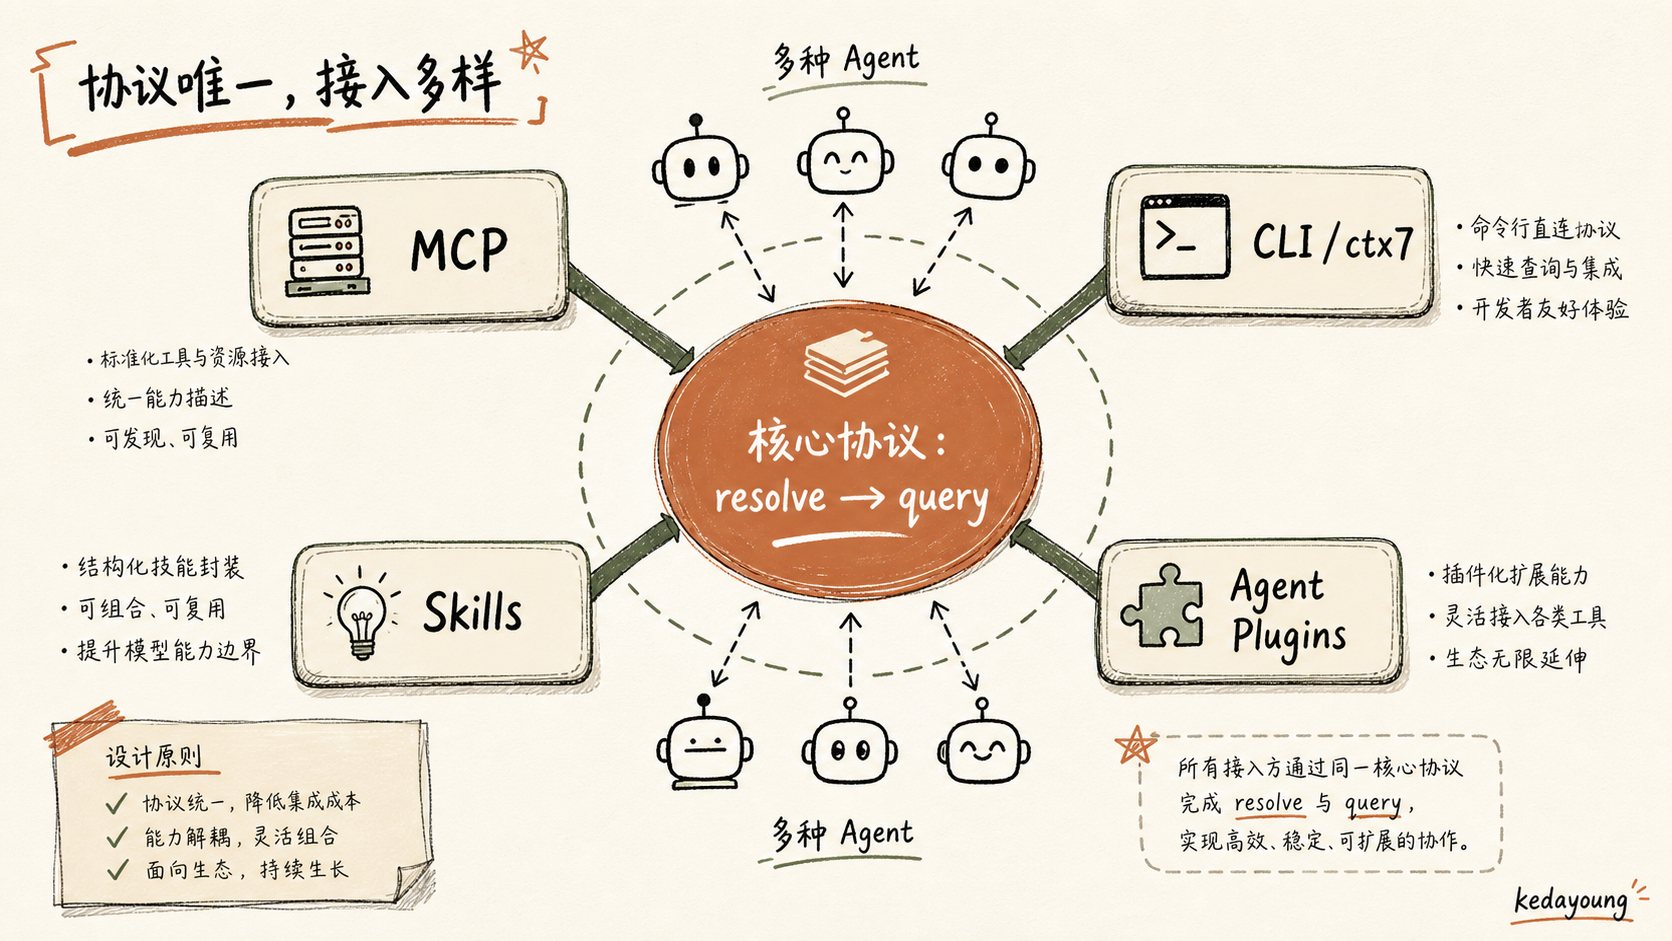
协议的价值,最终要看它被多少种形态的客户端使用。Context7 的接入面非常宽,但底层协议只有一个,这本身就是设计信号。按接入形态从「最贴近模型」到「最贴近用户」梳理:
MCP server(主入口)
两个工具的注册代码就是协议本体(packages/mcp/src/index.ts:174-308)。server 级 instructions 已经把「什么时候该查文档」写成了给模型的指令(第 1 节引用过那句「Use even when you think you know the answer」);工具级 description 更进一步,连 query 怎么写都教:query-docs 的 description 写着「scoped to a single concept… if the user's question spans multiple distinct concepts, make a separate call per concept」(index.ts:284)。这就是prompt 工程藏在工具描述里:工具定义既是 schema,又是使用指南,模型在「学会调用工具」的同时被完成了「学会检索」的教育。
CLI(ctx7)
命令 ctx7 library <name> <query> 与 ctx7 docs <libraryId> <query> 与 MCP 工具一一对应(README.md:101-113)。真正有意思的是 skills generate 子命令(packages/cli/src/commands/generate.ts:305-371):它用检索结果生成一份库专属的 skill——命令先逐条检索库文档(queryLog 记录每次查询与返回),再把读到的内容组织成一个 skill 文件,让 agent 以后查这个库时按这份 skill 行事。skill 的内容本身来自检索结果:这是「AI 为 AI 服务」的飞轮——检索系统产出的上下文,反过来变成另一个 agent 的长期指令。
Skills 形态
仓库里带三份 skill(skills/find-docs、skills/context7-cli、skills/context7-mcp)。以 find-docs 为例,它的 frontmatter description 就是触发指南(「Use this skill whenever the user asks about a specific library… even for well-known ones like React, Next.js」),正文是 CLI 用法;最值得看的是它的反幻觉 fallback(skills/find-docs/SKILL.md:144-151):如果检索失败或配额用尽,skill 明确要求「answer from training knowledge and clearly note it may be outdated」「Do not silently fall back to training data — always tell the user why Context7 was not used」。换句话说,协议把「何时可以退回训练知识」这种道德问题,也写成了可执行的规则——宁可承认不知道,也不静默用过期知识糊弄。
Agent 适配矩阵
packages/cli/src/setup/agents.ts:108-286 里为 6 个 agent(Claude Code、Cursor、OpenCode、Codex、Antigravity、Gemini)各定义了一份配置:装到哪、MCP 配置怎么写、rule 放哪、skill 放哪,全部是声明式数据;plugins/ 目录下还有 claude / cursor / codex / copilot / context7-power 等插件形态。对用户来说,安装适配被折叠成了一条命令(细节见下文)。
把四类接入面放在一起看,设计含义就很清楚:接入面多样(MCP/CLI/Skill/插件),核心协议唯一(resolve→query)——这正是「协议设计优于 SDK 绑定」的实例:只要协议是公开稳定的,每多一个客户端形态,都只是配置问题,而不是重新实现一遍检索逻辑。
README 把这种「协议统一、形态分化」讲得更直白:Context7 工作于两种模式——CLI + Skills(装一个 skill,引导 agent 用 ctx7 命令查文档,不需要 MCP)和 MCP(注册 MCP server,agent 原生调用文档工具)(README.md:39-42)。两种模式下层是同一个 resolve → query 协议,只是载体不同。而对用户来说,连「选哪种模式、装到哪个 agent」这种决策都被折叠进了一条命令:npx ctx7 setup 会完成 OAuth 认证、生成 API key、安装对应 skill,并支持 --cursor、--claude、--opencode 指定目标 agent(README.md:49-57)。协议化带来的规模效应在这里体现得最明显:接入一个新 agent,不需要写新代码,只需要在 agents.ts 里加一份「装到哪、配置怎么写」的声明(agents.ts:108-286)。
5. 上下文的新鲜度:分级刷新与 ingest 异步化
「最新」由什么保证?这是前四节埋下的伏笔——协议能承诺「新鲜」,靠的不是客户端,而是服务端一套与查询解耦的刷新机制。以下均为服务端行为,以官方文档为准,代码未公开。
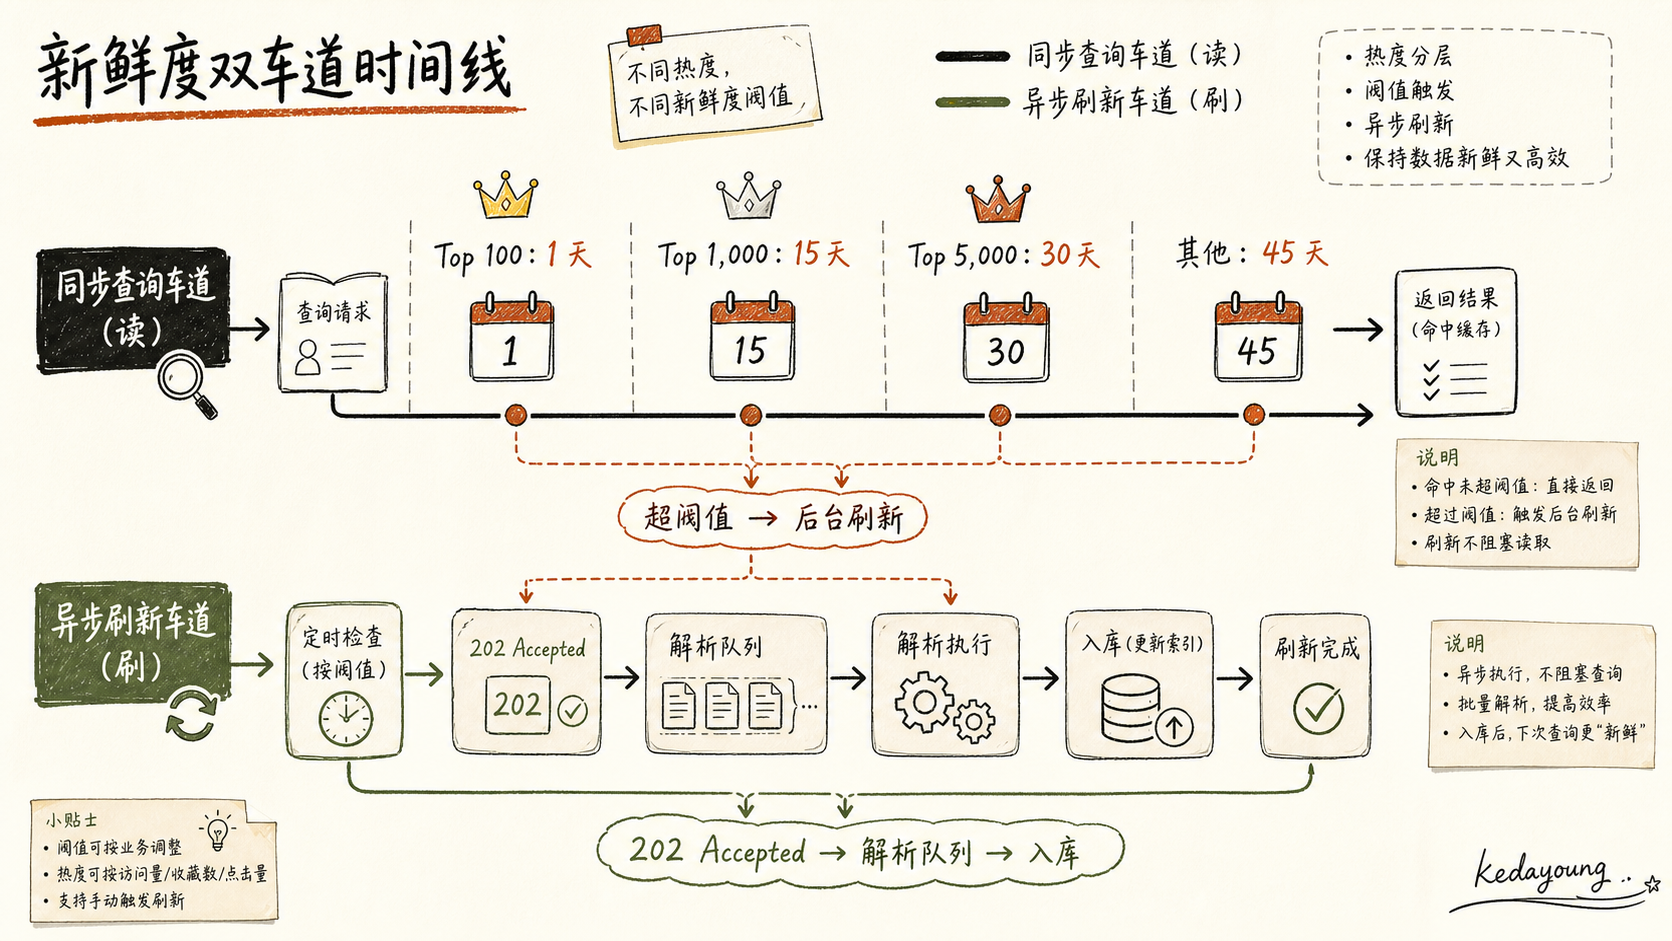
分级刷新阈值(docs/library-updates.mdx:10-27)。Context7 按流行度把库分成四档,每档一个「陈旧度阈值」:
| 流行度排名 | 刷新阈值 |
|---|---|
| Top 100 | 1 天 |
| Top 1,000 | 15 天 |
| Top 5,000 | 30 天 |
| 其他 | 45 天 |
逻辑很朴素:越流行的库,开发者依赖越重、更新越快,所以刷新越勤。每次库被请求时,系统检查「上次更新时间是否超过阈值」,超了就在后台触发刷新,当前请求立刻返回现有文档,不受影响(library-updates.mdx:26-27)。注意「最近被请求过」也是触发条件之一——没人用的库不会白白刷新,资源花在活跃文档上(library-updates.mdx:37-42)。
ingest 异步化
刷新不是同步的「重新抓一遍再返回」,而是走异步任务:提交解析后接口返回 202 Accepted — Library not finalized, wait and retry later(docs/api-guide.mdx:183)。对调用方(agent 或上层工具)来说,202 是一个重要的协议信号:它告诉调用方「入库是异步的,别傻等,稍后重试」,把「文档还没准备好」从错误变成一种可预期的状态——这比同步阻塞或静默失败都更诚实,也让「查询走快路径、入库走慢路径」的分工在协议层就成立。
在企业级部署里,这种异步化做得更彻底:所有副本从 PostgreSQL 里的同一个共享队列拉解析任务,索引吞吐随副本数扩展(scaling.mdx:315)——入库是「排队慢慢做」,查询是「立即返回」,两者之间隔着一条队列。
触发方式
除了自动分级刷新,还有两条手动/主动路径:POST /api/v1/refresh 手动触发(docs/api-guide.mdx:23),以及 CI 集成——在 GitHub Actions 里配一个 push 触发的工作流,文档变更一提交就调 refresh 接口(docs/integrations/github-actions.mdx:25-46)。这等于把「文档保鲜」从「等平台刷新」变成「库作者自己控制节奏」。
入库来源
能进 Context7 索引的不只是 GitHub 仓库:API 文档里列了 10 个入库端点(docs/api-guide.mdx:27-36),覆盖 Git 系(GitHub/GitLab/Bitbucket/其他 Git)、OpenAPI(URL 与文件上传)、llms.txt、网站爬取、Confluence、Notion——一个库的文档可能是 GitHub 仓库、官网、OpenAPI spec 或 wiki,统一进同一个索引。这种来源的多样性,正是「分级刷新」要覆盖的前提:不同来源的文档保鲜节奏不同,统一交给分级阈值管理。
这套刷新体系里还有几个值得注意的细节,补全一下全貌:库所有者如果认领了自己的库(claimed library),会拿到更高的刷新限流,能更自主地控制文档更新节奏(library-updates.mdx:33);私有库不自动刷新,只能手动触发(library-updates.mdx:44-46);网站类来源的阈值比通用值略高(library-updates.mdx:23)。这些细节说明「分级」不是一刀切,而是把「谁在乎新鲜、谁有权刷新」都纳入了设计——流行度决定默认节奏,所有权决定例外权限。
设计含义是本节最重要的结论:「新鲜度」是上下文质量的前置条件,但 Context7 把「保鲜」和「取用」彻底解耦了——刷新在后台异步进行,查询永远走「现有索引 + 命中即返回」的快路径,「保鲜」不拖慢「取用」。这与 Continue 的本地索引路线(在用户机器上建索引、增量更新)是两种截然不同的保鲜哲学,下一节展开对照。
6. 与本地检索路线的对照与可迁移经验
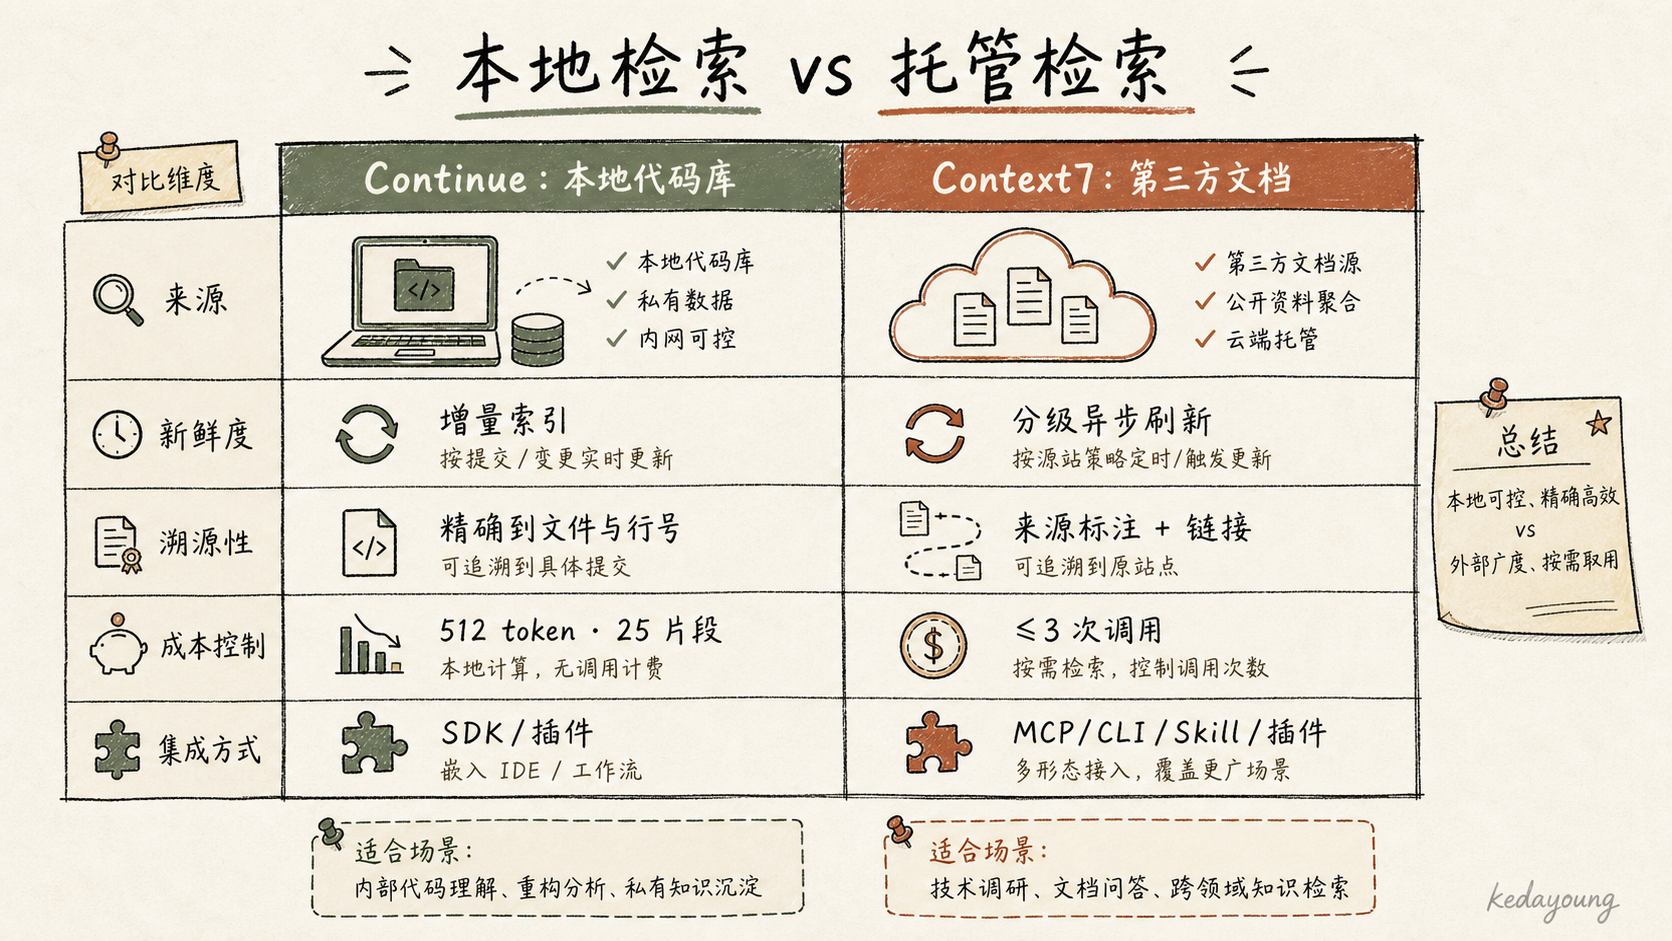
把 Context7 放进 0-context-engineering 系列里,它的位置就清晰了——它回答的是「外部知识怎么进上下文」这一端,与 Continue(本地多路召回)走的是相反的路线。对照如下:
| 维度 | Continue(本地检索) | Context7(托管检索) |
|---|---|---|
| 上下文来源 | 用户代码库(本地索引) | 第三方库文档(云端托管) |
| 检索入口 | ContextProvider 插件(getContextItems) | MCP 两段式工具(resolve-library-id → query-docs) |
| 新鲜度 | 本地索引增量更新 | 分级异步刷新(托管) |
| 溯源 | itemId / providerTitle | codeId / pageId + token 数 |
| 成本控制 | 检索预算(512 token/25 片段) | 调用次数限制(≤3 次/问题) |
| 集成 | SDK/插件 | MCP / CLI / Skill / 插件矩阵 |
差异的本质在来源与归属:一个向内(你的代码,索引在本地),一个向外(别人的文档,索引在云端)。对普通开发者来说,这两者不是竞争而是互补——写代码时既需要自己代码库的上下文,也需要所依赖库的最新文档。
从 Context7 里能带走的,是四条可迁移的模式(以下为作者判断):
- 把外部知识检索设计成「有限次、可寻址、带版本」的工具协议,而不是万能搜索。模型需要的不是「一个能搜一切的工具」,而是「一组边界清晰、语义明确、成本封顶的专用工具」。≤3 次/问题的约束不是限制,是预算。
- 把溯源与成本内建进数据单元(URL + token 数)。上下文单元自带出处和价格,模型与上层框架才能做「信不信、用不用、用多少」的决策。溯源是信任的基础设施,成本是决策的基础设施。
- 让新鲜度与查询解耦:分级刷新 + 异步 ingest。「保鲜」是后台的长期职责,「取用」是前台的即时动作,两者之间用队列隔开,互不拖累。
- 让工具 description 承担 prompt 工程。把「怎么查、查几次、什么时候不要查」写进工具定义,模型在调用工具的同时被完成了使用教育——甚至包括「参数名可能记错」这种幻觉防御(aliasArgs)。
这条对照最实用的落点是一句话:先问「我要查的知识住在哪里」。住在自己代码库里(项目结构、内部约定、历史决策)→ 本地索引路线(Continue)更合适,因为它贴着你的代码走、离线可用;住在外部世界里(依赖库的新版本、框架的最新 API、服务商的配置)→ 托管协议路线(Context7)更合适,因为它把「保鲜」这件麻烦事外包了,你要的只是「一个能查到最新文档的工具」。两者不互斥:一次编码任务里,「自己的代码」和「依赖的文档」常常同时需要,理想形态是两条路线各司其职。
回看系列定位:0-context-engineering 主题现在有四条路线——hello-agents(教学流水线)、pi(生产压缩优先)、Continue(本地插件化检索)、Context7(托管协议化检索)。四篇合在一起,恰好覆盖了上下文工程的两个轴:横轴是「来源在本地还是托管」,纵轴是「上下文在内部怎么组装还是对外怎么提供」。本篇(Context7)站在「外部 × 协议」这个象限:它证明上下文工程不只发生在「本地如何组织消息」,也可以发生在「外部如何提供可溯源、保鲜的知识」——而协议化正是这类上下文来源的关键设计。
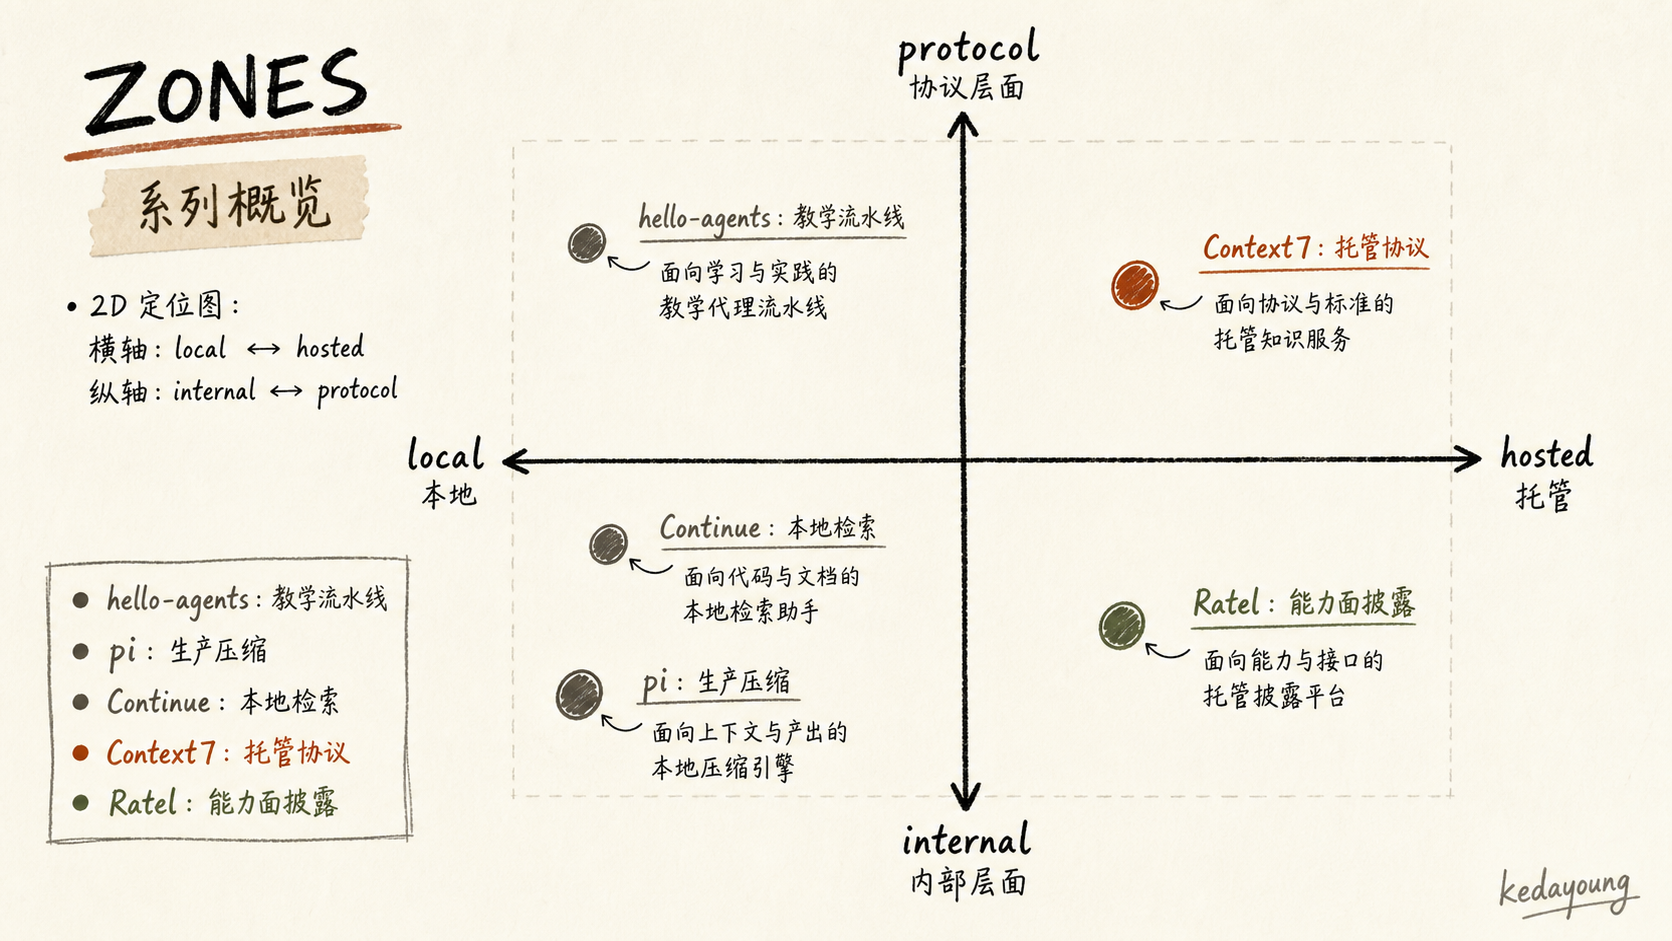
(示意:按「上下文来源住在哪」分列——本地三条路线,托管一条;Context7 是唯一把上下文来源外置为托管服务的路线。)
附录 A:证据清单
本文所有断言对应的仓库证据(仓库根:0-context-engineering/20260810-context7/repo/,main 分支快照,2026-08-11 克隆):
| 断言 | 证据位置 |
|---|---|
| 仓库边界声明(后端私有) | README.md:136 |
| 两段式工具协议 | packages/mcp/src/index.ts:174-262(resolve-library-id)、:264-308(query-docs) |
| 检索调用次数限制 ≤3 次/问题 | packages/mcp/src/index.ts:210、:272 |
| 工具 description 即 prompt(instructions) | packages/mcp/src/index.ts:168-170;query 写作指南 :284 |
| 幻觉参数名改写(aliasArgs) | packages/mcp/src/index.ts:109-145 |
| 库 ID 寻址与版本 pin | docs/api-guide.mdx:53-58;正则 docs/openapi.json:1487 |
| CodeSnippet 结构 | docs/openapi.json:1662-1715 |
| InfoSnippet 结构 | docs/openapi.json:1734-1758 |
| 双通道响应(codeSnippets + infoSnippets) | docs/openapi.json:1760-1777 |
| 文本返回带 Source 行 | docs/openapi.json:266-271 |
| 分级刷新阈值 | docs/library-updates.mdx:10-27(后台刷新不阻塞 :26-27) |
| ingest 异步(202 Accepted) | docs/api-guide.mdx:183;共享解析队列 docs/enterprise/deployment/scaling.mdx:315 |
| CI 触发刷新 | docs/integrations/github-actions.mdx:25-46 |
| 入库来源(10 个端点) | docs/api-guide.mdx:27-36 |
| CLI skills generate | packages/cli/src/commands/generate.ts:305-371 |
| agent 适配矩阵(6 个 agent) | packages/cli/src/setup/agents.ts:108-286;plugins/ |
| skill 反幻觉 fallback | skills/find-docs/SKILL.md:144-151 |
写作边界说明:
- 服务端行为(抓取、解析、嵌入、检索流水线、分级刷新)全部以
docs/与docs/openapi.json为据,正文已显式标注「服务端私有,以官方文档为准」,未暗示代码在仓库内。 - 本文未实际调用 CLI/MCP 做真实查询,检索返回结构仅引用 OpenAPI schema(
docs/openapi.json),未展示真实请求样例。 - 「两段式设计的原因」「可迁移模式」为作者判断,已在正文标注。