证据版本:本地克隆
0-agent-evaluation/20260810-cua/repo/,commit41e47b5(2026-08-11 main 快照)。除标注「仓库声明」「作者判断」或「作者理解」处外,所有行号引用均可在该快照中核对。
中心论点
cua 是一个「驱动 + 评测 + RL」三件套 monorepo——driver 侧提供可验证、可录制的背景计算机操作能力(不偷焦点、snapshot-before-action、verify_state、轨迹录制),cua-bench 提供 Gym 式评测环境(reset/step/solve/evaluate)让任意 computer-use agent 可被测,评测轨迹又直接导出为 RL 训练数据(GRPO)——「驱动 → 验证 → 录制 → 训练」形成闭环。它回答的是「GUI agent 如何被可靠地驱动、打分并持续变强」,也是当前评测主题里唯一把「评测」与「训练」直接接在一起的路线。
给一个 LLM 出题:「把邮箱里第一封未读邮件标为已读。」对文本评测来说,判定等于比对输出字符串;对 GUI 评测来说,判定等于「那个复选框的状态真的变了吗」。后者远不是 agent 能力问题——它需要一套能把输入注入真实操作系统、能读到元素状态、能隔离现场、还能把整个过程存下来的环境。四者缺一,评测就不成立。
这就是 computer-use 评测与文本/工具评测的根本分野:判定对象从「输出字符串」变成了「环境状态」。而 trycua/cua 的路线是把这个难题拆成三个可独立复用的部分:跨 OS 的背景驱动(cua-driver)、Gym 式评测环境(cua-bench)、以及评测即训练数据的 RL 闭环。本文按这条路线,讲清每一部分对应的真实代码。
先做一个思想实验:给 agent 一张截图,让它「把右上角的按钮点一下」。agent 或许能猜出按钮的位置,但评测真正需要的是:点击真的落在那个按钮上、按钮真的响应了、这个响应等价于任务完成、以及这一切被记录下来可供复盘与复用。任何一环是黑盒,评测就退化成「看起来对」的表演。下文所有机制,都是为了让这些环节从黑盒变成可检查、可断言、可复用的接口。
1. computer-use 评测的难点:GUI 环境不可控
评测一个「会点鼠标」的 agent,到底在评测什么
文本与工具调用的评测,环境是可控的:输入是一段字符串,输出是一段字符串或一个 JSON,判定可以用精确匹配、脚本断言或产物比对。bfcl-gaia / agentbench 一类评测走的正是这条路线——它们的工程重点在于判定确定性(同一条输出在不同运行下得分一致)与回归管理。
GUI 评测没有这个便利。agent 的「输入」是鼠标键盘事件、「输出」是环境状态的变化,而环境是真实操作系统与真实浏览器。于是四件事必须同时成立:
- 驱动(Drive):能向 OS 注入输入、能感知屏幕,且不干扰真人使用;
- 隔离(Isolate):评测跑在沙箱/镜像里,失败与污染不影响下一次;
- 判定(Evaluate):能确定性地判断「任务完成了没有」——而这要求环境状态可读、可断言;
- 数据(Data):把 agent 的每一步轨迹存下来——否则失败样本无法复现,更无法变成训练数据。
逐项看它们各自难在哪。驱动难在坐标与焦点:注入一次点击,要同时答对「点给哪个窗口、点在窗口内哪个局部坐标、这次点击会不会抢走用户正在用的焦点」三个问题,分辨率缩放、多显示器、各平台的辅助功能权限都会把这三个问题从「一个函数」变成「一整层基础设施」。隔离难在可重复:评测必须能反复回到同一初始状态,任务的任何写操作(装软件、改配置)都不能污染下一次运行——这要求快照与回滚机制,代价要到第 4 节的双容器架构才看得全。判定难在任务语义:文本评测的答案是字符串,可以精确匹配;GUI 任务却是「把表单填好」「把邮件标为已读」,完成与否只存在于环境的真实状态里——评测者必须能读出那个状态,并把「完成」翻译成可执行的谓词。数据难在结构:文本评测天然留下 prompt/response 对,GUI 轨迹却是「屏幕状态序列 + 动作序列 + 终局结果」,没有驱动层的主动录制,失败样本连复现都做不到。
四个问题环环相扣:判定依赖感知的确定性(看不到状态就无从断言),数据依赖驱动的可录制性(操作不可记录就无轨迹可用)。所以 GUI 评测本质上是一个系统问题,不是一个 prompt 问题。
cua 的结构化回答:monorepo 三件套
cua 用工程结构来回应:README.md:23-58 把仓库定位为四块——Drivers(跨平台驱动)、Cua sandbox(隔离环境)、Cua-Bench(评测与 RL)、Lume(macOS 虚拟化);README.md:159-169 的 Packages 表进一步给出组件归属。对应本文关心的两条主线:
libs/cua-driver/rust/(Rust)——被驱动的能力层:agent 通过 MCP 协议获得操作电脑的工具;libs/cua-bench/cua_bench/(Python)——评测与 RL 层:任务声明、环境循环、轨迹录制与 GRPO 训练。
外加两个隔离组件:cua-sandbox(Docker/虚拟机沙箱)与 lume(macOS 虚拟化,评测的隔离底座)。严格说 README 定位的是四块,但 sandbox/lume 是支撑件;本文的「三件套」是围绕「驱动、评测、训练」三件事的组织口径——三件套的分工正好落在前面四个难点上:驱动管「驱动」,sandbox/lume 管「隔离」,cua-bench 管「判定 + 数据」。
图 1|GUI 评测四要素 → cua 三件套映射
驱动 → cua-driver,隔离 → cua-sandbox/lume,判定 → cua-bench;数据在两侧录制——driver 侧(recording.rs)与 bench 侧(tracing.py)。
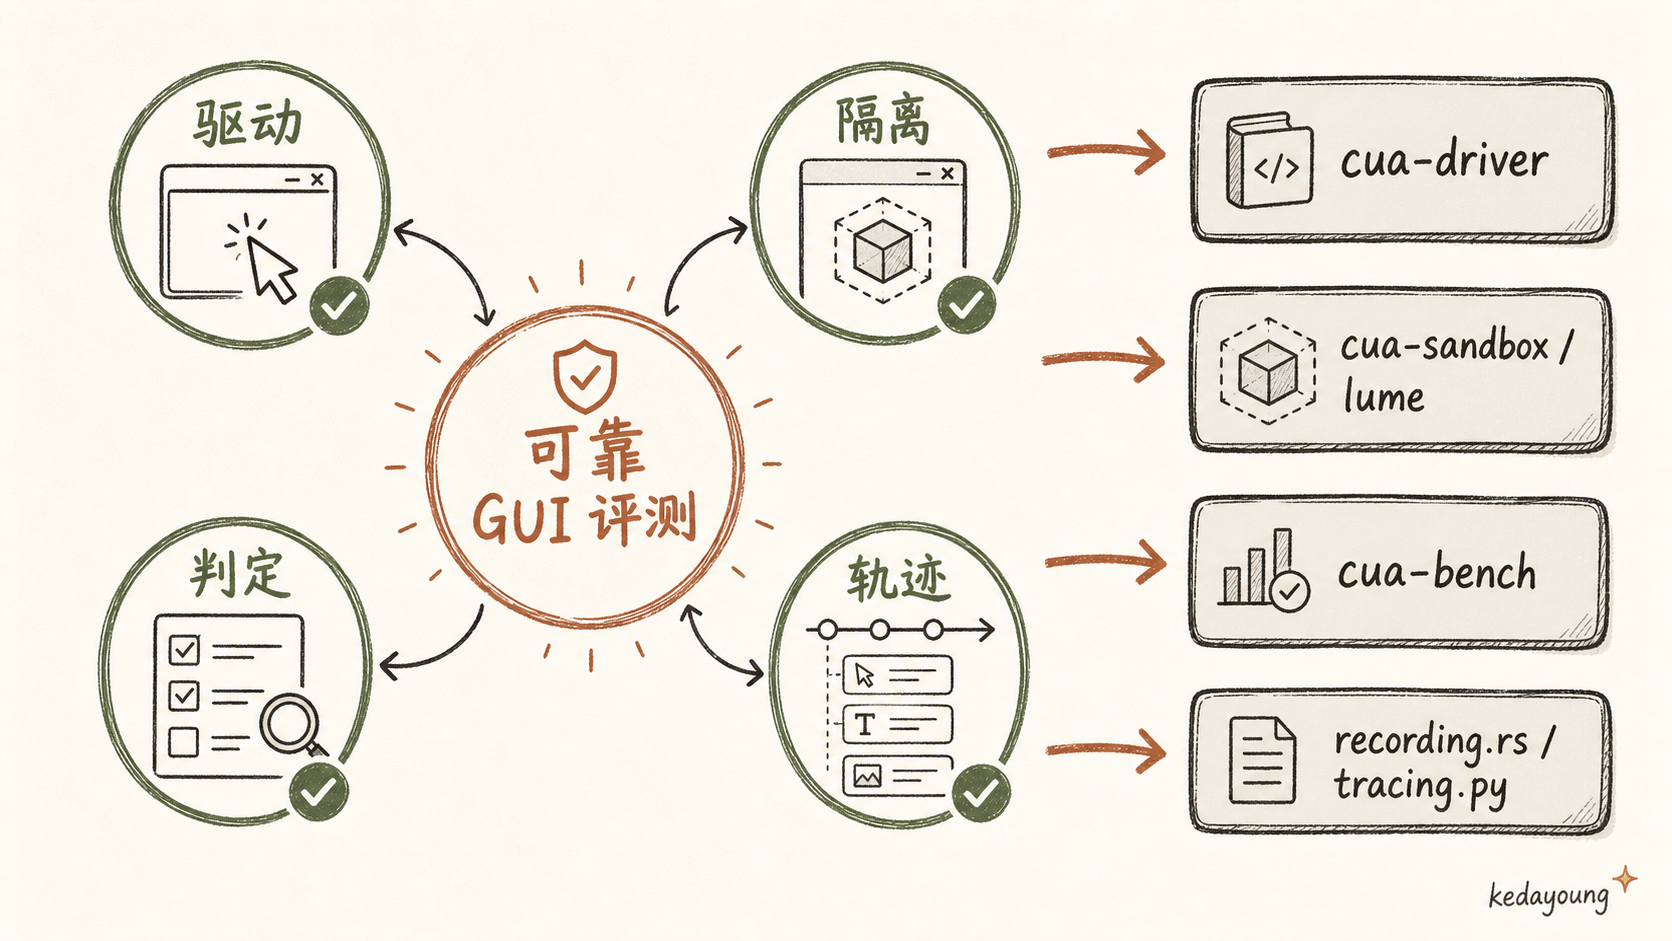
后文按「先会动、再会看、然后会考、最后会练」的顺序展开:第 2–3 节讲 driver(动与看),第 4 节讲 cua-bench 的环境与打分,第 5 节讲评测轨迹如何回流成训练数据。
2. 驱动架构:MCP + daemon + 三平台 + 背景输入安全
协议:agent 用标准 MCP 工具接入
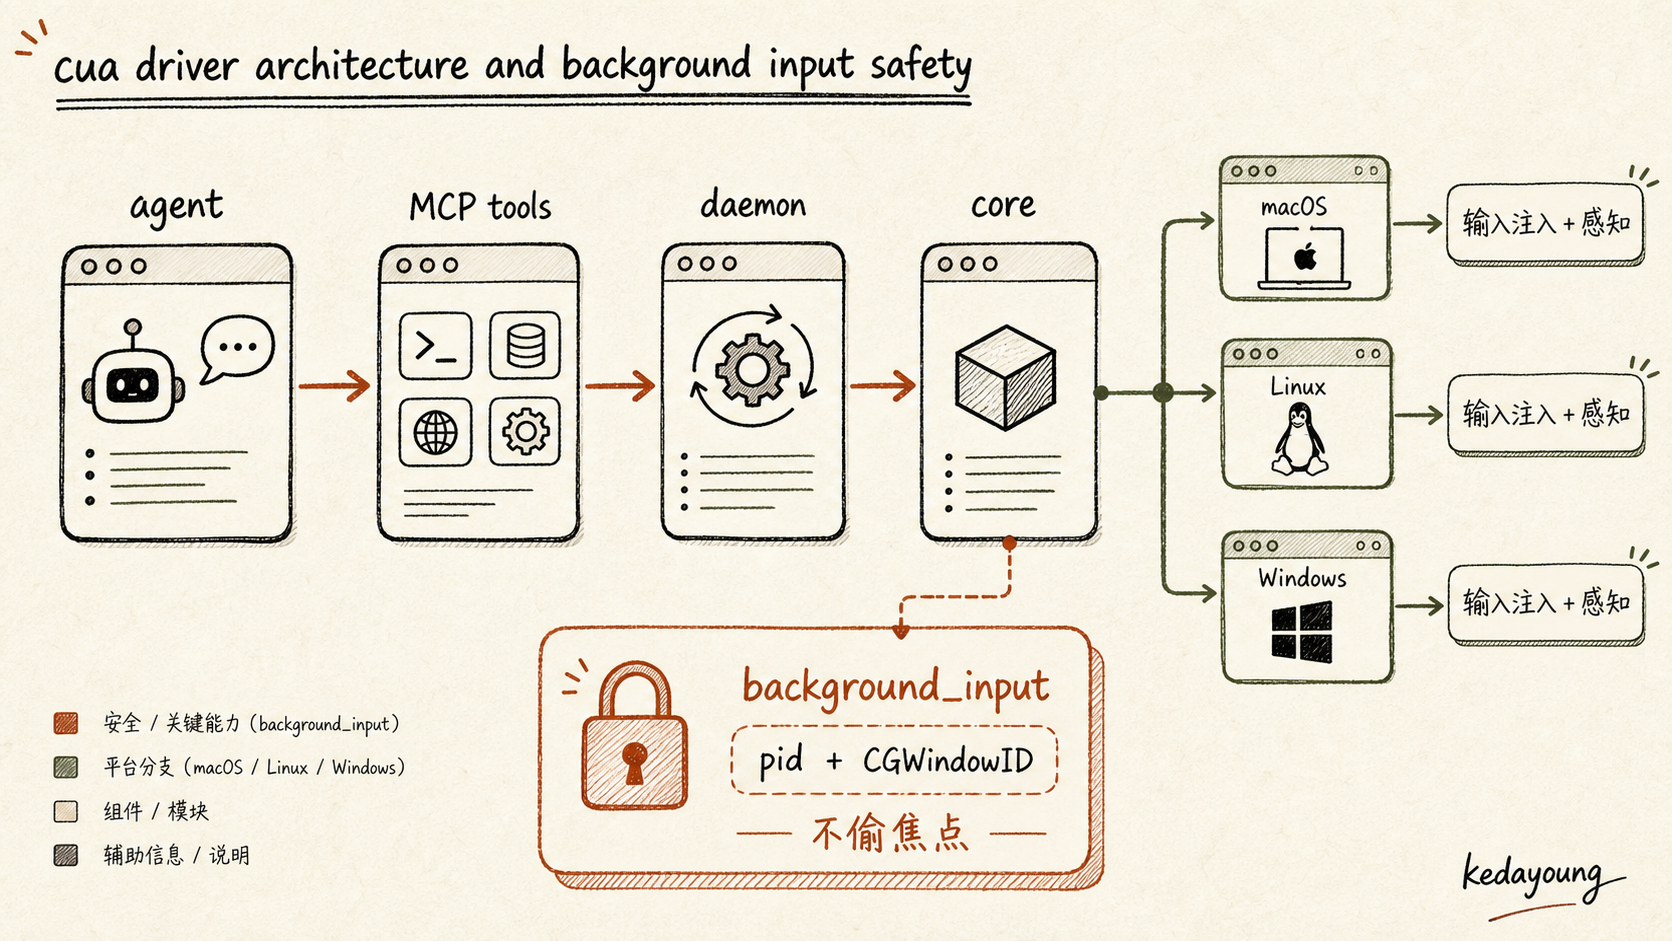
agent 获得「操作电脑」的能力,入口是一个 MCP 服务器:libs/cua-driver/rust/crates/cua-driver-core/src/lib.rs:1-11 列出标准 MCP 方法(initialize、notifications/initialized、tools/list、tools/call),协议类型定义在 cua-driver-core/src/protocol.rs:10-331,分发逻辑在 cua-driver-core/src/server.rs:850-860。换句话说,cua-driver 把「操作系统」包装成了一组标准 MCP 工具——对 agent 而言,点按钮和调用 API 在协议层面没有区别。
daemon:把驱动与客户端进程解耦
MCP 是 stdio 传输,但驱动不能只活在一个进程里——它需要长驻、跨客户端复用,并且让浏览器/CDP、输入注入等子系统独立于 agent 进程运行。cua-driver 用 daemon 架构解决:cua-driver-core/src/daemon.rs:1-9 定义 daemon wire protocol,传输层是平台 socket——Unix domain socket(daemon.rs:207 的 UnixStream::connect)或 Windows 命名管道(路径在 daemon.rs:155-158,非 unix 实现在 :256-292)。入口 libs/cua-driver/rust/cua-driver/src/main.rs:5-6 自述为「runs a daemon-backed MCP JSON-RPC 2.0 proxy over stdio」:客户端进程只负责把 stdio 上的 MCP 请求转发给 daemon。
为什么需要 daemon,而不是让每个 agent 进程自建一套驱动?(作者理解)直接原因有两个。其一是状态复用:CDP 的浏览器会话、窗口句柄、输入注入上下文都是长生命周期资源,每次启动都重建,既慢又容易让前后两次操作上下文断裂——agent 进程可以随时退出,daemon 负责让这些上下文存活。其二是汇流:评测脚本、交互式客户端可能交替使用同一个驱动,daemon 是这些请求的唯一入口,也是后文 background_input 决策能够全局生效的位置。
三平台共享一个 core
驱动能力按平台拆分实现,但共享同一套 core 语义。platform-macos/src/lib.rs:3-7 显示 macOS 后端由 AX(辅助功能 API)、CGEvent/SkyLight(输入注入与窗口)、NSRunningApplication、CGWindow/ScreenCaptureKit 拼成;Windows 用 UIA + Win32,Linux 用 X11 + AT-SPI + Wayland。本文以 macOS 为样本,其它平台只提存在性与差异——三平台的差别主要在「怎么注入、怎么读树」,不在「agent 看到的工具面」。
背景输入安全契约:不偷焦点,是安全而非卖点
GUI 驱动最反直觉的约束是:评测/自动化运行时,用户可能正坐在同一台电脑前。如果驱动每次点击都抢走焦点,自动化就变成了对用户的干扰,甚至不可用。cua 的处理方式是把「背景操作」做成硬性契约,见 cua-driver-core/src/background_input.rs:1-13 的核心注释:
核心注释(转述自
background_input.rs:3-4):每次背景变更必须携带一个精确的(pid, CGWindowID)目标——没有目标,就没有背景操作。
决策集中在 decide_background_input(定义于 background_input.rs:183,文档注释 :170-182):它对每个候选动作给出唯一决策——执行,或带机器可读原因地拒绝。拒绝原因分类为 refusal_codes(background_input.rs:104-113 六个拒绝码),供 agent 理解「为什么不行」而非盲目重试。
背景点击的关键机制在 platform-macos/src/input/mouse.rs:22-33:点击使用 window-local 坐标,mouse.rs:384-389 说明每次事件通过 CGEventSetWindowLocation 设置为窗口内局部坐标,并用 pid 路由投递(SLEventPostToPid)——真实光标不移动,用户看到的是「没发生任何事」,目标窗口却收到了点击。只有桌面级回退分支才会 warp 真实光标(mouse.rs:105-117 的 desktop scope 分支,见 CGDisplay::warp_mouse_cursor_position)。
这就是 cua 驱动层的设计含义:把「不偷焦点」从功能卖点变成 fail-closed 的安全契约。对评测而言这尤其关键——环境不可控的原因之一就是驱动与真人抢机器;把「可用性」和「安全性」做成同一件事,GUI 自动化才谈得上可靠。
这个契约对评测还有一层具体收益(作者理解):被评测的 agent 偶尔会试图「点什么都行」——点任务栏、点无关窗口。背景输入决策在每次动作前强制检查 (pid, CGWindowID),等于给评测加了一道范围约束:操作被限制在 agent 声明的目标窗口内,越界动作拿到的是带机器可读原因的拒绝,而不是静默执行。评测者得到的不是「更乖的 agent」,而是「动作空间被环境强制收敛」的确定性——这对打分可复现的意义,比任何 prompt 工程都大。
图 2|driver 架构
agent(MCP)→ daemon → 平台后端 → 输入注入 + 感知;background_input 是每次背景变更的强制决策点。
3. 感知与验证:get_window_state 与 verify_state
驱动解决了「动」,这一节解决「看」与「确认动了」。
感知双通道:AX 元素树 + 截图
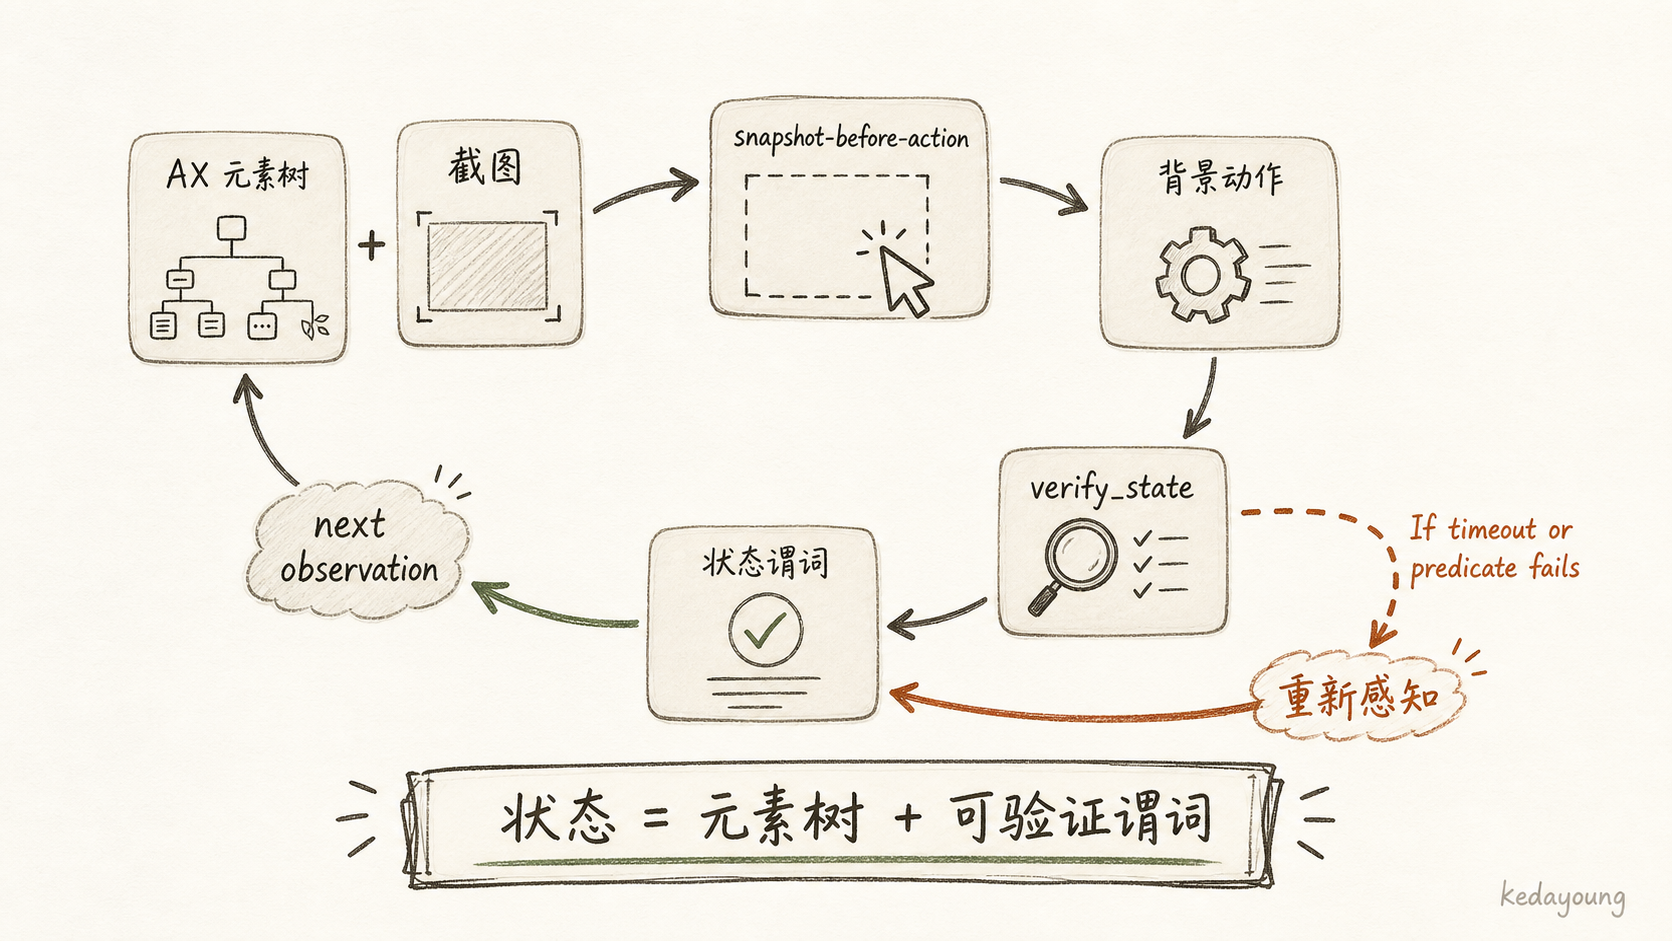
agent 怎么「看见」屏幕?cua 的答案不是截图,而是双通道。tools/get_window_state.rs:39-47 描述了 get_window_state 工具:它同时返回目标窗口的 AX 元素树与截图;include_screenshot 是显式开关(get_window_state.rs:212-213),截图由 capture::screenshot_window_bytes 生成(:325)。独立的 screenshot 工具已被并入它——tools/mod.rs:893-900 的注释明确记载 standalone screenshot tool 被移除,改由 get_window_state 统一提供。这是一个有意的设计取舍:树给语义,图给上下文,agent 可以在树失效(如 canvas 应用)时退到像素,而不是让两种感知各说各话。
浏览器是 GUI 的另一个主战场,且有独立的感知通道:CDP 驱动的 DOM 语义快照(browser/engine.rs:14-24,支持 Shadow DOM 与 OOPIF 穿透),共 9 个浏览器工具注册在 browser/tools.rs:32-41。相比截图像素,DOM 快照天然携带可查询的语义结构。
为什么树和截图缺一不可?AX 树给的是「是什么」:一个按钮、它的可访问性标签、它的 enabled 状态;截图给的是「长什么样」:布局、颜色、以及树覆盖不到的自绘内容。两个通道在评测里各司其职——agent 决策主要靠树(低成本、可精确引用元素),场景级的人工核对靠截图。双通道还能互相校验(作者理解):树说按钮存在,截图却显示它被别的窗口遮挡——这类「存在但不可交互」的状态,只靠任一个通道都发现不了。
验证:操作后必须验证,不是「点完就完」
看得到还不够——agent 需要知道「操作生效了」。cua 把这一步做成一等公民:verify_state,cua-driver-core/src/expectation.rs:4-8 自述为「deterministic, bounded state verification」——在轮询窗口内等待谓词收敛,超时上限为 MAX_TIMEOUT_MS = 10_000(expectation.rs:25),注册于 tools/mod.rs:836-843。
与一次性工具不同,verify_state 是「轮询 + 谓词 + 超时」的复合语义:状态没到位就继续等,到位返回成功,超时返回失败。这让「操作 → 确认」成为驱动协议的一部分,而不是 agent 的自觉。
轮询而不是一次性检查,是因为 GUI 状态变化几乎总是异步的:点击按钮后,前端要发请求、改 DOM、重绘,元素状态才从旧值变成新值。10 秒的等待窗口(expectation.rs:25)正是为覆盖这类异步窗口设计的;超时则明确返回失败。对评测而言,这个设计把「慢」和「错」区分开了:状态最终到达谓词是成功(只是慢),始终未到达才是失败。一个没有轮询与超时语义的验证工具,会把这两者混成同一种「没生效」。
使用不变式:snapshot-before-action 与路由阶梯
cua 把「怎么用驱动」沉淀成了写给 agent 的协议,而不是留给 agent 临场发挥。rust/Skills/cua-driver/SKILL.md:34-37 把 snapshot-before-action 称为 not optional 的不变式:动作前必须取窗口状态快照,跳过它会静默破坏后续一切验证。SKILL.md:68-95 进一步给出六级路由阶梯(编号 0–5):API/CLI → 类型化 Cua 操作 → 后台无障碍 → 后台像素 → 前台 → 桌面回退。逐级下探的规则是「优先不打扰用户」:能 API 调用就不点鼠标,能后台无障碍就不碰像素,能后台就不抢焦点。
这套阶梯的正确性依赖第 2 节的背景输入能力:为什么前台操作可以留到最后?因为前面的每一级(API/CLI、后台无障碍、后台像素)都要求「不抢焦点」,而 (pid, CGWindowID) 契约恰好保证了这一点。反过来,没有背景输入,阶梯的前四级全部不可用,agent 就只剩「前台抢焦点硬点」一条路——这也是背景输入安全被放在驱动架构核心位置的原因。对评测还有一个副产品(作者理解):同一个任务可以在不同「干扰等级」下运行,从而评估 agent 在受限环境下的鲁棒性。
设计含义:状态 = 元素树 + 可验证谓词
把感知与验证合起来看,cua 对「GUI 状态」的定义是:不是截图像素,而是元素树 + 可验证谓词。这为第 4 节的确定性打分埋下了伏笔——如果状态只能靠像素比对,评测就退化成「看图猜分」;有了元素树与谓词,任务完成度才能被程序化地判定。
图 3|感知/验证闭环
树+截图 → 决策 → 背景动作 → 验证 → 下一轮;超时失败时 agent 可重新感知再决策。
4. cua-bench:Gym 式评测环境
driver 解决了「单个 agent 如何操作电脑」,cua-bench 回答「任意 agent 如何被一步步驱动并最终打分」。它的设计是让评测环境长得像强化学习里成熟的环境接口——任何 agent(无论内部实现)只要按这个接口行动,就能被测。
环境四件套:reset / step / solve / evaluate
cua_bench/environment.py:44-49 的 Environment 类把评测循环拆成四个方法,每个方法委托给一个由装饰器注册的 provider 函数(tasks_config_fn / setup_task_fn / solve_task_fn / evaluate_task_fn,签名见 __init__ :67-83)——框架提供循环,任务提供语义。四个方法构成完整生命周期:
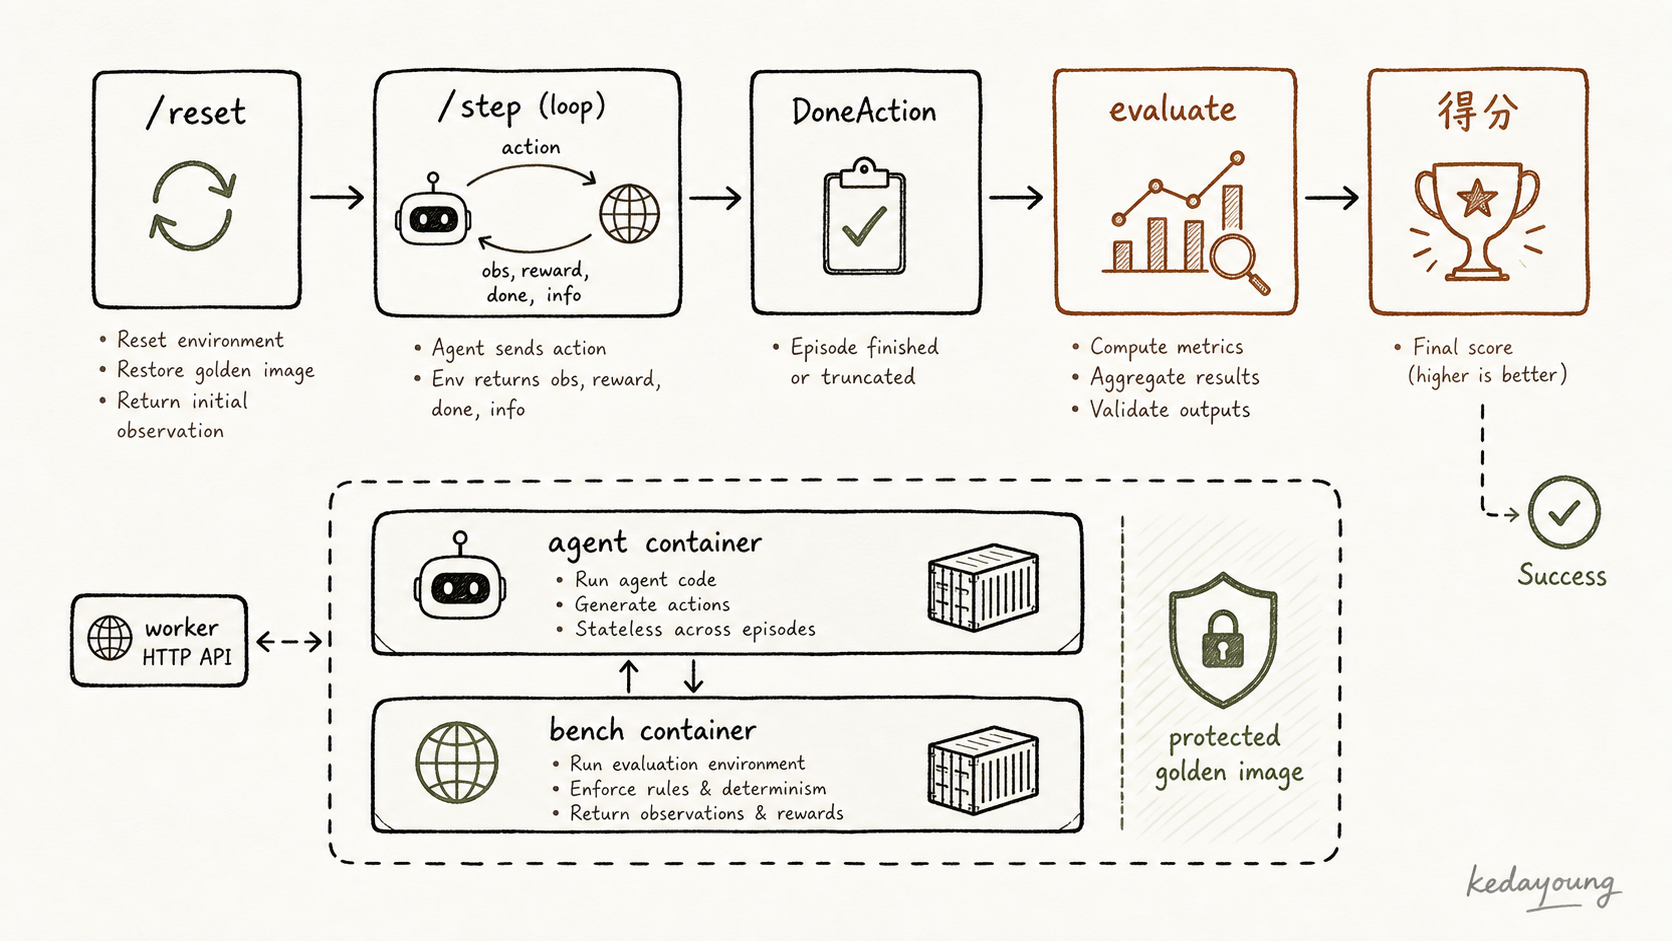
reset(environment.py:156-248):按 split 挑任务、构建环境、返回初始截图与 instruction——这是 agent 每一轮「开局」看到的全部信息;step(:250-327):执行一个 action,返回截图 + reward + done;solve(:329-366):agent 循环调用 step 直到完成任务或耗尽预算;evaluate(:368-418):终局打分,success 判定规则在:398-416——支持数值阈值(result >= 0.5)、布尔、或dict["success"]。
这是标准 Gym 风格接口,于是接入成本被压到最低:外部 agent 不必懂 cua 的任务声明格式,只需要「看截图 → 出动作 → 收 reward」。
四件套的分工正好对应一次评测的三个阶段:reset 是「出题」——选定任务变体并把环境恢复到该任务的初始状态;step/solve 是「作答」——agent 与环境逐轮交互;evaluate 是「判卷」——由环境(而非评测者肉眼看截图)给出确定性得分。注意 solve 与 evaluate 的分离:solve 是 agent 自己驱动的循环,evaluate 是环境专属的终局判定。二者解耦意味着「怎么解题」与「怎么判分」可以独立演进——换判分逻辑不需要动 agent,换 agent 不需要动判分。
任务声明:装饰器即 DSL
任务怎么声明?答案是四个装饰器:@cb.tasks_config、@cb.setup_task、@cb.solve_task、@cb.evaluate_task(cua_bench/decorators.py:22-187),加载入口是 core.py:20-46 的 make(env_name, split)。一个任务 = 一个 Python 模块里的几段函数,框架零侵入。
以最简单的示例任务看全貌:datasets/cua-bench-basic/click-button/main.py:7-29 的 tasks_config 用参数组合生成 7 个按钮变体(1 种 OS × 7 种按钮文字);而 main.py:56-64 的 evaluate 用 session.execute_javascript(cua-bench 的 DesktopSession 提供的能力)读页面里的 window.__submitted,返回 [1.0] 或 [0.0]——判定不是看截图,而是读页面真实状态。这正是第 3 节埋的伏笔:evaluate 消费的是「可验证谓词」,不是像素。该数据集共 13 类任务(datasets/cua-bench-basic/README.md:7-34),从点按钮到表单填写,覆盖 GUI 操作的基础面。
把 click-button 的任务流串起来看:agent 从 reset 拿到截图与 instruction(点击指定文字的按钮),经由 driver 感知按钮位置、背景点击、verify_state 确认,最后发 DoneAction;evaluate 用 execute_javascript 读 window.__submitted(main.py:56-64),这个变量由页面脚本在按钮被真实处理时置位。注意判分既不比对截图,也不看点击坐标是否命中,而是读页面自身的状态机——按钮没被真正点击,页面状态就不会变,得分就是 0。这就是「环境状态谓词」判定的最小可运行示例。
隔离运行:双容器与 golden image 保护
评测必须可重复,隔离因此是硬要求。runner/task_runner.py:1-4 的模块注释自述为 2-container architecture:每个任务跑在一对容器里——agent 容器(运行 solver)与 env 容器(运行被测环境),二者通过独立的 Docker 网络通信(task_runner.py:79-90、:85-86),任务之间不共享端口与服务;env 容器的磁盘面由 QCOW2 overlay 保护(task_runner.py:116-135 的 _create_task_overlay)——任务内的任何写操作(装软件、改配置)都被重定向到 overlay,底层 golden image 永不污染。两层隔离合起来,评测才能回答「重复运行同一任务,结果差异只来自 agent,而非环境残留」——对 RL 训练这尤其重要:rollouts 会大量重复执行,任何环境漂移都会被模型当作噪声学进去。run_task(task_runner.py:147-387,含 finally 清理块)编排整个生命周期。
评测协议:worker HTTP API
环境对外暴露为 worker HTTP 服务(workers/worker_server.py:306-430):
POST /reset:返回截图 + instruction;POST /step:执行 action,返回截图 + reward + done;GET /screenshot:随时取当前屏幕。
关键在 worker_server.py:379-394:当 agent 发出 DoneAction 时,worker 触发 env.evaluate()——终局打分由环境自己决定,不由 agent 自报。外部 driver、训练器都可以按 Gym 风格调用这套 API,这正是第 5 节 RL 闭环的接口前提。
难度校准:OpenAI computer-use 在这里是被评测基线
任务难度不是拍脑袋定的:scripts/calibrate_tasks.py:29-57 用 Claude 与 OpenAI computer-use-preview 两个模型跑全部任务,按通过情况划分难度 tier。注意这里 OpenAI computer-use 的角色——它是被评测的基线模型之一(calibrate_tasks.py:29-32),不是被对比宣传的产品。这条校准流程的意义在于:难度标注是数据,可随模型进步重新校准。
图 4|cua-bench 评测循环
/reset → agent 循环 /step → DoneAction → evaluate → 得分。
5. 评测即训练:轨迹录制 → RL(GRPO)
前四节回答「如何可靠地驱动与打分」,这一节回答「评测的轨迹为什么能直接当训练数据」。这是 cua 路线区别于其它评测工具的核心:评测投入产生复利。
录制:driver 侧与 bench 侧各记一笔
轨迹在两侧同时录制。driver 侧:每个非只读、非录制工具调用都会写一个 turn-NNNNN/action.json 文件(cua-driver-core/src/recording.rs:1-10)——动作细节(坐标、目标、工具参数)在源头被完整保留。
bench 侧:cua_bench/tracing.py:17-22 是 HF Datasets 的封装,tracing.py:46-71 的 record(event_name, data_json, data_images) 把事件落成数据集条目;事件由 environment.py 在各阶段调用点传入——reset(environment.py:238-246)、step 前后(:264-322)、evaluate(:391-395)。两侧一合,一条轨迹 = 动作序列 + 环境反馈 + 终局结果。
导出:命令行即训练接口
cli/commands/trace.py:119-145 提供 cb trace view / cb trace traj 查看与导出轨迹;README.md:118 明示「Evaluate computer-use agents on OSWorld, ScreenSpot, Windows Arena, and custom tasks. Export trajectories for training.」(仓库声明)。导出不是副产品,而是产品面的一部分。
RL 消费:off-policy GRPO
轨迹进了 RL 循环。cua_bench/trainer/off_policy/tinker/rl_loop.py:70-248 实现 off-policy GRPO:rollouts 可以在线收集——cb run 直接驱动环境采样(:159-169)——也可以离线复用已有 run IDs(:171-181),这正是录制数据的主消费路径。
为什么必须是 off-policy?因为被测 agent 与正在训练的模型往往不是同一个——评测时跑的是 Claude 或 OpenAI 基线,训练时消费的是这些轨迹。off-policy 设定(rl_loop.py:70-248)让「任意来源的评测轨迹」都能进入训练,这也解释了(作者理解)第 4 节 worker HTTP API 保持 Gym 风格的原因:无论轨迹来自 cua 自带 agent、外部 agent 还是人工录制,只要格式统一就能训练。评测对 agent 的实现一无所知,RL 对轨迹的来源一无所知,中间只隔着一个统一的轨迹格式。
GRPO 的轨迹级 advantage 计算在 cua_bench/trainer/off_policy/tinker/grpo.py:48-54:terminal_reward − 组均值(同任务组内相减)。注意这里被比较的单元是整条轨迹而非单步——因为 GUI 任务的奖励天然稀疏,只有终局 evaluate 才产生明确的 reward。轨迹还原逻辑在 cua_bench/trainer/off_policy/tinker/traces.py:83-155:从录制数据重建 episode,其中 evaluate 事件作为终局奖励(traces.py:98-106 从 evaluate 事件取 result 作为 terminal_reward)。
为什么用组均值做基准,而不是直接拿绝对 reward 当优势?因为 GUI 任务的终局 reward 稀疏,且绝对值在不同任务间不可比(满分口径不同),但「同一任务内谁比平均好」是可比的。组在这里按任务聚合多个 episode,模型学到的梯度信号是「在同任务上做得比平均更好」,天然避开了跨任务 reward 标定问题——这正是 GRPO 用组内相对值而不用绝对值的原因。
设计含义:评测与训练共用同一套环境与轨迹格式
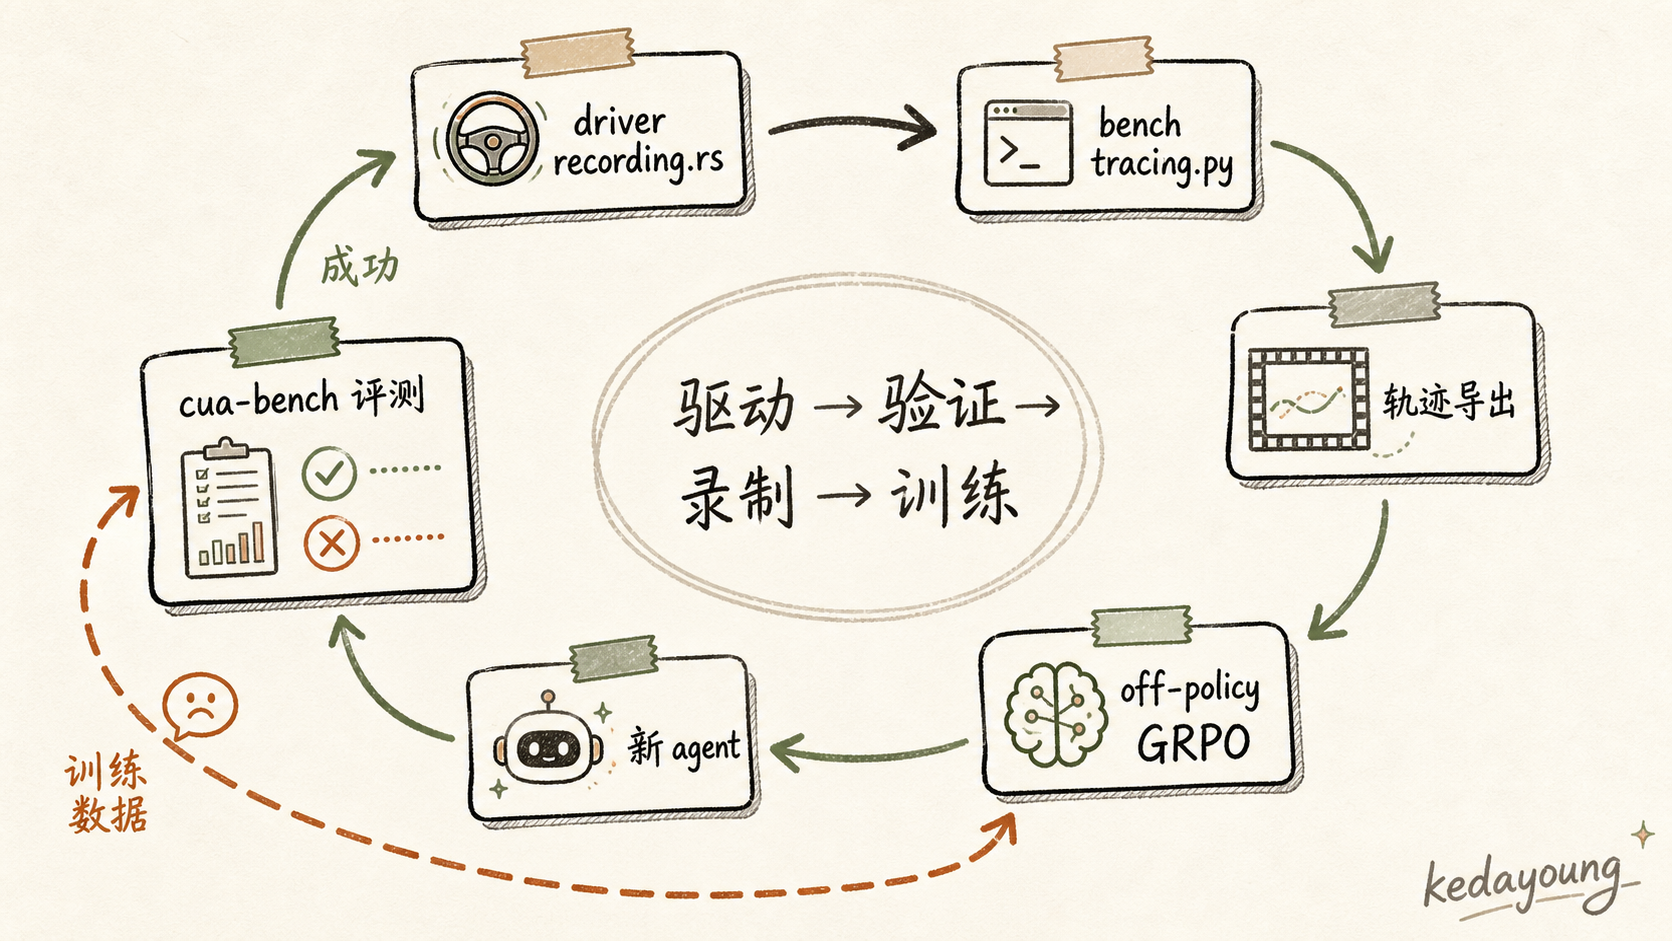
把第 4、5 节并起来看:cua-bench 的评测环境(reset/step/evaluate)、worker 的 HTTP 协议、轨迹的 HF Datasets 格式,评测与训练完全复用。于是出现一个自然循环:评测失败的样本直接变成训练数据 → 训练出的新模型再进同一套环境评测 → 更强的模型暴露更难的失败样本。对 computer-use 这种「真实交互数据稀缺」的领域,这是把评测基础设施直接转化为数据产线的工程答案。
图 5|驱动 → 验证 → 录制 → 训练闭环
评测失败样本回流为训练数据,训练结果再进评测。
6. 与其它路线的对照与可迁移经验
五条路线定位
回到本系列评测主题的坐标系。下表把 cua 与本系列其它路线(以及常见评测工具)放在同一张表里对照:
| 维度 | bfcl-gaia / agentbench | promptfoo / skillsbench | cua |
|---|---|---|---|
| 评测对象 | 文本/工具调用/多环境 agent | prompt/agent/skill 使用 | 像素级 GUI 操作 |
| 环境 | 模拟环境/容器 | 容器/CLI harness | 真实 OS/浏览器 + 沙箱 |
| 判定 | 匹配/脚本/产物 | 断言/产物 | 环境状态谓词(evaluate_task_fn) |
| 数据 | 无轨迹复用 | 部分录制 | 轨迹即训练数据(GRPO) |
| 工程重点 | 判定确定性/回归 | 对照实验/digest | 驱动安全 + 评测训练闭环 |
这张表的读法不是「谁更好」,而是「各自把工程资源花在了哪里」:bfcl-gaia / agentbench 面对的输出可精确匹配,工程重点自然落在判定确定性与回归;promptfoo / skillsbench 把成本花在对照实验的严谨性上;cua 面对的环境(真实 OS)是最不受控的,不得不把「控制」本身做成产品,再顺手让评测结果回流训练。横轴看,评测对象从「文本」延伸到「GUI」;纵轴看,cua 是唯一把评测结果闭环回训练的路线。路线选择取决于评测对象是「会说话的 agent」还是「会动手的 agent」。
可迁移模式(作者判断)
以下四点是从 cua 里提炼、且不依赖其具体实现的模式:
- 驱动层与评测层分离(driver / bench 分属两个语言、两套 API)。环境能力可复用,评测可插拔——换评测任务不需要动驱动,换驱动不需要改任务声明。
- 「操作后必须验证」进环境接口。把 verify_state 做成环境协议的一部分,而不是事后抽查——评测的确定性来自「动作 → 断言」的强制配对,而非 agent 的自觉。
- Gym 式环境 + 装饰器声明任务。reset/step/evaluate 四件套让任意 agent 可接入;装饰器让「新任务 = 新函数」,不碰框架代码。这是把任务编写成本压到最低的关键。
- 评测轨迹直接导出为训练数据。轨迹录制不是「为了复现」的审计功能,而是数据产线的输入端——评测与训练共用格式,失败样本自动变成训练信号。
这四点的落地顺序也值得注意:前两点是「让评测可信」的底线,后两点是「让评测增值」的上限。若环境还做不到「动作与断言强制配对」,不应急于上 RL——用不可信的轨迹训练,只是把噪声放大。
最后说边界(作者判断):这条路线不是免费的。它要求评测方具备沙箱/虚拟化基础设施(Docker、macOS 虚拟化)、跨平台驱动的长期维护成本,以及足够多的评测任务来支撑 RL 训练;若只做 prompt 级对照实验,这套基础设施是过剩的。它的适用前提是:评测对象确定为 GUI 操作、且评测结果要被训练消费——这时「评测即训练」才成立为闭环。
系列内定位与收束
在 0-agent-evaluation 系列里,cua 代表「GUI 专项 + 评测训练闭环」路线,是本系列评测主题里唯一与 RL 训练直接衔接的候选——它与另外几篇共同覆盖「文本 / 工具 / 技能 / GUI」四类评测对象。
回到开头那个「标已读」的任务。现在可以完整回答它为什么难:它要求环境可控(driver 能注入输入且不抢焦点)、状态可判(get_window_state + verify_state 让完成度成为可验证谓词)、数据可得(轨迹两侧录制、直接进 GRPO)。cua 用 driver 解决「可控」、用 cua-bench 解决「可判」、用轨迹录制解决「可得」,再用 RL 闭环让三者互相喂给——这既是对 GUI 评测难点的分解,也是「评测让 agent 持续变强」这一目标的工程实现。
附录 A:证据清单(写作时逐条核对)
所有路径相对本地克隆
0-agent-evaluation/20260810-cua/repo/(commit41e47b5,2026-08-11 main 快照)。
| 断言 | 证据位置 |
|---|---|
| 仓库定位为 Drivers / sandbox / Cua-Bench / Lume 四块 | README.md:23-58、:159-169 |
| MCP 工具入口与协议 | libs/cua-driver/rust/crates/cua-driver-core/src/lib.rs:1-11、protocol.rs:10-331、server.rs:850-860 |
| daemon 架构(socket 传输、stdio 代理) | daemon.rs:1-9、:155-158、:207;libs/cua-driver/rust/cua-driver/src/main.rs:5-6 |
| 背景输入安全契约(pid + CGWindowID) | background_input.rs:1-13、:3-4、:104-113、:170-182、:183 |
| window-local 坐标点击(不移动真实光标) | platform-macos/src/input/mouse.rs:22-33、:105-117、:384-389 |
| 感知双通道(AX 树 + 截图) | tools/get_window_state.rs:39-47、:212-213、:325;tools/mod.rs:893-900 |
| 浏览器 DOM 语义快照与 9 个工具 | browser/engine.rs:14-24、browser/tools.rs:32-41 |
| verify_state(轮询 + 谓词 + 10s 超时) | cua-driver-core/src/expectation.rs:4-8、:25;tools/mod.rs:836-843 |
| snapshot-before-action 不变式与六级路由阶梯 | rust/Skills/cua-driver/SKILL.md:34-37、:68-95 |
| Environment 四方法(reset/step/solve/evaluate) | cua_bench/environment.py:44-49、:156-248、:250-327、:329-366、:368-418 |
| 装饰器 DSL 与加载入口 | cua_bench/decorators.py:22-187、core.py:20-46 |
| 判定读页面真实状态(execute_javascript) | datasets/cua-bench-basic/click-button/main.py:7-29、:56-64 |
| 双容器隔离与 QCOW2 overlay | runner/task_runner.py:1-4、:79-90、:116-135、:147-387 |
| worker HTTP API 与终局 evaluate | workers/worker_server.py:306-430、:379-394 |
| 难度校准(Claude / OpenAI computer-use 为基线) | scripts/calibrate_tasks.py:29-57、:29-32 |
| 轨迹录制(driver 侧 / bench 侧) | cua-driver-core/src/recording.rs:1-10;cua_bench/tracing.py:17-22、:46-71;environment.py:238-246、:264-322、:391-395 |
| 轨迹导出 CLI | cli/commands/trace.py:119-145;README.md:118(仓库声明) |
| off-policy GRPO 与轨迹级 advantage | cua_bench/trainer/off_policy/tinker/rl_loop.py:70-248、grpo.py:48-54、traces.py:83-155、:98-106 |
附录 B:素材缺口与待办
- [x] 概念口径统一:第 1 节已说明「四块定位 vs 三件套」的关系(sandbox/lume 为支撑件,三件套按「驱动、评测、训练」组织)。
- [ ] 未实际运行评测(需 macOS + Docker 沙箱/虚拟化与真实 GUI 环境);机制描述以源码为准。
- [ ] 标注「作者理解」处的因果推断(daemon 的状态复用与汇流、背景输入的范围约束收益、双通道互验等)未逐一做实验验证,如需引用建议复核。
- [ ] Windows / Linux 驱动后端仅提及存在性与差异(
platform-windows/platform-linux),未通读实现。