代码基线:本地克隆
graphiti_corev0.29.3(pyproject.toml:4,commit401c59a),文中所有file:line均以该版本源码为准。
引言
给 LLM 配记忆,最朴素的做法是「聊天记录全部塞进向量库,检索时拼进上下文」。这条路有两个问题:事实一变(用户搬了城市、换了工作),新旧版本以相似向量的形式共存,模型分不清"现在是哪一年";改用知识图谱 RAG(GraphRAG 一类批处理管线)能回答结构化问题,但图谱建好就凝固——新信息进来要么全量重建,要么靠 LLM 在摘要里"和稀泥"。
graphiti(Zep 开源的时序记忆框架)把记忆建模成带时间戳的事实流:每条事实(EntityEdge)绑定有效性窗口(valid_at / invalid_at / expired_at),每段原始数据(EpisodicNode)作为可溯源证据;事实被推翻时不删除,而是打时间戳失效、留在图里;写入走增量管线(只处理新 episode,不重算全图),检索走语义 + 关键词 + 图遍历多路召回融合,并支持"任意时刻的图状态"查询。本文按 v0.29.3 源码拆这条链路:数据模型如何表达"事实何时为真"(§2)→ 增量写入与实体消歧(§3)→ 混合检索与时间过滤(§4)→ 后端抽象与可迁移经验(§5)。§2 到 §4 用同一例贯穿:Alice 一月"住在北京"、三月"搬到上海",看这条事实在代码里如何建立、失效、并按时间查回。
1. 为什么记忆需要「时序上下文图」
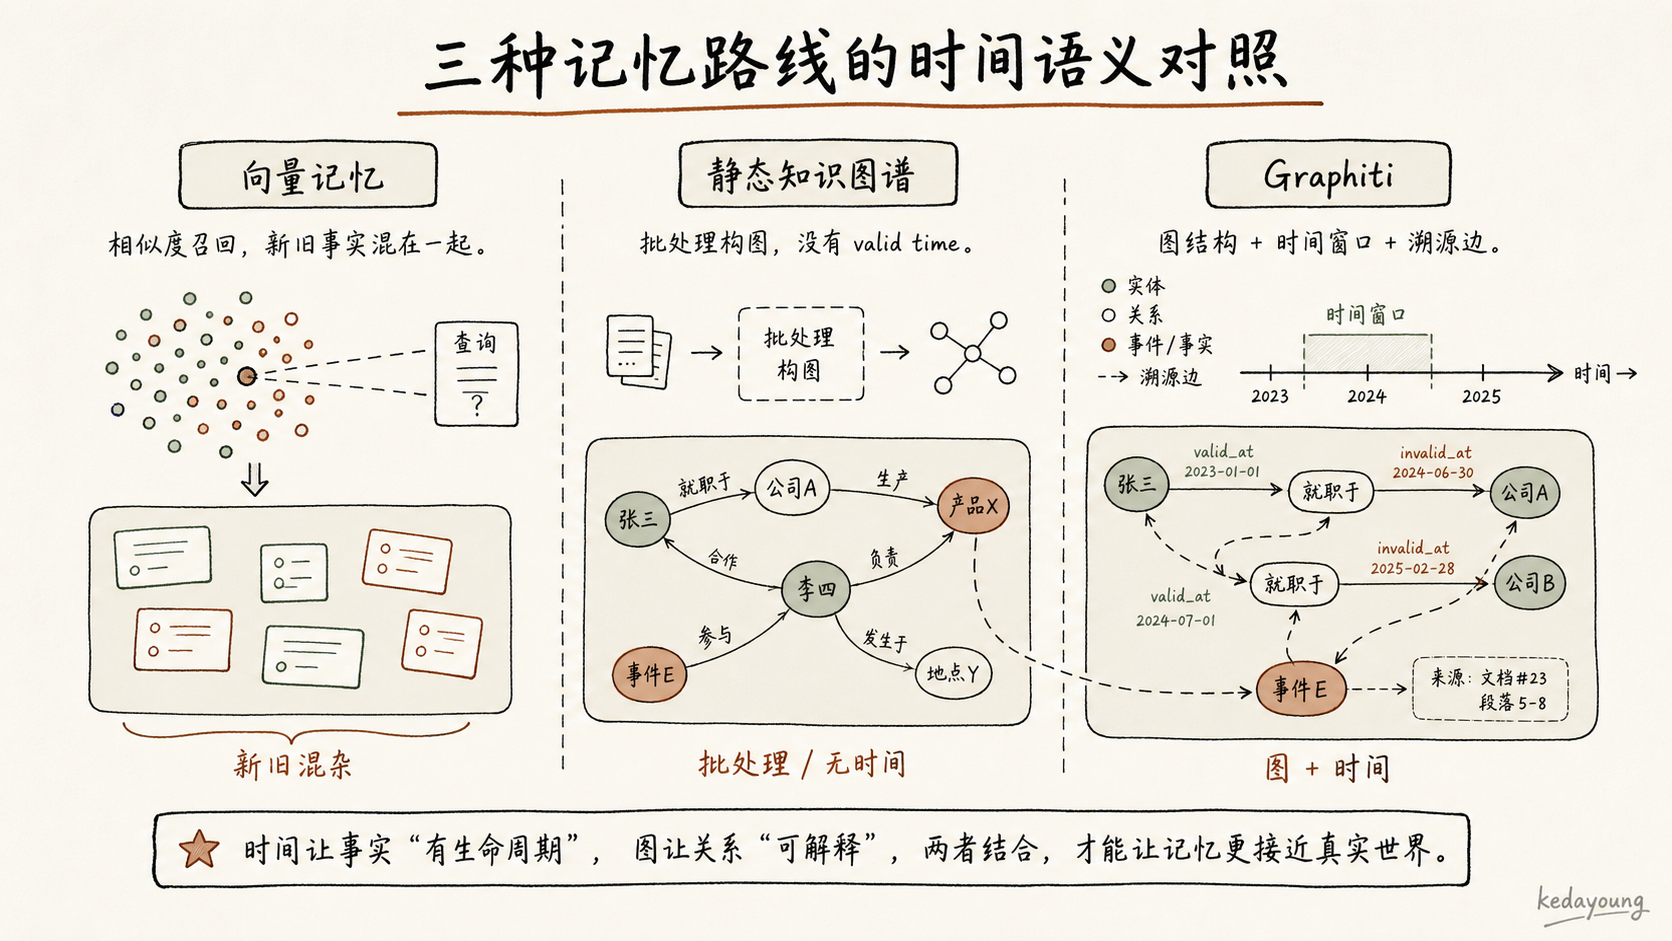
1.1 向量记忆的失效:新旧混杂
先看一个贯穿全文的例子。你在给客服助手配记忆:用户 Alice 一月份说"我住在北京,在字节上班",三月份说"我搬到上海了,入职了美团"。助手需要能回答两个问题:Alice 现在住哪?她换工作的经历是怎样的?
向量记忆的问题不在于"记不住",而在于"分不清现在"。
把每条消息 embed 成向量存进向量库,检索时按相似度取回 Top-K。事实一旦发生变化,旧版本不会消失,新版本也不会标记"我更新了旧的那条"——它们只是作为两个相似的向量共存于库里。当你问"用户现在住哪",取回的结果可能同时包含"住在北京"和"搬到上海"两条,谁先谁后、谁还成立,向量相似度回答不了。
更隐蔽的问题是引用缺失:返回的片段来自哪段原始对话?为什么这条后来不成立了?纯向量库只保存了语义快照,没有证据链,也就无法做"失效"这种操作——你甚至不知道该失效谁。
1.2 静态知识图谱的失效:批处理与无时间
知识图谱 RAG 比向量记忆前进了一步:事实从非结构化文本中被提取为结构化的三元组,检索可以沿着实体跳转。但 graphiti 官方 README 的 "Graphiti vs. GraphRAG" 对照表(官方自述,非独立评测)明确指出,典型 GraphRAG 管线的局限是:批处理(定时全量构建,新数据要等下一轮)、无时间处理(图谱里没有"这条事实何时为真"的概念)、矛盾靠 LLM 摘要兜底(图谱里同时存在"住在北京"和"住在上海"时,只能靠摘要层用自然语言含糊过去)。
批处理带来另一个连带问题:构建成本。全图重新提取、重新 embedding、重新消歧,数据量大时昂贵且延迟高,无法支撑"每来一条消息就更新"的交互式记忆场景。更糟的是,批处理天然是"晚一拍"的——图谱反映的是上一次构建时的世界,而对话记忆恰恰要求"这一秒说的事,下一秒就能被问到"。
1.3 graphiti 的回答:图 + 时间
graphiti 的思路是把"图"和"时间"叠在一起,让每一条事实自带生命周期:
- 事实是带有效期的:
EntityEdge上挂着valid_at(开始为真)、invalid_at(停止为真)、expired_at(被撤销的墙钟时间)三个时间戳(graphiti_core/edges.py:271-282); - 失效不是删除:新信息推翻旧事实时,旧事实被标记失效但保留在图里,历史完整可查;
- 写入是增量的:新 episode 进来只提取增量、消歧、挂边,不重算全图;
- 检索是带时间轴的:查询可以附加日期过滤,等价于"把图倒回到某一天看"。
1.4 双层时序模型一句话
整个模型可以压缩成一句:Episode 是原始数据(EpisodicNode,以 valid_at 为时序锚点,nodes.py:322-324),EntityEdge 是派生的结构化事实(带有效期 + episodes 溯源),实体 EntityNode 是事实两端的锚点。原始层负责"证据是什么",派生层负责"结论是什么、何时成立",两层之间用 episodes 引用串成证据链。这就是后两节要展开的骨架。
2. 数据模型:EntityEdge / EntityNode / EpisodicNode 与其它图结构
这一节回答一个问题:一张时序图里到底存什么?每条事实凭什么成立、何时失效?
2.1 事实 = EntityEdge:有效性窗口与溯源
在 v0.29.3 里没有独立的 Fact 类——事实就是边 EntityEdge(graphiti_core/edges.py:263-285)。注意这个术语映射:早期文档里叫 Fact 的东西,在这个版本里已经统一成 EntityEdge,读旧文档时要留意。
它的核心字段分三组(代码块注释里的 # :NNN 为该字段在 edges.py 中的源码行号):
内容与关系:
class EntityEdge(Edge):
    name: str = Field(description='name of the edge, relation name')          # :264
    fact: str = Field(description='fact representing the edge and nodes...')  # :265
    fact_embedding: list[float] | None = ...                                  # :266
name 是关系名(如 lives_in),fact 是自然语言事实文本(如 "Alice lives in Beijing"),fact_embedding 是这条事实的向量,供语义检索用。检索的粒度是"边"而不是"节点"——这是 graphiti 和很多图谱 RAG 的差异:召回单位是一条完整事实。
溯源:
    episodes: list[str] = Field(                                        # :267-270
        default=[],
        description='list of episode ids that reference these entity edges',
    )
episodes 存的是产生这条事实的 EpisodicNode 的 uuid 列表。这构成了证据链:任何一条事实都能从图里反查"它是在哪段原始消息里被提取出来的"。溯源是"失效"操作能成立的前提——当新 episode 说"Alice 搬到上海",系统需要知道旧事实来自哪里、要不要覆盖。
有效性窗口——整张图的"时间心脏":
    expired_at: datetime | None = ...   # :271-273 节点被撤销(invalidated)的墙钟时间
    valid_at: datetime | None = ...     # :274-276 这条事实开始为真的时间
    invalid_at: datetime | None = ...   # :277-279 这条事实停止为真的时间
    reference_time: datetime | None = ...  # :280-282 产生该边的 episode 的参考时间
三个时间戳各司其职:
valid_at与invalid_at描述事实世界内的真值区间:[valid_at, invalid_at)之间这条事实成立;expired_at描述系统操作层面:这条边是什么时候被判定失效并保留下来的——它是"失效而非删除"这一策略的物理落点;reference_time是产出这条边的 episode 的参考时间,用于把派生事实对齐回原始时间轴。
attributes(:283-285)是扩展位:按 name 不同可以挂自定义类型属性。比如一条 employment_at 边可以带 {position: "engineer"},一条 lives_in 边可以带 {city_code: "310000"}——这些结构化属性在检索时还能通过 property_filters 参与精确过滤(见 4.3 的 SearchFilters.property_filters),让"事实级"存储不止于自然语言。
2.2 实体 = EntityNode:锚点与区域摘要
边的两端是实体节点 EntityNode(graphiti_core/nodes.py:499-504),继承自 Node 基类(:93-98,字段为 uuid / name / group_id / labels / created_at,group_id 用于图分区)。group_id 是值得留意的一个设计:它允许把一张大图切成互不干扰的分区——比如不同租户、不同用户、不同项目各占一个 group_id,检索与增量更新都按分区隔离,避免多租户数据互相污染,也让"取最近上下文"的候选集天然受限。EntityNode 额外有两个关键字段:
name_embedding:实体名的向量,用于实体消歧时的语义召回(第 3 节);summary:周边事实的区域摘要("regional summary of surrounding edges")。实体并不存储"它知道的所有事实",而是维护一个随时间滚动的摘要——当新事实到来,旧摘要与新事实会被 LLM 合并出新的摘要。这是图谱在节点层面"自更新"的机制,与边层面的失效机制互补:边管"单条事实的真值",摘要管"一个实体的知识画像"。attributes(:502-504):与边上的attributes对称的扩展位,按节点 label 挂自定义属性。注意这里有个设计对称性:节点和边两侧都留了属性位——节点属性描述"实体本身是什么"(如{type: "person"}),边属性描述"这段关系的特点"(如 2.1 的{city_code}),而属性过滤(4.3 的property_filters)对两者都生效。
2.3 Episode = EpisodicNode:时序锚点与证据
EpisodicNode(nodes.py:318-332)是原始数据的容器:
class EpisodicNode(Node):
    source: EpisodeType = Field(description='source type')          # :319
    source_description: str = ...                                   # :320
    content: str = Field(description='raw episode data')            # :321
    valid_at: datetime = Field(                                    # :322-324
        description='datetime of when the original document was created',
    )
    entity_edges: list[str] = ...                                   # :325-328
    episode_metadata: dict[str, Any] | None = ...                   # :329-332
source 是 EpisodeType 枚举(:54-77),取值 message / json / text / fact_triple——其中 message 的 content 按 "actor: content" 格式约定(如 "user: Hello")。区分类型不是为了花哨:结构化数据(json)与自由文本(text)在提取策略和 schema 上天然不同,枚举让后续管线能按类型分流。valid_at 是原始文档的创建时间,它充当整条链路的时序锚点:后续所有派生事实的 valid_at / reference_time 都从它推导。entity_edges 反指本 episode 产生的边。
图 1|时序数据模型
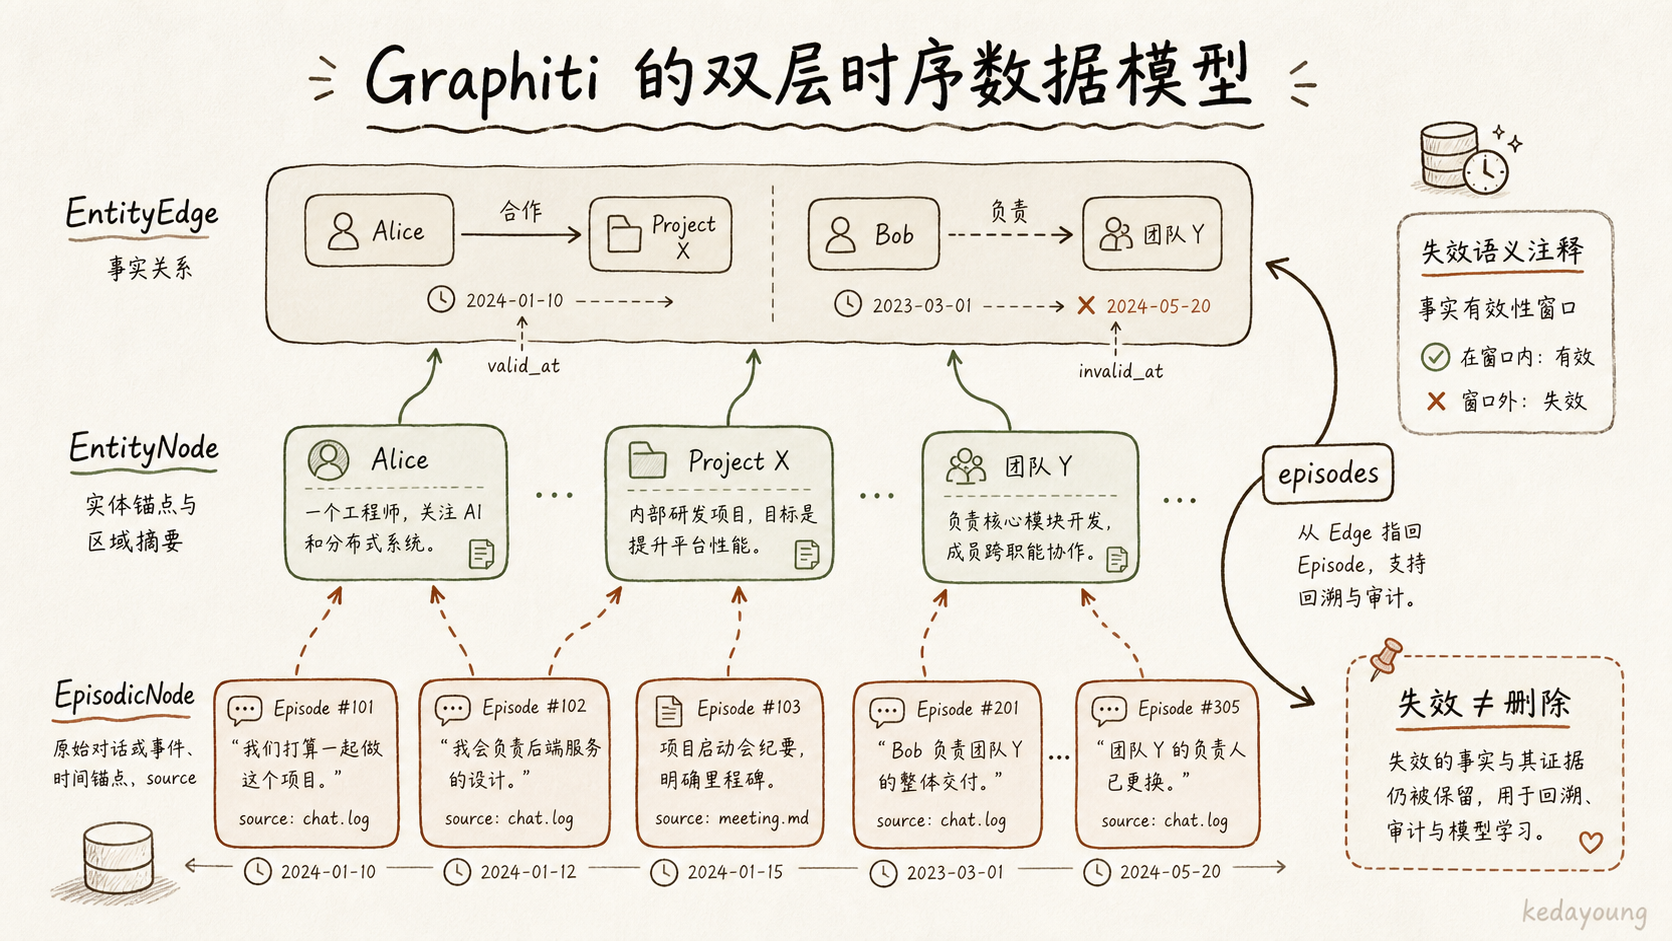
图注:原始层(Episode)与派生层(Edge)之间用
episodes溯源相连;边的失效 = 打时间戳保留,不是删除。
2.4 其它图结构:社区、Saga 与三种边
除三件套外,v0.29.3 还有几类结构值得知道(名字认识即可,细节后续章节展开):
EpisodicEdge(nodes.py:143):episode 之间的边,把同一组对话串成时间线;HasEpisodeEdge(:689):实体节点指向其所属 episode 的边,建立"实体 ↔ 证据"连接——从实体出发能一路走到原始消息;NextEpisodeEdge(:822):episode 之间指向前驱/后继的边,支撑"检索时沿时间线回溯上下文"。它对应add_episode里的previous_episode_uuids参数(graphiti.py:1029):调用方可以显式声明"这条消息紧跟哪些消息",图里便形成有序的时间线,而不是只靠时间戳猜测先后;CommunityNode(:687-689):社区摘要节点,存放一组相关实体的聚合摘要(第 4 节的社区检索路径);SagaNode(:867-876):故事线(saga)节点,含last_summarized_episode_valid_at这种时序水位线字段——记录该 saga 的摘要已经吸收到哪个时间点的 episode,是增量摘要不重复计算的标尺。
值得一提:SagaNode 的"水位线"和 EntityNode 的 summary 是同一思想的两种体现——凡是"聚合型"信息,都带一个时间戳表明自己新鲜到哪。这是时序图里处理派生数据的一致手法。
3. 增量构建:add_episode 与实体消歧
数据模型是静态的骨架,这一节看动态的血流:一条新消息进来,如何变成图里的节点、边、失效标记和摘要——全程不重算全图。
3.1 公开入口:Graphiti.add_episode
一切从 Graphiti.add_episode(graphiti_core/graphiti.py:980-1228)开始。签名(:981-998)的关键参数:name、episode_body(原始内容)、source_description、reference_time(调用方传入的参考时间)、source(默认 EpisodeType.message)、group_id(图分区)、update_communities(是否更新社区,默认 False)、saga(可选故事线归属)。
管线主体(:1086-1191)按顺序做六件事:
- 取上下文(:1087-1096):
retrieve_episodes按reference_time取最近 N 个 episode(last_n=RELEVANT_SCHEMA_LIMIT),作为本次提取与消歧的"近期记忆"。它的过滤逻辑在graph_data_operations.py:67-128:候选 episode 必须满足valid_at <= reference_time——只用"当时已经发生"的数据当上下文,防止未来信息倒灌污染提取。这一步的语义很微妙:它是给 LLM 的"工作记忆",决定提取器能看到哪些历史事实、从而判断"这条新消息是更新还是新增";取少了看不到被推翻的旧事实,取多了引入无关信息干扰 schema 输出。 - 创建/复用 EpisodicNode(:1099-1112):传了
uuid就复用已有节点,否则新建,valid_at=reference_time(:1110)——原始层的时间锚点在此落定。 - 提取实体(:1122-1129):
extract_nodes调 LLM,从 episode 内容中抽实体,返回(extracted_nodes, node_episode_index_map)。 - 消歧实体(:1131-1137):
resolve_extracted_nodes做三级消歧(下节详述),产出(nodes, uuid_map, _)——uuid_map把提取实体的临时 uuid 映射到图里最终实体,是"去重"的落点。 - 提取并消歧边(:1140-1154):
_extract_and_resolve_edges返回三组边:
                (
                    resolved_edges,    # 与已有边匹配上的事实
                    invalidated_edges, # 被新事实推翻的旧边
                    new_edges,         # 全新的事实
                ) = await self._extract_and_resolve_edges(...)   # :1140-1154
                entity_edges = resolved_edges + invalidated_edges   # :1156
invalidated_edges 就是"失效而非删除"的代码落点
新事实与旧事实冲突时,旧边不会从图里消失,而是被打上失效时间戳放进 invalidated_edges,和正常边一起返回、一起写库。观察位 edge.invalidated_count(:1204)可以直接从一次 add_episode 的 tracing span 里看到本次失效了多少条。
- 属性与摘要(:1160-1167):
extract_attributes_from_nodes只把new_edges传给摘要生成——注释写得很清楚,是为了 "avoid duplicating facts that already exist in the graph"。随后_process_episode_data(:1170-1179)建EpisodicEdge/HasEpisodeEdge等边、事务写入、关联 saga。saga参数(签名 :996)允许把分散在不同时刻的 episode 归入同一条故事线(SagaNode,见 2.4):比如一次跨越数月的用户访谈,各期记录是独立 episode,但共享一个 saga,摘要水位线就能跨 episode 维护。最后按需update_community(:1184-1191)。
整条管线自始至终只处理"这一个新 episode"及其直接影响的实体/边——没有全图重扫。
图 2|add_episode 增量管线
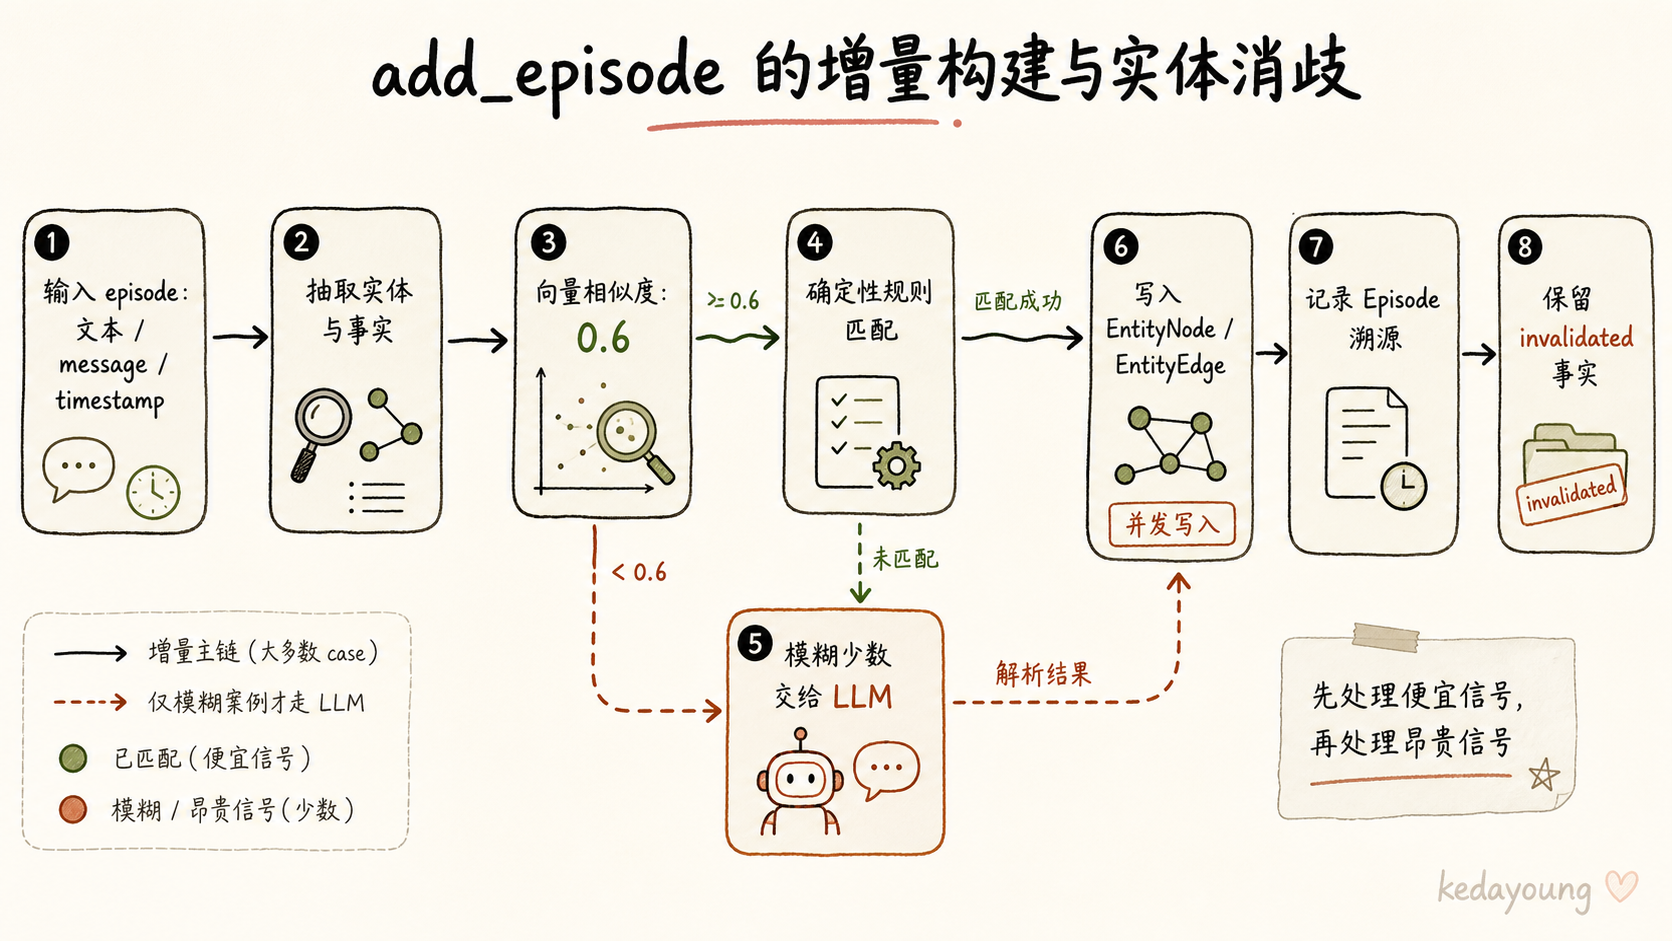
图注:标红分支证明"被推翻的事实进入 invalidated 而非被删除",全程不重算全图。
3.2 实体消歧三级
实体去重是知识图谱增量构建的经典难题:这次 LLM 提取出的 "Alice",和上周图里的 "Alicia Chen" 是不是同一个人?错了就产生重复节点。resolve_extracted_nodes(utils/maintenance/node_operations.py:627-708)用三级漏斗处理,docstring 自述:"Resolve nodes with semantic retrieval first, then deterministic and LLM dedup."
第一级:语义召回候选
_collect_candidate_nodes(:407)对每个提取实体调用 _semantic_candidate_search(:418):用实体的 name_embedding 在图里做向量相似度搜索,命中阈值以上的节点作为候选集。阈值是 NODE_DEDUP_COSINE_MIN_SCORE = 0.6(:65,在 :445 处生效)——相似度低于 0.6 的直接不参与消歧,算作新实体,省掉大量无效的 LLM 调用。
第二级:确定性相似度合并
对候选集,_resolve_with_similarity(调用点 :659,实现在 dedup_helpers.py:220)走确定性规则,docstring 说得很清楚(:225-229):先做精确名称匹配——所有名字都尝试,命中唯一候选即合并,命中多个则因歧义升入未决;再用熵门控保护模糊匹配路径——短名或低熵名不做模糊匹配,直接进未决;通过门控的名字才走 MinHash/LSH 模糊匹配。能确定就合并,不能确定就标记为"未决"(state.unresolved_indices,:670)。
第三级:LLM 裁决
所有未决实体收拢后交给 _resolve_with_llm(:467,:681 调用),用 prompts/dedupe 提示词让 LLM 结合 episode 上下文做最终判断。
注意顺序的工程意义:先免费(向量+规则),后付费(LLM)。绝大多数实体靠 0.6 阈值 + 确定性规则就能定案,LLM 只处理真正模糊的少数——这直接决定了增量写入的成本曲线。
图 3|三级实体消歧漏斗
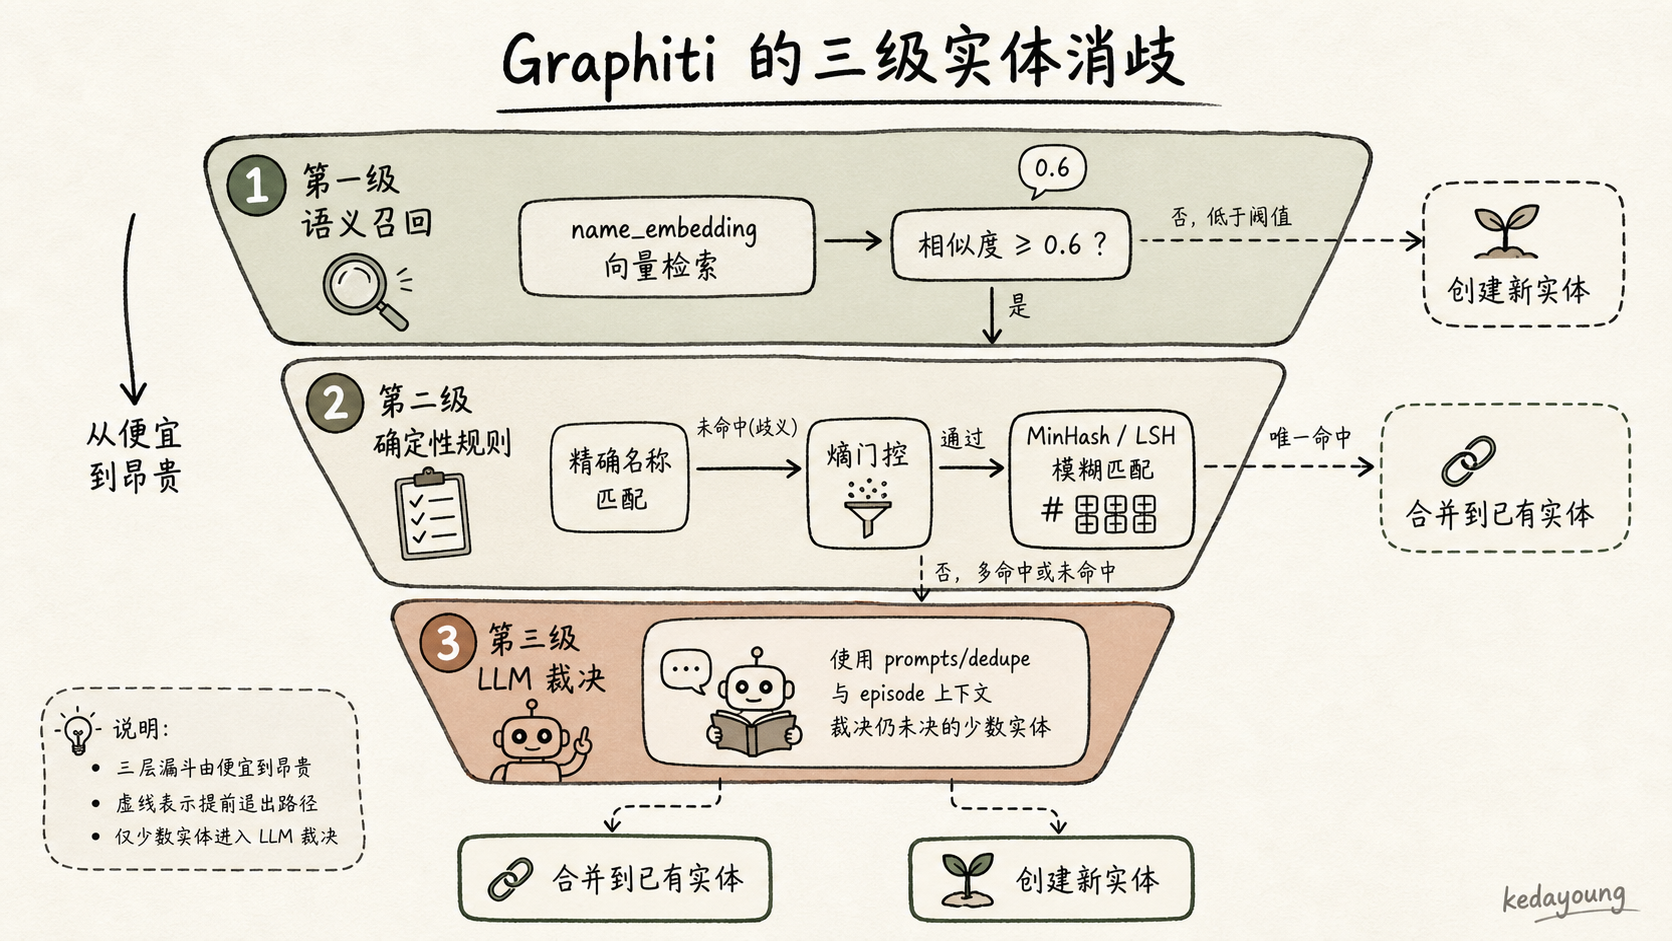
图注:成本从免费到付费逐级上升——向量(0.6 阈值)与确定性规则先消化绝大多数,LLM 只处理真正模糊的少数,这是增量写入成本曲线的关键。
顺带澄清一个容易混淆的点:边消歧和节点消歧不是同一套流程。节点有独立的三级消歧(resolve_extracted_nodes),而边的"消歧"发生在 _extract_and_resolve_edges 内部,它利用节点消歧产出的 uuid_map(graphiti.py:1131-1137)把提取边两端的临时实体映射到图里的真实实体——同一条事实连到同一个实体节点上,自然就"归并"了;边本身的冲突判定(新事实 vs 旧事实)则由有效性窗口语义完成。所以图里不会出现"两个节点各连一条说同样内容的边",因为节点层面已经去重。
3.3 失效语义再回看
把 3.1 和 3.2 连起来看,"事实被推翻"的完整链路是:新 episode 提取出新边 → 边消歧发现与旧边矛盾 → 旧边被打上 invalid_at / expired_at 进入 invalidated_edges → 与正常边一起写回图库。此后,旧边仍然存在、仍然可检索(第 4 节的时间过滤能把它捞出来),只是不再参与"当前时刻"的事实集合。回到引言里的 Alice:三月那条"搬到上海"的 episode 进来时,"住在北京"这条边走的就是这条链路——被打上 invalid_at 留在图里,而不是被抹掉。
3.4 工程约束:结构化输出与并发
增量管线的高效建立在强结构化输出之上:LLM 必须产出符合 JSON schema 的实体/边/属性结构,提取、消歧、摘要每一步都是。README 明确警告:小模型容易产生 schema 失效,导致管线不稳定——这是把它跑在小模型上的首要风险,不是精度问题,是"格式崩溃"问题。
并发侧,库用信号量限制并发(SEMAPHORE_LIMIT 之类的全局常量)主动压低 LLM 并发,防止触发 429 限流。也就是说,graphiti 把"慢一点但稳定"作为默认工程取向——记忆写入不是延迟敏感路径,宁可排队也不让一次 429 打断整条管线。
4. 检索:混合召回、融合重排与时间查询
写进去的结构化时序图,怎么查出来?graphiti 的回答是:多路召回 + 融合重排 + 时间过滤。
4.1 混合召回:语义 + 关键词 + 图遍历
一条查询同时走三条路:
- semantic:用查询向量对
fact_embedding(边)和name_embedding(节点)做向量检索,各后端实现位于driver/<provider>/operations/search_ops.py(如driver/neo4j/operations/search_ops.py); - BM25 全文本:对边的
fact文本做全文检索(各后端的fulltext.py,如driver/falkordb/fulltext.py),GraphDriver.fulltext_syntax(driver/driver.py:92)就是为不同库的全文语法差异预留的扩展点; - 图遍历 / BFS:从命中的实体节点出发沿边扩散(
driver/search_interface/search_interface.py:22),把"语义上沾边但文本上不沾边"的邻居事实也带回来。
召回单位依然是边——三条路最终都汇总成边(事实)的候选列表。
4.2 融合重排:五种 reranker 与预置组合
多路召回的结果不能直接拼,需要融合排序。search_utils.py:357-446 定义了一批 reranker,常见五种:
rrf(Reciprocal Rank Fusion,:1764-1779):核心一行scores[uuid] += 1 / (i + rank_const)——只看排名不看分数,天然免疫各路召回的分数量纲差异,是默认的稳健选择;mmr:在相关性与多样性之间折中,避免召回结果全部是同一段内容的变体;cross_encoder:对 (query, fact) 逐条打分,精度最高但最贵,适合候选集已缩小的精排阶段;node_distance:按候选事实与"中心节点"(查询定位到的实体)的图距离加分;episode_mentions:按事实在 episode 中被提及的频度/新鲜度加权。
用户不需要自己拼:search_config_recipes.py 预置了组合,比如 COMBINED_HYBRID_SEARCH_RRF(:34)和 COMBINED_HYBRID_SEARCH_CROSS_ENCODER(:81)——前者便宜稳健(多路召回 + RRF),后者用 cross_encoder 精排换取精度。取舍也很直白:cross_encoder 要对每条候选边跑一次模型推理,候选集大时延迟和成本线性上涨,所以工程上常见的姿势是"召回阶段用 RRF 组合把候选压到几十条,精排阶段再上 cross_encoder"。选择权被暴露成配置而非写死,正是为了让你按自己的延迟/成本预算调档位。
图 4|混合检索:多路召回、融合重排与时间过滤
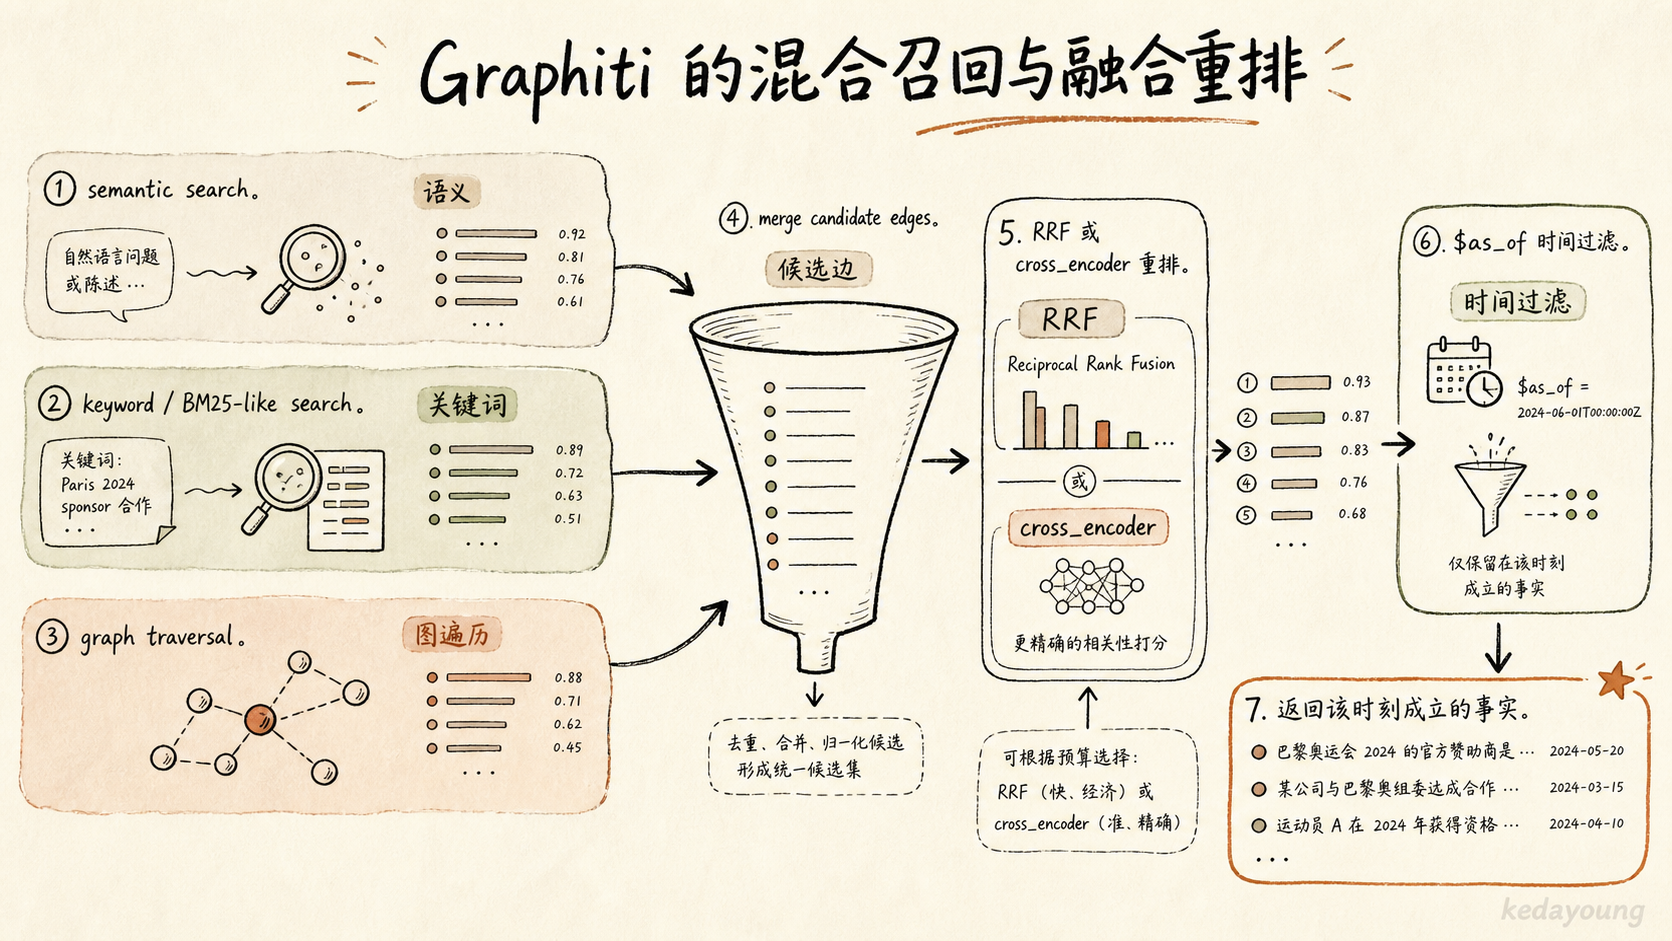
图注:三条召回路都汇总成「边」作为候选;融合只看排名(RRF)或按预算选 cross_encoder;时间过滤把候选剪到「该时刻成立的事实」。
4.3 时间过滤:查询"任意时刻的图状态"
这是时序记忆和普通图谱 RAG 的分水岭。SearchFilters(search/search_filters.py:55-67)允许对四个时间字段分别过滤:
class SearchFilters(BaseModel):
    node_labels: list[str] | None = ...      # :56-58
    edge_types: list[str] | None = ...       # :59-61
    valid_at: list[list[DateFilter]] | None = ...   # :62
    invalid_at: list[list[DateFilter]] | None = ... # :63
    created_at: list[list[DateFilter]] | None = ... # :64
    expired_at: list[list[DateFilter]] | None = ... # :65
    edge_uuids: list[str] | None = ...       # :66
property_filters: list[PropertyFilter] | None = ... # :67每个日期字段支持一组比较算子(ComparisonOperator,:27-35):= / <> / > / < / >= / <= / IS NULL / IS NOT NULL。嵌套的 list[list[DateFilter]] 结构对应 AND/OR 布尔组合,由 edge_search_filter_query_constructor(:120-271)编译成 Cypher 条件,贯穿 edge_search / node_search / BFS(search_utils.py:459 一带)。
"某时刻的图状态"查询由此变得直接:问"2025 年 3 月时用户住哪",就构造 valid_at <= 2025-03-31 AND invalid_at IS NULL OR invalid_at > 2025-03-31 这类条件——命中 [valid_at, invalid_at) 覆盖该时刻的事实,同时自然排除 expired_at 已过期的边。落在 Cypher 上大致是:
MATCH ()-[r:EntityEdge]->()
WHERE (r.valid_at IS NULL OR r.valid_at <= $as_of)
  AND (r.invalid_at IS NULL OR r.invalid_at > $as_of)
  AND (r.expired_at IS NULL OR r.expired_at > $as_of)
RETURN r
(实际查询由 edge_search_filter_query_constructor 按 SearchFilters 动态组装,这里只示意语义。)失效不是删除,正是因为查询需要"回到过去";如果删了,这个查询就无解了。引言里承诺的"把三月份的 Alice 查回来"就是这么实现的:把 $as_of 设在二月底(2025-02-28)——"住在北京"当时还在有效期内,命中;"搬到上海"的 valid_at 在三月初、晚于该时刻,不命中。此时查到的图就是"二月底的 Alice";而今天的查询则会同时看到两条边,各自带着不同的有效区间。
图 5|时间过滤:"任意时刻的图状态"怎么查
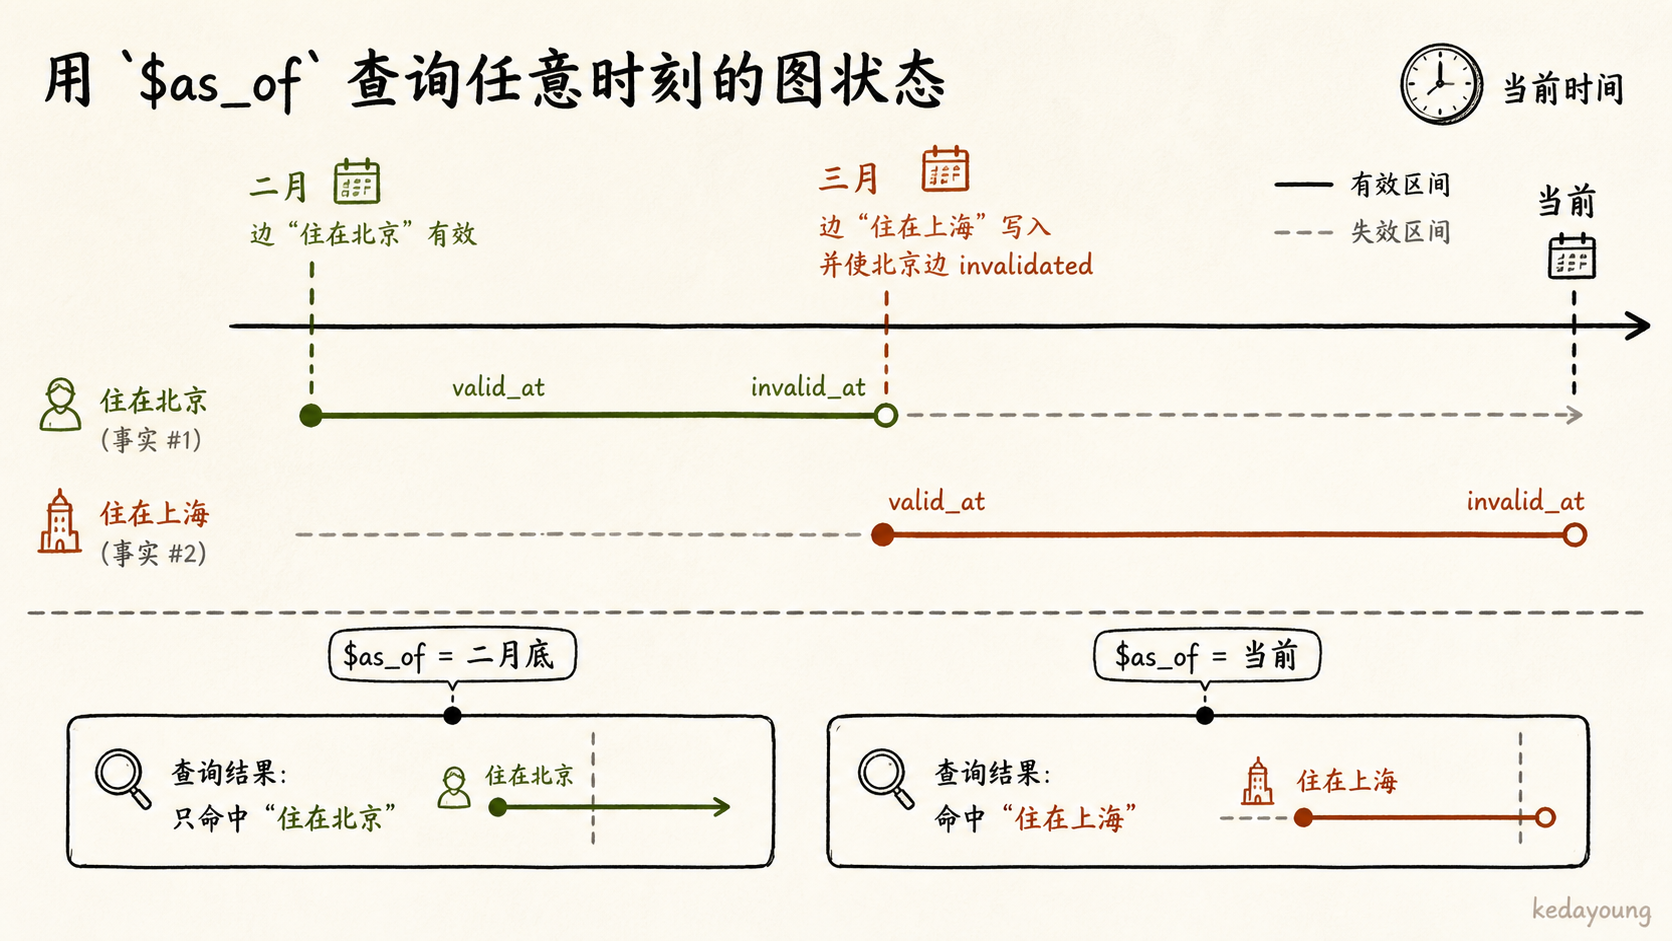
图注:同一时刻查询命中两条带不同有效区间的边;倒回二月底则只剩"住在北京"。
$as_of就是 Cypher 里的$as_of参数。
4.4 社区摘要:可选的聚合检索路径
最后一条可选路径是社区摘要。build_communities(graphiti.py:1490-1524)基于标签传播算法(utils/maintenance/community_operations.py:93-138 的 label_propagation)把关联实体聚成社区,再对社区内事实做配对摘要合并(:174-213),产出 CommunityNode。它服务的场景是"这组实体整体在讲什么"——比单条事实更高层的聚合视角,代价是额外的维护成本(update_communities 默认关闭)。
5. 后端抽象与可迁移经验
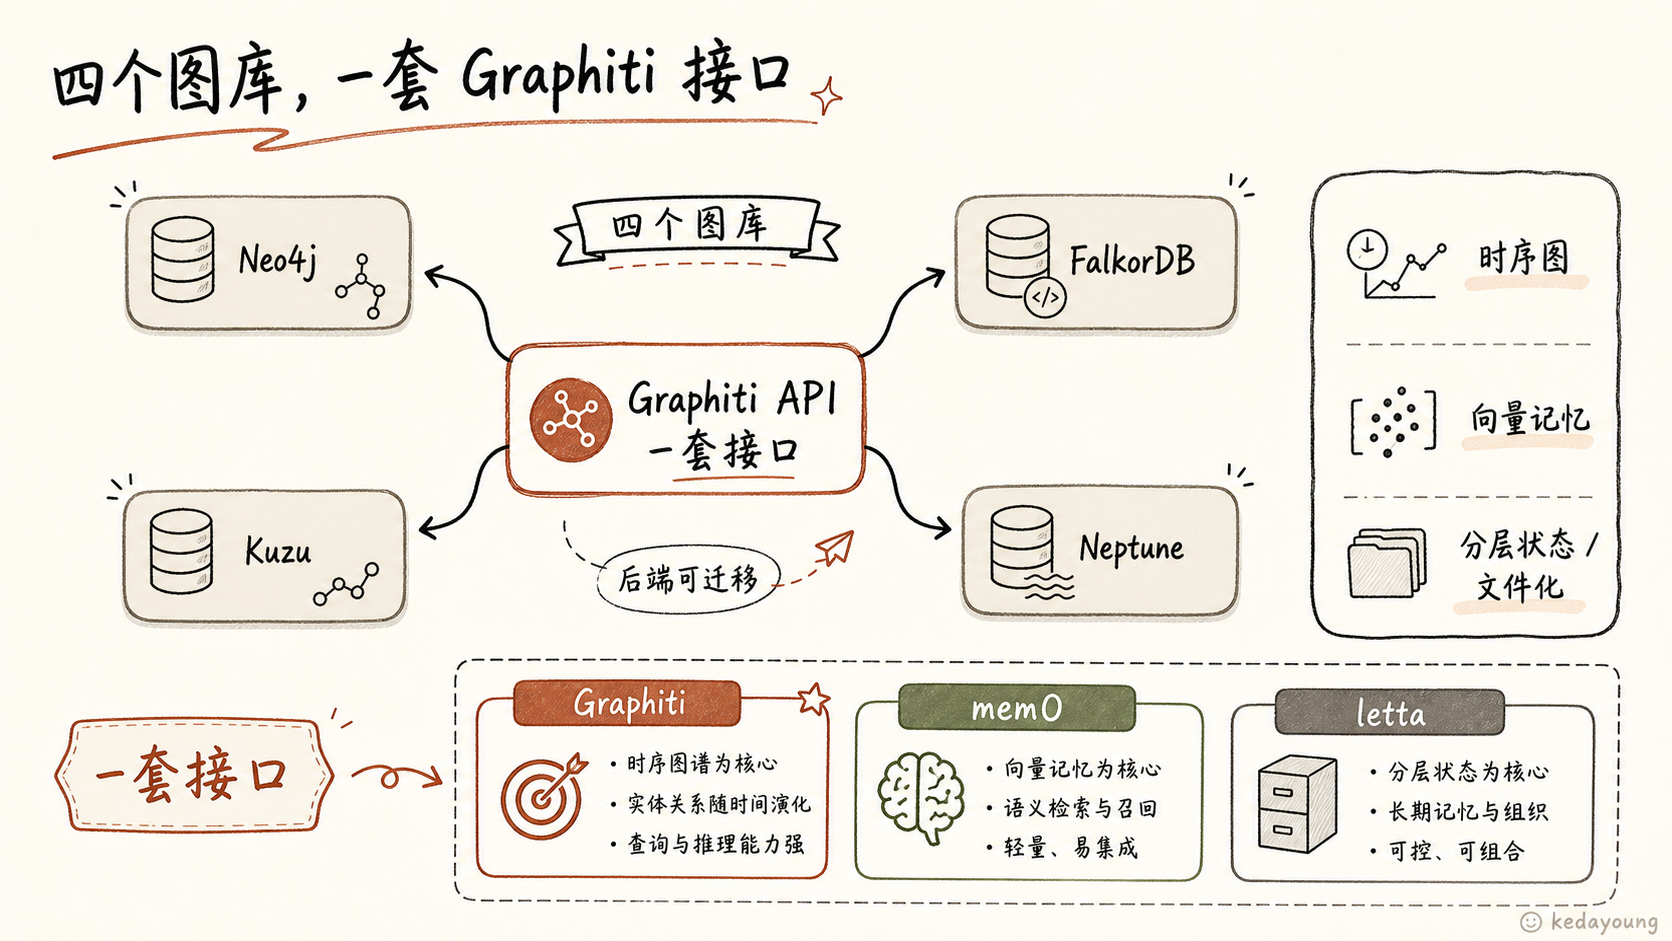
5.1 后端抽象:四个图库,一套接口
graphiti 对图数据库的抽象分三层(driver/driver.py):
GraphProvider枚举(:59-63):NEO4J/FALKORDB/KUZU/NEPTUNE,纯标识符;GraphDriver抽象基类(:90-211):定义execute_query/session/transaction/clone等核心方法,外加两个扩展点——search_interface(:98,语义/全文检索)与graph_operations_interface(:99,节点/边/社区/saga 的读写操作);- 四个具体实现(如
driver/neo4j_driver.py:61):各自实现查询语法、全文索引、向量索引的差异。
fulltext_syntax(:92)这类小字段暴露了抽象的真实意图:图查询语言(Cypher)各家基本兼容,真正的差异在全文检索语法和向量检索实现上,所以抽象把这两处单独开接口。transaction(:146-166)的注释同样是这个思路的体现:有原生事务的后端(如 Neo4j)提交/回滚语义完整,没有的(如 FalkorDB)返回一个"立即执行"的薄包装——抽象允许能力降级,而不是假装所有后端能力一致。设计上值得注意:图库后端抽象比 ORM 抽象难,因为要抽象的是"查询语言方言 + 索引能力矩阵 + 事务语义"的组合,接口设计要围绕"哪些能力各家都具备、哪些是加分项"来切,并为缺失能力留降级路径。
另外注意:README 已警告 Kuzu 后端已废弃——四库清单里的名字不代表都处于同等维护状态,选型前要看项目当前状态。
5.2 与 mem0 / letta 的边界
时序图不是唯一的记忆方案,三者的分工值得厘清:
| 维度 | mem0 | letta | graphiti |
|---|---|---|---|
| 存储结构 | 外部事实库(向量 + 提取事实) | Agent 状态(agent 自身管理工具/记忆) | 时序上下文图(带有效期的边 + 溯源) |
| 更新语义 | add / search,提取后入库 | 工具自编辑(agent 主动写/改) | 增量管线 + 失效而非删除 |
| 历史保留 | 弱(覆盖式更新) | 依赖实现 | 完整(打时间戳保留 + 时间查询) |
| 检索方式 | 相似度为主 | 工具调用/上下文 | 语义 + BM25 + 图遍历多路融合 + 时间过滤 |
存储结构决定能力边界:graphiti 能回答"当时是什么""后来怎么变的",代价是重(图库 + 强模型 + 结构化输出);mem0 轻、快,但"事实被覆盖"就丢了历史;letta 把记忆的控制权交给 agent 本身,灵活但一致性与可追溯性取决于 agent 的纪律。选型不是比谁强,而是比谁的结构匹配你的查询模式。
注:上表中 mem0 / letta 两列基于对其公开项目的一般认知,本克隆未包含二者源码,未做核验;graphiti 一列以本克隆源码为准。
5.3 可迁移的设计准则(作者判断)
以下三条是从 graphiti 里可以独立带走的模式,与具体库无关:
- 事实带有效期,而不是状态覆盖。任何"会变化的事实"存储,都值得加
valid_at/invalid_at/expired_at三件套。它们让你免费获得:当前状态查询(取invalid_at IS NULL)、历史回放(按时刻过滤)、变更审计(对比两个时刻的差集)。 - 派生数据必须可溯源到原始数据。
episodes: list[str]这个字段是整个系统的信任基础——没有它,"失效"不知道失效谁,"摘要"不知道基于什么。凡是聚合/派生信息,保留一条指向证据的引用。 - 聚合信息带水位线。SagaNode 的
last_summarized_episode_valid_at和 EntityNode 的滚动 summary 表明:增量系统里,任何"累积型"输出都要记录"我已消化到哪",否则无法安全增量更新。
5.4 边界:什么时候别用 graphiti
同样诚实地说清代价:
- 依赖图数据库:本地/小项目起步成本高于 SQLite + 向量库;
- 依赖强模型:提取、消歧、摘要、schema 输出全部靠 LLM,README 自述小模型结构化输出不可靠——这是实际运营风险,不是理论问题;
- 复杂度:数据模型、管线、多路检索都显著重于向量记忆,一个"记几条用户偏好"的场景用它属于杀鸡用牛刀;
- 运行依赖:需要 embedding 与 LLM 服务,离线/成本敏感环境要掂量。
graphiti 的价值峰值在"事实会反复变化 + 需要追溯历史 + 结构化查询"的场景:客服助手(用户信息随时间变)、个人助理(偏好演化)、研究助手(对同一话题的立场演变)。如果你的查询只有"最近说什么"而没有"当时怎么说",向量记忆可能已经够了。
把第 5 节压缩成一张决策清单:
- 需要回答"现在是什么"且事实频繁变化 → 需要有效期语义,graphiti / 自制时序边;
- 需要回答"当时是什么"、要完整历史 → 需要"失效保留 + 时间过滤",这是 graphiti 的核心差异点;
- 需要从一条事实追到原始消息 → 需要溯源字段(
episodes),任何方案都该留; - 只有"把最近相关内容拼进 prompt"的诉求 → 向量记忆即可,别为不用的能力付复杂度。
结语
回到开头的问题:记忆为什么需要"图 + 时间"?因为事实是会变的,而变过的事实依然是事实的一部分。graphiti 用 EntityEdge 的有效期窗口回答"现在是什么",用 episodes 溯源回答"凭什么这么说",用增量管线回答"怎么低成本地更新",用时间过滤回答"当时是什么"——四个问题,一套模型。
它的代价同样清晰:图数据库、强模型、结构化输出的硬依赖。但作为"时序记忆"这一方向的参考实现,它把"记忆 = 带时间戳、可溯源、增量维护的事实流"这句话翻译成了可读的代码——而这句话,才是比任何具体库都值得带走的东西。
参考文献与源码证据
- graphiti 源码,v0.29.3(本地克隆 commit
401c59a),graphiti_core/各文件行号见正文。 - graphiti 论文:Zep. Graphiti: A Temporal Knowledge Graph for Agentic Memory(arXiv:2501.13956)。概念性结论参考论文,代码行为以源码为准。
- graphiti README:"Graphiti vs. GraphRAG" 对照表及 Kuzu 废弃、小模型 schema 失效等运营性说明,均为官方自述,非独立评测。
关键证据速查
| 断言 | 证据位置 |
|---|---|
| 版本 v0.29.3 | pyproject.toml:4 |
| EntityEdge:事实 + 溯源 + 有效期 | edges.py:263-285(episodes :267-270,时间戳 :271-282) |
| Node / EntityNode | nodes.py:93-98、:499-504 |
| EpisodicNode / EpisodeType | nodes.py:318-332、:54-77 |
| add_episode 管线 | graphiti.py:980-1228(retrieve :1088、extract :1122、resolve :1131、edges :1140、community :1184) |
| 三级消歧(语义→规则→LLM) | utils/maintenance/node_operations.py:627-708、:407、:418、:467;dedup_helpers.py:220 |
| 消歧余弦阈值 0.6 | utils/maintenance/node_operations.py:65、:445 |
| 边失效返回 invalidated 组 | graphiti.py:1140-1154、:1156 |
| RRF 融合 | search_utils.py:1764-1779 |
| 预置检索配置 | search_config_recipes.py:34、:81 |
| 时间过滤 SearchFilters | search_filters.py:55-67、比较算子 :27-35、Cypher 构造 :120-271 |
| 社区标签传播 | utils/maintenance/community_operations.py:93-138、:174-213 |
| 后端抽象 | driver/driver.py:59-63、:90-211;neo4j_driver.py:61 |