中心论点:hello-agents 用「ContextBuilder(GSSC 流水线)+ NoteTool + TerminalTool + MemoryTool」四个组件,把"上下文工程"从概念落成了可运行、可单文件通读的教学代码;它用「相关性 + 新近性」的单一评分规则和固定分区模板,换来了可调试、可扩展、可教学——代价是相关性计算、token 估算与压缩都用朴素实现,直接搬进生产会精度不足。 证据说明:文中「hello-agents」指
datawhalechina/hello-agents仓库,证据一律引用本地克隆0-context-engineering/20260810-hello-agents/下的教程正文docs/chapter9/第九章 上下文工程.md(下文简称「第九章」)与配套代码code/chapter9/;与 pi 的对照引用20260803-pi-java-workflow/tmp/pi/(v0.84.1)。所有file:line以本地文件当前内容为准。
1. 从概念到落地:hello-agents 把「上下文工程」变成了什么
上下文工程(Context Engineering)在科普层面讲的是"管理什么进入模型":每次调用 LLM 之前,审视模型可见的整体状态,优化进入上下文窗口的那组 tokens 的效用。第九章把这个宏观命题收束成一个可操作的问题——推理发生时哪些信息进入模型、以什么形态、占多少预算——然后给出了它的答案:四个可运行组件。
- ContextBuilder:统一构建上下文的 GSSC 流水线(Gather-Select-Structure-Compress,第九章 §9.3);
- NoteTool:结构化笔记,承载跨会话的任务状态(§9.4);
- TerminalTool:即时文件系统访问,按需拉取证据(§9.5);
- MemoryTool:对话记忆,在示例代码中作为组件接入。
这套组合的落点可以概括为「一套流水线 + 三个配套工具」:ContextBuilder 是中枢,负责"每轮推理前如何拼装上下文";三个工具是它的信息源与出口,分别回答"持久信息从哪里来(笔记)""即时证据怎么取(终端)""短期记忆放哪里(MemoryTool)"。值得注意的是,它们不是并列的四个模块,而是一个构建器 + 三个工具——工具负责来源治理,构建器负责预算与形态治理,职责边界清晰。
这个结构不是凭空出现的。第九章的叙事顺序本身就是设计意图的注脚:§9.1–9.2 先讲概念(上下文腐蚀、JIT 上下文、长时程任务的三大策略),§9.3–9.5 全部是代码落地。「讲解概念 → 直接给实现」是本书的一贯结构,第九章尤其彻底——理论只占两节,剩下三节全是可运行的 Python。配套代码 code/chapter9/ 下是 6 个示例脚本 + 1 个核心组件 codebase_maintainer.py(476 行),示例按「基础用法 → Agent 集成 → 长程工作流」三个层次递进:01_context_builder_basic.py 演示构建器本身,02_context_builder_with_agent.py 演示与 Agent 集成,03/04 围绕 NoteTool,05 围绕 TerminalTool,06_three_day_workflow.py 把四件套装进一个跨会话的三天工作流。
在展开细节之前,先给出全文的判断:这是一份教学优先的工程样板——结构完整、单文件可读、无需重型依赖,可 30 分钟跑通全流程;但每一个简化处(关键词相关性、启发式 token 估算、截断式压缩)都是与生产实现对照的观察点。我们先把这四件套拆开看,最后再回到这个判断。
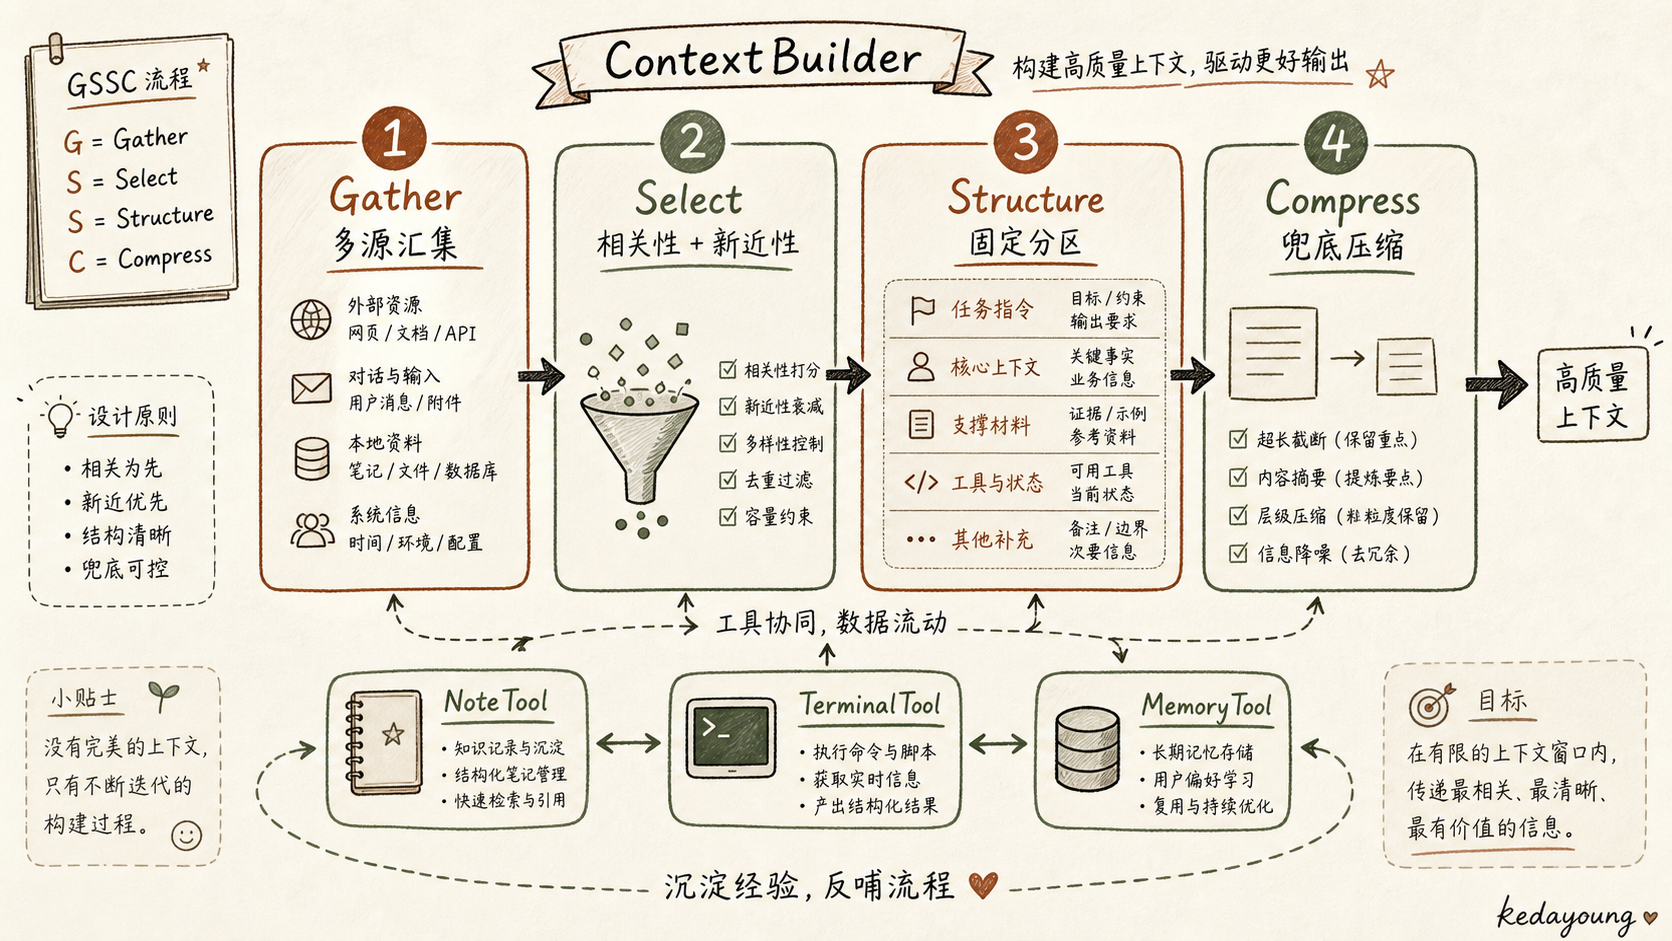
图 1|概念 → 组件映射:ContextBuilder 居中作为统一入口,三个工具从各自存储向它喂入信息。
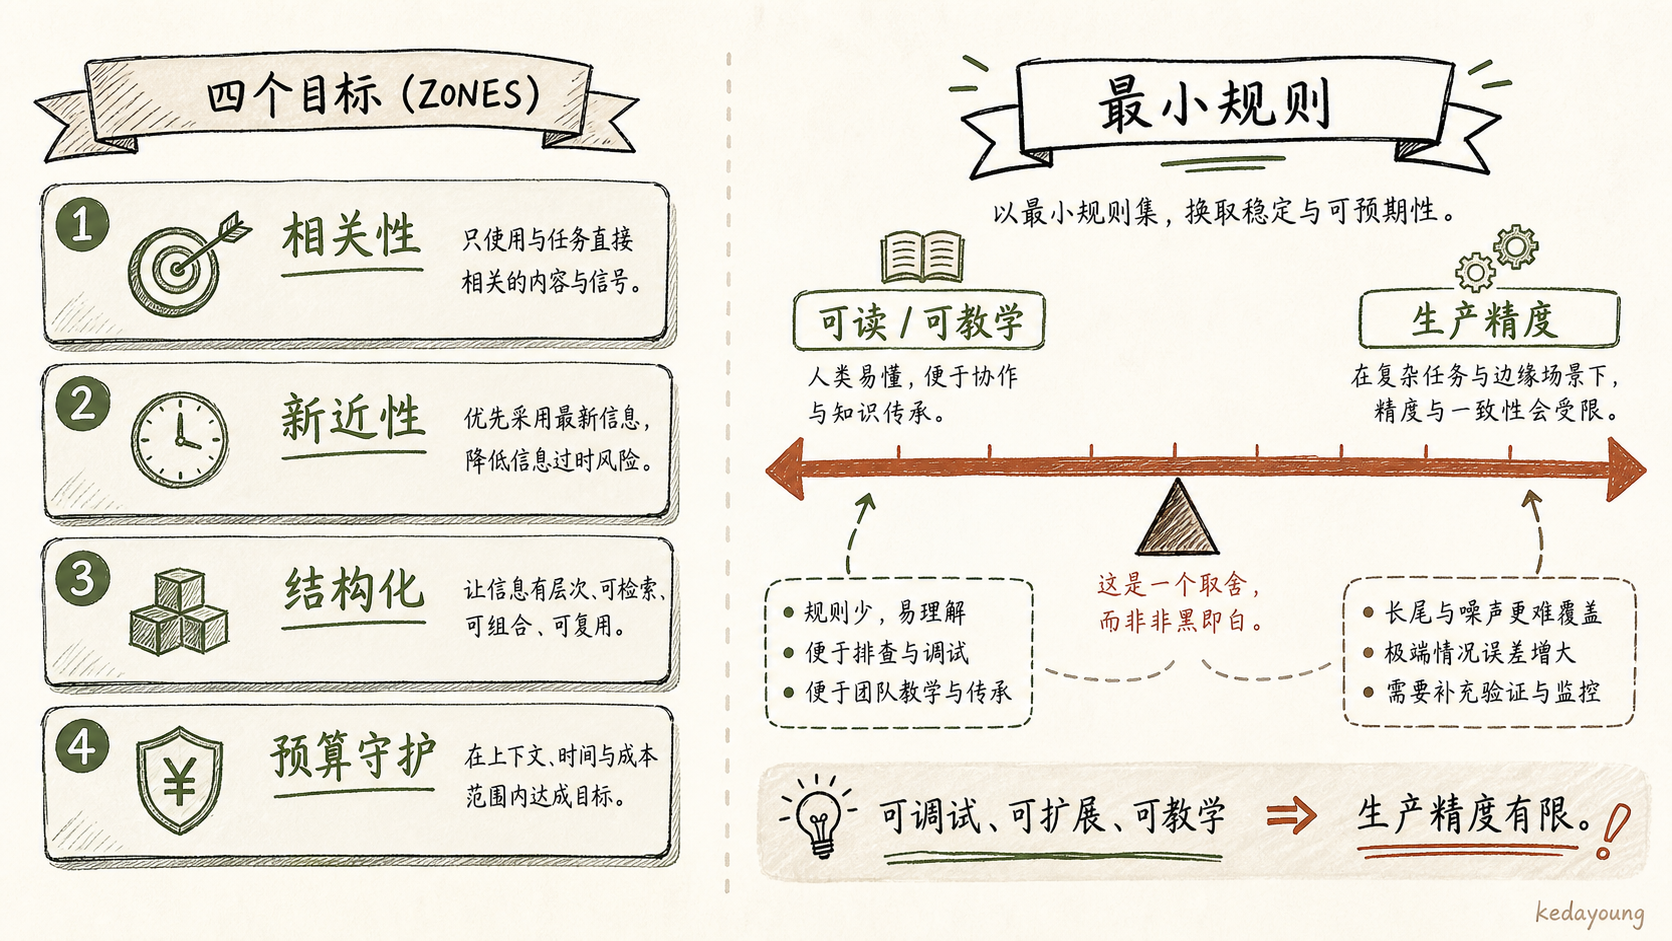
2. 设计动机:四个目标与「最小规则」的取舍
ContextBuilder 立项时不是"顺手写个工具类",而是带着明确的设计目标(第九章:129-145)。四个目标可以逐条对应到后面会看到的机制:
| 设计目标 | 对应机制 |
|---|---|
| 统一入口 | 把「获取-选择-结构化-压缩」抽象为可复用流水线,避免每个 Agent 重复写上下文管理代码 |
| 稳定形态 | 输出固定骨架的上下文模板,便于调试、A/B 测试与评估 |
| 预算守护 | token 预算内尽量保留高价值信息,超限有兜底压缩 |
| 最小规则 | 不引入来源/优先级等分类维度,只用「相关性 + 新近性」评分 |
其中「稳定形态」落到具体就是六个分区模板(第九章:135-141):[Role & Policies](角色与行为准则)、[Task](当前任务)、[State](Agent 当前状态)、[Evidence](外部知识库证据)、[Context](历史对话与记忆)、[Output](输出格式要求)。这个模板的意义在于:调试时能快速定位问题分区——模型回答不对,先看是 [Evidence] 给了错误证据,还是 [Task] 表达不清;评估时也能对"同样的骨架、不同的填充"做 A/B。
而「最小规则」是全文最重要的设计姿态。作者明确写了一句判断:"实践表明,基于相关性和新近性的简单评分机制,在大多数场景下已经足够有效"(第九章:145)。请注意措辞——这是作者判断,不是实验结论。它体现的是一种刻意的克制:不引入来源权重、优先级标签、信息类型分层这些在真实产品里常见的维度,宁可让评分规则简单到可以被一行公式讲清。对想读懂代码的人来说,这个选择是巨大的红利:整条流水线的行为可以被完全预测,改一个阈值就能看到效果变化。
四个目标叠加起来,指向的价值是可调试与可扩展:固定模板让调试有抓手,新增信息源 = 新增分区让扩展有路径。这两点直接服务于教学场景里"改得动"的需求——可运行的代码、可修改的参数、可理解的流程,而不是一个参数多到无从下手的系统。
3. 核心数据结构:ContextPacket 与 ContextConfig
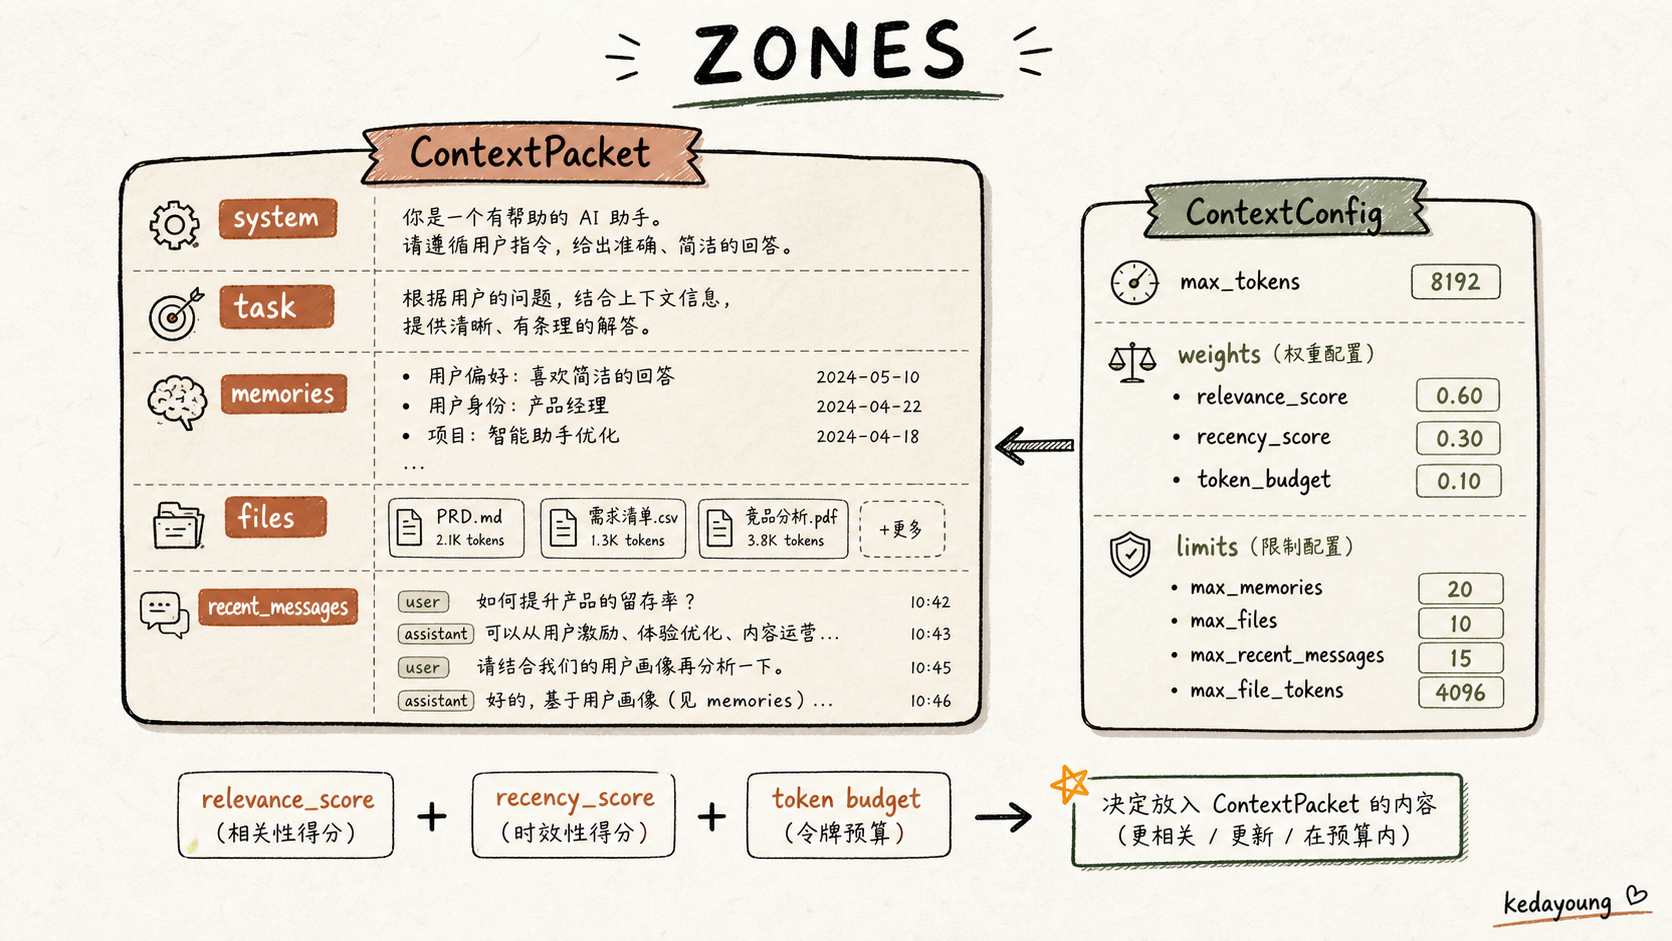
流水线处理的对象是"候选信息",配置约束的是"流水线行为"。这两个数据结构定义了系统的信息单元和边界条件。
ContextPacket:信息基本单元(第九章:153-181)。一条候选信息被封装为一个 dataclass,字段为 content / timestamp / token_count / relevance_score / metadata。三个细节值得注意:
relevance_score默认 0.5——这个"中性默认值"意味着「未评分的候选信息按中性分数进入流水线」,是否重算由 Select 阶段的规则决定(第九章:172、:349)。它让"谁负责打分"的边界变得清晰:Gather 阶段可以不带分数地收信息,Select 阶段统一处理。__post_init__把分数裁剪进[0, 1](第九章:180),防止上游传入越界值污染排序。metadata是自由的字典,实际承载了type(信息种类)、priority(优先级)等键,是 Structure 阶段分桶的依据。
ContextConfig:配置管理(第九章:187-213)。默认值本身就是一份"教学基线":max_tokens=3000、reserve_ratio=0.2、min_relevance=0.1、enable_compression=True、recency_weight=0.3、relevance_weight=0.7。__post_init__ 用断言校验参数合法性,包括一个容易被忽略的约束:recency_weight + relevance_weight == 1.0(第九章:211)——双因子必须归一化,否则综合分数没有可比意义。
其中 reserve_ratio 值得单独解释(第九章:215):它为系统指令等关键信息预留预算。流水线会先算出系统指令占用的 token,从总预算中扣除,剩下的才分配给普通信息(第九章:337-343)。这个字段是"预算守护"目标的直接落地——防止最高价值的角色/策略指令被海量普通信息挤占出窗口。
这里已经能看到与生产实现的第一处对照,先点一句、第 7 节再展开:hello-agents 用 dataclass + 断言做配置约束,简单直接;pi 则在代码里写死三个常量 reserveTokens=16384 / keepRecentTokens=20000 / contextWindow=128000(compaction.ts:126-136)。前者把"配什么"暴露给使用者,后者把"用多少"固化为产品决策——这是教学代码与生产代码在配置哲学上的典型差异。
4. GSSC 流水线:Gather / Select / Structure / Compress
GSSC 是 ContextBuilder 的核心(第九章:217-219),把"构建上下文"拆成四个阶段。逐阶段看关键决策与简化之处,是理解这套实践的门径。
4.1 Gather:多源信息汇集(第九章:225-304)
Gather 把五类来源汇集为候选 ContextPacket 列表:
- 系统指令:
relevance_score=1.0,metadata 标type=system_instruction, priority=high(第九章:246-254)——不参与评分、始终保留; - 记忆检索:
limit=10, min_importance=0.3(第九章:256-269),来自 MemoryTool; - RAG 检索:
limit=5, min_score=0.3(第九章:271-284),来自 RAGTool; - 对话历史:仅取最近 5 条,基础相关性 0.6(第九章:286-296);
- 自定义包:调用方直接传入的
custom_packets(第九章:298-300),是 NoteTool 等外部工具接入的通道。
三个设计要点(第九章:306-310):每个外部数据源都单独包在 try-except 里,单个源失败不拖垮整体(比如 RAG 挂了,记忆和历史照常进入);系统指令被标记为最高优先级;对话历史只留最近几条,防止窗口被历史对话占满——这呼应了第 2 节的"预算守护"。
第一个观察点也在这里:记忆与 RAG 的检索参数(limit、阈值)硬编码在调用处(第九章:262-263、:277-278),属于教学简化。生产实现中这类参数几乎一定是配置项,会随任务类型动态调整。
4.2 Select:智能信息选择(第九章:316-429)
Select 是整条流水线的决策核心。流程是:分离系统指令(不参与评分)→ 计算系统指令占用 → 对其它包计算综合分数 → 过滤低于 min_relevance 的包 → 按分数降序排序 → 贪心填充到 token 上限(第九章:333-382)。
综合分数 = relevance_weight × relevance + recency_weight × recency(第九章:356-360),两个权重来自 ContextConfig,默认 0.7/0.3。两个评分函数都刻意做成"一眼能看懂":
_calculate_relevance:Jaccard 关键词重叠(第九章:384-407)。把内容与查询各自lower().split()成词集,取交集/并集。注释明说"在生产环境中,可以替换为向量相似度计算"(第九章:387)。_calculate_recency:指数衰减(第九章:409-428)。exp(-0.1 × age_hours / 24),限幅在[0.1, 1.0]——24 小时内保持高分,之后逐渐衰减,下限 0.1 保证老信息也有一丝生存机会。
工程要点(第九章:433-435):贪心 + 预算上限保证"在有限预算内选最有价值信息";min_relevance 过滤低质量信息。注意贪心是按分数从高到低逐个尝试放入,放不下就 break(第九章:373-379)——这是一个"够用就好"的策略,不做复杂的背包优化。
第二个观察点,也是全文最明显的教学简化证据:Jaccard 对中文、同义词几乎失效。split() 按空格分词,中文文本天然没有空格,整段中文可能被当成一个词;"优化"与"性能优化"也不产生任何交集。在中文场景下,这个相关性函数实际退化为"有没有命中完全相同的英文关键词"。这正是它注释里那句"可替换为向量相似度"的真实分量。
4.3 Structure:结构化输出(第九章:441-489)
Structure 把选中的包按 metadata 的 type 分桶,拼成固定模板:system_instruction → [Role & Policies]、rag_result/knowledge → [Evidence]、其余 → [Context];[Task] 放用户查询、[Output] 放固定输出指令(第九章:452-488)。
三个价值(第九章:491-495):可读性(人和模型都能看懂结构)、可调试性(问题快速定位到具体分区)、可扩展性(新信息源 = 新分区,不用动既有逻辑)。
这里有一个必须按代码如实描述的细节:设计目标提到六个分区(含 [State]),但 Structure 的示例代码只实际输出五段——[Role & Policies] / [Task] / [Evidence] / [Context] / [Output],[State] 分区没有生成逻辑(第九章:452-488)。大纲设计是"理想形态",代码是"当前实现",两者存在一处出入。读代码的人应以代码为准:目前 Agent 的"当前状态"是被塞进 [Context] 或系统指令里表达的。
4.4 Compress:兜底压缩(第九章:501-578)
Compress 只在超限时触发:_count_tokens(context) > max_tokens 才执行(第九章:512-517),是"兜底"而非"常态"。
压缩策略是分区压缩,保持结构完整性:按 \n\n 把上下文切成段落,逐段决定完整保留或部分保留——剩余预算不足时,若还够 50 tokens 就截断该段并追加 [... 内容已压缩 ...] 标记,然后 break(第九章:519-544)。宁可截断内容,也不打乱分区边界,保证压缩后的上下文仍是同构模板。
两个辅助函数同样朴素:
_truncate_text:按字符比例估算截断位置(第九章:546-561),注释明说"生产环境中应该使用精确的 tokenizer";_count_tokens:中文 1 字符 ≈ 1 token、英文 1 词 ≈ 1.3 token 的启发式(第九章:563-577)。
第三个观察点:压缩是"结构保真优先"。这与 pi 形成全文最强的对照——pi 的压缩是"结构化摘要替代截断":把历史总结成带 ## Goal / ## Progress / ## Key Decisions / ## Next Steps 等固定小节的 checkpoint 摘要,由另一个 LLM 续写(compaction.ts:467-498)。一个是把旧内容截掉,一个是把旧内容蒸馏成可续写的新文档,这是两种完全不同的"压缩哲学"。
4.5 阶段小结
| 阶段 | 输入 → 输出 | 关键机制 | 简化处 |
|---|---|---|---|
| Gather | 多源 → 候选包列表 | 容错、系统指令最高优先级、历史限 5 条 | 检索阈值硬编码 |
| Select | 候选包 → 选中包 | 双因子评分、贪心填充、min_relevance 过滤 | Jaccard 相关性 |
| Structure | 选中包 → 分区模板 | 按 type 分桶、五分区输出 | 与六分区设计略有出入 |
| Compress | 模板 → 压缩后模板 | 分区保真、字符比例截断 | 启发式 token 估算 |
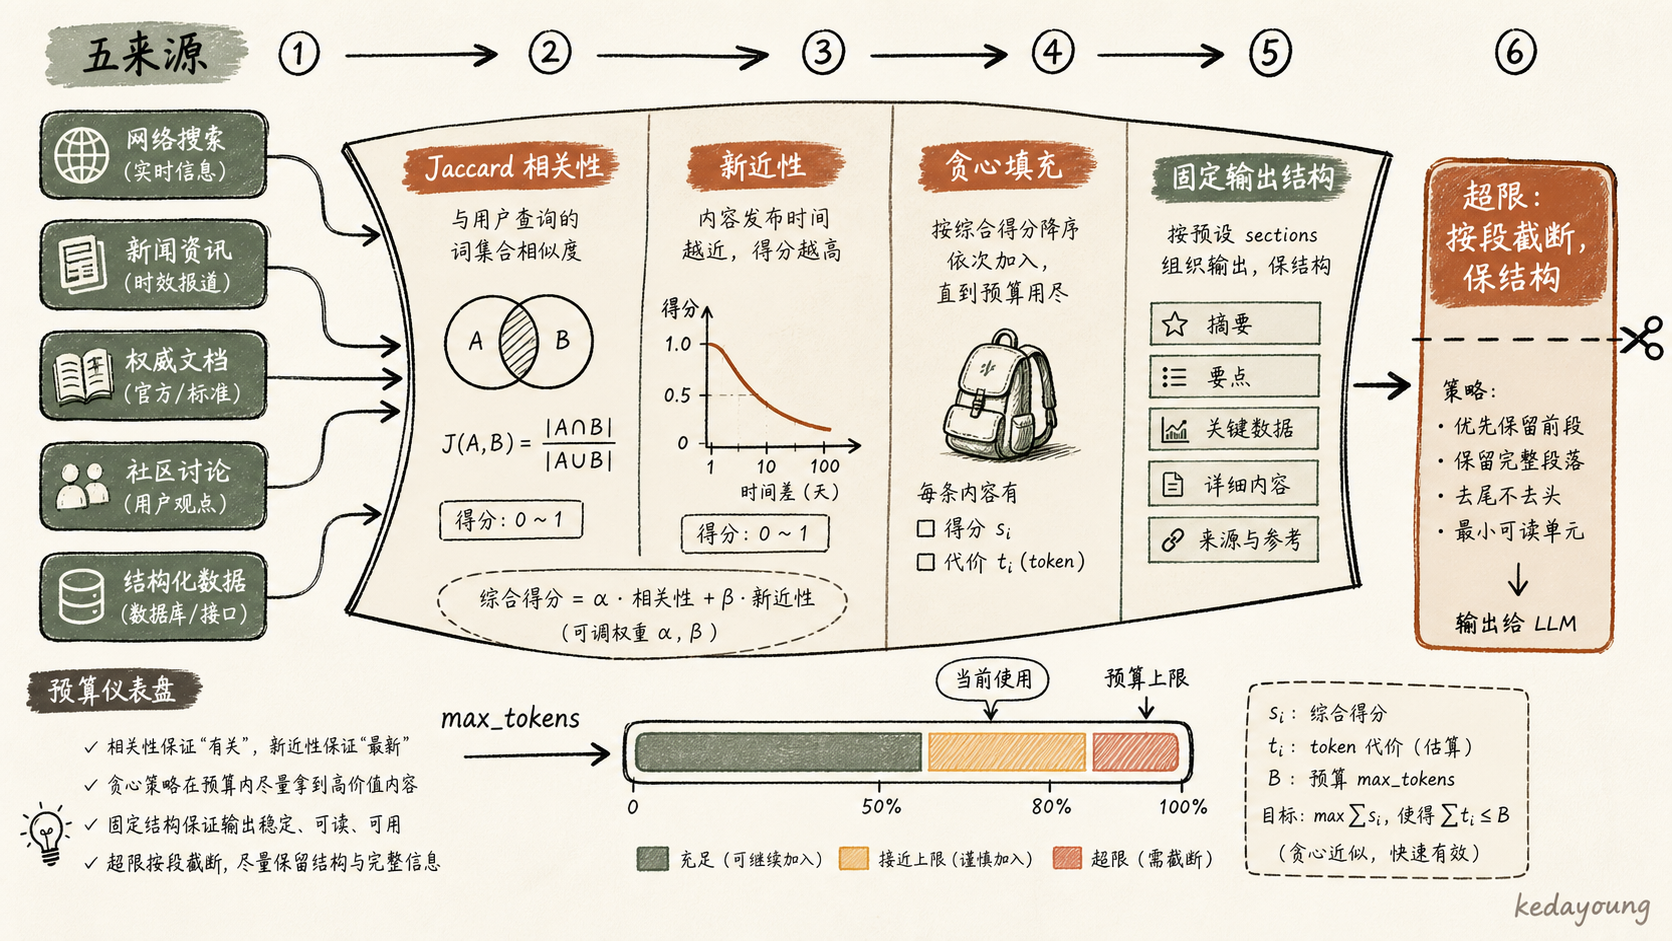
图 2|GSSC 流水线:四个阶段顺序执行,「预算」约束贯穿 Select 与 Compress 两处决策点。
再举一个 Select 评分的小例子,直观展示"谁进上下文":
| 候选信息 | 相关性 | 新近性 | 综合分(0.7/0.3) | 预算内? |
|---|---|---|---|---|
| 系统指令 | 1.0(不评分) | — | 预留在 reserve 内 | ✅ 始终保留 |
| 记忆:用户用 Pandas | 0.85 | 0.98 | 0.889 | ✅ |
| RAG:内存优化策略 | 0.72 | 0.96 | 0.792 | ✅ |
| 历史第 4 轮 | 0.60(基础分) | 0.88 | 0.684 | ✅ |
| 历史第 1 轮 | 0.60(基础分) | 0.45 | 0.555 | ❌ 预算用尽被跳过 |
表:综合分 = 0.7×相关性 + 0.3×新近性;分数排序 + 贪心填充决定取舍(数值为演示构造,非真实运行输出)。
5. 配套工具:NoteTool 结构化笔记与 TerminalTool 即时文件访问
ContextBuilder 解决的是"信息如何被选择和组织",但信息从哪来是另一个问题。NoteTool 与 TerminalTool 回答的正是这个来源问题:它们控制"哪些持久信息可以再进入上下文"与"哪些即时证据按需进入上下文",共同减少"盲目把整个仓库或整段历史塞进窗口"的行为。这是上下文工程的来源治理层。
5.1 NoteTool:以结构化笔记承载跨会话状态(第九章:788-1583)
为什么需要它
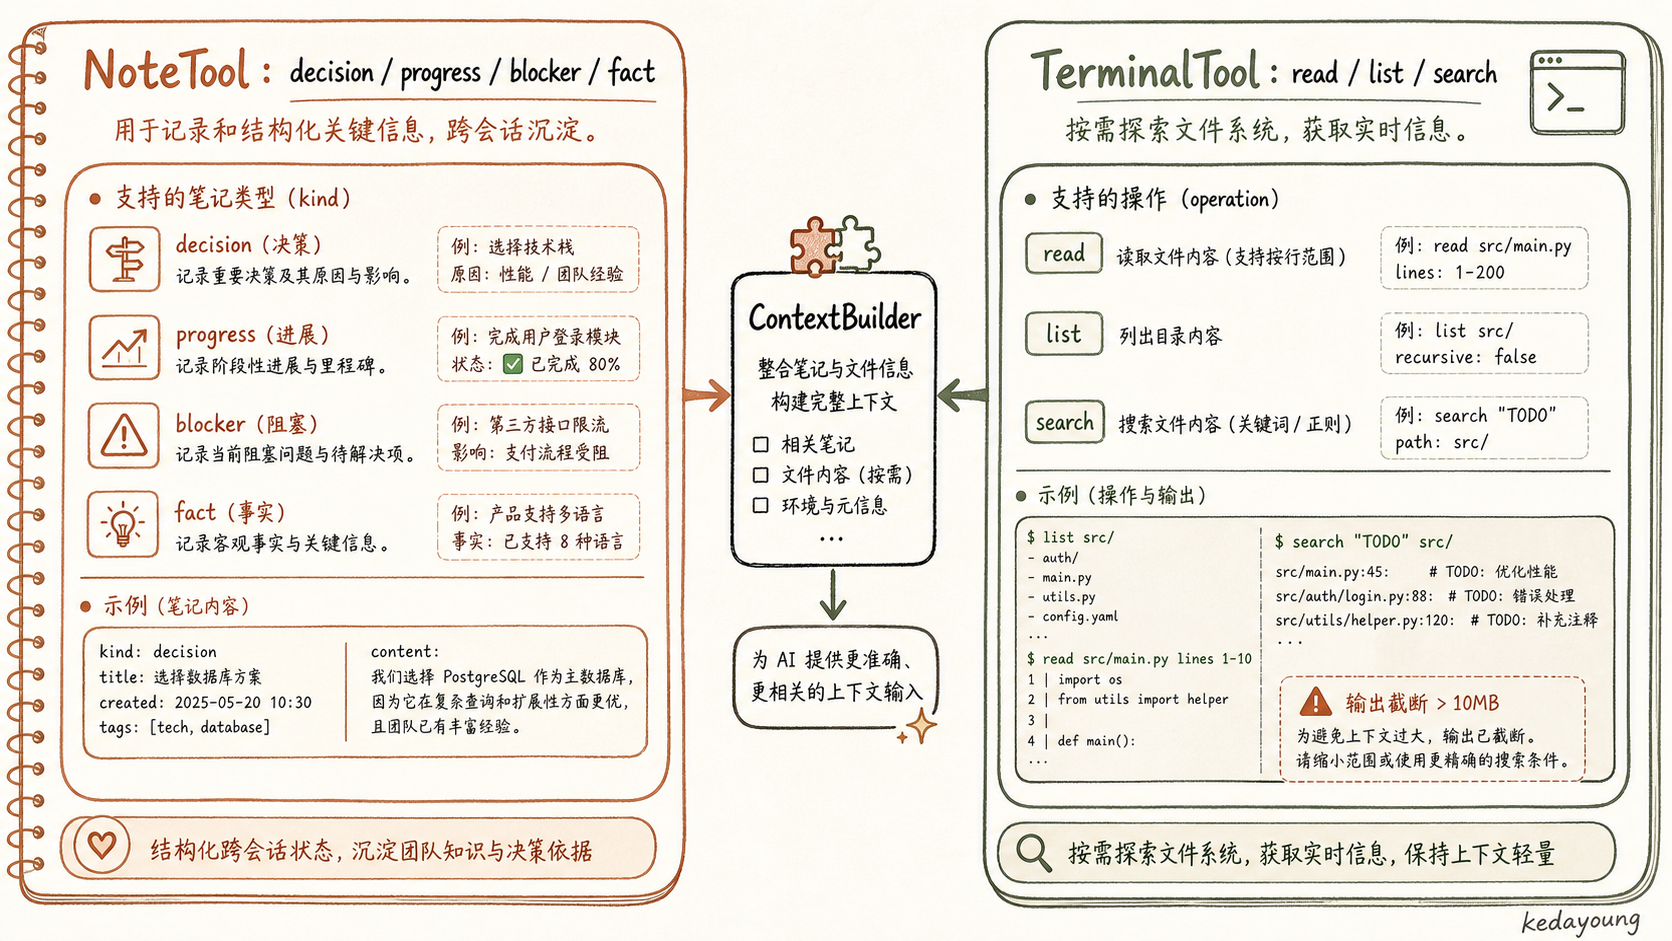
第八章的 MemoryTool 侧重对话式记忆(短期工作记忆、情景记忆、语义记忆),对"需要长期追踪、结构化管理的项目式任务"来说太重、也太隐式(第九章:798)。NoteTool 的定位是更轻量、更人类友好的持久化:以 Markdown 文件为载体,YAML 前置元数据记录关键信息,正文记录状态、结论、阻塞与行动项(第九章:790)。四个特性:结构化记录、Git 版本友好、低开销、可灵活分类(第九章:802-805)。
存储格式
每个笔记是一个独立 .md 文件,头部是 id / title / type / tags / created_at / updated_at 的 YAML 块,正文是自由 Markdown(第九章:889-919);另维护 notes_index.json 做快速检索与完整性校验(第九章:929-950)。文件名即 ID,简化管理。
核心操作
create / read / update / search / list / summary / delete 七个操作覆盖笔记完整生命周期(第九章:951-1314)。search 在标题与正文中做子串匹配,按更新时间倒序返回(第九章:1189-1206)。
类型驱动上下文相关性——这是 NoteTool 与 ContextBuilder 衔接的关键机制。笔记被分为 blocker / action / task_state / conclusion 四类(第九章:831-857 的示例、codebase_maintainer.py:164 的类型清单),类型在转成 ContextPacket 时映射为不同的相关性分数:blocker 0.9 / action 0.8 / task_state 0.75 / conclusion 0.7(codebase_maintainer.py:262-270)。阻塞问题天然比结论更容易被 Select 选中,这个优先级是编码在类型里的,而不是靠运行时猜测。
与 ContextBuilder 的集成(第九章:1316-1553):每轮对话前,Agent 用 search / list 检索相关笔记 → 转成 ContextPacket(type=note)→ 作为 custom_packets 注入构建流程。这正是"长时程上下文"的关键机制:笔记是跨会话的上下文来源,对话历史不是。对话历史只覆盖当前会话最近几轮;而笔记活在文件系统里,下一次会话、下一个进程都能读到。
5.2 TerminalTool:按需探索文件系统(第九章:1585-1952)
为什么需要它
很多场景需要即时访问文件系统——看日志、查代码结构、读配置文件。传统做法是"预先索引所有文件再向量化",成本高且索引会过时(第九章:1602-1608);TerminalTool 选择"按需探索":find / grep / head 一条命令,实时拿到最新状态。这实现了第九章 9.2.2 提出的"即时(Just-in-time, JIT)上下文"理念——智能体不需要预先加载所有文件,而是按需检索(第九章:1589)。
四层安全机制(第九章:1643-1729)——"允许执行命令"是强大且危险的能力,TerminalTool 的防护层层递进:
- 命令白名单:只允许
ls / cat / head / grep / find / wc / awk / sed等只读命令,rm等破坏性命令直接被拒(第九章:1652-1676); - 工作目录沙箱:只能访问初始化时指定的 workspace 及其子目录,
cat /etc/passwd、cd ../../..逃逸都会被拦(第九章:1678-1696); - 超时控制:默认 30 秒执行上限,防止死循环与资源耗尽(第九章:1698-1711);
- 输出大小限制:默认 10MB,超限截断并标注(第九章:1713-1727)。
典型使用模式(第九章:1843-1952)全部是"把证据按需拉进上下文"的形态:探索式导航(ls -la → cd src → grep)、数据文件分析(head -n 5 sales.csv → wc -l → cut/sort/uniq 统计)、日志分析(tail | grep ERROR → 错误类型分布)、代码库分析(grep -rn 'TODO' → sed 看函数实现)。
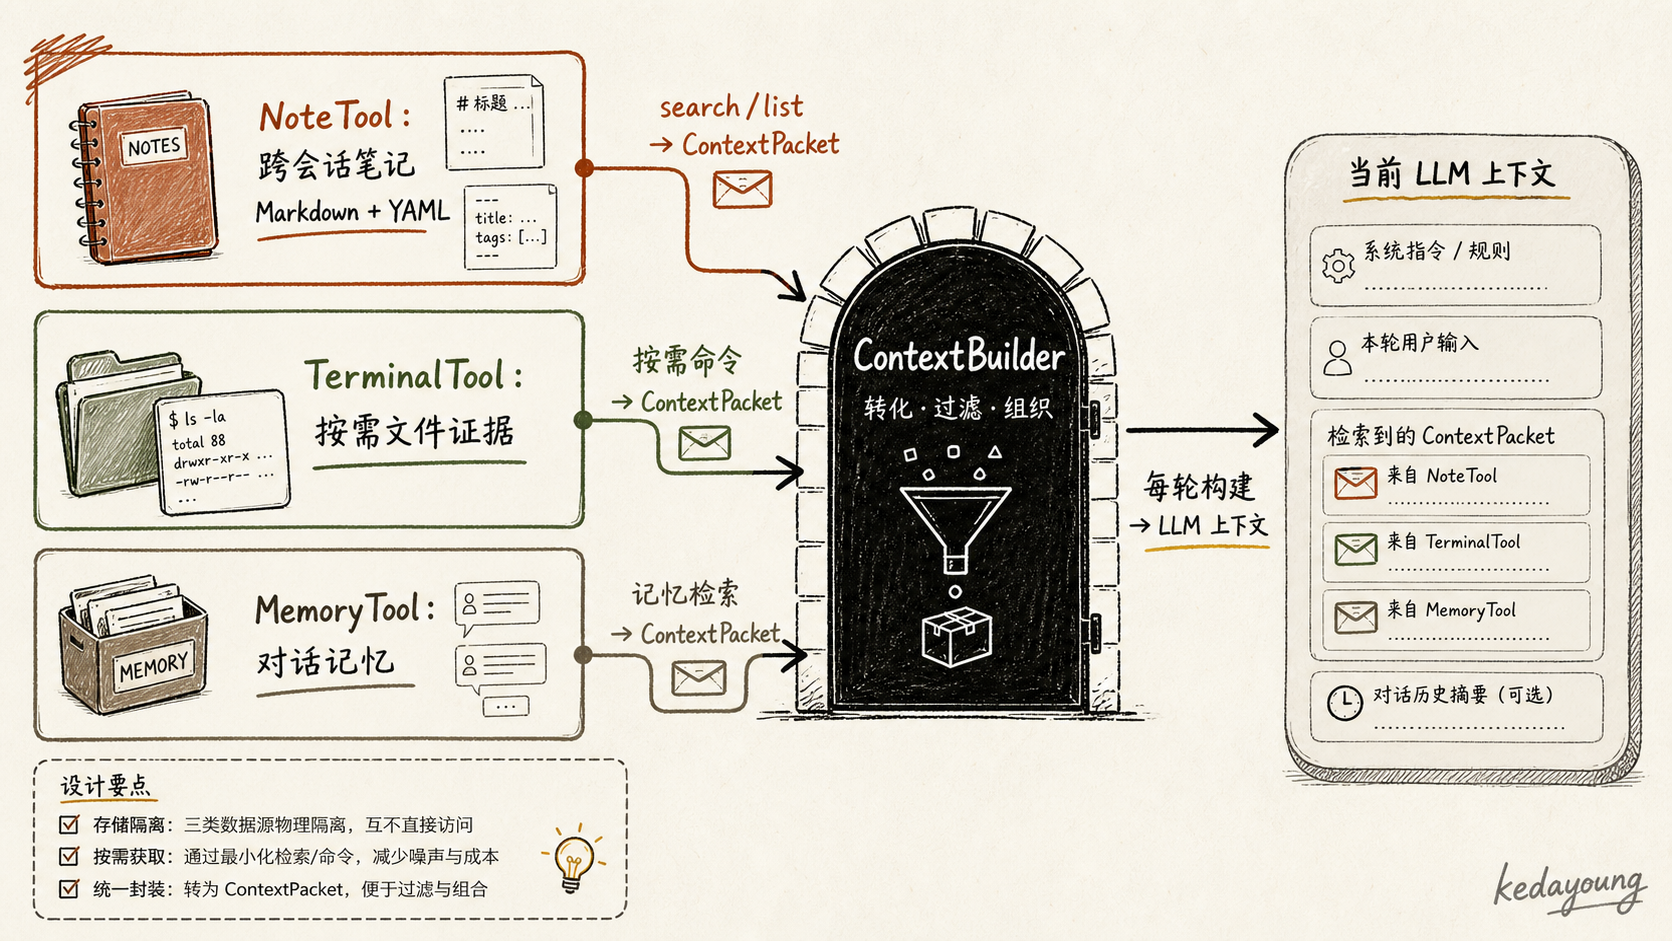
图 3|三个工具在「信息进出上下文」中的角色:工具是入口控制,存储与模型隔离;NoteTool 喂跨会话状态,TerminalTool 喂即时证据,MemoryTool 喂对话记忆。
6. 长程落地:CodebaseMaintainer 把四件套装进一个 Agent
前面是零件,第 6 节看整机。code/chapter9/codebase_maintainer.py 实现了一个代码库维护助手,把 ContextBuilder + NoteTool + TerminalTool + MemoryTool 整合进一个长程智能体。
6.1 组装(codebase_maintainer.py:37-101)
__init__ 里四个组件的配置本身就是一次"教学式参数选择":
- MemoryTool:
user_id=项目名,且只启用working记忆类型(:51-54); - NoteTool:
workspace=./<项目名>_notes(:55); - TerminalTool:
workspace=代码库路径, timeout=60(:56); - ContextBuilder:
max_tokens=4000, reserve_ratio=0.15, min_relevance=0.2,rag_tool=None(:59-68)——比第 3 节默认值更紧的预算、更低的过滤阈值,因为真实 Agent 场景信息量更大。
随后把三个工具注册进 ToolRegistry(:71-74),交给 FunctionCallAgent(max_tool_iterations=30,:77-84)。注意:这里 Agent 持有的是工具集合 + 系统提示,上下文构建器在 Agent 外部、由 run() 每轮驱动。
6.2 run() 的五步数据流(codebase_maintainer.py:103-151)
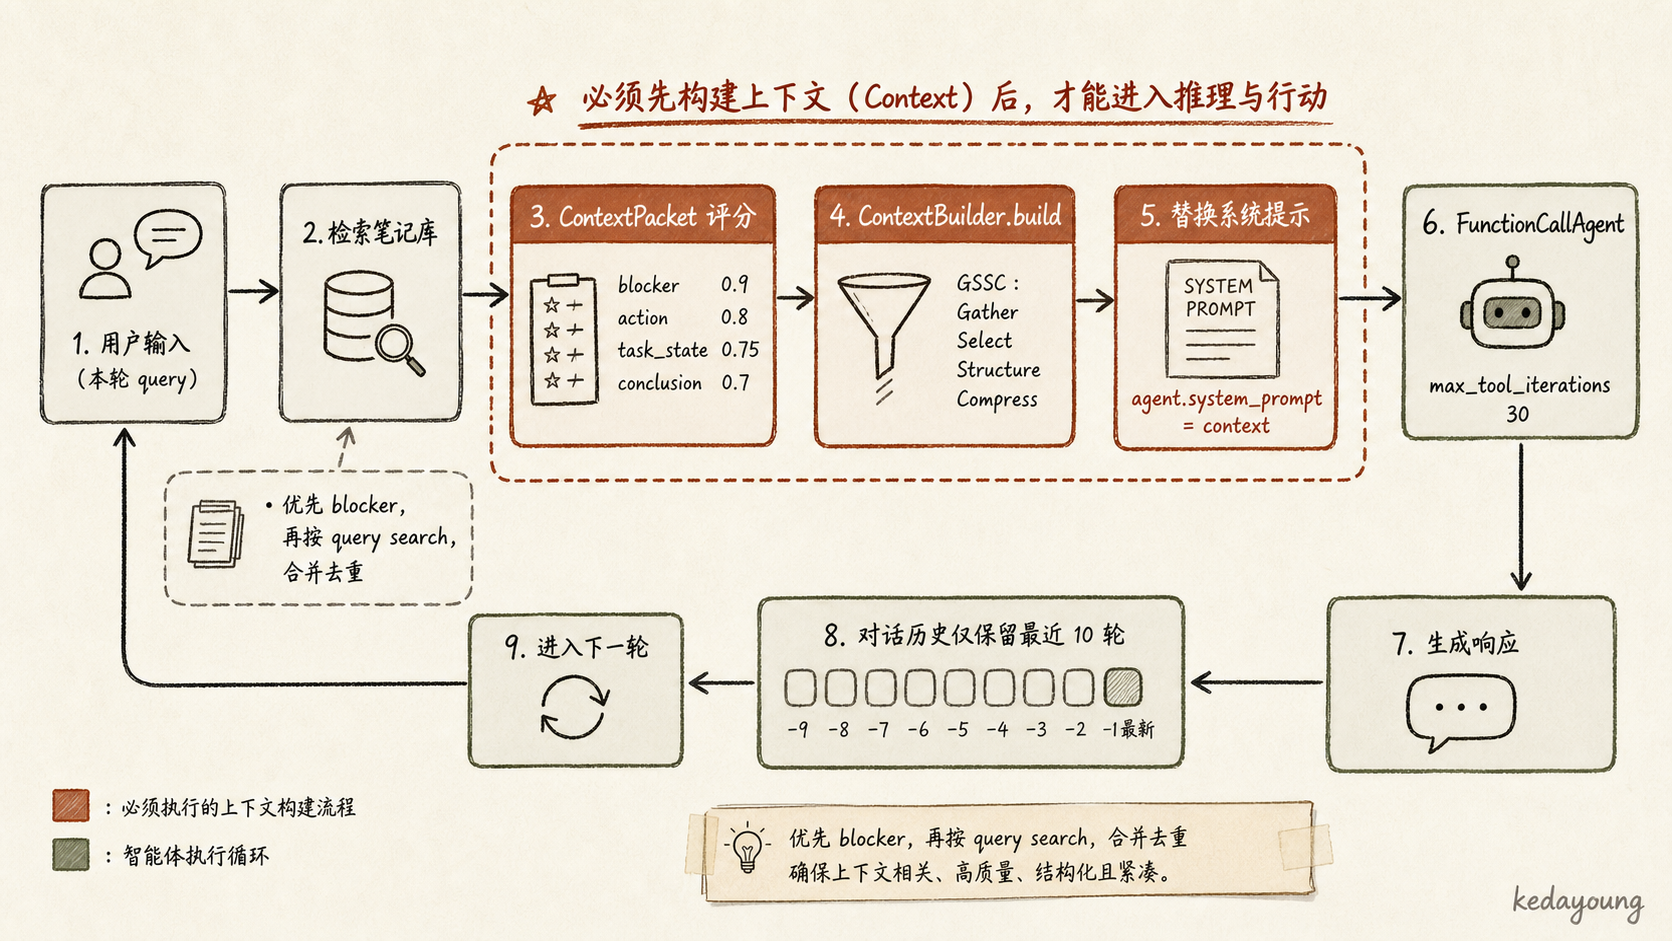
图 4|CodebaseMaintainer run() 数据流:上下文构建发生在「用户输入之后、Agent 推理之前」,是每轮循环的必经环节。
- 检索相关笔记:优先
listblocker 类型,再按查询search,合并去重(:193-227)——与 5.1 节的集成模式一致; - 笔记转 ContextPacket:按类型赋分
blocker 0.9 / action 0.8 / task_state 0.75 / conclusion 0.7,relevance_map在 :262-270; - 构建上下文:
context_builder.build(user_query, conversation_history, system_instructions, additional_packets)(:126-131); - 注入系统提示:
self.agent.system_prompt = context(:137)——这是这版代码最值得注意的设计:上下文不是追加进 user 消息,而是整体替换系统提示。也就是说,每轮对话前,Agent 看到的"我是谁、我有什么任务、有哪些证据"全部由 GSSC 流水线现场拼装; - Agent 自主调用工具 → 统计 → 更新对话历史(只保留最近 10 轮,:335-346)。
6.3 Agentic 模式:不预定义工作流
文件头注释明确写着"关键改进:使用 Agentic 方式,让 agent 自主决定使用哪些工具"(:10)。对比第九章正文里稍早的版本(第九章:2174-2237 的 _preprocess_by_mode,按 explore/analyze/plan 模式预执行固定命令),codebase_maintainer.py 的 mode 参数(explore/analyze/plan/auto)只作为系统提示里的方向性建议(:293-332),具体用什么命令、查什么文件,完全由 Agent 自行决策。这是从"预定义工作流"到"行为由上下文引导"的明确演进,也更贴合 Agent 的本意。
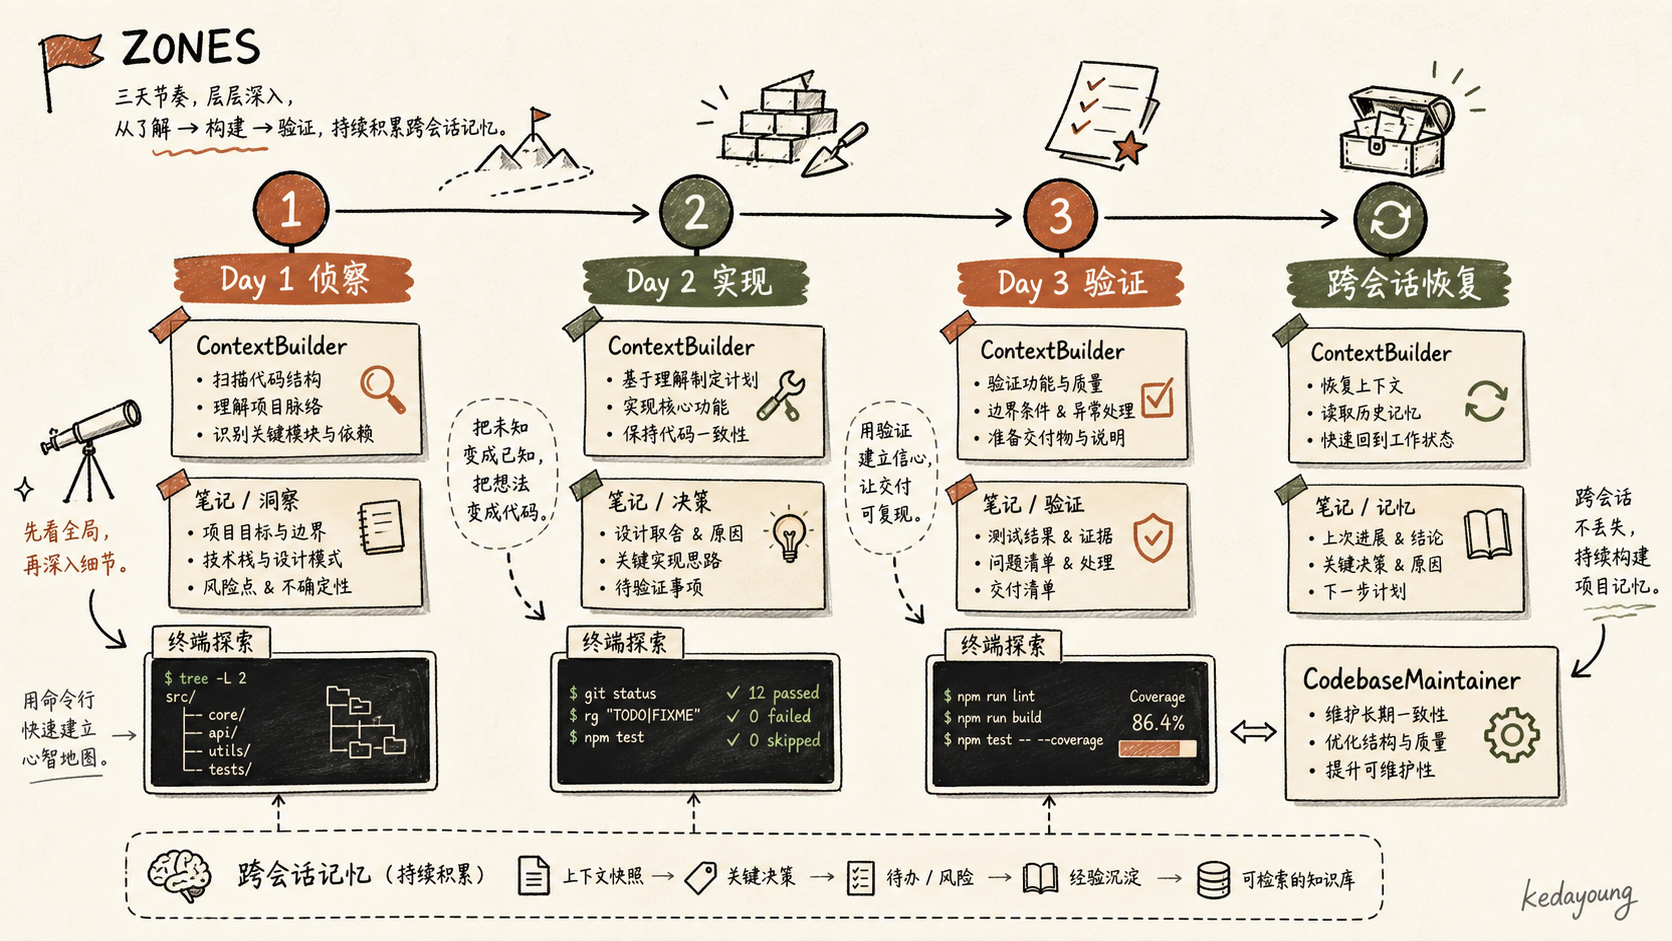
6.4 三天工作流与跨会话(06_three_day_workflow.py)
06 脚本把维护助手放进一个时间跨度场景:第一天探索代码库结构、第二天分析代码质量、第三天规划重构任务、一周后检查进度(:39-148)。跨会话连续性由 demonstrate_cross_session_continuity() 演示(:151-201):创建两个 CodebaseMaintainer 实例模拟两次会话,第一次会话写入 blocker 笔记,第二次会话(新的 session_id)通过笔记检索恢复上下文——会话间不靠长对话,而靠笔记库 + 记忆检索。
一个必须说清的观察点:这里的"跨会话"是同一进程内多次调用(maintainer 实例常驻),不是真正重启进程后的恢复。真正的跨进程恢复——把会话树持久化为文件(如 pi 的 session-manager 用 JSONL 记录完整会话结构)——是第 7 节的对照点。教学代码演示了"机制"(笔记承载状态),生产代码才解决"可靠性"(进程崩溃、断电后如何精确恢复)。
7. 设计权衡、局限与可迁移经验
回到开头的判断:这套实践的教学价值建立在"每一处简化都看得见、说得清"之上。下面把简化清单、可迁移原则与生产对照放在一起,作为全文的收束。
7.1 简化清单与生产差距
| 教学实现(hello-agents) | 生产差距(对照 pi) |
|---|---|
| Jaccard 关键词相关性(第九章:384-407) | 语义检索:向量 / embedding 相似度 |
| 字符比例 token 估算(第九章:546-577) | 精确 tokenizer,或直接用 provider usage 实报(compaction.ts:146-230 用 totalTokens 优先、缺省才估算) |
| 截断式压缩(第九章:519-544) | 结构化摘要:LLM 生成 checkpoint 摘要供续写(compaction.ts:467-498) |
同进程"跨会话"(06 演示) | 持久化会话 + 恢复:session-manager 用 JSONL 记录会话树 |
| 检索阈值 / 历史条数硬编码(第九章:262-263 等) | 可配置化,随任务动态调整 |
对照 pi 的意义不是评判谁更好,而是展示同一问题的两端:hello-agents 回答"从零理解上下文管理需要哪些零件",pi 回答"在真实产品约束(预算、切点、恢复)下同一问题如何被再次工程化"。前者给你全貌和可读性,后者给你精度和健壮性。
7.2 值得迁移的原则(作者判断,非实验结论)
以下五条是这套实践里可以照搬到自己 Agent 的"模式":
- 流水线化与统一入口:把"获取-选择-结构化-压缩"抽象成一条可复用流水线,而不是在每个 Agent 里手写上下文拼装;
- 固定分区模板:可调试性的收益是真实的——分区让"模型答错了"变成"哪个分区喂错了";
- 预算预留:
reserve_ratio的思想——给系统指令/角色信息留出固定份额,防止高价值指令被普通信息挤占; - 类型化笔记并映射到相关性分数:用"结构化持久信息"(笔记)替代"长对话"承载跨会话上下文,且让信息类型直接参与相关性排序;
- 按需探索替代预先索引:TerminalTool 的 JIT 理念,比"预索引整个仓库"更省、更新鲜。
7.3 不该照搬的实现
对应地,以下实现直接搬进生产会出问题:Jaccard 相关性(中文场景基本失效)、启发式 token 估算(误差会放大到压缩与预算决策上)、截断式压缩(信息损失不可恢复,应换结构化摘要)、同进程会话(崩溃即丢)。
把 7.2 与 7.3 并排看,结论很清楚:模式保留、实现替换。流水线、分区、预算预留、类型化笔记、按需探索——这些是设计思想,与语言和规模无关;Jaccard、字符比例、截断、进程内状态——这些是教学为了"30 分钟跑通"付出的代价,生产里各有更成熟的替代。
中心论点的收束
教学优先不是缺陷,而是设计取舍。它让整套机制在半小时内跑通"上下文管理"的完整闭环,看到每个零件如何咬合;要做的不是原样照搬,而是识别哪些原则可迁移、哪些实现需替换。这也是理解后续 pi 篇(生产实现如何回答同一问题)的正确姿势:20260810-pi/outline.md 是这一系列的下一篇。
附录 A:证据清单
| 断言 | 证据位置 |
|---|---|
| 四设计目标、六分区模板 | docs/chapter9/第九章 上下文工程.md:129-145 |
| ContextPacket / ContextConfig | 第九章:153-181 / :187-213 |
| Gather 五来源与容错 | 第九章:225-310 |
| Select 评分与贪心 | 第九章:316-382;评分函数 :384-428 |
| Structure 分桶与五分区 | 第九章:441-489 |
| Compress 分区截断与 token 估算 | 第九章:501-577 |
| NoteTool 类型、存储、集成 | 第九章:788-1583(重点 :831-857、:1316-1553) |
| TerminalTool 安全机制 | 第九章:1591-1730(白名单 :1674、超时 :1708、截断 :1723) |
| CodebaseMaintainer 组装与 run() | code/chapter9/codebase_maintainer.py:37-101、:103-151 |
| 笔记→包的类型分数映射 | code/chapter9/codebase_maintainer.py:254-291 |
| 历史限 10 轮 | code/chapter9/codebase_maintainer.py:335-346 |
| 三天工作流与跨会话演示 | code/chapter9/06_three_day_workflow.py |
| pi 对照点(预算常量/摘要/usage 估算) | 20260803-pi-java-workflow/tmp/pi/packages/coding-agent/src/core/compaction/compaction.ts:126-136、:146-230、:467-498 |
附录 B:素材缺口与待办
- [ ] 克隆
github.com/jjyaoao/helloagents(或pip install hello-agents),核对hello_agents/context/builder.py与第九章内嵌代码的差异——若差异大,正文需说明「教程代码」与「框架代码」的区别(本文一律以第九章内嵌代码为准)。 - [ ] 核对
06_three_day_workflow.py中示例代码库路径(当前为作者本机绝对路径),成文发布前改写为占位符。 - [ ] 验证
_count_tokens、_calculate_relevance在中文场景下的实际表现;若发布时举运行示例,需真实运行并记录输出(第 4.5 节评分示例表为演示构造数值,发布前可替换为真实输出)。