版本口径:本文以本地克隆
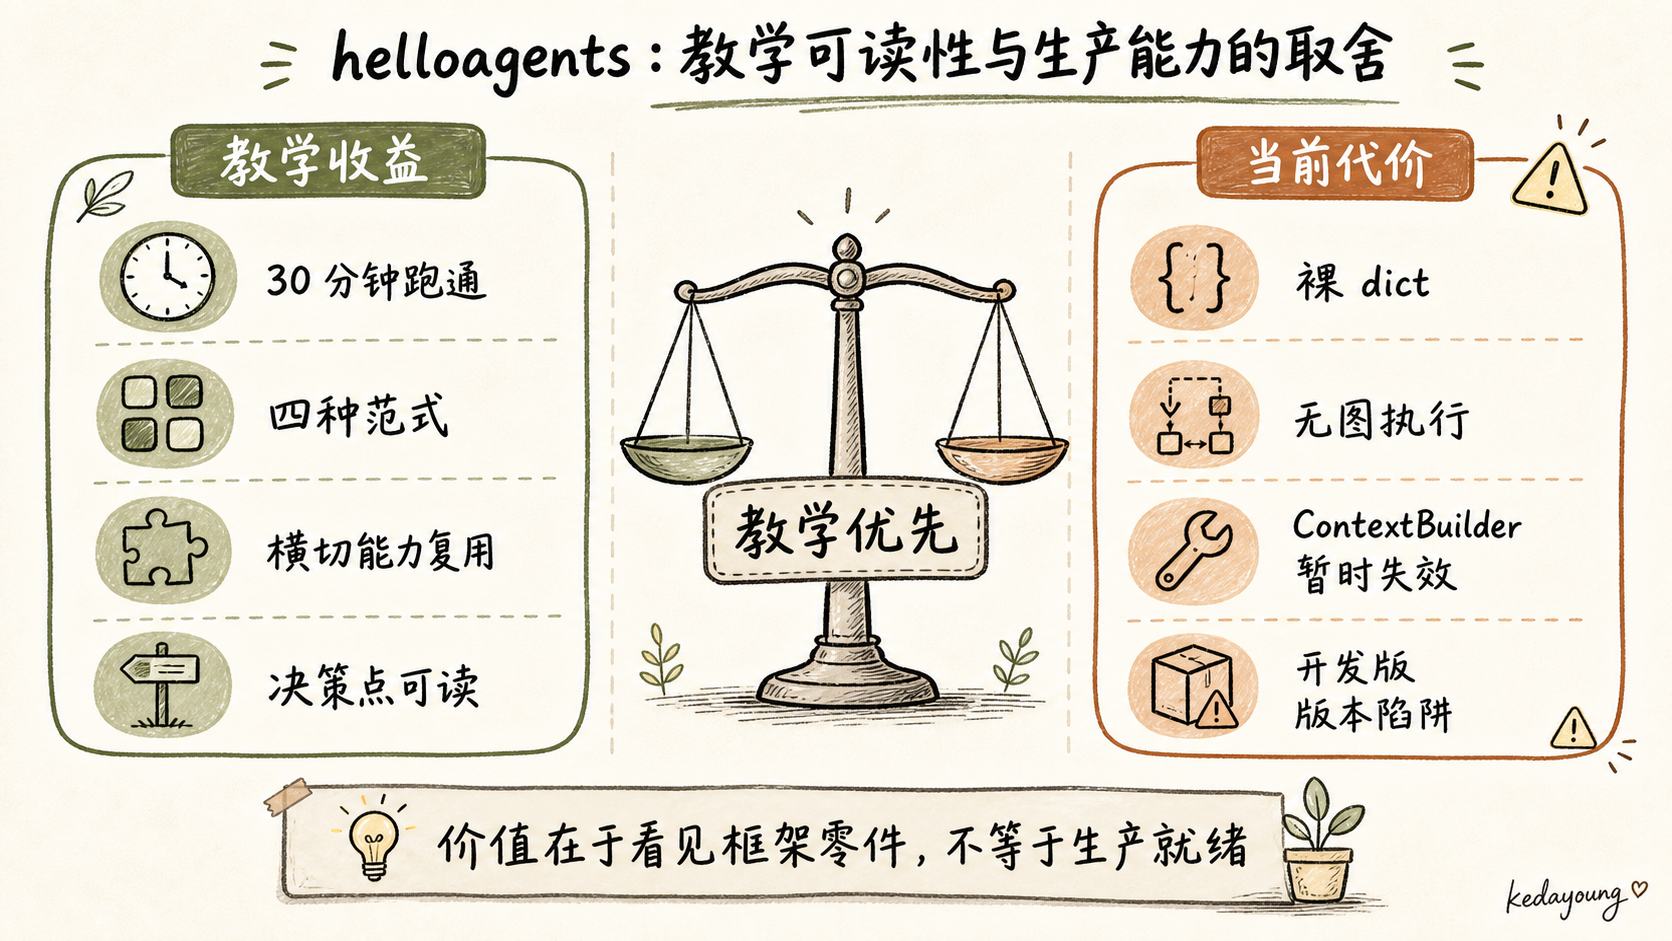
0-agent-framework/20260810-helloagents-framework/(jjyaoao/helloagents)当前开发版 V1.0.0(README.md:12-17,即main分支)为唯一事实来源;与 Datawhale《从零开始构建智能体》教程逐章对应的稳定版在learn_version分支,本地未克隆该分支,本文不涉及。所有file:line均以本地文件为准,路径前缀省略0-agent-framework/20260810-helloagents-framework/。 中心论点:helloagents 是「教学优先」的框架设计——把工具调用三件套提取进 Agent 基类、把「思考/结束」建模成工具、把横切能力一次性组装在__init__,换来的是新手 30 分钟跑通四种 Agent 范式;代价是消息流转用裸 dict、没有图执行模型、ContextBuilder 因 MemoryTool/RAGTool 移除而暂时失效。它的价值不在「生产可用」,而在把框架设计的关键决策点压缩到可读的代码里。
1. 从「自研框架」到代码:定位与包结构
本节要回答
为什么一本书要配套一个自研框架?它的包结构把「框架设计」拆成了哪几块?
helloagents 的 README.md:8 自称「生产级多智能体框架」,列了工具响应协议、上下文工程、会话持久化、子代理机制等 16 项核心能力——但它是 Datawhale《从零开始构建智能体》的配套自研框架。这个「自称生产级、实为教学框架」的张力,正是理解它的入口:教学需要读者看到「一个 Agent 框架最少的零件是什么」,而 langgraph / openai-agents 等生产框架把大量能力藏在图引擎、checkpointer、消息总线等抽象后面,读者只能当黑盒用。helloagents 的目标是把这些零件摊开、把决策点压缩进可读的代码里。
跨供应商、面向「从零构建」
框架基于 OpenAI 原生 API(hello_agents/__init__.py:18 导出 HelloAgentsLLM),但接入层 llm_adapters.py 有完整的供应商适配体系:BaseLLMAdapter(:13)之下是 OpenAIAdapter(:84)、AnthropicAdapter(:329)、GeminiAdapter(:580),create_adapter(:860)按 base_url 分发——anthropic.com 走 Anthropic、googleapis.com 或 generativelanguage 走 Gemini、其他走 OpenAI 默认(:874-884)。这说明它不是「为某一款模型定制」,而是教学用、可替换供应商接入的形态。
顶层导出即框架的「公共面」
hello_agents/__init__.py:17-31 统一导出核心组件:LLM、Config、Message、四种 Agent、ToolRegistry/global_registry、CalculatorTool。用户 from hello_agents import ReActAgent 就能开始,不需要知道内部包结构——这是教学框架应有的上手体验。
包结构按「教学主题」切,不是按「运行时职责」切
本地 hello_agents/ 下实际有 6 个子包:
| 子包 | 关键内容 | 承接的教学主题 |
|---|---|---|
core/ | Agent 基类、llm、llm_adapters、message、session_store、lifecycle | LLM 接入、Agent 循环底座 |
agents/ | SimpleAgent / ReActAgent / ReflectionAgent / PlanSolveAgent + factory.py | Agent 四种范式 |
context/ | HistoryManager、TokenCounter、ObservationTruncator、builder | 上下文工程章 |
tools/ | registry、base、response、circuit_breaker、builtin/ | 工具系统章 |
observability/ | trace_logger | 可观测性 |
skills/ | loader | 知识外化 |
(大纲原写「7 个子包」,本地实际为 6 个,本文以本地为准。)其中 context/ 与教程的上下文工程章、agents/ 与范式章一一对应——框架结构本身就是教学设计:学完哪一章,就能在代码里找到对应的包。
与生产框架的第一个对照点:切包哲学不同
langgraph 把包拆成「图构建 / 执行引擎 / 持久化」三层(graph/、pregel/、channels/ 等按运行时职责切,见《LangGraph 的框架实践》篇);helloagents 按功能域切包。前者是「运行时怎么运转」的视角,后者是「教材讲到哪」的视角。这个差异贯穿全文:helloagents 的一切组织都服务于「可读、可讲」。
图 1|helloagents 包结构 → 教学主题映射图
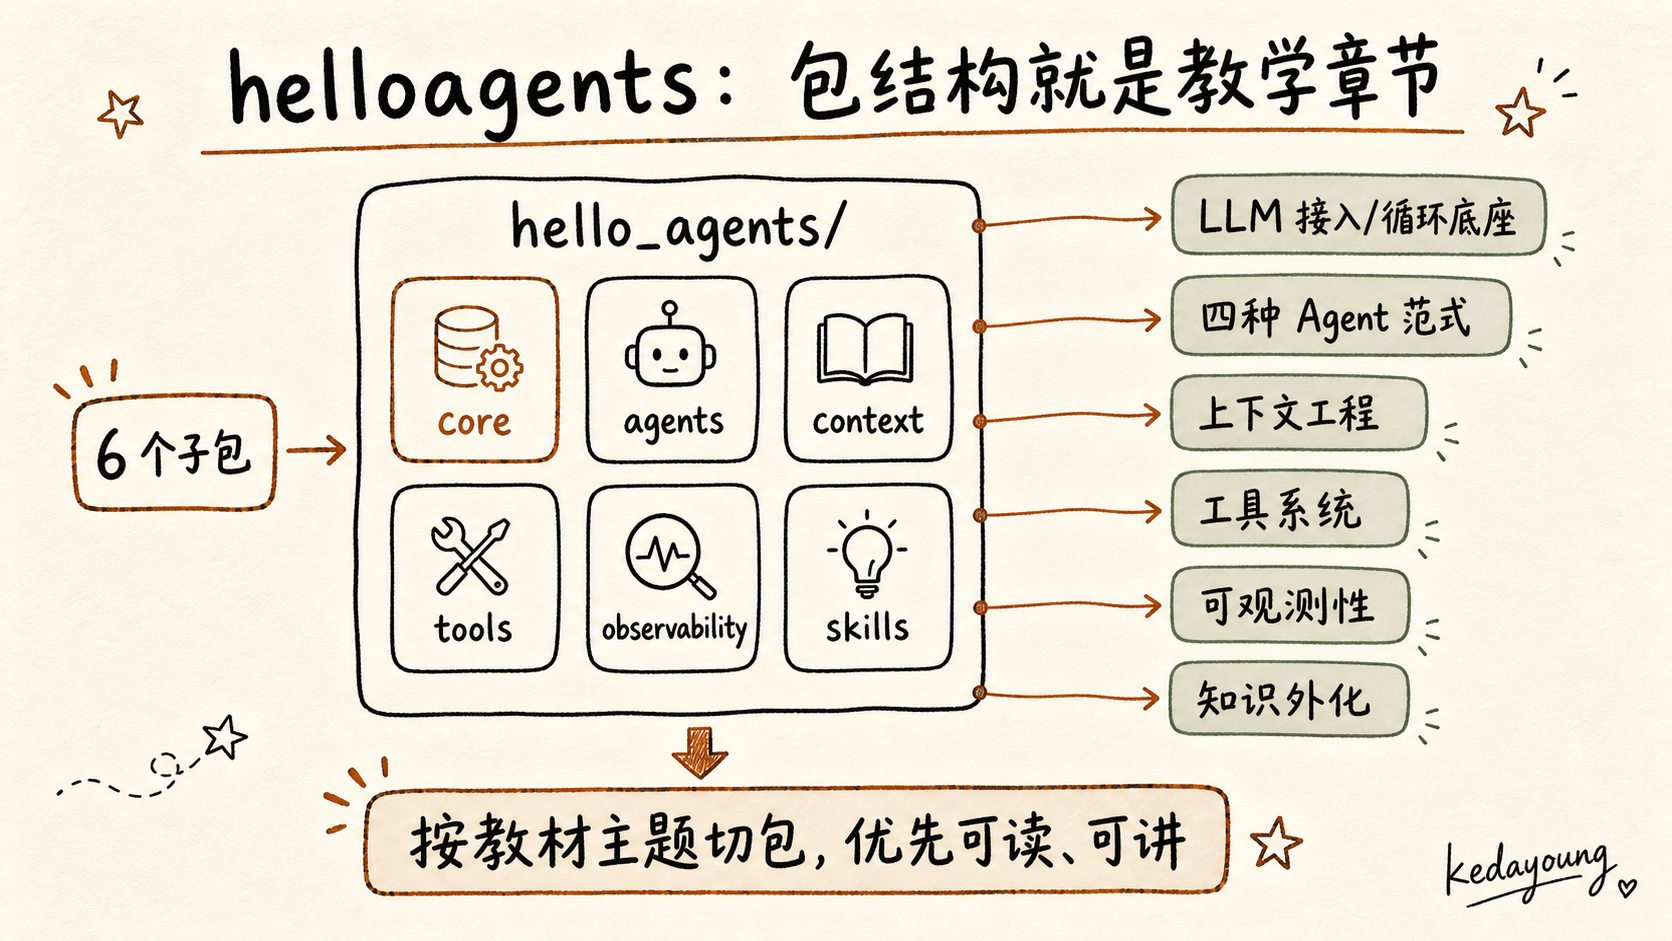
视觉要点:包边界 = 章节边界,与
0-context-engineering篇图 1 的视觉语言一致。
2. Agent 基类:横切能力的一次性组装
本节要回答
新增一个 Agent 需要重复什么、继承什么?「横切关注点收敛进 __init__」这个设计解决了什么问题?
答案是:新增 Agent 只需要继承 Agent + 实现一个 run,其余全部零成本复用。这个「零成本」来自基类 __init__ 的一次性组装。
Agent(core/agent.py:17)的 __init__(:32-131)按配置依次挂载:
- HistoryManager(
:49-55):历史管理,从 config 读取min_retain_rounds/compression_threshold; - ObservationTruncator(
:57-62):工具输出截断,读tool_output_max_lines/tool_output_max_bytes/tool_output_dir; - TokenCounter(
:65-67):tiktoken 计数,按self.llm.model选择编码器; - TraceLogger(
:70-87):trace_enabled时创建,并立即log_event("session_start", ...); - SkillLoader(
:90-102):skills_enabled时加载,skills_auto_register且给了tool_registry时自动注册 SkillTool; - SessionStore(
:105-110):session_enabled时会话持久化; - 子代理 / 进度 / 决策日志工具(
:122-131):subagent_enabled/todowrite_enabled/devlog_enabled时自动注册 TaskTool / TodoWriteTool / DevLogTool。
抽象方法 run 在 :146。也就是说,一个最小子类长这样:
class MyAgent(Agent):
    # __init__ 继承基类:需传 name、llm,横切组件在基类里自动组装
    def run(self, input_text: str, **kwargs) -> str:
        # 只用 self.llm、self.history_manager、self.tool_registry……
        ...
历史压缩、token 计数、工具输出截断、trace、会话持久化、子代理能力全部白拿。这是「教学优先」的第一个体现:把横切关注点收敛进基类,把差异压缩进子类的 run,读者对比四种范式时只需要读四个 run,不会被横切代码干扰。
工具调用三件套:公共底层,不是某一种 Agent 的特性
与 __init__ 组装的组件不同,三件套不是挂在实例上的状态,而是作为方法被子类循环调用——run 里先 _build_tool_schemas() 拿 schema,再对每次 tool_call 调用 _execute_tool_call()。core/agent.py:504-702 用一段注释标明「工具调用通用能力(从 FunctionCallAgent 提取)」(:504)——注意,当前开发版仓库中不存在 FunctionCallAgent 类,它的能力已并入基类(这是与旧教程叙述的关键差异,后文第 7 节还会回到版本陷阱)。三件套包括:
_build_tool_schemas(:506):把 Tool 对象(经get_parameters())与裸函数(经self.tool_registry._functions)统一转成 OpenAI Function Calling 的 JSON Schema;_convert_parameter_types(:594):LLM 返回的参数都是字符串,这里按工具定义的参数类型转回 int / float / bool;_execute_tool_call(:647):查注册表执行工具,并按ToolStatus给结果加前缀——ERROR→❌ 错误 [code]: ...、PARTIAL→⚠️ 部分成功: ...、SUCCESS→ 直接文本(:673-679)。
三件套放在基类而非各自范式里,这个观察点很关键:「工具调用」是框架的公共底层。这与 pi(packages/agent/ 的 agent loop)的架构直觉一致——工具调用独立于任何具体 Agent;但实现路径不同:helloagents 用继承把公共层下沉到基类,pi 用组合把 loop 作为独立组件(见《0-context-engineering》篇的 pi 分析)。
横切还不止同步路径
基类同时声明了异步生命周期方法 arun(core/agent.py:152),默认实现是在线程池里包装同步 run(:164 处 docstring「默认实现:在线程池中运行同步 run() 方法」)。这表明框架的异步能力是「先同步讲清楚、再异步包装」的教学策略——读者不需要为每种范式写两套循环;而 ReActAgent 更进一步实现了完整异步版 arun(react_agent.py:483 起),作为「异步写法长什么样」的示范。同样的逻辑也体现在 _history property(core/agent.py:134-143)对旧接口的向后兼容上:教学框架连「旧代码怎么迁」都预留了。
图 2|Agent 基类组装示意图
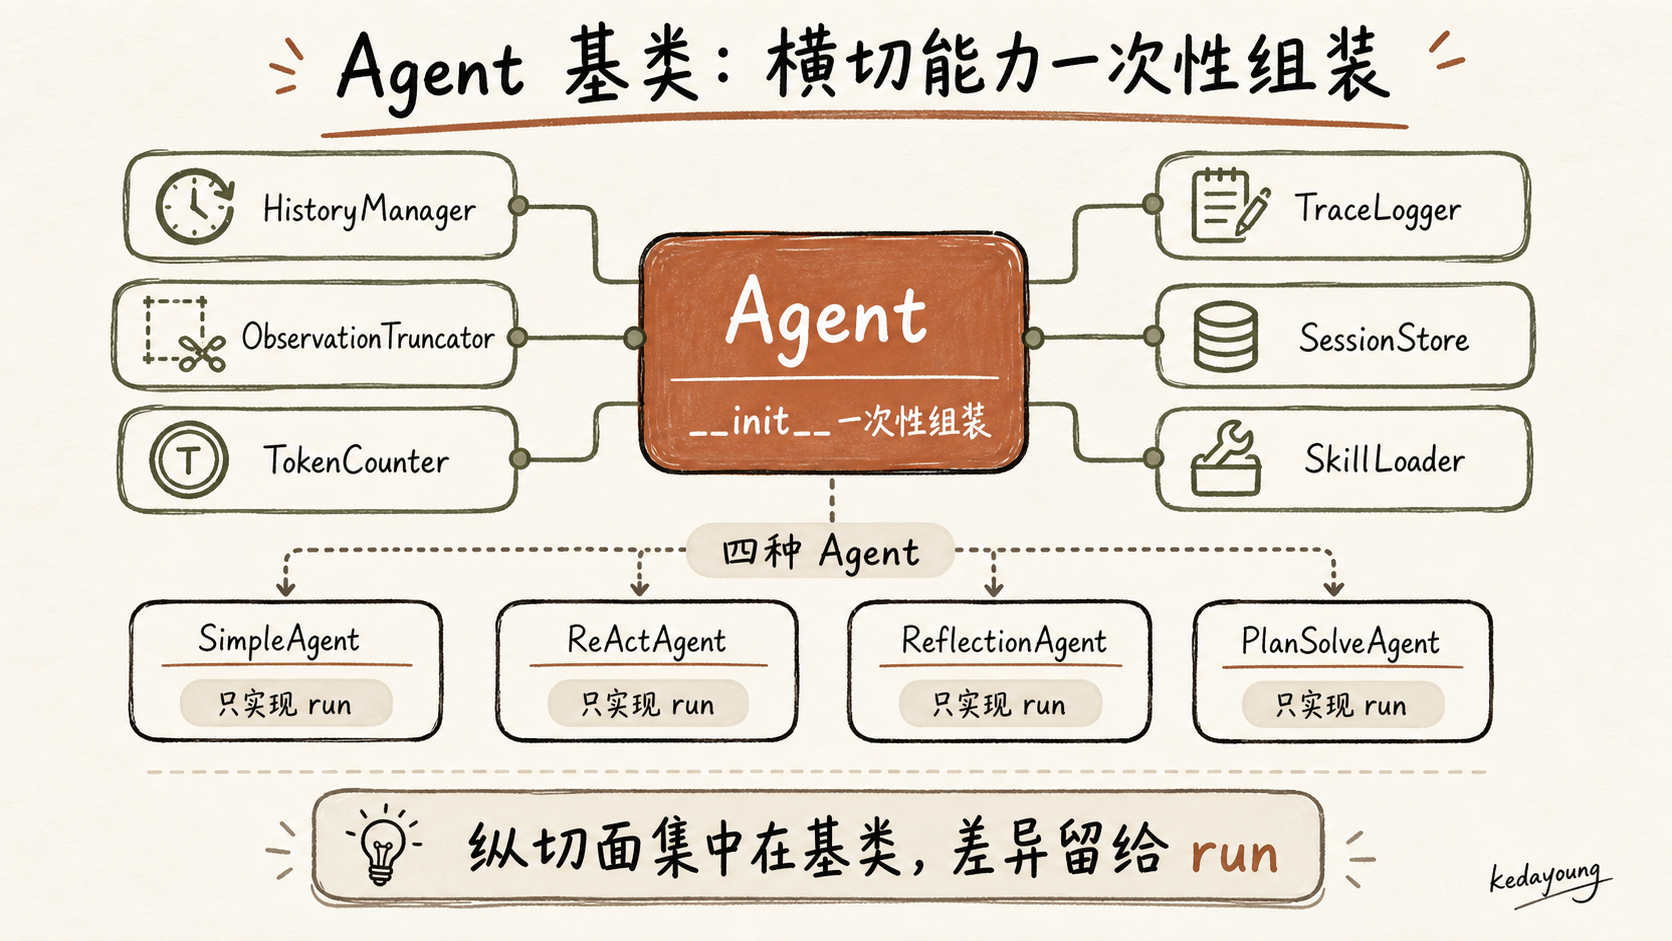
视觉要点:横切组件全部挂在基类,四个子类只有自己的循环逻辑。
3. 四种 Agent 范式与循环实现
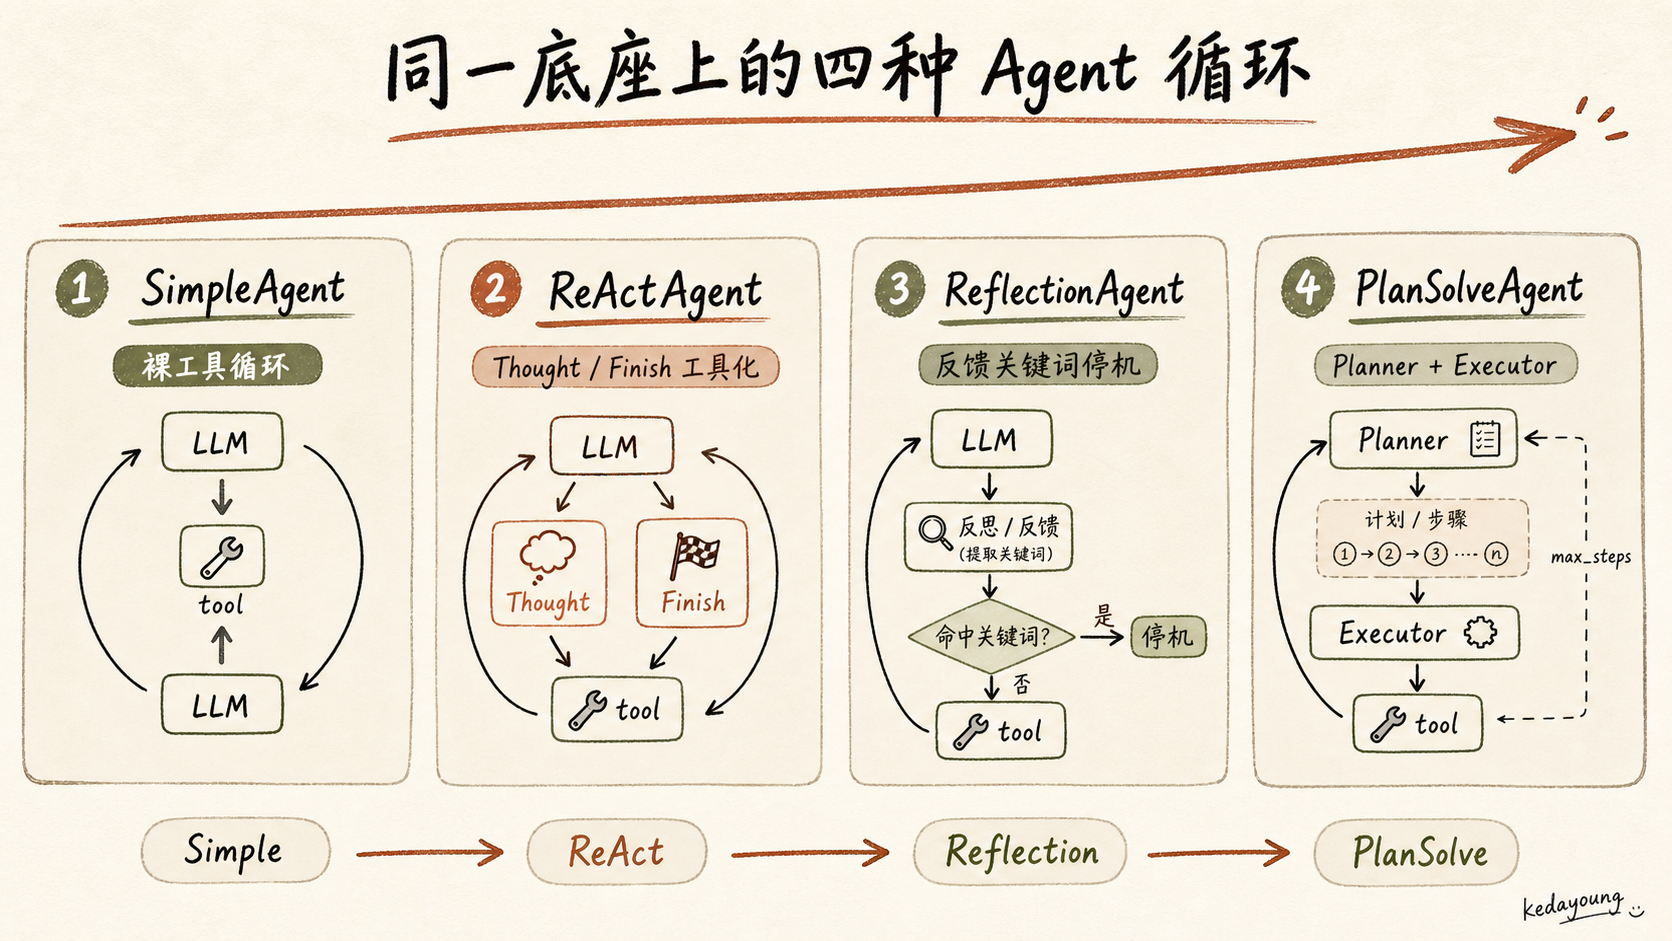
本节要回答
四种范式各自的循环怎么写?为什么把「思考」和「结束」建模成工具是 ReAct 实现的关键简化?
四种范式共享同一底座,差异全部在循环怎么写。逐一看:
SimpleAgent:最简 Function Calling 循环(agents/simple_agent.py:16,run :58)。逻辑是 while current_iteration < self.max_tool_iterations(:131-244):每次调用 llm.invoke_with_tools,有 tool_calls 就把 assistant 消息 + tool 结果消息追加进 messages 再循环,没有 tool_calls 就取文本返回(:174-177)。消息始终是 OpenAI 格式的 dict 列表(role / content / tool_calls / tool_call_id)。这是「四范式最小公共形态」:一个没有思考标记、没有结束工具的裸工具循环。
ReActAgent:核心教程 Agent,关键简化是 Thought / Finish 工具化(agents/react_agent.py:42)。_run_impl(:136)循环 while current_step < self.max_steps(:166-364)。与 SimpleAgent 的差别在两处:
- 内置工具:
self._builtin_tools = {"Thought", "Finish"}(:85),由_handle_builtin_tool(:460)处理。Thought把reasoning参数回填为「推理: ...」消息;Finish返回{"finished": True, "final_answer": ...},循环在:304检测到result.get("finished")后取final_answer终止并返回。 - docstring 直言「无需正则解析,解析成功率 99%+」(
:50)——传统 ReAct 用正则从「Action: xxx[yyy] / Observation: ...」文本里抠动作,脆弱且易失败;把 Thought / Finish 建模成 Function Calling 的工具,让模型用结构化 JSON 参数输出,解析问题被消解了。
我认为这是全文最值得迁移的一个设计:「思考」和「结束」不是 LLM 输出格式问题,而是控制流问题;把它们变成工具,就用上了 LLM 最擅长的结构化输出能力。代价是两种内置工具占用模型注意力,且「99%+」是代码注释里的自述,未在本文验证。
ReflectionAgent:执行 → 反思 → 优化迭代(agents/reflection_agent.py:46)。初始执行后进入 for i in range(self.max_iterations)(:130),每轮先反思、再判断是否停机——靠反馈文本里出现「无需改进」或 "no need for improvement"(:140)关键词结束迭代。这里没有内置工具,停机是字符串关键词匹配,与 ReAct 用 Finish 工具相比是更朴素的控制手段,这也是一种教学取舍:让读者看到「不建模成工具」的停机长什么样。代价(推断)是脆弱:模型措辞稍变就可能不触发停机,只能靠 max_iterations 耗尽兜底——与 ReAct 把「结束」建模成工具相比,这是控制手段的反面对照。
PlanSolveAgent:Planner + Executor 两段式(agents/plan_solve_agent.py:262)。__init__ 里分别构造 self.planner = Planner(...) 与 self.executor = Executor(...)(:311-318):Planner 把复杂问题分解成步骤(Function Calling 结构化输出),Executor 逐步执行并维护上下文。这是「先规划再执行」的经典范式;代价是两段之间没有显式的图连接——计划如何喂给执行器由消息流隐式传递(此为推断,本文未逐行核实 Executor 接收计划的具体路径)。
工厂选型
agents/factory.py:15 的 create_agent 按字符串 "react" / "reflection" / "plan" / "simple"(:26-30)返回对应实例,让「换范式」变成改一个字符串——教学演示里可以直接用。
四种范式的教学递进序列(推断,基于上述代码事实):Simple → ReAct → Reflection → PlanSolve 不是并列的四种写法,而是一条难度递增的线索——SimpleAgent 是没有思考标记的裸工具循环(simple_agent.py:131-244);ReActAgent 在循环里加进 Thought / Finish 两个内置工具,把「控制流标记」结构化(react_agent.py:85);ReflectionAgent 把循环的停止条件从「工具返回值」换成「文本关键词」(reflection_agent.py:140),展示另一条控制路径;PlanSolveAgent 则把单循环拆成两个对象的两段协作(plan_solve_agent.py:311-318)。顺着这条线读下来,读者看到的是同一个底座上的四次变体——这正是「基类收敛横切 + 子类只写循环」设计的教学回报。
观察点(对照)
helloagents 用 while + max_steps 硬编码多步控制流;langgraph 用显式图拓扑 + checkpoint 重放(见《LangGraph 的框架实践》篇)。两种「循环」的哲学差异是本篇与 langgraph 篇的对照主线:while 是「在代码里描述顺序」,图是「把状态流转声明成数据」。教学框架选前者,因为一个循环就是一章课的容量;生产框架选后者,因为不可控任务需要中断、重放、并行。
图 3|ReActAgent 循环流程
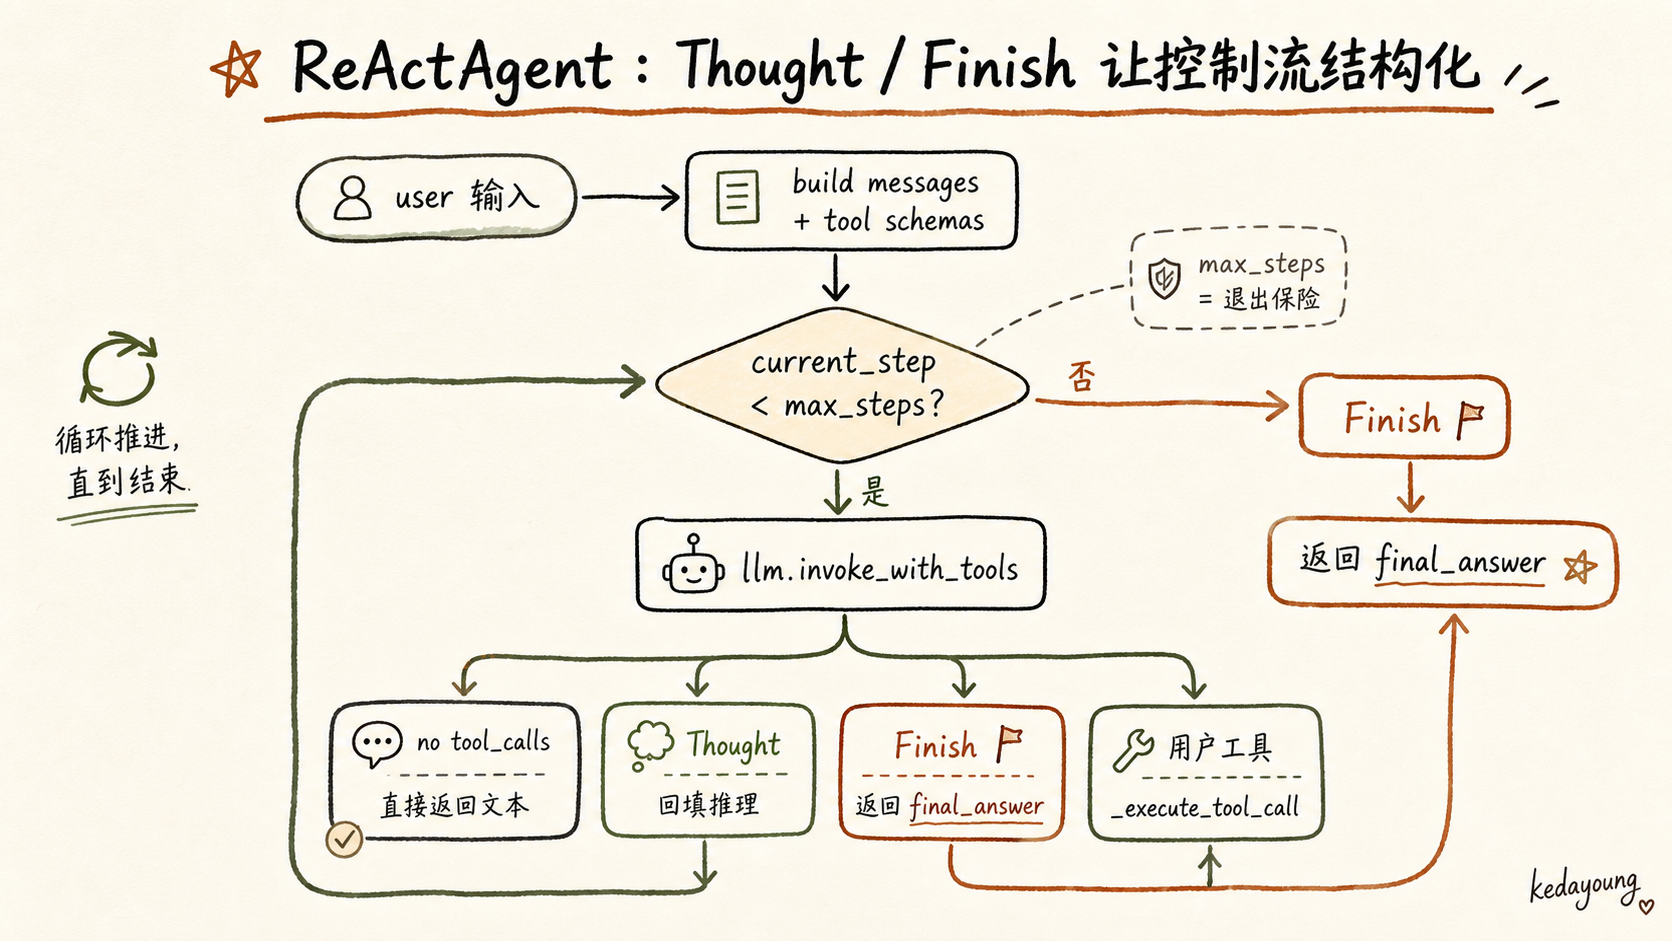
视觉要点:
max_steps是唯一退出保险;_handle_builtin_tool分支是 ReAct 与 Simple 的分水岭。与 langgraph 篇的 StateGraph 图形成对照。
4. 工具机制:双层注册、ToolResponse 协议与 @tool_action
本节要回答
工具怎么进系统、怎么被执行、失败怎么处理?为什么同时支持「Tool 对象」和「裸函数」两种注册?
工具进系统的入口是 ToolRegistry(tools/registry.py:10),模块级单例 global_registry 在 :291。它提供双层注册:
register_tool(:30):注册 Tool 对象,且支持expandable工具自动展开——若auto_expand且对象带expandable标记,就把get_expanded_tools()的子工具逐个注册成独立工具(:39-48);register_function(:57):直接注册裸函数,自动用函数名作工具名、用 docstring 第一行作描述(:89-101),兼容老式register_function(name, description, func)调用。
为什么两层?我认为是上手门槛的梯度设计:教学先让你 registry.register_function(my_func) 一行把工具挂上,理解「工具 = 一个函数」;进阶后再讲 Tool 对象协议(参数定义、状态返回、展开)。这个梯度背后有一个硬限制在支撑:_build_tool_schemas 对函数工具生成的是固定 schema——只有一个 input: string 入参(core/agent.py:566-574),意味着裸函数注册后只能接收单个字符串参数,没有参数定义、没有类型转换;要表达多参数、强类型工具,就必须走 Tool 对象。所以「双层注册」不是装饰性的便利,而是「够用的快捷方式 vs 完整协议」的能力分界。
执行入口
execute_tool(:132)统一做三件事:先查熔断器(:143-153,连续失败后短路禁用、返回 ToolResponse.error 并带恢复时间),再分发到 Tool 对象或函数,最后统一包装成 ToolResponse 并 record_result 回写熔断器(:218)。失败不抛异常,而是变成三态响应——这是给 LLM 看的错误,不是给进程看的错误。
ToolResponse 三态协议(tools/response.py:12):ToolStatus 枚举 SUCCESS / PARTIAL / ERROR(:12-16),ToolResponse dataclass(:20)承载 status / text / data / error_info / stats / context。工具执行统一走 run_with_timing(tools/base.py:101),自动加时间统计与参数上下文。三态让工具作者精确表达「完全成功 / 部分成功(截断、回退)/ 失败」,agent 循环据此给结果加 ✅/⚠️/❌ 前缀(见第 2 节)。
@tool_action 元编程(tools/base.py:15):装饰器给类方法打标记,父工具声明 expandable 后,AutoGeneratedTool(:294)从方法签名 + type hints + docstring 自动解析参数(_parse_parameters :339,含 inspect.signature、get_type_hints、docstring Args: 段正则解析),把 _add_memory 变成 parent_add_memory 这样的独立工具(:311-313)。这把「写一个工具」降维成「写一个带注释的方法」。
内置工具面(tools/builtin/__init__.py:15-20):CalculatorTool、Read/Write/Edit/MultiEditTool(文件工具带乐观锁,README.md:8 亦提及)、TodoWriteTool、DevLogTool、TaskTool(子代理)、SkillTool。观察点:熔断器 + 乐观锁 + 三态响应协议是「生产意识」的教学样例,但工具集整体偏「文件 + 进度 + 子代理」,缺少 pi / Claude Code 那类 Terminal、搜索等通用工具(对照见《0-context-engineering》篇的 pi 工具面分析)——面向教材场景够用,面向生产场景偏窄。
响应协议自带序列化
ToolResponse 提供 to_dict / from_dict / to_json / from_json(tools/response.py:52-89),工具结果可以原样落盘或跨进程传递。这与 Message.to_dict(core/message.py:25)是同一序列化思路:框架内部流转用轻量结构,需要持久化/传输时统一走显式转换——可惜这层能力只在「工具响应」和「消息」两个边界上各自实现,没有收敛成一个公共序列化层。
图 4|工具注册 → 执行 → 响应 链路图
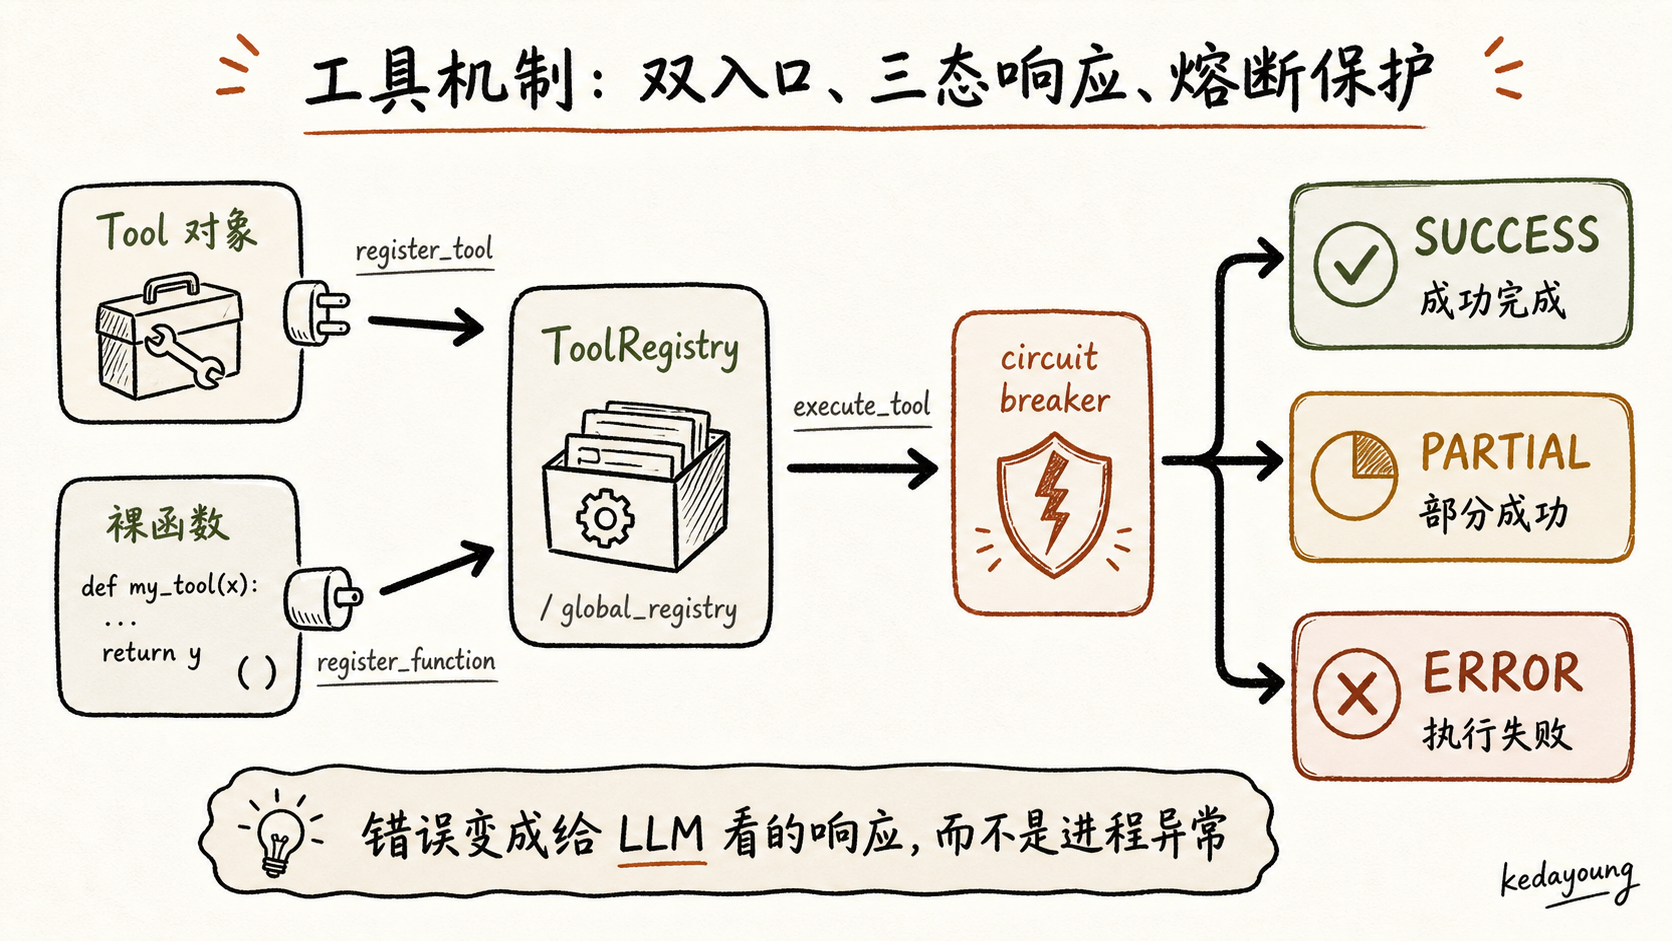
视觉要点:
@tool_action位于「工具定义 → 注册」之间,是元编程的插入点。
5. 上下文与消息:HistoryManager / TokenCounter / Truncator + Message 模型
本节要回答
实际生产就绪的上下文管理是「压缩」路线还是「检索」路线?消息对象与循环内 dict 的「双轨制」意味着什么?
先做事实核查,这点必须如实写:仓库里的 ContextBuilder(context/builder.py:52)实现了完整的 GSSC 四阶段——build 依次调用 _gather(:119,多源收集)、_select(:157,优先级/相关性/多样性筛选)、_structure(:214,结构化模板)、_compress(:269,预算内压缩)——但文件注释明言「MemoryTool 和 RAGTool 已被移除,此类暂时不可用」(:9、:55、:136)。也就是说,GSSC 流水线是「为记忆与检索而设计」的,依赖的两个数据源被移除后,_gather 只能收集系统指令、最近 10 条对话与外部包(:129-153),不能当作当前可用的记忆/检索能力。成文必须与旧教程划清边界:0-context-engineering 篇基于另一个仓库版本(旧版含 FunctionCallAgent / MemoryTool 的教程代码),两篇对 ContextBuilder 的叙述以各自仓库实际代码为准。
实际被 Agent 使用的上下文三件套(组装点在 core/agent.py:49-66):
- HistoryManager(
context/history.py:15):只追加不编辑(:60-66);find_round_boundaries(:101)按 user 消息定位轮次边界;compress(:113)在轮次超过min_retain_rounds时把旧历史替换为一条role="summary"的摘要消息、保留最近 N 轮完整对话(:136-144)。这是压缩路线:不检索,只摘要 + 裁剪。 - TokenCounter(
context/token_counter.py:15):tiktoken 编码(:49-66,模型名失败降级cl100k_base,再失败降级字符估算len(text) // 4:134-137),带内容级缓存(:92-104)与角色开销 +4 tokens(:100-101)。 - ObservationTruncator(
context/truncator.py:18):工具输出按行/字节截断(max_lines/max_bytes,:72-130),支持 head / tail / head_tail 三种方向(:141-150),并把完整输出落盘到output_dir(:152-182)。
文档声称与实现缺失的又一例
TokenCounter 的 docstring 宣称支持「增量计算」并给了 count_incremental(previous_count, new_messages) 调用示例(token_counter.py:35),但代码中并无该方法的定义——实际只实现了「带缓存的重复计算」,没有真正按新增消息增量累计。这与 ContextBuilder 的「已移除」是同一类偏差的两种形态:一个是组件被移除、文档没跟上;一个是方法被示例引用、实现没跟上。教学框架的文档-代码偏差不是偶发,而是常态。
三个组件合起来回答「生产就绪的上下文管理走哪条路」:走压缩路线,不走检索路线。对教学场景这是正确选择——压缩逻辑 200 行内能讲完,检索(RAG)则需要向量库、重排、MMR,是另一章的内容。
消息模型与「双轨制」
Message(core/message.py:9)是 pydantic BaseModel,字段 content / role / timestamp / metadata;MessageRole(:7)是 Literal["user", "assistant", "system", "tool", "summary"],其中 summary 角色专供历史压缩;to_dict(:25)转 OpenAI API 格式。但 Agent 循环内部并不用 Message 对象——SimpleAgent / ReActAgent 循环里手工拼裸 dict(OpenAI 格式,如 react_agent.py:240-255 拼 assistant 消息、:328-332、:359-363 拼 tool 消息),Message 对象只服务历史持久化(add_message(Message(...)) + session_store)。
这形成「双轨制」:循环用裸 dict,持久化用 Message。证据落在 session_store.py:110——会话保存时对历史逐条调 msg.to_dict(),而 to_dict(message.py:25)输出含 timestamp / metadata 的完整结构,比循环内的裸 dict 更适合落盘与恢复(from_dict :35 反向还原)。与 pi 的「双轨制」(transformContext / convertToLlm 显式转换层)形似,但 pi 有显式转换函数,helloagents 靠各处手工拼 dict(见《0-context-engineering》篇的 pi 分析)。我认为这是全框架最明显的「生产差距」:裸 dict 没有类型约束,字段拼错、漏加 tool_call_id 都只能在运行期暴露;双轨制本身没错,缺的是转换层(修复方向见第 7 节第 1 条)。
Token 估算的对照素材
子代理元数据里按「字符数 / 4」估算 token(core/agent.py:1055-1057),与 0-tokenization-context-budget 篇的 pi token 估算策略(字符级近似 + 上下文预算)形成对照——两者都说明:token 精确到个位数不是教学框架的目标,够用即可。
图 5|「GSSC(已失效) vs 实际三件套」对照图
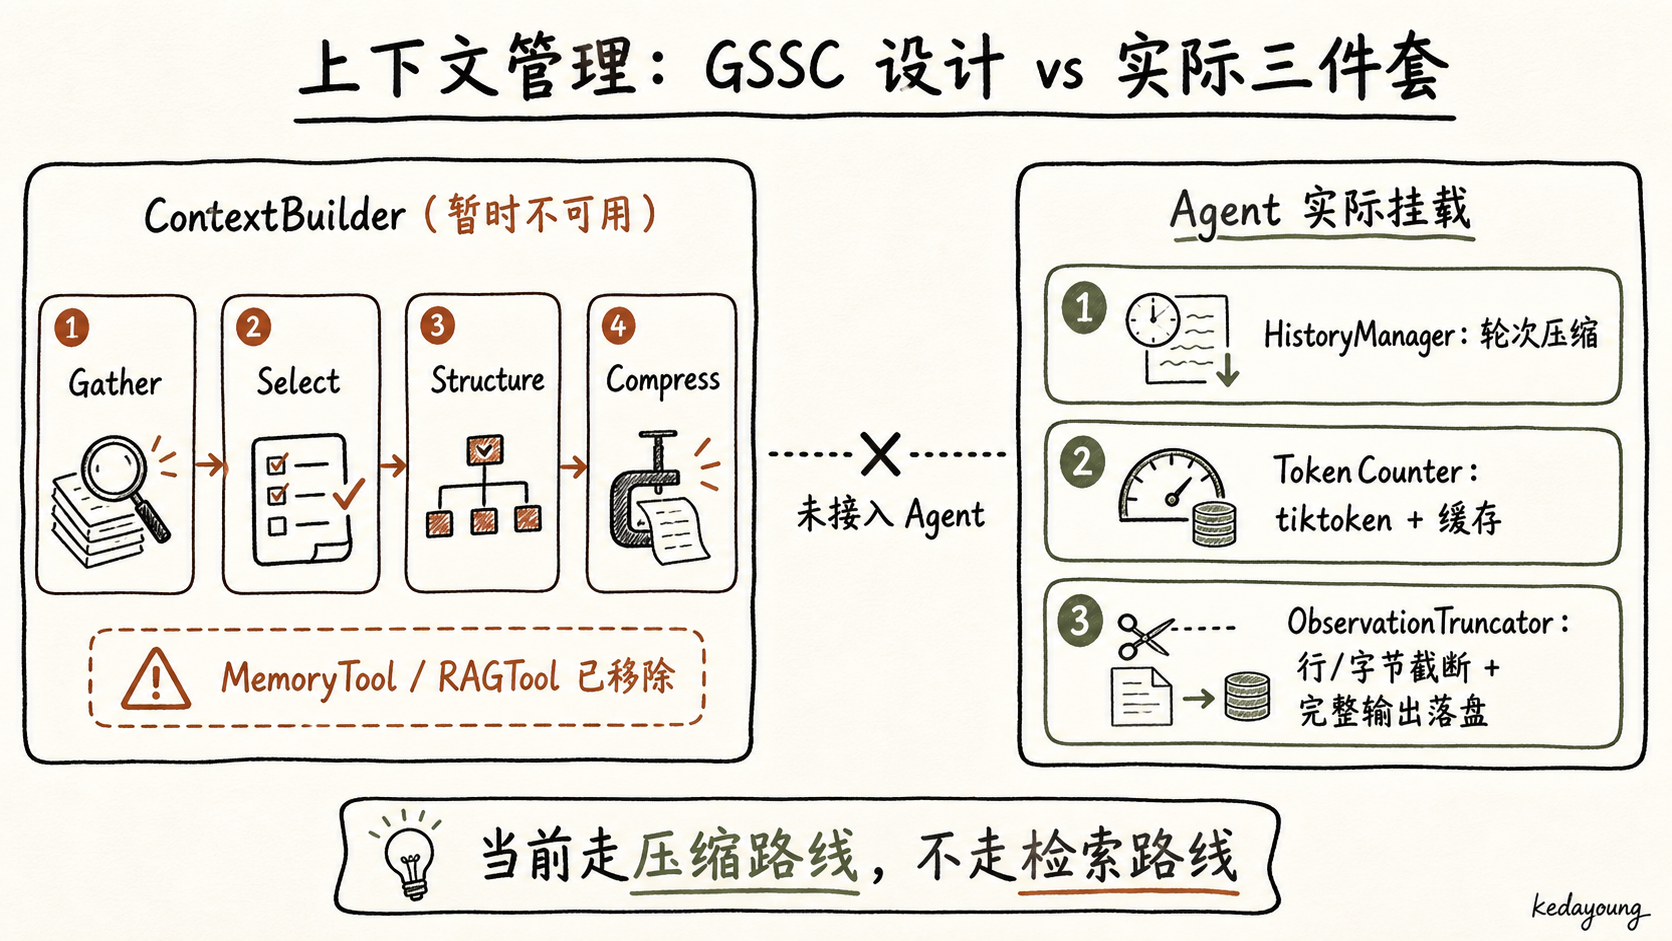
视觉要点:左列是「教学文档里的完整流水线」,右列是「代码里真正被
Agent.__init__挂载的组件」。教学文档与实际代码的偏差本身就是本文论点的一部分。
6. 与生产框架对照:四种「循环/状态/工具」哲学
本节要回答
同样的问题,langgraph / openai-agents / MetaGPT / llama_index 各自怎么答?helloagents 的哪些差异是「教学简化」,哪些是「不同设计取向」?
同一组问题,四个生产框架加上 helloagents,给出五种答案。本节只做可验证的架构取舍对照,不评判优劣(各框架细节见对应篇目)。
1. 控制流:谁在驱动多步循环?
- helloagents:
while + max_steps硬编码(react_agent.py:166)——顺序就是代码顺序。 - langgraph:图被编译成 channel 数据流,边变成状态读写(见《LangGraph 的框架实践》篇)。
- openai-agents:
NextStep四态状态机驱动单循环(见《OpenAI Agents 的框架实践》篇)。 - MetaGPT:Role 的
observe / think / act循环(见《MetaGPT 的框架实践》篇)。 - llama_index:事件驱动 Workflow,
BaseWorkflowAgent只需实现三个方法(见《LlamaIndex 的框架实践》篇)。
2. 状态管理:多步之间的中间状态放哪?
- helloagents:裸 dict 消息列表,状态 = 消息序列本身,无独立状态对象。
- langgraph:TypedDict 状态契约 + reducer + checkpoint 版本化(可重放、可恢复)。
- openai-agents:
RunState状态机(见其篇)。 - MetaGPT / llama_index:各自以消息/事件流为状态载体(见各自篇目)。
3. 工具系统:工具如何进入系统、失败如何表达?
- helloagents:ToolRegistry 双层注册 + ToolResponse 三态 + 熔断器(
tools/registry.py:30/:57/:132)。 - langgraph:ToolNode + InjectedState(工具可直接注入图状态,见其篇)。
- openai-agents:
@function_tool装饰器 + 「handoff 即工具」——多 agent 切换被收敛成一次工具调用(见其篇)。 - MetaGPT:Action 即工具(见其篇)。
4. 多 Agent:子任务如何委托?
- helloagents:TaskTool 子代理工具——在
__init__里按配置自动注册(core/agent.py:122-123、:1139),agent 通过调用 TaskTool 起一个子 agent。 - langgraph:子图 +
Send并行扇出(见其篇)。 - openai-agents:Handoff(见其篇)。
- MetaGPT:Environment 消息总线做发布/订阅路由(见其篇)。
判断(作者观点,需标注)
helloagents 的 while 循环不是「错误」,而是「把 Agent 的最简形态讲清楚」的刻意选择。一个 while + 一个函数调用就是 Agent 的最小完备定义;生产框架的图 / 状态机 / 消息总线是对「不可控长任务」的回应——需要中断恢复、并行扇出、人工介入时,线性循环才不够用。教学框架不必承担这个约束,所以它有资格把循环写成 while。同样地,helloagents 没有 checkpoint / 重放,也是同一逻辑的延伸:不是忘了做,而是教学阶段还轮不到讲。
由此可以得到一个判别「教学简化 vs 不同设计取向」的尺子:差异是否影响「最短可读实现」的成立。三件套进基类、Thought/Finish 工具化、双层注册,是任何实现都要做的决策,helloagents 选了最直白的一种,属于「教学简化」;而 while 循环本身、裸 dict 状态、无 checkpoint,属于「教学阶段不需要的约束」,一旦任务失控就必须换——它们不是简化,是范围选择。前者可迁移,后者要按场景替换,第 7 节据此收束。
图 6|五种框架「循环 / 状态 / 工具 / 多 agent」四维对照表 | 维度 | helloagents | langgraph | openai-agents | MetaGPT | llama_index | |---|---|---|---|---|---| | 控制流 |
while + max_steps(教学) | 图 → channel 数据流 | NextStep 四态状态机 | observe/think/act | 事件驱动 Workflow | | 状态 | 裸 dict 消息 | TypedDict + reducer + checkpoint | RunState + 会话 | 消息/角色状态 | 事件流/Workflow 状态 | | 工具 | Registry 双层注册 + 三态响应 | ToolNode + InjectedState | @function_tool + handoff | Action | Retriever/QueryEngine Tool | | 多 agent | TaskTool 子代理 | 子图 + Send | Handoff | Environment 消息总线 | (该篇未强调,Workflow 可组合) | | 定位 | 教学优先 | 生产图编排 | 官方轻量 API | 多角色 SOP | 检索型 Workflow | 与0-agent-framework/README.md的对照轴一致,可作为系列横向阅读的索引。
7. 可迁移经验与边界
本节要回答
从 helloagents 能带走哪些「框架设计」原则?什么场景不该用它的实现?
可迁移的原则(作者判断):
- 工具调用三件套提取为公共层:schema 构建 / 参数类型转换 / 执行回填(
core/agent.py:506/:594/:647)与具体范式解耦——无论什么循环,工具接入路径都一致。这条对任何框架都成立。 - 「思考/结束」建模成工具:用结构化 Function Calling 取代正则解析动作文本(
react_agent.py:85/:460),让控制流标记走 LLM 最稳的输出通道。这是低成本、高收益的设计。 - 横切关注点集中组装:历史 / token / 截断 / trace / 会话在基类
__init__一次挂载(core/agent.py:32-131),新增 Agent 零成本复用。教学框架因此能快速横向扩展范式。 - 双层工具注册:对象 + 裸函数(
tools/registry.py:30/:57)降低上手门槛,从「函数即工具」过渡到「对象协议」。
需替换 / 不迁移的实现(前文均已述,这里收拢为清单):
- 裸 dict 消息流转 → 领域对象 + 显式转换层:helloagents 循环内手工拼 dict(
react_agent.py:240-255),缺类型约束;对照 pi 的显式转换层(见《0-context-engineering》篇),生产实现应把「内部表示」与「LLM 协议表示」分开,用函数集中转换。 - while 硬编码控制流 → 图 / 状态机:当任务不可控(长时、需中断/重放/并行)时,线性循环的兜底只有
max_steps超步数(react_agent.py:365-387),生产上应引入图或状态机(见第 6 节对照)。 - 按字符估算 token → 精确 tokenizer 或 provider usage:
core/agent.py:1055-1057的chars // 4只是子代理元数据估算;若用 token 预算做上下文裁剪,应走 tiktoken(TokenCounter 已具备,token_counter.py:128-137)或直接读 provider 返回的 usage。
版本陷阱提醒
教材 / 旧教程引用的 FunctionCallAgent、MemoryTool、RAGTool 等在开发版已不存在或失效——FunctionCallAgent 的能力并入基类(core/agent.py:504 注释),MemoryTool/RAGTool 仅剩「已移除」注释(context/builder.py:9/:55/:136)。读者迁移代码时以仓库当前代码为准,尤其要区分 main(开发版 V1.0.0)与 learn_version(教程对应)两个分支(README.md:12-17)。
一个已核实的「教学框架的坑」
create_agent("simple") 创建 SimpleAgent 时没有透传 tool_registry(agents/factory.py:75-82),而同文件其余三个分支都传了(:47-73)——导致经工厂创建的 SimpleAgent 永远拿不到工具。这正是一个典型的教学框架缺陷形态:工厂是教学演示入口,恰恰在这里漏参数,读者照着工厂用就会踩坑。进一步看(推断):基类组装路径本身没问题,漏的是工厂这条「框架自己暴露给读者的入口」——演示路径不经由基类 __init__ 的同一套参数传递,缺陷更容易潜伏在这一层,教学框架的缺陷常发生在演示代码上。它不影响基类设计本身,但说明「教学优先」也会在演示代码上牺牲正确性。
收束中心论点
教学框架的价值是「把决策点变可见」——工具三件套为什么在基类、Thought/Finish 为什么是工具、上下文为什么走压缩路线、循环为什么是 while,每个决策都在几百行代码里摊开给你看。读者要做的是识别哪些原则可迁移、哪些实现需替换——这正是整个「Agent 框架」系列 5 篇文章的共同任务:helloagents 给「最简形态」,langgraph / openai-agents / MetaGPT / llama_index 给「生产形态的四种解法」,对照着读,才能分清什么是框架的必要零件、什么是特定取舍。
图 7|「可迁移 vs 需替换」两列表 | ✅ 可迁移的原则 | 🔁 需替换的实现 | |---|---| | 工具调用三件套提取为公共层 | 裸 dict 消息流转 → 领域对象 + 转换层 | | Thought / Finish 建模成工具 | while 硬编码 → 图 / 状态机(任务不可控时) | | 横切关注点集中组装进基类 | 字符估算 token → 精确 tokenizer / usage | | 双层工具注册降低上手门槛 | — | 视觉语言与
0-context-engineering篇图 7 一致,作为收尾。
附录 A:证据清单(正文实际引用,均已对本地源码复核)
| 断言 | 证据位置(相对 0-agent-framework/20260810-helloagents-framework/) |
|---|---|
| 版本说明(开发版 V1.0.0;learn_version 分支对应教程) | README.md:12-17 |
| 顶层导出核心组件 | hello_agents/__init__.py:17-31 |
| 跨供应商适配(OpenAI/Anthropic/Gemini 按 base_url 分发) | hello_agents/core/llm_adapters.py:13、:84、:329、:580、:860、:874-884 |
| 函数工具固定 input schema(双层注册能力分界) | hello_agents/core/agent.py:566-574 |
| Agent 基类与横切组装(History/Truncator/Token/Trace/Skill/Session/Task/Todo/DevLog) | hello_agents/core/agent.py:17、:32-131、:146 |
| 基类异步入口 arun(线程池包装 run)与 _history 向后兼容 | hello_agents/core/agent.py:152、:164、:134-143 |
| 工具调用三件套(从 FunctionCallAgent 提取) | hello_agents/core/agent.py:504、:506、:594、:647、:673-679 |
| 子代理 token 按字符/4 估算 | hello_agents/core/agent.py:1055-1057 |
| SimpleAgent 循环 | hello_agents/agents/simple_agent.py:16、:58、:131-244 |
| ReActAgent 与 Thought/Finish 工具化 | hello_agents/agents/react_agent.py:42、:50、:85、:166-364、:304、:460 |
| ReActAgent 异步完整版 | hello_agents/agents/react_agent.py:483 |
| ReAct 手工拼 dict(assistant / tool 消息) | hello_agents/agents/react_agent.py:240-255、:328-332、:359-363 |
| ReflectionAgent 迭代与关键词停机 | hello_agents/agents/reflection_agent.py:46、:130、:140 |
| PlanSolveAgent Planner/Executor 两段式 | hello_agents/agents/plan_solve_agent.py:262、:311-318 |
| 工厂选型;simple 分支未透传 tool_registry | hello_agents/agents/factory.py:15、:26-30、:47-82 |
| ToolRegistry 双层注册 / 执行 / 熔断 / 单例 | hello_agents/tools/registry.py:10、:30、:39-48、:57、:132、:143-153、:291 |
| @tool_action 与 AutoGeneratedTool 元编程 | hello_agents/tools/base.py:15、:101、:294、:339 |
| ToolStatus 三态与 ToolResponse | hello_agents/tools/response.py:12、:20、:52-89 |
| 内置工具清单 | hello_agents/tools/builtin/__init__.py:15-20 |
| ContextBuilder GSSC 四阶段与「已移除」注释 | hello_agents/context/builder.py:52、:119、:157、:214、:269、:9、:55、:136 |
| 实际三件套(History/Token/Truncate) | hello_agents/context/history.py:15、:101、:113;token_counter.py:15、:49-66、:119-137;truncator.py:18、:72-130 |
| TokenCounter 声称增量计算但无实现(docstring :35) | hello_agents/context/token_counter.py:35(仅示例引用,无 def count_incremental) |
| Message 模型与 summary 角色 | hello_agents/core/message.py:7、:9、:25、:35 |
| SessionStore 用 to_dict 序列化历史(双轨制证据) | hello_agents/core/session_store.py:110 |
| 与大纲差异记录:子包实际为 6 个(大纲写 7) | hello_agents/(目录实测) |
附录 B:遗留问题与降级说明
learn_version分支与开发版的差异未复核:本地克隆仅有main分支(git branch -a实测),无法比对教程对应版本的行为。本文已按开发版 V1.0.0 成文并在文首声明;若文章定位教材对照,建议后续补一次分支差异比对。factory.py:75-82的 SimpleAgent 疏漏已核实为真实缺陷(未透传tool_registry),已在第 7 节作为「教学框架的坑」素材写入。- 与
0-context-engineering篇的边界:本篇基于20260810-helloagents-framework/(开发版,无 FunctionCallAgent / MemoryTool);那边基于0-context-engineering/20260810-hello-agents/(旧版教程代码)。两篇对 ContextBuilder / 工具的叙述以各自仓库实际代码为准,本文未沿用旧版叙述。 - 文中结构图已统一替换为正式图示,并与系列其他篇保持一致的视觉语言。