版本口径:langgraph v1.2.10(
langchain-ai/langgraph),本地克隆0-agent-framework/20260810-langgraph/;文中所有file:line以本地源码为准。 证据说明:draft-v1,基于outline.md生成;所有file:line已按附录 B 待办复核(版本、deprecated 状态、核心行号);interrupt/resume最小示例尚未运行验证(见附录 B)。
你写 agent 时学的第一件事,多半是一个 while 循环:把消息喂给模型,模型说「要调工具」就调,把结果塞回去,再来一轮,直到模型说「好了」。简单、直白、人人都懂。然后某一天需求变了:你要让两个子任务并行跑、要等它们都回来再汇总、要在中途停下来问用户、要能断点续跑。于是 while 循环开始长出各种 if/else、ThreadPoolExecutor、全局变量、手写状态恢复——代码开始像一团毛线。
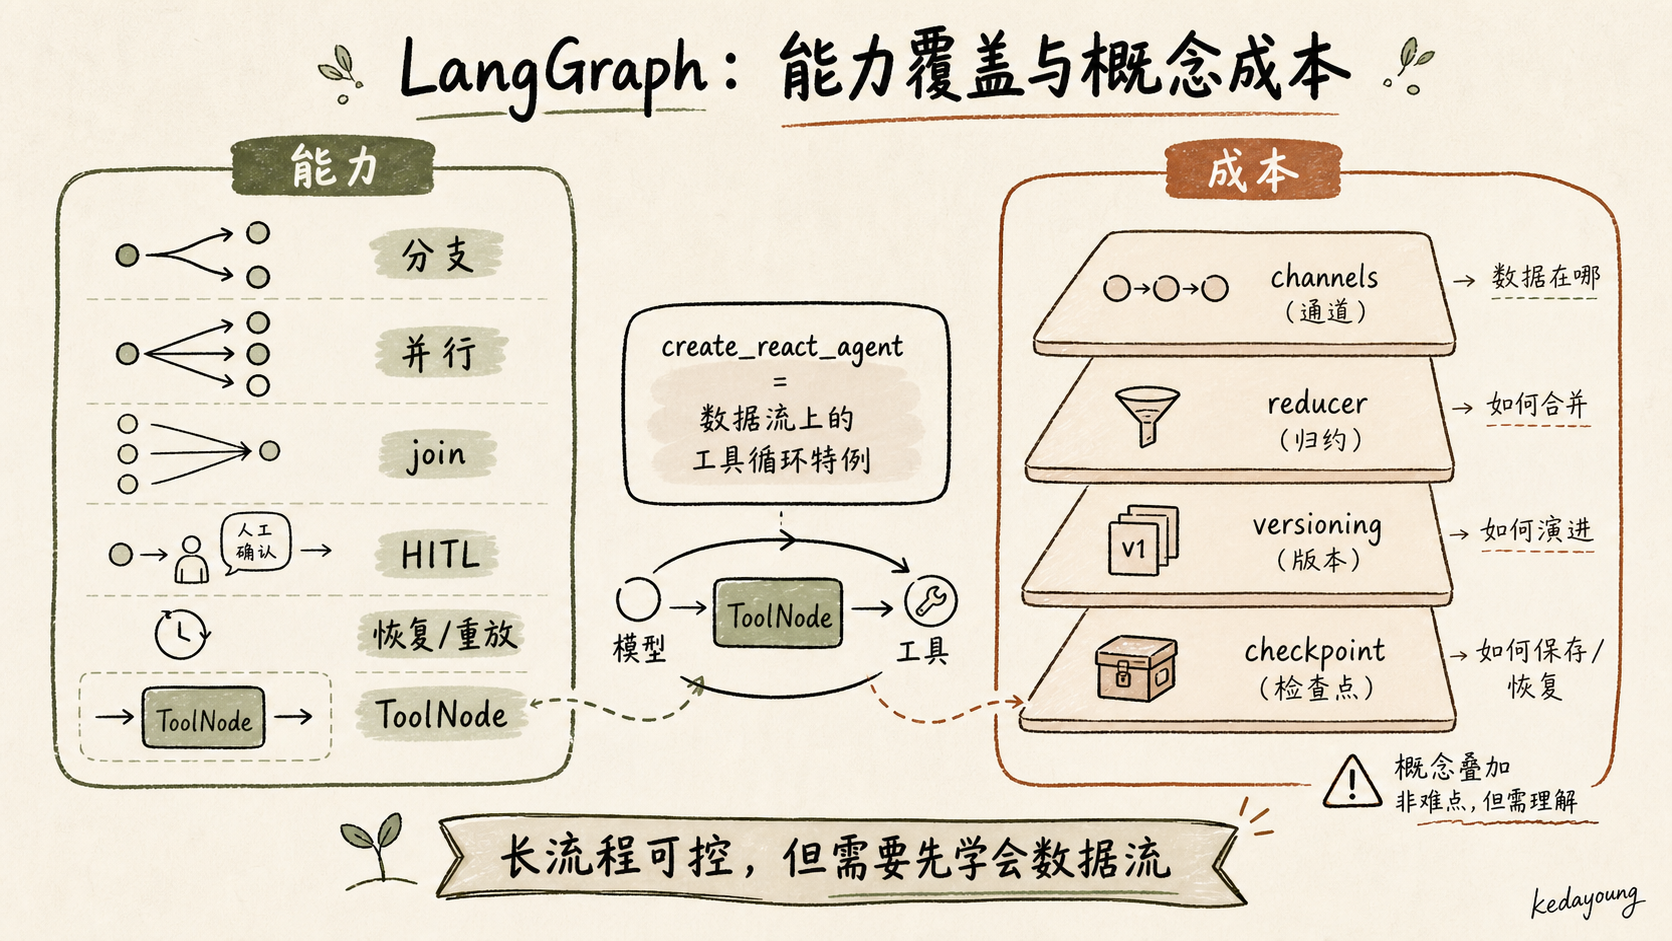
LangGraph 给出的回答不是「把循环写得更漂亮」,而是换一个底层模型:你不是在写循环,你是在声明一张图;这张图被编译成 channel 读写的并发数据流来执行。边在 attach_edge 里变成 channel 写入/订阅,状态是带 reducer 的 TypedDict 契约,checkpointer 用版本号支撑可恢复可重放。分支、并行、join、人机协同,都是这套数据流上的组合原语(Command / Send / interrupt)——代价是概念负荷高:channels、reducer、versioning、checkpoint 四层抽象叠加。这笔学费值不值,第 7 节再算。
接下来顺着这条链路走到底:先看「图凭什么比循环强」(第 1 节),再看 StateGraph 声明如何被编译成 channel 数据流(第 2–3 节)、被 Pregel 引擎执行(第 4 节)、被 checkpointer 变成可恢复的记忆(第 5 节);第 6 节用预构建 agent 把前四层串起来实证,第 7 节回答那个该在动手前就问的问题:什么时候不该用它。
1. 图模型 vs 线性循环:LangGraph 想解决什么
1.1 为什么「一个 Agent = 一个循环」不够
while 循环天然是单一路径的:一条指令流,一个状态变量,循环体里顺序执行。helloagents 克隆的 hello_agents/agents/react_agent.py:166 是典型代表——max_steps 封顶、循环内「模型 → 工具 → 状态更新」串行推进。它适合什么?单模型、单工具集、一条主线走到底的任务。
但它对以下需求是硬伤的:
- 分支:不同输入走不同子流程(比如「代码问题 → 走 debug 流程」「文档问题 → 走检索流程」);
- 并行:多个相互独立的子任务同时跑(比如同时检索三个数据源),而不是串行排队;
- join(汇合):等所有并行分支都完成,再统一进入下一步;
- 人机协同(HITL):中途暂停、把上下文交给用户、等用户答复再恢复——
while循环的break只能退出,不能「挂起后从原地继续」; - 恢复/重放:进程崩溃后从上一个检查点续跑,而不是从头再来。
这些需求的共同点:执行流程不再是一条直线,而是一张有分叉、有汇合、有暂停点的图。你需要显式控制流。
如果你用 while 硬扛这些需求,代价会逐项显形:并行要么串行排队(慢),要么手写线程池再手动收集结果(错);join 得靠「所有任务完成计数器」这类全局状态(脆);HITL 得把「暂停点 + 恢复上下文 + 恢复指令」自己编码进状态变量(散);崩溃恢复基本无从谈起(除非你自己实现状态序列化)。每加一个需求,循环体就多一层胶水代码,而这些胶水与「agent 到底该做什么」毫无关系——它们全是在手动实现一个不完整的执行引擎。这正是框架的切入点:把控制流从业务代码里抽出来,交给一个专门的引擎。
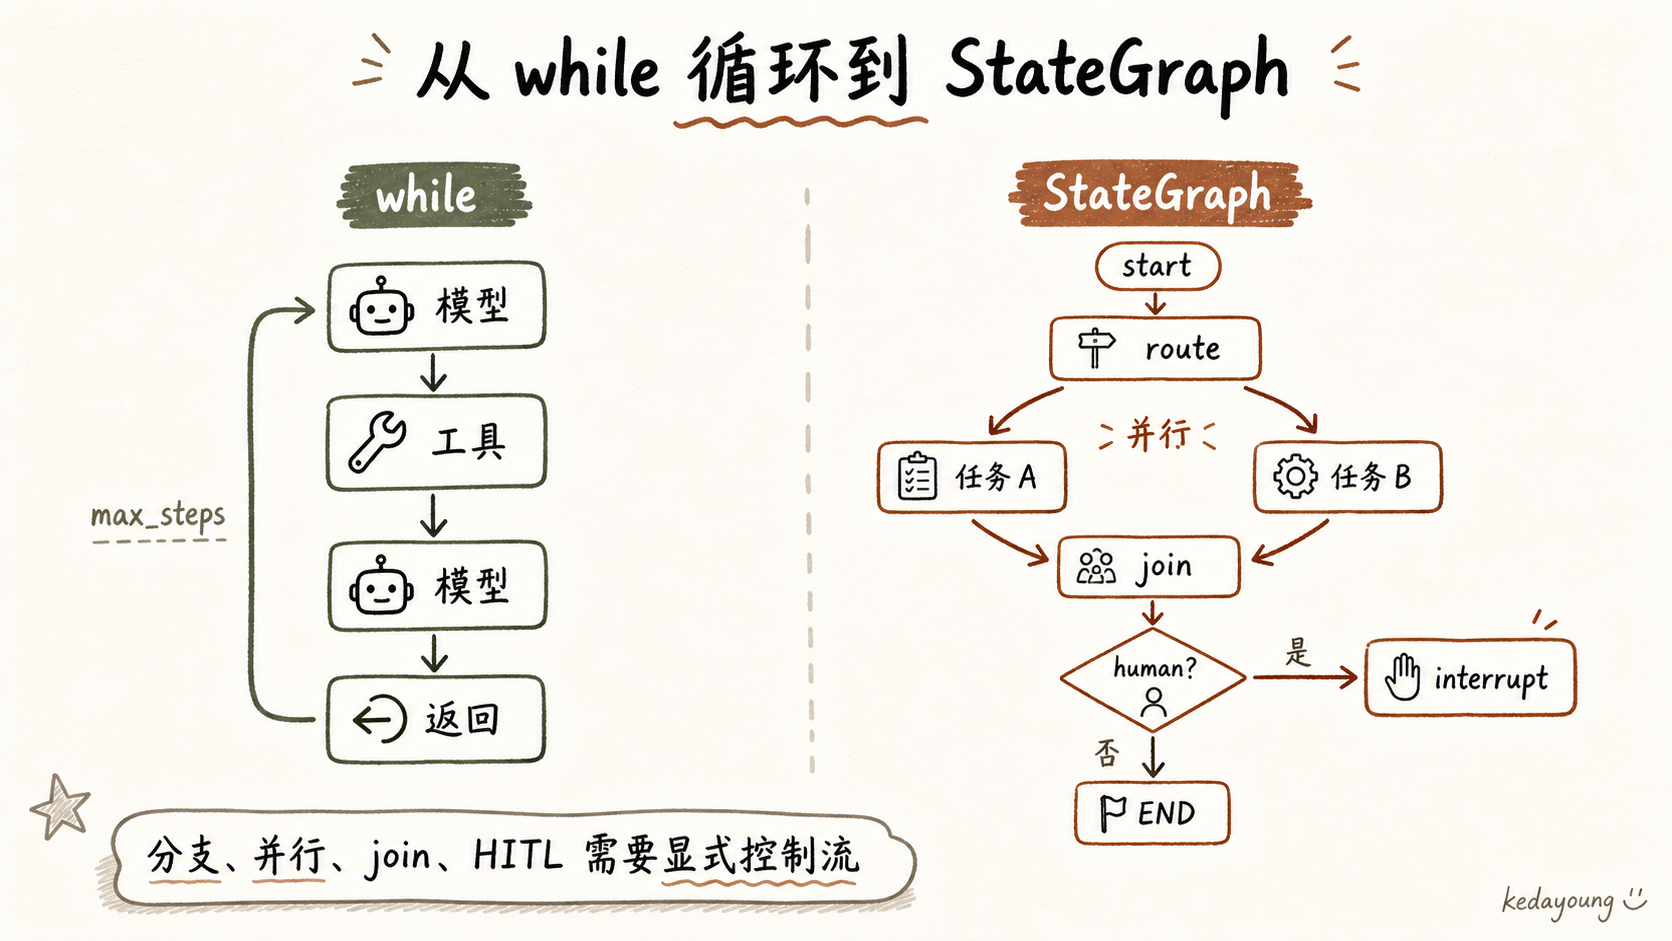
图 1|线性循环 vs 图编排
左边是单路径 while 循环,右边是带分支/并行/join/HITL 的图——LangGraph 明确覆盖右边。
1.2 LangGraph 的定位:与 LangChain 的边界
LangGraph 自己的 README 把定位说得很清楚:
LangGraph is a low-level orchestration framework for building, managing, and deploying long-running, stateful agents.(
libs/langgraph/README.md:22)
注意措辞:low-level orchestration。LangGraph 不是又一个「写 agent 的脚手架」,而是「构建、管理、部署长时间运行的有状态 agent」的底层编排层——甚至 LangChain 自己的 agent 也构建在 LangGraph 之上(README.md:26)。README 接着给出了明确的使用分界:当你有「确定性工作流 + agentic 工作流混合、重度定制、精细控制延迟」这类进阶需求时用它;只想快速构建 agent 时,直接用 LangChain 的预构建架构(README.md:22-24)。
1.3 包结构预览:一次执行涉及的四个层次
顺着这个定位看包结构,LangGraph 的职责切分一目了然:
langgraph/graph/—— 图构建层:StateGraph及节点/边 API;langgraph/pregel/—— 执行引擎层:Pregel、PregelLoop、任务调度、并行执行;langgraph/channels/—— 状态底层:BaseChannel及各 channel 实现(LastValue、BinaryOperatorAggregate、NamedBarrierValue…);libs/checkpoint*—— 持久化层:checkpointer(短期记忆)与 Store(长期记忆)的接口与实现。
另外还有一层不在「执行链路」上、但全文会用到的高级 API:libs/prebuilt(ToolNode、create_react_agent 等开箱组件)。前四个层次贯穿全文:第 2–3 节讲 graph + channels,第 4 节讲 pregel,第 5 节讲 checkpoint/store,第 6 节用 prebuilt 作为前四层能力的实证。
1.4 版本事实:v1.x 没有独立的 Graph 类
一个常见的困惑:很多教程里说「LangGraph 的 Graph」,但 v1.x 里没有独立的 Graph 类——只有 StateGraph(libs/langgraph/langgraph/graph/state.py:130)。而曾经存在的 MessageGraph(graph/message.py:316)已经打了 @deprecated 标记:「MessageGraph is deprecated in langgraph 1.0.0, to be removed in 2.0.0. Please use StateGraph with a messages key instead.」(message.py:312-316)。也就是说,v1.x 的图模型已经收敛为「一张带状态 schema 的图」这一个入口——所有状态(包括消息列表)都是 state 的 key,reducer 决定怎么合并。成文时克隆版本为 v1.2.10(libs/langgraph/pyproject.toml:7),下文所有行号以该克隆为准,并如实标注迁移中的 API。
2. StateGraph:节点、边、条件边与编译
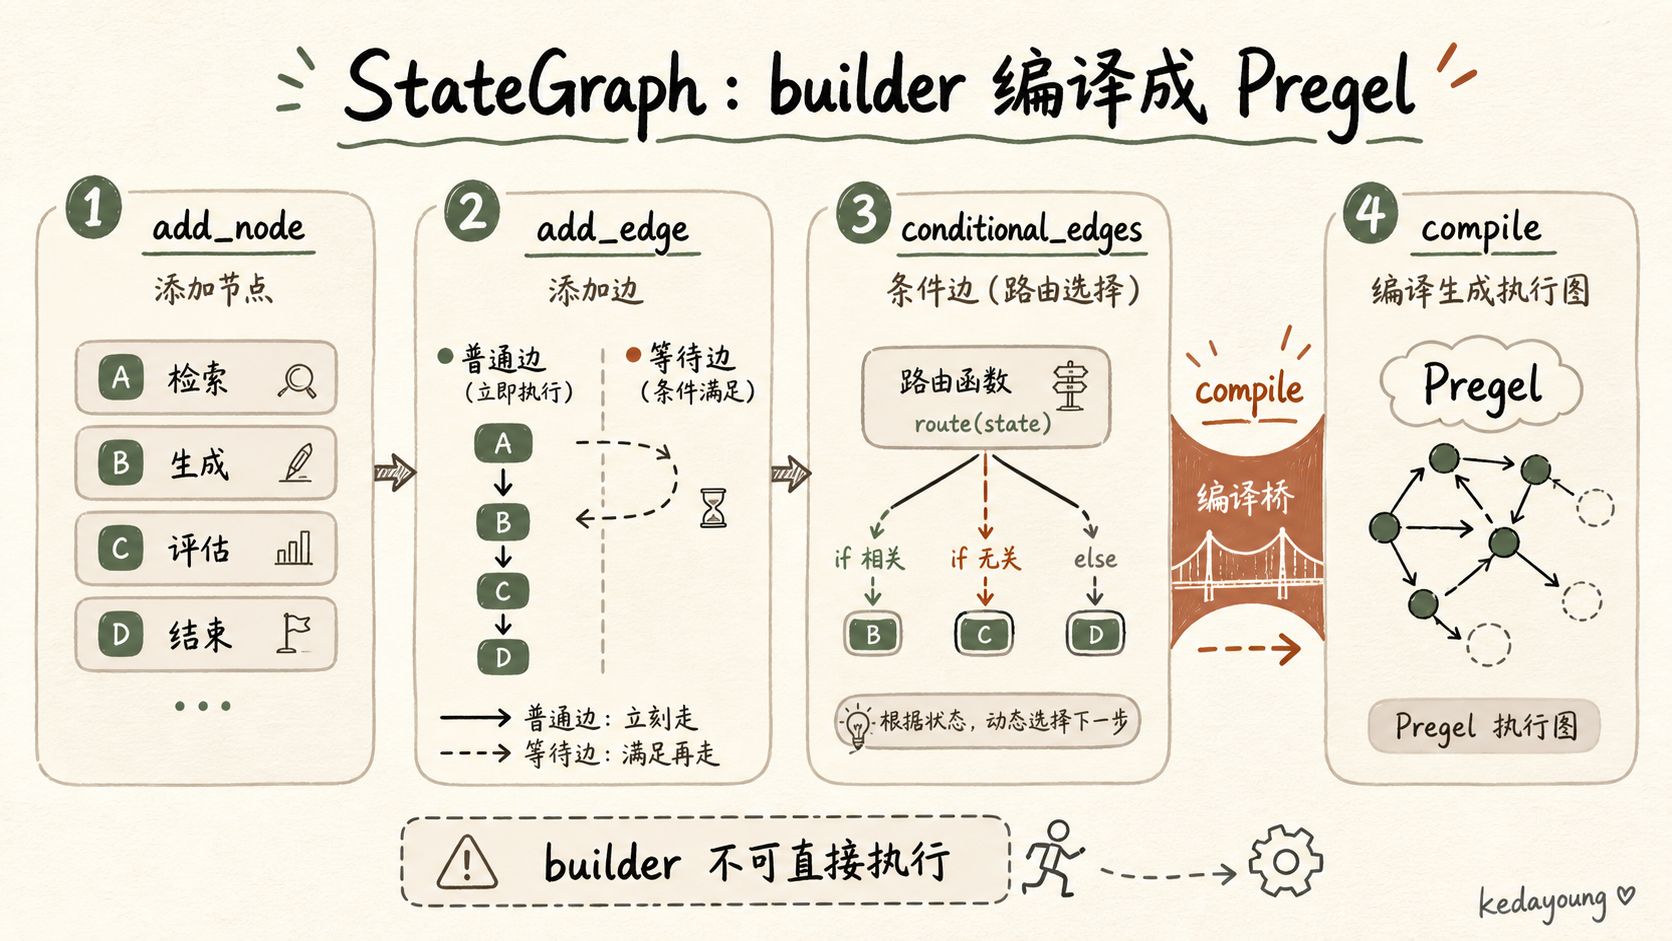
这一节回答两个问题:builder API 各自的语义和实现位置是什么?「图被编译成 channel 读写」具体发生在哪一步?第二个问题的答案(attach_edge)是全文的核心论据。
2.1 StateGraph:不可直接执行的 builder
StateGraph 的 docstring 第一句就声明了它的身份:
A graph whose nodes communicate by reading and writing to a shared state. …
StateGraphis a builder class and cannot be used directly for execution. You must first call.compile()to create an executable graph.(graph/state.py:130-144)
它的核心设计是「节点通过读写共享状态来通信」(state.py:131)——注意这个措辞:节点之间没有直接的调用关系,它们通过状态(channel)间接通信。这正是「数据流」模型的第一条线索:节点是 State -> Partial<State> 的函数(state.py:133),任何节点读到的状态来自 channel 的当前值,写出的东西进入 pending writes,由执行引擎统一合并。
2.2 add_node:命名、schema 推断与 Command
add_node(graph/state.py:662)做三件值得注意的事:
- 命名:节点可以显式命名,也可以不传 name——此时自动取函数的
__name__(state.py:768-789)。命名不是装饰性的:后面所有边、条件边、goto、checkpoint 里的versions_seen都按节点名索引。 - schema 推断:通过类型提示(
type hints)推断节点的输入/输出 schema(state.py:803-826)。这是「状态即契约」的起点——节点的入参不是自由 dict,而是有类型约束的。 - Command 可达终点推断:如果节点返回
Command,编译器会推断它可能跳转到的终点集合(state.py:839-851)。Command是第 5 节 HITL 和动态跳转的载体,这里提前埋了伏笔。
另外,add_node 有 5 个 overload(state.py:374/444/517/586)——API 面在往 v3 节点签名演进,成文时(v1.2.10)处于迁移中,读者看到旧教程里的写法不必惊讶。
2.3 add_edge:单源边与多源边(等待边)
add_edge(state.py:915)区分两种语义:
- 单源边
start -> end:直接进self.edges,语义是「start 完成即触发 end」; - 多源边
(start1, start2) -> end:进waiting_edges,语义是「所有 start 都完成才执行 end」(state.py:918-920)。
第二种就是 fan-in join 的声明形式——它不只是一条「边」,而是一个「等待条件」。
2.4 add_conditional_edges:把路由函数交给执行期
add_conditional_edges(state.py:969)接受可调用对象或 runnable,包装成 BranchSpec 存储(state.py:1006-1016)。注意它不是立刻求值:路由函数的结果(目标节点名或 Send 列表)要到执行期、依据当时的 channel 值才算——这就是「条件边是执行期动态求值的」这一事实的来源,也解释了为什么它能支撑 Send 这种运行时动态派发(第 4 节)。
2.5 compile:从 builder 到 Pregel
compile()(state.py:1164)返回 CompiledStateGraph(state.py:1391),而 CompiledStateGraph 是 Pregel 的子类(state.py:1392)。这一步的意义:build 阶段结束,builder 变成执行引擎——invoke/stream/get_state 这些运行时 API 直接继承自 Pregel(第 4 节),不再有「图」的概念,只有「执行器」。
2.6 关键证据:attach_edge——边如何进入执行层
现在回答本节最重要的问题:声明阶段结束后,边去哪了? 答案是:边消失了,变成了 channel 读写。转换发生在 compile() 的装配阶段:StateGraph.compile(state.py:1164)创建 CompiledStateGraph 后,遍历 self.edges 与 self.waiting_edges,逐个调用 compiled.attach_edge(start, end)(state.py:1378-1382)。注意 attach_edge 是编译后对象的方法——它持有 state builder 的引用(self.builder,state.py:1408),在装配时把声明阶段的边逐条降维。看代码(state.py:1537-1561):
def attach_edge(self, starts: str | Sequence[str], end: str) -> None:
    if isinstance(starts, str):
        # subscribe to start channel
        if end != END:
            self.nodes[starts].writers.append(
                ChannelWrite(
                    (ChannelWriteEntry(_CHANNEL_BRANCH_TO.format(end), None),)
                )
            )
    elif end != END:
        channel_name = f"join:{'+'.join(starts)}:{end}"
        # register channel
        if self.builder.nodes[end].defer:
            self.channels[channel_name] = NamedBarrierValueAfterFinish(
                str, set(starts)
            )
        else:
            self.channels[channel_name] = NamedBarrierValue(str, set(starts))
        # subscribe to channel
        self.nodes[end].triggers.append(channel_name)
        # publish to channel
        for start in starts:
            self.nodes[start].writers.append(
                ChannelWrite((ChannelWriteEntry(channel_name, start),))
            )
逐行拆解:
- 单源边(
state.py:1538-1545):给start节点追加一个ChannelWrite,向名为__channel_to_<end>的 channel 写入。边 = 「上游节点的写操作」。 - 多源边(
state.py:1546-1561):创建一个名为join:<start1>+<start2>:<end>的NamedBarrierValuechannel;每个 start 节点向它写入自己的值(state.py:1558-1561),end 节点订阅这个 channel(state.py:1556)。边 = 「一个等待所有命名值到达的屏障 + 下游节点的订阅」。
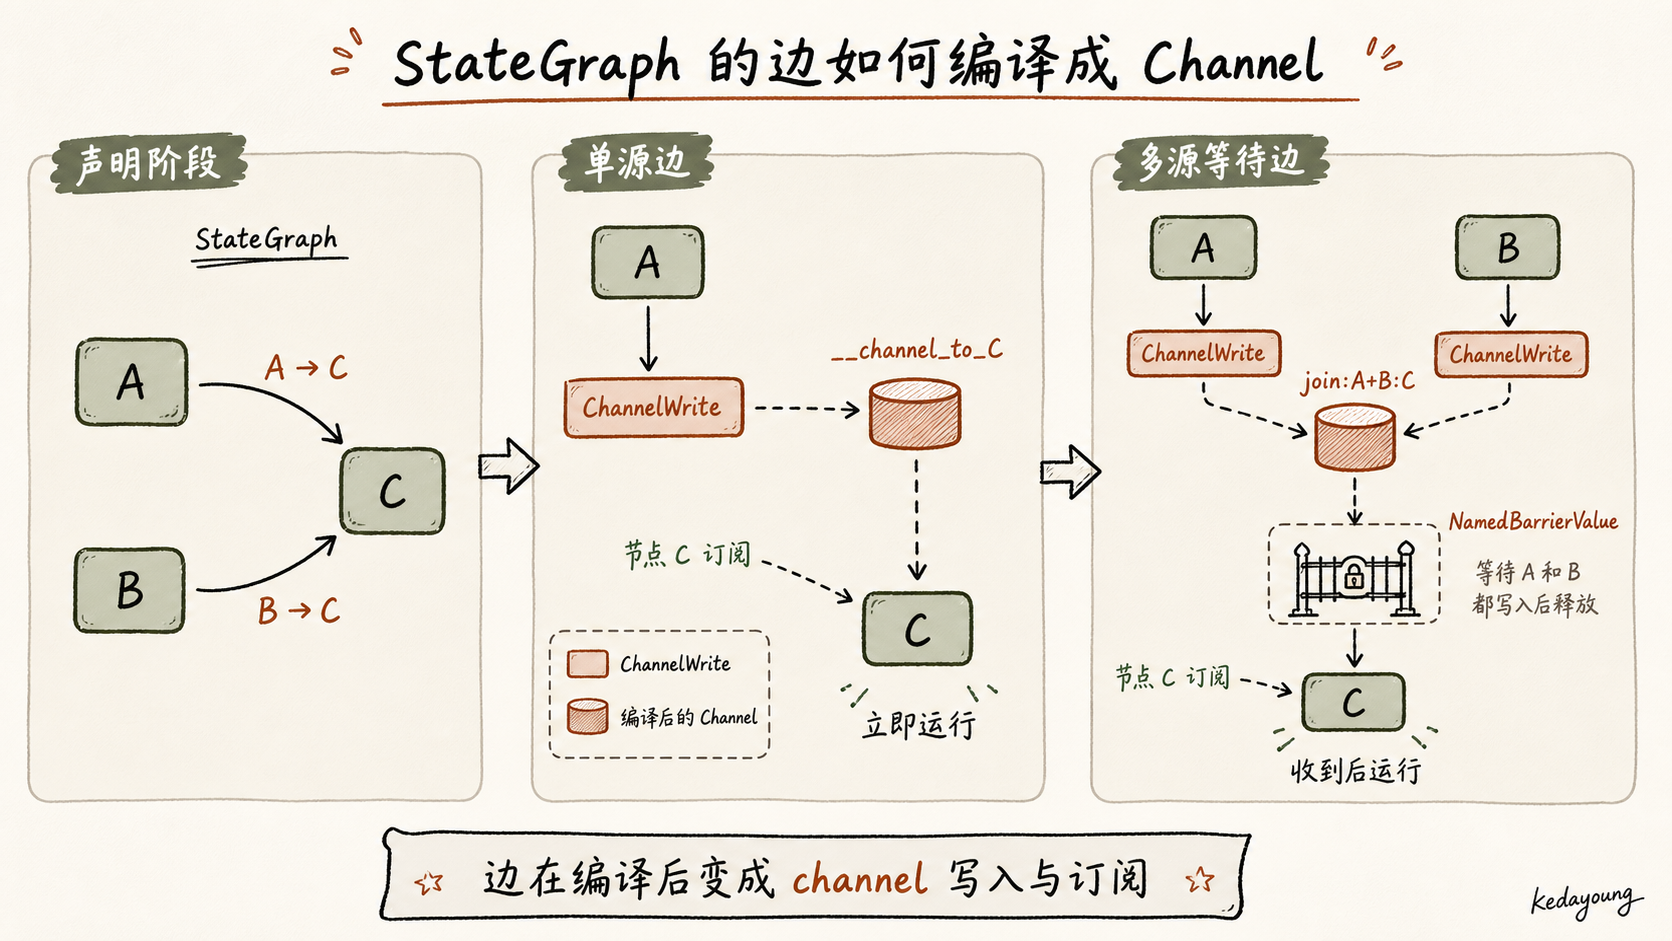
图 2|StateGraph → compile → channel 数据流
声明阶段的「边」在编译后变成「channel 写入 + 下游订阅」;多源边变成 NamedBarrierValue 屏障 channel。这是全文核心图——边消失,channel 出现。
这就是中心论点的实证:执行层根本不认识「图」和「边」,它只认识 channel 的读写。声明阶段的高层抽象(节点/边/条件边)在 compile 时被降维成一组 channel 更新规则,剩下的执行工作全部发生在「哪些 channel 被写了 → 哪些节点订阅了这些 channel → 调度这些节点」这条链路上。
3. 状态即契约:TypedDict、Channel 与 Reducer
3.1 从状态 schema 到 channels
StateGraph(state_schema=TypedDict) 是图模型的「契约面」:状态是什么、哪些 key 可以被谁写、写冲突怎么办,全在这张类型声明里(graph/state.py:215-269)。而 schema 展开成 channels 的路径是 _add_schema(state.py:342)→ _get_channels(state.py:1801)→ _get_channel(state.py:1836)。
3.2 类型注解 → channel 映射规则
_get_channel(state.py:1836-1859)按注解类型做分派:
| 注解形态 | 生成的 channel | 语义 |
|---|---|---|
ManagedValueSpec | managed value | 由框架管理的派生值 |
已是 BaseChannel 实例 | 直接使用 | 手动精细控制 |
Annotated[T, reducer] | BinaryOperatorAggregate(state.py:1890-1908) | 多写按 reducer 合并 |
| 其余默认 | LastValue | 每 step 只保留最后一个值 |
这张表是「状态即契约」的具体化:同一个 key,注解方式决定了它的并发写语义。这是声明式 reducer 设计的核心——你不写「怎么合并」的过程代码,而是声明「用什么函数合并」,执行引擎负责在合适的时机调用。
3.3 Channel 读写协议
所有 channel 实现都继承 BaseChannel(channels/base.py:19),协议只有三个关键方法:
update(values)(channels/base.py:90-99):Pregel 在每个 step 结束时调用,把本 step 收集到的所有写入合并进 channel;consume(channels/base.py:101):标记「本 step 已消费」,用于屏障类 channel;finish(channels/base.py:112):图结束时通知 channel 收尾。
注意时序:update 是「step 结束后批量调用」,不是写入即时生效——这正是「superstep」模型的基础(第 4 节):一个 step 内所有节点并发跑,step 结束统一 merge writes、统一推进版本号。
3.4 Reducer 落地:BinaryOperatorAggregate
Annotated[list, add_messages] 里的 reducer 最终落在 BinaryOperatorAggregate.update(channels/binop.py:123-144):把本 step 的多个值逐个折叠进 channel。它还支持 Overwrite 哨兵强制覆盖(binop.py:129-141)——声明「这个写要无视 reducer 直接替换」。reducer 纯函数化((Value, Value) -> Value,见 state.py:137)保证了合并顺序无关性之外的确定性:任何两个值合并,结果只取决于函数本身。
3.5 默认纪律:每 step 每 key 只能写一次
没有 reducer 的普通 key(LastValue)有一道硬纪律(channels/last_value.py:56-67):
def update(self, values: Sequence[Value]) -> bool:
    if len(values) == 0:
        return False
    if len(values) != 1:
        msg = create_error_message(
            message=f"At key '{self.key}': Can receive only one value per step. Use an Annotated key to handle multiple values.",
            error_code=ErrorCode.INVALID_CONCURRENT_GRAPH_UPDATE,
        )
        raise InvalidUpdateError(msg)
    self.value = values[-1]
    return True
如果两个并行节点在同一 step 里写同一个普通 key,执行引擎直接抛 InvalidUpdateError,错误信息还贴心提示「Use an Annotated key」。这条错误信息本身就是在教学:并发写冲突不是运行时静默覆盖,而是编译期可预防、运行期显式报错的契约违规。它是「状态即契约」的第一条纪律。
3.6 消息 reducer:add_messages
聊天场景的消息列表用 add_messages reducer(graph/message.py:61)——按消息 id 合并、append-only、同 id 替换。MessagesState 就是 messages key 预置了 add_messages 的 TypedDict(message.py:372-373)。这就是 MessageGraph 被废弃后官方推荐的写法:「Use StateGraph with a messages key instead」(message.py:313)——消息不再是特殊概念,只是「一个带 reducer 的 key」。
3.7 写入执行:apply_writes
写入的真正执行在 apply_writes(pregel/_algo.py:232):把本 step 的 pending writes 按 channel 分组(:294-333)→ 对每个 channel 调 update(vals) 合并 → 递增 channel_versions 版本号。读取侧对应 read_channels(pregel/_io.py:38)——节点的入参就是从这些 channel 读出的值,读写两侧走的是同一套 channel 协议,方向相反。版本号递增是第 5 节 checkpoint 重放的基础,这里先记住「每次写入都推进版本号」这一事实。
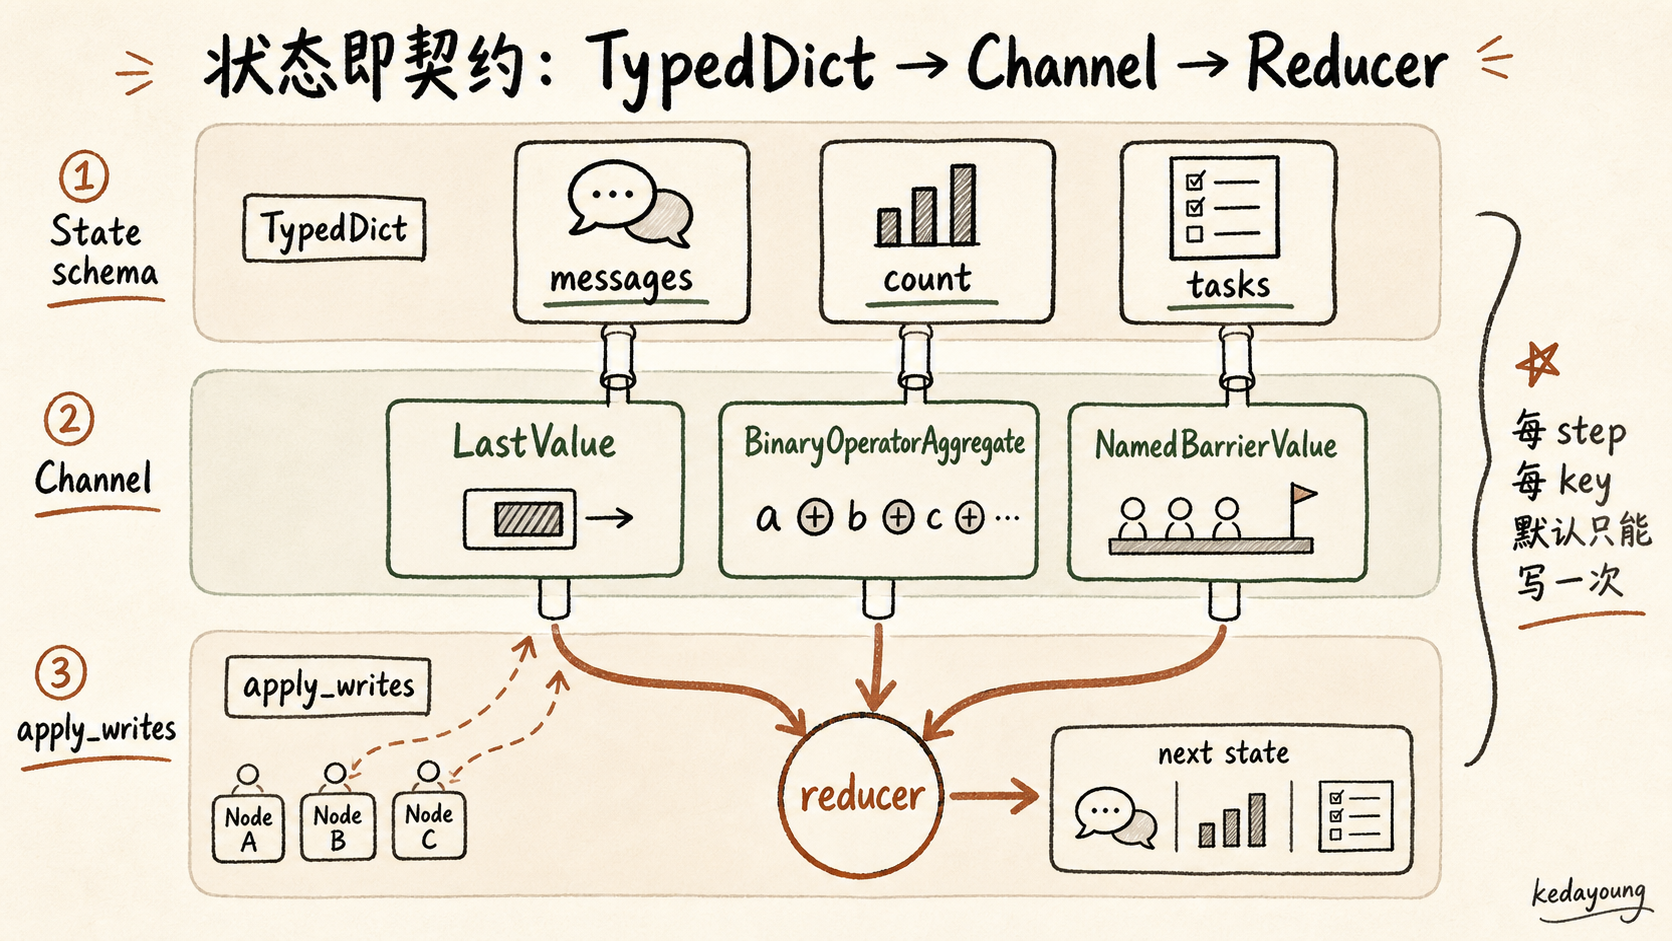
图 3|TypedDict → channel → reducer 三层
一条 Annotated[list, add_messages] 从类型注解展开为 BinaryOperatorAggregate,step 结束时按 reducer 合并并推进版本号;普通 key 多节点并发写则抛 InvalidUpdateError。
4. Pregel 执行引擎:superstep、并行与屏障
前两节讲完了「图怎么变成 channel 数据流」,这一节看执行引擎怎么跑这条数据流。
4.1 为什么是「superstep」而不是「逐条执行」
在进入代码之前,先建立正确的执行心智模型。Pregel 这个名字来自 Google Pregel(图计算系统),核心思想是 BSP(Bulk Synchronous Parallel,整体同步并行):执行被切成一个个 superstep,每个 superstep 内所有任务并行计算,superstep 结束时统一同步(合并写入、推进版本、落检查点),然后进入下一个 superstep。BSP 的价值是它把「并发」和「同步」的复杂度从应用层收进引擎:节点作者永远不需要写锁、不需要管「另一个节点是不是正在写同一个 key」——并发写冲突由 channel 契约(第 3.5 节)在执行引擎层裁决。代价是单个 step 内的写入要到 step 结束才可见,节点间没有「边跑边读」的细粒度通信——这是设计者明确接受的折中。
4.2 运行时三件套
Pregel(pregel/main.py:450):对外执行器,CompiledStateGraph的父类,暴露invoke/stream等 API;PregelLoop(pregel/_loop.py:158):内部主循环,管理 step 推进;- 同步/异步变体(
pregel/main.py:1469、:1722):同一套逻辑的sync/async双实现。
4.3 单步循环:tick()
PregelLoop.tick()(pregel/_loop.py:599-681)是一个 step 的完整生命周期:
prepare_next_tasks构造本 step 要执行的任务列表(:612-629)——具体怎么构造见 4.5;- 如果任务为空,循环结束(
:653-655); - 若配置了
interrupt_before,在 step 前暂停(:667-671)。
注意第 2 点:没有新任务 = 图执行完毕。这是一个纯数据流驱动的终止条件——没有显式的「循环上限」,图的终点不是某个节点,而是「没有任何 channel 更新再触发任何节点」。
4.4 step 收尾:after_tick()
after_tick()(pregel/_loop.py:683-726)是 step 的收尾:
- 收集所有节点的 writes →
apply_writes合并(第 3.7 节); - 清空 pending writes;
_put_checkpoint把当前状态存为检查点(:718)——每个 step 结束都落一次检查点;- 若配置了
interrupt_after,在 step 后暂停(:720-724)。
这里已经能看到「checkpoint 是一等公民」:它不是可选的事后备份,而是执行循环每个 step 的固定环节。
4.5 superstep 任务构造:prepare_next_tasks
prepare_next_tasks(pregel/_algo.py:392-513)回答「下一个 step 跑哪些节点」:
- PUSH 任务:来自
Topic[Send]——即Send原语动态派发的任务(:442-466)。Send是「运行时把新任务投递给指定节点」的机制,用于动态 fan-out(比如一个规划节点拆出 N 个子任务); - PULL 任务:来自被触发节点——即「订阅的 channel 被更新了」的节点(
:468-512)。
关键过滤逻辑(:475-482):只调度「订阅的 channel 版本变了」的节点。这正是 2.6 节那套「channel 写入 + 订阅」语义在执行期的兑现:一个节点会不会跑,取决于它订阅的 channel 是否更新,而 channel 是否更新取决于版本号是否推进——所以第 3.7 节的「每次写入推进版本号」不是细节,是调度正确性的核心。
4.6 并行执行
一个 step 内的多个任务怎么跑?PregelRunner.tick(pregel/_runner.py:176)有两条路径:
- 单任务快速路径(
:200-255):当前 step 只有一个任务时,直接当前线程跑,省去调度开销; - 多任务线程池:多个任务丢进
concurrent.futures线程池并行(_runner.py:75-131),通过BackgroundExecutor(pregel/_executor.py:40)管理。
这就是「图模型天然支持并行」的引擎层面答案:并行不是应用层手写 ThreadPoolExecutor,而是执行引擎看到同一 step 有多个可调度节点就自动并行——并行是「同一 superstep 内多个节点」的自然结果,不是特例。
4.7 同步屏障:NamedBarrierValue
多源边的 join 语义(2.3 节)在执行期由 NamedBarrierValue 实现:「等待所有命名值到达」(channels/named_barrier_value.py:13-14)。每个上游写入自己的命名值,最后一个值到达时屏障放行,下游节点才被调度。这是 fan-in join 的引擎实现。
另一对容易混淆的 channel:EphemeralValue(channels/ephemeral_value.py:15-17)跨 step 失效——值只在写入的 step 内可见,图结束时会被清掉,用来做「step 内临时通信」,不落 checkpoint。
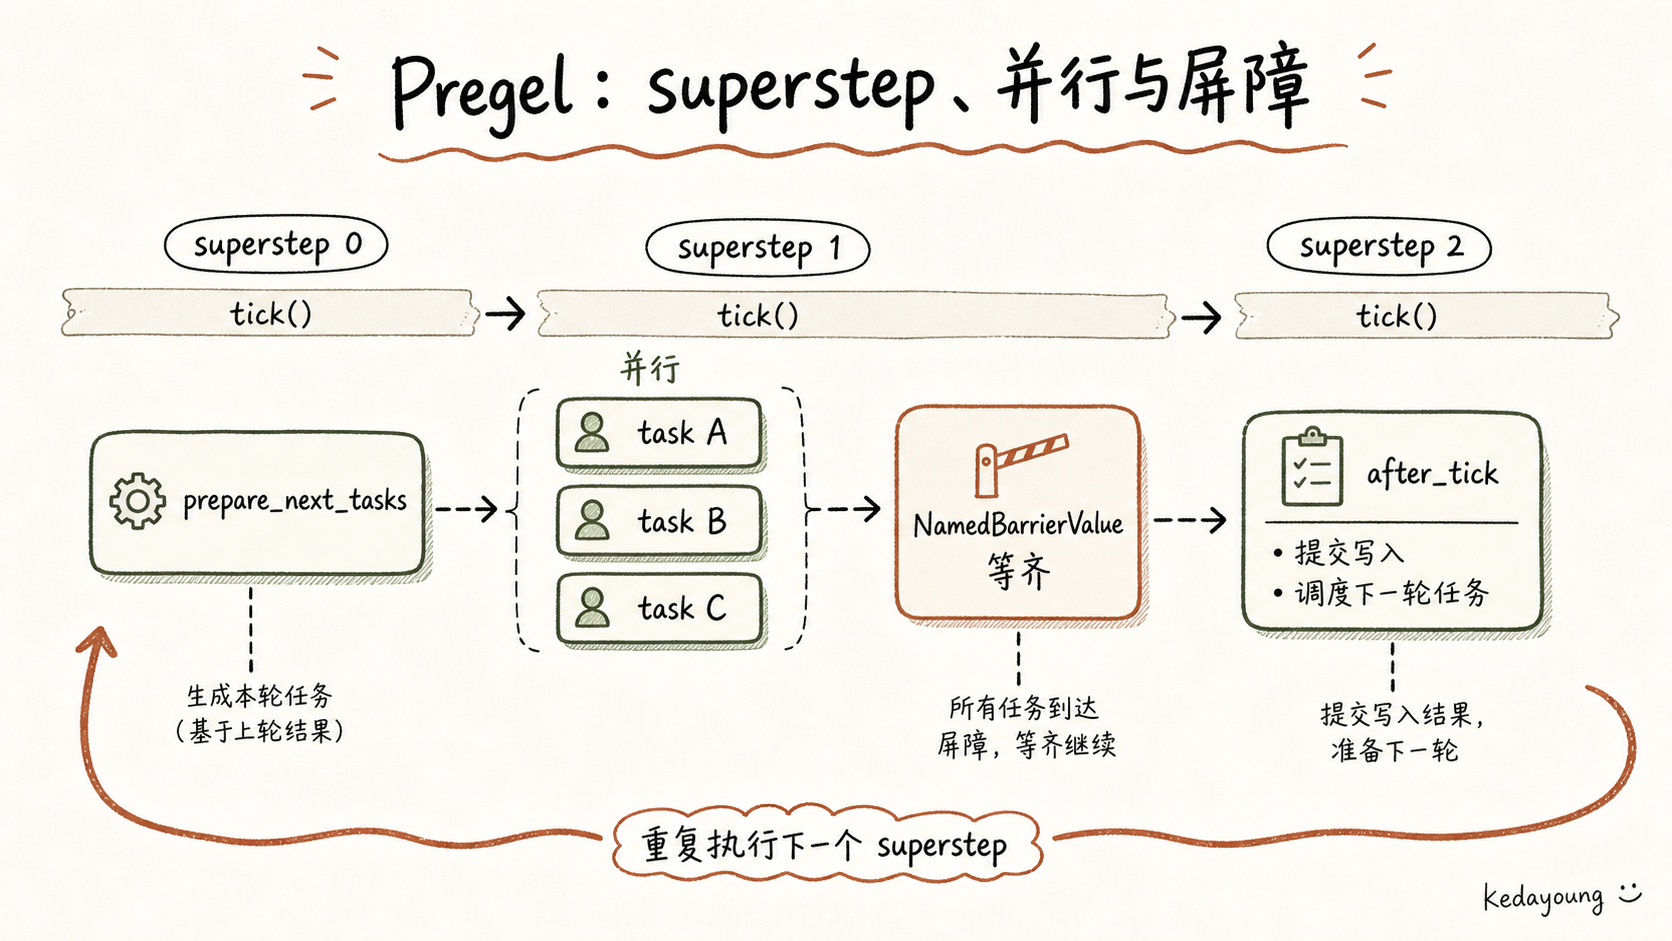
图 4|superstep 时序
并行节点在同一 superstep 被调度,向屏障 channel 写入,最后到达者触发放行;每个 step 结束落检查点;Send 可在节点内动态派发新任务。
5. 持久化与记忆:checkpointer 与 Store 的分层
「记忆」在 LangGraph 里不是一个模糊概念,而是两个层次分明、实现完全不同的存储域:短期记忆(thread 内) 与 长期记忆(跨 thread)。
5.1 短期记忆:checkpointer
短期记忆由 checkpointer 承担——「thread 内的状态快照链」。接口 BaseCheckpointSaver(libs/checkpoint/langgraph/checkpoint/base/__init__.py:176)定义五个核心方法:get(:227)、get_tuple(:239)、list(:253)、put(:277)、put_writes(:300)。
一个 Checkpoint 的结构是(base/__init__.py:92-123):
class Checkpoint(TypedDict):
    v: int                 # checkpoint 格式版本
    id: str                # 唯一且单调递增,可排序
    ts: str                # ISO 8601 时间戳
    channel_values: dict   # 各 channel 的快照值
    channel_versions: ...  # 各 channel 的版本号(单调递增)
    versions_seen: ...     # 每个节点看到的 channel 版本(决定下一步调度谁)
    updated_channels: ...  # 本 checkpoint 更新了哪些 channel
内存实现 InMemorySaver(libs/checkpoint/memory/__init__.py:33)适合开发;生产实现有 SQLite(libs/checkpoint-sqlite/)和 Postgres(libs/checkpoint-postgres/)。
5.2 版本化检查点:为什么能支撑恢复与重放
关键在 channel_versions + versions_seen 这两个字段——还记得 3.7 节 apply_writes 递增的那个版本号吗?它在这里派上用场了:
channel_versions:channel 当前的版本号。重启后,channels_from_checkpoint(pregel/_checkpoint.py:229)用检查点重建所有 channels——channel 的当前值 + 版本号都来自 checkpoint;versions_seen:每个节点上次看到各 channel 的版本。执行引擎据此判断「这个节点订阅的 channel 有没有新版本」——这正是 4.5 节调度逻辑的恢复依据。
所以「恢复」不是「把 state 存下来再读回去」那么简单,而是精确恢复到「上一个 step 结束时」的调度状态:哪些值已合并、哪些节点已经看过哪些版本、pending writes 要不要重放(_needs_replay,pregel/_checkpoint.py:217)。这让「崩溃后从断点续跑」和「同一输入重放到任意 step 调试」都成为可能——对 HITL 尤其重要(5.5 节)。
启用方式在 compile 处:接 checkpointer 后,运行时必须传 thread_id(graph/state.py:1164-1218、:1191-1201)——thread 是 checkpoint 快照链的定位键。
5.3 长期记忆:Store
跨 thread 的长期记忆由 Store 承担。接口 BaseStore(store/base/__init__.py:708)按 namespace 作用域 组织数据——namespace 是多级路径(如 ("user", "123", "prefs")),用于把不同用户/不同业务的数据隔离在各自的命名空间。
批操作 batch(ops)(store/base/__init__.py:733)一次提交多个原语,原语包括:
GetOp(:157):按 key 读取;SearchOp(:203):按 namespace 搜索,支持语义检索(向量索引);PutOp(:431):写入;ListNamespacesOp(:368):枚举命名空间。
内存实现 InMemoryStore(store/memory/__init__.py:136)。
5.4 节点内访问记忆
节点里怎么读写这些存储?Runtime.store(runtime.py:125)暴露 store,或者用 InjectedStore 把 store 注入节点参数(prebuilt/tool_node.py:1829)——第 6 节的注入体系会细讲。checkpointer 则不需要节点感知:它透明地挂在执行循环里(4.4 节的 _put_checkpoint)。
5.5 HITL:interrupt 与 Command.resume
人机协同是「持久化能力」的直接消费者。interrupt(types.py:811-831)在节点内被调用时抛出可恢复的 GraphInterrupt 异常,图在此暂停;客户端拿到 value(要展示给用户的上下文),用户做出决定后,用 Command.resume(types.py:783)带着答复恢复执行。
两个必须如实说明的语义细节:
- interrupt 必须启用 checkpointer(
types.py:830-831)——暂停 = 把当前状态落成检查点,恢复 = 从该检查点继续,两者天然依赖 5.2 节的版本化机制; - 恢复后节点整体重执行:「The graph resumes from the start of the node, re-executing all logic.」(
types.py:824)——不是从interrupt那一行接着跑,而是整个节点重新执行,interrupt再次被调用时直接返回 resume 值。这意味着节点里的代码必须对「重执行」幂等友好——这是一个容易踩的坑,见第 7 节局限。
一个最小的人机协同流程在 API 层的长相(示意,未运行验证,见附录 B):
from langgraph.checkpoint.memory import MemorySaver

def review_node(state):
    # 第一次执行到这里:抛 GraphInterrupt,图暂停,
    # value 展示给用户(如「这批变更要发布吗?」)
    decision = interrupt({"batch": state["batch"], "question": "approve?"})
    # 用户经 Command.resume("approve") 恢复后:
    # 节点从头重执行,interrupt 直接返回 resume 值
    return {"status": decision}

graph = StateGraph(Schema).add_node(review_node) \
    .add_edge("review_node", END) \
    .compile(checkpointer=MemorySaver())
graph.invoke(inputs, config={"configurable": {"thread_id": "t1"}})
# 用户答复后:
graph.invoke(Command(resume="approve"), config={"configurable": {"thread_id": "t1"}})
注意恢复调用的 config 必须带同一个 thread_id——checkpointer 靠它找到暂停时的检查点(5.2 节)。
Command 本身是通用原语(types.py:758-784):update(改状态)、resume(恢复 interrupt)、goto(跳转节点或发送 Send)三个字段可以组合出「修改状态 + 跳转」等复杂行为。
5.6 与「记忆生命周期」主题的呼应
checkpointer(短期,thread 内快照链)+ Store(长期,跨 thread 命名空间)的分层,与 0-agent-memory 主题的「记忆生命周期」直接呼应:短期记忆随 thread 生命周期存亡,长期记忆按 namespace 沉淀复用。与 helloagents 的 SessionStore(hello_agents/core/session_store.py:19)对比也很有意思:helloagents 的 SessionStore 是消息日志(append 对话历史),而 LangGraph 的 checkpoint 是版本化状态快照——前者回放「说过什么」,后者恢复「系统处于什么状态」。两种「记忆」回答的是不同的问题。
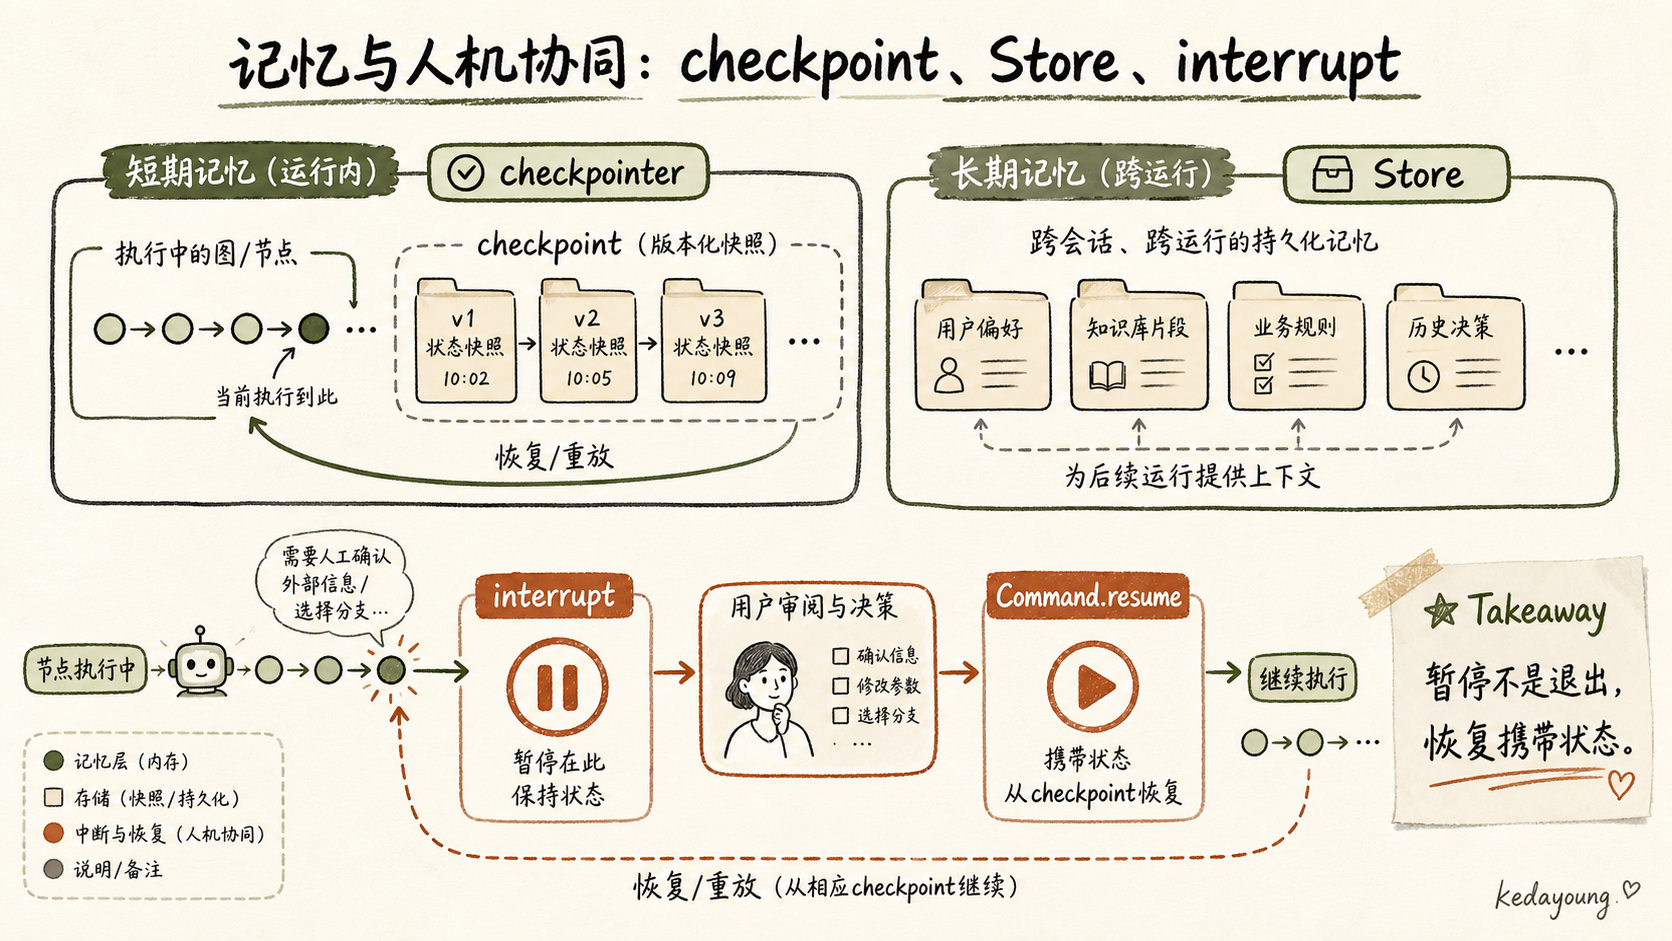
图 5|checkpointer vs Store 分层
thread 内是版本化 checkpoint 快照链(定位键 thread_id),跨 thread 是 namespace 作用域的 Store(定位键 namespace)。
6. 工具与预构建:ToolNode 与 create_react_agent
6.1 ToolNode:把工具接进图的标准方式
ToolNode(prebuilt/tool_node.py:622)是「工具执行」的标准图节点:一个 step 内解析所有 tool_calls,并行执行——同步路径走线程池(tool_node.py:793-826),异步路径走 asyncio.gather(:828-860)。一个 step 多个工具调用,不再需要应用层自己写并行。
6.2 注入体系:ToolRuntime / InjectedState / InjectedStore
工具怎么拿到图和运行时信息?LangGraph 用「注入」而不是「全局变量」:
ToolRuntime(tool_node.py:1663):携带 state、store、stream_writer 的运行时句柄;InjectedState(:1753):把图的当前状态注入工具参数(如把已有消息列表注入工具);InjectedStore(:1829):把长期记忆 store 注入工具。
依赖注入的好处是工具的签名自文档化:看参数注解就知道这个工具需要什么上下文,且可测试性远好于闭包捕获全局。
6.3 tools_condition:路由函数
tools_condition(tool_node.py:1582):判断最后一条 AI 消息是否包含 tool_calls——有则路由到 tools 节点,没有则走到 END。它就是第 2.4 节条件边的一个具体实例。
6.4 create_react_agent 内部搭了一张什么样的图
create_react_agent(chat_agent_executor.py:278)是研究「预构建 API 内部图」的最好样本:
- 无工具:退化为单节点图——只有一个 agent 节点,跑完即 END(
:787-828); - 有工具:
agent+tools两个节点,should_continue条件边在它们之间循环(:831-859;add_node("tools")在:872;add_conditional_edges在:964-968),最后compile(checkpointer, store)(:995-1002)把记忆能力挂上; - v2 模式:每个 tool_call 生成一个
Send任务并行执行(:849-859、:939-950)——这是第 4.5 节 PUSH 任务的真实应用; - 默认状态
AgentState = messages + remaining_steps(:57):消息列表(带add_messagesreducer)+ 剩余步数计数器。
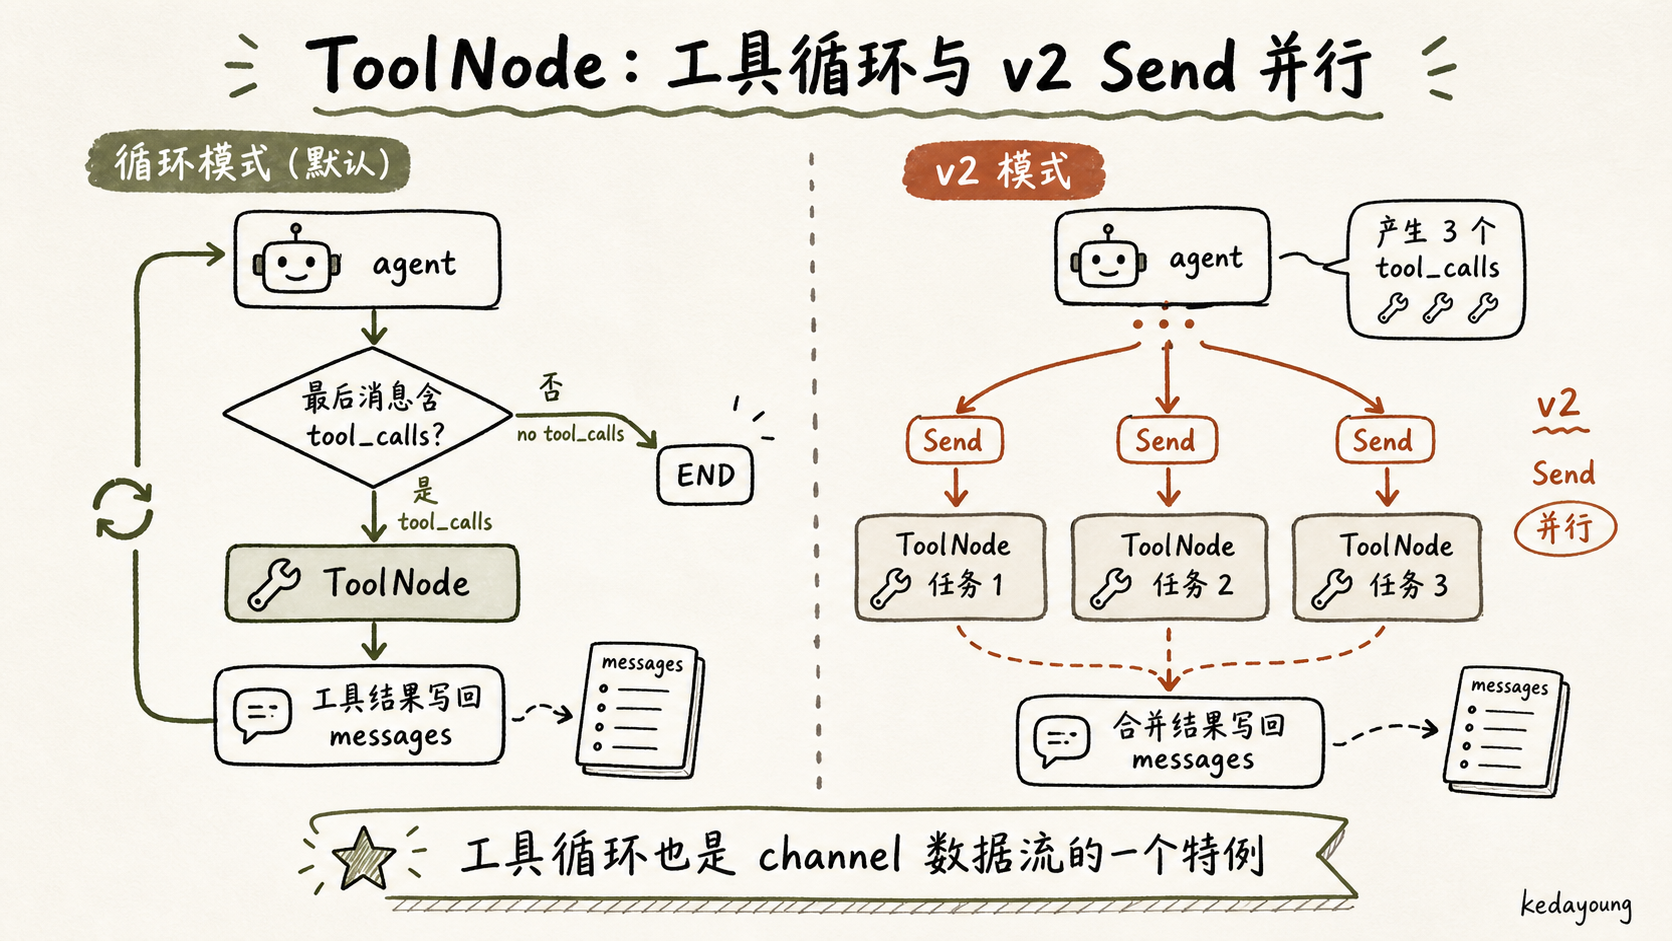
图 6|create_react_agent 内部图
agent ↔ tools 两节点循环 + should_continue 条件边;v2 模式用 Send 把每个 tool_call 并行派发。
6.5 重要演进:create_react_agent 已 deprecated
如实标注:create_react_agent 在 v1.2.10 已标记 deprecated(chat_agent_executor.py:311-318),官方建议迁移到 langchain.agents.create_agent——它在 langchain 包中提供等价的 agent 工厂和更灵活的中介层(middleware)体系。所以本文把它当「解剖样本」而非「推荐 API」使用:它证明了预构建 agent 也只是一张被编译的图,而不是什么特殊魔法。
6.6 回到中心论点:为什么「工具循环」只是数据流的一个特例
把第 6 节放回全文的主线上看:create_react_agent 搭的那张 agent ↔ tools 循环图,本质是什么?是「messages channel 被 AI 消息更新 → should_continue 路由 → tools 节点写回工具结果 → messages 再次更新 → 再次触发 agent」这条 channel 数据流的循环。它和手写 while 循环在语义上等价——但注意等价发生在哪个层面:手写时,循环是代码结构,并行、恢复、暂停都需要你自己实现;在这里,循环是「两个节点订阅了同一个 channel」的数据流事实,于是第 4 节的并行、第 5 节的恢复、interrupt 的暂停,全部免费获得。这就是图模型的杠杆:你声明的是「数据如何流动」,而不是「代码如何执行」;凡是数据流能表达的,引擎的既有能力都能自动覆盖。
7. 设计取舍、局限与可迁移经验
7.1 设计亮点(可迁移的框架设计原则)
1. 图编译成 channel 数据流,执行层只认 channel 更新。 attach_edge(state.py:1537-1561)把高层图声明降维成 channel 写入/订阅。这条设计的分工极其干净:声明层表达意图(分支、并行、join),执行层只有一种机制(channel 更新 + 版本号调度),因此分支/并行/join 不是特例代码,而是同一机制的自然结果。
2. 状态即契约 + 声明式 reducer。 状态是带注解的 TypedDict(state.py:1836-1908),并发写冲突在声明期可预防、运行期显式报错(last_value.py:56-67);合并逻辑是纯函数 reducer(message.py:61)。「契约先行」让图的行为可预期、可调试。
3. 版本化检查点支撑断点续跑、重放与 HITL。 Checkpoint 携带 channel_values + channel_versions + versions_seen(checkpoint/base/__init__.py:92-123、:109-119),恢复的不是「数据」而是「执行状态」——pending writes 重放、节点已见版本、下一步调度,全部可精确重建。
4. 原语小而组合。 interrupt / Command / Send(types.py:759-808)各自极小,组合出 HITL、动态跳转、动态 fan-out 等复杂模式。小原语 + 组合律,是框架可扩展性的来源。
5. 流式执行多通道。 stream/transformers.py:28 的 stream transformer 体系提供多个投影通道——如 run.values 的状态快照流、run.interrupted/run.interrupts 的中断事件流——调用方按需订阅,而不用把状态更新、事件、输出混在一条流里手动分流。
7.2 局限(成文需诚实)
1. 概念负荷高。 channels / reducer / versioning / checkpoint 四层叠加,README 自己都说它是 low-level、适合「advanced needs」(README.md:22-24)。对 80% 的简单 agent,这些概念是纯成本。
2. 并发写默认受限。 普通 key 多写抛 InvalidUpdateError(last_value.py:56-67)——安全但反直觉:你以为在「并发」,实际每个 key 每 step 只能写一次,除非显式声明 reducer。
3. 强依赖静态类型注解。 channel 分派靠 Annotated 类型(state.py:1811-1859)——类型系统是框架的一部分,动态类型语言用户或大模型生成的 schema 可能需要额外小心。同步节点还无法安全取消/超时(state.py:705-712)。
4. 状态必须可序列化。 checkpoint serde 有白名单机制(state.py:1220-1241)——channel 里的值必须能序列化落盘,函数/句柄/非序列化对象不能进状态。这可能是新手第一个「灵异 bug」来源。
5. interrupt resume 后节点整体重执行。 types.py:824 明确「re-executing all logic」——节点内代码必须幂等,副作用(发消息、写外部系统)要小心重复执行。这与其他框架的「挂起/恢复」心智模型不同。
7.3 适用边界(作者判断)
| 任务特征 | 推荐 |
|---|---|
| 单一路径、快速原型 | helloagents 式 while 循环 |
| 需要分支/并行/join/恢复/HITL | LangGraph 图 |
| 「状态必须是可序列化契约」 | 图模型的硬前提——不满足就别上 |
图 7|「图模型 vs 线性循环」决策表
任务特征(路径数量 / 并行需求 / 恢复需求 / 可序列化)→ 框架选择。
一句话:如果你的流程是一条直线,while 循环就是对的工具;当流程长出分叉和汇合,才轮到图模型出场。而「状态必须是可序列化契约」这个前提,决定了图模型的适用域——它不是所有 agent 的银弹,是「有状态、可恢复、可重放」这类问题的专用解。
7.4 系列对照
与系列其他框架形成「控制流哲学」对照:
- helloagents:
while循环——最简单,单路径,无状态恢复; - openai-agents:NextStep 状态机——显式 step 推进,比 while 强但仍是线性状态机;
- MetaGPT:角色消息总线——用消息传递做「多人协作」,控制流隐含在角色交互里;
- llama_index:Workflow 事件——事件驱动的图,与 LangGraph 的 channel 数据流是同一思想谱系的不同实现;
- LangGraph:channel 数据流——声明式图编译成 channel 读写,并行/join/恢复是执行引擎内建能力。
五者回答的是同一个问题:「agent 的控制流应该由什么承载?」答案从「代码里的循环」到「显式的并发数据流」,复杂度递增,能力也随之递增。
结语
回到开头的问题:LangGraph 比 while 循环强在哪?强在它把「控制流」从代码里搬了出来,搬进了可编译、可版本化、可重放的数据结构。StateGraph 声明意图,compile 把意图编译成 channel 读写,Pregel 按版本号调度执行,checkpointer 让每一步都可回退——分支、并行、join、HITL 不再是你要手写的控制逻辑,而是这套数据流上的组合结果。
代价同样真实:四层抽象的概念负荷、对静态类型和可序列化的强依赖、interrupt 重执行的陷阱。所以最后的建议是:先诚实评估你的任务是否需要图模型,再决定要不要为此付学费。而如果你决定进入,理解「图只是表象,channel 数据流才是本体」这句话,能帮你省掉大量对着文档猜行为的时间——因为几乎所有 LangGraph 的「为什么」,都能在这条编译链路上找到答案。
附录 A:证据清单(draft-v1 已核对项打 ✓)
| 断言 | 证据位置(相对 0-agent-framework/20260810-langgraph/) | 复核 |
|---|---|---|
| 版本 | libs/langgraph/pyproject.toml:7(v1.2.10) | ✓ |
| StateGraph / compile / CompiledStateGraph | libs/langgraph/langgraph/graph/state.py:130、:1164、:1391-1392 | ✓ 已读 |
| add_node / add_edge / 条件边 | state.py:662、:915、:969 | ✓ 已读(终审复读) |
| 边编译成 channel | state.py:1537-1561 | ✓ 已读 |
| 注解→channel 规则 | state.py:1836-1908 | ✓ 已读(终审复读) |
| LastValue 并发限制 | libs/langgraph/langgraph/channels/last_value.py:56-67 | ✓ 已读 |
| add_messages reducer | libs/langgraph/langgraph/graph/message.py:61、:372-373 | ✓ 已读(终审复读) |
| MessageGraph deprecated | graph/message.py:312-316 | ✓ 已读 |
| Pregel 循环 | libs/langgraph/langgraph/pregel/_loop.py:158、:599-681、:683-726 | ✓ 已读(终审复读) |
| superstep 任务构造 | libs/langgraph/langgraph/pregel/_algo.py:392-513 | ✓ 已读(终审复读) |
| 并行执行 | libs/langgraph/langgraph/pregel/_runner.py:176 | ✓ 已读(终审复读) |
| 屏障 | libs/langgraph/langgraph/channels/named_barrier_value.py:13-14 | ✓ 已读(终审复读) |
| Checkpoint 结构 | libs/checkpoint/langgraph/checkpoint/base/__init__.py:92-123、:176 | ✓ 已读 |
| Store 长期记忆 | libs/checkpoint/langgraph/store/base/__init__.py:708、:733 | ✓ 已读(终审复读) |
| interrupt / Command / Send | libs/langgraph/langgraph/types.py:759-831 | ✓(:758-784、:811-831 已读) |
| ToolNode / create_react_agent | libs/prebuilt/langgraph/prebuilt/tool_node.py:622、chat_agent_executor.py:278 | ✓ 已读(终审复读) |
| create_react_agent deprecated | chat_agent_executor.py:311-318 | ✓ 已读 |
| README 定位 | libs/langgraph/README.md:22-24 | ✓ 已读 |
| helloagents while 循环(跨仓库) | helloagents 克隆 hello_agents/agents/react_agent.py:166 | ✓ 已读 |
| helloagents SessionStore(跨仓库) | helloagents 克隆 hello_agents/core/session_store.py:19 | ✓ 已读 |
附录 B:素材缺口与待办(draft-v1 更新)
- [x] 复核克隆版本 v1.2.10(
libs/langgraph/pyproject.toml:7)——✓ 已核实; - [x] 核对
create_react_agent的 deprecated 状态(chat_agent_executor.py:311-318)——✓ 已核实,建议迁移langchain.agents.create_agent; - [ ] 未验证(环境受限):最小
interrupt/resume示例——本机 Python 3.9.6 不满足 langgraphrequires-python >= 3.10(pyproject.toml:10),无法运行;draft 中「resume 后节点整体重执行」(types.py:824)目前仅依据源码 docstring,发布前请在满足版本的环境运行一次确认; - [x] 附录 A 全部条目已逐条复读确认(终审);
- [x] 6 张结构图已替换为正式图示,并与正文措辞对齐;
- [ ]
vllm-project/semantic-router(路由主题候选)与 langgraph 的关系可作跨主题引用,待0-reasoning-routing篇定纲后交叉核对。