代码基线:legacy Python server 克隆 commit
ff19ffe(下称 server),TypeScript Agent SDK 克隆 commit0ebe141(下称 letta-code)。所有file:line以此为准;为可读性,正文中的行号省略文件前缀目录20260810-letta/。
引言
letta 把「记忆」从「喂给模型的外部数据」改造成了「agent 自身状态的一部分」:记忆有数据结构(blocks)、有预算(字符上限)、有渲染(进 prompt 的样子)、有编辑工具(agent 自己改自己)。这与「外部事实库」路线(mem0)和「会话即文件」路线(pi)根本不同。本文按六步拆完整条路线:MemGPT 思想遗产与两仓库现状(§1)→ core memory 与 external context 分层(§2)→ 外部记忆只注入「存在感」(§3)→ agent 用工具自我编辑记忆(§4)→ letta-code 把记忆投影成 git 文件(§5)→ 对照与可迁移经验(§6)。
1. MemGPT 遗产与 letta 的现状:一个思想、两个仓库
2017 年之后,大模型研究里最持久的拷问之一是:一个上下文窗口有限的模型,如何表现出「记得住、忘不掉、还能长大」的智能体?MemGPT 论文给出的答案今天听起来依然很操作系统——把 LLM 的上下文窗口当作工作内存,把外部存储当作磁盘,由 agent 自己在两者之间「分页换入换出」,而不是把所有信息一次性塞进窗口(本系列研究笔记对 MemGPT 分页类比的梳理见 notes-topic-research.md:200-209)。letta 是 MemGPT 的后续项目,它把这个思想落实成了一套可运行的 agent 状态机制:常驻的 core memory blocks、按需检索的 archival / recall 外部记忆,以及 agent 通过工具自我编辑记忆的完整回路。
但在看代码之前,必须先讲清楚一个容易让人困惑的现状:letta 目前是一个思想、两个仓库。
- legacy Python server(本目录,包
letta/,commitff19ffe):实现完整记忆分层服务端——core blocks、archival / recall 存储与检索、记忆编辑工具执行器、REST API。这是本文的证据主体。 letta-code/(TypeScript Agent SDK / CLI,commit0ebe141):面向 coding agent 的客户端 harness,核心创新是 MemFS——把记忆投影成 git-backed 的本地文件。
为什么拆成两个?server 仓库的 README 自己给了答案,它在开头的 NOTE 里直言:「This repository contains the legacy Letta server ... Active development has moved to the [Letta Agent repo]」(server README.md:8-9)。也就是说,开发重心已经明确迁移到 letta-code,server 侧被保留为 API 服务端的兼容形态。这带来一个选型信号:要「可自托管的记忆分层 API server」,legacy server 仍是开源代码里最完整的实现;要「本地 coding agent 的记忆 harness」,应当看 letta-code。
两仓库各自的「身位」可以先用一张表钉死,后文不会再反复切换视角:
| 维度 | legacy server(Python) | letta-code(TypeScript) |
|---|---|---|
| 定位 | 记忆分层服务端 + REST API | 客户端 Agent SDK / CLI |
| core memory | Memory / Block 模型 + XML 渲染 | persona/human 两个默认 block |
| 外部记忆 | archival(Passage/Archive)+ recall(hybrid 检索) | recall 子代理走 letta messages search |
| 记忆编辑 | memory 工具族,server 执行器运行 | 直接编辑 MemFS 文件 + git commit |
| 演进状态 | legacy,兼容维护 | 活跃开发(README 明示) |
图 1|两仓库分工:核心圈的记忆分层与外围的 letta-code
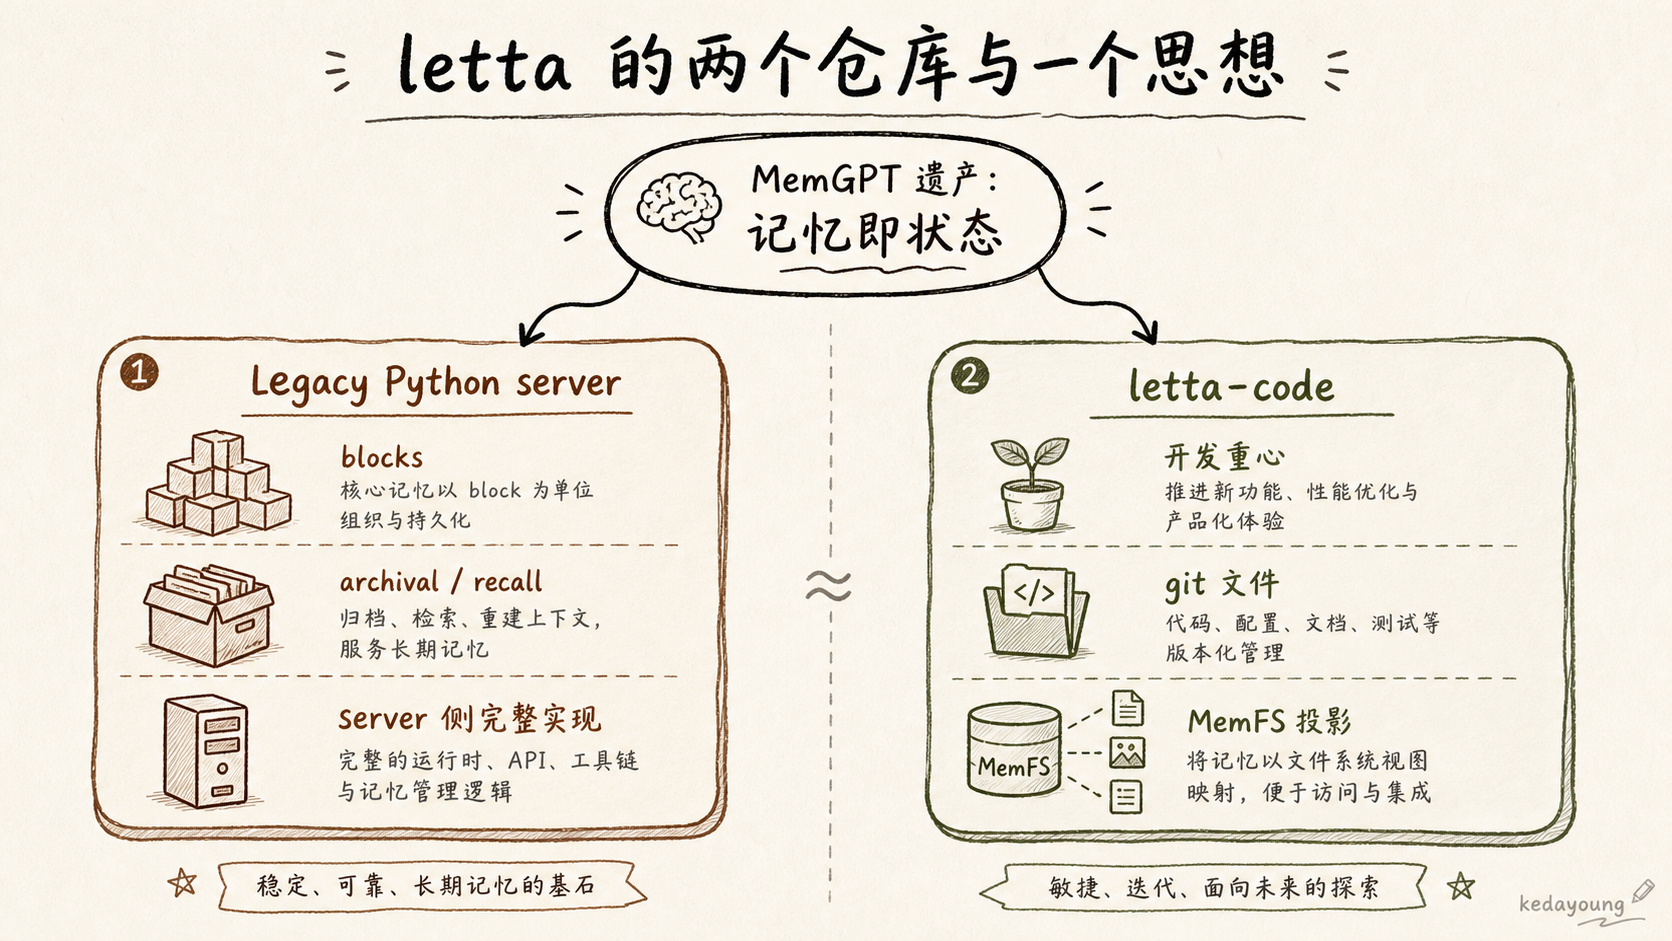
图注:记忆分层机制(核心圈)在 server 里实现得最完整,但开发重心正移向外圈——letta-code 把记忆的存储隐喻从「数据库 blocks」换成「git 文件」(server README.md:8-9)。
图 1 的读法是:记忆分层本身(核心机制)在 server 里实现得最完整,但开发重心正从内圈移向外圈——letta-code 在重做同一件事,只是把记忆的存储隐喻从「数据库 blocks」换成了「git 文件」(第 5 节)。后文凡引用「server 的记忆机制」,指的都是内圈;凡说「新一代实现」,指的是外圈。
MemGPT 论文的「操作系统式分页」是思想源头,但分页只是隐喻——letta 真正实现的是三件更具体的事:常驻什么、暴露什么、怎么改——core memory 常驻(§2)、外部记忆只暴露元信息(§3)、模型用工具自改(§4)。这三件事构成的闭环,比「分页」这个隐喻更值得带走;§5-§6 落到选型:文件化记忆(MemFS)与数据库化记忆(server)分别适合什么场景、哪些设计可以直接抄。
一句话概括本文的中心论点:letta 把记忆做成 agent 状态的一部分,而不是外部组件。 Memory(core memory blocks)常驻上下文且有字符预算;archival / recall 等外部记忆默认只注入计数不注入内容(<memory_metadata>);agent 通过 memory、core_memory_append、archival_memory_insert 等工具主动读写记忆。这与 mem0「外部事实库 + add/search」是记忆归属上的根本分歧(详见第 6 节对照),而它的代价同样真实:状态管理复杂度上升,编辑效果要延迟到下一轮才生效。下面逐层拆开。
2. 记忆分层:core memory 与 external context
MemGPT 的核心/archival/recall 三级记忆在 letta 里首先物化为两类东西:常驻的 core memory 与 按需的 external context。分界线在代码里非常清楚。
2.1 core memory:常驻上下文的 blocks
core memory 的数据结构是 Memory 类(letta/schemas/memory.py:68),它只有两类字段:
# letta/schemas/memory.py:77-80
blocks: List[Block] = Field(..., description="Memory blocks contained in the agent's in-context memory")
file_blocks: List[FileBlock] = Field(
    default_factory=list, description="Special blocks representing the agent's in-context memory of an attached file"
)
blocks 就是那个「常驻」的部分——每次对话都会以某种渲染形式进入上下文。单个 Block(letta/schemas/block.py:67)本身很薄,关键字段都定义在父类 BaseBlock(:13)上:
# letta/schemas/block.py:19-39
value: str = Field(..., description="Value of the block.")
limit: int = Field(CORE_MEMORY_BLOCK_CHAR_LIMIT, description="Character limit of the block.")
label: Optional[str] = Field(None, description="Label of the block (e.g. 'human', 'persona') in the context window.")
read_only: bool = Field(False, description="Whether the agent has read-only access to the block.")
description: Optional[str] = Field(None, description="Description of the block.")
注意 limit 字段——字符上限是块的一等公民,每个 block 都自带预算,不是事后统计。默认值指向 CORE_MEMORY_BLOCK_CHAR_LIMIT = 100000(letta/constants.py:435),旁边还有两个更紧的默认:CORE_MEMORY_PERSONA_CHAR_LIMIT = 20000、CORE_MEMORY_HUMAN_CHAR_LIMIT = 20000(:433-434)。
默认的块是 ChatMemory(letta/schemas/memory.py:840),构造时固定生成两个 block(:845-854):
def __init__(self, persona: str, human: str, limit: int = CORE_MEMORY_BLOCK_CHAR_LIMIT):
    ...
    super().__init__(blocks=[Block(value=persona, limit=limit, label="persona"),
                             Block(value=human, limit=limit, label="human")])
DEFAULT_BLOCKS = [Human(value=""), Persona(value="")](letta/schemas/block.py:131)进一步把「persona + human」定为出厂配置——一个块描述 agent 自己,一个块描述它服务的对象。这就是为什么几乎所有 letta 文档里你都会看到这两个词:它们是 core memory 的最小骨架。
Memory 还有第二类字段 file_blocks(memory.py:78):「Special blocks representing the agent's in-context memory of an attached file」——当 agent 挂载了某个外部文件(比如一份长文档)时,文件内容会以 file block 的形式参与常驻记忆。这补充了 core memory 的另一面:常驻的不只是「关于自己的事实」,也可以是「正在处理的对象」。加上 read_only 标志(block.py:36,渲染时体现为 <metadata> 里的 - read_only=true,memory.py:162-163),core memory 实际上支持四种语义的组合:内容(常驻事实 vs 文件对象)× 权限(可写 vs 只读)。persona/human 默认可写,挂载的文件通常只读——「自己的记忆可改,外部材料只能读」,这个默认权限边界本身就说明设计者对记忆归属的态度。
2.2 渲染:core memory 如何进入上下文
core memory 不是数据库里躺着的数据,它要变成 prompt。Memory.compile()(letta/schemas/memory.py:688)承担这件事,按配置走三种渲染模式(分发逻辑见 :705-712):
- standard(
_render_memory_blocks_standard,:143):输出<memory_blocks>XML——「The following memory blocks are currently engaged in your core memory unit:」,每个 block 以标签包起来(:149-173)。实际的渲染格式值得完整看一遍,因为它决定模型每一轮能看到记忆的哪些侧面:
  <memory_blocks>
  The following memory blocks are currently engaged in your core memory unit:

  <persona>
  <description>
  ...(persona block 的描述)
  </description>
  <metadata>
  - chars_current=312
  - chars_limit=100000
  </metadata>
  <value>
  ...(persona block 的实际内容)
  </value>
  </persona>
  ...
  </memory_blocks>
注意 <metadata> 里的两个字段:chars_current 与 chars_limit(memory.py:164-165)——每个 block 当前的字符占用和预算上限被直接渲染进了 prompt。模型不仅能读到记忆内容,还能读到「自己在这块记忆上还剩多少空间」,这是第 6 节「预算显式化」经验的直接证据。如果 block 是 read_only,还会多一行 - read_only=true(:162-163),模型据此知道这块不能改。
- line-numbered(
_render_memory_blocks_line_numbered,:175):同样输出<memory_blocks>,但<value>里每行带{i}→行号前缀(:197-198),并且额外渲染一个<warning>段,内容是CORE_MEMORY_LINE_NUMBER_WARNING(:194)——提醒模型行号只是显示坐标、调用编辑工具时不要带上。行号是给模型看的「定位坐标」,也是第 4 节工具拒绝行号前缀的伏笔; - git(
_render_memory_blocks_git,:205):结构完全不同——不再有<memory_blocks>根标签,而是把system/persona渲染进一个专门的<self>段,并输出<projection>$MEMORY_DIR/system/persona.md</projection>(:224-225),其余system/*block 挂到<memory>下嵌套标签(:229起)。
这个 git 模式是全文一个重要的伏笔:它说明「把记忆当作文件系统里的文件来投影」的想法在 server 侧就已经以渲染层形态存在了,letta-code 的 MemFS(第 5 节)是把它升级成了真正的 git-backed 文件系统。渲染层面的区别(谁渲染、谁存储、输出什么标签)正是后文「三种记忆模式」对比的源头。
2.3 external context:archival 与 recall
core memory 之外是「按需」的外部记忆,分两路。
archival(长期事实库) 的存储单元是 Passage(letta/schemas/passage.py:35):text + embedding + tags。embedding 被强制补零到 MAX_EMBEDDING_DIM = 4096(letta/constants.py:93),由 pad_embeddings validator(passage.py:49-77)在 pgvector 场景下执行,目的是让不同来源的向量维度一致,方便统一检索。容器是 Archive(letta/schemas/archive.py:24),docstring 直接写明「a collection of archival passages that can be shared between agents」——archival 不是某个 agent 的私有状态,而是组织级可共享的资产,这是它和 core memory(agent 私有)的本质区别之一。
recall(对话历史) 走的是另一条路:消息自动持久化。每次对话的消息由 create_many_messages_async 批量写入数据库(letta/services/message_manager.py:477 起),同时后台任务 _embed_messages_background(:605 起)把消息文本送去 Turbopuffer 生成 embedding 入库——也就是说,recall 是「自动发生的」,agent 不需要主动保存任何东西,历史就在那里。
为什么 recall 检索要默认 hybrid 而不是纯向量?因为对话历史的查询很杂:有些是「上周我们讨论过什么」(语义,向量擅长的),有些是「有没有人提到过 CORE_MEMORY_BLOCK_CHAR_LIMIT 这个常量名」(精确字符串,全文检索擅长的)。纯向量会漏掉精确匹配,纯 FTS 会漏掉同义表达。hybrid 双路召回、RRF 融合(message_manager.py:1340-1342 的结果字段里 fts_rank / vector_rank / rrf_score 三值并存)就是为了两头都接住。这个默认值写在了方法签名里(:1147 的 search_mode: str = "hybrid"),意味着除非显式覆盖,recall 检索永远是双路并行的。
于是分层图就完整了:
图 2|记忆分层全景:常驻的 core memory 与按需的 external context
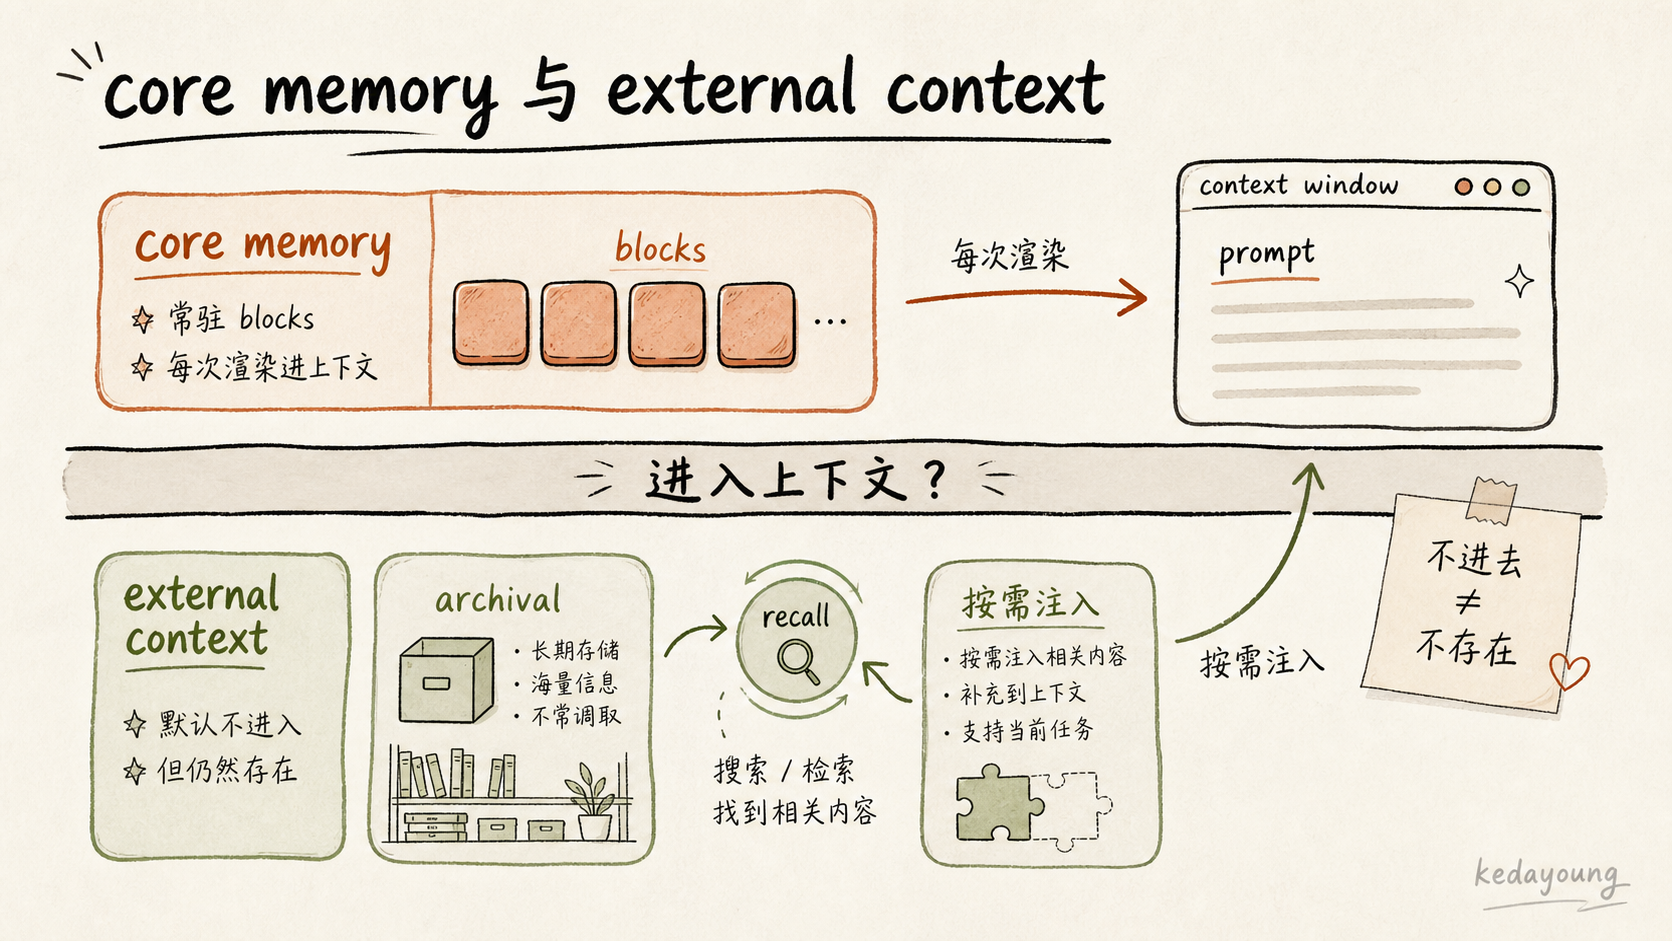
图注:分界线的判据只有一个——进不进上下文:core memory 每次渲染进去,archival / recall 默认不进去(但「不进去」不等于「不存在」)。
分界线的判据只有一个:进不进上下文。core memory 每次都会渲染进去;archival / recall 默认不进去。但「不进去」不等于「不存在」——第 3 节看 letta 如何让 agent「知道它们存在」。
3. 渐进披露:外部记忆只注入「存在感」
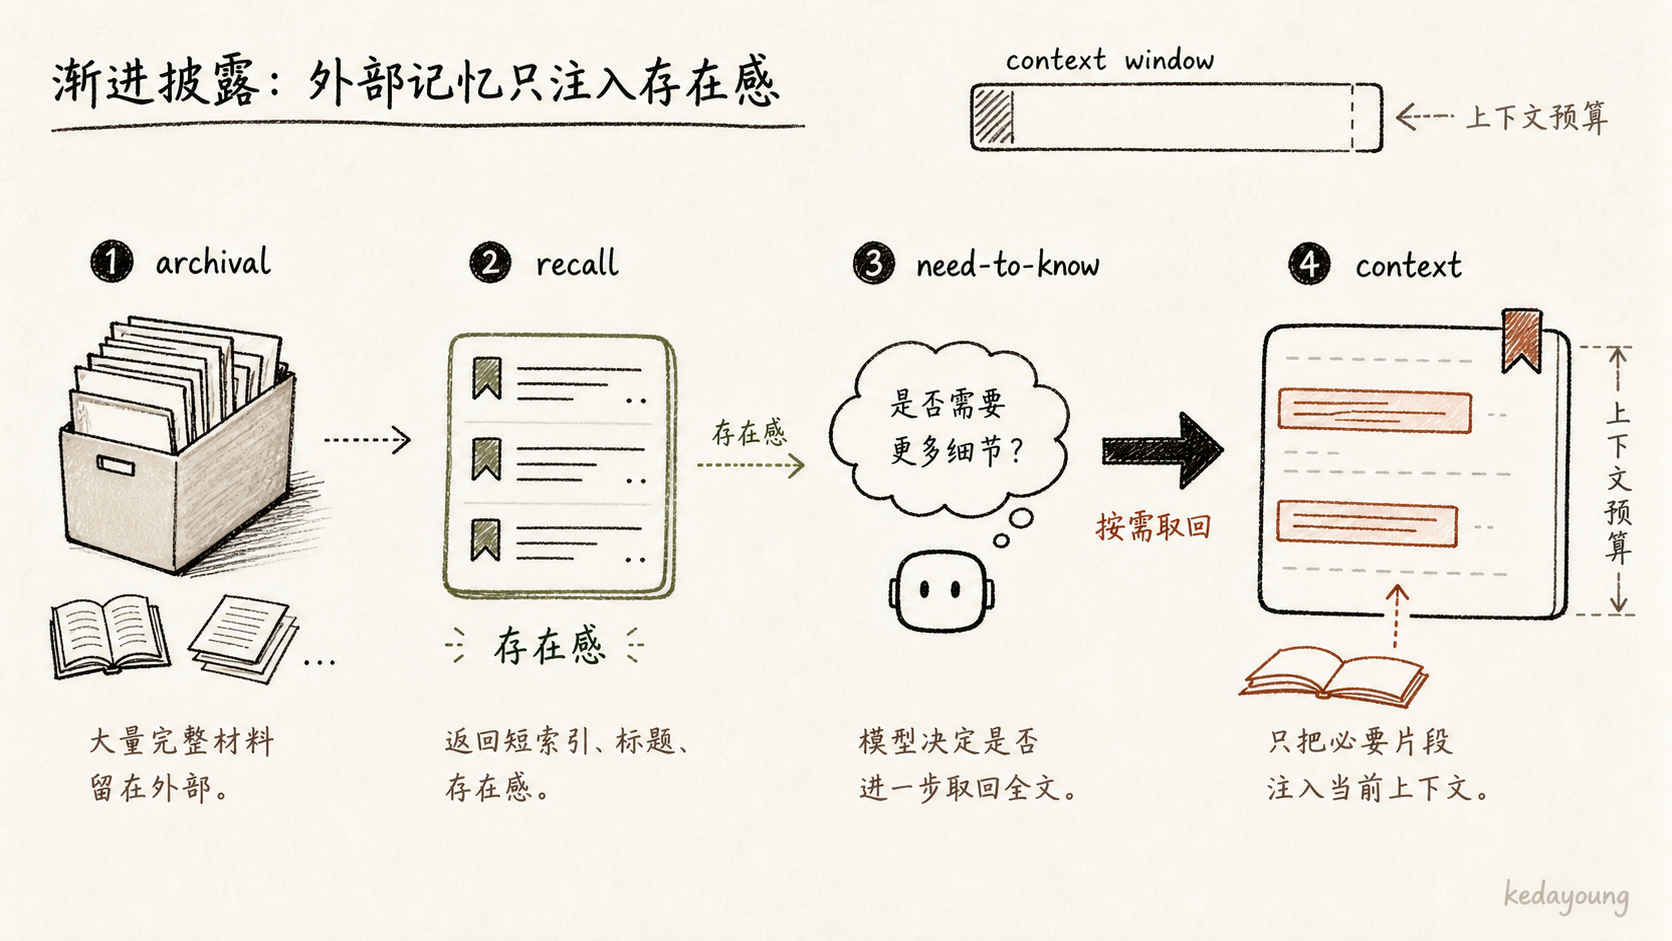
如果 archival / recall 的内容不进上下文,agent 怎么知道还有东西可查?letta 的答案是:注入一个轻量的存在感清单。
核心函数是 compile_memory_metadata_block(letta/prompts/prompt_generator.py:26),它生成一个 <memory_metadata> 块,里面只放计数,不放内容。函数 docstring 里就给出了真实输出样例(prompt_generator.py:55-63):
<memory_metadata>
- AGENT_ID: agent-123
- CONVERSATION_ID: default
- System prompt last recompiled: 2024-01-15 09:00 AM PST
- 42 previous messages between you and the user are stored in recall memory (use tools to access them)
- 156 total memories you created are stored in archival memory (use tools to access them)
- Available archival memory tags: project_x, meeting_notes, research, ideas
</memory_metadata>实现与样例一一对应(:69-89):recall 消息数(:74)、archival 条目数(仅在 >0 时出现,:78-81)、archival tags(:84-85)。注意 docstring 的措辞——「This helps the agent understand what information is available through its tools」:这个块的目的不是提供信息,而是告诉 agent「你有哪些信息可查、怎么查(用工具)」。
也就是说,agent 每一轮都知道「我有 12,847 条历史消息、203 条 archival、其中 17 个 tag」——知道有多少、有什么分类,但看不到内容。要看到内容,它必须主动调用检索工具(第 4 节)。这正是「渐进披露(progressive disclosure)」:常驻的是索引式的元信息,内容按需加载。
把第 2 节的渲染和第 3 节的元数据拼起来,模型每一轮真正看到的是这样一个「记忆全景」:core memory 的完整内容(带字符预算)、archival/recall 的计数与 tag、以及一整套可调用的记忆工具。它缺的只有一件事——外部记忆的正文,而那恰恰需要它自己动手去取。
这个设计有一个很容易被低估的含义:它把「发现」的成本从系统侧转移给了模型侧。系统不再负责判断「哪条记忆此刻相关」然后硬塞进 prompt——那正是传统 RAG 的活,也是记忆预算的失控点;相反,系统只保证「agent 不会忘记自己还有记忆」,至于查不查、查什么,由模型基于当前任务自主决定。用通俗的话说:系统负责让 agent 记得「自己有档案馆」,agent 负责决定「什么时候去档案馆」。
举个具体的决策场景。假设 agent 收到一条消息:「我们上次说好的 API 命名方案你还记得吗?」此刻它看到的 metadata 是「42 条历史消息、156 条 archival、tags 里有 project_x」。模型面对的是一个真实的判断题:直接凭 core memory 里的摘要回答,还是先调 conversation_search 翻历史?如果它判断「上次说好」这件事太具体、core memory 里没有,就会先检索再回答;如果它判断摘要已足够,就直接答。两种选择都没有系统干预,而 metadata 里的计数(42 / 156 / tags)是模型做这个判断的唯一线索——计数让它知道「有得查」,tags 让它知道「查什么关键词」。这就是渐进披露的完整运转:元信息给足「判断依据」,正文留到「决定之后」。
与 pi 的 skills 渐进披露是同构的,而且这次可以给出 pi 源码的一手证据:pi v0.84.1 的系统提示只常驻每个 skill 的 <name> / <description> / <location> 三个字段(packages/coding-agent/src/core/skills.ts:350-356),正文由模型用 read 工具按需加载(:342-345),官方文档直接写明「This is progressive disclosure: only descriptions are always in context, full instructions load on-demand.」(docs/skills.md:71)。letta 常驻的是计数与 tag(§3),pi 常驻的是索引元数据——而 letta-code 的路径索引(§5.3)是更接近 pi 的形态。三者在不同层实现了同一句设计格言:上下文预算有限,发现能力要常驻,内容要按需。
代价也在这里。不注入内容,模型就必须在「值不值得检索」上做判断,而判断就会出错:该查没查、不该查乱查。系统把预算省下来了,把错误率的风险转移给了 agent 的行为质量。这是「上下文预算」与「发现能力」之间一条真实的权衡曲线,后面第 6 节会回到它。
4. self-editing memory:agent 用工具改自己的记忆
第 2、3 节回答了「记忆是什么、怎么进来」,这一节回答最特别的问题:记忆怎么被改? letta 的回答是——agent 自己改,通过一套专门设计的工具。
4.1 工具集:docstring 即 schema
记忆编辑工具的 schema 集中在 letta/functions/function_sets/base.py。这套代码有一个极有特色的写法:函数体大多是 raise NotImplementedError,真正的「工具定义」是 docstring——docstring 会被编译成给 LLM 看的工具描述。换句话说,工具的契约写在给模型读的散文里,而不是给机器读的类型签名里。这是 letta 工具系统的一个核心设计选择:工具描述的可读性优先,模型能理解,才能正确调用。
核心工具如下(行号以 letta/functions/function_sets/base.py 为准):
| 工具 | 位置 | 职责 |
|---|---|---|
memory | :10 | omni 工具,一个入口覆盖全部编辑:create / str_replace / insert / delete / rename 子命令(:27-32) |
conversation_search | :87 | 混合搜索对话历史(recall) |
archival_memory_insert | :164 | 写入长期记忆,「permanent and searchable by semantic similarity」 |
archival_memory_search | :194 | 语义检索 archival,「ranked by semantic relevance」 |
core_memory_append | :246 | 向某个 core block 追加内容 |
core_memory_replace | :263 | 精确字符串替换 core block 内容 |
memory_replace | :311 | 通用精确替换(面向带行号渲染的记忆) |
memory_insert | :391 | 在某行之后插入新行 |
memory 这个 omni 工具的 docstring 值得单独看一眼——它是整套工具语汇的浓缩(base.py:23-63),尤其是参数命名:
Args:
    command (str): The sub-command to execute. Supported commands:
        - "create": Create a new memory block
        - "str_replace": Replace text in a memory block
        - "insert": Insert text at a specific line in a memory block
        - "delete": Delete a memory block
        - "rename": Rename a memory block
    path (Optional[str]): Path to the memory block (for str_replace, insert, delete)
    ...
Examples:
    memory(agent_state, "str_replace", path="/memories/user_preferences",
           old_string="theme: dark", new_string="theme: light")
    memory(agent_state, "insert", path="/memories/notes",
           insert_line=5, insert_text="New note here")
    memory(agent_state, "create", path="/memories/coding_preferences",
           description="The user's coding preferences.",
           file_text="The user seems to add type hints to all of their Python code.")
注意 docstring 里的 path="/memories/user_preferences" 这种写法:server 侧的记忆工具已经用「路径」隐喻来寻址 block了——尽管此时 block 还只是内存里的对象,不是文件。这个隐喻在第 5 节 letta-code 的 MemFS 里被字面化:路径变成真实的目录与 .md 文件。可以认为 server 的工具层早就为「文件化记忆」铺好了语汇,letta 只是把隐喻兑现成存储。
两个细节值得展开,它们体现了这套工具设计里「防呆」的思考:
第一,拒绝行号前缀。 第 2 节提到 line-numbered 渲染会给每行加 {i}→ 前缀,那是给模型看的显示坐标。但当模型回写时,如果它把行号一起写进 old_string,就会匹配失败甚至产生脏数据。所以 memory_replace 显式拒绝带行号的输入(:345-352):
if bool(re.search(r"\nLine \d+: ", old_string)):
    raise ValueError(
        "old_string contains a line number prefix, which is not allowed. "
        "Do not include line numbers when calling memory tools (line numbers are for display purposes only)."
    )
memory_insert 同样有这一层防御(:412-419)。显示格式与编辑输入被刻意隔离——模型看到的是带坐标的文本,写回去的必须是纯文本。这是「人机界面」和「机器接口」分离的一个小而美的实例。
第二,编辑是原子化的字符串操作,不是重写。 core_memory_append 追加、memory_replace 替换、memory_insert 插行,全部是细粒度的原地修改,而非「把整个 block 拿出来改完放回去」。这既减少了模型的输出长度(不用重复整段记忆),也降低了「改一个字符毁掉整块记忆」的风险——代价是模型必须精确地知道要改哪一行、哪一段,于是又回到行号渲染的必要性。
4.2 执行与暴露:server 执行器 + REST API
这些工具由 server 的执行器(core_tool_executor)实际运行,同时通过 REST API 对外暴露。letta/server/rest_api/routers/v1/agents.py 的 :1221-1369 区间提供了完整的 core-memory 管理端点:
GET /agents/{agent_id}/core-memory/blocks与GET .../blocks/{block_label}(:1236、:1221):读取 block;PATCH /agents/{agent_id}/core-memory/blocks/{block_label}(:1268):修改 block;POST /agents/{agent_id}/recompile(:1291):重新编译 system prompt;PATCH .../blocks/attach/{block_id}/detach/{block_id}(:1355、:1369):动态挂载/卸载 block。
注意 PATCH 修改 block 之后会触发 rebuild_system_prompt_async(:1286)——修改不会在当前轮生效,而是要等 system prompt 重新编译。这是第 5 节「写作给未来的自己」的 server 侧机制根源:记忆编辑的生效时机是「下一次编译」,不是「立刻」。
把工具集、渲染和执行器串起来,一次「agent 自我编辑记忆」的完整流程长这样:
- 感知:agent 从渲染好的
<memory_blocks>(§2)和<memory_metadata>(§3)里,知道自己有哪些记忆、各占多少字符、外部还有多少可查; - 定位:如果需要回忆细节,调用
conversation_search或archival_memory_search把内容取回来(混合检索,message_manager.py:1147); - 决策:判断哪条记忆过时、缺失或冗余——这个判断完全由模型做出,没有任何系统侧的提炼器;
- 修改:调用
memory(或core_memory_append/memory_replace等)精确修改对应 block,注意不能带行号前缀(base.py:345-352); - 等待生效:修改后的 block 要等下一次 system prompt 重新编译(显式
recompile或新一轮对话)才会真正影响行为——「写作给未来的自己」。
这套流程里,系统只提供「感知材料 + 编辑工具 + 生效机制」,剩下的每一步判断都属于模型。这就是 4.3 要展开的设计含义。
图 3|agent 自我编辑记忆的完整回路
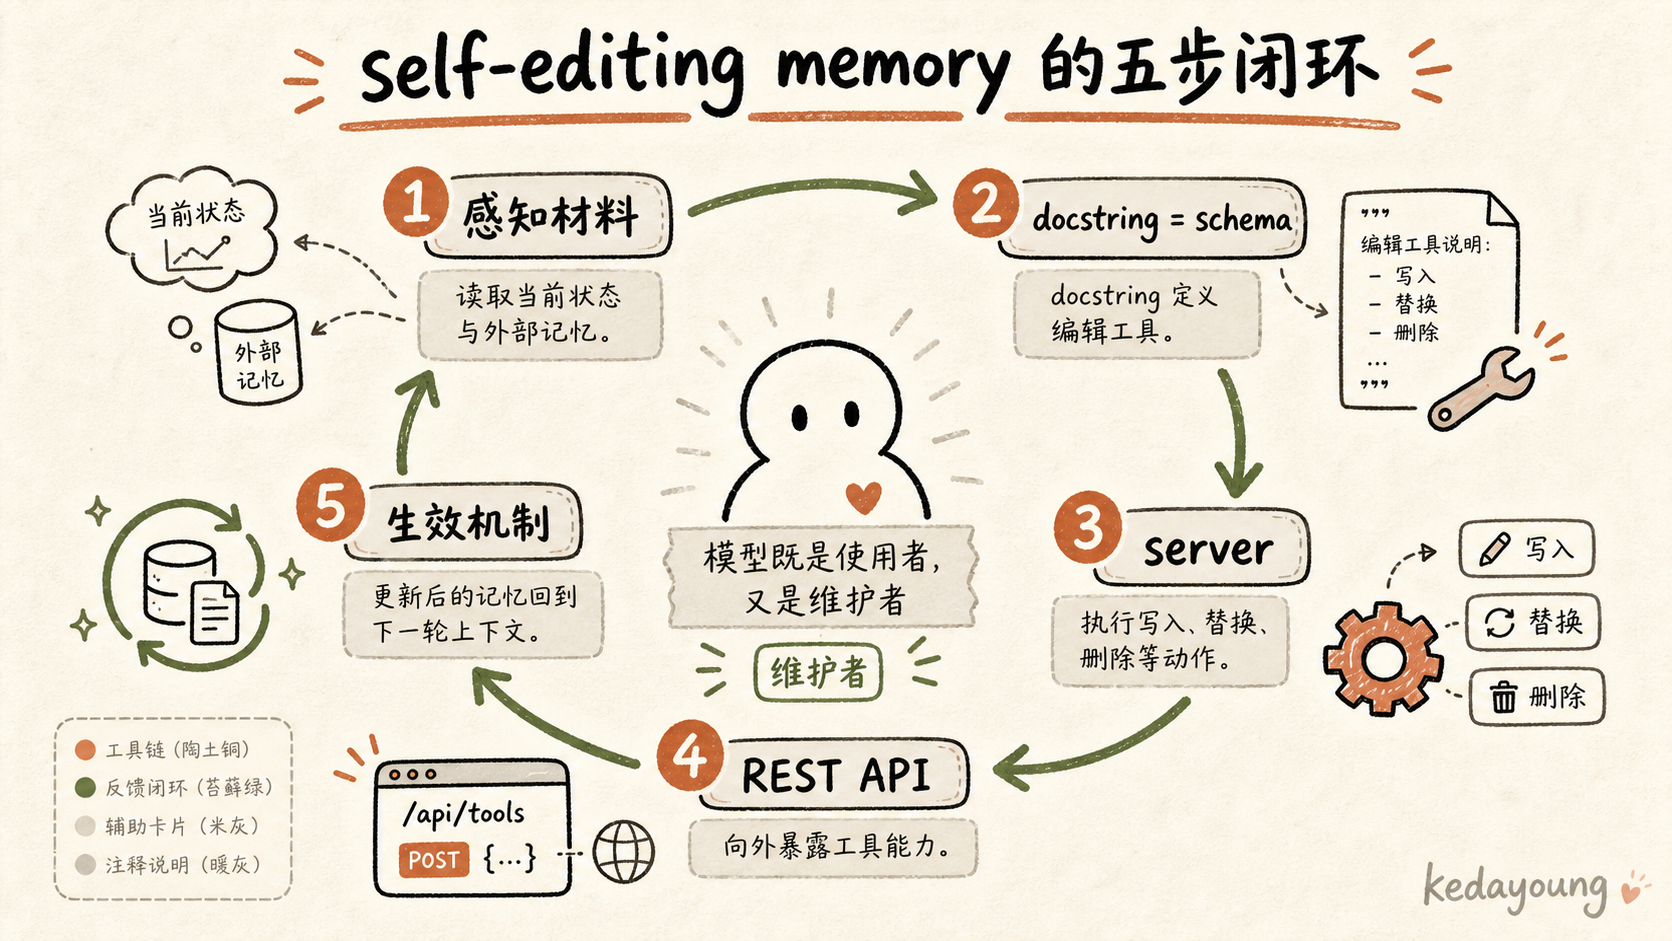
图注:系统只提供「感知材料 + 编辑工具 + 生效机制」,五个环节里除工具执行外没有系统侧提炼逻辑——模型既是记忆的使用者,又是维护者。
4.3 设计含义:模型既是记忆的使用者,又是维护者
把这一节的工具集和第 3 节的渐进披露拼起来,letta 的记忆模型就完整了:记忆的生命周期——写入、修改、删除、检索——全部由「模型决策 + 工具约束」实现,系统不预置任何提炼管线。 没有「每隔 N 轮自动总结记忆」的定时任务,没有「记忆评分器」,没有后台压缩器。有的只是:记忆以 blocks 形式常驻、以计数形式被知晓、以工具形式被编辑,而决定「什么时候记、记什么、忘什么、查什么」的,是模型每一轮的工具调用。
这既是 letta 最激进的地方,也是它最诚实的边界。激进在于:它把「记忆管理」这件事整体外包给了模型本身——模型的记忆能力 = 模型调用记忆工具的能力,于是模型越强,记忆越好,系统侧几乎不用写任何智能逻辑。与经典 RAG 对照会更清楚:RAG 的管线是「系统侧写好检索 → 每轮自动注入 top-k 结果」,记忆的「相关性判断」由 embedding 距离和系统代码完成,模型只是被动接收;letta 则把这个判断完全交给模型——系统不再替模型决定「该看哪条记忆」,只保证记忆「可被看到、可被修改」。代价是,记忆质量的上限 = 模型自律的下限:模型要记得去查、查得对、改得准、不越界。系统侧省掉的每一条提炼逻辑,都转化成了模型行为上必须守住的纪律。
5. letta-code 的 MemFS:把记忆投影成 git 文件
如果说第 2-4 节是「记忆分层的经典实现」,那 letta-code 就是 letta 对同一个问题的重新实现——把记忆从「数据库里的 blocks」变成「文件系统里的文件」。这正是第 1 节说的开发重心迁移的真正含义:不是把 server 的 Python 代码翻译成 TypeScript,而是换了一套记忆的底层隐喻。
5.1 默认 blocks 与 MemFS 目录
记忆的「骨架」没有变。letta-code/src/agent/memory.ts:16 定义了默认 block 标签:
export const MEMORY_BLOCK_LABELS = ["persona", "human"] as const;内容则从 src/agent/prompts/ 下的 persona.mdx / human.mdx 加载(loadMemoryBlocksFromMdx,memory.ts:57-93),部分 label 还会被标记为 read_only(:82-83)。到这里,和 server 的 ChatMemory 还是同一套语汇。
变的是存储位置。MemFS 把记忆投影成本地文件:
~/.letta/agents/<agentId>/memory/
├── system/            # system/* blocks 挂在这里
│   ├── persona.md
│   └── ...
└── <其他 block>.md
根目录由 getMemoryFilesystemRoot() 拼出(letta-code/src/agent/memory-filesystem.ts:43-54),system/ 子目录由 getMemorySystemDir() 定义(:56-61),目录常量在 :26-29。记忆从此可读、可写、可 diff、可回滚——因为整个目录是 git-backed 的,commit 即记忆的版本点。
图 4|MemFS:把记忆 blocks 投影成 git 文件
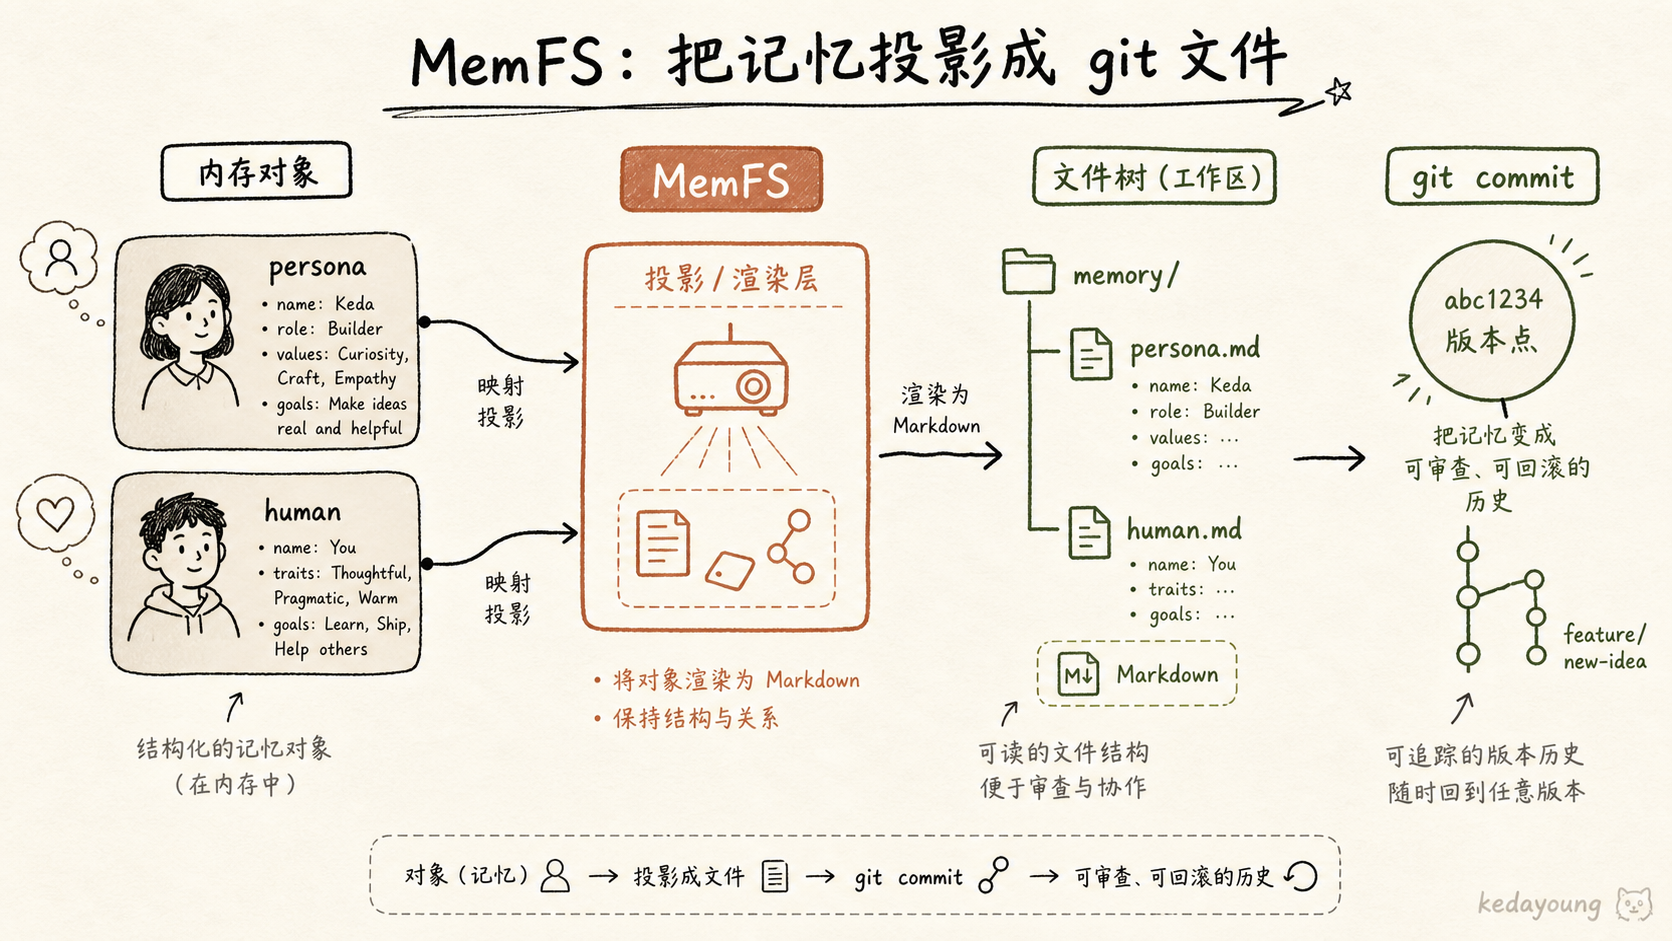
图注:同一份「persona + human」骨架,从内存对象投影成真实文件;commit 即记忆的版本点,记忆第一次可以被通用工具链处理。
5.2 三种记忆模式:谁渲染、谁存储
同一份记忆骨架,可以按三种模式编译进系统提示。类型定义在 letta-code/src/agent/prompt-assets.ts:110:
export type MemoryPromptMode = "standard" | "memfs" | "local-memfs";buildSystemPrompt()(:131-153)按模式从 preset 中确定性选取对应文本(content / memfsContent / localMemfsContent)。三种模式分别对应三个系统提示文件,语义差异是:
- standard(
letta_no_memfs.md):没有 MemFS,记忆就是渲染进 prompt 的文本块; - memfs(
letta.md):记忆是 MemFS 文件,模型通过读写文件来维护记忆,改完要 commit; - local-memfs(
letta_local_memfs.md):类似 memfs,但指向本地后端目录(LETTA_LOCAL_BACKEND_DIR,见memory-filesystem.ts:63-80的getScopedMemoryFilesystemRoot)。
三种模式的差异可以压成一张「谁渲染、谁存储」的对照表:
| 模式 | 谁渲染 | 谁存储 | 系统提示文件 |
|---|---|---|---|
| standard | 系统提示内联文本块 | 无(纯文本,不落盘为文件) | letta_no_memfs.md |
| memfs | MemFS 文件(路径索引常驻) | git-backed 本地文件 ~/.letta/agents/<id>/memory/ | letta.md |
| local-memfs | 同 memfs | 本地后端目录(LETTA_LOCAL_BACKEND_DIR) | letta_local_memfs.md |
图 5|三种记忆模式的「谁渲染、谁存储」
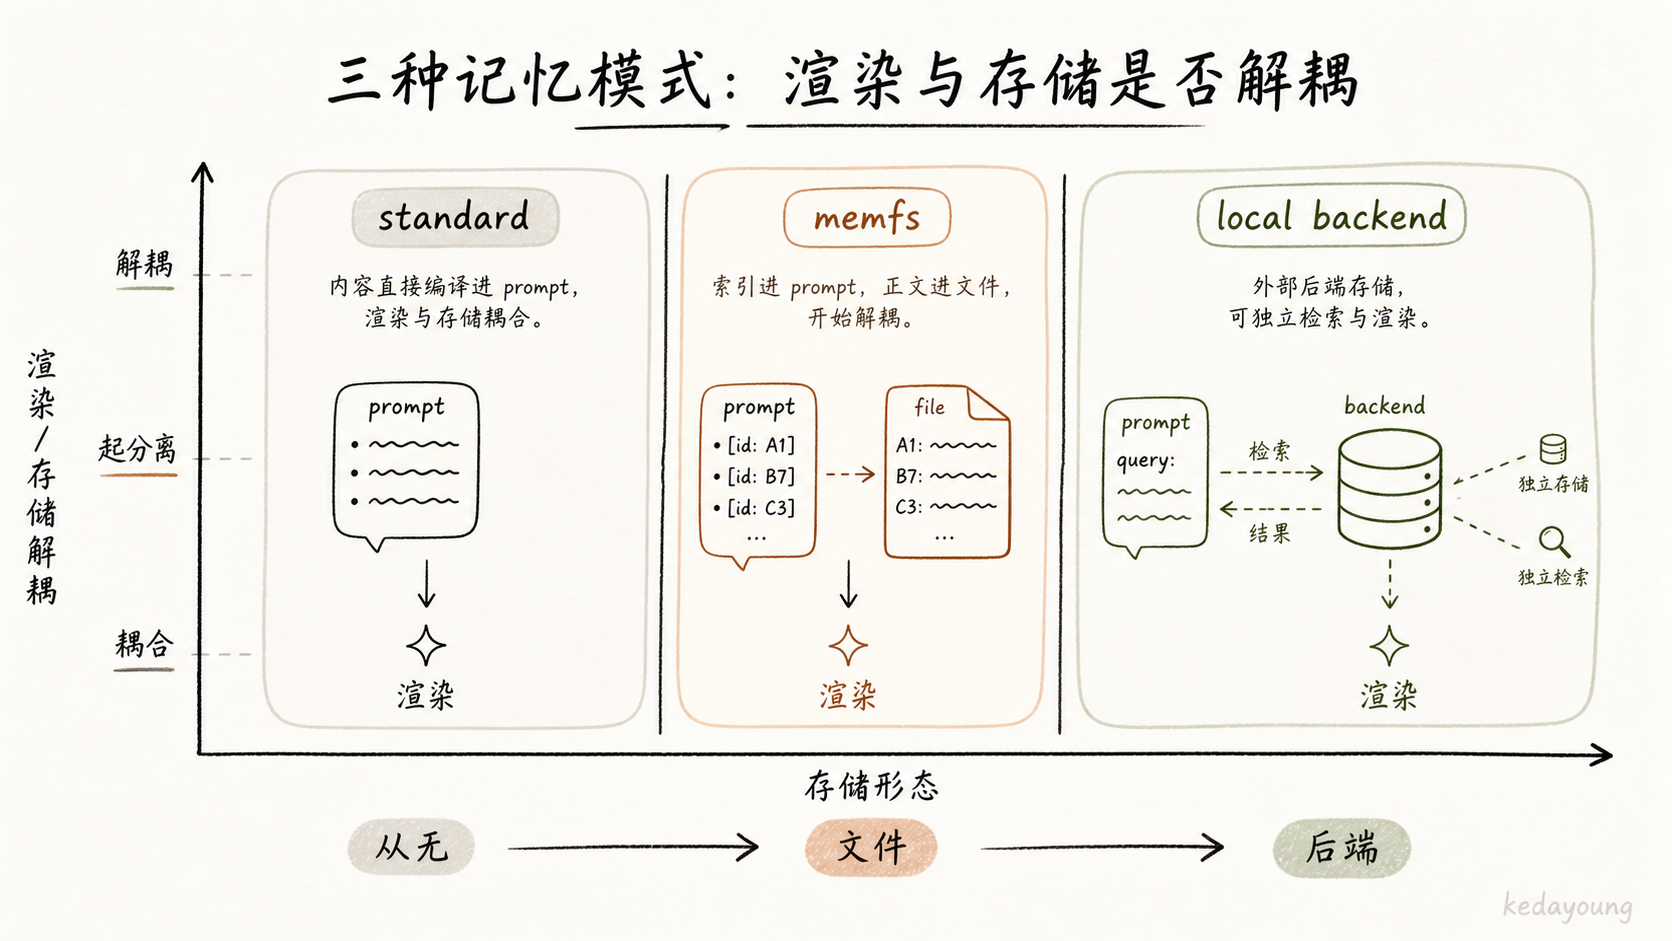
图注:横向是记忆的存储形态从「无」到「文件」再到「本地后端」,纵向是渲染与存储是否解耦——standard 耦合(内容直接编译进 prompt),memfs 起分离(索引进 prompt、内容进文件)。
图 5 的读法:横向是「记忆的存储形态」从无到文件再到本地后端,纵向对比的是「渲染与存储是否解耦」——standard 里两者耦合(内容直接编译进 prompt),memfs 起两者分离(索引进 prompt,内容进文件)。这个解耦正是 §5.3 渐进披露语义的前提。
对照 server 的三种渲染模式(standard / line-numbered / git,memory.py:143/:175/:205),血缘一目了然:server 的 git 渲染模式输出 <projection>$MEMORY_DIR/system/persona.md</projection>,letta-code 把同一个「投影」变成了真实的文件系统——渲染层演进成了存储层。
5.3 两条写在 prompt 里的设计语义
MemFS 最重要的两条语义不是写在 TypeScript 里,而是写在给模型的系统提示里——这本身就说明 letta-code 把「模型理解」当作第一优先。
渐进披露。 letta_no_memfs.md:43 明示:
External memory follows progressive disclosure — only the index of paths and descriptions sits in the system prompt.
和第 3 节 server 侧的 <memory_metadata> 计数是同一个原则,只是形式从「计数」变成了「路径索引」:prompt 里常驻的是路径和描述,内容按需读取。
编辑不即时生效。 letta.md:52 有一段几乎可以当格言引用的话:
Editing memory does NOT change your behavior in the current turn. ... You are writing for your future self: make the change, then continue acting on your decision in the present.
「写作给未来的自己」——记忆修改的目标读者是下一轮、下一个会话的 agent,不是当前轮。这与 server 侧 PATCH 后要 rebuild_system_prompt_async 才能生效(agents.py:1286)是同一机制的两个表述。这个语义设计(第 6 节会展开)避免了 agent 在「刚改完记忆」的同一轮里依赖这份尚未生效的记忆做出推理——那会造成幻觉式的自我引用。
检索路径上,letta-code 用 recall 子代理(letta-code/src/agent/prompts/recall_subagent.md:1-37)承载:子代理被要求用 CLI 命令 letta messages search --query <text> 搜索历史(:16-18),默认模式是 hybrid(:25、:34「Combines vector similarity + full-text search with RRF scoring」)。与 server 的 search_mode: "hybrid"(message_manager.py:1147)完全同构——这是两仓库在检索语义上保持一致的少数直接证据之一。
5.4 文件化记忆改变了什么
把记忆从「数据库里的 blocks」换成「文件系统里的文件」,收益不是存储介质变了,而是记忆第一次可以被通用工具链处理:
- 可 diff、可回滚:git-backed 意味着每次记忆修改都是一个 commit,「哪一轮改了什么」变成可审计的历史。记忆坏了,可以像回滚代码一样回滚;
- 可被普通工具读写:任何编辑器、任何脚本、任何会读文件的 agent 工具,都能直接操作记忆——记忆不再需要专用 API;
- 对人可见:
~/.letta/agents/<agentId>/memory/persona.md就是一个普通文件,用户可以直接查看甚至手改,「记忆透明」从口号变成字面事实; - 与系统提示解耦:standard 模式里记忆内容直接编译进 prompt,memfs 模式里 prompt 只保留路径索引(§5.3 的渐进披露),内容按需读取——记忆的「存储」和「渲染」两个关注点被拆开了。
代价也随收益而来:文件是弱一致性的共享资源,两个并发轮次可能同时编辑同一个 .md 文件;git 的 commit 语义需要 agent 在「改完记忆后记得 commit」,否则修改不会进入下一轮上下文(letta.md:49-50 明示「Changes affect your future context only after they are committed」)。记忆从「服务端强一致的状态」变成了「客户端自觉维护的文件」——这正是 server 与 letta-code 在记忆架构上的分岔点,也是选型时要掂量的关键差异。
6. 对照与可迁移经验
6.1 三条记忆路线的对照
把 letta 放在它所属的谱系里看,它并不是唯一的选择。与本文主题相关的另外两条路线,一是 mem0「外部事实库 + add/search」,二是 pi「会话文件 + checkpoint 摘要 + skills 渐进披露」。三者可以在三个维度上对照(mem0 与 pi 的结论基于其源码一手证据:mem0 本地克隆 20260810-mem0/ commit 4debc58;pi v0.84.1 克隆 20260803-pi-java-workflow/tmp/pi/):
| 维度 | letta | mem0 | pi |
|---|---|---|---|
| 记忆归属 | agent 状态(blocks / MemFS 文件) | 外部事实库(本地 qdrant 向量库 + SQLite 历史) | 会话文件(JSONL 会话树)+ AGENTS.md 项目上下文 |
| 修改方式 | 工具自编辑(memory 工具族 / 编辑文件) | add / search 入口;写入侧 ADD-only 提取,显式 update() / delete() 修订 | 分支 + checkpoint 摘要折叠 |
| 发现机制 | metadata 计数 / 路径索引常驻,内容按需 | semantic + BM25 + entity 三信号检索 | skills 索引常驻(name/description/location),正文按需 |
mem0 侧的证据:接口确实收敛为 add(mem0/memory/main.py:755)与 search(:1374)两个入口;写入侧提取提示词明确「Your sole operation is ADD」(mem0/configs/prompts.py:468、:472),但显式修订 API 仍存在(update :1810、delete :1864);存储是独立的向量库(默认本地 qdrant,mem0/configs/base.py:29-57)+ SQLite 历史日志(mem0/memory/storage.py:11)。pi 侧的证据:稳定知识由作者维护的 AGENTS.md 承载并以 <project_instructions> 全文注入(packages/coding-agent/src/core/system-prompt.ts:145-152),跨会话历史靠 JSONL 会话树 + checkpoint 摘要折叠(见本系列 pi 篇),发现机制则靠 skills 索引常驻 + 按需读取(§3 已引)。
根本分歧在「记忆归属」:letta 的记忆是 agent 的一部分——有预算、有渲染、有编辑工具,agent 对它拥有完整的读写权;mem0 的记忆是 agent 之外的库——agent 通过增删查接口使用它,但记忆不属于 agent 的「身体」;pi 的记忆则是「会话的文件化投影」——不建记忆库,靠文件与结构承担记忆生命周期。这个分歧决定了后面所有差异:因为记忆在 agent 状态里,letta 必须回答「预算多少、怎么渲染、怎么改、改完何时生效」,而这些恰恰是 mem0 不需要面对的问题(它只需要一个检索得好的库),也是 pi 用「作者维护 AGENTS.md」绕开的问题(它把稳定知识的可靠性外包给了人,而不是模型)。
三路怎么选?一个朴素的决策框架(作者判断)是问自己三个问题:
- 你要的是服务端记忆基础设施,还是一个本地 coding agent? 前者看 legacy server(完整的分层 API,
agents.py:1221-1369),后者看 letta-code(MemFS 文件化,memory-filesystem.ts:43-54)。两仓库不是同一个东西,别混用。 - 你相信「模型自己管记忆」吗? 相信,走 letta:记忆生命周期全交模型决策 + 工具约束(§4.3),系统侧不写提炼逻辑;不信,走 mem0:记忆的写入/提炼由提取管线负责(ADD-only,
mem0/configs/prompts.py:468),模型只管 add/search。这本质上是「模型能力 vs 系统确定性」的取舍。 - 你的记忆需要跨会话的结构化状态吗? 需要,letta 的 blocks / MemFS 是结构化状态;不需要、只要对话连续性,pi 风格的压缩折叠更省事。
6.2 可迁移的经验(作者判断)
从 letta 的代码里,我认为有三条经验值得任何做「记忆即状态」路线的团队带走:
- 「常驻核心 + 按需外部 + 只注入计数」的分层准则。 预算永远是稀缺资源,分层的关键不是「存哪些」,而是「默认给模型看哪些」。letta 的
<memory_metadata>和 MemFS 的路径索引给出了同一个答案:常驻的是元信息,内容按需加载。这比「全量注入 + 截断」优雅,也比「完全靠模型自己想起来」可靠。
- 记忆修改工具化,且效果延迟到下一轮生效。 让模型通过结构化工具(而不是自由文本)改记忆,能让修改可校验、可回滚、可审计;而「写作给未来的自己」的语义(server
agents.py:1286、letta-codeletta.md:52)避免当前轮幻觉式地依赖刚写的记忆。两条合起来,记忆编辑才从「危险的自由度」变成「可控的能力」。
- 字符预算显式化。
CORE_MEMORY_BLOCK_CHAR_LIMIT = 100000(constants.py:435)不是隐形的窗口限制,而是每个 block 上可见的字段(block.py:20),更是在每次渲染时直接写进 prompt 的元数据——chars_current/chars_limit(memory.py:164-165)。预算成为数据模型的一部分,agent 才能感知预算、围绕预算决策(什么时候 append 会爆、该不该 replace 掉旧内容)。隐式预算让模型「不知道自己在超支」,显式预算让它「知道该清理了」——这是 letta 最容易被抄走、也最容易被忽视的一条。
6.3 边界:哪些不能照着抄
最后,必须诚实标注这条路线付的税:
- 状态管理复杂度。 blocks 的并发写、append 的预算溢出、共享 Archive 的归属冲突——记忆一旦成为 agent 状态,这些问题就从「存储问题」变成「一致性/并发问题」。server 侧
memory_replace对行号前缀的防御(base.py:345-352)只是冰山一角:它防的是「模型写错格式」这种低层错误,而更高层的风险——两个 agent 并发编辑同一个共享 block、append 把 block 撑过limit、模型把重要记忆误删——在 letta 的开源代码里没有系统级的护栏,主要靠模型自律 + 事后审计。对比之下,mem0 把记忆放在独立存储里(向量库 + SQLite 历史),写入与检索由提取/检索管线决定,模型没有「改坏共享状态」的权限——这是两种路线在运维心智上的根本差别:letta 的运维者要像对待「会自我修改的数据库」一样对待 agent 状态,mem0 的运维者只需要维护一个普通存储。 - 两仓库拆分的选型成本。 一个思想、两个仓库,且一个已经进入 legacy 状态:读 server 代码做设计参考没有问题,但新项目直接用 letta-code 时,会发现它和 server 的 API 并不一一对应。选型前必须想清楚自己需要的是「服务端分层」还是「客户端文件化」。
- 托管平台不评价。 Letta Cloud / Constellation 的内部实现不在开源代码中,本文所有结论仅基于两仓库可读部分;实际生产环境中平台层的记忆策略可能与开源版本不同。
附录:证据清单(正文引用的关键 file:line)
| 断言 | 证据位置 |
|---|---|
| Memory / blocks / file_blocks | server letta/schemas/memory.py:68、:77-78 |
| Block 字段(value/limit/label/read_only/description) | server letta/schemas/block.py:13(BaseBlock)、:19-39 |
| ChatMemory 默认 persona + human | server letta/schemas/memory.py:840、:845-854 |
| DEFAULT_BLOCKS | server letta/schemas/block.py:131 |
| core memory 字符上限 | server letta/constants.py:433-435 |
| compile() 与三种渲染模式 | server letta/schemas/memory.py:688、:143、:175、:205、:705-712 |
| git 渲染的 projection 输出 | server letta/schemas/memory.py:224-229 |
| read_only / chars_current / chars_limit 渲染进 prompt | server letta/schemas/memory.py:162-165 |
| 记忆编辑工具执行器 | server letta/services/tool_executor/core_tool_executor.py(被 tool_execution_manager.py:24 引用) |
| memory_insert 拒绝行号前缀 | server letta/functions/function_sets/base.py:412-419 |
| Passage / embedding 补零 / MAX_EMBEDDING_DIM | server letta/schemas/passage.py:35、:49-77;letta/constants.py:93 |
| Archive 可跨 agent 共享 | server letta/schemas/archive.py:24-25 |
| recall 自动持久化(DB 写入 / 嵌入) | server letta/services/message_manager.py:477 起、:605 起 |
| hybrid 检索默认值 / RRF 字段 | server letta/services/message_manager.py:1147、:1340-1342 |
| memory_metadata 计数注入 | server letta/prompts/prompt_generator.py:26、:69-89 |
| 记忆编辑工具集 | server letta/functions/function_sets/base.py:10/27-32/87/164/194/246/263/311/345-352/391 |
| 工具函数体 docstring 即 schema | server letta/functions/function_sets/base.py(各函数体 raise NotImplementedError) |
| core-memory REST 端点与 recompile | server letta/server/rest_api/routers/v1/agents.py:1221-1369(修改后重建见 :1286) |
| legacy 声明(活跃开发迁移) | server README.md:8-9 |
| letta-code 默认 blocks | letta-code src/agent/memory.ts:16、:57-93 |
| MemFS 目录结构 | letta-code src/agent/memory-filesystem.ts:26-29、:43-54、:56-61 |
| 三种记忆模式 / buildSystemPrompt | letta-code src/agent/prompt-assets.ts:110、:131-153 |
| 渐进披露语义 | letta-code src/agent/prompts/letta_no_memfs.md:43 |
| 编辑不即时生效语义 | letta-code src/agent/prompts/letta.md:52(commit 语义见 :49-50) |
| recall 子代理与 hybrid 默认 | letta-code src/agent/prompts/recall_subagent.md:1-37(命令 :16-18,hybrid :25/:34) |
| local-memfs 本地后端重定向 | letta-code src/agent/memory-filesystem.ts:63-80 |
| MemGPT 分页类比梳理 | notes-topic-research.md:200-209 |
| mem0 接口面(add / search) | mem0 mem0/memory/main.py:755、:1374 |
| mem0 ADD-only 提取提示词 | mem0 mem0/configs/prompts.py:468、:472 |
| mem0 显式修订 API(update/delete) | mem0 mem0/memory/main.py:1810、:1864 |
| mem0 存储形态(向量库 + SQLite) | mem0 mem0/configs/base.py:29-57;mem0/memory/storage.py:11 |
| pi skills 渐进披露(索引常驻) | pi v0.84.1 packages/coding-agent/src/core/skills.ts:342-345、:350-356;docs/skills.md:71 |
| pi AGENTS.md 全文注入 | pi v0.84.1 packages/coding-agent/src/core/system-prompt.ts:145-152 |