版本口径:llama-index-core 0.14.23(
llama-index-core/pyproject.toml:37)。文中所有file:line以本地克隆0-agent-framework/20260810-llamaindex/为准,路径前缀省略。
引言:一次删掉半个 agent 体系的 release
2025 年 7 月 30 日,llama_index 发布 0.13.0。在 CHANGELOG.md:6153 的 breaking 条目里,它一口气移除了 FunctionCallingAgent、旧版 ReActAgent、AgentRunner、全部 step workers、StructuredAgentPlanner、OpenAIAgent——几乎是此前教程里所有「Agent」字样对应的类。替代品是四个新名字:FunctionAgent、CodeActAgent、ReActAgent、AgentWorkflow。
这不是一次普通的 API 整理。旧 agent 体系里「执行入口 + step 逻辑」的分层被整个废弃,agent 被统一迁移到事件驱动 Workflow 模型上——新基类 BaseWorkflowAgent 同时是一个 Workflow,子类只需要实现三个方法,循环、重试、事件流全部由基类提供。与此同时,llama_index 把它的立身之本——索引、检索器、查询引擎——以「一行代码变工具」的方式原生焊进了 agent 框架。
本文的中心论点
0.13+ 的这次设计是一次「架构断裂」的豪赌——赌 Workflow 事件模型能统一承载 agent,赌检索能力做成工具的默认形态能构成差异化。收益是「agent 与检索管线同构、可嵌入任意 Workflow」;代价是旧教程、旧代码、第三方集成大面积失效,ReAct 仍依赖正则解析,Workflow 引擎本体还外置在 llama-index-workflows 包。下面七节,用真实代码逐层拆开这次豪赌的得与失。
沿着这条主线,全文回答三个递进的问题:
- 新架构长什么样(第 1–2 节):旧分层为何被废弃?
BaseWorkflowAgent的「三方法极简接口 + 基类提供循环」具体是怎么落地的? - 它靠什么跑起来(第 3–6 节):三种内置 agent 怎么分工?事件驱动引擎如何编排?检索如何变成一等公民、多 agent 如何 handoff?
- 这笔交易划不划算(第 7 节):设计亮点、诚实列出的局限、适用边界,以及哪些原则可以迁移到自己的框架里。
每一节的代码引用都锚定本地仓库 llama-index-core 0.14.23 的具体行号(证据清单见附录 A),你可以边读边打开源码核对。
1. 架构断裂:从 AgentRunner/Worker 到 Workflow-based Agent
旧架构:执行入口与 step 逻辑的分层
0.13.0 之前,llama_index 的 agent 是典型的两层结构:
- AgentRunner:执行入口,负责调度、收集结果、维护 memory;
- AgentWorker:单步逻辑的实现者,
ReActAgentWorker、FunctionCallingAgentWorker、LATSAgentWorker、CoAAgentWorker……每一种推理风格是一个 Worker 类。
docs/src/content/docs/framework/changes/deprecated_terms.md:57-77 的废弃清单几乎是一份「旧分层全谱系」:除了 AgentRunner 本身,还包括 12+ 个 Worker 类(ReActAgentWorker、LATSAgentWorker、CoAAgentWorker、FnAgentWorker、QueryPipelineAgentWorker、MultiModalReActAgentWorker、IntrospectiveAgentWorker、SelfReflectiveAgentWorker、ToolInteractiveReflectionAgentWorker、LLMCompilerAgentWorker、QueryUnderstandAgentWorker 等)。
这套分层的问题在于:「怎么循环」和「每步做什么」被耦合进了两套互相引用的类。Runner 要理解 Worker 的 step 协议,Worker 要理解 Runner 的 task/task_step 协议,双方通过 TaskStepOutput 传递状态。加一种新的 agent 行为,往往要同时动两层;而任务编排(多个 agent 协作)在分层模型里没有一等公民的表达——只能靠外部包装。
断裂点:0.13.0 的一刀切
CHANGELOG.md:6153 的原文值得细读:
breaking: removed deprecated agent classes, including
FunctionCallingAgent, the olderReActAgentimplementation,AgentRunner, all step workers,StructuredAgentPlanner,OpenAIAgent, and more. All users should migrate to the new workflow based agents:FunctionAgent,CodeActAgent,ReActAgent, andAgentWorkflow.
注意措辞:「and more」。同一次 release 还移除了 QueryPipeline 类族,并把默认的 index.as_chat_engine() 从 agent-based chat engine 改成了 CondensePlusContextChatEngine——连「用 agent 做聊天引擎」这个默认路径都一并关掉了。这是一次有意的「清场」:新架构上线,旧路径不再保留兼容层。
残留代价:第三方集成还活在旧世界里
断裂的代价不在核心库内部——核心库自己当然一致——而在生态的外围。搜索本地仓库,llama-index-integrations/agent/llama-index-agent-agentmesh/llama_index/agent/agentmesh/worker.py:7 仍然写着:
from llama_index.core.agent import AgentRunner
from llama_index.core.agent.types import BaseAgentWorker, Task, TaskStep, TaskStepOutput
这是一个 integration 包对已删除 API 的直接引用。任何依赖 agentmesh 的升级路径,都会在 import 期炸掉。这也解释了为什么 deprecated_terms.md 里的清单至今还在文档里占着位置:迁移不是一次 release 能完成的,文档必须为迁移者提供「旧名 → 新名」的对照。
观察点(作者判断)
这次断裂是「框架押注 Workflow 范式」的激进决策。对读者的直接教训是框架教程的时效性风险——2024 年的 llama_index agent 教程,到今天一行都跑不了。写这类框架文章必须锚定版本,这也是本系列每篇都标注 0.14.23 的原因。
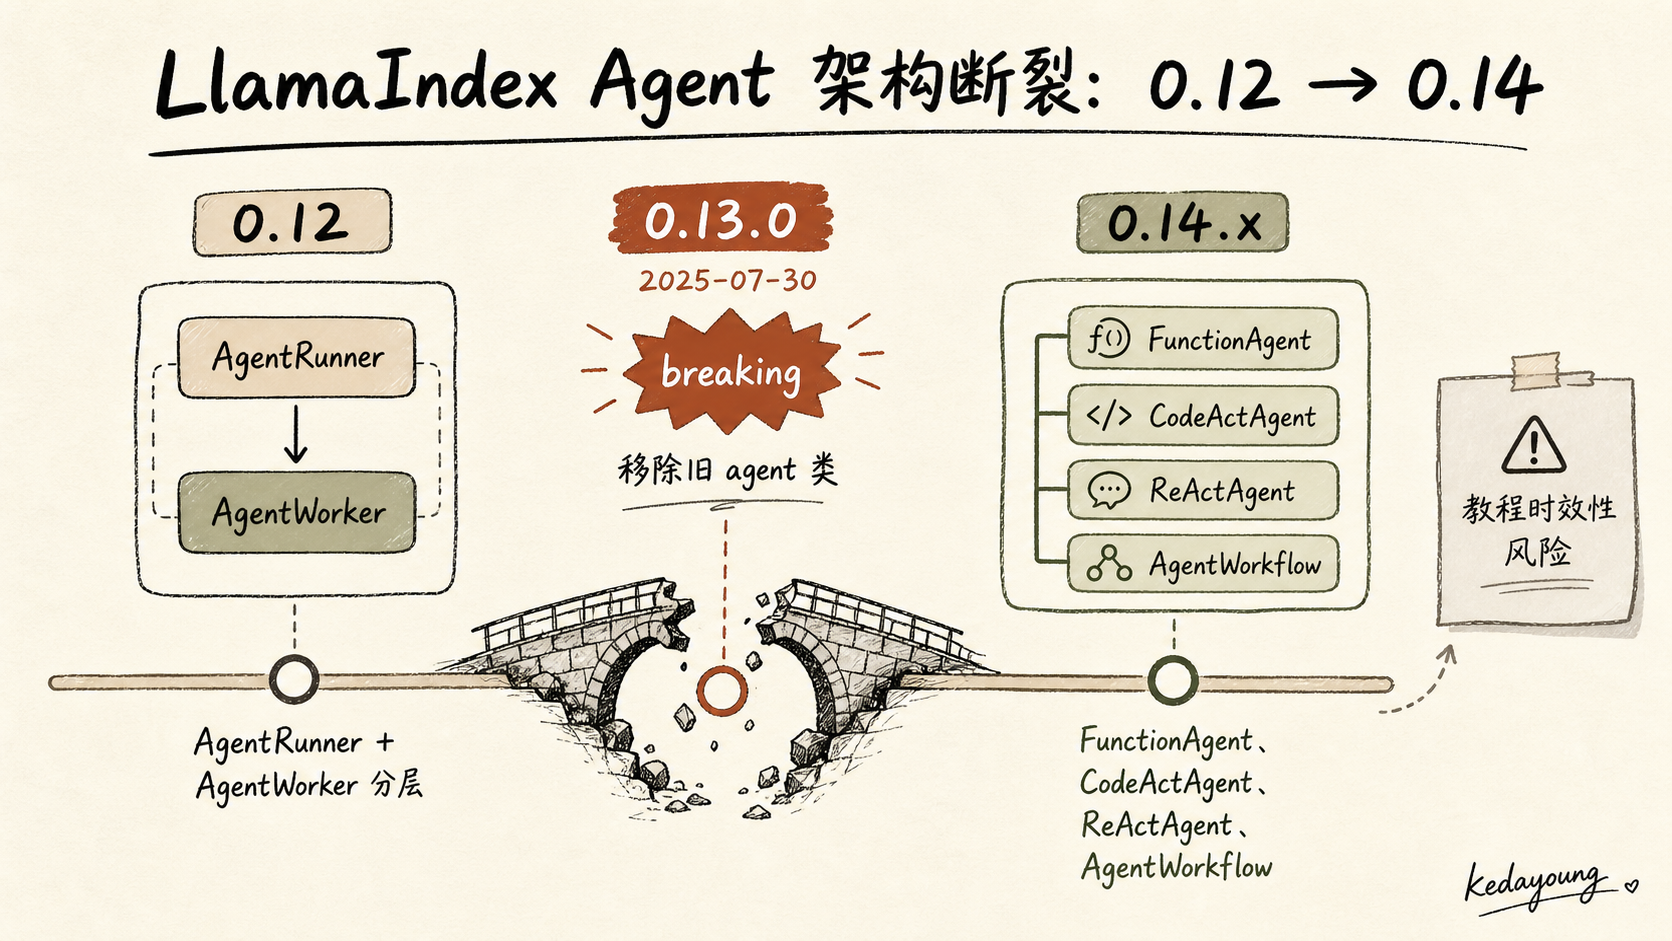
图 1|llama_index agent 架构演进时间线(0.12 分层 → 0.13 breaking → 0.14 当前)
2. BaseWorkflowAgent:一个 agent 就是一个 Workflow
一个类,三个身份
新架构的根在 llama-index-core/llama_index/core/agent/workflow/base_agent.py:87-90:
class BaseWorkflowAgent(
    Workflow, BaseModel, PromptMixin, metaclass=BaseWorkflowAgentMeta
):
    """Base class for all agents, combining config and logic."""
BaseWorkflowAgent 同时是 Workflow(事件驱动引擎)、BaseModel(Pydantic 配置模型)和 PromptMixin(提示词管理)。元类 BaseWorkflowAgentMeta 由 WorkflowMeta 与 ModelMetaclass 合并而来(:83-84)。这是 Python 里多重继承 + 元类协作的典型样板:Workflow 的 @step 收集机制和 Pydantic 的字段验证机制在同一棵继承树上共存。
docstring 只有六个词:combining config and logic。配置字段(base_agent.py:94-142)可以分成四组看:
| 分组 | 字段 | 语义 |
|---|---|---|
| 身份 | name / description / system_prompt | agent 的自我描述,也是多 agent 场景下 handoff 寻址的依据 |
| 能力 | tools / tool_retriever / llm | 工具列表或动态工具检索器(二选一或并用),以及所用的 LLM |
| 协作 | can_handoff_to / initial_state | 可转交对象白名单、初始状态 |
| 行为 | output_cls / structured_output_fn / streaming / early_stopping_method | 结构化输出、流式、超限时的终止策略 |
其中 tools 统一归一为 BaseTool(可传 Callable 自动包装),tool_retriever 允许用检索器代替静态工具列表(第 5 节展开)。注意 can_handoff_to、initial_state 这两个字段的存在说明「多 agent 协作」从设计第一天就是 Workflow 模型的一部分,而不是事后补丁。它们作为字段长在单个 agent 上,但只在 AgentWorkflow 编排时才生效(第 6 节展开)。
三方法极简接口:子类只描述策略
子类需要实现的抽象方法只有三个(base_agent.py:245-265):
@abstractmethod
async def take_step(self, ctx: AgentContext, llm_input: List[ChatMessage],
                    tools: Sequence[AsyncBaseTool], memory: BaseMemory) -> AgentOutput:
    """Take a single step with the agent."""

@abstractmethod
async def handle_tool_call_results(self, ctx: Context, results: List[ToolCallResult],
                                   memory: BaseMemory) -> None:
    """Handle tool call results."""

@abstractmethod
async def finalize(self, ctx: Context, output: AgentOutput, memory: BaseMemory) -> AgentOutput:
    """Finalize the agent's execution."""
take_step 回答「这一轮模型输出什么」(可能包含 tool_calls、可能包含最终回答);handle_tool_call_results 回答「工具结果回来之后如何并入记忆与推理链」;finalize 回答「收尾时把原始输出包装成什么」。循环本身不在子类手里——「循环、重试、迭代上限、事件流、并行聚合由基类提供」是这个接口设计最核心的转移。
基类的循环:一个普通的 @step
基类怎么提供循环?它就是一个普通的 Workflow step。base_agent.py:520-622 的 parse_agent_output 是整个 agent 运行的心脏:
@step
async def parse_agent_output(self, ctx: Context, ev: AgentOutput
                             ) -> Union[StopEvent, AgentInput, ToolCall, None]:
    max_iterations = await ctx.store.get("max_iterations", default=DEFAULT_MAX_ITERATIONS)
    num_iterations = await ctx.store.get("num_iterations", default=0)
    num_iterations += 1
    await ctx.store.set("num_iterations", num_iterations)

    if num_iterations >= max_iterations:
        early_stopping_method = await ctx.store.get("early_stopping_method", default="force")
        if early_stopping_method == "generate":
            return await self._generate_early_stopping_response(ctx, max_iterations)
        else:
            raise WorkflowRuntimeError(...)   # base_agent.py:531-542
这个 step 的返回类型说明了一切:StopEvent(结束)、AgentInput(回环再跑一轮)、ToolCall(派发工具调用)、None(继续等下一个事件)。循环不是 while 语句,而是事件流的「回边」——step 之间通过事件互相触发。三种终止/回环路径都在这一个 step 里:
- 达到迭代上限且
early_stopping_method="force"→ 直接抛WorkflowRuntimeError(base_agent.py:538),默认行为是失败而不是软化收场; - 返回带
retry_messages的AgentOutput→ 基类把历史 + retry 消息重新拼成AgentInput送回模型(base_agent.py:546-558),这是「自修复」机制的落点; - 没有 tool_calls → 调
finalize,走结构化输出分支,产出StopEvent(base_agent.py:560-609)。
结构化输出本身也是基类职责:output_cls 非空时用 generate_structured_response 强制模型按 Pydantic 类输出;structured_output_fn 允许自定义转换函数(base_agent.py:569-605)。
事件流:一切中间产物都可观测
基类把每个中间产物都发到事件流。base_agent.py:329-340 展示流式场景:模型每次吐一个 delta,就构造 AgentStream 事件写入流,AgentOutput、ToolCallResult 同理。配合 instrumentation,你可以订阅事件流做日志、调试、或在前端实时渲染思考过程——「agent 内部发生了什么」终于有了统一、可编程的出口。
(系列对照)helloagents 的做法是「继承 Agent 基类 + 实现 run」(0-agent-framework/20260810-helloagents-framework/hello_agents/agents/react_agent.py:85 附近),llama_index 是「继承 Workflow + 实现三方法」——两者都是模板方法模式,但 llama_index 把「循环」从子类责任中完全移走:子类只描述策略(单步怎么做、结果怎么处理、怎么收尾),运行时策略(迭代、重试、事件分发)由基类闭包。代价是:想要非标准循环行为的开发者,不再有 Runner 层可以绕过——你必须理解 Workflow 的事件模型。
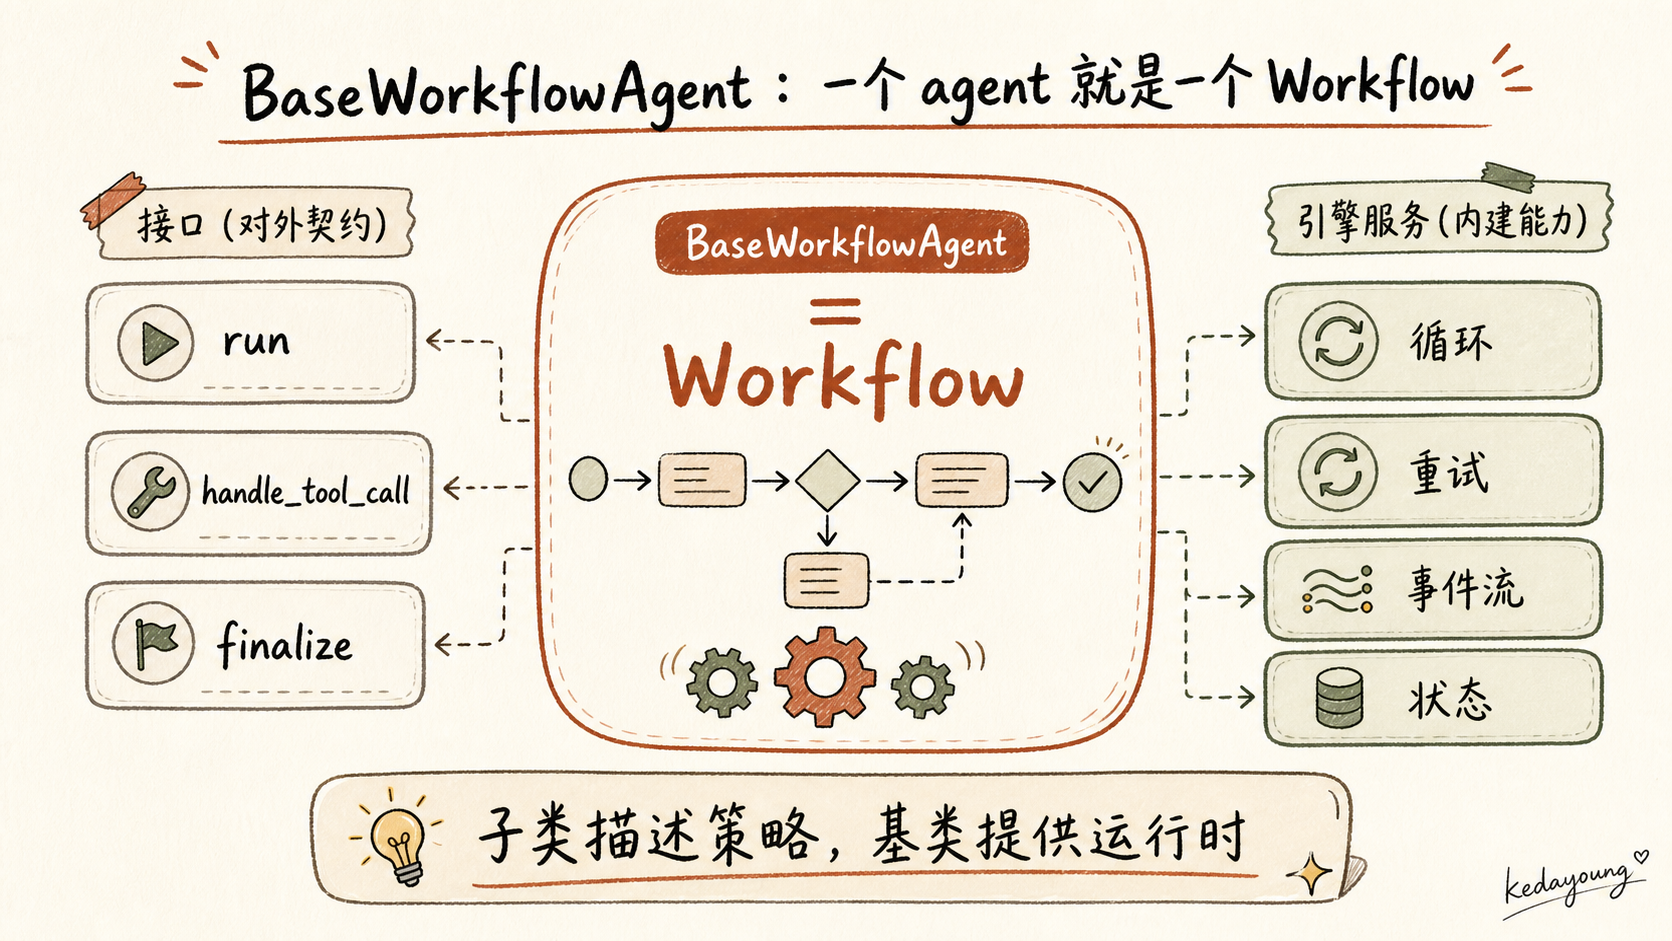
图 2|BaseWorkflowAgent 分层:基类提供循环/重试/事件流/迭代上限,子类只实现三个策略方法
3. 三种内置 Agent:ReAct 模板化、FunctionAgent 与 CodeActAgent
框架只给三个开箱 agent,各解决一个问题:模型能力(会不会 function calling) 与 执行环境(能不能跑代码) 两个维度切成三格。
ReActAgent:模板化与自修复
ReActAgent(llama-index-core/llama_index/core/agent/workflow/react_agent.py)是唯一不要求 function calling 的通用 agent。它的设计有两个值得注意的点:
第一,提示词与解析可插拔
react_agent.py:41-48 把两个关键组件声明成 Pydantic 字段:
output_parser: ReActOutputParser = Field(
    default_factory=ReActOutputParser, description="The react output parser")
formatter: ReActChatFormatter = Field(
    default_factory=default_formatter,
description="The react chat formatter to format the reasoning steps and chat history into an llm input.")系统提示词模板独立成文件(templates/system_header_template.md),formatter 负责把「推理轨迹 + 对话历史」拼成 LLM 输入,parser 负责把 LLM 输出拆回推理步。两者都是字段、都能替换——想换一种 ReAct 方言(比如中文提示词、JSON 格式),不需要 fork agent 类。
第二,弱模型输出有自修复机制
react_agent.py:164-225 覆盖两种失败:空输出(:164-190)和解析失败(:192-225),两者都返回带 retry_messages 的 AgentOutput——把模型自己的输出 + 一段「你哪里错了、正确格式是什么」的指令作为新的 user 消息塞回去,再走一轮。这是上一节基类 retry_messages → AgentInput 回环机制(base_agent.py:546-558)在 ReAct 里的具体用武之地。
ReAct 的脆弱点:正则解析
自修复机制的背后是更基础的问题:ReAct 的 Thought/Action/Answer 是靠正则从模型文本里抠出来的。llama-index-core/llama_index/core/agent/react/output_parser.py:15-25:
def extract_tool_use(input_text: str) -> Tuple[str, str, str]:
    pattern = r"(?:\s*Thought: (.*?)|(.+))\n+Action: ([^\n\(\) ]+).*?\n+Action Input: .*?(\{.*\})"
    match = re.search(pattern, input_text, re.DOTALL)
    if not match:
        raise ValueError(f"Could not extract tool use from input text: {input_text}")
只要模型输出里多了个空行、把 Action: 写成了 Action :、或者 JSON 里带了单引号(action_input_parser 还要再做一次引号清洗,:28-32),这条正则就可能失配——然后触发上面的重试,重试要付出完整一次 LLM 调用的 token 开销。格式漂移即失败,能救但贵。
(系列对照)helloagents 用完全不同的策略处理同一问题——把 Thought 和 Finish 做成内置工具(hello_agents/agents/react_agent.py:85,self._builtin_tools = {"Thought", "Finish"}),让模型通过工具调用协议表达「我要思考」和「我结束了」,绕开了正则解析。llama_index 选择「正则 + 重试」:实现简单、兼容任意文本模型,但把脆弱性暴露在一条正则表达式上。这是「处理模型输出脆弱性」的两种代表性策略:改变协议 vs 容忍并修复。
FunctionAgent 与 CodeActAgent
FunctionAgent(function_agent.py)把赌注押在 function calling 协议上——take_step 的第一行就是硬前提校验(function_agent.py:109-110):
if not self.llm.metadata.is_function_calling_model:
    raise ValueError("LLM must be a FunctionCallingLLM")
模型不支持 function calling,直接拒绝运行,而不是降级。换来的是结构化的 tool_call 流:不需要正则、不需要提示词模板教模型「输出格式」,解析错误理论上不会发生。
CodeActAgent(codeact_agent.py)面向可执行环境:以代码为行动语言,模型把 Python 代码包在 <execute>...</execute> 标签里输出(系统提示词如此要求,codeact_agent.py:25-58),框架用正则把代码从输出里抠出来(_extract_code_from_response,:151-169),再交给 code_execute_fn 执行并把结果回喂。关键在最后一步:执行环境不是内置的,而是用户注入的插件——code_execute_fn 在 __init__ 里被包装成名为 execute 的框架保留工具(:70-75、:99-101),你可以接本地解释器、沙箱或远程服务。它是三兄弟里最「重」的一个——正确性依赖执行环境,但能力上限也最高(可以写循环、调库、做多步计算,而不是一个个工具调用)。
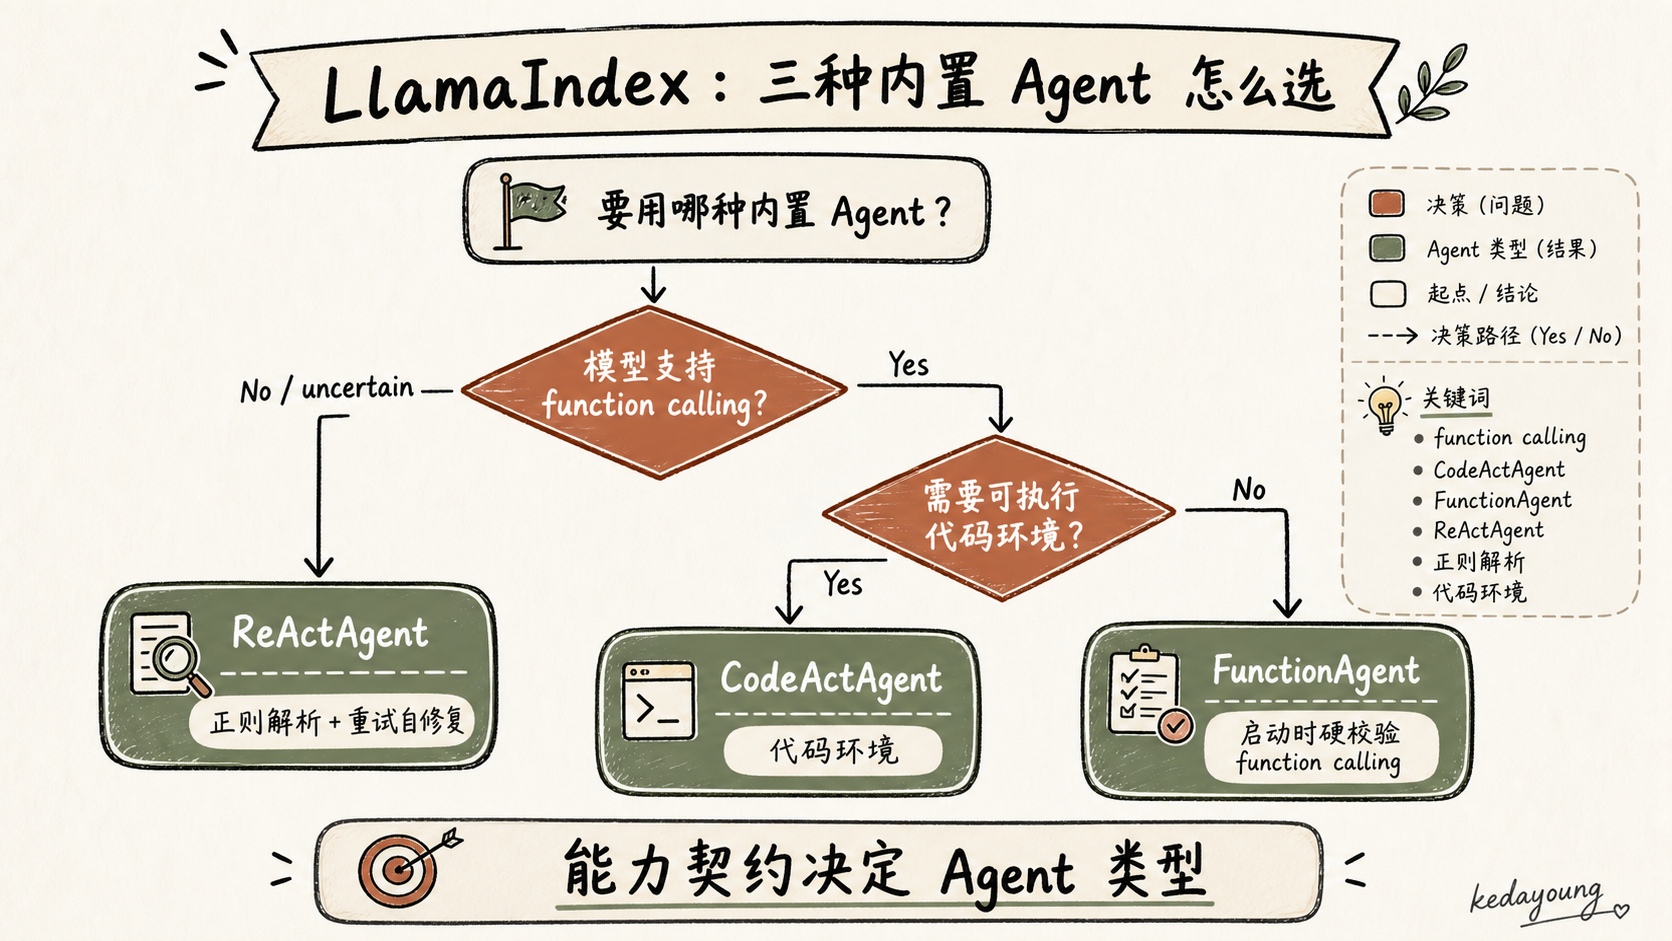
图 3|三种内置 agent 的决策路径:按「模型是否支持 function calling」与「是否需要可执行代码环境」分派
4. Workflow 事件驱动引擎(跨包)
引擎不在 core 里
一点容易被忽略、却影响不小的设计:Workflow 引擎本体不在 llama-index-core 里。llama-index-core/pyproject.toml:83 声明依赖 llama-index-workflows>=2.14.0,<3,而 core 里的 llama_index/core/workflow/workflow.py:1 只有一行 re-export:
from workflows.workflow import Workflow, WorkflowMeta # noqa这意味着:事件循环可以在 llama_index 之外独立使用(作者判断:这也是引擎独立成库的动机之一——llama_index 想推广的不只是 agent,而是「通用编排原语」);但反过来,本地 core 仓库里没有引擎实现,本文对引擎的描述只能停留在 API 级(Workflow 类 + @step 装饰器 + 事件流驱动),涉及内部细节(上下文对象如何路由事件、step 的并发调度)时需要以 llama-index-workflows 源码为准。排障时要跨两个包,这是它设计上的一个隐性成本。
事件驱动:数据以事件流的方式流动
Workflow 模型的核心抽象只有两个:Workflow 类和 @step 装饰器。一个 step 消费事件、产出事件;事件驱动执行——Event A → @step → Event B → …。回到上一节:BaseWorkflowAgent 本身就是 Workflow,所以它的「循环」是一个普通的 step 回边;AgentWorkflow 也继承 Workflow(multi_agent_workflow.py:99),多 agent 的 handoff 同样是事件流的一部分。agent 与编排器共享同一套运行时——这是「一个 agent 就是一个 Workflow」在架构上的兑现:一个 agent 可以嵌进任意 Workflow 管道(比如「检索 → agent → 写作」三段式),不用任何适配层。
(作者判断)事件驱动 vs 图 vs 消息总线,是「数据如何流动」的三种答案。langgraph 用 channel 显式声明数据流(图结构可见、可静态分析);MetaGPT 用消息总线广播(角色松耦合);llama_index 用事件流(step 之间通过事件类型隐式连接)。事件流的优势是异步与解耦:step 不知道谁在消费自己的事件,天然支持并行聚合(AgentWorkflow 里多个 tool_call 可以并发执行、再在某个聚合 step 里汇合,无需显式的 fork/join 语法)。代价是控制流隐式:「谁触发谁」散落在每个 step 的返回类型里,整张执行图没有单一的可视化载体。一个直观后果:在 langgraph 里你能一眼看出图的形状(有哪些节点、几条边),在 llama_index 里你需要通读每个 @step 的签名和返回类型才能还原执行图——这正是本文每一节都要配图的原因,也是第 7 节「排障跨包」之外第二个隐性成本。
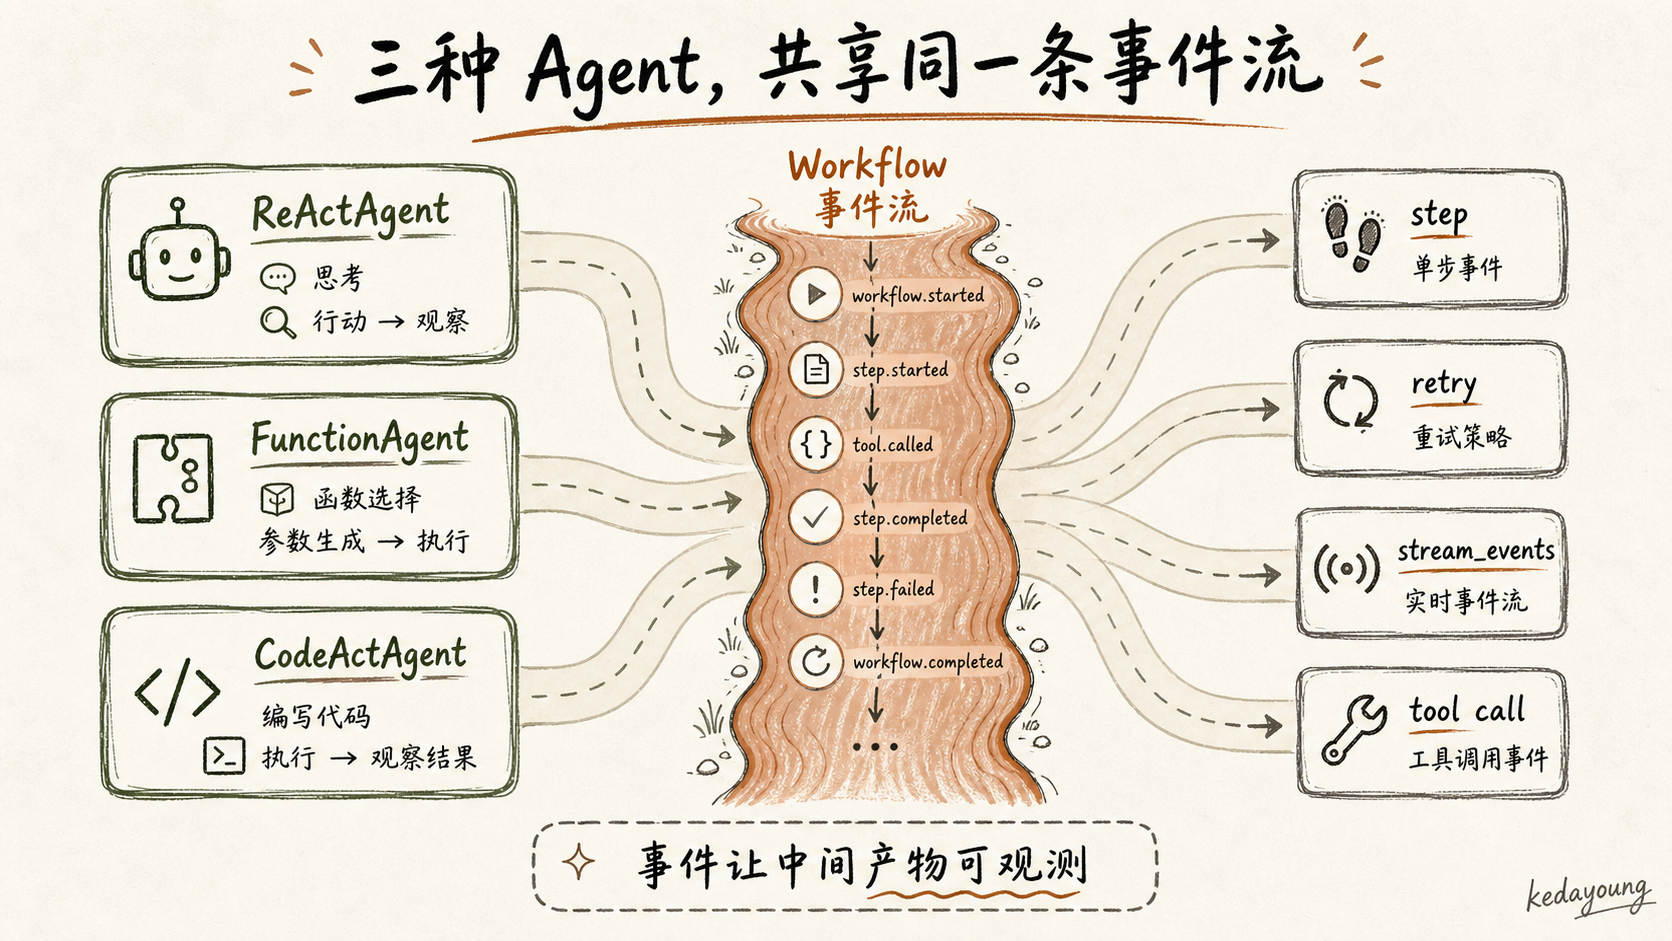
图 4|事件驱动 Workflow 示意。引擎实现在外部
llama-index-workflows包(pyproject.toml:83),上图仅表示 API 级语义。
5. 检索即工具:BaseTool 统一与 tool_retriever
为什么 llama_index 的 agent 与检索「同构」
其它 agent 框架的典型路径是「先选框架,再找检索方案,然后用适配器把检索结果塞给 agent」。llama_index 反着来:检索就是框架的一部分。indices/、retrievers/、query_engine/ 是它从第一天就有的核心模块,agent 只是这些模块的又一个消费端。
这个「同构」的机械基础是 BaseTool 接口的统一。RetrieverTool(把一个 Retriever 包成工具)、QueryEngineTool(把整个查询引擎包成工具)、FunctionTool(把任意函数包成工具)都实现同一个 BaseTool 接口。结果是一条完全同构的链:
Index → Retriever → RetrieverTool(BaseTool) → Agent 的 tools 列表任意索引、任意检索器、任意查询引擎,包装一下就是 agent 的一个工具——不需要「把检索结果转成工具输出」的胶水层。对 RAG 场景这几乎免费。以最常见的查询引擎为例,一行代码:
from llama_index.core.tools import QueryEngineTool

query_engine_tool = QueryEngineTool.from_defaults(
    query_engine=my_query_engine,          # 任意 QueryEngine
    name="annual_report_qa",
    description="回答关于公司年报的问题,例如营收、利润、研发投入。",
)
agent = ReActAgent(tools=[query_engine_tool], llm=llm)
my_query_engine 内部可以是一条完整的 RAG 管线(索引 + 检索 + 合成),但对 agent 来说它只是一个工具:模型根据 description 决定何时调用,检索结果直接变成工具输出返回给模型。这也是本系列 0-rag-retrieval 主题里「检索边界」问题在框架层面给出的一个答案:llama_index 的检索边界由工具描述(description)决定。模型只根据工具描述决定何时调用检索器;检索器内部的 top_k、相似度阈值等参数完全由工具持有者控制,模型碰不到。
tool_retriever:动态工具集
静态工具列表之外,BaseWorkflowAgent 还支持动态工具集:配置 tool_retriever(base_agent.py:105-108),每轮把本轮用户消息丢给 ObjectRetriever.aretrieve 重新取工具(base_agent.py:273-282):
async def get_tools(self, input_str: Optional[str] = None) -> Sequence[AsyncBaseTool]:
    tools = [*self.tools] if self.tools else []
    if self.tool_retriever is not None:
        retrieved_tools = await self.tool_retriever.aretrieve(input_str or "")
        tools.extend(retrieved_tools)
    return self._ensure_tools_are_async(cast(List[BaseTool], tools))
工具集超过模型上下文容纳量时(比如企业里有几百个工具/数据源),这是标准解法:每轮按 query 召回相关工具注入。但注意两个开销:一是每轮一次检索,二是粒度粗——aretrieve 拿到的是本轮用户消息的文本(没有独立用户消息时,退而取聊天历史里的最后一条用户消息,base_agent.py:405-427),检索噪声可能把不相关的工具也拉进来,模型反而更困惑。这是「检索边界」在框架内的第二个落点:tool_retriever 的选择器(Retriever)质量直接决定 agent 的工具选择正确性。
(作者判断)这是 llama_index 难以替代的地方。langgraph / openai-agents 的 agent 能力更强、编排更精细,但「检索器 → 工具 → agent」的零胶水链条,是检索优先框架的独门优势。如果你的应用本质是「从大量私有文档/数据库里取数再决策」,llama_index 是文档/检索密集 agent 的首选土壤。
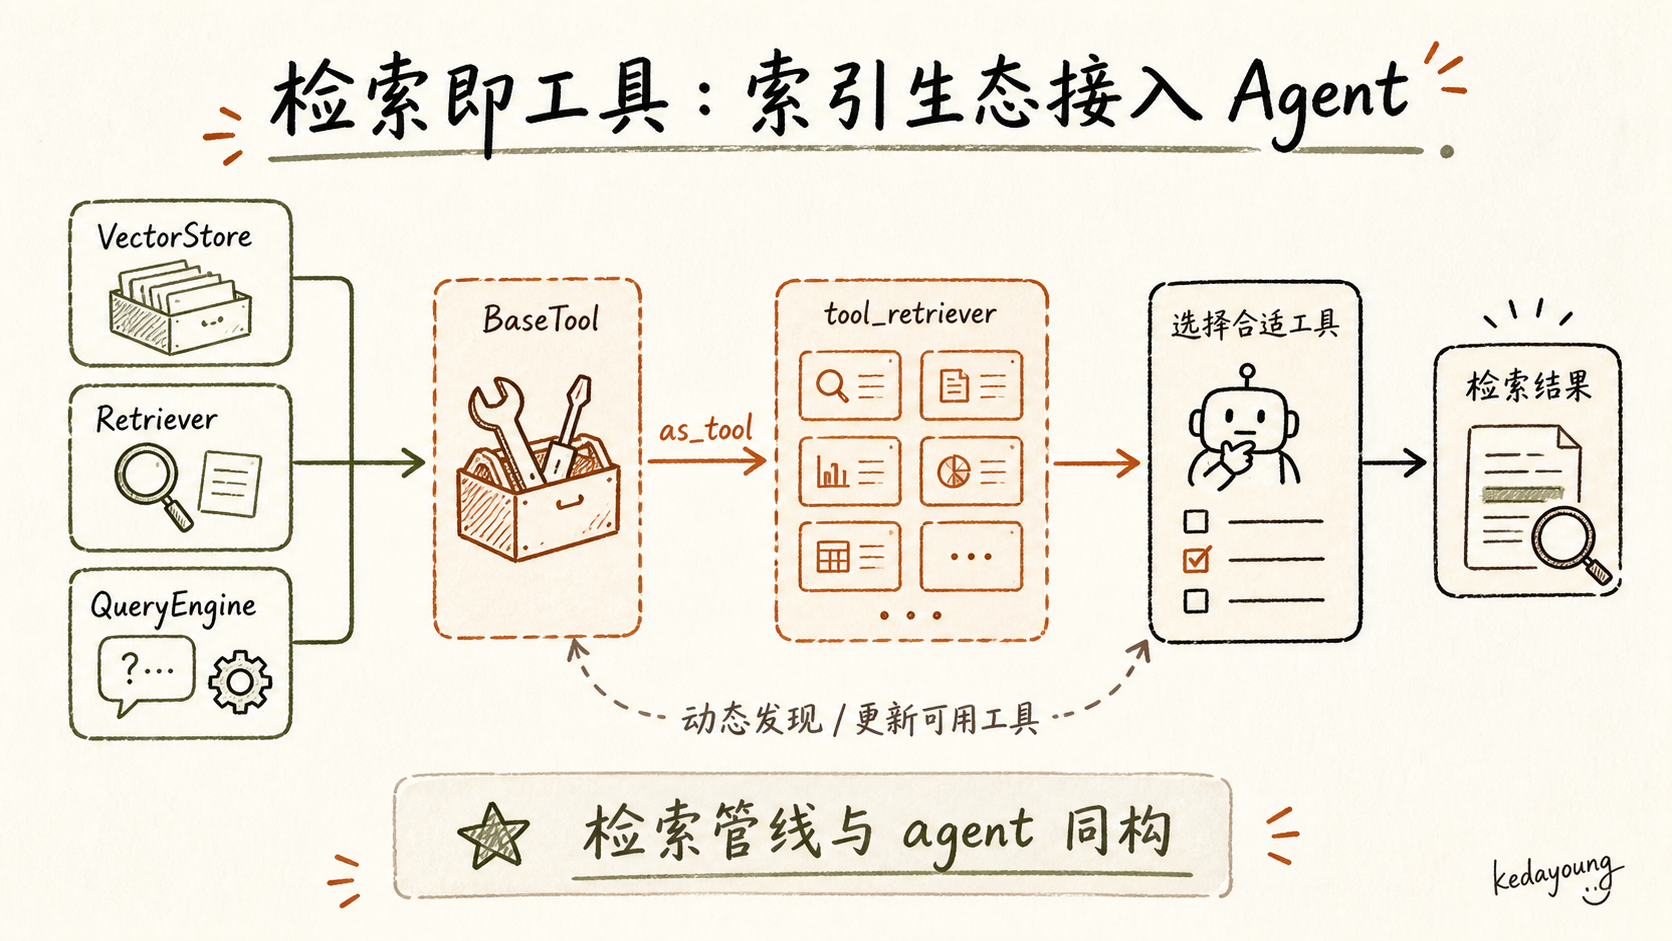
图 5|「检索器 → 工具 → agent」同构链;
tool_retriever按用户输入动态取用工具
6. AgentWorkflow:多 agent handoff
handoff 是内置工具,权限是配置
多 agent 协作在 Workflow 模型里长这样:AgentWorkflow(multi_agent_workflow.py)接收一组 BaseWorkflowAgent,给每个 agent 动态生成一个 handoff 工具。工具本身是个普通函数(multi_agent_workflow.py:73-92):
async def handoff(ctx: Context, to_agent: str, reason: str) -> str:
    agents: list[str] = await ctx.store.get("agents")
    current_agent_name: str = await ctx.store.get("current_agent_name")
    can_handoff_to: dict[str, list[str]] = await ctx.store.get("can_handoff_to")
    if to_agent not in agents:
        ...  # 目标不存在 → 返回错误文本让模型自己纠正
    if can_handoff_to.get(current_agent_name, []) is not None \
       and to_agent not in can_handoff_to.get(current_agent_name, []):
        return f"Agent {to_agent} cannot hand off to {current_agent_name}..."
    await ctx.store.set("next_agent", to_agent)
return handoff_output_prompt.format(to_agent=to_agent, reason=reason)注意它的返回值设计:失败不抛异常,而是返回一段文本——handoff 工具的调用者是一个 agent,模型会读到这段文本并自行决定下一步(换个目标、或者直接回答用户)。这是「工具即对话」的典型手法:把控制流错误降级为模型可读的反馈。对比一下:如果 handoff 抛异常,整个 Workflow 会中断,用户只看到错误栈;现在 agent 收到「Agent X 不存在,可选的是 Y 和 Z」,它能自己纠偏——错误处理从代码逻辑转移到了模型推理。这不总是好事(模型可能反复选错、多烧几轮 token),但对「模型驱动的编排」来说,这是让协作更抗错的务实选择:目标就是让错误进入模型可自我修正的回路,而不是打断回路。
权限控制 can_handoff_to 在工具生成时就被编码进工具描述。_get_handoff_tool(multi_agent_workflow.py:216-246)为每个 agent 构造工具时,先按 can_handoff_to 白名单过滤掉不可转交的 agent(self.agents 里去掉当前 agent 自己和白名单外的人),再把「可转交给谁 + 各自的职责描述」拼进工具的 description——模型看到的工具描述里,就只剩它有权转交的对象。这是权限的「prompt 级实现」:不是运行时强制,而是让模型在信息层面就见不到不可选项。
配置门槛:多 agent 需要显式命名
多 agent 模式有几个硬性配置约束(multi_agent_workflow.py:124-139):
- 每个 agent 必须有唯一的
name和description(否则抛ValueError); - 每个 agent 的
initial_state不被支持(per-agent 状态在多 agent 场景被禁用,状态统一走 workflow 级 store)。
第一点是功能必需——handoff 工具按名字寻址,description 是模型选择转交目标的依据,两者缺失会让「模型自己决定转交给谁」变成瞎猜。第二点是刻意的架构简化:多 agent 时状态归属变复杂(谁的状态?转交时带不带?),干脆一刀切禁掉 per-agent 初始状态,只保留 workflow 级 initial_state。
(系列对照)llama_index 的 handoff 与 openai-agents 的 Handoff(src/agents/handoffs/__init__.py:126,一个带 TContext/TAgent 泛型的 dataclass)功能等价——都是「一个 agent 把控制权交给另一个」——但形态完全不同:openai-agents 的 Handoff 是头等类型(有自己的数据结构、history 映射器、输入过滤器),llama_index 的 handoff 是一个普通工具函数 + 事件流里的 next_agent 状态。前者给开发者更细的钩子,后者赢在「没有新概念」——你已经会写工具,就会 handoff。MetaGPT 则走另一条路:角色之间用消息总线广播通信,不存在「把控制权交给某一个人」的显式动作。
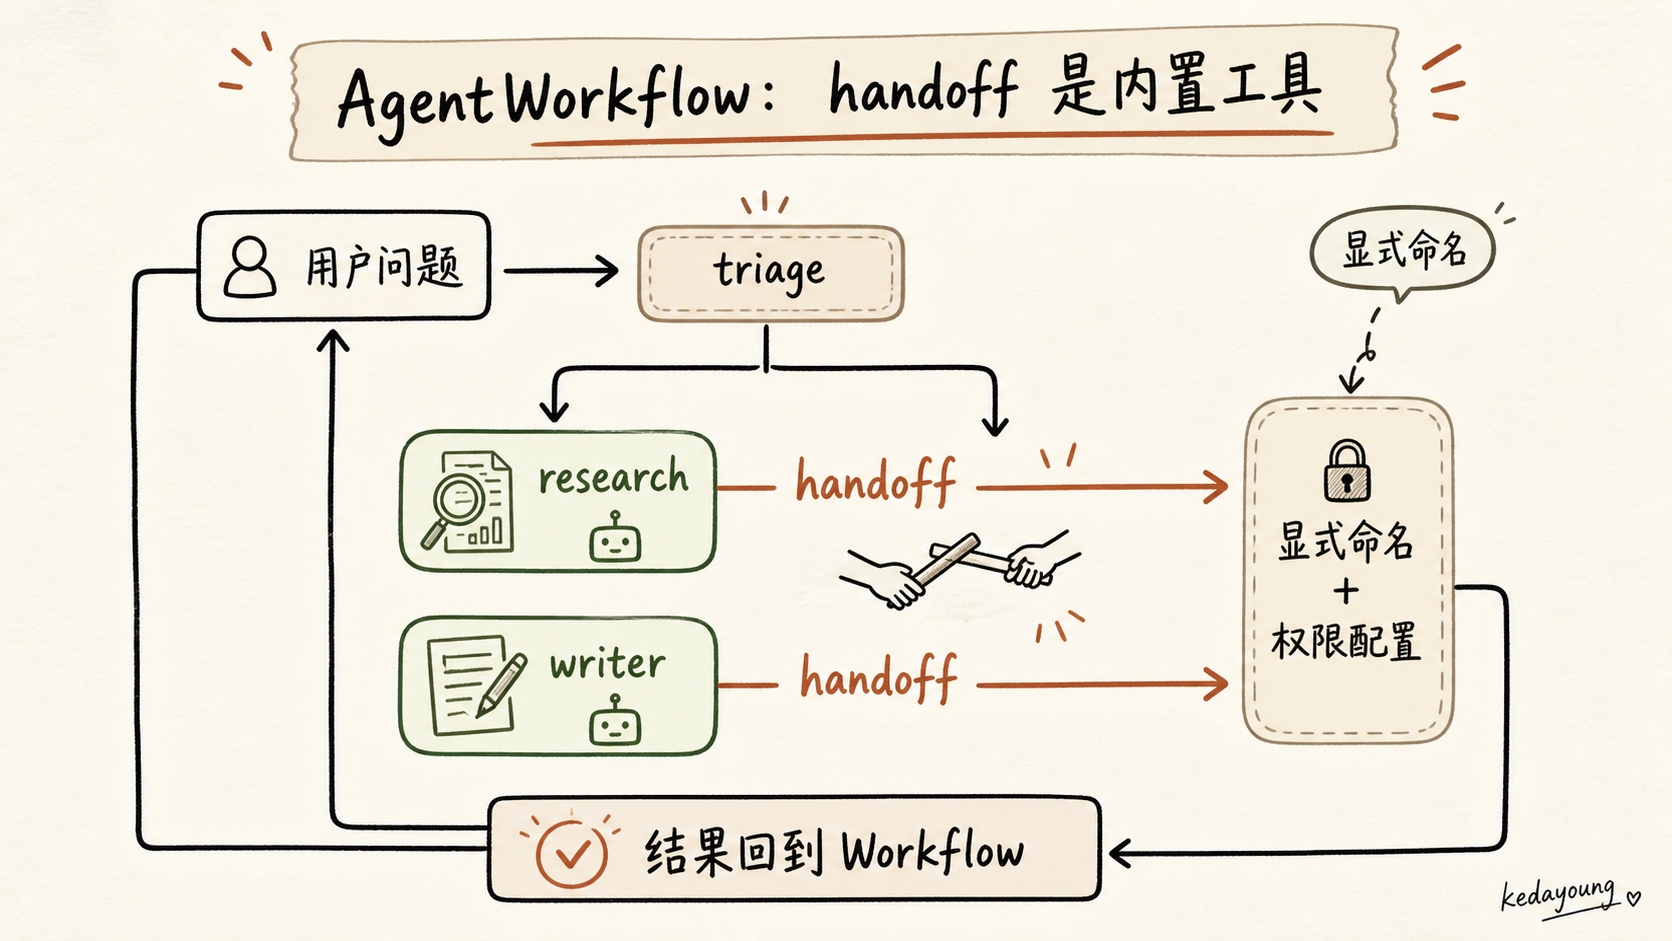
图 6|AgentWorkflow 多 agent handoff:转交目标受
can_handoff_to白名单约束,事件流贯穿
7. 设计取舍、局限与可迁移经验
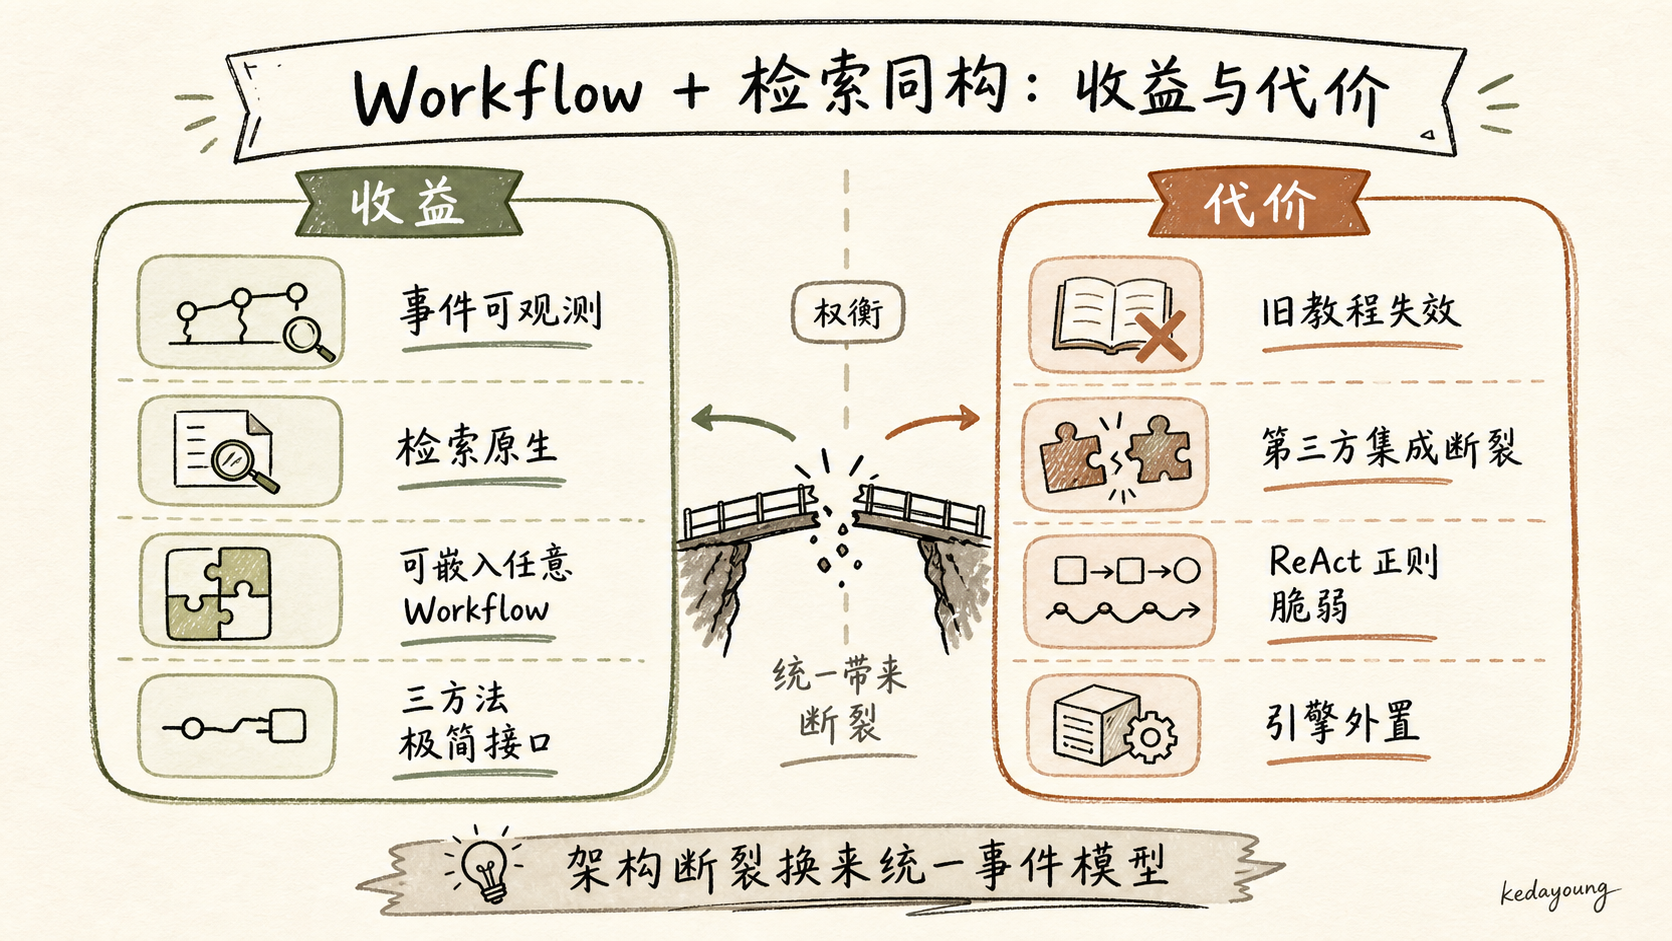
设计亮点(可迁移)
- Agent 即 Workflow(
base_agent.py:87-90):策略与运行时解耦,agent 可嵌入任意管道,编排器与 agent 共享同一套运行时。这是整套设计的支点。 - 三方法极简接口(
base_agent.py:245-265):自定义 agent 的门槛被压到「实现三个策略方法」,循环/重试/事件流白拿。接口面积小 → 心智负担小 → 生态贡献门槛低。 - 事件流 + instrumentation 天然可观测(
base_agent.py:329-340):中间产物全部流式可见,调试不再是 print 大法。 - 检索生态与工具统一:BaseTool 一条链(Index → Retriever → Tool → Agent),「检索优先框架」的范例级实现。
- 多 agent handoff 原生化(
multi_agent_workflow.py:73-92):没有新概念,工具 + 状态字段就完成了协作原语。
从这五点里可以提炼三条跨框架可迁移的原则(这也是本系列每篇都会收束出的「带走什么」):
- 运行时与策略分离:把循环、重试、超时这类横切机制收进基类/运行时,子类只描述单步策略。接口面积小了,自定义 agent 的门槛就低了——这是
BaseWorkflowAgent三方法设计的本质,也适用于你自己的 agent 框架。 - 能力做成「默认形态」:检索在 llama_index 里的成功,不是因为检索 API 好,而是因为检索结果默认就是工具输出——与 agent 消费的形态零转换。任何框架里,「让核心能力成为 agent 的原生消费形态」都比提供适配器更彻底。
- 失败进入模型可修正的回路:ReAct 的 retry_messages、handoff 的错误文本反馈,都是同一个原则的两种实现——把失败变成模型能读到的反馈,而不是直接中断。代价是 token,收益是鲁棒性。
局限(成文需诚实)
- 0.13.0 架构断裂的迁移成本:旧代码/旧教程/第三方集成大面积失效(
CHANGELOG.md:6153;agentmesh/worker.py:7至今残留旧 import)。 - 文本协议依赖正则解析:ReAct 的 Thought/Action 靠正则从模型文本里提取(
output_parser.py:15-25),CodeAct 的<execute>代码块同样靠正则抠出(codeact_agent.py:151-169)——格式漂移即失败,重试是 token 开销。 - FunctionAgent 硬前提(
function_agent.py:109-110):非 function-calling 模型直接报错,无降级路径。 - 引擎不在 core 内(
pyproject.toml:83):排障跨包,核心机制(事件路由、并发调度)在另一个仓库里。 - 默认迭代上限是硬失败:
early_stopping_method默认"force",超限直接抛WorkflowRuntimeError(base_agent.py:531-542)——长任务(检索 + 多轮工具调用很容易顶到上限)默认行为是中断而不是软化收场,需要显式调max_iterations或改"generate"。 - 状态存进程内 store(
ctx.store):无开箱的跨会话持久化,重启即失忆,生产级会话需要自己接存储。 - tool_retriever 每轮重取、粒度粗(
base_agent.py:279):动态工具集场景有额外延迟与检索噪声。
适用边界
(作者判断,请批判性看待)
文档/检索密集的 agent 应用(RAG 问答、私有知识库代理、数据查询助手)→ llama_index 首选;纯代码任务(写代码、跑测试、操作环境)→ 不如 pi / langgraph 系(CodeActAgent 虽有,但执行环境生态不如专门框架);需要精细图控制流(条件分支、并行 fan-out/fan-in 的可视化编排)→ langgraph 更直白。
系列收束:五种框架的对照总表
五篇「Agent 框架」实践——helloagents(教学)、langgraph(图)、openai-agents(handoff)、MetaGPT(角色)、llama_index(Workflow)——回答的是同一个问题:「agent 的循环与协作」有几种组织方式,各自用什么换什么。llama_index 的答案:用「架构断裂」换「agent 与检索管线同构」,用「模板方法极简接口」换「自定义 agent 的低门槛」,用「事件驱动隐式控制流」换「异步与解耦的自由」。
| 框架 | 循环组织 | 协作方式 | 状态 | 检索绑定 |
|---|---|---|---|---|
| helloagents | 继承基类 + 实现 run | 无(单 agent 教学) | 内存对象 | 手动接入 |
| langgraph | 显式图(channel 数据流) | 图节点编排 | 图 state(显式声明) | 手动/自定义节点 |
| openai-agents | 内置 loop(Runner) | Handoff 头等类型(handoffs/__init__.py:126) | context 参数传递 | 手动 |
| MetaGPT | 角色循环 | 消息总线广播 | 共享消息池 | 手动 |
| llama_index | Workflow 事件循环(基类提供) | handoff 工具 + can_handoff_to 权限 | ctx.store(进程内) | BaseTool 原生同构(差异化) |
附录 A:证据清单(成文时已逐条核对)
| 断言 | 证据位置(相对 0-agent-framework/20260810-llamaindex/) |
|---|---|
| 版本 0.14.23 | llama-index-core/pyproject.toml:37 |
| 0.13.0 breaking 记录(移除旧 agent 体系) | CHANGELOG.md:6153 |
| 废弃术语清单(AgentRunner/全部 step workers 等) | docs/src/content/docs/framework/changes/deprecated_terms.md:57-77 |
| 第三方集成残留引用旧类 | llama-index-integrations/agent/llama-index-agent-agentmesh/llama_index/agent/agentmesh/worker.py:7 |
| BaseWorkflowAgent 多重继承 + 元类 | llama-index-core/llama_index/core/agent/workflow/base_agent.py:83-84、:87-90 |
| 配置字段 | base_agent.py:94-142 |
| 三方法抽象接口 | base_agent.py:245-265 |
| 循环 step + 迭代上限 + retry + 结构化输出 | base_agent.py:520-622 |
| 迭代上限 force 抛 WorkflowRuntimeError | base_agent.py:531-542 |
| 事件流 AgentStream | base_agent.py:329-340 |
| 结构化输出(output_cls / structured_output_fn) | base_agent.py:569-605 |
| tool_retriever 每轮 aretrieve(input_str 取用户消息/历史末条) | base_agent.py:273-282(:279)、:405-427 |
| ReAct formatter/parser 可插拔字段 | llama-index-core/llama_index/core/agent/workflow/react_agent.py:41-48 |
| ReAct retry_messages 自修复 | react_agent.py:164-225 |
| ReAct 正则解析 | llama-index-core/llama_index/core/agent/react/output_parser.py:15-25 |
| FunctionAgent 硬前提 | llama-index-core/llama_index/core/agent/workflow/function_agent.py:109-110 |
| CodeActAgent 执行环境插件式(code_execute_fn → execute 工具) | llama-index-core/llama_index/core/agent/workflow/codeact_agent.py:70-75、:99-101 |
CodeActAgent 正则提取 <execute> 代码 | codeact_agent.py:151-169 |
| 引擎外置 llama-index-workflows | llama-index-core/pyproject.toml:83、llama_index/core/workflow/workflow.py:1 |
| AgentWorkflow handoff 函数 | multi_agent_workflow.py:73-92 |
| handoff 工具权限过滤 | multi_agent_workflow.py:216-246 |
| 多 agent 配置约束 | multi_agent_workflow.py:124-139 |
| 系列对照:helloagents Thought/Finish 工具化 | 0-agent-framework/20260810-helloagents-framework/hello_agents/agents/react_agent.py:85 |
| 系列对照:openai-agents Handoff 类型 | 0-agent-framework/20260810-openai-agents/src/agents/handoffs/__init__.py:126 |
附录 B:成文待办(初稿遗留)
- [ ] Workflow 引擎(对应图 4)的事件循环内部细节(step 并发调度、ctx 路由)保持 API 级描述——若需深入,需另行克隆
llama-index-workflows包核实行号。 - [ ] 与
0-rag-retrieval主题的边界:本篇第 5 节「检索即工具」已克制到「检索边界由工具 description 决定」一句,避免与那边的「检索边界/参数」深度重复;成稿前交叉检查一遍。 - [ ]
AgentWorkflow单 agent 模式(len(agents) == 1时自动设 root)未展开,若篇幅允许可补一句。 - [x] 结构图均已替换为正式 PNG,不再依赖目标发布平台的在线图表渲染能力。