代码基线:文中「mem0」指
mem0ai/mem0,本地克隆锁定 commit4debc58。所有file:line引用均以该克隆为准,路径前缀省略为仓库根。
引言
mem0 用两个 API(add / search)把记忆生命周期收敛成一个「加法系统」:写入侧是单次 LLM 调用、纯 ADD 提取(ADDITIVE_EXTRACTION_PROMPT 明确「Your sole operation is ADD」),靠哈希去重避免重复;检索侧用语义、关键词、实体三路信号加性融合,并让阈值在融合前拦截低分候选。它的简化姿态是「记忆只累积、不自动改写」——修订交给显式 update()/delete() API 与过期时间,新鲜度靠检索侧的时间过滤而非写入侧的覆盖写。
本文用 mem0 的真实代码回答一个问题:一个通用记忆层,在工程上到底把哪些事情做掉了,哪些事情留给了你? 路线:定位与能力边界(§1)→ 最小接口 add/search 与作用域治理(§2)→ v3 写入管线(§3)→ 存储与记忆对象(§4)→ 多信号检索(§5)→ 修订与边界(§6)→ 评测、对照与可迁移经验(§7)。
1. 从「记忆层」概念到 mem0:定位与能力边界
1.1 mem0 把「记忆层」做成什么形态
上一篇我们把「记忆层」定义为:位于 LLM 与外部存储之间、负责「记住 → 组织 → 召回」的基础设施。mem0 是这一概念最直白的开源实现之一——README 的 Introduction 把它定位为 AI 助手 / Agent 的记忆层(memory layer),核心卖点是三件套:给 LLM 追加记忆、检索相关记忆、管理记忆的持久化。
它提供的记忆是多级作用域的:记忆按 user_id(用户级)、agent_id(Agent 级)、run_id(会话/运行级)三套身份隔离,形成「User / Session / Agent」三种粒度。这一点在 add() 的签名上直接可见——三个 id 都是命名参数,至少传一个(mem0/memory/main.py:755-768)。
代码的入口非常收敛:一个 Memory 类(main.py:482)加一个 MemoryConfig(mem0/configs/base.py:29)。MemoryConfig 聚合五类配置:vector_store(向量库)、llm(提取用模型)、embedder(嵌入模型)、history_db_path(默认 ~/.mem0/history.db,SQLite 历史库)、reranker(可选重排器),外加两个行为开关:version(默认 "v1.1",见 base.py:50-53)与 custom_instructions(自定义提取指令,base.py:54-57)。
也就是说,一个 Agent 接上记忆层的「最小仪式」就是:
from mem0 import Memory
m = Memory.from_config(config_dict)   # 指定 vector_store / llm / embedder
m.add(messages, user_id="u1")          # 写入(add 接受顶层 user_id)
hits = m.search("他喜欢什么编程语言", filters={"user_id": "u1"})  # 检索(search 必须走 filters)
它在整个 Agent 架构中的位置(图 1):
图 1|记忆层在 Agent 架构中的位置
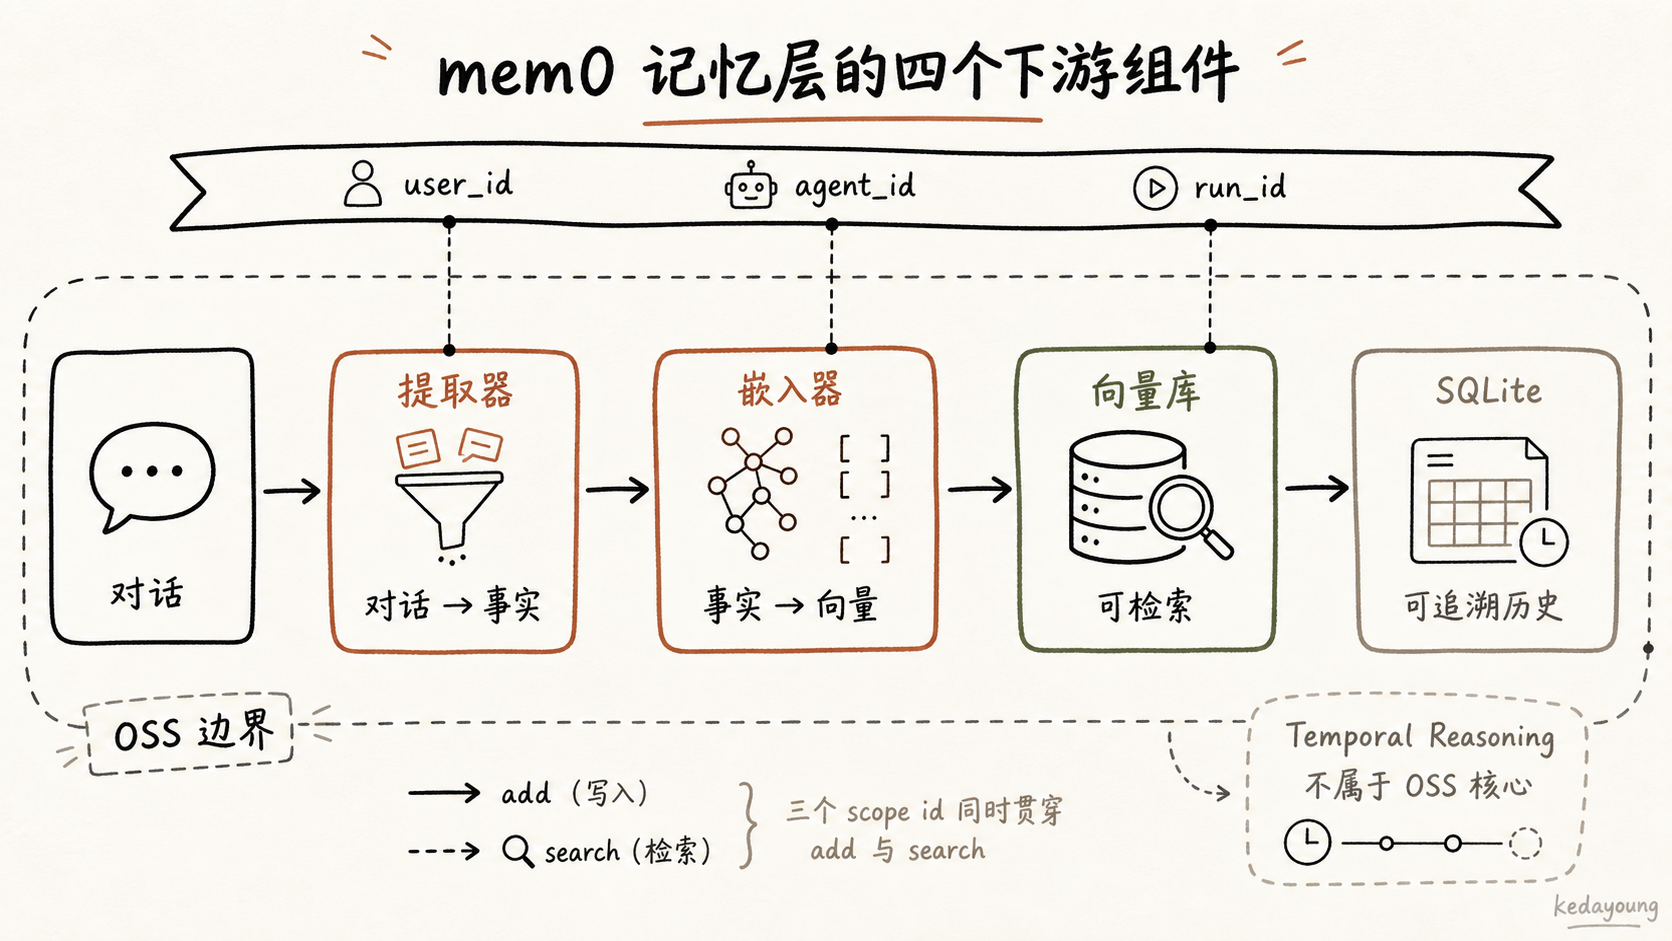
图注:四个下游组件各司其职——提取器负责「对话 → 事实」、嵌入器负责向量化、向量库负责检索、SQLite 负责可追溯历史;
user_id/agent_id/run_id三个作用域 id 贯穿写入与读取。图上没有画出的「Temporal Reasoning」等平台能力,就是第 1.2 节对照表里 ❌ 的那一行——它们不属于 OSS 记忆层,属于托管平台。
四个下游组件各司其职:提取器负责「对话 → 事实」、嵌入器负责向量化、向量库负责检索、SQLite 负责可追溯历史;user_id / agent_id / run_id 三个作用域 id 贯穿写入与读取。图上没有画出的「Temporal Reasoning」等平台能力,就是第 1.2 节对照表里 ❌ 的那一行——它们不属于 OSS 记忆层,属于托管平台。
1.2 能力边界先行:README 声称 vs OSS 实际
写实践文章最怕的坑,是把项目 README 的「能力宣言」当成「开源代码现状」。mem0 恰好是个典型案例:它的 README 在「New Memory Algorithm」一节(2026 年 4 月更新)列了五项新能力,但其中至少一项是托管平台专有的。先把对照表放在这里,后面每节再展开证据:
README 宣称(README.md 相关行) | OSS 代码实际状态 | 证据 |
|---|---|---|
| Single-pass ADD-only extraction | ✅ OSS 已实现 | ADDITIVE_EXTRACTION_PROMPT(prompts.py:468) |
| Agent-generated facts are first-class | ✅ OSS 已实现 | _create_procedural_memory(main.py:1988) |
| Entity linking | ✅ OSS 已实现 | 写入侧 Phase 7 实体链接(main.py:1081-1185) |
| Multi-signal retrieval | ✅ OSS 已实现 | _search_vector_store 三信号融合(main.py:1623) |
| Temporal Reasoning | ❌ 托管平台能力 | timestamp / reference_date 参数在 OSS 显式标注「Platform-only… Not supported in OSS」并抛错(main.py:782、:812-813、:1416、:1427-1428) |
这张表是全文的「能力地图」:读完之后你会知道,OSS 版 mem0 能放心依赖的,是纯 ADD 提取 + 哈希去重 + 三信号检索 + 过期时间过滤;而时间感知检索这类「魔法」属于付费平台,自建时必须自己补。
为什么会出现这种落差?答案藏在上游代码的注释里:ADDITIVE_EXTRACTION_PROMPT 写着「Ported from platform/backend/shared/core/config/prompts.py」(prompts.py:465-466)——OSS 的提取管线是托管平台的下游移植,二者同源;但 README 是平台团队写的,自然以平台能力为全集。于是「同源代码 + 平台级文档」就成了落差的结构性来源。这对所有「开源 SDK + 托管平台」双轨项目都成立:文档描述的能力全集里,总有几项依赖专有基础设施,OSS 侧只能做到「方向性相似」。
1.3 本节小结
mem0 的形态一句话:一个 Memory 类,把「记忆层」收敛成写(add)与读(search)两个入口,外加作用域隔离与配置注入。 它不是一个通用数据库,也不是 RAG 框架——它的全部价值在于「把对话变成可检索事实」这一段管线。而这段管线中 README 声称与 OSS 实际之间的边界,就是接下来三节的正文。
四个核心证据文件,贯穿全文:
| 文件 | 角色 |
|---|---|
mem0/memory/main.py | 同步 API 主实现:Memory.add、Memory.search、Memory.update/delete 及全部内部管线 |
mem0/configs/prompts.py | 提取指令:ADDITIVE_EXTRACTION_PROMPT 等 |
mem0/utils/scoring.py | 检索侧融合打分:BM25 归一化与 score_and_rank |
mem0/memory/storage.py | SQLite 历史与消息存储:SQLiteManager |
2. 最小接口:add / search 与作用域治理
2.1 写入入口:add()
add() 的签名(main.py:755-768)非常短:
def add(self, messages, *, user_id=None, agent_id=None, run_id=None,
        metadata=None, timestamp=None, expiration_date=None,
        infer=True, memory_type=None, prompt=None):
要点拆开看:
messages:str、dict或list[dict]三种形态都会被归一成消息列表(:834-846),每项是{"role": ..., "content": ...}。- 作用域三选一:
user_id/agent_id/run_id至少传一个(docstring:772)。三者可以组合,比如「某个用户的某个 Agent」。 metadata:随记忆存入向量库 payload 的自定义字段,检索时可用高级算子过滤(见 2.2)。expiration_date:YYYY-MM-DD字符串(或datetime),写入时归一化后塞进 metadata(:823-824),过期的记忆在检索/列表时默认隐藏。这是 OSS 里唯一的「时间」能力。timestamp:⚠️ 传了就抛ValueError(:812-813),错误信息来自get_temporal_feature_error_message——「Platform-only temporal parameter. Not supported in OSS」。infer:默认True走 LLM 提取;False则把消息原文原样入库(第 3 节详述,两条写入路径并存)。memory_type:目前只接受"procedural_memory"(配合agent_id走程序性记忆通道,:826-832、:848-857)。prompt:覆盖提取指令的临时参数(优先级高于MemoryConfig.custom_instructions,:941)。
2.2 读取入口:search()
search() 的签名(main.py:1374-1385):
def search(self, query, *, top_k=20, filters=None, threshold=0.1,
rerank=False, explain=False, reference_date=None, show_expired=False, **kwargs):query:检索的自然语言查询。top_k:默认 20,返回条数上限。filters:作用域过滤的唯一入口——必须至少包含user_id/agent_id/run_id之一,否则直接抛ValueError(:1452-1456)。此外还支持一套高级元数据过滤算子(docstring:1397-1412):精确匹配、eq/ne/in/nin/gt/gte/lt/lte/contains/icontains、通配*,以及AND/OR/NOT逻辑组合。threshold:最低得分门槛,默认 0.1(第 5 节会看到它「拦在融合前」的精确位置)。reference_date:⚠️ 与add的timestamp对称,传了就抛错(:1427-1428),OSS 不支持时间点检索。show_expired=True:把已过期的记忆也放进结果(默认隐藏)。explain=True:每条结果附带score_details(语义分 / BM25 分 / 实体加成 / 融合分),是调试检索质量的利器(:1721-1722)。
2.3 作用域治理的「写宽松、读严格」不对称
这是 mem0 API 设计里一个容易被忽略、但值得记下来的细节:add() 接受顶层实体参数,search() / get_all() 拒绝顶层参数、强制走 filters。
add() 里 user_id 是命名参数;而 search() / get_all() 中若有人传 search(query, user_id="u1"),会被 _reject_top_level_entity_params(:165-172)拦下并报错:
Top-level entity parameters {'user_id'} are not supported in search().
Use filters={'user_id': '...'} instead.
docstring 也把这条规则写得明明白白(:794-797)。为什么这么设计?一个合理的解释是:add() 的调用方通常只有一条写入路径,作用域直接给参数最顺手;而 search() 的 filters 需要承载作用域 + 元数据高级过滤两套语义,混用顶层参数会造成歧义(user_id 在 metadata 过滤里可能是某个字段名)。于是设计者选择「写入宽容、读取严格」,用报错把使用者逼到 filters 这一种形态上,保持读取侧语义单一。这是值得借鉴的 API 纪律。
2.4 两条写入路径:infer 开关
infer 是理解 mem0 行为的关键开关。_add_to_vector_store(:874)第一行就分叉:
infer=False(原始 ADD):不做任何 LLM 调用,把每条消息的content直接嵌入并入库(:875-909),role、actor_id(消息里的name)一并记入 metadata,事件标记为ADD。这条路径是「原文存档」,适合你只想让 Agent 记住原始对话、不想让 LLM 改写语义的场景(比如日志、法律/医疗原文)。infer=True(默认,LLM 提取):进入 v3 提取管线,下节完整拆解。
图 2|两条写入路径:infer 开关分叉
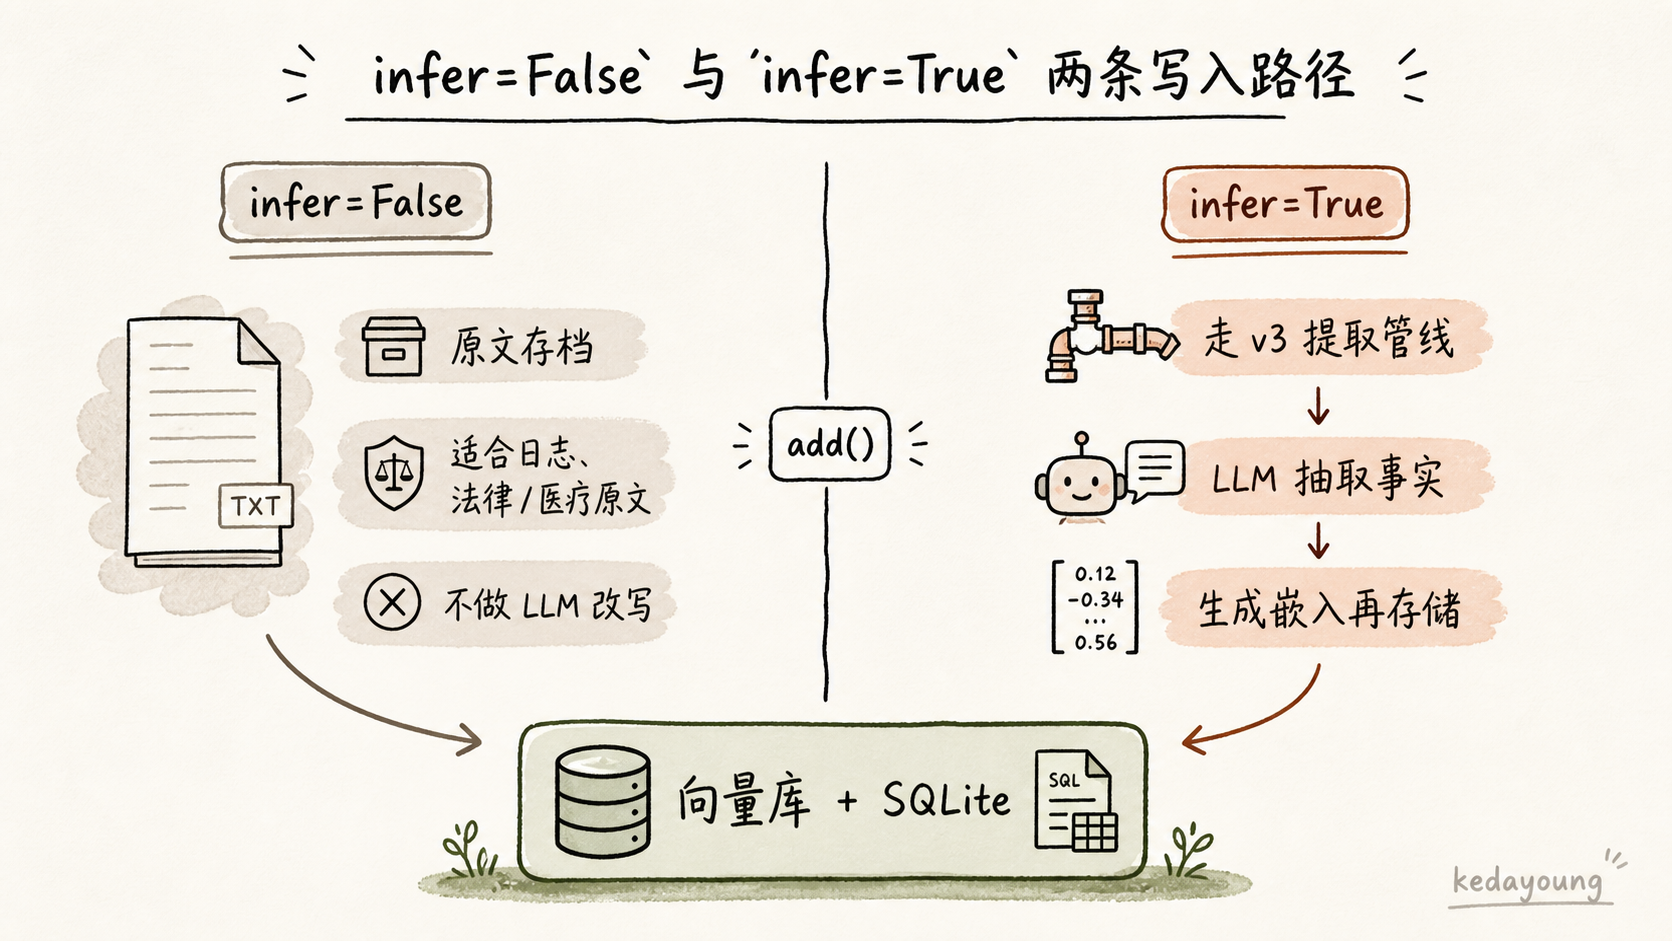
图注:
infer=False是「原文存档」路径(适合日志、法律/医疗原文),不做 LLM 改写;infer=True走第 3 节的 v3 提取管线。两条路径共用同一个向量库 + SQLite 双写。
一句话总结第 2 节:mem0 的最小接口是「写入一个函数、读取一个函数」,作用域靠三选一 id 表达、靠 filters 强制,infer 则给了你「提取入库还是原样入库」的选择权。 接下来进入全文最核心的一节——infer=True 时那条 v3 写入管线到底做了什么。
3. v3 写入管线:单次提取、纯 ADD、哈希去重
3.1 全景:一次 add() 调用发生了什么
add() 的 infer=True 分支最终落到 _add_to_vector_store(main.py:874),代码里赫然写着 # === V3 PHASED BATCH PIPELINE ===(:911)。这条管线把「一条对话变成一批记忆」拆成 8 个阶段,但全程只调用一次 LLM:
图 3|v3 写入管线:一次 add() 的八个阶段
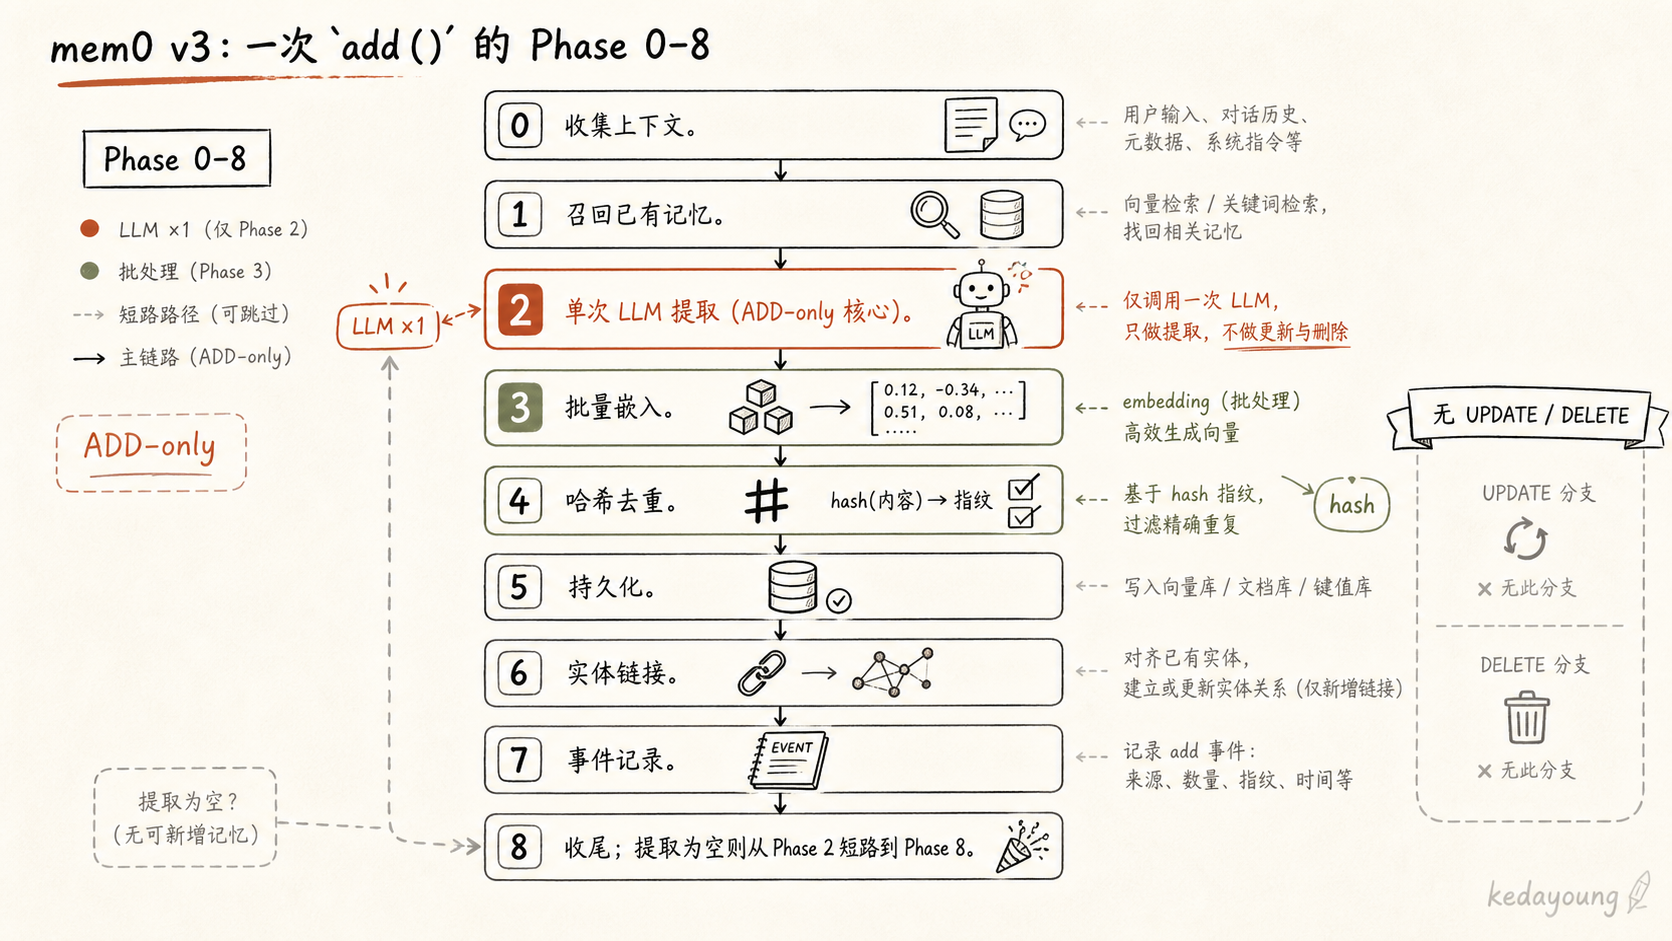
图注:整条链路上只有 Phase 2 是 LLM 调用,没有任何 UPDATE / DELETE 分支——这就是「ADD-only」在代码里的样子。提取为空时直接从 Phase 2 短路到 Phase 8。
视觉要点
整条链路上只有 Phase 2 是 LLM 调用,没有任何 UPDATE / DELETE 分支——这就是「ADD-only」在代码里的样子。下面按阶段拆解。
3.2 Phase 0–1:上下文收集与已有记忆召回
Phase 0 上下文收集(:913-916):先按作用域取最近消息作提取上下文:
session_scope = _build_session_scope(filters)
last_messages = self.db.get_last_messages(session_scope, limit=10)
这里取的是 SQLite 里该作用域最近 10 条消息(第 4 节会看到,SQLite 恰好只保留每个作用域最近 10 条——limit=10 不是巧合,是环形缓冲的容量)。
Phase 1 已有记忆召回(:918-933):对这批消息做一次向量检索,top_k=10 召回相关旧记忆,供 LLM 去重参考。有个细节很值得讲:召回结果的 UUID 会被映射成整数 id 再传给 LLM:
# Map UUIDs to integers (anti-hallucination)
uuid_mapping = {}
for idx, mem in enumerate(existing_results):
    uuid_mapping[str(idx)] = mem.id
    existing_memories.append({"id": str(idx), "text": mem.payload.get("data", "")})
注释写的是「anti-hallucination」——LLM 在 JSON 输出里编造一个不存在的 UUID 是常见幻觉,把真实 uuid 藏起来、只暴露 "0"、"1"、"2" 这种短 id,就能让「引用旧记忆」这件事无懈可击:LLM 只能引用我们给它的序号。这是一个小而美的工程技巧。
3.3 Phase 2:单次 LLM 提取(ADD-only 的核心)
提取的系统提示词是 ADDITIVE_EXTRACTION_PROMPT(mem0/configs/prompts.py:468),开头第一句就立规矩:
You are a Memory Extractor — a precise, evidence-bound processor… Your sole operation is ADD: identify every piece of memorable information and produce self-contained, contextually rich factual statements.
几个关键设计点(均来自 prompts.py:468 起的 prompt 正文):
- 用户与助手消息都提取:用户消息提取个人事实、偏好、计划、经历;助手消息提取给过的推荐、制定的计划、查到的信息——但助手内容要「以用户视角」转述(如 "User was recommended X"),避免把"我(助手)说了什么"当成记忆主体。
- 20 条最近提取记忆是主要去重依据:prompt 里的「Recently Extracted Memories」明确写着 "up to 20"、 "This is your primary deduplication reference — do not re-extract information already captured here"。
- 显式列出不提取的类别:泛化的奉承("you seem passionate")、助手通用应答("Sure!")、助手对自身能力的元评论——这些被明确排除。
- Existing Memories 只用于去重与链接,不从中提取:如果新消息与旧记忆语义等价且无新增信息,跳过;若相关则把旧记忆 UUID 填进新记忆的
linked_memory_ids。 - Observation Date 时间锚:prompt 要求把所有相对时间("yesterday"、"last week")都落到对话发生日(Observation Date),并给了一句很好的理由:"User went to Paris last week is useless 6 months later. 'User went to Paris the week of May 15, 2023' is meaningful forever."
调用侧(main.py:935-964)有几个工程细节:
- agent 作用域(有
agent_id无user_id)时,系统提示词追加AGENT_CONTEXT_SUFFIX(:936-939),把提取引导到 Agent 语境。 - 用户提示词由
generate_additive_extraction_prompt组装(:943),把 Phase 0 的最近消息、Phase 1 的已召回记忆、custom_instructions一起打包。 response_format={"type": "json_object"}(:956)强制 JSON 输出;解析时先剥代码块、容错 JSON 提取(:967-979)。- 提取失败 re-raise 而不是静默返回空(
:950-964):代码注释交代了历史——旧实现 LLM 失败时返回[],让上游分不清「LLM 挂了(429/5xx)」和「LLM 没提取出东西」,现在改成抛LLMError,把失败决策权还给调用方。
3.4 Phase 3–5:批量嵌入与哈希去重
- Phase 3 批量嵌入(
:986-999):embed_batch(mem_texts, "add")一次嵌入所有提取结果;批量失败则逐个嵌入回退,单条失败只告警不中断。 - Phase 4/5 哈希去重(
:1000-1034):这是「加法系统」能成立的保险丝。对每条提取结果计算md5(text),与「已有记忆的 hash 集合」和「本批已见 hash 集合」比对,命中即跳过:
mem_hash = hashlib.md5(text.encode()).hexdigest()
if mem_hash in existing_hashes or mem_hash in seen_hashes:
continue注意去重键是提取后文本的 md5:只要 LLM 这次提取的句子和上次逐字相同,就绝不重复入库。这很巧妙——它绕开了「语义去重」的复杂度(那是 LLM 的活,prompt 里已经让模型去重了),只用精确哈希兜底,把「LLM 漏了去重」的重复挡在门外。代价是:同义不同文的两条记忆("喜欢喝美式" vs "偏好美式咖啡")不会被哈希拦住,会并存——这被接受,因为并存比丢信息更安全,且语义层面的重复交给检索排序去稀释。
3.5 Phase 6–8:持久化、实体链接与收尾
- Phase 6 批量持久化(
:1040-1079):构造 payload(data、text_lemmatized、hash、created_at/updated_at),vector_store.insert批量插入,失败逐个回退;随后batch_add_history给每条记忆记一条ADD事件(:1059-1079)。 - Phase 7 实体链接(
:1081-1185,README「Entity linking」的 OSS 对应物):对新记忆批量提取实体(extract_entities_batch),去重后批量嵌入,到entity_store里search_batch找已存在实体(语义匹配阈值 0.95);命中就合并linked_memory_ids,未命中就新建实体记录(:1140-1182)。这条写入侧的实体索引,正是第 5 节检索侧「实体加成」的数据来源——实体关系在写入时建好、检索时按查询实体加分。 - Phase 8 收尾(
:1187-1201):save_messages存消息(供下次 Phase 0 用),返回[{"id", "memory", "event": "ADD"}]。
3.6 观察点:docstring 与实现的脱节
add() 的 docstring 至今仍写着(main.py:785-787):
infer (bool, optional): If True (default), an LLM is used to extract key facts from 'messages' and decide whether to add, update, or delete related memories.
但 v3 实现是纯 additive——_add_to_vector_store 里没有任何 update/delete 分支。README「New Memory Algorithm」宣称的转向("no UPDATE/DELETE. Memories accumulate; nothing is overwritten")在代码里已经落地,但 docstring 滞后了。这不是 bug,而是文档欠账;但这是个通用提醒:读开源库 API 文档时,行为以代码为准。 顺带预告:自动管线不做改写,不代表不能改写——修订被挪到了显式 API(update/delete),第 6 节专门讲。
4. 存储与记忆对象:向量库 + SQLite 历史
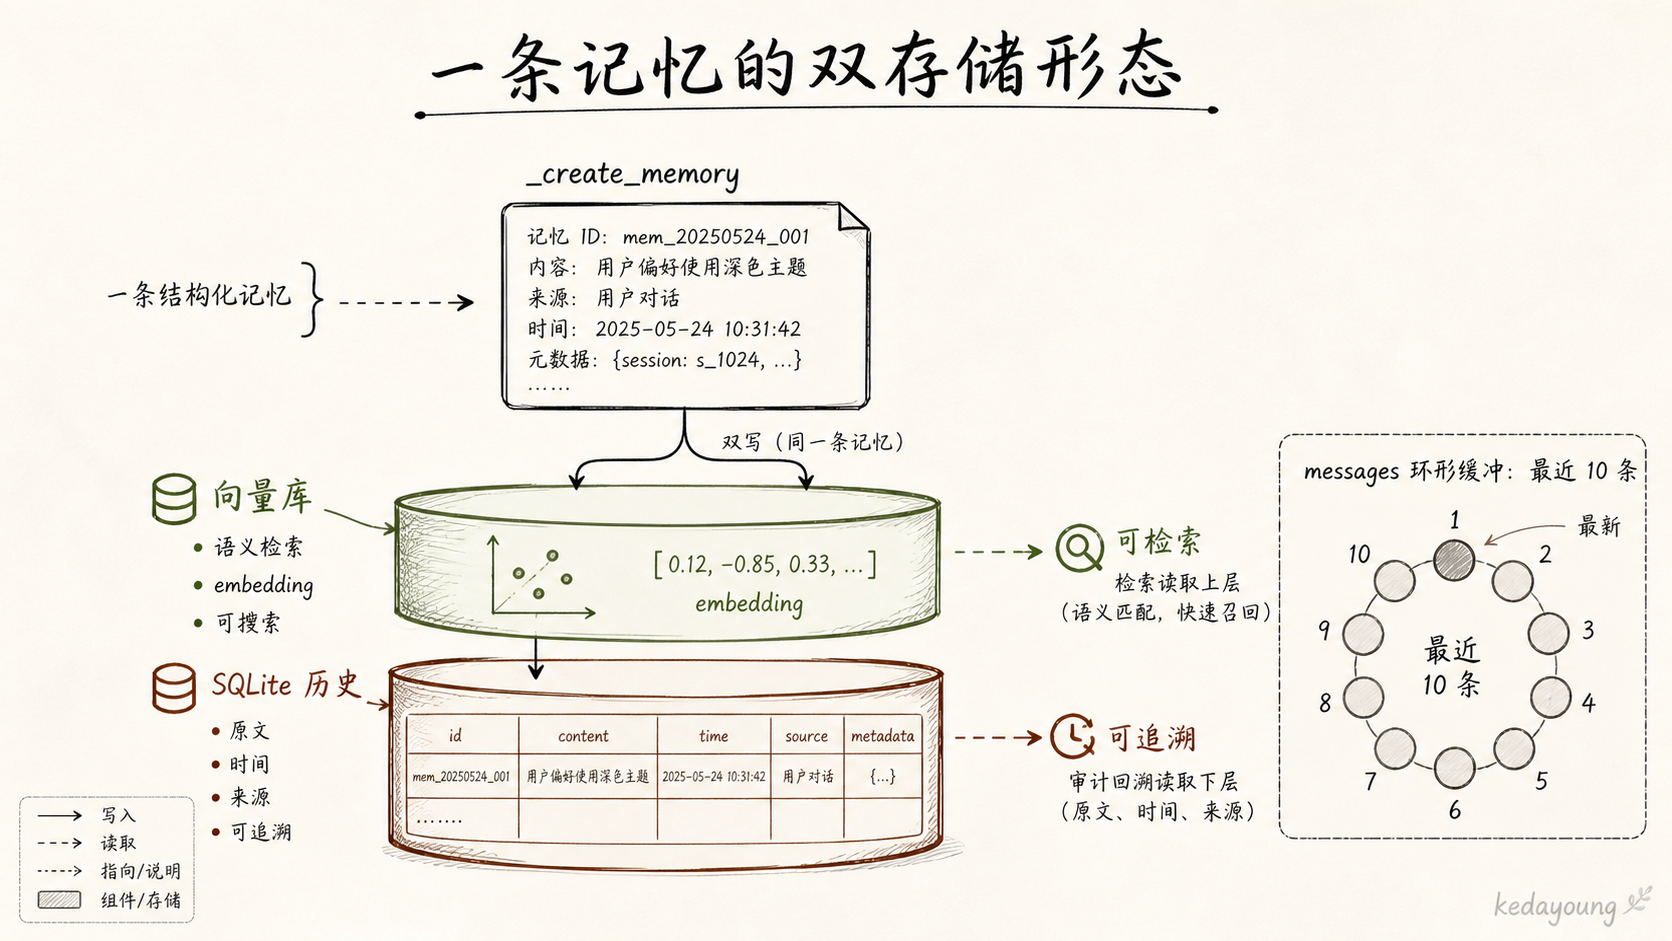
4.1 一条记忆的最终形态:_create_memory
infer=False 路径与 Phase 6 最终都会调用 _create_memory(main.py:1956-1986),一条记忆的「出生证明」是这样的:
memory_id = str(uuid.uuid4())
new_metadata["data"] = data
new_metadata["hash"] = hashlib.md5(data.encode()).hexdigest()
new_metadata["text_lemmatized"] = lemmatize_for_bm25(data)
self.vector_store.insert(vectors=[embeddings], ids=[memory_id], payloads=[new_metadata])
self.db.add_history(memory_id, None, data, "ADD", ...)逐项看:uuid4 作唯一 id;md5(data) 作去重指纹(与 Phase 4 同源);text_lemmatized 是词形还原后的文本(如 "likes" → "like"),专供 BM25 关键词检索;created_at/updated_at 自动打 UTC 时间戳。之后双写:向量库收正文与向量(承载检索),SQLite 收一条 ADD 事件(承载可追溯历史)。
4.2 双存储分工:「可检索」与「可追溯」分层
mem0 的存储不是单库,而是两层:
| 层 | 载体 | 存什么 | 服务什么 |
|---|---|---|---|
| 检索层 | 可插拔向量库(Qdrant / Chroma / FAISS…) | 记忆正文 + 向量 + payload metadata | 语义检索、关键词检索、实体检索 |
| 历史层 | SQLite(SQLiteManager,storage.py:11) | history 表(事件流)+ messages 表(原始消息) | 记忆变更追溯、写入上下文、调试 |
SQLiteManager(storage.py:11)默认建两张表:history 记录每条记忆的事件流(ADD / UPDATE / DELETE,带 old_memory/new_memory 和 actor_id/role,见 add_history :150-191);messages 记录原始对话消息(save_messages :257)。Memory.history(memory_id)(main.py:1941-1954)可以直接把某条记忆的完整演变史拉出来——这是「可追溯」的直接 API。
4.3 一个容易被忽略的设计:messages 环形缓冲
save_messages 的收尾有一段注释很说明问题(storage.py:279-291):
# Evict old messages beyond the most recent 10 for this scope.SQLite 的 messages 表每个作用域只保留最近 10 条消息
这跟 Phase 0 的 get_last_messages(limit=10) 正好对上:SQLite 不是消息仓库,而是「最近 10 条」的环形缓冲,只服务于提取时的上下文。想保留完整对话历史?那是你应用层的事,mem0 明确不做。这个「每个组件只做一件事」的分工,比把所有东西都塞进向量库要清醒得多。
4.4 程序性记忆:Agent 生成的事实
README 宣称「Agent-generated facts are first-class」——OSS 对应物是 _create_procedural_memory(main.py:1988)。当 add() 收到 agent_id + memory_type="procedural_memory" 时(入口分支 :848-857),走的是另一条通道:用 PROCEDURAL_MEMORY_SYSTEM_PROMPT(prompts.py:326)让 LLM 把一段对话提炼成「Agent 应当如何行动」的程序性记忆,memory_type="procedural_memory" 入库。这对应上一篇生命周期里的「程序性记忆」(procedural memory)——不是事实("用户喜欢 X"),而是行为规则("用户要求时应该 X")。它是与对话记忆平行的第二类记忆,在检索时同样参与打分。
4.5 本节小结
mem0 的记忆对象是「向量 + payload + SQLite 事件流」三位一体:向量库管检索、payload 管元数据、SQLite 管追溯与上下文。写入侧的"家底"到此讲完,接下来是另一半——记忆怎么被找回来,也就是 README 吹得最狠的「Multi-signal retrieval」。
5. 多信号检索:semantic + BM25 + entity 的加性融合
5.1 为什么只靠向量相似度不够
纯向量检索(semantic search)有两个已知短板:一是专名/缩写这类对语义嵌入不敏感的词,相似度会被稀释(搜 "BERT" 未必召回含 "BERT" 的记忆);二是精确词命中反而可能是强信号(用户搜 "密码重置" 时,含 "密码" 的记忆即便语义向量一般也该排前面)。混合检索(hybrid retrieval)的标准解法是关键词信号(BM25)兜底,而 mem0 在此基础上又加了第三路——实体加成。_search_vector_store(main.py:1623)把这三路信号并行打分、归一化后加性融合。
5.2 检索管线九步拆解
完整流程在 _search_vector_store(main.py:1623-1726),按顺序:
- 预处理查询(
:1629-1630):查询词形还原(供 BM25)+ 实体提取(供实体加成)。 - 嵌入查询(
:1633)。 - 语义召回 over-fetch(
:1636-1639):internal_limit = max(limit * 4, 60)——先超量取候选(top_k=20时取 80 条),为后续融合留出「陪跑池」。这是混合检索的标准姿势:召回宁可多、排序交给融合。 - 关键词召回(
:1642-1644):vector_store.keyword_search,用词形还原后的查询。 - BM25 归一化(
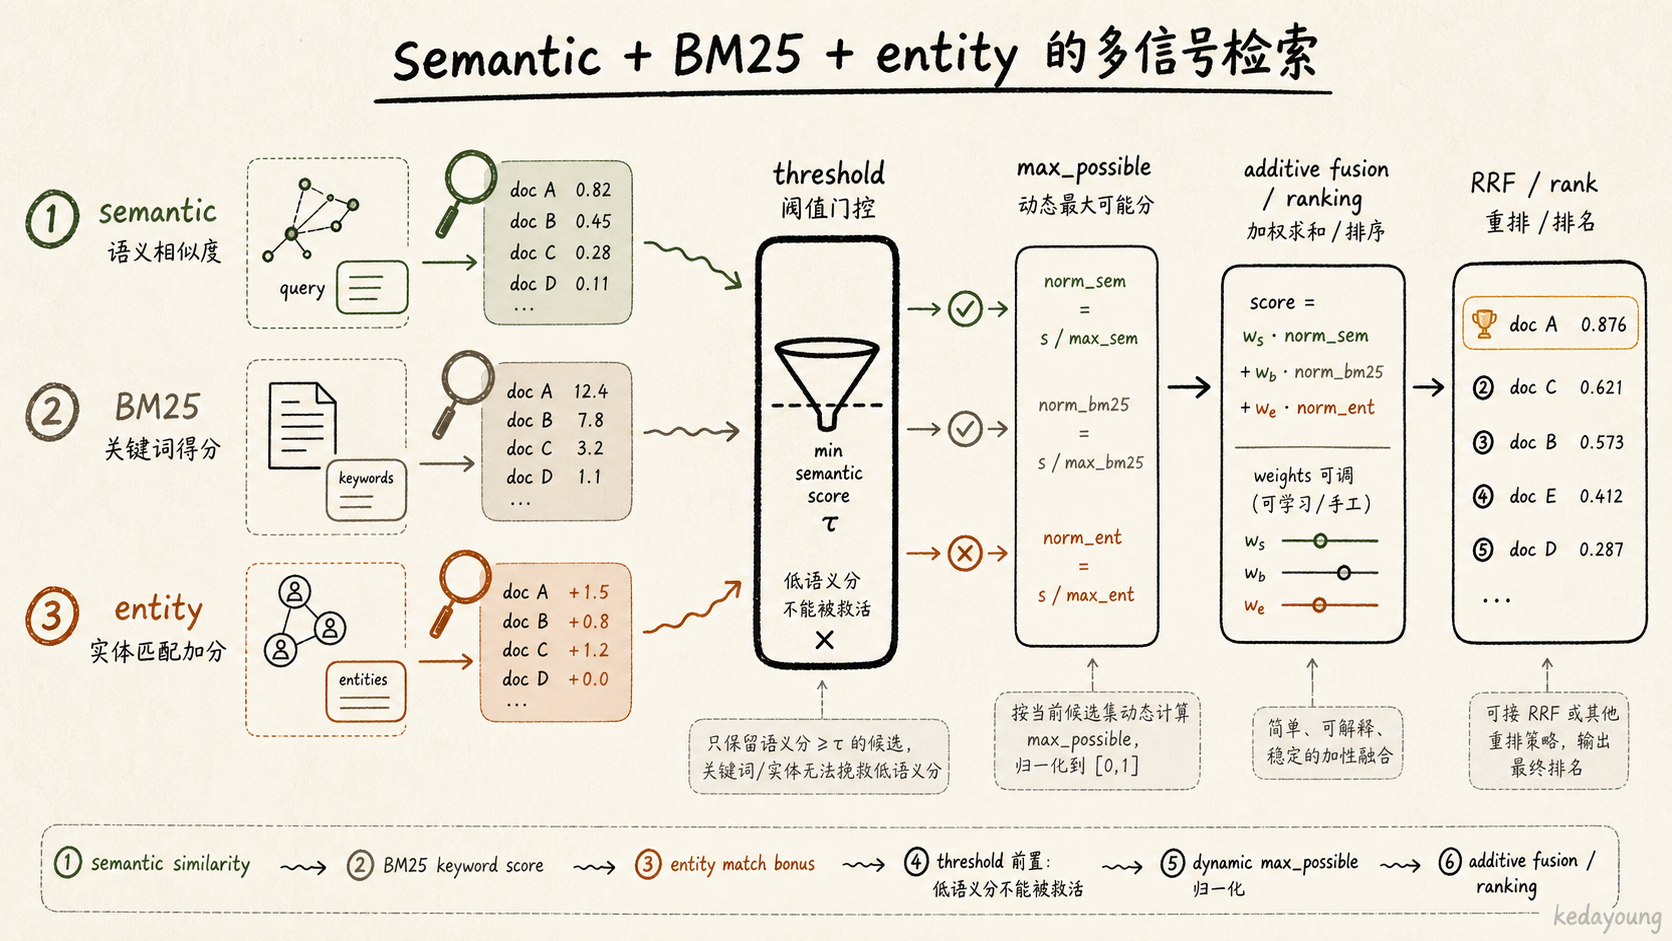
:1646-1654):原始 BM25 得分无界(0–20+),先用 logistic 压到 [0,1]:normalize_bm25 = 1 / (1 + exp(-steepness * (score - midpoint)))(scoring.py:43-54)。sigmoid 参数按查询长度自适应(get_bm25_params,scoring.py:16-40)——查询越长原始 BM25 越高,midpoint 就越大(3 词以内(5.0, 0.7),15 词以上(12.0, 0.5))。 - 实体加成(
:1656-1659):_compute_entity_boosts(:1728-1808),见 5.3。 - 候选集过滤过期(
:1661-1672):遍历语义候选,_payload_is_expired剔除已过期记忆(除非show_expired=True)。 - 融合排序(
:1675-1682):score_and_rank(scoring.py:60)。 - 结果格式化(
:1684-1726):把 payload 里的user_id/agent_id/run_id/role/expiration_date等提升为结果字段,其余 metadata 归入metadata;explain=True时附带score_details。
5.3 融合公式与「阈值前置」
score_and_rank(scoring.py:60-139)是检索的灵魂,核心就三行:
semantic_score = result.get("score") or 0.0
if semantic_score < threshold:      # 阈值在融合前拦截
    continue
combined = min((semantic_score + bm25_score + entity_boost) / max_possible, 1.0)
三个关键设计:
- 加性融合 + 自适应分母:
max_possible按实际启用的信号动态取值(scoring.py:97-101)——仅语义1.0;+BM252.0;+实体2.5;语义+实体(无 BM25)1.5。这样无论几路信号参与,融合分都落在 [0,1],不会因为信号多就天然分数高。 - 阈值拦在融合前(
scoring.py:110-112):semantic_score < threshold直接跳过——关键词和实体只能锦上添花,不能把语义低分救活。这是防止"混合检索把无关结果抬进 top-k"的关键闸门。threshold的默认值 0.1 很低,语义分过不了 0.1 的记忆本来就不该出现。 - explain 可观测:
explain=True时每条结果带score_details(scoring.py:126-135):semantic_score/bm25_score/entity_boost/raw_score/max_possible_score/final_score/threshold——调阈值、查"为什么这条没进 top-k"全靠它。
一个具体的数字例子
假设一条候选记忆语义分 0.55,BM25 归一化 0.40,实体加成 0.15,三路信号齐活(max_possible=2.5)→ 融合分 min((0.55+0.40+0.15)/2.5, 1.0) = 0.44。若 threshold=0.5,语义分 0.55 过了门槛,得以参与融合;而另一条语义分 0.45 的记忆,哪怕 BM25 0.6、实体 0.4(加和远超 0.5),也会在融合前被直接扔掉——门槛管语义、加成管排序,职责分明。
图 4|检索管线:over-fetch 召回 → 三路打分 → 阈值前置 → 加性融合
图注:
threshold拦在融合之前——关键词和实体只能锦上添花,不能把语义低分救活;max_possible按实际启用的信号动态取值,保证融合分落在 [0,1]。
5.4 实体加成:写入时建链、检索时加分
_compute_entity_boosts(main.py:1728-1808)的工作方式,正好消费第 3 节 Phase 7 写入的实体索引:
- 对查询实体去重,最多取 8 个(
:1739-1746); - 批量嵌入实体文本,到
entity_store检索,top_k=500、相似度 ≥ 0.5 才采纳(:1768-1791); - 命中实体的
linked_memory_ids指向的记忆获得加成:boost = similarity ENTITY_BOOST_WEIGHT memory_count_weight(:1797-1798)。其中ENTITY_BOOST_WEIGHT = 0.5(scoring.py:57),memory_count_weight对链接了大量记忆的"热实体"降权(1/(1+0.001*(n-1)^2),:1797)——防止明星实体把一批记忆无差别抬分。
因为 similarity ≤ 1 且 memory_count_weight ≤ 1,单条实体加成天然封顶 0.5(docstring :1737 也写明 [0, 0.5])。这保证了实体信号只能做语义的补充,不能反客为主。多实体命中时取各实体的最大加成(:1803)。
5.5 本节小结
mem0 的检索是一个教科书级的混合检索管线:over-fetch 召回 → 三路并行打分 → 各自归一化 → 加性融合 → 阈值前置拦截 → top_k 裁剪。它回答了一个常见疑问:"向量相似度之外还要什么?"——要关键词兜底专名、要实体关系补强关联记忆,但用融合前阈值守住底线,让加成永远只是排序的微调。explain=True 让这一切可调试,这是自建记忆层时最该抄的作业之一。
6. 修订与边界:显式 API、过期时间与 OSS 功能落差
6.1 「自动管线 ADD-only」与「显式修订入口」并存
自动管线不改写记忆,不代表记忆不可改。v3 的准确画像是:写入自动、修订手动。三个显式 API 都在:
update(memory_id, text=..., metadata=..., expiration_date=...)(main.py:1810-1862):按 id 更新记忆正文/元数据/过期时间。注意user_id/agent_id/run_id在 update 里被明确忽略——作用域创建后不可变(docstring:1825-1826),避免"改 id 把记忆挪到别人的作用域"这类事故。expiration_date传None表示清除过期。delete(memory_id)(:1864-1883):按 id 删除;id 不存在抛ValueError。删除会同步处理向量库与 history(事件DELETE)。delete_all(user_id=..., agent_id=..., run_id=...)(:1885-1939):按作用域批量清空。实现里有个细节(:1913-1927):因为多数向量库list()默认只返回 100 条,它循环分批删除并记录已见批次,批次重复即停止——防止delete_all静默删不干净。
对照第 3 节再看一遍:add() 的 docstring 说 LLM 会 "decide whether to add, update, or delete",但 v3 提取器只有 ADD 一种操作;真正的 update/delete 是人(或上层编排)调用的显式 API。README 的表述("Memories accumulate; nothing is overwritten")与代码一致——这就是 v3 的完整画像:加法管线 + 手动修订。
6.2 过期时间:写入侧标注、检索侧过滤
OSS 唯一的"时间"能力是过期(TTL),实现是两端配合:
- 写入:
expiration_date(YYYY-MM-DD)归一化后塞进 payload metadata(:823-824)。 - 检索:候选集构建时
_payload_is_expired(:1665)比对当前日期,过期即剔除;show_expired=True可显式包含(:1384)。 - 语义:过期不是删除,是"默认藏起来"——
get_all/search都遵守;delete才是真正清除。对"临时记忆"(如一场活动的提醒)这是够用的机制。
图 5|修订与过期:显式 API 与 TTL 两端配合
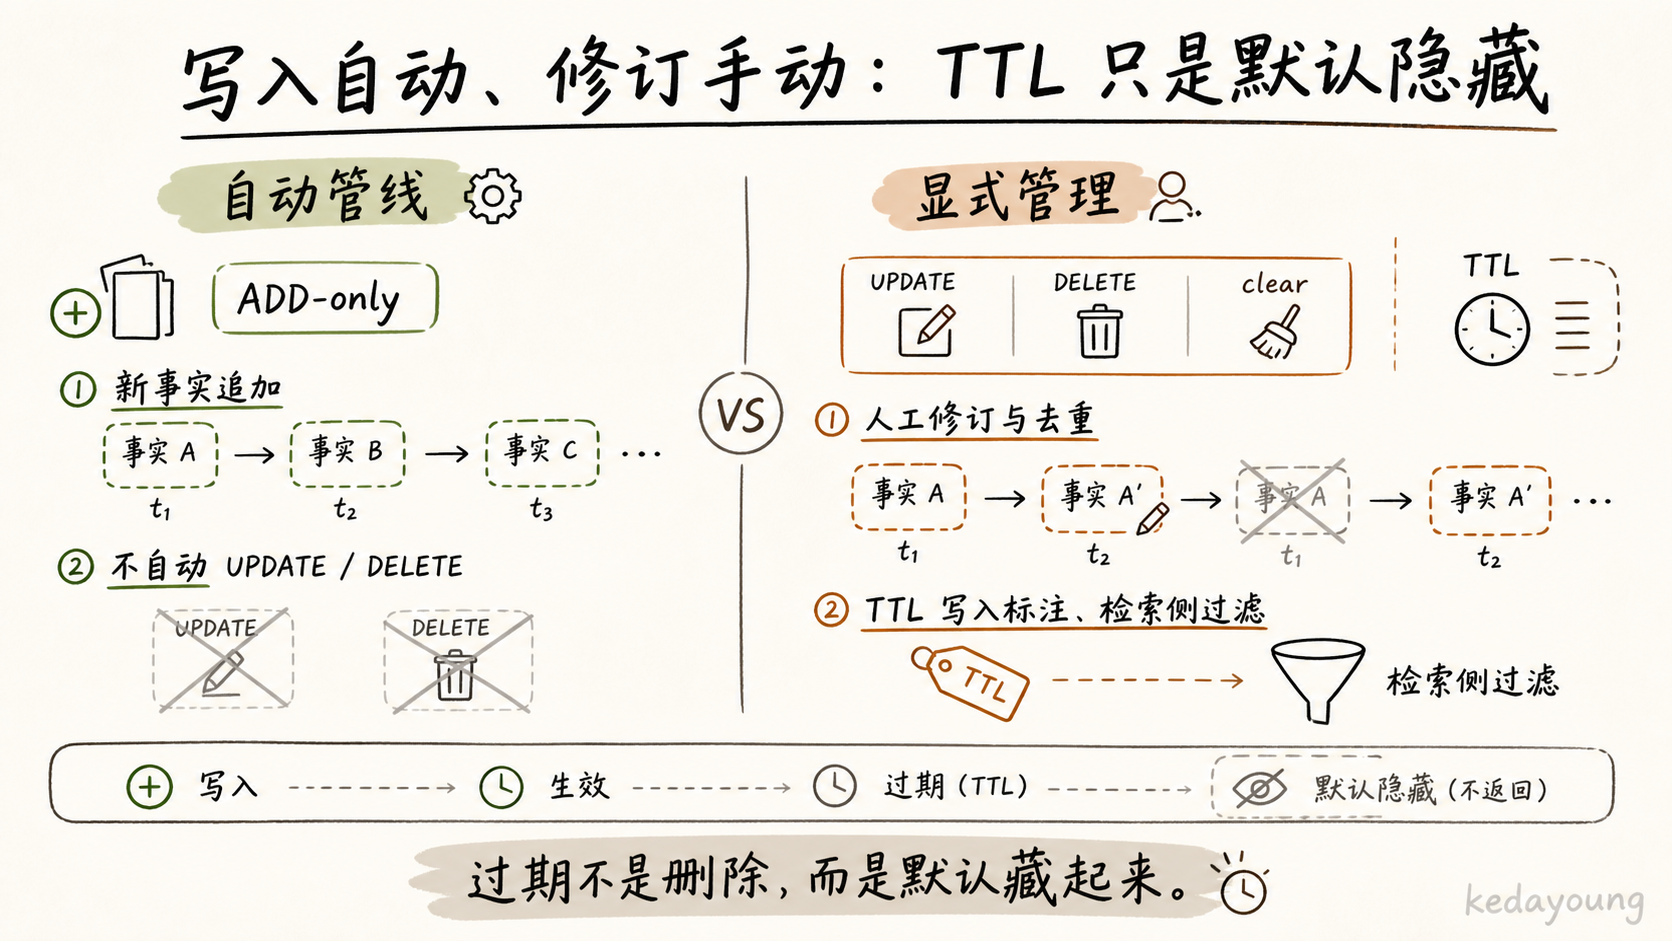
图注:「写入自动、修订手动」——自动管线只 ADD,改错/去重/清空走显式 API;过期(TTL)是写入侧标注、检索侧过滤,过期不是删除,而是"默认藏起来"。
6.3 README 与 OSS 的落差清单
把全文的"声称 vs 实际"收拢成一张表,就是最终的能力地图:
| README 宣称 | OSS 代码 | 状态 |
|---|---|---|
| "Single-pass ADD-only extraction — one LLM call, no UPDATE/DELETE" | ADDITIVE_EXTRACTION_PROMPT + Phase 2 单次调用 | ✅ 一致 |
| "Agent-generated facts are first-class" | _create_procedural_memory(procedural memory 通道) | ✅ 一致 |
| "Entity linking — entities extracted, embedded, and linked across memories" | Phase 7(main.py:1081-1185) | ✅ 一致 |
| "Multi-signal retrieval — semantic, BM25, entity scored in parallel and fused" | _search_vector_store + score_and_rank | ✅ 一致 |
| "Temporal Reasoning — time-aware retrieval that ranks the right dated instance" | timestamp/reference_date 传入即抛错 | ❌ 仅托管平台 |
结论很直接:README 是「托管平台能力 + OSS 能力」的并集。凡涉及"时间推理"(Temporal Reasoning)的宣称,OSS 用户都拿不到——代码甚至用抛错把边界焊死,防止误用。这也解释了为什么很多教程照 README 写出来的示例,在本地跑会报错:示例用的是托管平台参数。写实践文章、做技术选型时,把"README 能力"和"可运行能力"分开,是第一课。
6.4 本节小结
修订的完整图景是:自动管线只 ADD,修订交给显式 update/delete/delete_all,时间只提供过期过滤。这套设计的自洽之处在于:让提取 LLM 专注"记住新东西"这一件事,把"改/删"从自动路径彻底拿掉,避免 LLM 在写路径上做高风险改写;需要改错、去重、清空时,由上层用确定性代码显式操作。用加法代替改写,把修订变成显式动作——这是 mem0 最值得带走的设计哲学之一。
7. 评测、对照与可迁移经验
7.1 官方基准:看数字之前先看口径
README「New Memory Algorithm」给了一组基准(README.md:45-68):
| 基准 | 旧算法 | 新算法 | 说明 |
|---|---|---|---|
| LoCoMo | 71.4 | 92.5 | 长期对话记忆 |
| LongMemEval | 67.8 | 94.4 | 其中 assistant memory recall 98.2 |
| BEAM (1M) | — | 64.1 | 百万 token 级生产规模评测 |
| BEAM (10M) | — | 48.6 | 千万 token 级 |
但口径必须读:README 在同一段明确写了(README.md:52-53)——所有数字跑在 "Mem0's managed platform, which includes proprietary optimizations not available in the open-source SDK; open-source users should expect directionally similar gains but not identical numbers"。翻译过来:这些是官方自测、含托管平台专有优化(很可能就包括 OSS 里被焊死的 Temporal Reasoning),OSS 结果方向性相似但不一致。所以本文不把这些数字当作 OSS 独立复现结果,也不拿它跟其它记忆方案排名——正确的读法是:v3 的加法架构 + 混合检索,在官方口径下比 v2 提升显著,方向可信、数值不可直接迁移。
7.2 系列内对照:三条记忆路线
回到系列框架,把三种已读过的记忆方案并排看(hello-agents 与 pi 的细节以系列前文描述为准,非本次代码核查范围):
| 维度 | hello-agents MemoryTool | pi(会话树) | mem0(本文) |
|---|---|---|---|
| 存储结构 | 工作记忆(短期、随上下文进出) | 会话树 + checkpoint 摘要折叠 | 外部事实库(向量 + SQLite 事件流) |
| 写入策略 | 教学式注入(工具显式告知) | 会话过程中持续折叠摘要 | 单次 LLM 提取,ADD-only + 哈希去重 |
| 检索方式 | 随提示词携带(显式) | 沿树回溯父节点摘要 | semantic + BM25 + entity 三信号融合 |
| 修订方式 | 直接覆写工作记忆 | 折叠即覆写 | 显式 update/delete + 过期时间 |
三条路线的差异根源在存储结构与写入哲学:hello-agents 把记忆当"上下文的一部分"(随会话进出,弱持久化);pi 把记忆当"会话树的摘要"(随对话生长,结构与对话绑定);mem0 把记忆当"独立的事实资产"(与对话解耦,靠 id 索引、靠作用域隔离)。选哪条,取决于你的 Agent 是"一次性长对话"(pi 占优)、"轻量多轮"(hello-agents 够用)还是"跨会话长期记忆"(mem0 的用武之地)。
怎么选?一个实用的判断顺序:先问记忆要不要跨会话长期存活——不要,hello-agents 的工作记忆足够;要,再看记忆形态是"跟着对话长"还是"跟着事实走"——前者 pi 的会话树天然契合,后者(跨会话反复查询的事实库)才轮到 mem0 这类外部记忆层。另一个参考维度是工程代价:pi 与 hello-agents 几乎不需要额外基础设施,mem0 要引入向量库、嵌入服务、提取 LLM 三条外部依赖;如果场景只有几千条记忆、又不想维护这些依赖,为这点量级引入整套混合检索可能并不划算。
7.3 可迁移模式(作者判断)
从 mem0 的代码里,有四条不依赖任何 LLM 服务的工程模式值得自建记忆层时直接抄(以下为作者基于代码阅读的判断,非官方背书):
- 最小 API 面:把记忆收敛成
add(messages, scope)/search(query, scope, ...)两个入口 + 作用域过滤。API 少,心智负担小,作用域强制反而杜绝了"跨用户串记忆"的脏数据。 - 单次提取 + 哈希去重:用「加法 + 精确去重」替代「提取时改写」。LLM 在写路径上只做"记住新东西",改错/合并交给显式 API——既省 token,又把写路径的风险降到最低。
- 阈值前置的混合检索:语义分不过门槛,BM25/实体加分再多也不进结果。这比"先融合再截断"更能守住相关性底线,且
explain输出让每个分数可审计。 - over-fetch + 融合 + top_k 裁剪:召回超量(4x 或至少 60)、排序精算、按需裁剪——召回与排序解耦,是任何混合检索的标准骨架。
7.4 边界与适用性
最后说清楚 mem0 的边界,避免误用:
- 依赖外部服务:提取与嵌入都靠外部 LLM/embedding 服务,记忆质量 = 提取质量 + 嵌入质量。
custom_instructions(base.py:54-57)和prompt参数(main.py:941)是你调提取行为的唯一抓手,值得花力气。 - "原样存储"是特定场景的选项:
infer=False把消息原文入库,适合原文存档(日志、合规场景),但要接受它不做去重、不做提炼。 - 时间能力止步于过期:想按"当时 vs 现在 vs 将来"做时间推理,OSS 给不了,得在应用层自己建模。
- 哈希去重不拦同义:
md5只挡逐字重复,语义重复靠提取 prompt 的 20 条去重参考 + 检索排序稀释——高频场景下你仍可能看到"两条说得一样的话"。
结语
回到开篇的问题:一个通用记忆层,在工程上把哪些事情做掉了?——mem0 的答案清晰而克制:它替你做好了「对话 → 可检索事实」的加法管线(单次提取、哈希去重、实体建链)与「查询 → 排序结果」的混合检索(语义 + BM25 + 实体、阈值前置),并把这套能力收敛成 add / search 两个 API。 它不做的事同样明确:不自动改写(修订归显式 API)、不做时间推理(归托管平台)、不存完整历史(SQLite 只留最近 10 条消息)。这种「把边界焊死」的姿态,恰恰是它作为开源记忆层最值得学习的地方——知道一个组件不管什么,和知道它管什么,同等重要。
系列预告:下一篇将基于本文的检索管线,实测
explain=True的score_details在不同threshold下的行为,把「阈值前置」的直觉量化成调参指南。
附录 A:证据索引(与正文对应的代码位置)
| 正文断言 | 证据位置(20260810-mem0/ 克隆,commit 4debc58) |
|---|---|
Memory 类入口、MemoryConfig(version 默认 v1.1) | mem0/memory/main.py:482;mem0/configs/base.py:29、:50-53 |
add() 签名与作用域参数 | mem0/memory/main.py:755-768 |
timestamp / reference_date 平台限定、OSS 抛错 | mem0/memory/main.py:782、:812-813、:1416、:1427-1428 |
infer=False 原始 ADD 路径 | mem0/memory/main.py:875-909 |
| v3 写入管线 Phase 0–8 | mem0/memory/main.py:911-1201 |
| 单次 LLM 提取(ADD-only prompt、agent suffix、JSON 强制、失败 re-raise) | mem0/configs/prompts.py:468;mem0/memory/main.py:936-964 |
| UUID→int 防幻觉映射 | mem0/memory/main.py:928-933 |
| 哈希去重(md5、existing+seen) | mem0/memory/main.py:1000-1034 |
| Phase 7 实体链接(写侧建链) | mem0/memory/main.py:1081-1185 |
_create_memory(uuid4/hash/lemmatize/insert/history) | mem0/memory/main.py:1956-1986 |
_create_procedural_memory(agent 事实通道) | mem0/memory/main.py:1988、:848-857 |
| SQLite 双表、消息环形缓冲(每 scope 10 条) | mem0/memory/storage.py:11、:257、:279-291、:298 |
search() 签名、filters 强制作用域、元数据算子 | mem0/memory/main.py:1374-1412、:1452-1456 |
| 检索九步(over-fetch 4x/60、BM25、实体、过期、融合) | mem0/memory/main.py:1623-1726 |
| entity boost(≤8 实体、top_k=500、阈值 0.5、上限 0.5) | mem0/memory/main.py:1728-1808;scoring.py:57 |
| 融合公式与阈值前置 | mem0/utils/scoring.py:60-139(:97-101、:110-112、:118-119) |
| BM25 归一化与参数自适应 | mem0/utils/scoring.py:16-54 |
| 显式 update / delete / delete_all 与过期过滤 | mem0/memory/main.py:1810、:1864、:1885、:1665、:1384 |
| README 宣称与基准数字(含 managed platform 口径) | README.md:45-68 |
本文为「Agent 记忆」系列第二篇,代码锁定 mem0ai/mem0 commit 4debc58(2026-08-10 克隆)。文中所有 file:line 以该克隆为准;若你读到更新版本,请以你本地代码为准并核对行号位移。