版本口径:文中「MetaGPT」指本地克隆
0-agent-framework/20260810-metagpt/(FoundationAgents/MetaGPT),路径均省略该前缀。 证据说明:本文为代码级分析,未实际运行 Team 流程(依赖 llama_index / FAISS / LLM key);文中已写出的行号引用均已逐条核对(第 6 节对照表行号待补,见附录 B)。标注「作者判断」处为个人观点,其余为代码事实。
如果你让一个 LLM 扮演产品经理,另一个扮演架构师,再雇一个工程师和一个测试——它们会像一家真的软件公司那样协作吗?
这个问题正是 MetaGPT 的起点。2023 年它带着「First AI Software Company」的口号出现,把一家软件公司的岗位和流程——产品经理写 PRD、架构师画设计、工程师写代码、测试出用例——连同它们的协作规矩一起写进了框架代码。今天回头读它的源码,你会发现它既不像 openai-agents 那样「一个 agent 循环 + 工具调用」,也不像 langgraph 那样「把流程画成一张图」,而是第三种组织方式:多个角色在一个环境里,通过消息总线协作,沿着一条固化的 SOP 流水线推进。
这篇文章用 MetaGPT 的真实代码讲清它的三层组织——Role 的 observe/think/act 状态机、Environment 的消息总线路由、Team 的 SOP 编排——并诚实地说说这套设计带来的优势与代价。读完你会带走三样东西:一套「角色 + 总线 + 流程」的组织哲学、它在什么场景该用不该用的判断,以及三个可以直接搬进你自己框架的可迁移设计点。
1. 从「AI 软件公司」到框架:MetaGPT 的定位
1.1 把软件公司固化为代码
MetaGPT 的定位是多智能体(multi-agent)框架,核心理念是「First AI Software Company」:把产品经理、架构师、工程师、QA 等角色及其协作流程(SOP)固化为代码。这在框架设计上是一个明确的取舍——别的框架给你通用能力(工具调用、状态图),MetaGPT 给你一份「软件工程领域的现成组织」。
打开 metagpt/ 目录,包结构本身就是这份理念的展开:
metagpt/
├── roles/          # 角色:ProductManager / Architect / Engineer / QaEngineer ...
├── environment/    # 环境:消息总线与路由
├── actions/        # 动作:WritePRD / WriteDesign / WriteCode / WriteTest ...
├── team.py         # 编排入口:hire / invest / run_project
├── memory/         # 分层记忆:Memory / LongTermMemory / BrainMemory ...
├── schema.py       # Message / MessageQueue / Task 等数据模型
├── context.py      # 全局 Context(成本管理、供应商等)
├── provider/       # 多 LLM 供应商注册表
└── subscription.py # 发布/订阅机制注意这里的分工逻辑:roles/ 与 actions/ 分开——角色是「谁」,动作是「会做什么」;environment/ 管「消息怎么流转」;team.py 管「整条流水线怎么跑」。这四个目录对应了后面四节要讲的内容。
1.2 与 langgraph、openai-agents 的组织哲学差异
一句话预告三种哲学的差异(第 6 节还会补上 llama_index 的事件流,凑成四种):
- openai-agents:一个 agent 循环,靠工具调用和 handoff 显式转移控制权——「我做完,交给你」;
- langgraph:把流程拓扑画成图,节点执行、边路由——「流程长什么样,图就是什么样」;
- MetaGPT:多个角色在环境中通过消息协作——「我不直接叫下一个角色干活,我把消息发到总线上,谁订阅谁响应」。
最后这句是关键。MetaGPT 里控制权不显式转移:角色 A 干完活,把结果包装成 Message 发布到 Environment,接下来谁接手,由消息的 cause_by / send_to 和接收方的订阅集合决定,而不是 A 在代码里直接调用 B。这套「广播 + 订阅」的弱耦合,正是它与 handoff 哲学最根本的分歧点,第 3 节会展开。
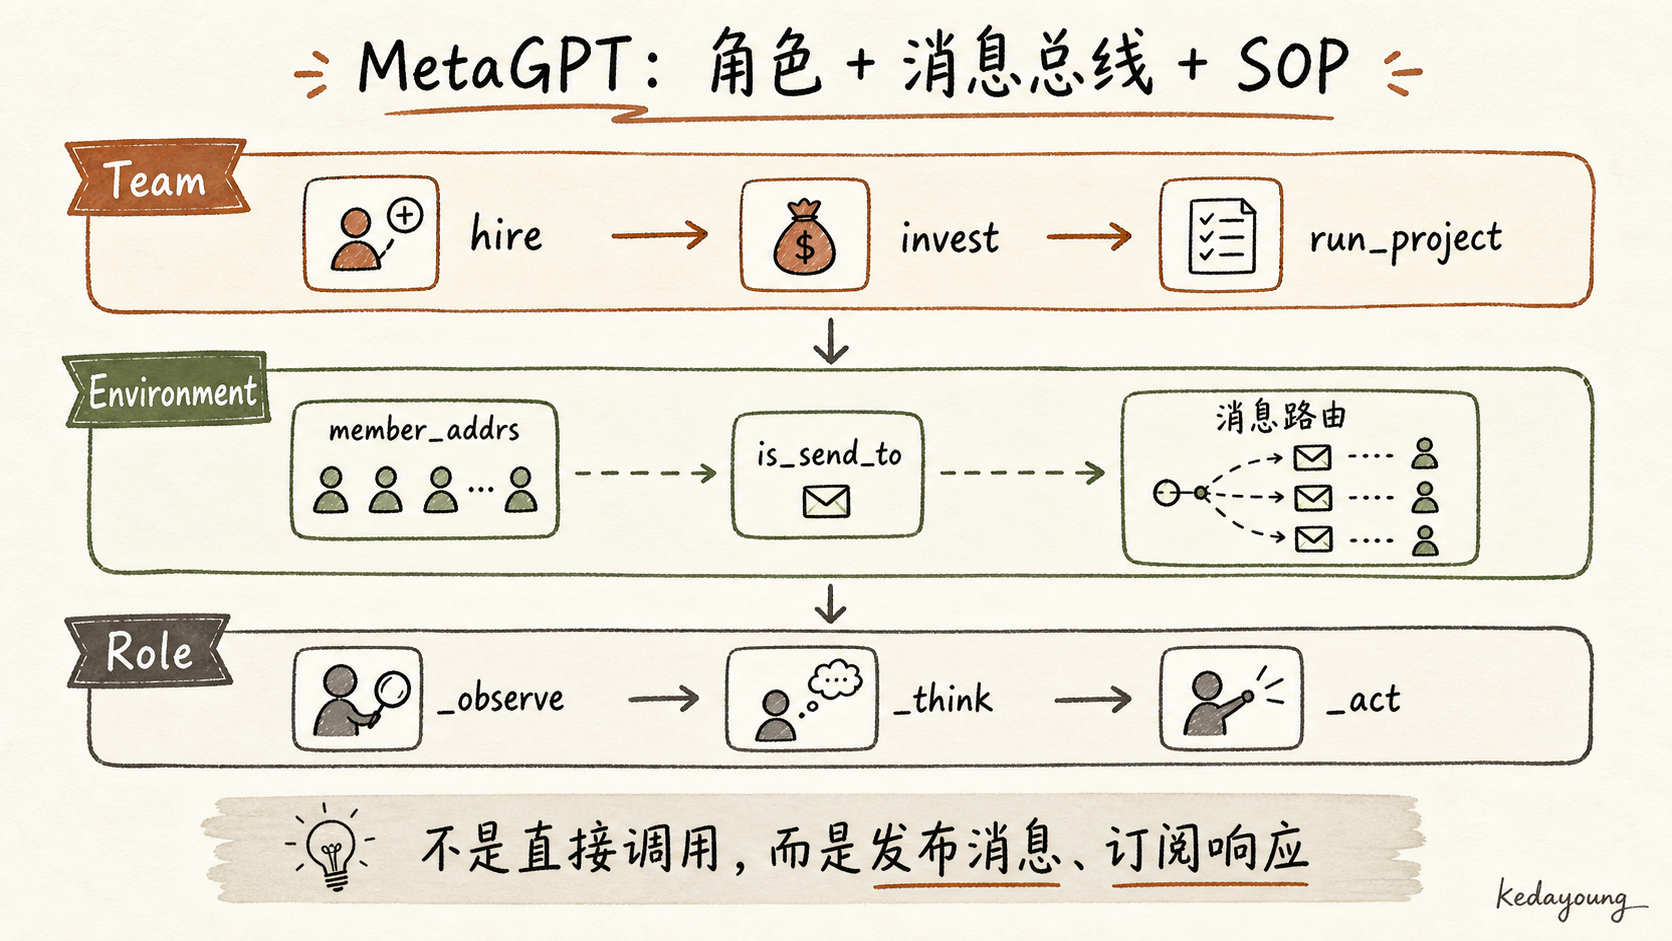
图 1|MetaGPT 组织三层图
Team 管编排,Environment 管路由,Role 跑状态机。
2. Role 循环:observe / think / act
一个角色每一轮「感知—思考—行动」在代码里怎么写?答案是 Role 类的 _observe → _think → _act 三步,外加一个循环驱动。这是整篇文章最重要的一节,值得把代码看仔细。
2.1 RoleContext:角色的一切运行时状态
Role 类定义在 metagpt/roles/role.py:125。它的 docstring(:8-20)记录了两次关键设计决策,值得先读:一是把 recv 功能并入 _observe,未来所有消息读取都收敛到 _observe 函数;二是规范消息传递方式——publish_message 把消息发出去,put_message 把消息放进角色私有的接收缓冲,没有第三条路径;路由功能则整体移交给 Environment。
角色的运行时状态装在 RoleContext(:92):
class RoleContext(BaseModel):
    env: BaseEnvironment          # 所属环境
    msg_buffer: MessageQueue      # 私有消息接收缓冲(异步追加)
    memory: Memory                # 短程记忆
    working_memory: Memory        # 工作记忆
    state: int = -1               # 状态编号:-1 表示初始/终止
    todo: Action = None           # 当前要执行的动作
    watch: set[str]               # 订阅的消息类型集合
    react_mode: RoleReactMode     # 反应模式
    max_react_loop: int = 1       # 单轮最多 act 次数
2.2 观察:_observe
_observe(:399)做三件事:从私有缓冲取消息、按兴趣过滤、写入记忆:
news = self.rc.msg_buffer.pop_all()                    # 取走所有未处理消息
self.rc.news = [
    n for n in news
    if (n.cause_by in self.rc.watch or self.name in n.send_to)  # 过滤
    and n not in old_messages
]
self.rc.memory.add_batch(self.rc.news)                 # 写入记忆
return len(self.rc.news) # 返回新闻条数过滤条件(:411)是订阅机制的核心:一条消息只要「消息的 cause_by(由哪个动作产生)在角色的 watch 集合里」,或者「消息的 send_to 里有这个角色名字」,就会被这个角色看到。前者是按类型订阅,后者是按点名接收——这两条规则共同决定了谁能响应什么消息,第 3 节讲路由时还会用到。
2.3 思考:_think
_think(:340)决定「下一步做什么」,分三种主要情况(另有 recovered 分支在断点恢复时按存档状态重入,:348-351,日常流程不经过):
- 只有一个 Action:不用问 LLM,直接置
state=0(:342-346); - by_order 模式:按顺序递增 state(
:353-357); - REACT 模式(默认)且多个 Action:把记忆历史 + 可选状态列表拼进
STATE_TEMPLATE(:360-365),让 LLM 输出一个数字来选择下一个状态:
Now choose one of the following stages you need to go to in the next step:
{states}
Just answer a number between 0-{n_states}...
If you think you have completed your goal and don't need to go to any of the stages, return -1.
LLM 返回后,代码对输出做校验(:371-378):不是数字、或数字超出 [-1, len(states)) 范围,就记 warning 并降级为 -1。这里需要泼一盆冷水:「-1 终止」只是 prompt 语义(STATE_TEMPLATE 告诉 LLM 任务完成就返回 -1),代码路径上它并不优雅退出——_set_state(-1) 会把 todo 置空(:302-306),而 _react 仍会继续调 _act,_act 访问 self.rc.todo.name 直接抛 AttributeError(:381-383),异常被 role_raise_decorator(utils/common.py:689)捕获后删除该角色最新观察的消息并重新抛出。这是全文第一处「强依赖 LLM 输出格式」的设计,也是运行时最脆弱的点,第 7 节会回到它的代价。
2.4 行动:_act
_act(:381)执行当前动作并把结果包装成消息:
response = await self.rc.todo.run(self.rc.history)     # 执行 Action
msg = AIMessage(
    content=response.content,
    instruct_content=response.instruct_content,        # 结构化内容
    cause_by=self.rc.todo,                             # 由哪个 Action 产生
    sent_from=self,                                    # 谁发的
)
self.rc.memory.add(msg)
注意 cause_by 是动作类型而不是文本,这保证了订阅者能按类型匹配(第 3 节)。instruct_content 是结构化载荷(ActionNode/ActionOutput 的输出),第 4 节详述。
2.5 循环驱动与三种反应模式
_react(:454)是标准 ReAct 循环:while actions_taken < max_react_loop: think → act。react(:512)按 react_mode 分派到 _react 或 _plan_and_act;run(:530)是完整一轮:observe → react → publish_message。
RoleReactMode(:82-85)定义了三种自动化程度:
| 模式 | 行为 | 代码位置 |
|---|---|---|
react(默认) | LLM 每步动态选 Action | :454 |
by_order | 按注册顺序依次执行 | :353-357 |
plan_and_act | 先 Planner 生成计划,再按计划执行 | :472-496 |
一个容易被忽略但极其重要的默认值:max_react_loop: int = 1(:113)——每轮 env.run 里,角色最多只 act 一次。也就是说默认 REACT 模式不是「一个循环内反复思考行动直到完成」,而是「观察一次、行动一次、把消息发出去」。复杂任务必须靠多轮 env.run 推进,由环境里的其他角色接力。(作者判断)这个默认值体现了 MetaGPT 对「协作」的理解:单角色不要贪多,把活干一步,交给下一个角色。
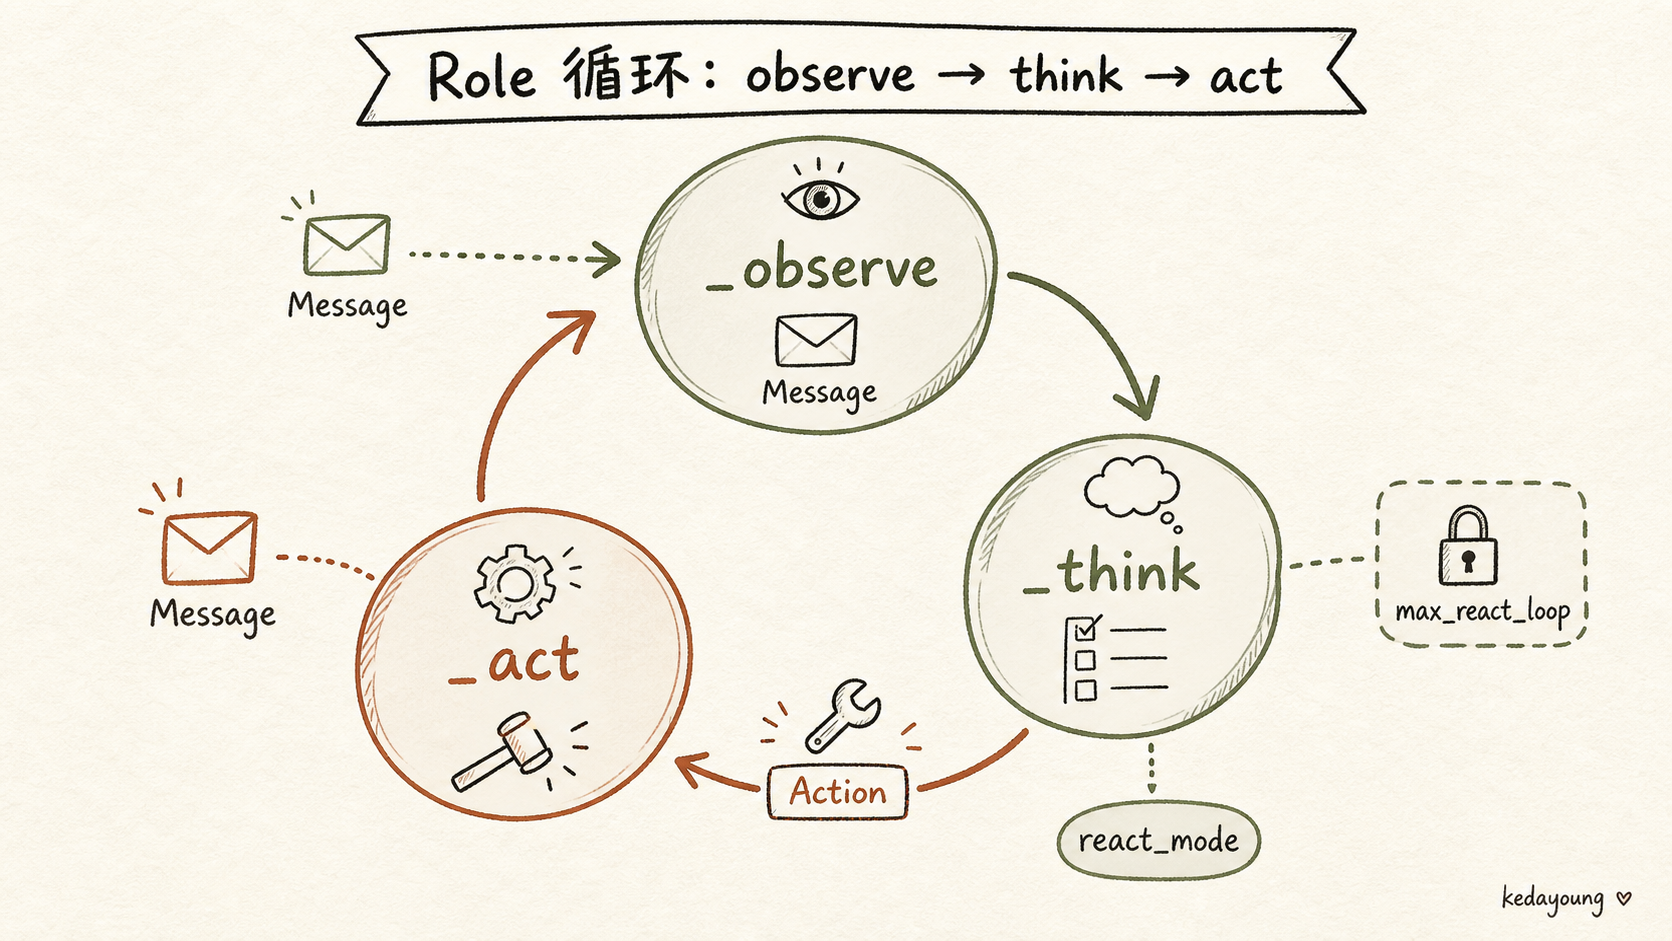
图 2|Role 单轮循环
注意默认 max_react_loop=1,每轮只 act 一次;三种 react_mode 在 _think 处分流。
3. Environment 消息总线与订阅路由
上一节回答了「角色怎么处理一条消息」,这一节回答「角色之间怎么看到彼此的消息」——答案是 Environment 这个消息总线。
3.1 一个 gym 式的环境
Environment(environment/base_env.py:124)继承了 ExtEnv,而 ExtEnv 定义了经典的 gym 式接口 reset / observe / step(:106-121)。这个设计并非偶然:MetaGPT 把多智能体协作建模成强化学习环境——ExtEnv 沿用了 gym 式的 reset / observe / step 接口(:106-121),角色是 agent,环境承载角色并分发消息,一次 step 推进一轮。不过从代码看,实际调用链并不依赖这三个抽象方法——Environment 自身的 reset/observe/step 甚至是空实现(:137-149)——但这个基因解释了为什么会有「地址表」「订阅」这类概念。
3.2 地址表与三维路由
路由的核心是地址表 member_addrs: Dict[BaseRole, Set](:133):每个角色映射到一组「地址」,地址是角色名或动作名的字符串(动作名实际为类的完整路径)。publish_message(:175)遍历地址表,用 is_send_to(utils/common.py:423)判断消息是否命中某个角色的地址:
def is_send_to(message, addresses):
    if MESSAGE_ROUTE_TO_ALL in message.send_to:   # 广播
        return True
    for i in addresses:
        if i in message.send_to:                  # 定向命中
            return True
    return False
而消息本身的「地址」由 schema.py:239-241 的三维字段构成:
cause_by:这条消息是哪个 Action 产生的(类型标签);sent_from:谁发的;send_to:发给谁(默认MESSAGE_ROUTE_TO_ALL,即广播)。
配合第 2 节 _observe 的过滤条件,一条消息可能被零个、一个或多个角色看到——是否响应由「发送方的 send_to」和「接收方的 watch」共同决定,发布方不需要知道接收方是谁。这就是「广播 + 订阅」与 handoff「点对点移交」的本质区别。
这里值得多看一眼:地址表不是手工配置的,而是角色进入环境时自动注册的。Role._watch(role.py:284-288)把关注的 Action 类型转成字符串集合写入 rc.watch;Role.set_addresses(:293-300)把地址同步给环境;set_env(:308-313)在角色加入环境那一刻执行注册(env.set_addresses(self, self.addresses))。所以「订阅」本质上是角色自己的声明——它关注什么动作、自己叫什么名字,决定了它在地址表里挂哪些标签。这也意味着字符串弱匹配的风险在注册侧就已经埋下:_watch 里写的类名与消息实际携带的 cause_by 必须逐字一致,差一个字母订阅就失效,而环境只会报一条「no recipients」的 warning。
3.3 弱匹配的代价:无收件人只告警不报错
publish_message 里有一段容易被忽略的逻辑(:191-192):
if not found:
    logger.warning(f"Message no recipients: {message.dump()}")
消息发出去没人订阅?只打一条 warning,消息被丢弃——对运行逻辑而言它是「静默」的:不报错、不重试、不排队。这是字符串弱匹配的代价:cause_by 与 watch 集合的比对是字符串相等,不是类型检查、更不是语义匹配。角色注册动作时稍有不一致(比如类路径写法不同),消息就会落空,且不会报错。对生产系统这是隐患,对调试这是噩梦——它不会崩,只会「静默不工作」。
3.4 观察点:与 handoff 的对比
与 openai-agents 的「控制权显式转移」相反,MetaGPT 是「广播 + 订阅」。这个差异带来一个有意思的能力:天然支持一个消息被多个角色竞争响应。比如一条评审消息发布到总线上,多个 reviewer 角色都订阅了它,就会同时看到、同时响应——这在「多个专家竞争解决同一问题」的场景里正是想要的。代价则是控制流变得隐式:读代码时你无法从调用链看出「这条消息最后被谁处理了」,只能靠地址表 + watch 集合静态推导(作者判断:这也是 MetaGPT 项目比 langgraph 项目更难读的原因之一)。
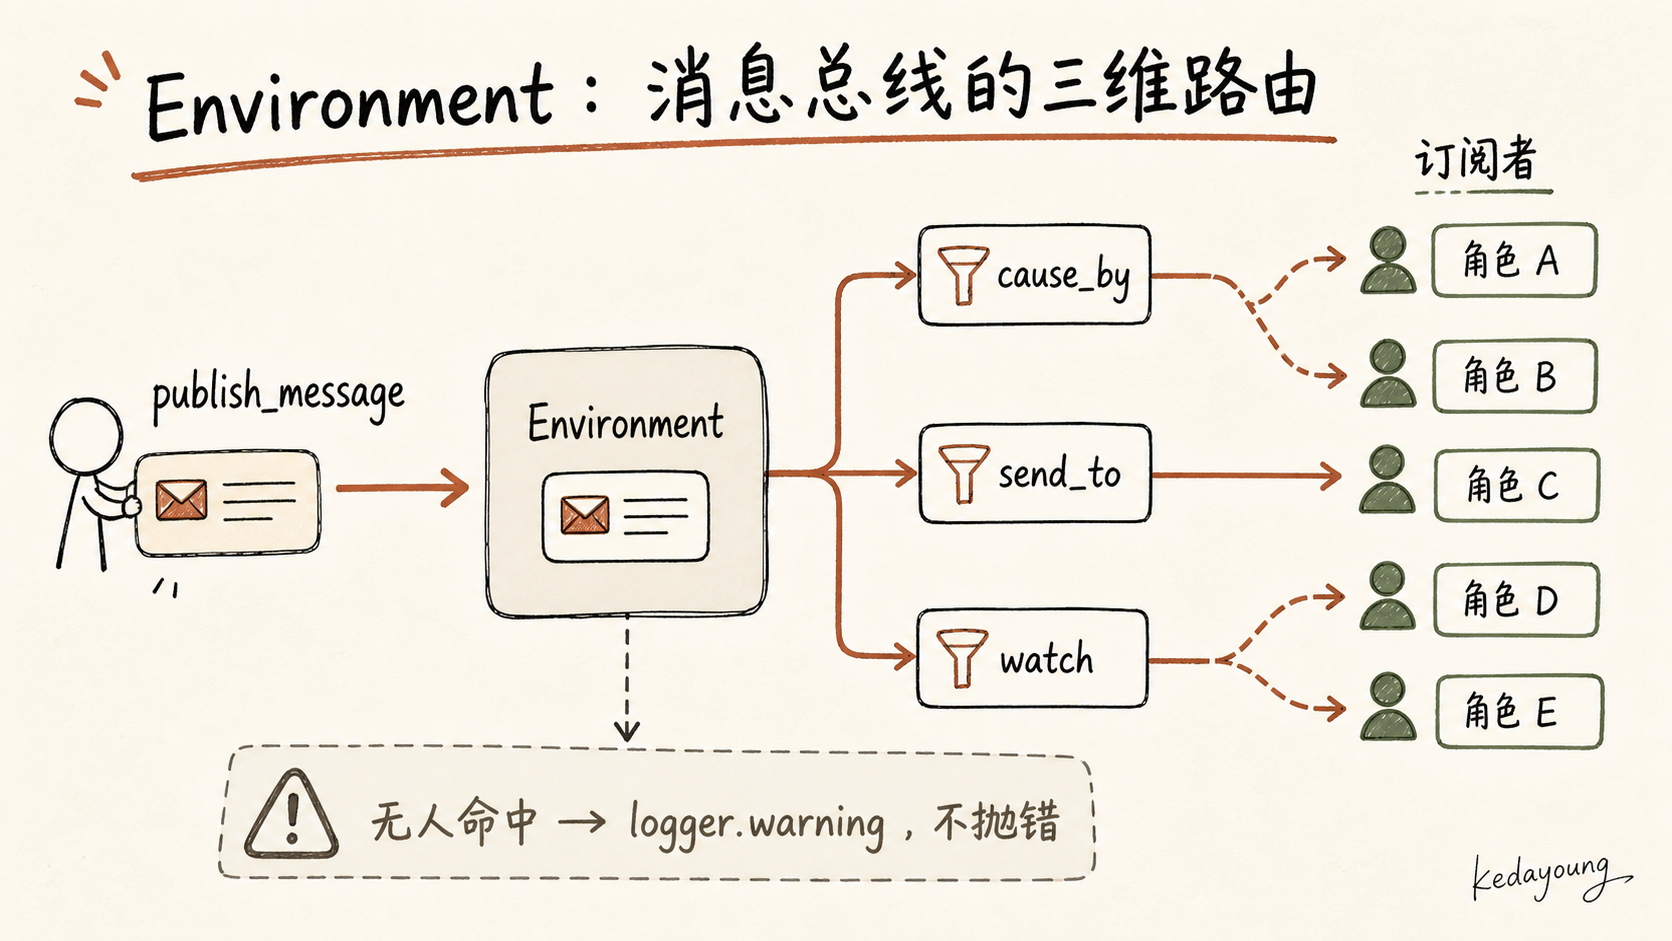
图 3|消息总线路由图
同一消息可命中多个订阅者;无人订阅时只告警不报错。
4. Action 与 SOP:角色-行动分离
第 2 节里 _act 调用的 todo.run() 就是 Action。这一节回答两个问题:Action 是什么、为什么角色与行动要分离,以及内置 SOP 流水线长什么样。
4.1 Action:单步原子能力
Action 基类在 actions/action.py:110,核心就是 run(args, *kwargs) 一个方法(子类实现),并持有自己的 LLM 与可选的 ActionNode。actions/ 目录下有几十个业务 Action:WritePRD、WriteDesign、WriteCode、WriteTest、WriteCodeReview、FixBug……
Action 与 Role 的关系是:Role 只管状态机与记忆,Action 才是能力。Role 的 actions 列表(注册于 set_actions)是它的「技能包」,_think 决定用哪个,_act 调用它。一个 Action 可以被不同角色复用,一个角色也可以组合任意 Action 集合。
顺带一提与「工具」的对照(作者判断,可迁移到你的框架设计里):helloagents 的工具(
hello_agents/tools/base.py,20260810-helloagents-framework克隆,Tool基类在:50)是「对 LLM 暴露的可调用函数」,由模型在上下文中选择调用;MetaGPT 的 Action 是「角色执行的领域步骤」,由角色状态机选择执行。一个是模型驱动,一个是角色驱动——这决定了谁对「下一步做什么」负责。
4.2 结构化信息传递
角色之间传的不只是自然语言,还有结构化文档。_act 里那个 instruct_content(role.py:384-390)就是 ActionNode/ActionOutput 的产物——比如 PRD 的 instruct_content 是一个带字段的 BaseModel 子类,经 Message.instruct_content 在角色间传递。下游角色可以直接 msg.instruct_content.xxx 取字段,不必解析文本。这是「软件公司流程」能跑起来的工程前提:PRD→设计→任务→代码,每一环都产出一份结构化中间产物,而不是一段自由文本。
4.3 SOP 固化:从 PRD 到测试的流水线
内置角色把软件公司的标准流程固化成一条流水线:ProductManager → Architect → Engineer → QaEngineer,对应产出 PRD → 设计文档 → 代码 → 测试用例(主干链路,完整流程还含任务拆分与评审环节,见 7.4)。
以工程师为例(roles/engineer.py):角色注册了 WriteCode 等 Action,并 _watch 了 WriteTasks / WriteCode / WriteCodeReview / FixBug ... 等消息类型(:106)——它只对上游「写任务/写代码/评审/修 bug」类的消息感兴趣,PRD 和设计文档不会直接触发它(由上游角色转成任务后再触发)。角色还固化了领域约束(:88-92):
goal: str = "write elegant, readable, extensible, efficient code"
constraints: str = (
    "the code should conform to standards like google-style and be modular and maintainable. "
    "Use same language as user requirement"
)
注意这段 goal/constraints 是写死在角色类里的——它既是 SOP 的体现(工程师就该按 google-style 写),也是第 7 节要讲的「领域强绑定」的第一现场。
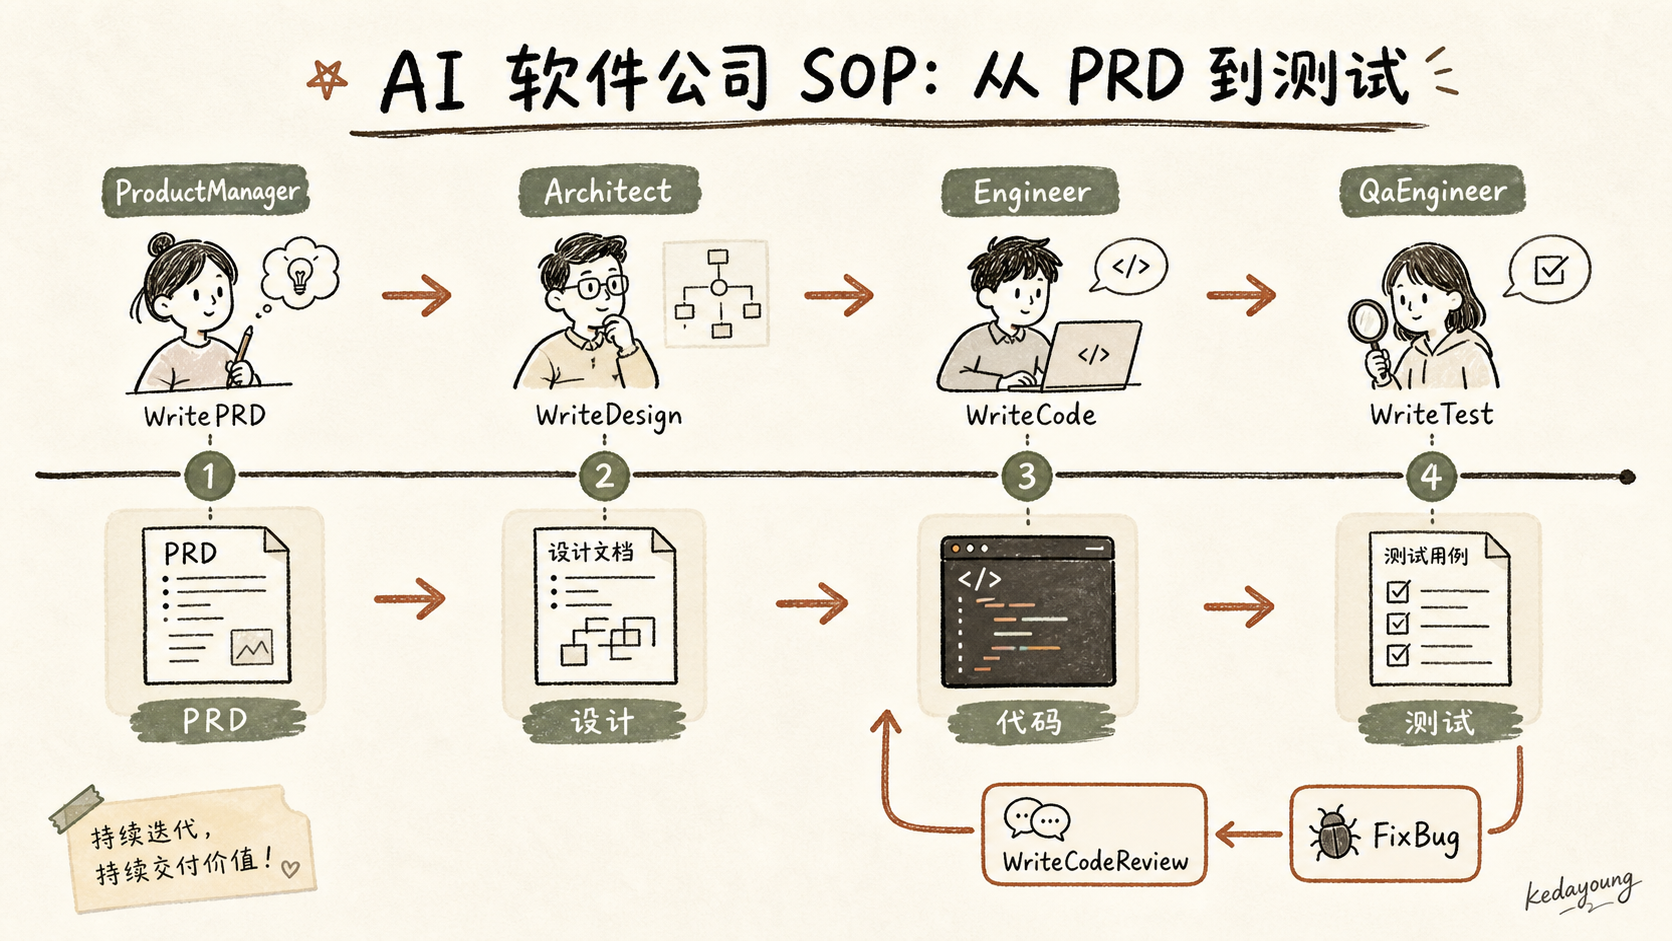
图 4|SOP 流水线图(协作流示意)
每个角色绑定一组 Action,通过 cause_by 匹配消息类型接力。
5. Team 编排与记忆分层
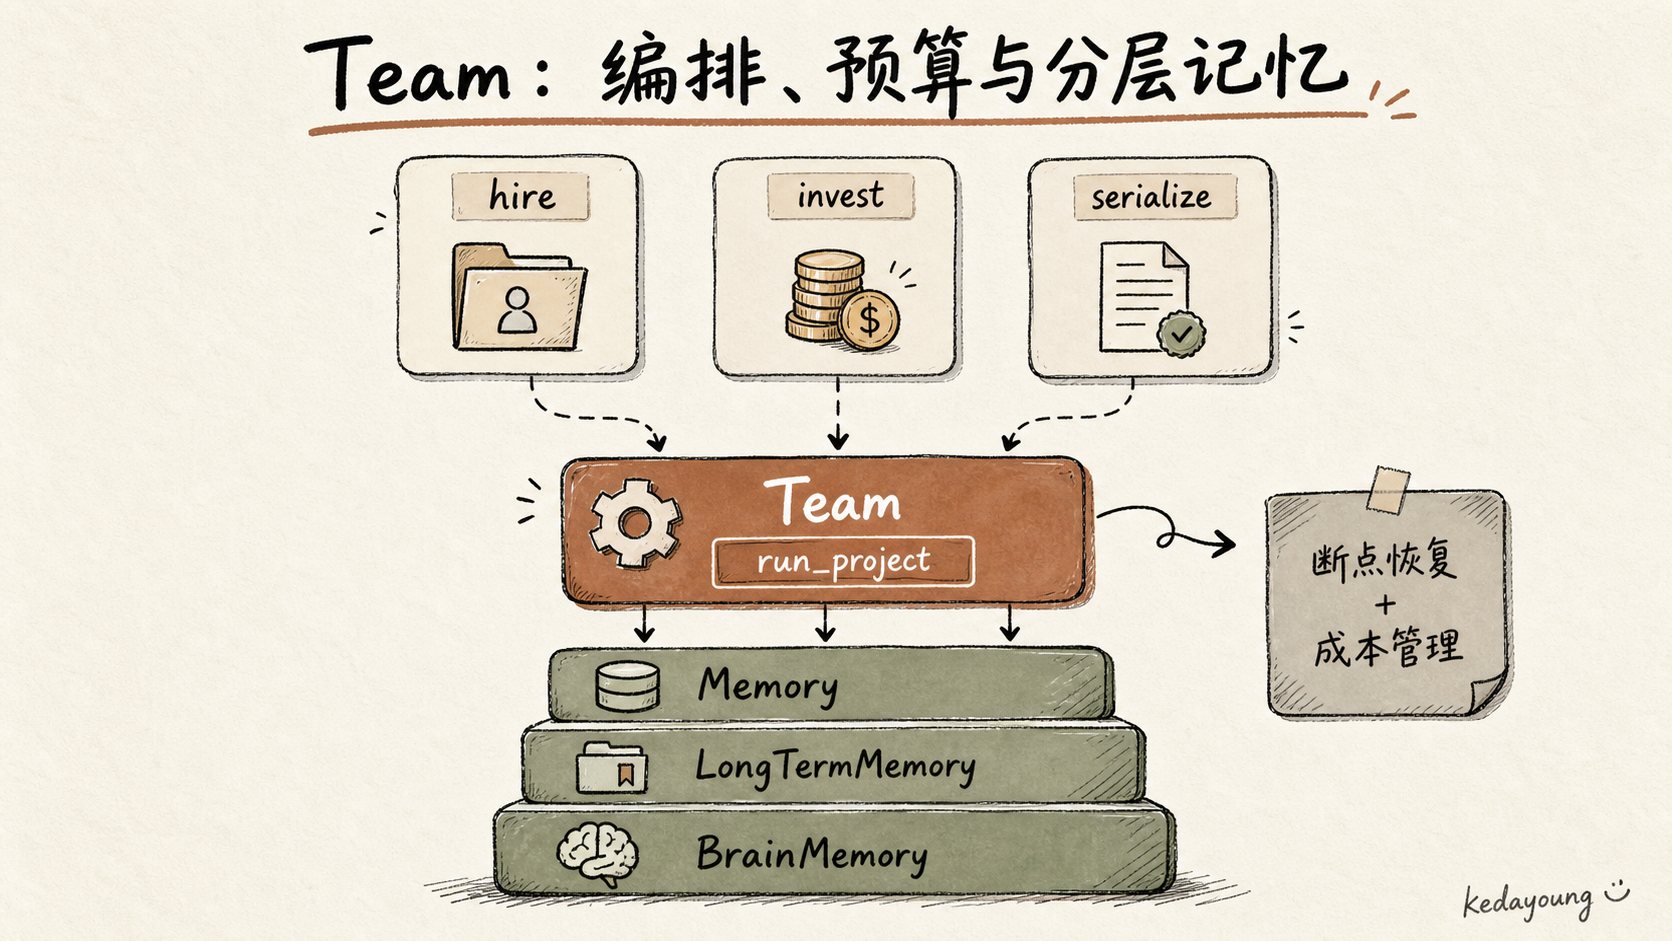
角色和环境都有了,谁把「雇佣、发布需求、控制预算、断点恢复」这些组织级能力串起来?答案是 Team(metagpt/team.py)。
5.1 Team:编排入口
Team 的 API 很直白:hire(roles) 把角色加入环境(:83-85),run_project(idea) 把用户需求包装成 Message 发布到环境(:102-107),之后就是环境里的角色们自己接力。
两个「生产意识」的设计值得单说:
- 断点恢复:
Team.serialize / deserialize(:59-81)把 team 配置、context、环境状态序列化到storage/team/team.json,下次从磁盘恢复继续跑。多智能体长任务动辄几十分钟、上百次 LLM 调用,没有断点恢复,一次网络抖动就前功尽弃。 - 预算上限:
invest(investment)(:92)设置成本上限,Team.run每一轮循环前调用_check_balance(:98-100,调用点:133)检查total_cost >= max_budget,超了抛NoMoneyException。把「公司预算」这个组织概念直接翻译成代码——预算耗尽,项目终止。
另一个必须交代的坑:Team 默认 use_mgx: bool = Field(default=True)(:43)——仓库存在双体系:经典 Role + Environment(本文主线)与新的 RoleZero + MGXEnv(__init__ 里按 use_mgx 分支创建环境,:48-51)。新体系不是旧体系的简单升级,两者在角色基类、环境实现、记忆机制上都有差异;初次读代码的人看到 team.py 里明明 new 的是 MGXEnv,别以为经典体系是摆设(双体系并存本身也是第 7 节要吐槽的维护成本)。
5.2 记忆分层
memory/ 目录实现了多层记忆:Memory(短程对话,每个角色一份)、MemoryStorage(FAISS 向量存储,带 TTL 与相似度阈值,memory_storage.py:19-28)、LongTermMemory(长程记忆)、BrainMemory / RoleZeroMemory(新体系用)。分层的目的和所有记忆系统一样:兼顾上下文窗口长度与跨会话复用——短程记忆装本轮对话,长程记忆沉淀跨任务知识,用检索而不是全量塞进 prompt。
交叉点提示:MetaGPT 的分层记忆是
0-agent-memory主题的天然素材,两篇定纲后划清边界(详见附录 B)。
5.3 多 LLM 供应商
provider/llm_provider_registry.py:48 的 LLM_REGISTRY 是供应商注册表,配合 @register_provider 装饰器,覆盖 OpenAI / Anthropic / Gemini / Ollama / ZhipuAI / DashScope 等十余家官方接口,OpenAI 兼容协议还可扩展到更多服务商(provider/*_api.py)。对多智能体框架这不是锦上添花:不同角色可以用不同模型(比如 Planner 用强模型、执行用便宜模型),成本控制是生产级多智能体的刚需。
5.4 观察点
invest 预算 + 断点恢复体现了多智能体长任务的生产意识——框架不只是「把消息传来传去」,还管「钱」和「续跑」。这是单 agent 框架(如 openai-agents)默认不提供的组织级能力,也正是「把软件公司流程固化成代码」理念的延伸。
6. 与其它框架对照:四种多智能体组织哲学
把视野拉远:MetaGPT 只是「多智能体怎么写」的一种答案。对照另外三个主流框架,可以看清四种组织哲学(下表基于各框架本地克隆的代码,行号核实列为附录 B 待办):
| 维度 | openai-agents | langgraph | MetaGPT | llama_index |
|---|---|---|---|---|
| 组织单元 | Agent(dataclass) | 节点(StateGraph) | Role(状态机) | Workflow Step |
| 信息传递 | 工具调用/handoff | channel 写入/订阅 | 环境消息总线 | 事件流 |
| 控制权 | 显式 handoff / as_tool | 边/条件边路由 | 消息 cause_by/send_to | handoff 工具 |
| 状态 | RunState + 服务端会话 | TypedDict + reducer + checkpoint | RoleContext + memory | Workflow state + store |
四个框架回答了同一个问题——「多智能体之间如何组织协作」——但答案分叉在谁持有控制权:
- openai-agents(handoff):控制权显式转移。「这个任务归你管了」——适合任务按类型清晰转交的场景(客服升级、模块分工);
- langgraph(子图):控制权在图上。流程拓扑就是执行路径,边和条件边决定走向——适合流程复杂、需要精确恢复的场景;
- MetaGPT(消息总线):控制权隐式,靠订阅竞争。「我把结果发出去,谁订阅谁响应」——适合多个专家角色竞争解决同一问题;
- llama_index(Workflow 事件流):节点通过事件流解耦,也有 handoff 工具——介于总线与显式转交之间。
(作者判断)四种哲学没有优劣,取决于你的协作形态:任务按类型转交 → handoff;流程拓扑复杂且需恢复 → 图;多专家竞争解决同一问题 → 消息总线;需要确定性事件流水线 → 事件流。MetaGPT 的价值在于它把「角色 + 订阅」这套组合完整做出来了,而不是只给了个概念。
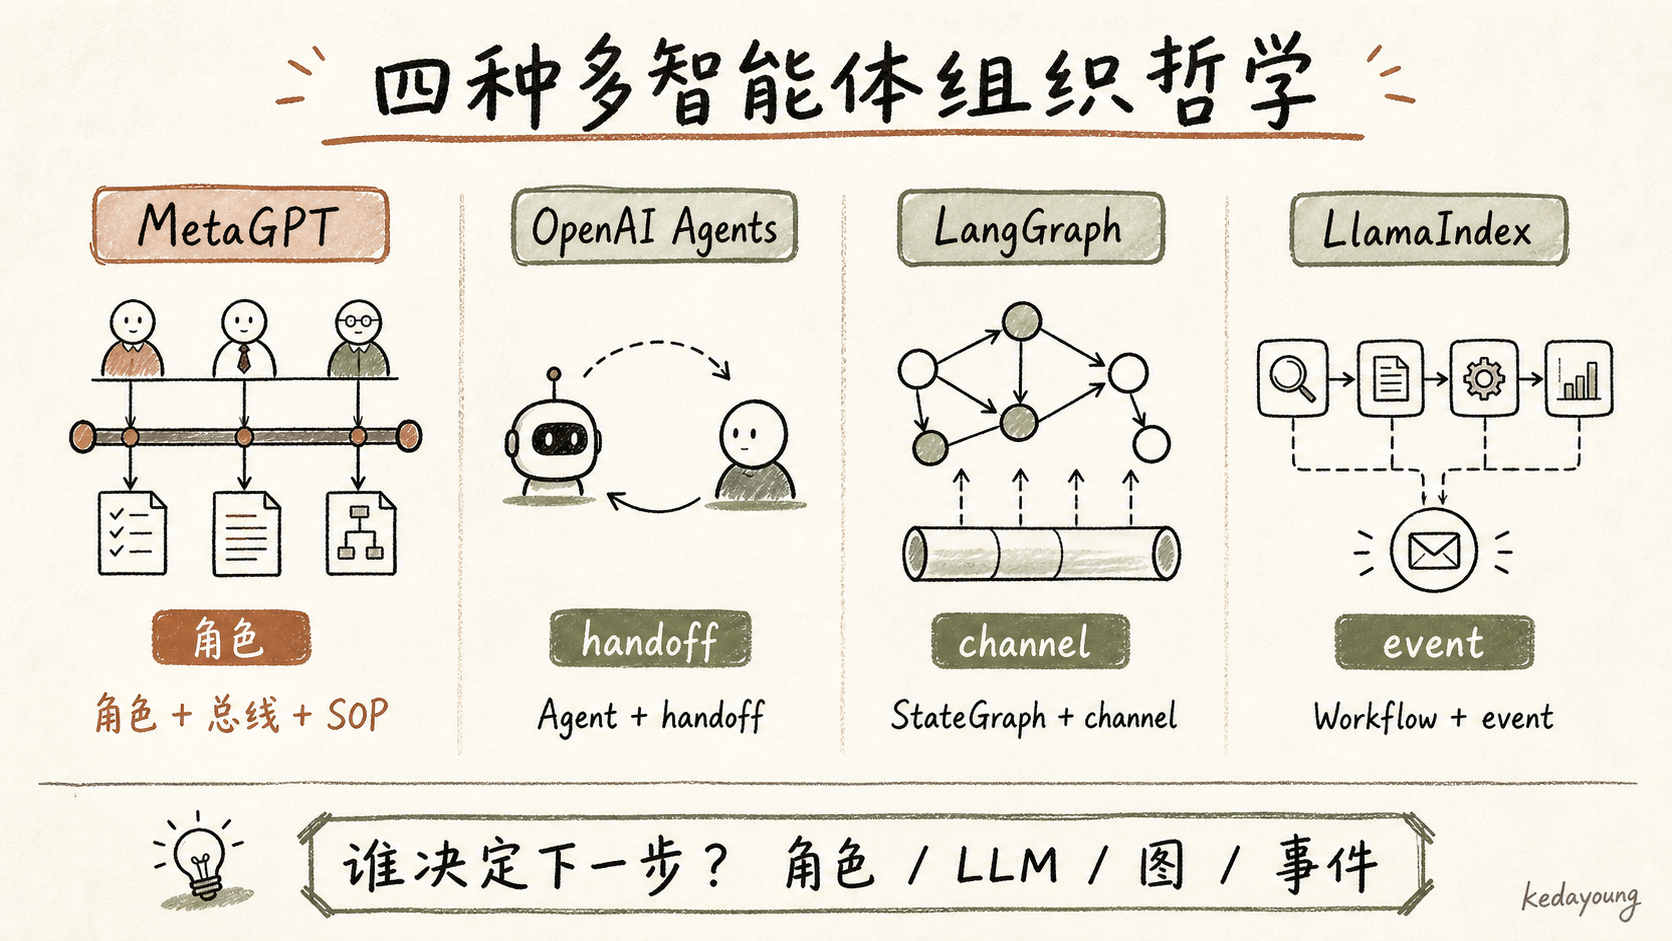
图 5|四种多智能体组织哲学示意图
链、图、总线、事件流。
7. 设计取舍、局限与可迁移经验
7.1 设计亮点(可迁移)
这套「角色 + 总线 + SOP」里,有几样东西值得任何多智能体框架借鉴:
- Role 状态机与 Action 分离(
role.py:340/381/399、action.py:110):角色可组合、动作可复用,「谁做」和「做什么」解耦; - 环境消息总线 + 三维路由(
base_env.py:133、schema.py:239-241):cause_by / sent_from / send_to三维标签 + 订阅集合,发布方与接收方完全解耦; - 三种 react_mode(
role.py:82-85):react(全动态)/by_order(全固定)/plan_and_act(先规划后执行),一套状态机覆盖「完全交给 LLM」到「完全脚本化」的光谱; - SOP 流水线(
engineer.py:106):把组织流程固化为代码,流程成为可复用资产; - 分层记忆与断点恢复(
team.py:59-81、memory/):长任务的生产保障。
7.2 局限(成文需诚实)
代价同样具体:
- 强依赖 LLM 输出「状态编号」(
role.py:367):多 Action 时让 LLM 从可选状态里选一个数字,不合规降级-1(:371-377)——而如第 2.3 节所示,「-1 终止」并未被兑现成优雅退出,而是异常冒泡中断整轮env.run,一次格式漂移消息被删、任务被打断(代码路径推演,未运行验证)——这是运行时最脆弱的一点; - 消息路由是字符串弱匹配(
schema.py:239-241):cause_by与watch的比对靠类名字符串相等,无收件人时消息被丢弃、仅告警不报错(base_env.py:191-192),排查成本高; - 默认单步执行(
role.py:113):max_react_loop=1,复杂单角色推理链要多轮环境推进,吞吐与延迟受限于「一轮一个动作」; - 内置 SOP 与软件工程领域强绑定(
engineer.py:88-92):角色、Action、prompt 全是软件公司语义,复用到其他领域(医疗、金融、客服)得重写整套 role+action+prompt,通用性差; - 角色实现笨重:
engineer.py(24KB)、roles/di/role_zero.py(21KB)、write_prd.py(15KB)——大文件堆业务逻辑,维护成本高; - 双体系并存(
team.py:43):Role+Environment与RoleZero+MGXEnv并行,读代码要先分清主次,新体系也不是旧体系的平滑升级。
7.3 适用边界
(作者判断)回到开头的问题——什么场景该用 MetaGPT 这类「SOP 驱动」框架?
- 很适合:流程固定、角色分工明确的多智能体协作(软件工程、文档生成流水线、审批流)——SOP 就是现成的组织骨架,
by_order甚至不需要 LLM 做路由决策; - 杀鸡用牛刀:单 agent 深度任务(写一篇文章、解一个题)——引入角色、环境、SOP 只是增加延迟和失败面;
- 不如 langgraph:需要精细控制流、复杂分支恢复的任务——消息总线的隐式路由给不了你「精确到边的控制」。
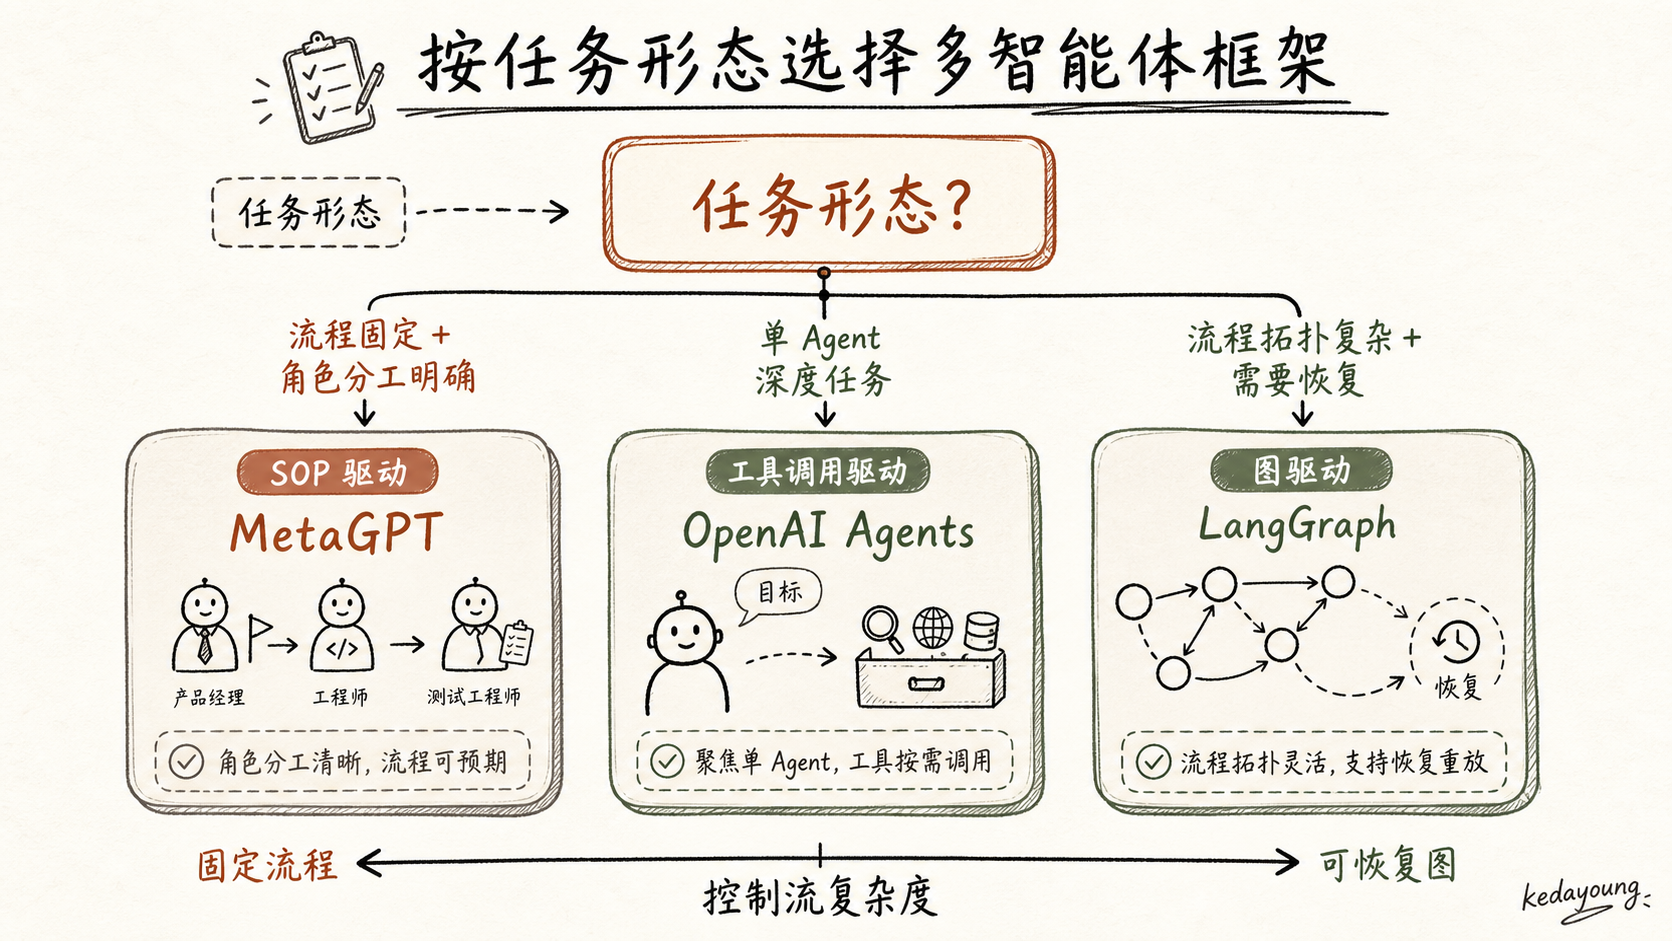
图 6|组织哲学决策表
按流程固定度 / 角色分工度 / 恢复需求选择。
7.4 收束
回到中心论点:MetaGPT 的框架内核是 Role 状态机 + Environment 消息总线 + SOP 流水线 三件套——Role 通过 _observe/_think/_act 循环消费消息、LLM 以「状态编号」选择下一步行动;Environment 用地址表做发布/订阅路由;Team 把「PRD→设计→任务→代码→评审→测试」固化成流水线。这套设计擅长「角色分工明确、流程固定的多智能体协作」,代价是通用性让位于领域绑定。
它真正证明的一件事是:把业务流程 SOP 化 + 角色化,是构建多智能体的一条可行路线——而且不一定要做一家「AI 软件公司」。哪怕你只做一个小型框架,从 7.1 的五个亮点里挑三个最通用的——Role 状态机与 Action 分离、消息三维标签 + 订阅、预算与断点——已经足够让你的多智能体从「demo」走向「系统」。
附录 A:证据清单
| 断言 | 证据位置(相对 0-agent-framework/20260810-metagpt/) |
|---|---|
| Role 类与 docstring(recv 并入 _observe、双路径传消息、路由归 Environment) | metagpt/roles/role.py:8-20、:125 |
| RoleContext 与默认单步 | metagpt/roles/role.py:92、:113 |
| _observe / _think / _act | metagpt/roles/role.py:399、:340、:381 |
| react_mode 三种模式 | metagpt/roles/role.py:82-85 |
| 循环驱动 | metagpt/roles/role.py:454、:512、:530 |
| Environment 地址表、无收件人 warning、gym 式接口 | metagpt/environment/base_env.py:133、:191-192、:106-121 |
| 消息三维路由 | metagpt/schema.py:239-241 |
| is_send_to 路由判定 | metagpt/utils/common.py:423 |
| Action 基类 | metagpt/actions/action.py:110 |
| SOP 固化与领域约束 | metagpt/roles/engineer.py:106、:88-92 |
| 结构化信息传递 | metagpt/roles/role.py:384-390 |
| Team 断点、预算、双体系 | metagpt/team.py:59-81、:92-100、:43 |
| LLM 供应商注册表 | metagpt/provider/llm_provider_registry.py:48 |
| 版本/环境要求(Python 3.9–3.12) | README.md:54 |
附录 B:素材缺口与待办
- [ ] 若要展示一个「软件公司」实例的真实输出,需实际运行 Team 流程(依赖 llama_index / FAISS / LLM key);当前保持代码级分析并在开头标注。
- [ ] 双体系(Role+Environment vs RoleZero+MGXEnv)的具体差异需通读
roles/di/role_zero.py确认,避免把新体系描述成旧体系的简单升级。 - [ ] 第 6 节对照表四行断言的行号需在 openai-agents / langgraph / llama_index / helloagents 四个本地克隆中逐一核实后补入。
- [ ] 与
0-agent-memory主题交叉点:MetaGPT 分层记忆(memory/)可作为记忆主题候选素材,两篇定纲后划清边界。