版本口径:本文基于本地克隆
openai/openai-agents-python(pyproject.toml:3声明版本0.20.0;src/agents/version.py:4通过importlib.metadata读取版本,未安装时回退0.0.0)。文中所有file:line均相对0-agent-framework/20260810-openai-agents/。
我第一次读 openai-agents 的源码时,有一种强烈的错位感。
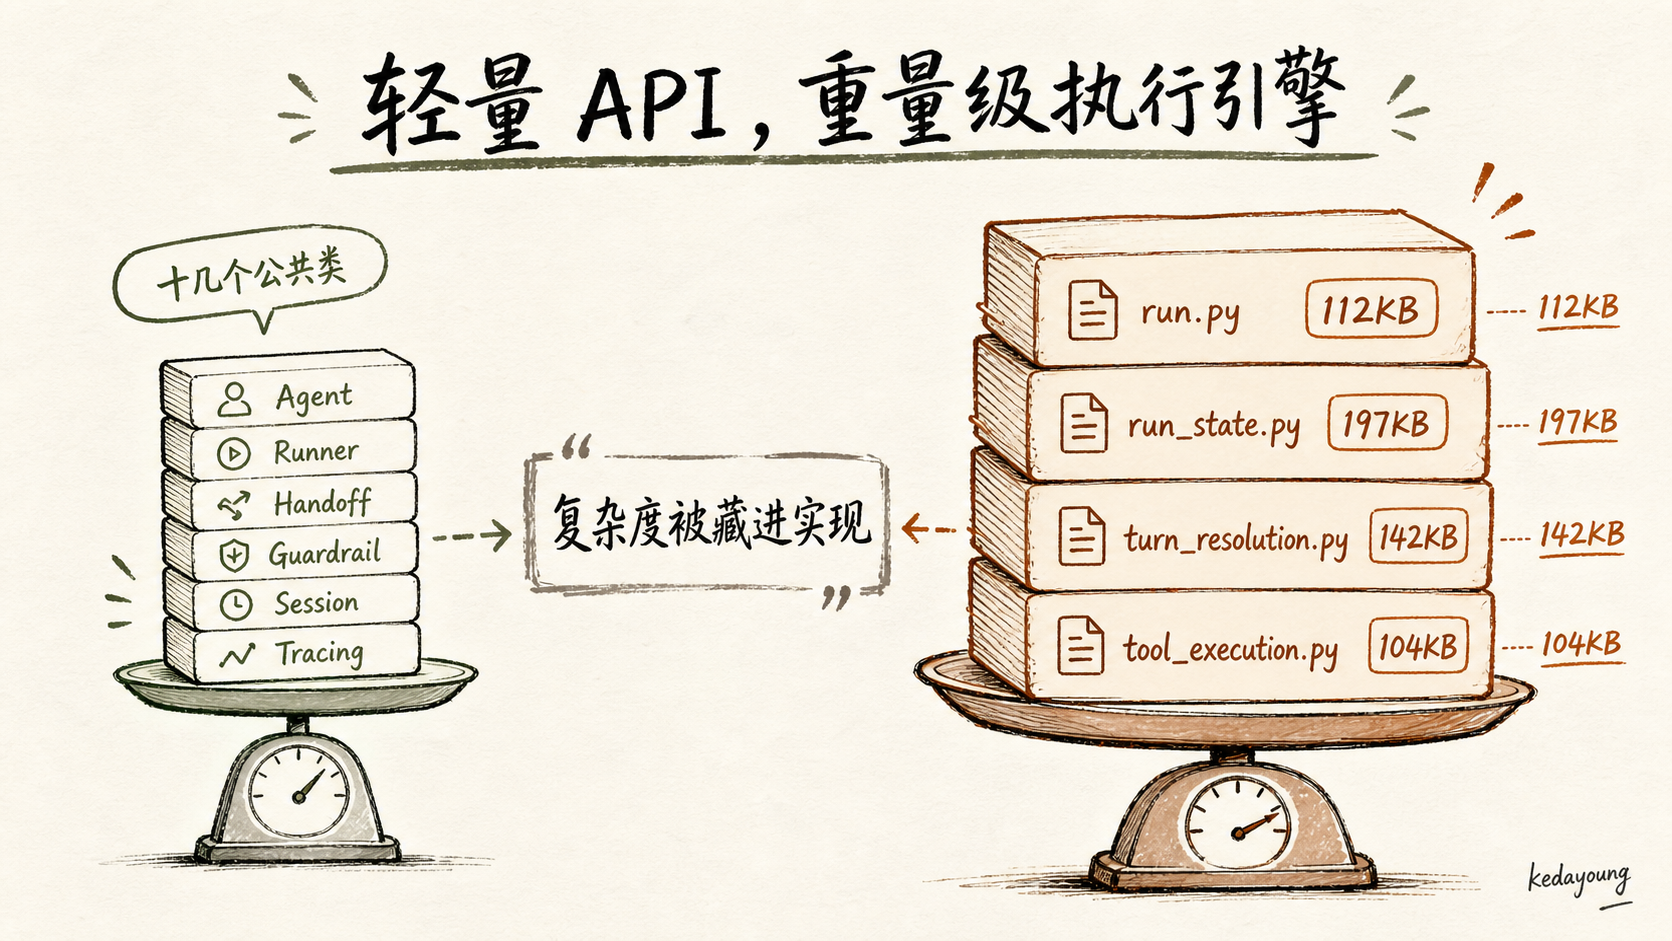
pip install 之后,面向开发者的公共 API 小得可怜:Agent、Runner、Handoff、Guardrail、Session、Tracing——十几个类,一个文件就能数完。写一个多 agent 应用,核心代码通常不超过 30 行:声明几个 Agent,挂上 tools 和 handoffs,调一次 Runner.run。
但当我点开 src/agents/ 目录时,run.py 有 112KB,run_state.py 有 197KB,run_internal/ 下面躺着 turn_resolution.py(142KB)、tool_execution.py(104KB)、run_loop.py(99KB)……这个「轻量」框架的执行引擎,重量级得不像话。
这篇文章想讲清楚这层错位:API 的轻量是刻意设计,执行引擎的庞大是代价。我沿着三层结构读代码——Agent 声明(dataclass)、运行循环(Runner + NextStep 状态机)、多 agent 编排(Handoff + Agent-as-Tool)——最终得出一个中心论点:
openai-agents 把「多 agent 协作」收敛成了「工具调用」一种原语。Agent 是一个 dataclass,
as_tool()与Handoff共享同一工具抽象,LLM 统一通过工具调用做编排决策,循环由NextStep四态状态机驱动。API 层刻意保持轻量,但执行引擎与 OpenAI 协议深度耦合,跨 Provider 能力有限。
如果你正在用 LangGraph(图)、MetaGPT(角色)或自研框架做多 agent 编排,这篇文章也会给你一个对照坐标系:多个 agent 之间如何传递控制权与数据,是每个框架都要回答的同一个问题。
先看它长什么样
空谈无益,先放一个能跑通的多 agent 客服示例——全文后面所有的机制分析,都回到这段代码:
from dataclasses import dataclass
from agents import Agent, Runner, function_tool, handoff

@dataclass
class Ticket:
    """结构化输出:客服结论"""
    category: str
    resolution: str

@function_tool
def check_refund_eligibility(order_id: str) -> str:
    """查询订单是否可退款"""
    return f"order {order_id}: 已发货 3 天,符合 7 天无理由退款。"

billing_agent = Agent(name="billing", instructions="处理账单与支付问题。")
refund_agent = Agent(
    name="refund",
    instructions="处理退款问题,用 check_refund_eligibility 核实资格。",
    tools=[check_refund_eligibility],
    output_type=Ticket,
)

triage = Agent(
    name="triage",
    instructions="判断用户诉求,交接给 billing 或 refund;无法判断就自己回答。",
    handoffs=[handoff(billing_agent), handoff(refund_agent)],
)

result = await Runner.run(triage, "我买的东西要退款,订单号 abc123。")
print(result.final_output) # Ticket(category='refund', resolution=...)这段代码里已经出现了本文要讲的全部机制:Agent 是 dataclass(第 2 节)、Runner.run 启动状态机循环(第 3 节)、@function_tool 定义工具(第 4 节)、handoff 与 output_type(第 5 节)。你只写了 30 行,框架替你跑了一个「triage → refund → 工具核实 → 结构化输出」的完整工作流。轻量 API 背后是庞大的执行引擎,这句话从现在开始有了具体所指。
1. 定位与包结构:轻量 API 背后是什么
1.1 「lightweight yet powerful」在代码层面如何体现
README 用 lightweight yet powerful 自述定位,这个表述在代码里的落点是 src/agents/__init__.py:全部公共 API 从一个入口集中导出——Agent、Runner、Handoff、Guardrail、Session、Tracing,以及各类 Tool。面向使用者,你不需要知道 run_internal/ 里任何一个模块的名字。
这份导出清单本身是一份「能力宣言」:单 agent 执行(Runner)、多 agent 协作(Handoff、as_tool)、护栏(Guardrail)、会话(Session)、可观测(Tracing)、工具协议(FunctionTool、WebSearchTool 等)——所有你期望一个生产级 agent 框架拥有的东西,都收在同一个命名空间里。对比 LangGraph 需要从多个子包(langgraph.graph、langgraph.prebuilt、langgraph.checkpoint……)拼装,MetaGPT 需要理解 Role/Environment/Message 的框架内术语,openai-agents 的导入面是刻意压平的:竞品把编排语义暴露成显式概念——图、边、子图、环境、角色;它则把复杂性藏进实现,只给开发者留一个「声明 agent → 跑起来」的平面模型,*一行 from agents import 之外,你几乎不需要再学新名词**。
1.2 包结构:一张图看懂大小分布
打开 src/agents/,模块按职责分成几个梯队:
src/agents/
├── agent.py                 # 47KB —— Agent 声明(dataclass)
├── run.py                   # 112KB —— Runner / AgentRunner 入口
├── run_state.py             # 197KB —— RunState:整个 run 的状态载体
├── run_internal/            # 真正的执行引擎
│   ├── run_loop.py          # 99KB
│   ├── turn_resolution.py   # 142KB —— 把上一轮输出解析为下一步动作
│   ├── tool_execution.py    # 104KB —— 工具执行
│   ├── run_steps.py         # NextStep 状态机定义
│   ├── turn_preparation.py
│   └── session_persistence.py # 43KB
├── handoffs/                # Handoff 与历史映射
├── guardrail.py             # 护栏
├── items.py                 # 41KB —— RunItem 类型体系
├── models/                  # 模型适配(OpenAI Responses / ChatCompletions)
├── memory/                  # Session 协议与实现
├── tracing/                 # 遥测
├── mcp/  sandbox/  realtime/  voice/   # 扩展面
图 1|API 面(小)vs 执行引擎(大)
上层是 __init__.py 导出的十几个公共类;下层是 run_internal/ 里动辄 100KB+ 的执行模块,各自标注行数。
1.3 观察:轻量是 API 层的,重量级是执行引擎的
这个结构本身就是设计取舍的注脚。面向开发者的心智负担小,意味着框架内部必须替你做更多事:turn 解析、工具执行、护栏触发、会话持久化、遥测埋点——每一条链路都是一个 100KB 级模块的复杂度来源。
记住这张图,后面每一节都会往里填细节:第 2 节讲 API 层的 Agent 声明,第 3、4 节讲执行引擎的循环与工具,第 5 节讲编排,第 6 节讲扩展面。
2. Agent 声明:一切能力都是 dataclass 字段
2.1 声明即配置
Agent 的定义朴素得惊人(src/agents/agent.py:295-296):
@dataclass
class Agent(AgentBase, Generic[TContext]):
一个 dataclass。没有 Builder,没有 Config 类,没有 YAML DSL。你声明一个 agent 的方式,就是构造一个 dataclass 实例:
from agents import Agent

triage_agent = Agent(
    name="triage",
    instructions="你是前台。判断请求归属,交给 billing 或 refund。",
    handoffs=[billing_agent, refund_agent],
)
2.2 核心字段全景
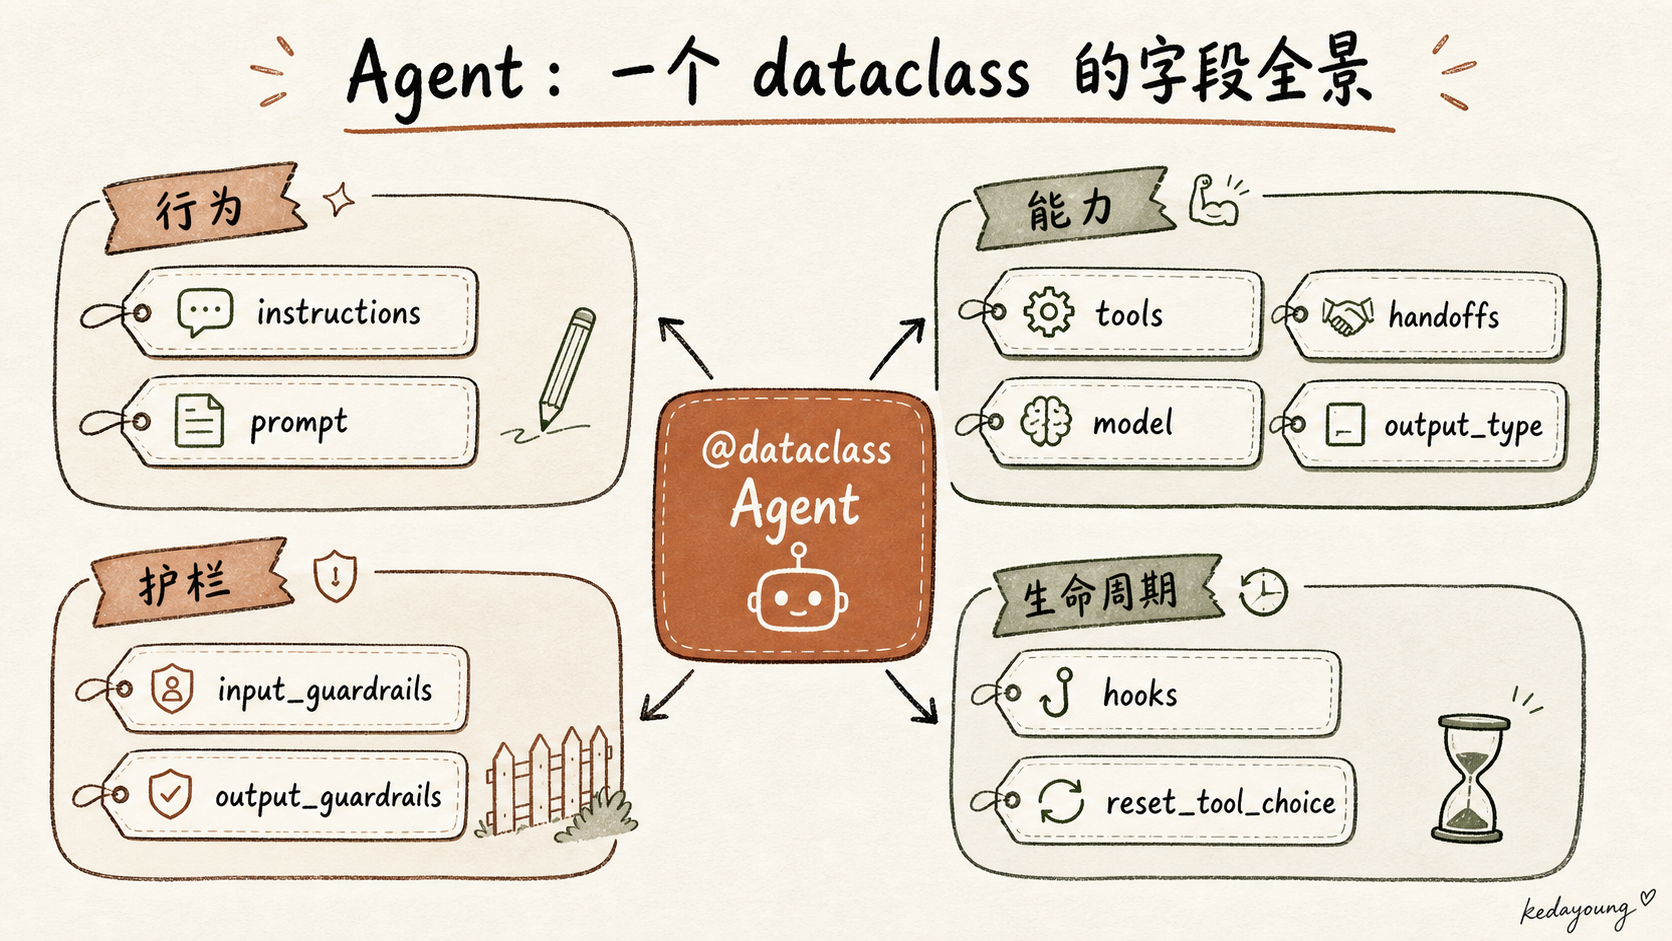
从 agent.py:309 到 :397,Agent 的全部能力以字段形式配置化,可以分成四组:
行为(agent 怎么想)
instructions(:309):字符串或Callable——动态函数可以在每次调用时根据 context 生成 system prompt。prompt(:325):Prompt 对象,把 instructions/tools 的配置挪到代码之外动态下发,仅 OpenAI Responses API 可用。
能力(agent 能做什么)
tools(AgentBase字段,本节未展开):可调用的工具列表——注意tools定义在基类AgentBase上,不在本段agent.py:309-397的范围内,但它是能力的核心。handoffs(:331):可委托的子 agent 列表。model(:337):字符串 /Model对象 /None。None时走默认模型——源码中写死为gpt-5.6-luna(agent.py:341注释明确写着currently "gpt-5.6-luna")。注意这是代码现状,不代表任何模型路线判断。model_settings(:344):temperature 等模型级调参。output_type(:360):结构化输出 schema——传一个 dataclass / Pydantic / TypedDict,output_type=None时输出就是str。tool_use_behavior(:373):默认"run_llm_again"(工具跑完把结果送回 LLM),也可"stop_on_first_tool"(第一次工具输出直接当最终结果,不再回送 LLM)。
护栏(agent 的边界)
input_guardrails(:350):首个 agent 生成响应前的并行检查。output_guardrails(:355):最终输出产生后的检查。
生命周期
hooks(:369):各类生命周期回调。reset_tool_choice(:395):工具调用后是否重置 tool choice 防死循环,默认True。
图 2|一个 Agent 的字段全景图
按「行为 / 能力 / 护栏 / 输出」分组展示上述字段。
2.3 校验与复用:__post_init__ 和 clone
dataclass 字段只是声明,框架在 __post_init__(agent.py:432-546)里做类型校验与归一化——比如把工具、handoffs 整理成内部结构。这对使用者透明,但保证了「声明式」之外的防御性。
复用走 clone(**kwargs)(agent.py:548):浅拷贝出一个新 agent 再覆盖指定字段。想派生一个「同样工具、不同 instructions」的变体,一行搞定,不用重新组装。
2.4 把这些字段组合起来
上面每个字段单独看都平淡无奇,组合起来才是 Agent 的完整表达力。一个「动态指令 + 结构化输出 + 双护栏」的 agent:
from agents import Agent, InputGuardrail, output_guardrail

def dynamic_instructions(ctx, agent):
    """动态 instructions:按用户身份生成 system prompt"""
    return f"你是 {ctx.context['tier']} 用户的专属客服,语气必须专业克制。"

@output_guardrail
async def no_jargon(ctx, agent, output):
    """输出护栏:检测黑话,命中则抛 tripwire 中断"""
    ...

agent = Agent(
    name="support",
    instructions=dynamic_instructions,       # 行为:动态生成
    tools=[check_refund_eligibility],         # 能力
    output_type=Ticket,                       # 能力:结构化输出
    input_guardrails=[InputGuardrail(...)],   # 护栏:响应前检查
    output_guardrails=[no_jargon],            # 护栏:输出后检查
    model="gpt-5.6-luna",                     # 显式指定模型
)
注意 instructions 的动态函数签名(agent.py:311-314):它接收 RunContextWrapper 和 agent 自己,返回字符串。这意味着 system prompt 可以按运行时 context 定制——同一个 Agent 在不同会话里看到不同指令,声明一次、处处复用。这是 dataclass 字段 + 回调的组合拳:配置是声明式的,但关键行为点是可编程的。
2.5 预告:as_tool()
Agent.as_tool()(agent.py:576-598)把整个 agent 变成一个 FunctionTool,供其他 agent 当工具调用。这是全文的关键机制之一,第 5 节展开。这里先记住它的本质区别(agent.py:601-605 注释):
- handoff 时新 agent 接管对话历史;as_tool 时子 agent 收到的是生成的输入。
- handoff 时新 agent 接管对话;as_tool 时子 agent 只是被调用的工具,原 agent 继续对话。
3. 运行循环:Runner 与 NextStep 状态机
3.1 入口
一次 run 从 Runner.run(run.py:219)开始。它的 docstring 用四句话描述了循环语义(run.py:237-244):
- agent 接收输入被调用;
- 产生最终输出(符合
output_type)→ 循环终止; - 产生 handoff → 换新 agent 再跑一轮;
- 否则执行工具调用,再跑一轮。
Runner.run 本身是薄壳,实际执行委托给模块级单例 DEFAULT_AGENT_RUNNER(run.py:287)。
3.2 NextStep 四态状态机
循环的语义被显式建模成四个 dataclass(run_internal/run_steps.py:155-181):
| 状态 | dataclass | 含义 |
|---|---|---|
| 终止 | NextStepFinalOutput | 产生最终输出,循环结束 |
| 再跑 | NextStepRunAgain | 工具执行完毕,把结果送回 LLM 继续 |
| 交接 | NextStepHandoff | 切换到新 agent 继续 |
| 中断 | NextStepInterruption | 工具需要审批,等待 approve/reject |
每一步执行后,SingleStepResult.next_step(run_steps.py:199)携带这四态之一,驱动下一轮。
图 3|NextStep 状态机:
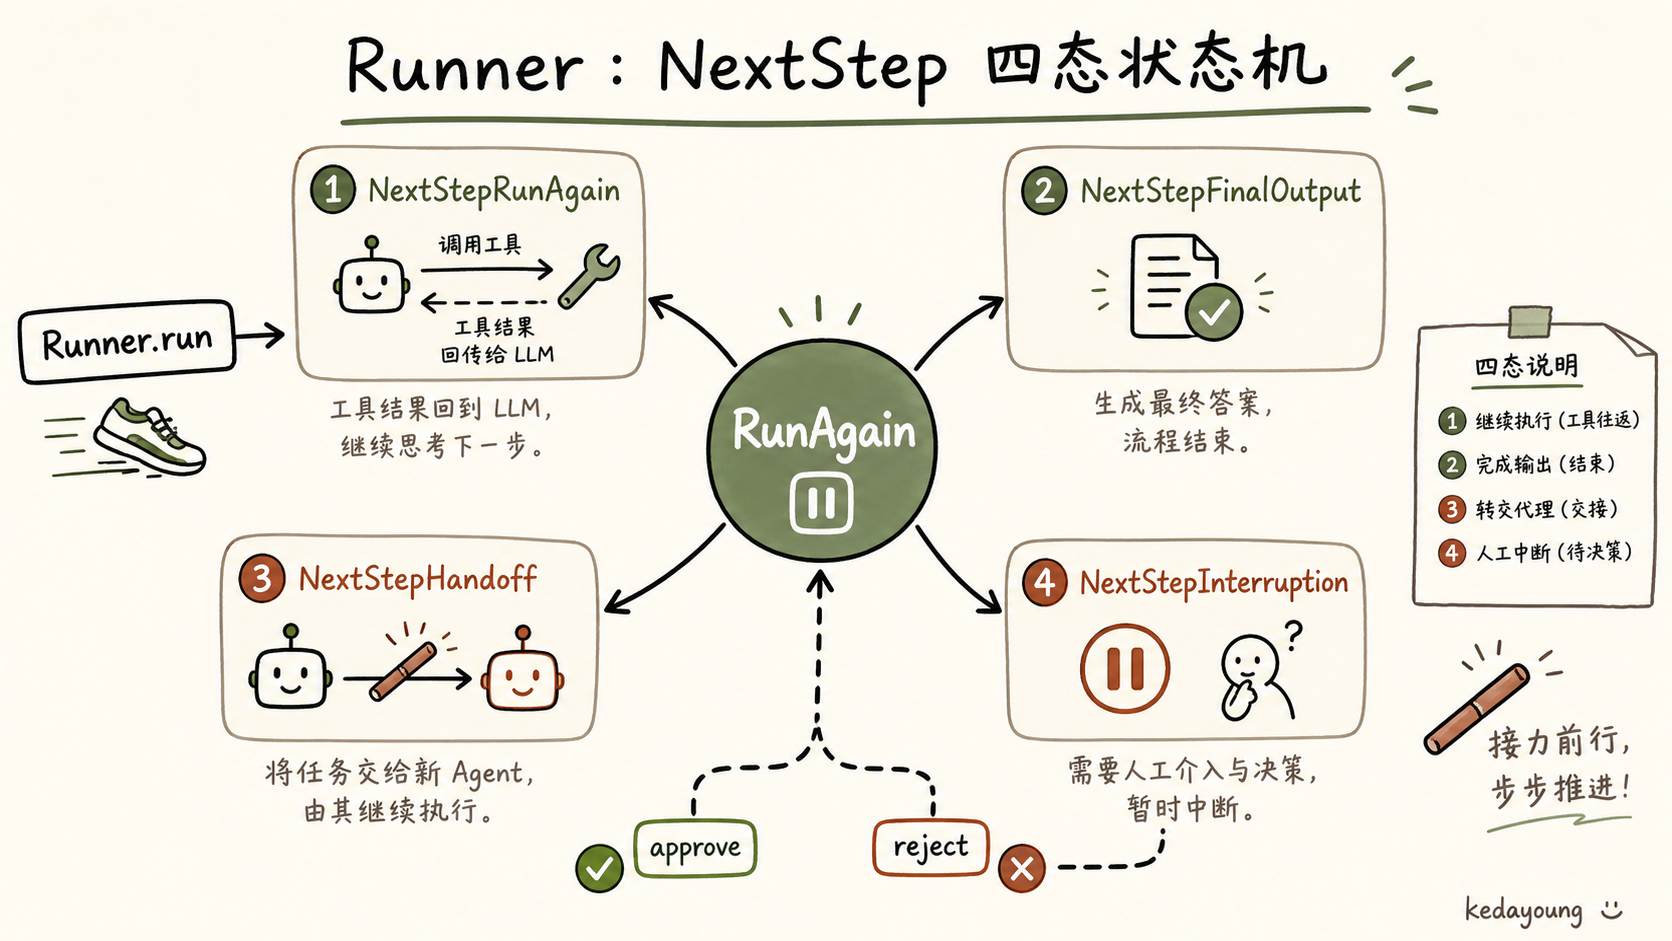
四个状态的归属模块:RunAgain 对应 turn_resolution.py(解析下一动作)+ tool_execution.py(执行工具);Handoff 由 handoff 工具触发(第 5 节);Interruption 由审批机制触发(第 4 节)。
3.3 一次 run 的完整时间线
把状态机和模块对上,一次 Runner.run(triage, "我要退款") 内部大致是这样推进的:
第 1 轮
  triage 被调用(turn_preparation 组装 system prompt + 历史)
  → LLM 调用 refund 交接工具(handoff 也是工具调用)
  → turn_resolution 识别为 handoff 工具调用
  → NextStep = Handoff(new_agent=refund_agent)
第 2 轮
  refund_agent 接管(带上经过 history mapper 处理的对话)
  → LLM 返回 tool_calls: check_refund_eligibility
  → tool_execution 执行工具,结果回填 RunItem
  → NextStep = RunAgain
第 3 轮
  refund_agent 再次被调用(工具结果已在历史里)
  → LLM 返回结构化输出(匹配 output_type=Ticket)
  → NextStep = FinalOutput → 循环终止
三条值得注意的语义:
- 一轮 = 一次 LLM 调用。
max_turns(run.py:259-261)计的是 AI 调用次数(含伴随的工具调用),默认DEFAULT_MAX_TURNS = 10(run_config.py:43),超出抛MaxTurnsExceeded(run.py:247)。多 agent + 多工具的链式任务,turn 数涨得很快——设计 loop 时心里要有这个预算。 - 切换 agent 不是重开对话。handoff 后新 agent 看到的是处理过的历史(第 5 节),上下文是连续的。
- 工具结果是「历史的一部分」。
RunAgain之所以能继续,是因为工具输出项已被写回对话历史,下一轮 LLM 自然能看到——这也是为什么「工具 → 回填 → 再调 LLM」是循环的主干。
3.4 与 helloagents 的对照:循环语义的显式化
helloagents(教学框架)的循环是朴素的 while + max_tool_iterations:一个循环里「调用 LLM → 执行工具 → 再调用」,直到无工具调用为止。
openai-agents 把同样的语义显式建模为四态状态机。区别不在能力,而在词汇:「终止 / 再跑 / 交接 / 中断」是 agent loop 的通用词汇,一旦显式化,就能被复用、被扩展(比如 interruption 态天然支撑 HITL)、被测试。这是这篇文章里最值得迁移的抽象之一——写你自己的 agent loop 时,先定义你的「步态」。
4. 工具机制:@function_tool 与工具调用回填
4.1 定义一个工具
@function_tool 装饰器把任意普通函数变成工具(src/agents/tool.py):
from agents import function_tool

@function_tool
def get_weather(city: str) -> str:
    """查询城市天气"""
return f"{city}: 晴, 24°C"值得注意的默认值:FunctionTool.strict_json_schema: bool = True(tool.py:468-470)——工具参数 schema 默认开 strict mode,官方注释的理由是「能显著提高正确 JSON 输入的概率」。这个默认值的取向很 OpenAI:与其靠 prompt 碰运气,不如从 schema 层面提高工具调用的结构化成功率。
4.2 RunItem:工具调用如何回到循环
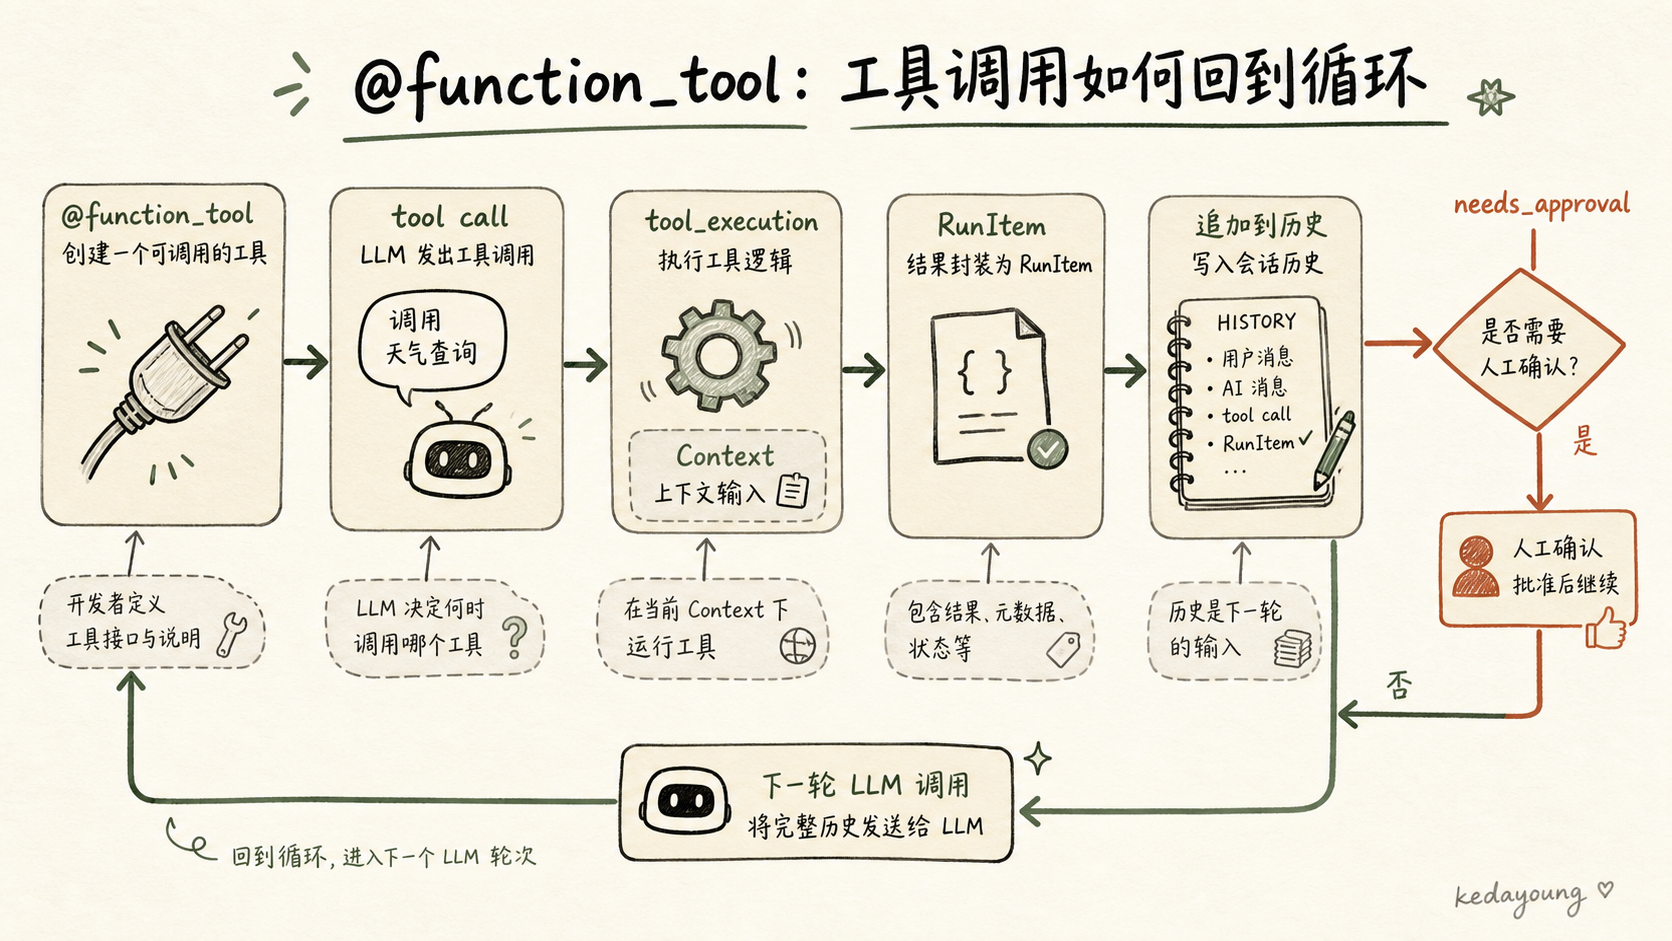
工具调用不是「裸消息」,而是被建模为 RunItem 类型体系(items.py,41KB):消息项、工具调用项、工具输出项、handoff 项……整个循环里流动的都是 RunItem,SingleStepResult 的 new_step_items(run_steps.py:196)就是本轮新增的 items。
全链路是(见第 3 节的状态机):
LLM 输出 tool_calls
  → turn_resolution.py 解析(把 tool_calls 变成工具执行计划)
  → tool_execution.py 执行(真正调你的函数)
  → 结果回填为 ToolOutputItem 进 RunItem 流
  → NextStep 判定:RunAgain(默认)→ 结果送回 LLM
图 4|一次工具调用的全链路
模型输出 tool_calls → turn_resolution 解析 → tool_execution 执行 → RunItem 回填 → NextStep 判定。
4.3 Context:工具不是孤立函数
Runner.run 的 context 参数(run.py:224)贯穿整个循环:工具、handoffs、guardrails、hooks 都能通过 RunContextWrapper[TContext] 访问它。一个常用模式是把用户/会话数据塞进 context,工具从中取,而不是靠参数传递:
def get_tier(ctx: RunContextWrapper[dict]) -> str:
    """工具签名里带 ctx,就能读到 context"""
    return ctx.context["tier"]

@function_tool
def suggest_tier_upgrade(ctx: RunContextWrapper[dict]) -> str:
    tier = ctx.context["tier"]
    return f"建议升级到 {'pro' if tier == 'free' else 'enterprise'}"
这是 dataclass 声明之外的另一个关键设计:工具是有状态的,状态由 context 注入。这也解释了为什么 Agent 是 Generic[TContext](agent.py:296)——agent、工具、护栏共享同一份运行时上下文,类型安全地。
4.4 HITL:needs_approval 与 RunState
工具字段 needs_approval(tool.py:486-493)为 True 时,本轮不执行工具,而是产生 NextStepInterruption(run_steps.py:170-181),把待审批的工具调用挂起。外部通过 RunState.approve() / RunState.reject()(run_state.py:623/634)恢复循环。
完整的恢复路径是:
Runner.run(...)                        # 第一次调用
  → 工具 needs_approval=True
  → NextStepInterruption 挂起,run 返回
调用方(你的 Web 层/队列)收到中断,向用户展示审批卡片
  → 用户点「批准」
调用方构造 RunState,调 state.approve(approval_item)   # 参数是 ToolApprovalItem,run_state.py:623
  → 再次 Runner.run(state) 续跑
  → 被批准的工具有条件地执行,循环继续
注意 RunState 本身就是 Runner.run 的合法输入(run.py:222 的 input 参数接受 RunState)——所以「中断 → 外部审批 → 续跑」不是 hack,而是把整个中间状态序列化之后重新喂给 Runner。approve 的参数是待审批项 ToolApprovalItem(run_state.py:623),批准后该工具才有条件地执行;reject 则否决并继续(run_state.py:634)。这也是为什么 HITL 能跨进程做:RunState 是可持久化的(run_state.py 197KB 不是白写的)。
这个设计把 human-in-the-loop 做成框架原语而不是业务 hack:审批是循环的一个合法状态,而不是「跑了一半抛异常」。对比很多框架把 HITL 做成外部 while 包装,openai-agents 的做法更干净。
4.5 对照 helloagents:从注册表到编排原语
helloagents 的工具执行走 ToolRegistry.execute_tool(name, input_text)(20260810-helloagents-framework/hello_agents/tools/registry.py:132)——注册表模式,职责对应,但工具只是「被调用的函数」。openai-agents 把工具调用提升为编排层语义:handoff 是工具、子 agent 是工具(第 5 节),LLM 的所有「决策动作」都通过同一个 tool_calls 通道表达。这是它与教学框架的本质分野。
5. Handoff 与 Agent-as-Tool:多 agent 编排的两种姿势
5.1 Handoff 也是一个工具
Handoff 是一个 dataclass(handoffs/__init__.py:125-126),字段包括 tool_name、tool_description、input_json_schema、on_invoke_handoff(:134-153)——没错,它长得很像一个工具。事实正是如此:handoff 以工具形式暴露给 LLM,LLM 通过一次工具调用发起交接。
工厂函数 handoff() 是标准用法:
from agents import handoff

billing_agent = Agent(name="billing", instructions="处理账单问题")
refund_agent = Agent(name="refund", instructions="处理退款问题")

triage_agent = Agent(
    name="triage",
    instructions="根据用户诉求决定交接目标。",
    handoffs=[handoff(billing_agent), handoff(refund_agent)],
)
执行时:LLM 发起 billing 工具调用 → handoff 解析分支(run_internal/turn_resolution.py)把控制权交给 billing_agent → 新 agent 带上对话历史继续 → NextStepHandoff 驱动下一轮。交接时还可以通过 input_filter / HandoffHistoryMapper 做历史映射(handoffs/history.py;handoffs/__init__.py:158-172)——比如只把「最近的 N 条 + 摘要」传给新 agent,而不是全量历史。
与工具一致,handoff 参数也默认 strict_json_schema: bool = True(handoffs/__init__.py:181-183),同一个「提高结构化调用成功率」的取向。
5.2 as_tool:把 agent 当工具调用
Agent.as_tool()(agent.py:576-605)把 agent 包成一个 FunctionTool,调用方(原 agent)在工具返回后继续主导对话:
researcher = Agent(name="researcher", instructions="做资料调研,返回要点。")
writer = Agent(
    name="writer",
    instructions="基于调研结果写文章。",
    tools=[researcher.as_tool(tool_name="do_research", tool_description="调研指定主题")],
)
运行时:writer 调用 do_research → 框架在内部起一个嵌套 run 跑 researcher(可带独立 max_turns、run_config,agent.py:586-597)→ researcher 的输出提取成工具返回值 → writer 拿到结果继续。对 writer 而言,researcher 就是一个会「想很久」的工具。
5.3 handoff 的运行时细节:历史映射
回到客服例子,handoff(refund_agent) 执行时发生三件事(handoffs/__init__.py:125-172):
- LLM 发起
refund工具调用,参数是on_invoke_handoff定义的 JSON payload(:148-153); - 触发
NextStepHandoff(run_steps.py:155-157),turn_resolution的 handoff 分支接管; - 新 agent 收到历史——默认全量,但可以通过
HandoffHistoryMapper换成「摘要 + 最近 N 条」之类的压缩形式(handoffs/history.py)。
第三个细节容易被忽略,但它决定了长对话场景的内存与 token 成本。input_filter(handoffs/__init__.py:158-172)是另一个闸口:你可以在交接时剔除敏感工具、截断旧消息。交接不是简单的指针切换,它是一道可编程的数据变换——这正是它被设计成 dataclass 而不是内置魔法的原因。
5.4 两种姿势的取舍
| 维度 | handoff | as_tool |
|---|---|---|
| 控制权 | 转移给新 agent | 原 agent 继续 |
| 新 agent 的输入 | 对话历史(可映射) | 生成的工具参数 |
| 适用场景 | 专业分工:客服分流、专家接力 | 子任务委托:调研、计算、检索后回到主线 |
| 类比 | 电话转接 | 外包给供应商 |
图 5|handoff vs as_tool 对比图
左 handoff——控制权箭头从 triage 指向 billing,billing 接续对话;右 as_tool——writer 调用 do_research 工具,researcher 返回结果,箭头回到 writer。
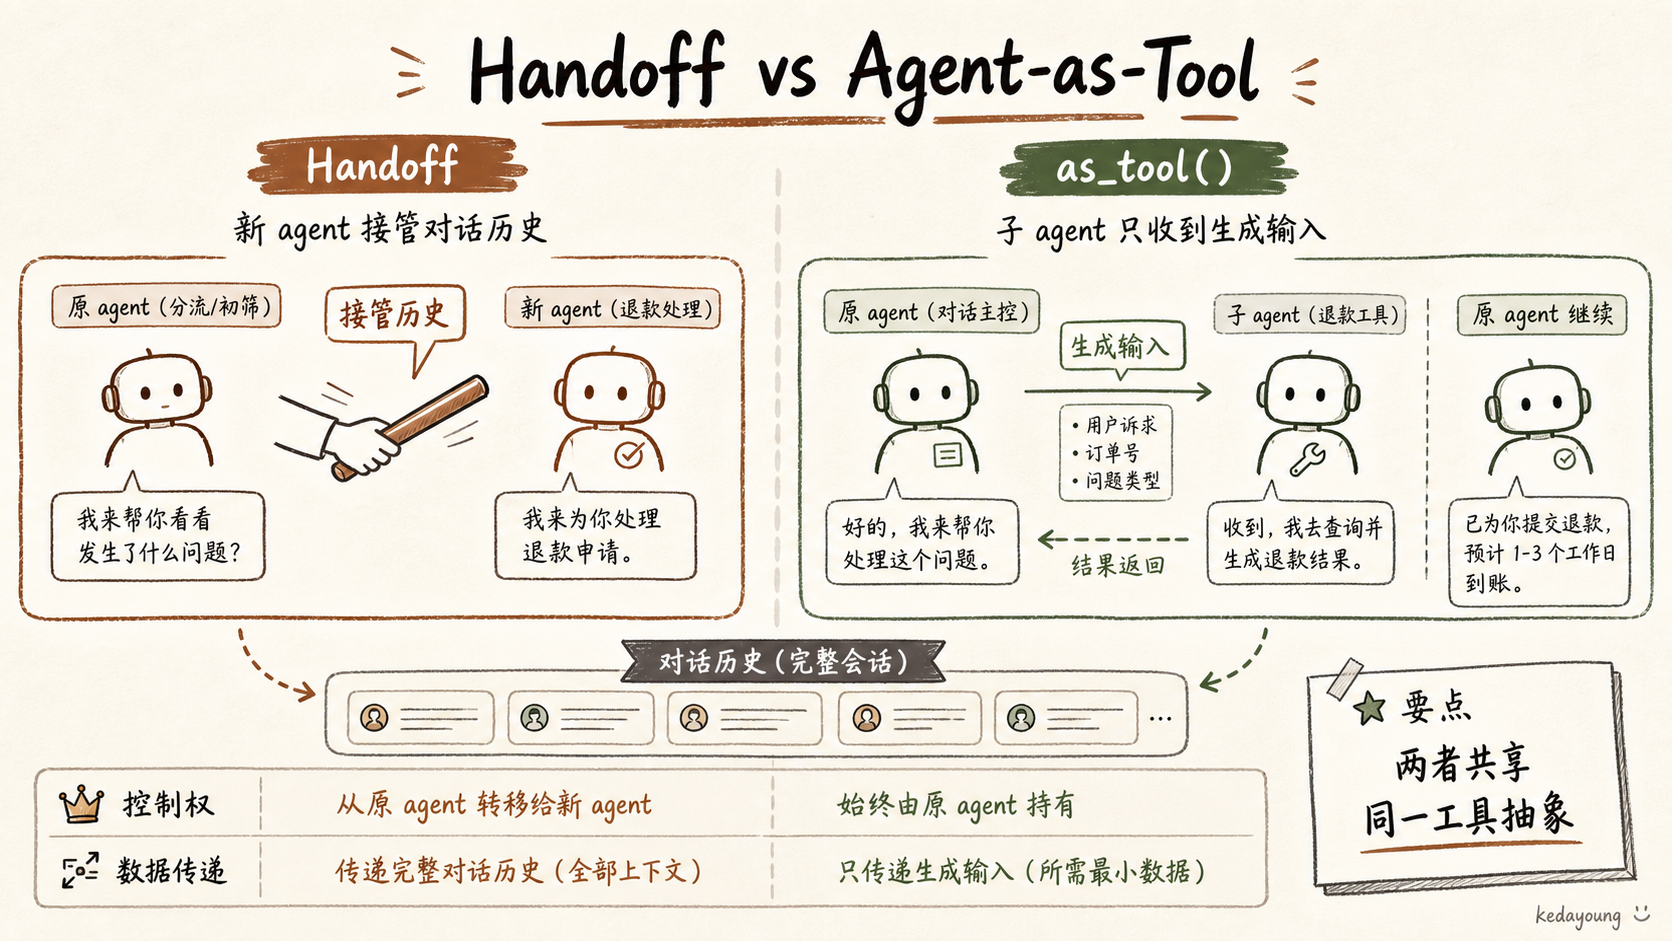
判断准则(作者经验):如果子任务完成后还得回到主线继续,用 as_tool;如果任务是「一类完整会话」(账单、退款、售后),用 handoff——它天然适合把长期对话按域切分。
5.5 系列对照:四种多 agent 编排哲学
「多个 agent 之间如何传递控制权与数据」,openai-agents 的答案是工具调用。对照另三个框架:
- MetaGPT:用环境消息总线广播——角色向环境
publish_message(20260810-metagpt/metagpt/environment/base_env.py:175,docstring:126-127定义了「角色可向环境发布消息、可被其他角色观察」),松耦合但控制流隐式。 - LangGraph:用图结构 +
Send原语(20260810-langgraph/libs/langgraph/langgraph/types.py:664)做显式分支与并行,控制流显式但概念多(图、节点、边、状态、checkpointer)。 - helloagents:教学级
while循环,控制流最简单,能力也最受限。
openai-agents 选择了「最少概念」的中间路线:不给图、不给环境,把编排决策全部交给 LLM 的工具调用。代价是控制流不可静态预览——这是它和 LangGraph 最本质的分野。
6. 会话、Guardrails 与 Tracing:框架提供的周边能力
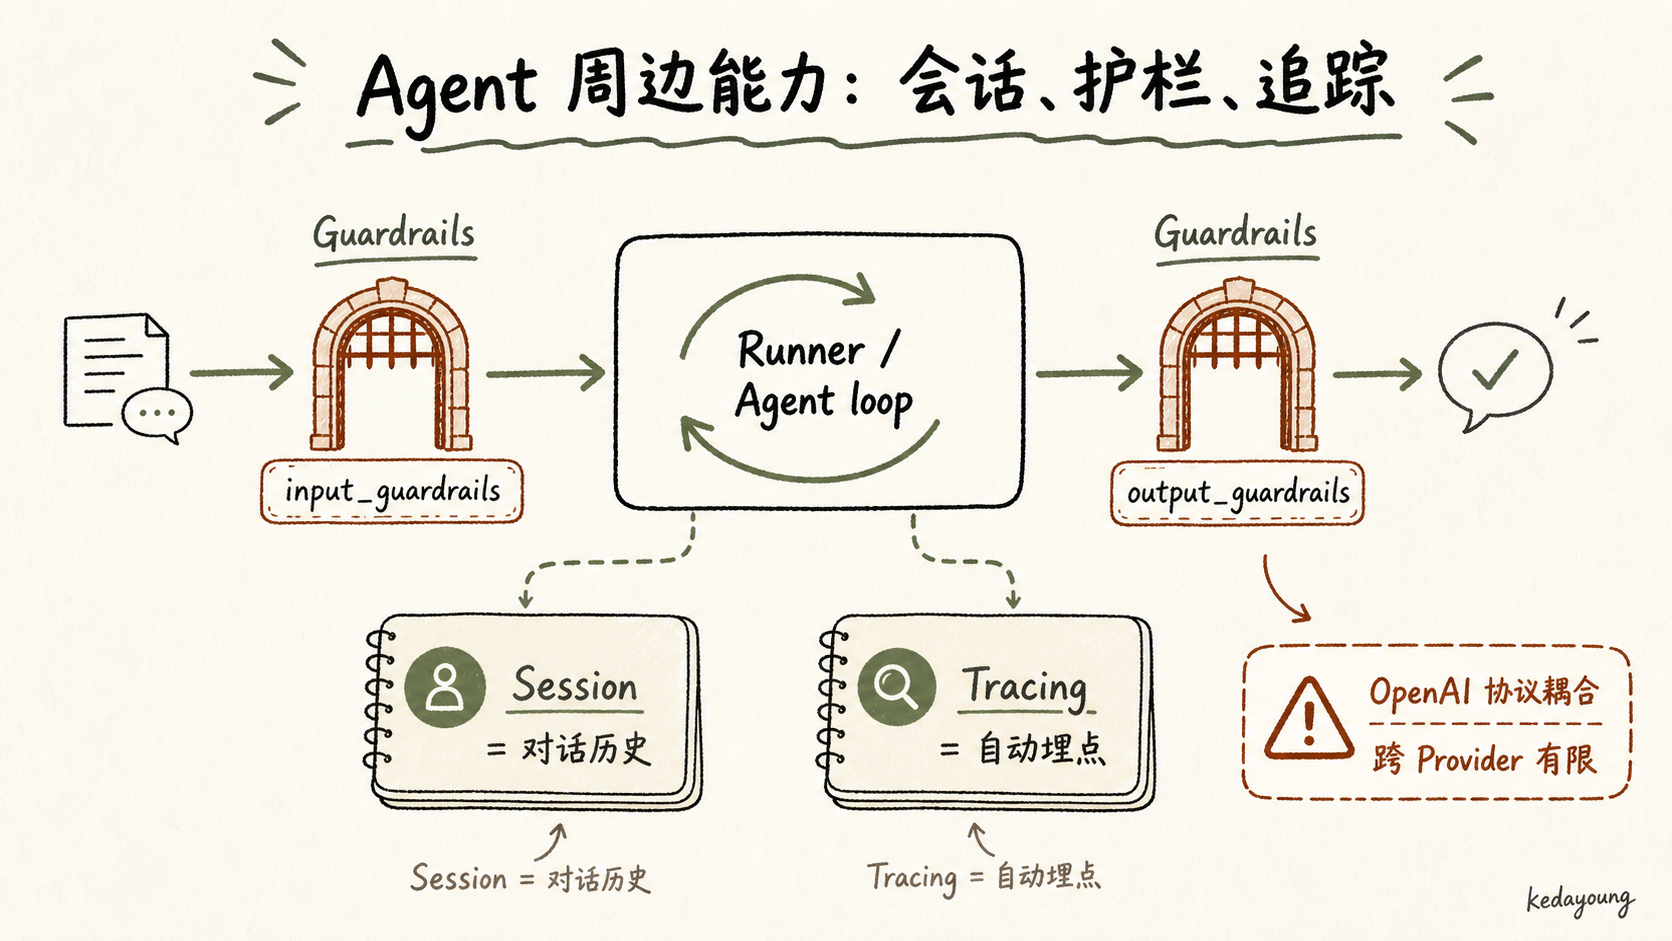
这三块能力决定了一个多 agent 应用能不能「出实验室」。大纲把这节列为周边,但读代码后要修正一点:它们不是可选插件,而是框架一等公民。
6.1 会话与记忆:Session 只是对话历史
memory/session.py:15-21 定义 Session 协议:session_id + get_items + add_items。实现有 SQLiteSession(本地持久化)和 OpenAIConversationsSession(服务端会话),另有 OpenAIResponsesCompactionSession 做上下文压缩。
用法很直白:Runner.run(agent, input, session=SQLiteSession(...)),循环自动把每一步产生的 RunItem 写入 session(run.py:639 的 session_persistence_enabled 分支),下次 run 再取回。对多轮产品(客服、聊天应用),这意味着多轮历史管理是框架替你做掉的,你不用自己维护消息数组。
两个关键事实:
- Session 不是长期记忆。协议只有
get_items/add_items两个方法,存的就是对话历史(session.py:19-20注释:stores conversation history)。没有向量库、没有知识注入——想要 RAG,得自己叠memory/之外的东西。也就是说,memory/这个目录名有点误导:它管的是「短期对话记忆」,不是「长期事实记忆」。 - 服务端会话仅 OpenAI 可用。
conversation_id/previous_response_id把历史交给 OpenAI 服务端管理(run.py:626-638的OpenAIServerConversationTracker)。run.py:276-278注释直接警告:建议只在纯用 OpenAI 模型时启用,其他 provider 不写 Conversation 对象,会留下「半截会话」。
6.2 Guardrails:进出都有闸口
input_guardrails / output_guardrails 挂在 Agent 字段上(agent.py:350/355),另有工具级 tool_guardrails.py。每个 guardrail 包一层 guardrail_span 参与遥测。值得注意的语义(agent.py:352/357 注释):input guardrail 只在链上第一个 agent 跑,output guardrail 只在产生最终输出时跑——guardrail 是「边界检查」,不是每轮检查。
一个 output guardrail 的形态(沿用引言示例的 Ticket 输出;hit 时抛 tripwire 中断整个 run):
from agents import GuardrailFunctionOutput, output_guardrail

@output_guardrail
async def forbid_pii(ctx, agent, output: Ticket):
    if "身份证" in output.resolution:
        return GuardrailFunctionOutput(
            output_info=output,
            tripwire_triggered=True,   # 触发即抛 OutputGuardrailTripwireTriggered
        )
    return GuardrailFunctionOutput(output_info=output, tripwire_triggered=False)
这段代码背后是第 3 节的状态机:guardrail 命中不是一个 if 分支,而是一个异常路径(run.py:248-249 注释里 InputGuardrailTripwireTriggered / OutputGuardrailTripwireTriggered)。也就是说,护栏与 HITL、final output 一样,都是循环语义的一等成员,而不是包在循环外面的装饰。
6.3 Tracing:自动埋点
tracing/ 提供 Trace/Span 层级(docs/tracing.md:23-43),group_id 把一次多 agent 会话的多个 run 串起来(tracing/create.py:48-58),TracingProcessor 可插拔(默认打到 OpenAI 平台,可换成自己的后端)。
group_id 是产品层最值得用的一个参数:一次用户请求可能触发多个 run(triage 一次、handoff 后 refund 一次、as_tool 嵌套又几次),没有 group_id 你在 trace 面板里看到的是散落的 run;带上它,整个请求的 trace 树一目了然:
from agents import RunConfig

result = await Runner.run(
    triage, "我要退款",
    run_config=RunConfig(group_id=f"user-session-{session_id}"),  # 关联整条链路
)重点是「自动」:开发者不写一行埋点代码,Runner.run 全程自动埋 Trace/Span。对比 helloagents 的 TraceLogger(20260810-helloagents-framework/observability/trace_logger.py)需要手动调 log,openai-agents 把遥测做到了零侵入级别——这背后是执行引擎(第 3 节)里无处不有的 tracing 参数透传。代价是(作者判断):如果你不想让遥测出网,得自己实现并注册 TracingProcessor,而不是关掉开关那么简单。
7. 设计取舍、局限与可迁移经验
7.1 设计亮点(可迁移)
- 声明式 Agent:dataclass 字段即配置(
agent.py:296-397)。无 Builder、无 DSL,schema 就是类型本身。 - 编排收敛为工具调用一种原语:
as_tool+Handoff共享同一工具抽象,LLM 统一通过 tool_calls 做决策。 NextStep四态状态机(run_steps.py:155-181):循环语义的干净抽象,HITL 是其中一个合法状态。- 全链路自动遥测:零侵入 tracing。
- HITL 原生支持:
RunState.approve/reject(run_state.py:623/634)是框架能力而非业务 hack。
7.2 局限
- 「轻量」只是 API 层。执行引擎庞大(
run.py112KB、run_state.py197KB),且真正干活的AgentRunner标注 experimental、不属公共 API(run.py:506-510警告not part of the public API)——API 稳定不代表引擎稳定。 - 深度耦合 OpenAI 协议。
models/interface.py:67-100的Model.get_response直接用 OpenAI Responses 类型(TResponseInputItem)当输入/输出;服务端会话、compaction 仅 OpenAI 可用(run.py:274-278)。换 Provider 不是换一个 base_url 的事,是换一套类型协议。 - 无内置长期记忆。Session 只是对话历史(
memory/session.py:15-21)。 - OpenAI 生态特判。默认模型写死
gpt-5.6-luna(agent.py:341),默认推理设置按 GPT-5 系列特判(models/default_models.py:16-48的_GPT_5_*常量)。代码如实如此,选择哪个模型路线是 OpenAI 的事,不是本文的判断。
7.3 适用边界(作者判断,非框架承诺)
- 很合适:官方模型栈 + 需要快速搭多 agent 应用(客服分流、专家协作、工具型 agent),要的是「半小时出活」和全链路可观测。
- 不适合:需要跨 Provider(Azure 之外的厂商模型混用)、需要静态可控的控制流(LangGraph 的图更适合)、需要长期记忆 / 深度定制的 RAG。
7.4 四视角收束
「多 agent 编排」的四个框架视角:
| 框架 | 编排抽象 | 控制流可见性 | 一句话 |
|---|---|---|---|
| openai-agents | 工具调用(handoff / as_tool) | 隐式(LLM 决策) | 少概念,快出活 |
| LangGraph | 图 + Send | 显式 | 控制流可控,概念多 |
| MetaGPT | 环境消息总线 | 隐式 | 角色广播,松耦合 |
| llama_index | Workflow(llama_index/core/workflow/) | 显式步骤 | 面向 RAG 流水线 |
| helloagents | while 循环 | 最简 | 教学用途 |
这张表回答的还是同一个问题:多个 agent 之间如何传递控制权与数据。openai-agents 的答案是「把控制权变成工具调用的返回值」——LLM 每次 tool_calls 既是执行动作,也是编排决策;LangGraph 的答案是「把控制权画成图上的边」,状态转移由图结构保证,不依赖 LLM 是否碰巧选了正确的工具;MetaGPT 的答案是「把控制权放进环境」,谁都能发布、谁都能观察,协作由角色自主达成;llama_index 则更保守,Workflow 是显式的步骤编排,适合确定性流水线而非自由协作。
选型没有对错,只有权衡:你想要「LLM 自由发挥 + 框架托底」(openai-agents),还是「结构先行 + LLM 填内容」(LangGraph / llama_index)。前者起步快、上限高但控制流不可静态预览;后者可控、可测试,但要把每个分支都画出来。对于「先验证想法」的阶段,前者几乎总是更划算;对于「要交付给客户」的生产控制流,后者的静态可见性是实打实的资产。
图 6|「工具调用作为唯一编排原语」哲学图
LLM → 工具调用(FunctionTool / Handoff / Agent-as-Tool 三种)→ 执行层(turn_resolution / tool_execution),标注 NextStep 判定。作为收尾。
7.5 给自研框架的迁移清单
如果这篇文章对你有一点点行动价值,最实用的收获是这张清单——你在自己的 agent 框架里可以照搬的四条设计:
- 用 dataclass/配置对象表达 Agent,别用一堆散落的全局变量。字段分组(行为/能力/护栏/输出)本身就是文档。
- 把「控制权转移」建模为状态,而不是异常或回调。
NextStep四态(run_steps.py:155-181)值得原样抄一遍:FinalOutput / RunAgain / Handoff / Interruption,四态足以覆盖绝大多数 agent loop。 - 让工具调用成为唯一的执行通道。handoff、子 agent、普通函数都走 tool_calls——LLM 侧只有一种决策原语,解析侧只有一条执行管线。
- 遥测内建而不是外挂。在循环的每个状态迁移点埋 span(tracing 模块的
guardrail_span、run span 都是这么做的),比事后在业务代码里打 log 干净一个量级。
反过来,也要记住 openai-agents 的教训:「轻量 API + 重型引擎」是一笔有账可查的交易。当你选择框架时,算的不是 API 好不好看,而是引擎与你的技术栈(模型提供商、会话存储、观测后端)的耦合度——这正是它和 LangGraph 分道扬镳的地方。
结论
回到开头的错位感。openai-agents 的答案现在很清楚了:
它用「一个 dataclass」换来了开发者的低心智负担,用「一套工具调用原语」统一了多 agent 协作,用「NextStep 四态状态机」撑起整个执行循环。 API 的轻量是送给使用者的礼物,执行引擎的庞大是这礼物的账单,而 OpenAI 协议耦合是账单里最显眼的一项。
如果你从这篇文章只带走三句话:
- Agent 就是 dataclass,能力都是字段——先学会读
agent.py:296-397的字段清单,胜过读十篇博客。 - handoff / as_tool / function_tool 是同一个东西的三种用法——多 agent 编排 = 让 LLM 做工具调用。
NextStep四态(run_steps.py:155-181)是 agent loop 的通用词汇——写自己的循环前,先定义自己的状态机。
最后提醒一句:以上所有 file:line 都来自工作区内的本地克隆,openai-agents 版本为 pyproject.toml:3 声明的 0.20.0。框架迭代很快,读代码永远比读文章新。
附录:证据清单
| 断言 | 证据位置(相对 0-agent-framework/) |
|---|---|
| Agent dataclass 与字段 | src/agents/agent.py:296、:309-397 |
| 默认模型 gpt-5.6-luna | src/agents/agent.py:341、src/agents/models/default_models.py:16-48 |
| as_tool 与 handoff 区别 | src/agents/agent.py:576-605 |
| Runner 入口与委托 | src/agents/run.py:219、:287 |
| 循环语义 docstring | src/agents/run.py:237-244 |
| NextStep 四态 | src/agents/run_internal/run_steps.py:155-181 |
| 工具 strict schema | src/agents/tool.py:468-470 |
| HITL approve/reject | src/agents/tool.py:486-493、src/agents/run_state.py:623/634 |
| Handoff 即工具 | src/agents/handoffs/__init__.py:125-183 |
| 服务端会话仅 OpenAI | src/agents/run.py:626-638、:274-278 |
| Session 无长期记忆 | src/agents/memory/session.py:15-21 |
| Tracing 层级 | docs/tracing.md:23-43、src/agents/tracing/create.py:48-58 |
| AgentRunner experimental | src/agents/run.py:506-510 |
| OpenAI 协议耦合 | src/agents/models/interface.py:67-100 |
| 版本读取方式 | src/agents/version.py:4、pyproject.toml:3 |
| helloagents execute_tool | 20260810-helloagents-framework/hello_agents/tools/registry.py:132 |
| MetaGPT 消息总线 | 20260810-metagpt/metagpt/environment/base_env.py:126-127、:175 |
| LangGraph Send | 20260810-langgraph/libs/langgraph/langgraph/types.py:664 |
写作说明
成文时 openai-agents 未在本机安装(importlib.metadata 读取失败、回退 0.0.0),版本号引用 pyproject.toml:3 声明的 0.20.0;若发布前需要运行期版本号,请 pip install openai-agents 后以 importlib.metadata.version("openai-agents") 实测为准。两处与大纲原始行号不一致的对照引用已按本地代码修正:MetaGPT 消息总线在 base_env.py:126-127/:175(非 :133),helloagents registry 完整路径含 hello_agents/ 前缀。