中心论点:opencode 把「上下文规模」问题简化为「摘要 + 截断」,把「成本」问题交给 provider 缓存——上下文 = 全量历史(或从摘要点截断后的历史)+ 系统提示 + 工具定义,不做 token 级裁剪;摘要由专用 summarizer 代理生成、达到窗口 95% 自动触发 AutoCompact,工具输出在源头硬截断,长上下文成本靠 Anthropic prompt caching 而非本地裁剪。 证据说明:全部机制描述以本地克隆
0-context-engineering/20260810-opencode/repo/(main 分支快照,2026-08-11 克隆)为准,行号为该克隆的真实行号;本版本不加载AGENTS.md,项目上下文文件是internal/config/config.go:108-120列出的默认列表(成文按源码如实写,不套用惯例);不写任何模型表现数字,只讲机制。
0. 引言:一档「简单而显式」的上下文工程
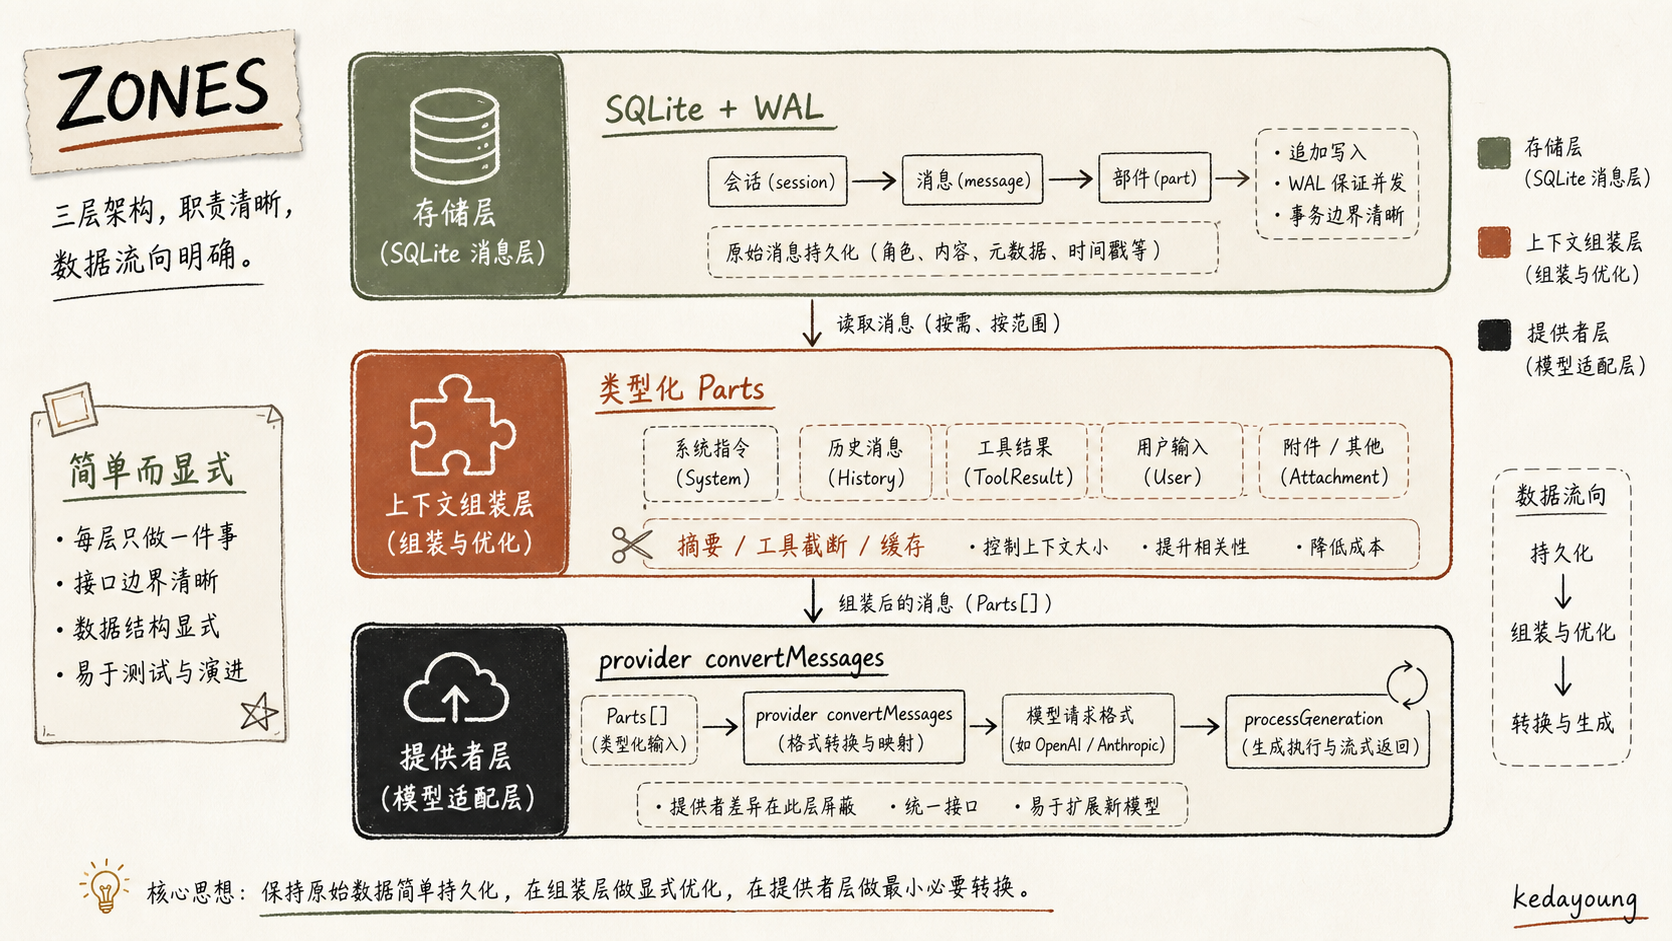
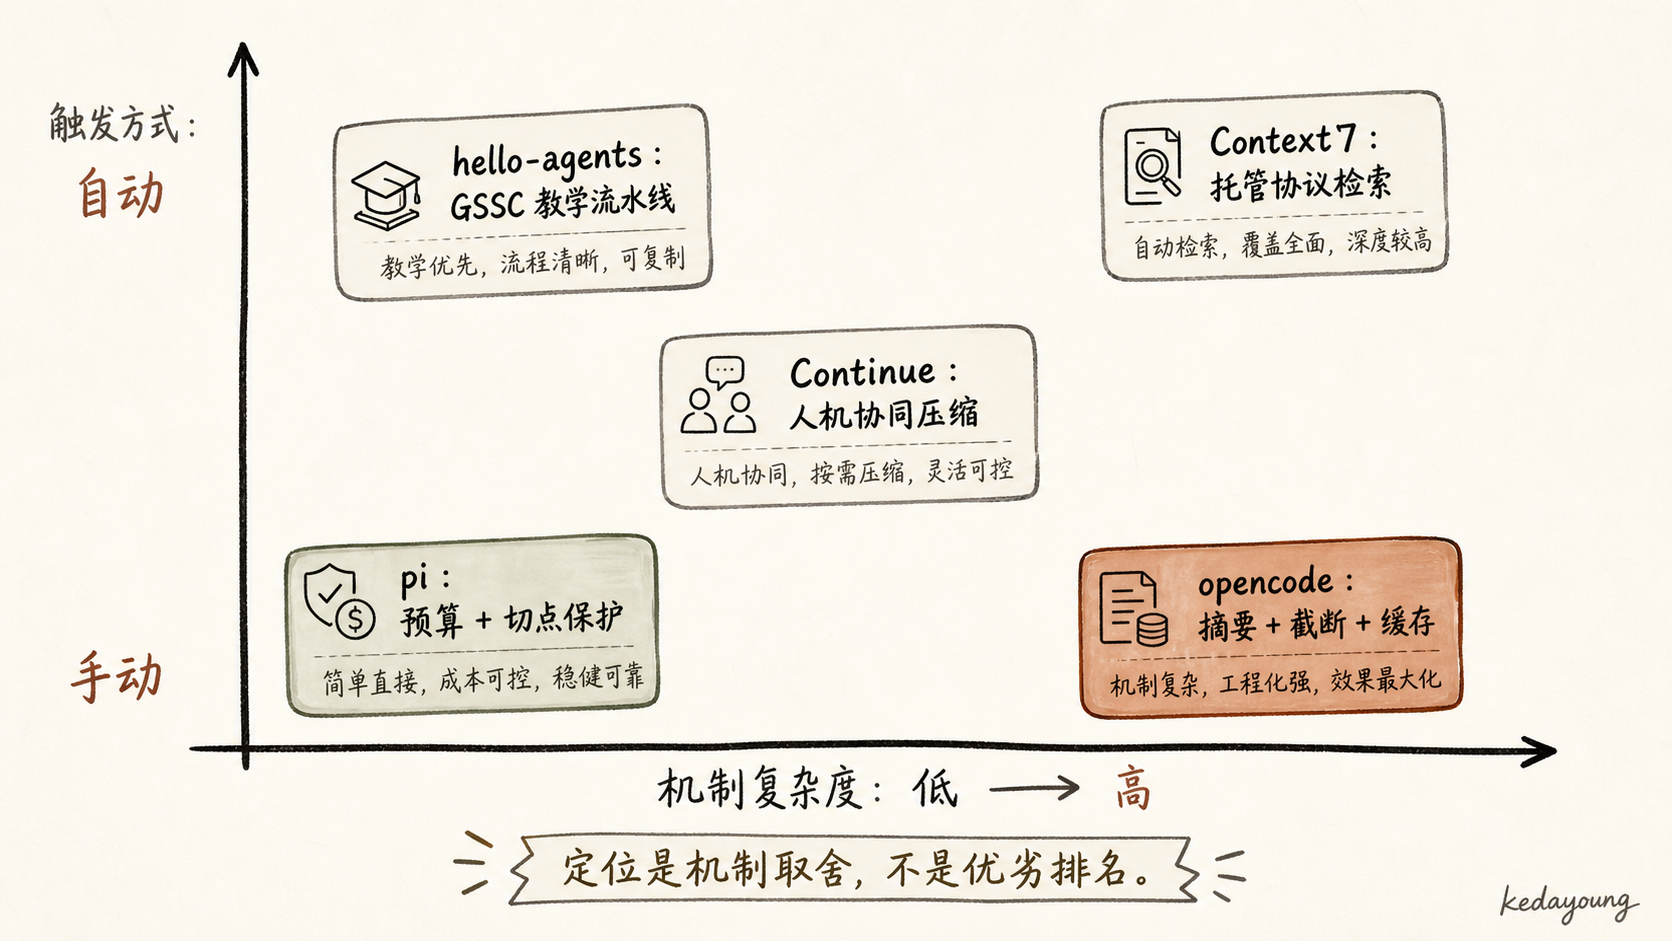
同一个「长会话装不下」的问题,不同的 agent 给出了截然不同的答案。教学向的 hello-agents 把上下文工程讲成一条 GSSC 流水线;生产向的 pi 用精密的 token 预算和切点保护让「超限时刻可预测」;IDE 插件向的 Continue 把决定权交给用户,做「人机协同」的手动压缩。而本文的主角 opencode——一个 Go 实现的终端 agent——选择了另一条路:尽量少做机制,把每件事做显式。
opencode 对「上下文」的定义简单得近乎朴素:
上下文 = 全量历史(或从摘要点截断后的历史)+ 系统提示 + 工具定义,不做 token 级裁剪。
规模控制不靠「精打细算」,而是靠三件事:
- 摘要式压缩:专门的 summarizer 代理把历史压成摘要,
SummaryMessageID记录摘要位置,后续组装从摘要点截断重放;达到窗口 95% 时 AutoCompact 自动触发。 - 工具输出硬截断:文件内容不进上下文,靠
view/grep/glob等工具按需拉取,并在源头设硬限制。 - Anthropic prompt caching:system + tools + 末尾 3 条消息加 cache control,把「长上下文成本」问题交给 provider 缓存而不是本地裁剪。
这套设计的中心论点是:opencode 把「上下文规模」问题简化为「摘要 + 截断」,把「成本」问题交给 provider 缓存——与 pi 的精密预算、Continue 的人机协同压缩都不同,是终端场景下「少机制、可审计」的一种取向。第 2–5 节从存储、组装、压缩、成本四个落点展开,最后一节与 pi / Continue 对照并提炼可迁移模式。
1. 定位:终端 agent 的上下文工程与 IDE agent 的差异
1.1 终端 agent 缺什么
opencode 运行在终端里,没有 IDE 那一层「现成上下文」:没有编辑器选中的代码、没有语言服务器实时推送的诊断、没有文件树面板、没有 hover 预览。IDE agent(如 Continue)可以把这些状态直接拼进提示词;终端 agent 面对的是一个裸 shell,它必须自己回答两个问题:
- 项目上下文从哪来? —— 靠指令文件注入。
- 文件内容怎么进上下文? —— 靠工具按需拉取,而不是自动塞入。
第一个问题的答案在 internal/config/config.go:108-120——defaultContextPaths 定义了 11 条默认项目上下文路径(其中 .cursor/rules/ 是目录):
var defaultContextPaths = []string{
    ".github/copilot-instructions.md",
    ".cursorrules",
    ".cursor/rules/",
    "CLAUDE.md",
    "CLAUDE.local.md",
    "opencode.md",
    "opencode.local.md",
    "OpenCode.md",
    "OpenCode.local.md",
    "OPENCODE.md",
    "OPENCODE.local.md",
}值得注意:这份列表不包含 AGENTS.md。opencode 兼容的是 Copilot / Cursor / Claude 三家已有的指令文件约定(*.local.md 是 Claude Code 的「仅本机生效」变体),它没有另立一套「AGENTS.md 惯例」。注入逻辑在系统提示层完成:GetAgentPrompt(internal/llm/prompt/prompt.go:15-39)先把角色提示词取出来;如果是 coder / task 代理,再把 getContextFromPaths()(prompt.go:46-58)读到的项目上下文拼进系统提示(prompt.go:30-35)。
第二个问题的答案是一组文件读取工具,第 4.4 节展开:文件内容默认不进消息历史,模型需要时用 view / grep / glob / bash 等工具拉取,且每个工具的输出都在源头设了硬上限。
1.2 多代理架构:摘要不是主代理自己压的
opencode 不是「一个模型干所有事」。internal/config/config.go:37-44 定义了四类代理的角色名:
type AgentName string
const (
    AgentCoder      AgentName = "coder"
    AgentSummarizer AgentName = "summarizer"
    AgentTask       AgentName = "task"
    AgentTitle      AgentName = "title"
)
Agent 结构体(config.go:47-51)为每个角色独立配置 Model、MaxTokens、ReasoningEffort;Config.Agents map[AgentName]Agent(config.go:90)。agent 结构体持有三个 provider(internal/llm/agent/agent.go:59-71):主对话的 provider、异步起标题的 titleProvider、以及专门做摘要的 summarizeProvider。NewAgent(agent.go:73-97)为 coder 代理额外创建 title 与 summarize 两个 provider(agent.go:83-97);task 子代理则在使用时由 agent 工具现建(agent-tool.go:57,见 2.4 节)。
「摘要由专用 summarizer 代理做,不是主代理自己压」——这是 opencode 与很多「主循环内顺手压缩」实现的关键区别:压缩是一个独立角色、独立模型、独立提示词(internal/llm/prompt/summarizer.go)的工作,主代理的上下文与「如何总结自己」这件事完全解耦。第 4 节会看到这个设计的完整形态。
1.3 上下文工程的三个落点
先给一张整篇文章的地图——opencode 的上下文工程落在三层:
| 落点 | 位置 | 职责 |
|---|---|---|
| 消息持久化 | internal/db/ + internal/message/ | 会话与消息存 SQLite,带 token/cost 字段 |
| 组装 | internal/llm/agent/agent.go + internal/llm/provider/ | 历史 + 系统提示 + 工具定义,在 provider 层统一转换 |
| 压缩 | agent.go Summarize + internal/tui/tui.go AutoCompact + internal/llm/tools/ | 摘要生成、摘要点截断、95% 自动触发、工具输出源头硬截断 |
与 pi 的差异预告:pi 有精密的 token 预算(reserveTokens / keepRecentTokens)和绝不在 toolResult 处切的切点保护;opencode 把这些简化成「摘要 + 截断」,第 4.5、6 节展开对比。
2. 消息持久化:SQLite 与类型化 Parts
2.1 存储层:WAL 模式的 SQLite
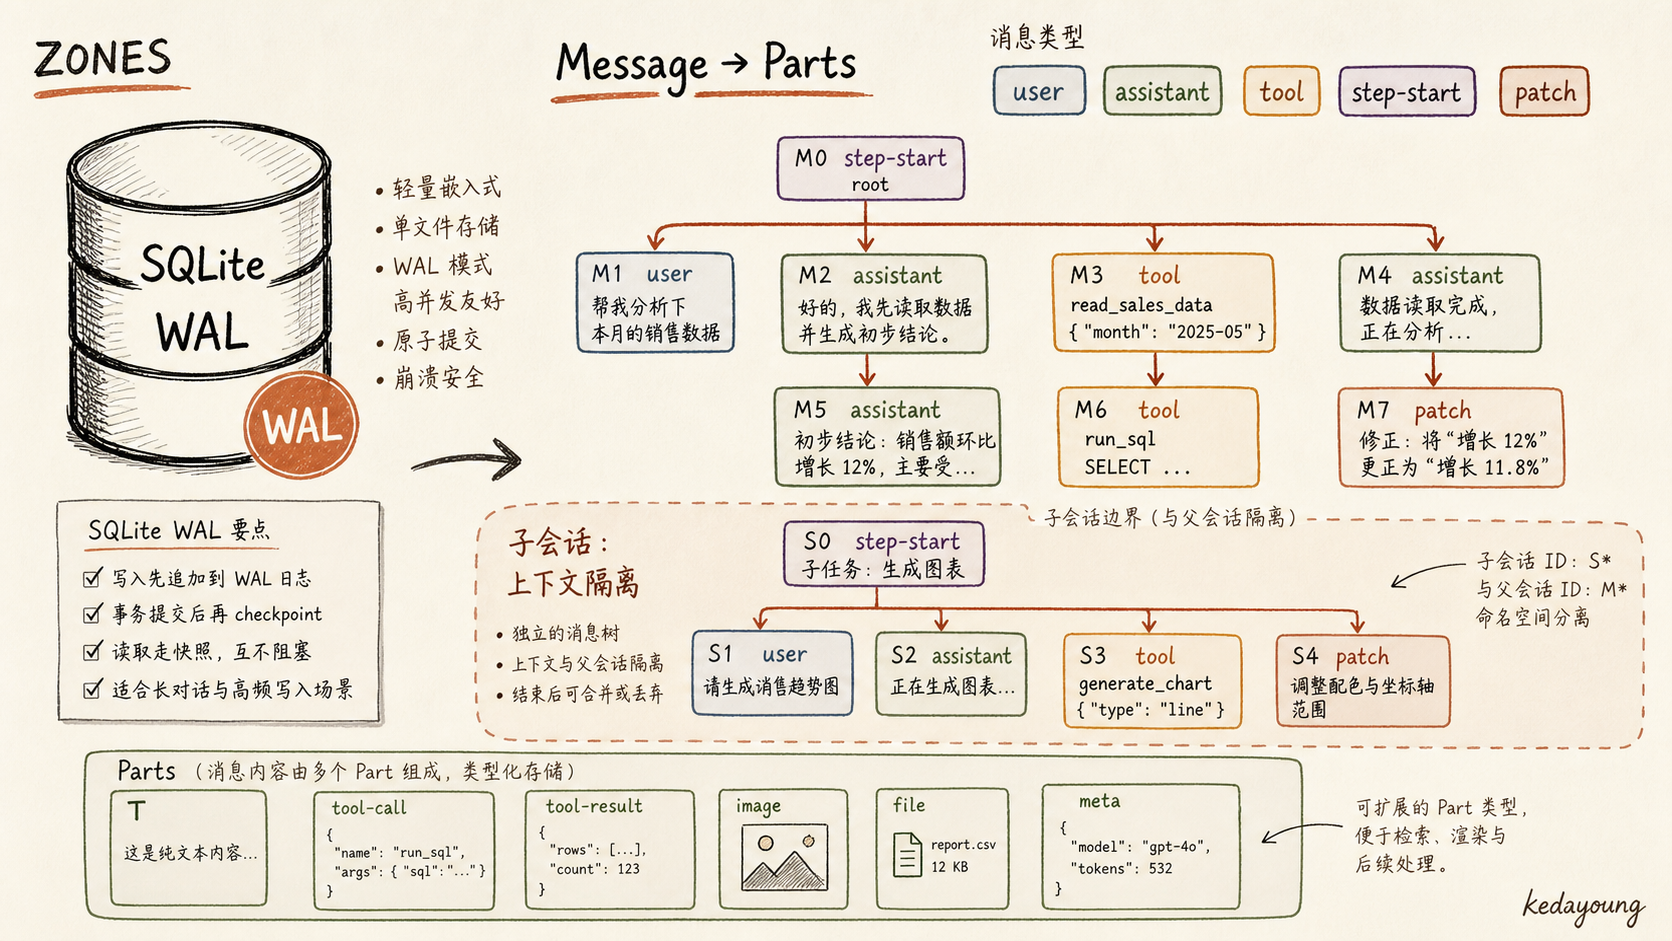
opencode 用 SQLite 做持久化。internal/db/connect.go:18-68 的 Connect 打开 opencode.db(connect.go:26-28),并设置一组 pragma(connect.go:40-46):
pragmas := []string{
    "PRAGMA foreign_keys = ON;",
    "PRAGMA journal_mode = WAL;",
    "PRAGMA page_size = 4096;",
    "PRAGMA cache_size = -8000;",
    "PRAGMA synchronous = NORMAL;",
}
WAL 模式 + synchronous = NORMAL 是典型的「读写并发、容忍少量崩溃窗口」的本地数据库配置;连接建立后,用 goose 应用迁移(connect.go:56-66)。表结构在 internal/db/migrations/20250424200609_initial.sql:
sessions表(:4-14)除 ID / title 外,还带四个用量字段:message_count、prompt_tokens、completion_tokens、cost,全部NOT NULL DEFAULT 0并加CHECK (>= 0)约束。messages表(:47-57)的核心是parts TEXT NOT NULL default '[]'(:51)——消息内容以 JSON 文本存一整列。- 触发器(
:68-82)在插入 / 删除消息时自动增减sessions.message_count,计数由数据库保证一致性。
2.2 消息模型:类型化 Parts
消息的 Go 模型在 internal/message/content.go。角色是枚举(:11-18):Assistant / User / System / Tool——注意 tool 结果是独立角色,不是挂在 user 消息里的附件,这一点对第 3、4 节的转换与截断都有影响。更反直觉的是:System 角色在消息流里从不产生——系统提示不经过消息模型,而是作为 provider 请求参数直接传给 API(见 3.4),枚举里的 System 只是为完整性保留。
ContentPart 是一个密封接口(content.go:34-36,私有方法 isPart() 防止外部实现),七种类型(:38-109):
| 类型 | 含义 |
|---|---|
ReasoningContent | 模型的推理过程 |
TextContent | 文本 |
ImageURLContent / BinaryContent | 图片 / 二进制附件 |
ToolCall | 工具调用(含 ID、名称、JSON 参数) |
ToolResult | 工具结果(含对应 ToolCallID、内容、是否错误) |
Finish | 结束标记(reason + 时间戳) |
Message 结构体(content.go:111-119)由 ID / SessionID / Role / Parts / Model / CreatedAt / UpdatedAt 组成。一条消息是一组类型化 parts 的集合——一次 assistant 回复可以是 TextContent + ToolCall + ToolCall + Finish,一次 tool 回复可以是多个 ToolResult。这个模型让「消息」既是展示单元也是协议单元:序列化时按 {Type, Data} 包装(internal/message/message.go:180-211 的 marshallParts),反序列化时按类型还原(:213-281),provider 层再按各自 API 的格式把这些 parts 重新组装(第 3 节)。
2.3 写入与读取
- 写入:
Create(message.go:57-83)把 parts 序列化成 JSON 写入parts列(:63)。 - 读取:
List(sessionID)(message.go:132-145)全量加载该 session 的所有消息并反序列化——没有任何分页或截断,这是「上下文 = 全量历史」的第一层含义。 - 恢复:切换会话时,
internal/tui/components/chat/list.go:441-460的SetSession调用Messages.List把消息从 DB 拉回 TUI 渲染(:446、:450)。
2.4 子会话:上下文隔离的廉价方案
当主代理调用 agent 工具派发子任务时,internal/session/session.go:54-66 的 CreateTaskSession 会新建一个独立 session——ID 直接用工具调用的 ID,ParentSessionID 指向父会话。子代理跑在自己的 session 里(internal/llm/agent/agent-tool.go:57-67:新建 task agent → 建子会话 → agent.Run),上下文与父会话完全隔离,互不污染;子会话的 cost 会在结束时累进父会话(agent-tool.go:90)。
子代理 = 独立 session,天然隔离上下文——这是 opencode 用「数据模型」解决「上下文污染」的例子:不需要复杂的上下文切换机制,一个 ParentSessionID 字段就够了。
2.5 设计含义:把用量存进数据模型
Session 结构体(session.go:12-23)里躺着 PromptTokens、CompletionTokens、SummaryMessageID、Cost 四个上下文工程相关的字段。这意味着「这个会话花了多少 token、压缩到哪了」是持久化数据,不是运行时状态。它是第 4 节 AutoCompact 触发阈值的依据(tui.go:338 直接读 session 字段),也是第 5 节成本核算的落点(TrackUsage 累进 session)。先有数据,后有机制——这是贯穿全文的一个设计模式。
3. 上下文组装:provider 层统一,无 token 级裁剪
3.1 组装入口:processGeneration
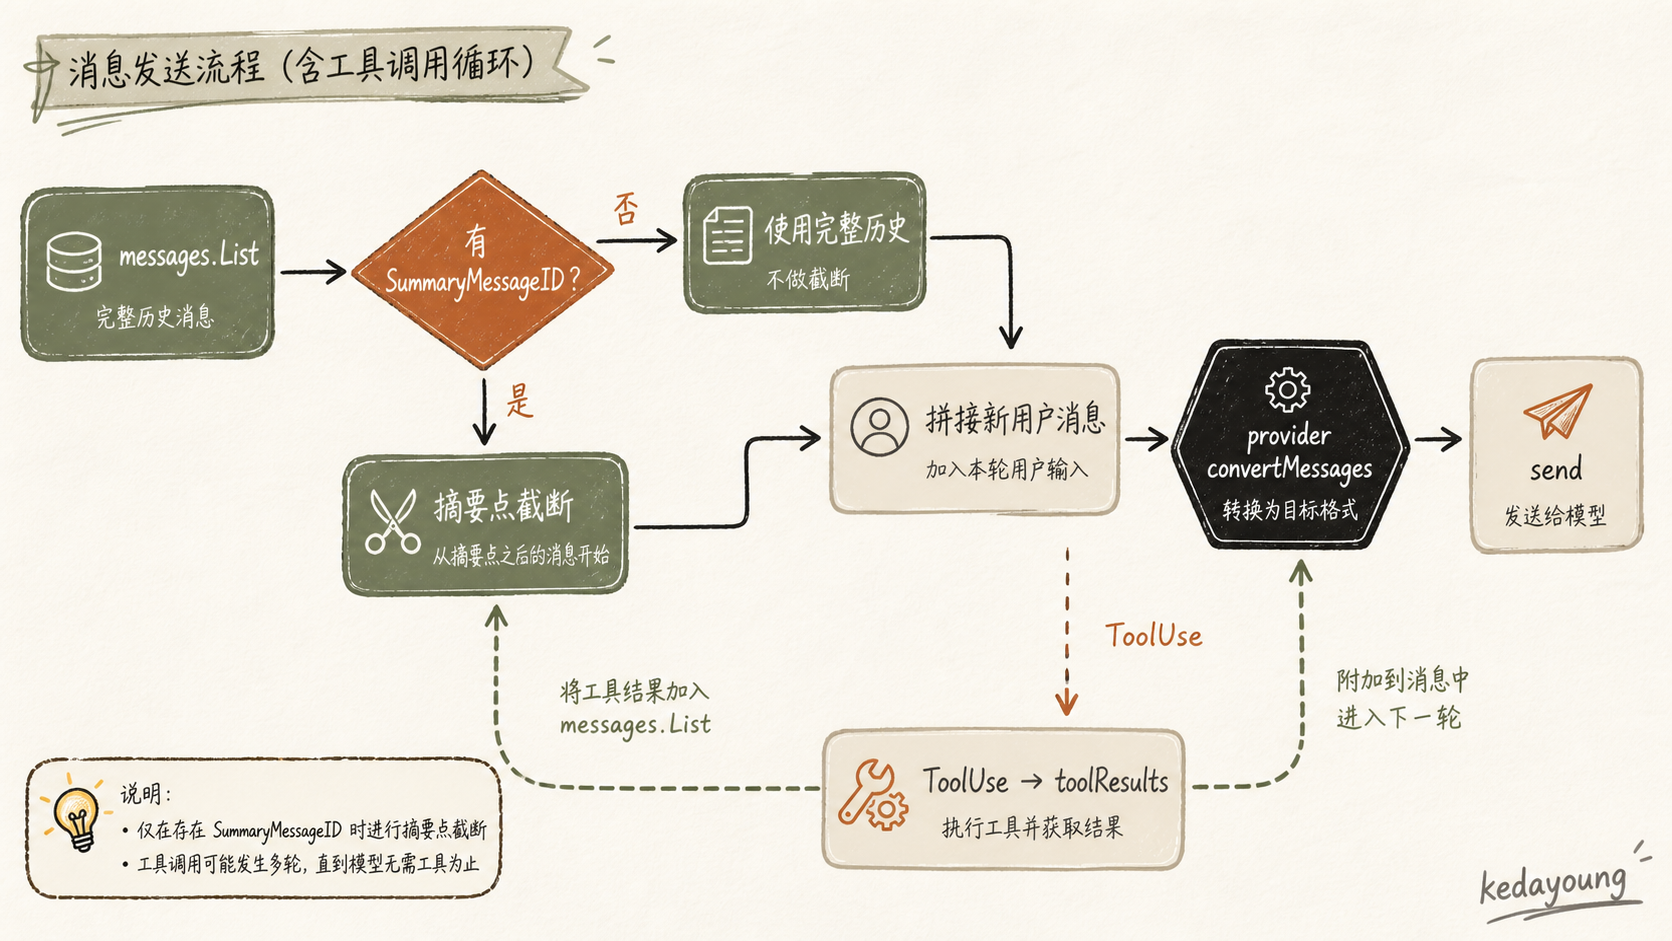
每次用户输入,走 Run(agent.go:198-231)→ processGeneration(agent.go:233-311):
msgs, err := a.messages.List(ctx, sessionID)      // :236 加载全量历史
...
if session.SummaryMessageID != "" {               // :255 存在摘要则截断
    ...找摘要消息索引 summaryMsgInex...
    msgs = msgs[summaryMsgInex:]                  // :264 从摘要点截断
    msgs[0].Role = message.User                   // :265 首条改为 user 角色
}
userMsg, err := a.createUserMessage(...)          // :269 拼接新用户消息
msgHistory := append(msgs, userMsg) // :274然后进入循环(:276-310):发送 → streamAndHandleEvents → 如果结束原因是 FinishReasonToolUse 且有工具结果,把 agentMessage 和 *toolResults 追加进 msgHistory 继续请求(:300-303)——工具结果回流是就地重放,不重新读库。整条链路里没有任何按 token 数裁剪历史的逻辑:历史要么全量,要么从摘要点一刀切。
3.2 摘要点截断:唯一的「输入侧裁剪」
agent.go:255-267 是全文最核心的几行(第 4 节详解摘要怎么来的,这里只看它怎么用):
- 找到
session.SummaryMessageID在消息列表中的下标(:256-262;源码变量名即summaryMsgInex,拼写沿袭源码); msgs = msgs[summaryMsgInex:]——丢弃摘要之前的所有历史(:264);msgs[0].Role = message.User——摘要消息本来是 assistant 角色,改成 user(:265)。
最后一步很关键:压缩后的「历史」以一条 assistant 的摘要文本开头,但所有 provider 的 API 都不接受以 assistant 开头的消息序列,所以 opencode 把摘要消息的角色翻成 user——摘要文本从此作为「用户侧陈述」参与对话,而不是一条模型输出。这是把「压缩」伪装进「对话格式」的一个小技巧,代价是摘要消息的 role 与它的真实产生方不一致,但它保证了转换层零特判。
3.3 provider 层转换:角色模型差异在这里抹平
组装完的 []message.Message 是 opencode 自己的模型,各家 provider 的 convertMessages 负责翻译:
- Anthropic(
internal/llm/provider/anthropic.go:60-119):Tool角色消息转成 user 消息、内容内嵌tool_resultblock(:110-115);assistant 消息的ToolCall转tool_useblock(:95-102);末尾 3 条消息加 prompt caching(:62-72,见第 5 节)。 - OpenAI(
internal/llm/provider/openai.go):首条注入 system 消息(:68-70);Tool角色转ToolMessage(:116-121)。 - Gemini(
internal/llm/provider/gemini.go:53-133):user / model / function 三角色转换,tool 结果尝试 JSON 解析后打包为FunctionResponse。
每个 provider 都在「自己的 API 约束」和「opencode 的统一消息模型」之间做适配——组装逻辑只写一遍,差异收敛在 provider 层。
3.4 系统提示与唯一的「预算」
系统提示由 createAgentProvider 装配(agent.go:706-758),内容是 GetAgentPrompt 的输出(prompt.go:15-39,见 1.1 节)——注意它是 provider 请求参数(anthropic.go:187-193 的 System 字段、openai.go:68-70 首条注入),与消息模型里的 System 角色无关(见 2.2)。
opencode 唯一的「预算」在输出侧:internal/config/config.go:536-563 的 maxTokens 校验——非法值回退到 MaxTokensFallbackDefault(= 4096,config.go:105,仅当模型没有 DefaultMaxTokens 时);超过 ContextWindow/2 则钳制为窗口一半(同区段的钳制分支,注释明说 "Ensure max tokens doesn't exceed half the context window")。这是输出上限,不是输入裁剪。
3.5 设计含义:少机制的另一面
不做输入侧 token 裁剪,靠「摘要截断 + 工具输出截断」间接控制输入规模——这是「少机制」设计。收益:组装路径只有一条,任何一步都可审计(--debug 下甚至会把组装好的请求 JSON 落盘,anthropic.go:200-204)。代价:窗口利用率不如精密预算方案——pi 会在触碰窗口前提前压缩、精打细算保留多少;opencode 只在 95% 处一刀切,摘要点之前的历史信息(除了摘要文本)全部消失。这个取舍在第 6 节对照表里展开。
4. 压缩与工具截断:Summarize + 摘要点重放 + AutoCompact
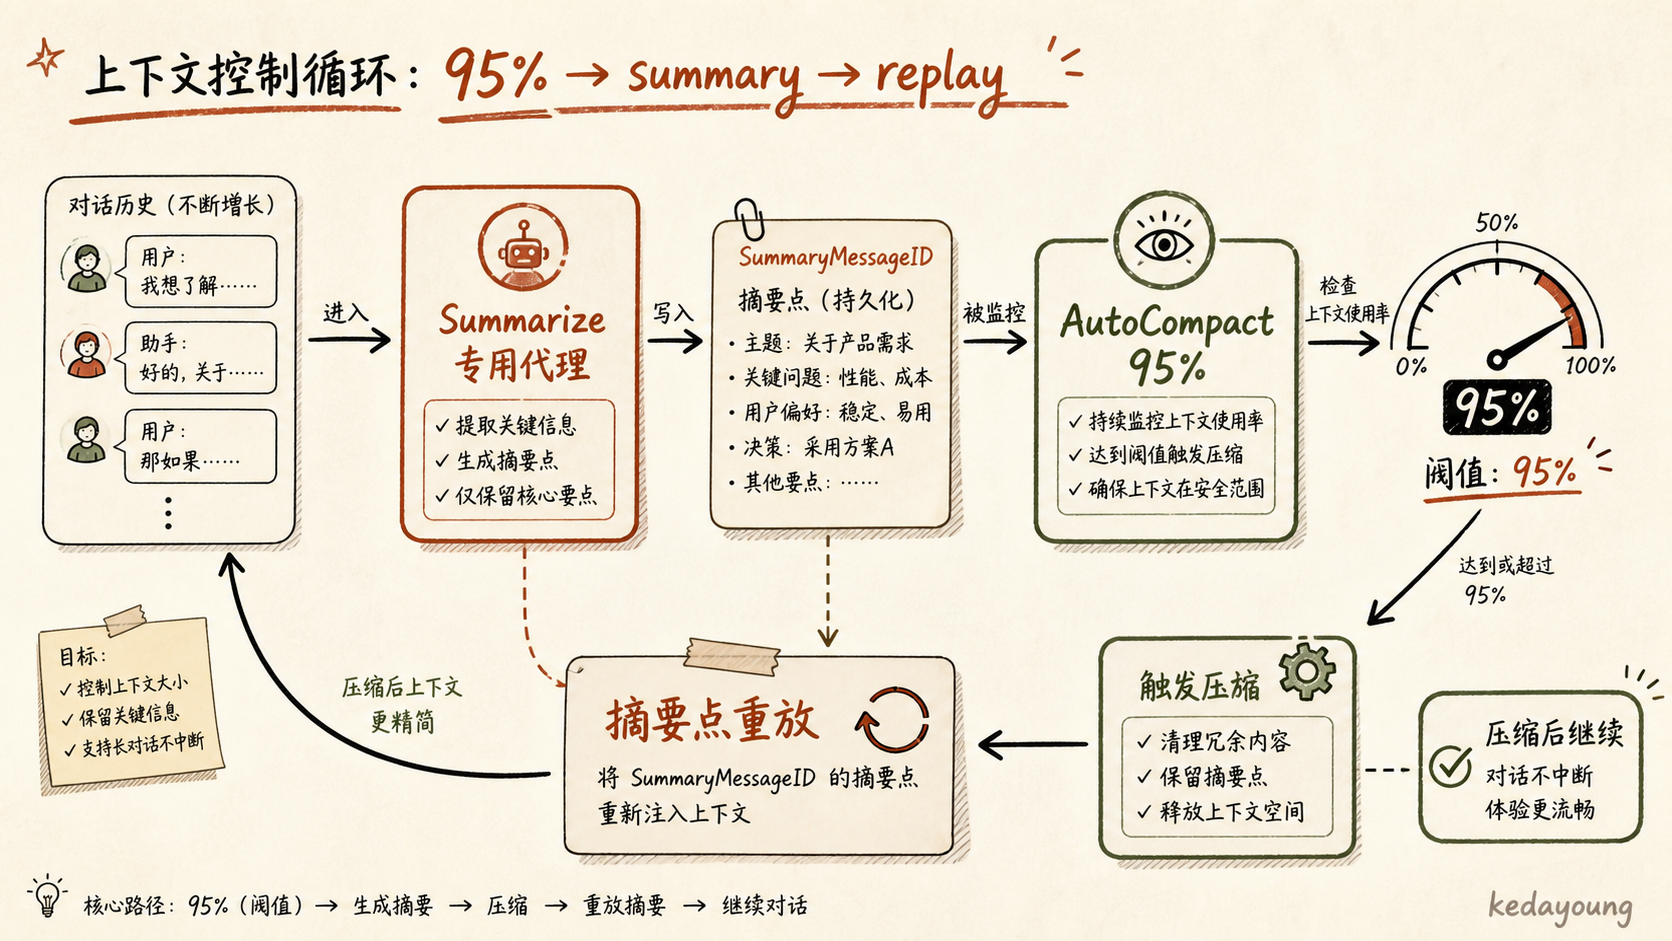
4.1 Summarize:专用代理把历史压成摘要
Summarize(agent.go:535-704)是压缩的第一环。流程:
- 校验
summarizeProvider存在(:536-538),否则报错——压缩不是主 provider 的隐藏能力,而是独立可配置的角色。 - 加载该 session 全量消息(
:561)。 - 追加一条 user 消息作为总结指令:「Provide a detailed but concise summary of our conversation above. Focus on information that would be helpful for continuing the conversation, including what we did, what we're doing, which files we're working on, and what we're going to do next.」(
:590-599)。 - 用 summarizer provider 发送,不挂任何工具(
:609-613,make([]tools.BaseTool, 0))——总结任务是纯文本对话,不给工具,避免摘要过程引入工具调用的不确定性。 - 把返回的摘要写回原 session:一条 assistant 消息,parts 为
TextContent{summary} + Finish{end_turn}(:652-662)。 - 记录
oldSession.SummaryMessageID = msg.ID(:673)——摘要的位置就是未来的截断点。
注意第 5 步:摘要消息和原历史存在同一个 session,不是新建会话(Progress 文案写的是 "Creating new session...",但代码用的就是 oldSession.ID,:652)。压缩后历史不是被删除,而是「前面一大截被一条摘要替代、摘要留在原地」,这与 pi 的「增量折叠」、Continue 的「summary 持久化在会话消息上」异曲同工——都是不丢摘要、只丢细节。
4.2 摘要点截断重放:压缩后历史可继续
摘要点截断的用法在 3.2 节已述:后续每次组装,agent.go:255-267 找到 SummaryMessageID,组装时把摘要点之前的消息全部切掉(数据库里的旧消息仍在,只是不再进请求),摘要文本以 user 角色成为新历史的第一条。于是对话的「记忆」变成:
[摘要文本(user)] → [摘要点之后的消息] → [当前用户输入]压缩后历史不是被丢弃,而是被摘要替代——模型仍然有完整的「过去发生了什么」的语义,只是失去了逐字逐句的细节。
4.3 AutoCompact:95% 阈值自动触发
谁调用 Summarize?两处:用户手动触发(TUI 命令),以及自动触发——internal/tui/tui.go:335-341:
} else if payload.Done && payload.Type == agent.AgentEventTypeResponse && a.selectedSession.ID != "" {
    model := a.app.CoderAgent.Model()
    contextWindow := model.ContextWindow
    tokens := a.selectedSession.CompletionTokens + a.selectedSession.PromptTokens
    if (tokens >= int64(float64(contextWindow)*0.95)) && config.Get().AutoCompact {
        return a, util.CmdHandler(startCompactSessionMsg{})
    }
}每次主代理响应完成(AgentEventTypeResponse 且 Done)时,把 session 里累计的 CompletionTokens + PromptTokens 与 model.ContextWindow 的 95% 比较,超了就发 startCompactSessionMsg 触发 Summarize(tui.go:306-321)。几个要点:
- 阈值是 95% 而非 100%:在触碰窗口之前就压缩,留出摘要生成的余量。
- token 计数来自 session 字段,即第 2.5 节说的「用量是持久化数据」——阈值判断零计算成本。
AutoCompact是配置开关(config.go:96):README 示例标"autoCompact": true // default is true(README.md:97),但源码字段没有默认赋值——未配置时 Go 零值为 false、不自动压缩,需要显式开启。- 摘要完成后,
Summarize会把 session 的 token 计数重置:PromptTokens = 0、CompletionTokens = 摘要输出 token(agent.go:674-675)——压缩同时重置了 AutoCompact 的「里程表」,否则刚压缩完又会立刻触发。
4.4 工具输出硬截断:「文件内容不进上下文」
token 级裁剪的另一半被前置到了工具层。opencode 的文件读取不是「读进上下文再裁」,而是在源头就把输出限制死:
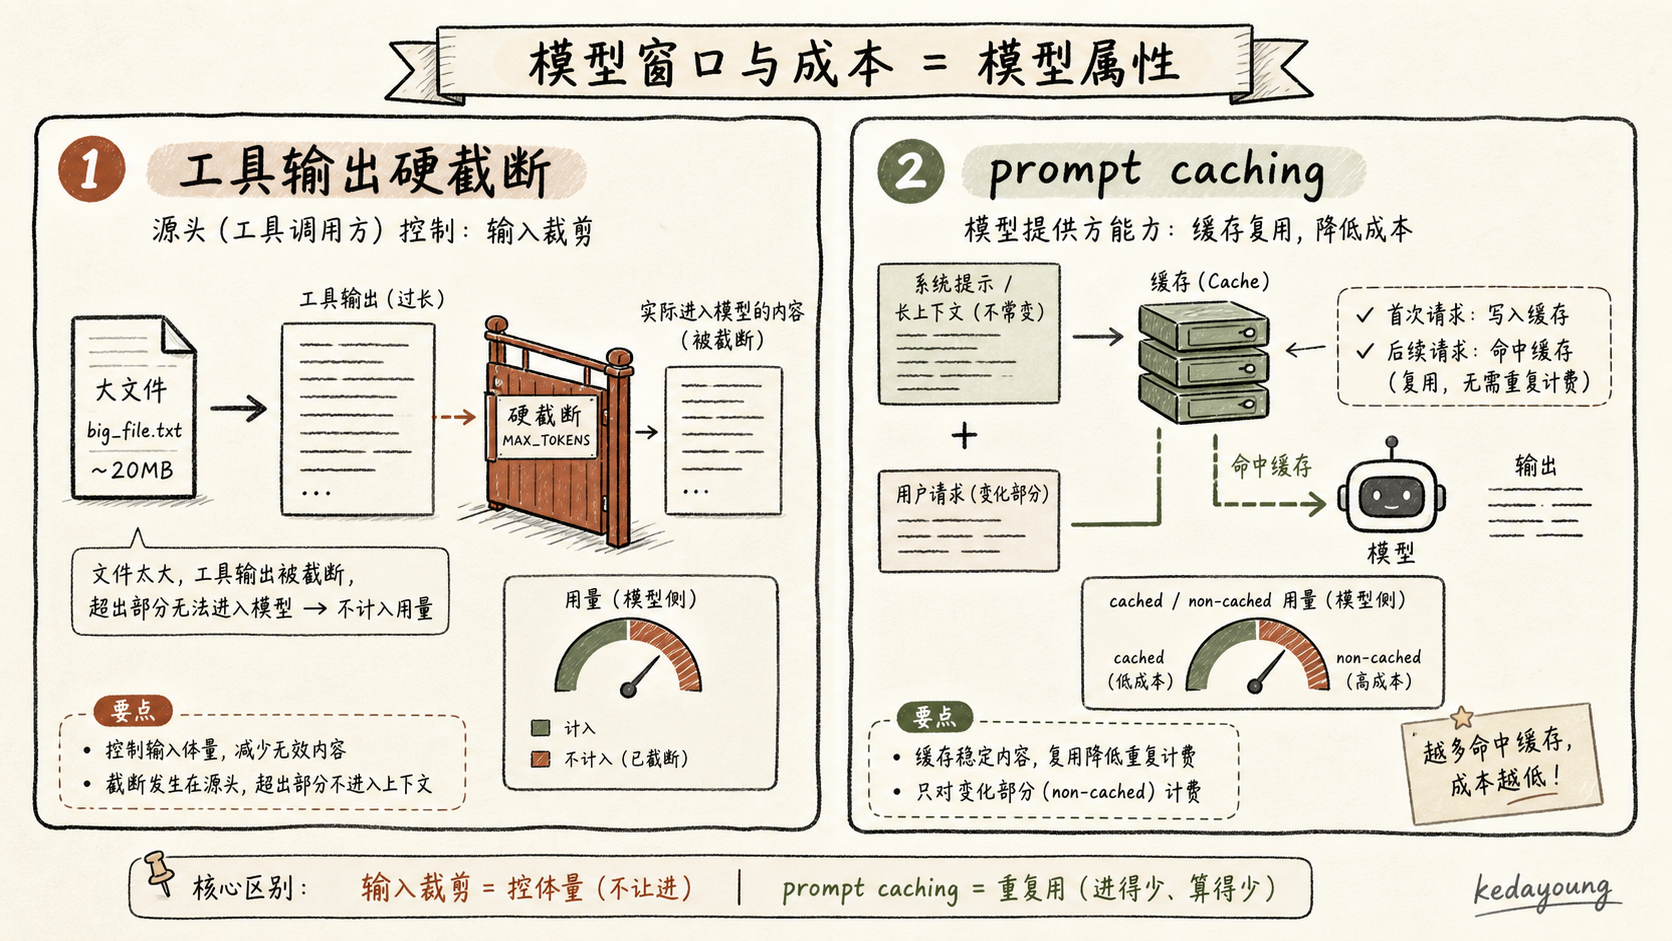
view(internal/llm/tools/view.go):常量区(:33-37)定义MaxReadSize = 250 * 1024(250KB 读取上限)、DefaultReadLimit = 2000(默认最多 2000 行)、MaxLineLength = 2000(单行超 2000 字符截断加省略号);执行逻辑在readTextFile(:224-272):for scanner.Scan() && len(lines) < limit(:253)行数封顶,len(lineText) > MaxLineLength时截断(:256-258)。bash(internal/llm/tools/bash.go):输出超过MaxOutputLength = 30000(bash.go:38)时,truncateOutput(:329-340)保留首尾各一半,中间提示... [N lines truncated] ...。ls(internal/llm/tools/ls.go):MaxLSFiles = 1000(:35),目录条目超过 1000 即截断(:110)。grep/glob(internal/llm/tools/grep.go、glob.go):匹配结果各限 100 条(grep.go:145、glob.go:46),超限标记truncated并提示模型「结果被截断、请缩小范围」(grep.go:172-173)。
这些限制写在工具实现里而不是组装层——模型拿到的工具输出「天生就是短的」。配合 1.1 节「文件内容靠工具按需拉取」,形成了完整的「源头截断」策略:上下文里永远只有模型主动要的东西,且每样东西都有硬上限。这是终端 agent 与 IDE agent 最根本的结构性差异之一:IDE 可以把整个文件树 / 选中代码作为「免费上下文」,终端 agent 必须用工具调用去换每一块内容。
4.5 设计含义:与 pi 的切点保护对照
一个值得追问的问题:opencode 的截断是否保护「工具调用-结果」配对?核对源码后的答案是:不显式保护,但靠触发时机隐式保证。
agent.go:255-267 的截断是纯按消息 ID 切,没有任何「检查截断点前后是不是配对的 tool call / tool result」的逻辑——与 pi 的 findCutPoint 显式声明 "Never cut at tool results (they must follow their tool call)"(20260810-pi/outline.md 第 6 节,compaction.ts:403+)形成对比。opencode 之所以不需要这条规则,是因为摘要总是在一次完整响应结束后触发:AutoCompact 挂在 AgentEventTypeResponse 的 Done 分支(tui.go:335),此时每一轮「assistant 发起调用 → tool 返回结果」都已闭合,消息流里不存在悬空的 tool call。而截断点是摘要消息本身——纯文本 + Finish{end_turn},其后是新一轮完整对话。工具配对完整性由「摘要点必然落在完整回合边界」保证,而不是由截断逻辑保证。
一句话概括 opencode 的压缩哲学:pi 把「该在哪切」当作一等设计约束去精细求解;opencode 把「什么时候切」交给触发时机,切的时候只做一刀。前者更可控,后者更简单、更可审计——代价是如果用户手动在奇怪时机触发 Summarize(或未来引入流式中断),配对保护将不存在。
5. 成本控制:prompt caching 与用量追踪
5.1 不做 token 裁剪,成本怎么控制?
第 3 节说 opencode 不做输入侧 token 裁剪,那长会话的高昂输入成本怎么办?答案是把问题外包给 provider 的缓存机制,而不是自己本地裁剪。Anthropic 的 prompt caching 是 opencode 的主要成本杠杆,在 anthropic.go 三处标记 cache control:
- system(
preparedMessages,:187-193):系统提示常驻缓存,每次请求命中。 - tools(
convertTools,:135-139):最后一个工具定义打上 cache control——工具定义在长会话里逐次请求完全不变,是缓存命中率最高的前缀。 - 末尾 3 条消息(
convertMessages,:62-72):if i > len(messages)-3 { cache = true },user 文本(:69-73)和 assistant 文本(:87-91)都标记。
为什么是「末尾 3 条」?Anthropic 的缓存是前缀命中:请求中从开头到各 cache_control breakpoint 的序列与上次一致即命中。在 system、tools、末尾 3 条消息三处置 breakpoint,等于把「稳定前缀」(system + tools + 历史前段)与「易变尾部」(最近 3 条 + 本次输入)划开:长上下文的重复前缀被缓存,每次请求只需为增量部分付费。disableCache 配置可整体关闭(:69、:135)。
注意这套策略的适用范围:Anthropic 专属(OpenAI 侧 usage 解析甚至把 CacheCreationTokens 硬编码为 0,openai.go:384-394,注释 "OpenAI doesn't provide this directly")。这是「把成本问题交给 provider 缓存」的代价——provider 能力决定成本策略的上限。
5.2 用量追踪:按缓存/非缓存单价拆分
缓存参与成本核算,意味着用量统计必须区分「缓存读写」和「普通输入输出」。TrackUsage(agent.go:494-514)把 provider 返回的 TokenUsage 按四种单价折算成成本(:500-503):
cost := model.CostPer1MInCached/1e6*float64(usage.CacheCreationTokens) +
    model.CostPer1MOutCached/1e6*float64(usage.CacheReadTokens) +
    model.CostPer1MIn/1e6*float64(usage.InputTokens) +
    model.CostPer1MOut/1e6*float64(usage.OutputTokens)
并累进 session(:505-509):sess.Cost += cost;CompletionTokens = OutputTokens + CacheReadTokens;PromptTokens = InputTokens + CacheCreationTokens;随后 sessions.Save。
「缓存写」算进 PromptTokens、「缓存读」算进 CompletionTokens,贴合各家 API 的计费口径(缓存读按输出侧缓存单价 CostPer1MOutCached 折算,agent.go:500-503)。但注意这个拆分与 AutoCompact 的触发口径(第 4.3 节)有一个粗糙的耦合:阈值判断是 CompletionTokens + PromptTokens 之和(tui.go:338),缓存读计入 CompletionTokens 会同样推动总和逼近 95%——缓存命中率高的长会话反而可能更快触发压缩,尽管缓存读并不增加上下文体积;真正的「里程表清零」发生在 Summarize 重置计数(agent.go:674-675)。
usage 解析在各 provider 完成:Anthropic 区分 CacheCreationInputTokens / CacheReadInputTokens(anthropic.go:443-450);OpenAI 只给 CachedTokens(openai.go:384-394)。
5.3 模型元数据:窗口/成本是模型属性
不同模型能装多少、默认输出多少、能不能推理、缓存单价多少——这些是模型属性,存在 internal/llm/models/models.go:10-23 的 Model 结构体里:
type Model struct {
    ID                  ModelID
    Name                string
    Provider            ModelProvider
    APIModel            string
    CostPer1MIn         float64
    CostPer1MOut        float64
    CostPer1MInCached   float64
    CostPer1MOutCached  float64
    ContextWindow       int64
    DefaultMaxTokens    int64
    CanReason           bool
    SupportsAttachments bool
}
具体模型在 internal/llm/models/anthropic.go 定义(如 Claude35Sonnet,:18-30:ContextWindow: 200000、DefaultMaxTokens: 5000、四档单价)。AutoCompact 的 95% 阈值、maxTokens 的 ContextWindow/2 钳制、TrackUsage 的单价折算——三处机制读的都是当前模型的元数据,而不是全局常量。窗口与成本随模型走,机制本身不写死任何数字(唯一的例外是 AutoCompact 的 0.95 比例,硬编码在 tui.go:339)。
5.4 设计含义:缓存优于裁剪
opencode 把「成本优化」从「压缩上下文」移到了「缓存前缀」:对长会话,缓存比裁剪更划算且不丢信息——裁剪是永久丢失,缓存是「付一次前缀、重复命中」。这与 hello-agents 的本地启发式 token 估算(_count_tokens:中文 1 字符 ≈ 1 token、英文 1 词 ≈ 1.3,见 20260810-hello-agents 篇第九章:563-577)形成对照:hello-agents 靠本地估算决定何时压缩,opencode 靠 provider 返回的实报用量(usage)决定——实报意味着不需要维护估算器,也就少了一个「估算不准」的错误源;代价是依赖 provider 的用量统计口径(如 OpenAI 不报缓存写,成本核算就会低估缓存写开销)。
6. 与 pi / Continue 的对照与可迁移经验
6.1 三种「压缩/成本」策略对照
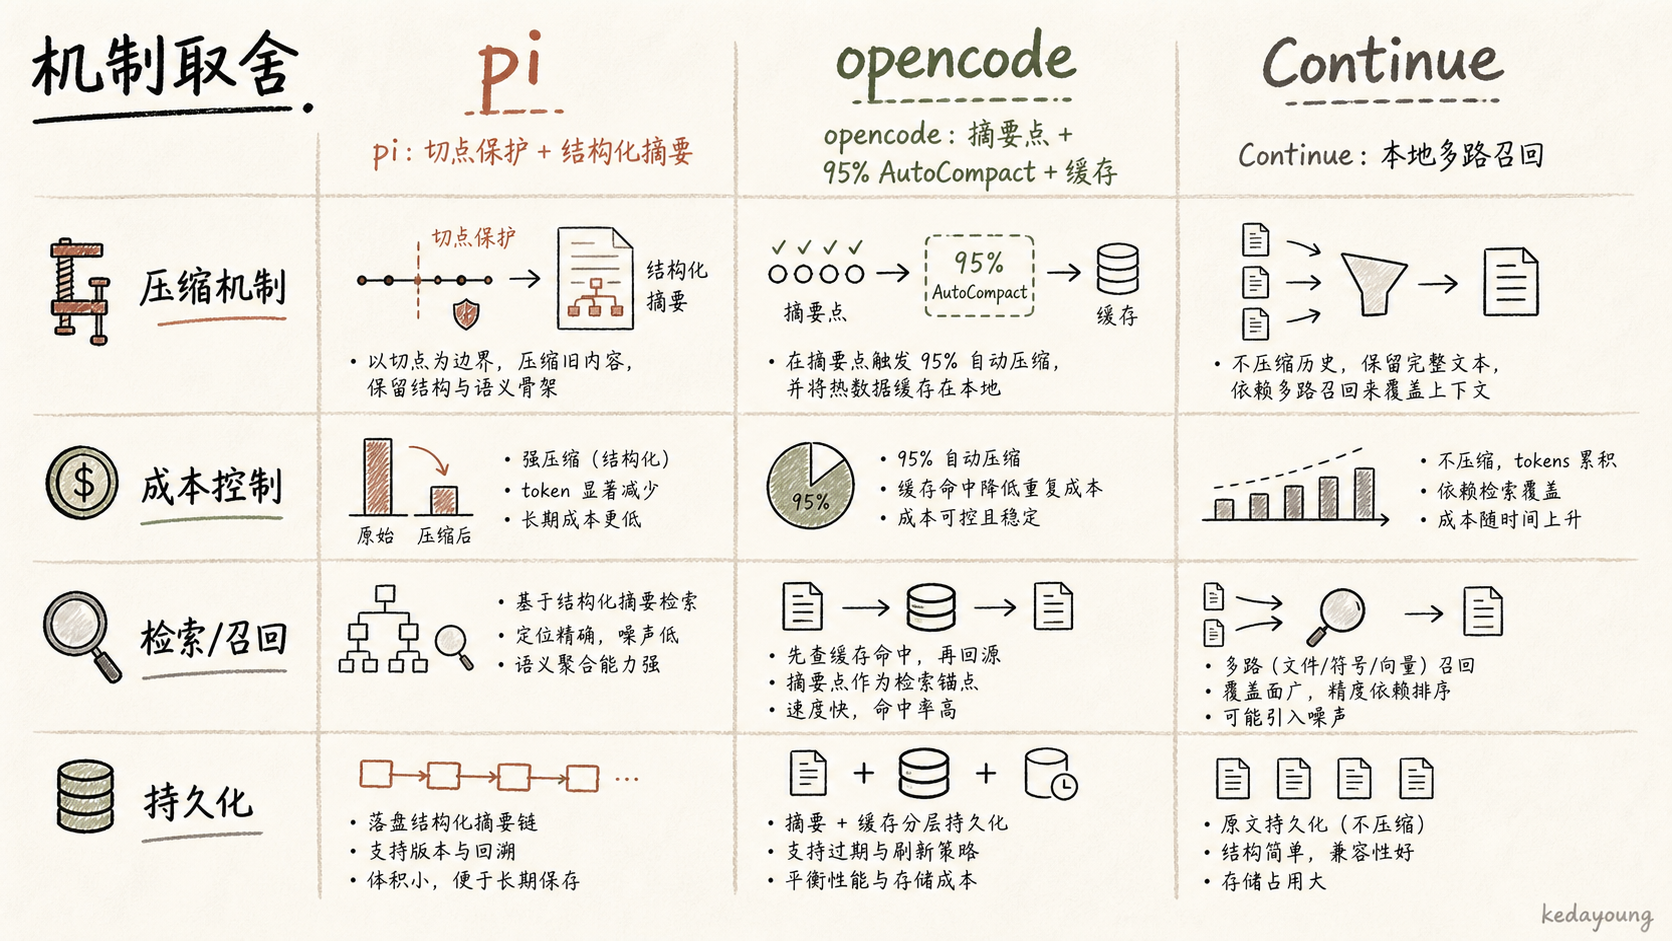
把 pi(20260810-pi/outline.md)、Continue(20260810-continue/outline.md)和 opencode 放在一张表里:
| 维度 | pi | Continue | opencode |
|---|---|---|---|
| 输入预算 | 精密(reserveTokens / keepRecentTokens,compaction.ts:128-135) | 预编译双阶段裁剪(countTokens.ts:422-551) | 无 token 级裁剪 |
| 压缩 | 自动摘要 + 切点保护(findCutPoint 绝不在 toolResult 处切) | 手动摘要 + 头部裁剪(≥60% 提示用户) | 自动摘要(95% 阈值)+ 摘要点截断(不显式保护配对,靠触发时机) |
| 成本 | 估算 + usage 实报优先 | 缓存 + 预算 | prompt caching(Anthropic system/tools/末尾 3 条) |
| 工具输出 | 截断(50KB / 2000 行) | 检索预算(512 token/片段、25 片段上限) | 硬截断(view 2000 行 / bash 30KB / ls 1000 项 / grep/glob 100 条) |
| 场景 | 后台自动化 | IDE 会话 | 终端会话 |
三个最尖锐的差异点:
- 裁剪 vs 摘要:pi 和 opencode 都做「摘要替代」,但 pi 把「在哪切」当一等约束(切点保护),opencode 用「触发时机」隐式保证;Continue 则干脆把决定权交给用户。摘要替代是 pi / Continue / opencode 三家的共识,与 hello-agents 的「分区截断、保结构不保语义」形成根本分歧——保语义是这三条路线的共同底色。
- 预算 vs 无预算:pi 有精密预算和提前压缩线(
shouldCompact在触碰窗口前触发);opencode 只有 95% 一条触发线、没有保留区概念。窗口利用率和信息保真度 pi 更优、机制数量与可审计性 opencode 更优——这是作者判断,不是源码结论。 - 成本策略的归属:pi 自己估算成本(
usage实报优先),opencode 把成本杠杆完全交给 provider 缓存——谁的 provider 生态强,谁就能用缓存换简单。
6.2 可迁移模式(作者判断,非源码结论)
从 opencode 可以带走的五条经验:
- 消息/成本存进持久化模型:session 带 token/cost/SummaryMessageID 字段(
session.go:12-23)——压缩触发(95% 阈值)与成本核算(TrackUsage)都有数据依据,机制之间通过数据而非全局变量耦合。 - 摘要专用代理:summarizer 独立 provider、独立提示词(
agent.go:73-97、prompt/summarizer.go)——主代理不被「如何总结自己」污染,压缩质量可单独调优、单独计费。 - 摘要点截断重放而非全文重放:
SummaryMessageID+msgs[summaryMsgInex:]+ 首条改 user(agent.go:255-267)——压缩后历史可继续,且「摘要文本以 user 角色开头」绕开了所有 provider 的角色约束,零特判。 - 工具输出源头硬截断 + 文件按需拉取:「文件内容不进上下文」是终端 agent 的高性价比选择(第 4.4 节的 view / bash / ls / grep / glob)——把「上下文体积」问题前置到工具层,组装层就永远不需要裁剪。
- prompt caching 替代本地裁剪:长上下文场景,缓存前缀优于裁剪内容(
anthropic.go三处 cache control)——不丢信息、重复命中,但依赖 provider 能力,多 provider 时要有退化路径(OpenAI 的缓存写字段缺失即是一例)。
6.3 系列定位与收束
0-context-engineering 主题已有五条路线:hello-agents(教学派:GSSC 流水线)、pi(精密派:预算 + 切点保护)、Continue(IDE 插件派:可插拔上下文 + 人机协同压缩)、Context7(托管协议派)、以及本文的 opencode——终端 agent 的简单显式派。
收束中心论点:opencode 证明「上下文规模控制」不一定要精密的 token 预算——摘要 + 截断 + 缓存三件套在终端场景足够有效,机制更少、更可审计:上下文只有一条组装路径(全量或摘要点截断),压缩只有一种触发方式(95% 或手动),成本优化完全交给缓存;代价是窗口利用率与信息保真度不如精密方案(pi 的保留区、切点保护),缓存依赖 provider 生态。「少机制」本身是一种设计选择——当你能把问题简化为「摘要 + 截断 + 缓存」时,复杂预算带来的边际收益可能配不上它引入的审计成本。这恰恰是终端 agent 场景的答案:没有 IDE 的现成上下文,就让每一块进上下文的字节都是显式、可审计、有上限的。
附录 A:证据清单(已逐条核对)
| 断言 | 证据位置(0-context-engineering/20260810-opencode/repo/) | 核对结果 |
|---|---|---|
| 多代理架构(AgentName 常量 + agent 持有 provider/title/summarize) | internal/config/config.go:37-51、internal/llm/agent/agent.go:59-97 | ✅ |
| 项目上下文默认文件列表(11 项,不含 AGENTS.md) | internal/config/config.go:108-120(defaultContextPaths) | ✅ |
| SQLite 连接与 pragma(WAL) | internal/db/connect.go:26-46 | ✅ |
| 表结构:sessions 用量字段 / messages parts JSON / 触发器 | internal/db/migrations/20250424200609_initial.sql:4-14,47-57,68-82 | ✅ |
| 消息模型与类型化 parts | internal/message/content.go:11-119 | ✅ |
| parts 序列化 / 全量加载 / 会话恢复 | internal/message/message.go:57-83,132-145,180-281、internal/tui/components/chat/list.go:441-460 | ✅ |
| 子会话隔离 | internal/session/session.go:54-66、internal/llm/agent/agent-tool.go:57-90 | ✅ |
| 组装与摘要点截断 | internal/llm/agent/agent.go:198-311(:255-267 摘要截断) | ✅ |
| provider 转换与缓存 | internal/llm/provider/anthropic.go:60-196、openai.go:68-121、gemini.go:53-133 | ✅ |
| 系统提示与项目上下文注入 | internal/llm/prompt/prompt.go:15-39,46-136、internal/config/config.go:108-120 | ✅(提示词文案在 prompt/coder.go 等四文件) |
| Summarize 与摘要消息写回原 session | internal/llm/agent/agent.go:535-704(:652-673 摘要落库、:674-675 计数重置) | ✅ |
| AutoCompact 95% 阈值 | internal/tui/tui.go:335-341(:339 tokens >= 0.95*ContextWindow && AutoCompact) | ✅ |
| 工具输出硬截断 | internal/llm/tools/view.go:33-37,224-272、bash.go:38,329-340、ls.go:33-35,110、grep.go:145,199-204、glob.go:46 | ✅(执行逻辑在 view.go:224-272,非 :33-67;grep/glob 各限 100 条) |
| maxTokens 校验与钳制 | internal/config/config.go:536-563(4096 为二级回退,优先 DefaultMaxTokens) | ✅ |
| 用量追踪与成本核算 | internal/llm/agent/agent.go:494-514、anthropic.go:443-450、openai.go:384-394 | ✅(OpenAI 缓存写恒为 0) |
| 模型元数据 | internal/llm/models/models.go:10-23、internal/llm/models/anthropic.go:18-30 | ✅ |
附录 B:素材缺口与待办(初稿阶段更新)
- [x] 核对 AutoCompact 95% 阈值的确切行号与表达式——确认
tui.go:335-341,表达式(tokens >= int64(float64(contextWindow)*0.95)) && config.Get().AutoCompact,触发于AgentEventTypeResponseDone 分支。 - [x] 确认 Summarize 截断是否保护「工具调用-结果」配对——不显式保护(
agent.go:255-267纯按消息 ID 切,无配对检查);由触发时机(AutoCompact 挂在响应完成之后、摘要消息为纯文本 + end_turn)隐式保证截断点落在完整回合边界。文中已如实标注(4.5 节)。 - [x] 核对工具输出截断常量与执行位置——
view.go常量在 :33-37,执行逻辑在readTextFile:224-272;bash.goMaxOutputLength=30000;ls.goMaxLSFiles=1000。 - [x] 核对项目上下文文件列表——实际 11 项(含
*.local.md与大小写变体),不含 AGENTS.md;大纲原列 7 项,已按源码补全。 - [x] 核对 Summarize 落库位置——摘要消息写回原 session(非新 session),并重置
PromptTokens=0、CompletionTokens=输出 token(影响 AutoCompact 续触发)。 - [ ] 待裁决:
README.md:97标注"autoCompact": true // default is true,与源码不一致(config.go:96无默认赋值,Go 零值 false)——定稿前需确认是改文档还是改代码。 - [ ] 待补充:
defaultContextPaths注入的优先级/去重细节若需展开,可引用prompt.go:46-136的processContextPaths(并发读取 + 大小写不敏感去重)。 - [x] 全文图 1–6 已替换为正式 PNG 图示。
- [ ] 不实际运行 opencode(需模型 key);机制描述以源码为准。