中心论点:pi 用六个机制管理上下文(短系统提示与渐进披露、层级项目上下文、消息双轨、预算触发、切点保护的结构化摘要、工具输出截断),把压缩从「兜底补救」变成「设计内的一等机制」——不追求把信息组织得更漂亮,而是让超限时刻可预测、可审计、可恢复。 证据说明:文中「pi」指
earendil-works/pi项目,证据一律引用本地源码克隆20260803-pi-java-workflow/tmp/pi/(版本 v0.84.1,git log最近提交53fa77c,Release v0.84.1);引用时注明「截至 v0.84.1」。与 hello-agents 的对照引用0-context-engineering/20260810-hello-agents/第九章与code/chapter9/。所有file:line以本地克隆当前内容为准;所有数字(token 预算、阈值、截断限制)均为 v0.84.1 源码中的默认值。
1. pi 上下文工程全景:生产 agent 如何管理「什么进入模型」
pi 是一个极简的 terminal coding harness:支持多 Provider、可通过扩展定制、以 read / bash / edit / write 四个内置工具为核心,定位是「在终端里用自然语言驱动一个 coding agent」(项目定位细节本文不展开)。它的上下文工程与 hello-agents 回答的是同一个问题——推理发生时哪些信息进入模型、以什么形态、占多少预算——但答案的组织方式完全不同。
hello-agents 的答案是「一条流水线 + 三个工具」:ContextBuilder 统一负责每轮推理前的上下文拼装(Gather-Select-Structure-Compress),NoteTool / TerminalTool / MemoryTool 作为信息源与出口。pi 没有这样的统一入口。它的上下文管理散落在六个机制里,按「信息进入 → 信息流动 → 超限处理」的生命周期组织:
- 短系统提示 + 渐进披露(
system-prompt.ts、skills.ts):系统提示保持短小,文档与技能全文不内联,只给路径与摘要,模型按需读取; - 层级项目上下文加载(
resource-loader.ts):从全局目录到当前目录逐层收集 AGENTS.md 一族文件,注入系统提示; - 消息双轨制(
agent-loop.ts:290-295):内部维护带角色语义的AgentMessage,每轮推理前转换成 LLM 协议内的Message; - token 预算与压缩触发(
compaction.ts、agent-session.ts):用硬性预算常量判断「该压缩了」,并自动执行; - 切点保护 + 结构化摘要(
compaction.ts:403-461、:467-537):压缩时只允许在安全切点截断历史,把被截掉的部分折叠成结构化 checkpoint 摘要; - 工具输出截断(
truncate.ts):工具输出在进入会话历史之前先被限长。
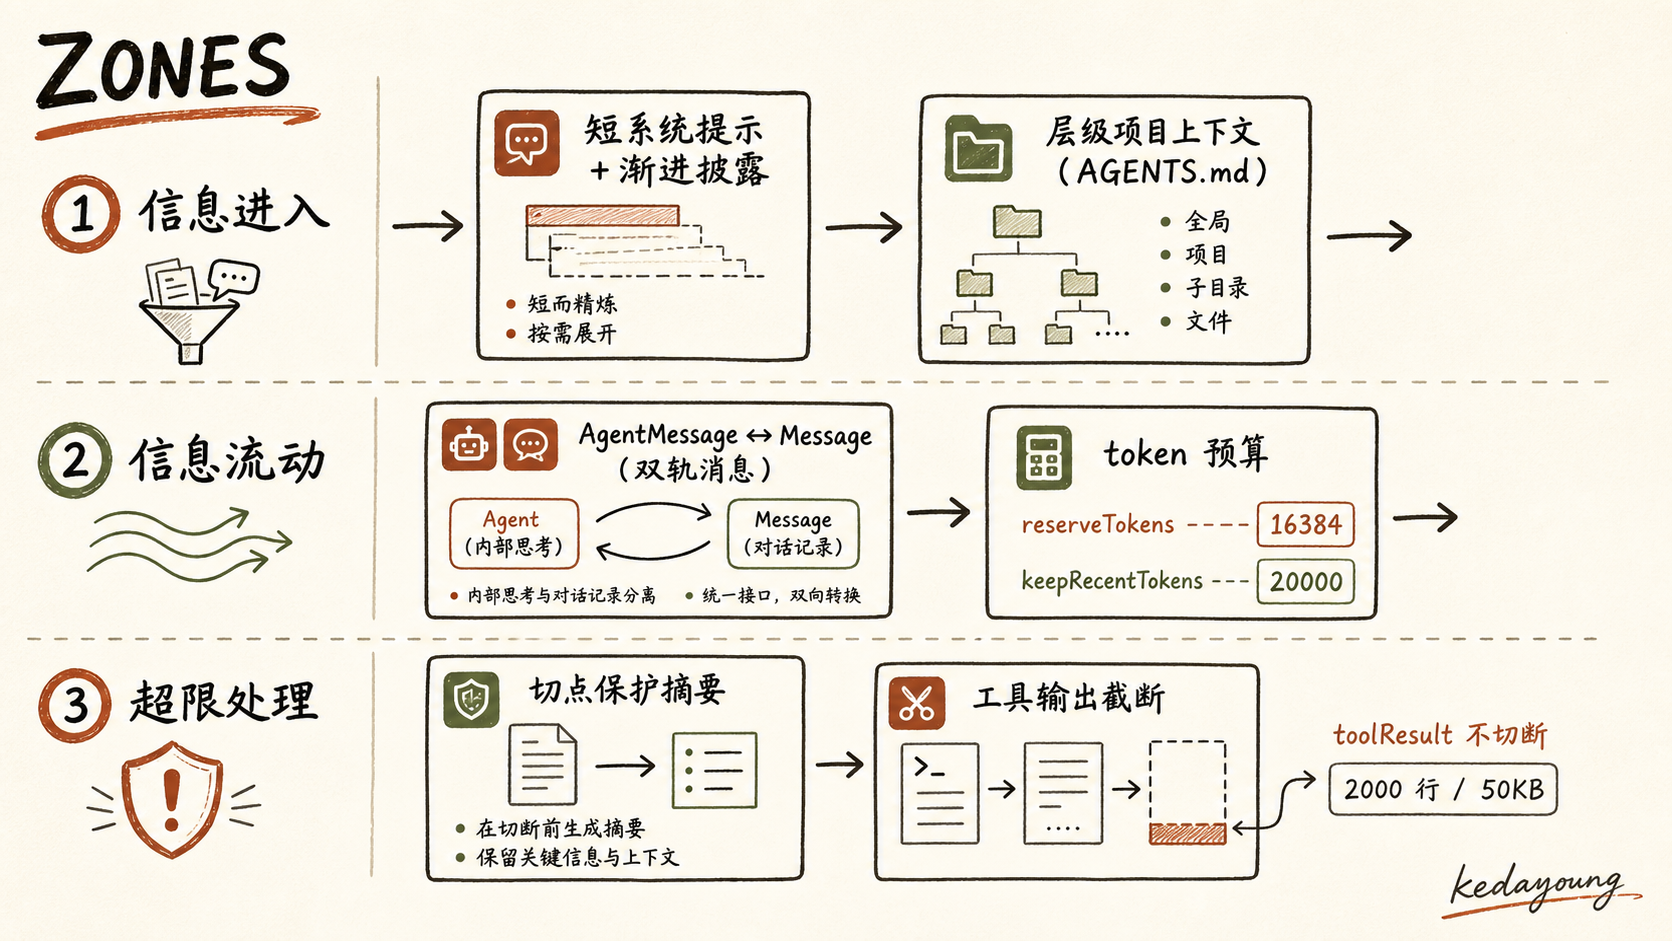
图 1|pi 上下文工程六机制全景图。按「信息进入 → 流动 → 超限」排列,标注每个机制的源码位置。与 hello-agents 篇图 1(概念→组件映射)形成对照:一个按功能组件分,一个按生命周期阶段分。
与 hello-agents 的「一条流水线 + 三个工具」相比,这个结构差异不是风格偏好,而是「生产」二字加进来的新约束。hello-agents 是教学实现,它的上下文在单进程、单线程、可控的演示时长里运行;pi 是真实产品,会话必须能在不可控的长时间运行中保持可用——长会话、分支、中断后恢复都是常态。于是 pi 的上下文工程重点不是「构建更好的上下文」,而是超限时刻如何优雅降级,且不破坏工具调用-结果的配对。
因此,全文的判断可以提前给出:hello-agents 展示「全貌与可读性」,pi 展示「在真实产品约束下同一问题被再次工程化」。对 pi 而言,上下文工程的成败不在「把信息组织得多漂亮」,而在超限时刻的三个属性——可预测、可审计、可恢复:硬性 token 预算(reserveTokens / keepRecentTokens)把触发时点变成可预期的常数;绝不在工具结果处切断的切点规则保证降级不破坏工具调用-结果的配对;保留关键事实的结构化摘要让被折叠的历史仍可追溯。把上下文压缩从「兜底补救」变成「设计内的一等机制」,是这套设计的共同指向。两篇合起来,才是「上下文工程落地」的完整答案。
2. 短系统提示与渐进披露:上下文预算的第一道闸门
pi 的系统提示由 buildSystemPrompt(system-prompt.ts:28)构建。它的组成可以拆成五块:
- 可用工具清单:按工具给出一行 snippet,只有调用方提供了 snippet 的工具才会出现在列表里(:79-84,默认
read / bash / edit / write); - guidelines:基于可用工具生成的少量行为约束,外加两条固定准则「回答要简洁」「处理文件时清晰展示路径」(:115-119);
- 角色定位:一句话说明「你是运行在 pi 里的 coding assistant」(:121);
- pi 文档路径:
Main documentation、Additional docs、Examples三个路径,以及「什么时候该读哪份文档」的指引(:131-138)——注意,这里是路径,不是文档内容; <project_context>:项目上下文文件内容(:146-151,细节见第 3 节),以及 skills 摘要和 cwd。
关键设计分为「按需」与「常驻」两块。按需这一块是:文档与技能内容不进入系统提示,只给路径/摘要。系统提示里写的是「当用户问 pi 自身、SDK、扩展、主题、skills 或 TUI 时,才读 pi 文档」(:131),并且「读 pi 文档时,完整地读 .md 文件,遵循其中的交叉引用」(:137-138)——模型需要时用 read 工具加载完整文档,而不是一开始就背着它们。常驻那一块是 <project_context>,下一节专门讲。
skills 的渐进披露走的是同样的路子。formatSkillsForPrompt(skills.ts:335)在系统提示里为每个 skill 输出一个 XML 块,只含三项:<name>、<description>、<location>(:352-354),并附一条指引「当任务匹配 skill 描述时,用 read 工具加载 skill 的文件」(:344)。完整 SKILL.md 不内联;名字与描述还有规格上限(skills.ts:10-14:name 最长 64 字符、description 最长 1024 字符)——即使把全部 skill 的元数据列进系统提示,体积也受控,而 SKILL.md 全文始终按需读取。
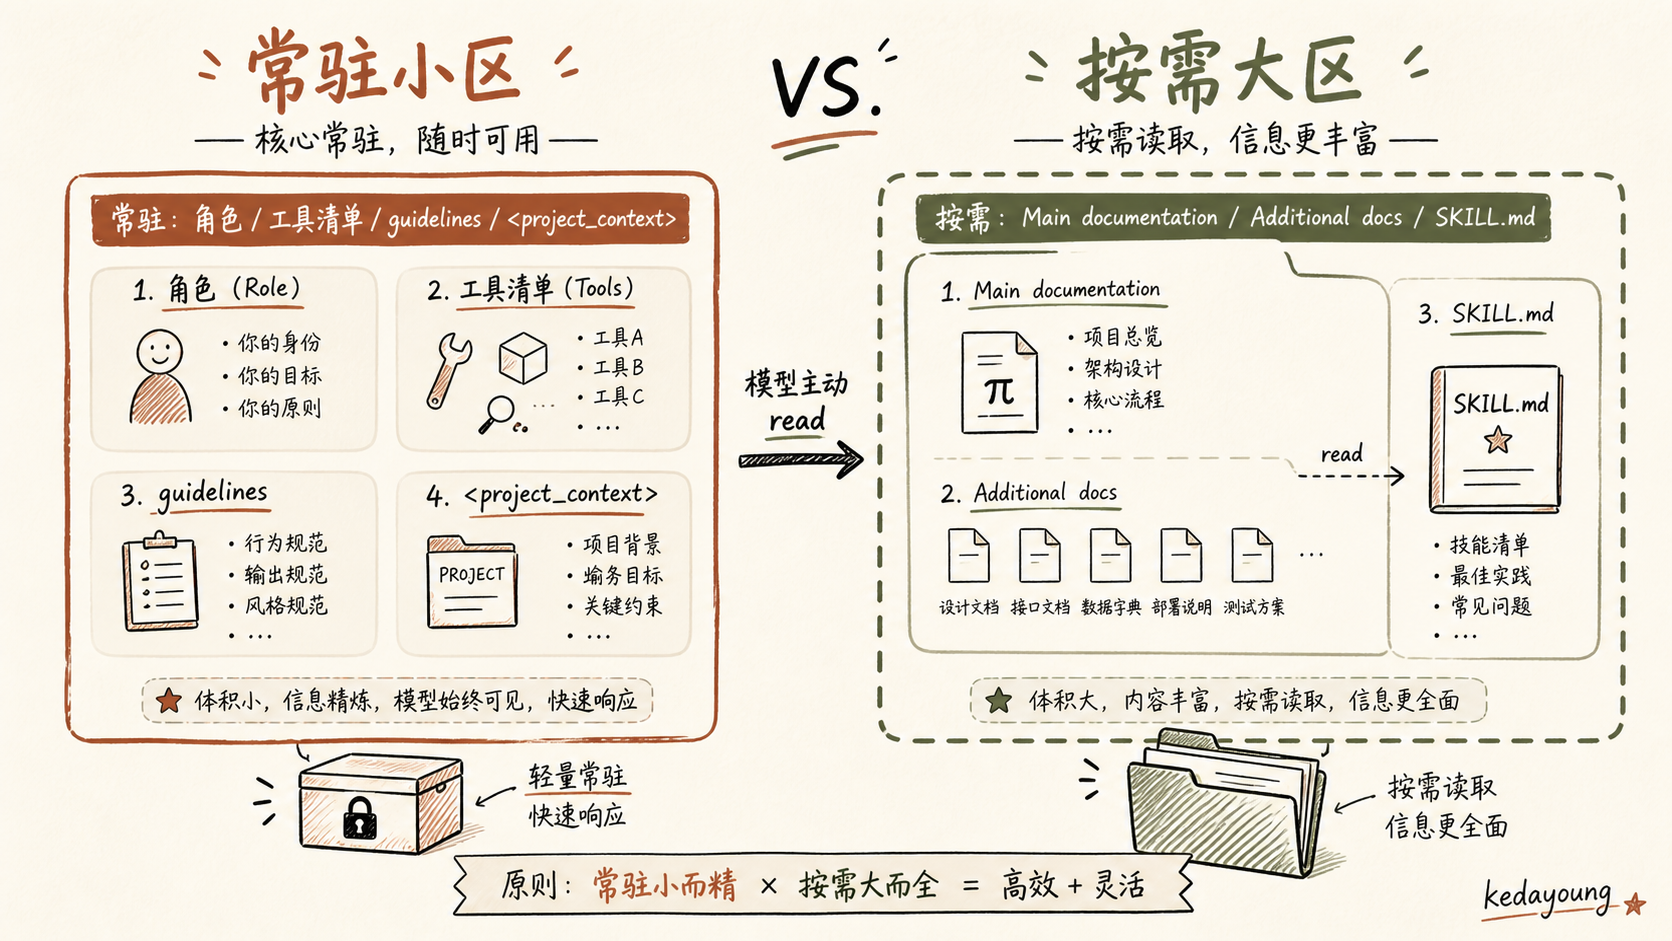
图 2|系统提示 = 常驻部分 + 按需部分。视觉要点:常驻部分小、按需部分大。
这个设计的收益很直接:启动即用的上下文预算被压到很小,长会话前期的「非任务信息」占用低——模型开局只带着「你是谁、有哪些工具、项目规则」,而不是整包文档。代价同样真实(作者判断):模型必须先「知道有」再「去读」,增加了发现与治理成本——如果系统提示里的描述写得不够精准,模型可能根本不会去读;同时,把可加载内容暴露给模型,也扩大了提示注入面——一个恶意的项目文件如果伪装成 skill 或文档,必须先骗过模型的「值不值得读」判断,才可能被读入;多了一条发现路径,就多了一面攻击面。
与 hello-agents 对照,这是两种策略的分歧点:hello-agents 把「系统指令」当作最高优先级常驻信息(第九章:246-254,relevance_score=1.0、不参与评分、始终保留);pi 则把「一切可再获取的信息」都推向按需。分歧的本质是「常驻 vs 渐进披露」的边界画在哪里——教学实现倾向于让关键信息永远在场,生产实现倾向于让一切可重取的信息只在需要时在场。
3. 项目上下文:层级 AGENTS.md 的加载
第 2 节说「文档按需读取」,但有一类项目信息是例外的:项目级约束。构建命令、代码规范、注意事项这些内容每轮都可能用到,如果也按需读取,模型每次都要先想「我该不该读」——这对生产 agent 太贵了。pi 的选择是:这类信息常驻注入,但只注入精心维护的短文件。
加载逻辑在 loadProjectContextFiles(resource-loader.ts:118)。候选文件按优先级依次查找:AGENTS.override.md > AGENTS.md > CLAUDE.md(:71 的完整数组为 ["AGENTS.override.md", "AGENTS.md", "AGENTS.MD", "CLAUDE.md", "CLAUDE.MD"],含大小写变体)。收集顺序分两段:
- 先从全局 agentDir 加载一份(:128-132)——这是用户级、跨项目的通用约束;
- 再从 cwd 逐层向上遍历到根目录,每层取优先级最高的那个文件(:137-151),用
seenPaths去重(同一目录多个候选只取一个,:143-146)。
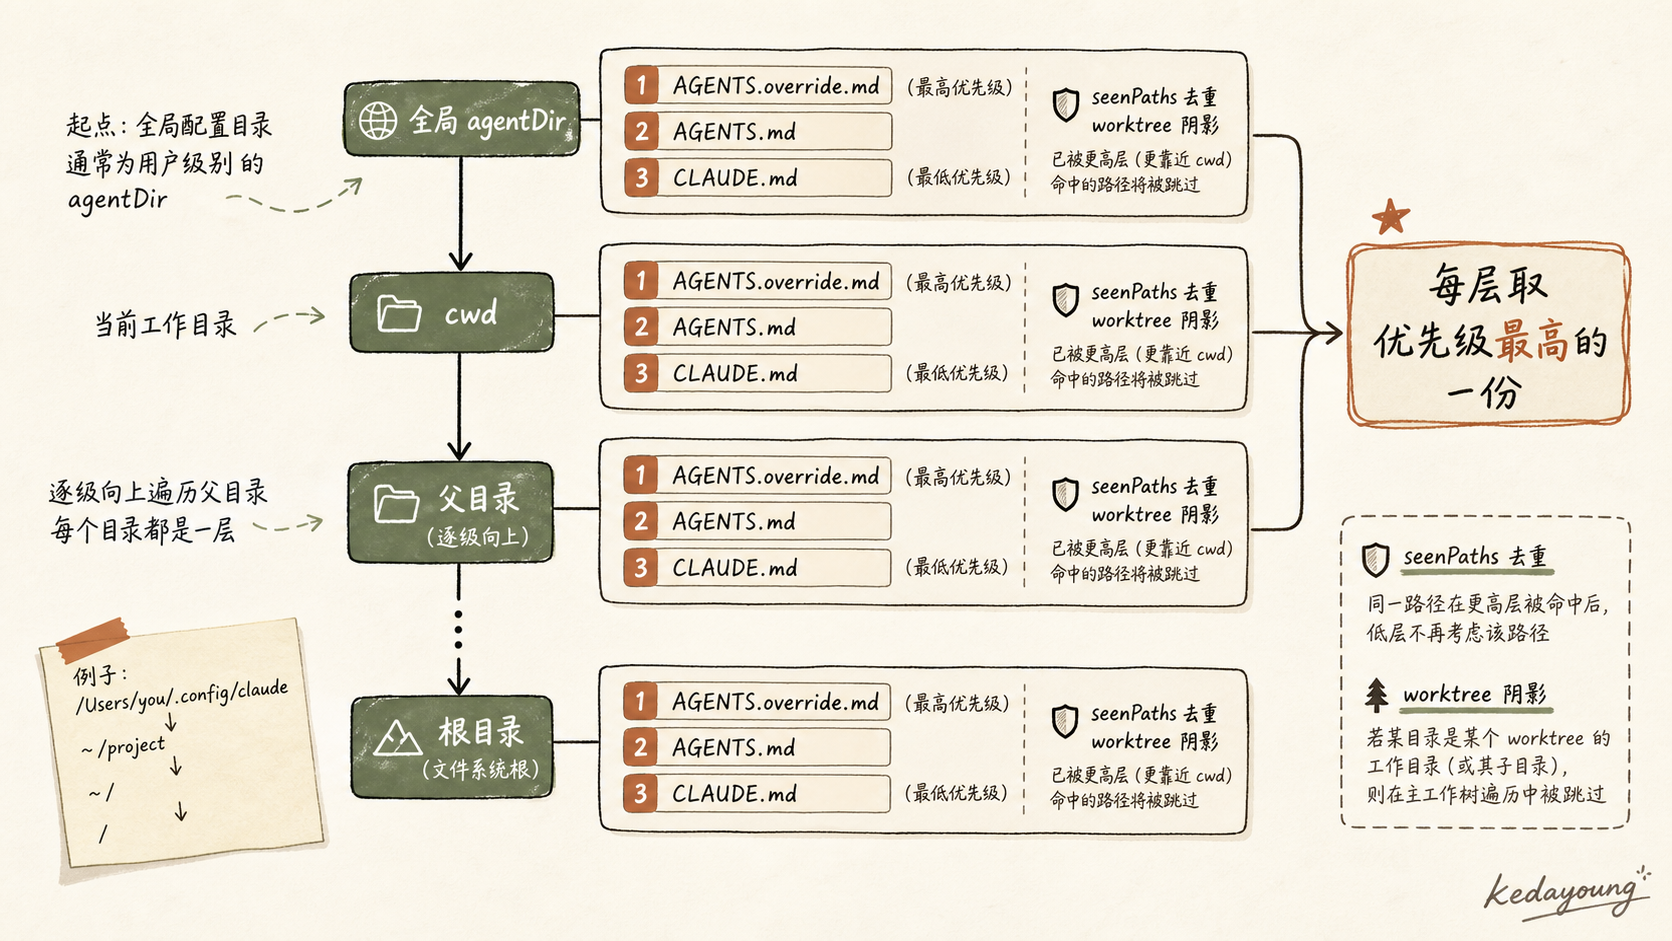
图 3|层级加载图:全局目录 + cwd 向上逐层,每层按候选优先级取一份,处理 worktree 阴影(同一目录多个候选去重)。
实现里还有一层细节:findShadowedContextFile(resource-loader.ts:100-116)专门处理 git worktree 阴影——当主仓库的一份上下文文件被子 worktree 自己的副本遮蔽时,两者属于同一个逻辑仓库作用域,加载两份等于把同一份约束注入两次,所以要去掉被阴影的那份。这是生产环境(真实 worktree 布局)才会遇到、教学实现根本不会考虑的问题。
加载结果以 <project_context> 标签整体注入系统提示(system-prompt.ts:146-151),随会话启动固定下来——截至 v0.84.1,系统提示在会话启动时构建,会话期间不会因新写入的 AGENTS.md 而重读。
设计含义值得单独说:这里出现了全文第一个可迁移的判断准则——稳定且高价值 → 常驻;体积大且低频 → 按需。项目级约束是「每轮都需要的稳定信息」,所以走常驻注入;pi 文档、SKILL.md 全文是「体积大且低频」,所以走按需读取。第 2 节与第 3 节不是两个孤立设计,而是同一条准则在两类信息上的不同应用。
对照 hello-agents:它的等价物是 NoteTool 中类型化笔记 + _retrieve_relevant_notes(codebase_maintainer.py:193-227,优先检索 blocker、再按查询搜索、合并去重)。但 hello-agents 走的是「检索注入」而非「全量常驻」——每轮按相关性把笔记翻出来。pi 对项目文件选择常驻,前提是 AGENTS.md 是作者精心维护的短文件;如果项目上下文膨胀到几万 token,「常驻」的成本就会超过「检索」。两种选择各自成立,取决于信息的体积与维护纪律。
4. 消息流水线:双轨制与转换
pi 内部维护着两套消息表示。第一套是内部 AgentMessage(携带角色语义),第二套是发给 LLM 的 Message。两套之间不能直接互相替代,这是理解 pi 上下文流动的关键。
内部消息除了标准的 user / assistant / toolResult 三种角色,还扩展了一组特殊角色(messages.ts:19-59):bashExecution(bash 命令执行,带 command / output / exitCode / truncated / fullOutputPath,messages.ts:19-29)、custom(自定义消息)、branchSummary(分支摘要)、compactionSummary(压缩摘要)。这些内部类型承载了丰富的语义——比如 bashExecution 知道「这是一次命令执行、退出码是多少、输出是否被截断、完整输出存在哪个文件」。
但 LLM 协议不认识这些角色。每轮推理前,流水线做两步转换(agent-loop.ts:288-295):
transformContext(:290-292):外部注入/裁剪钩子,可以改写整份消息列表(AgentMessage[] → AgentMessage[]);convertToLlm(:295):把内部消息转成 LLM 协议内的形态(AgentMessage[] → Message[])。
转换规则在 messages.ts:124-168,核心动作是降维:bashExecution、custom、branchSummary、compactionSummary 一律转成 user 角色消息,并带上前缀标签说明来源——分支摘要包在 <summary> 标签里、以「The following is a summary of a branch that this conversation came back from」开头(BRANCH_SUMMARY_PREFIX,:12-17);压缩摘要则用「The conversation history before this point was compacted into the following summary」(COMPACTION_SUMMARY_PREFIX,:4-10)。bashExecution 还会附带退出码、截断提示等信息(bashExecutionToText,:63-79)。
降维不是无代价的(作者判断):内部事件转成 user 消息后,「语义」扁平化为文本标签,模型靠前缀措辞理解来源——如果标签写得不清楚,模型可能把压缩摘要当成普通用户发言。
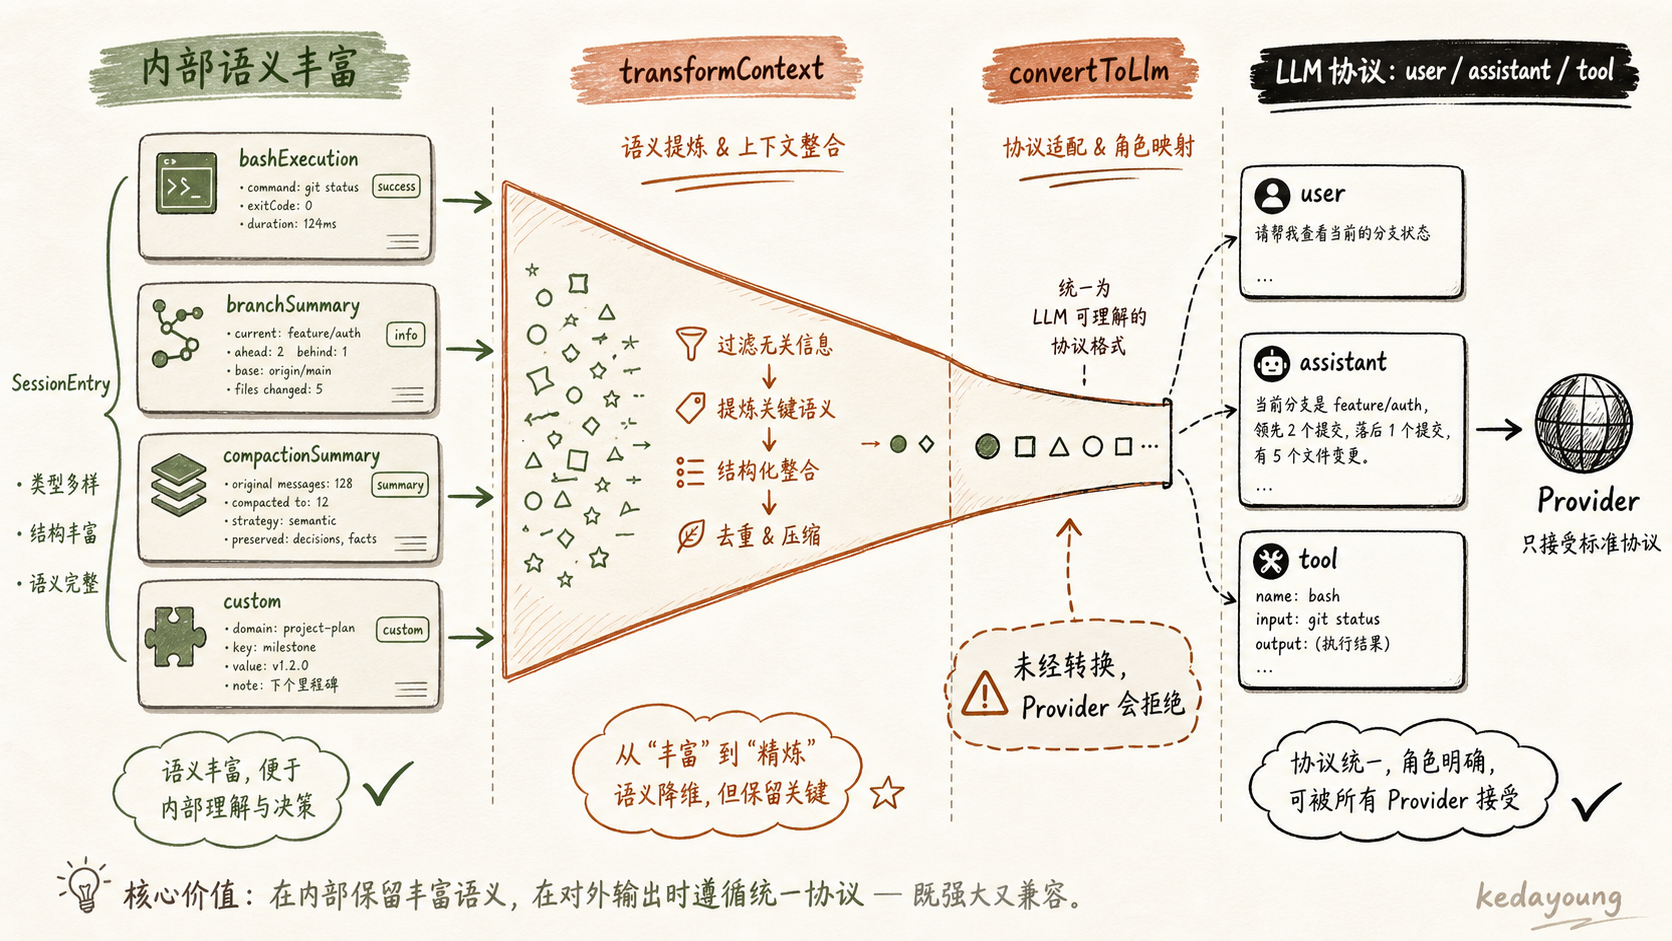
图 4|双轨转换流程:内部消息 → transformContext → convertToLlm → 三类角色消息 → Provider。
这个设计把「内部怎么记」和「外部怎么发」彻底解耦。内部可以积累任意复杂的事件类型,而 LLM 侧永远只看到稳定的 user / assistant / tool 三类角色——这是多 Provider 兼容的前提。agent-loop.ts:60-62 的注释点明了这条约束的严肃性:agentLoopContinue 要求「context 里的最后一条消息必须能通过 convertToLlm 转成 user 或 toolResult 消息,否则 LLM provider 会拒绝请求」。也就是说,未经 convertToLlm 的形态根本过不了 Provider 那一关,双轨不是可选项,是协议边界。
对照 hello-agents:它直接把 context_builder.build() 的结果赋给 agent.system_prompt(codebase_maintainer.py:137),没有双轨——内部消息与外部消息是同一份。差异根源是场景:hello-agents 是教学单线程(一种 Provider、一种事件类型),pi 是多 Provider、多事件类型(bash 执行、分支、压缩都是需要进入对话流的「事件」而非「对话」)。当 Agent 的事件种类变多,双轨转换几乎是必然的架构选择。
5. Token 预算与压缩触发:何时承认「装不下了」
第 4 节讲的是消息怎么流动,第 5–6 节讲的是窗口快满时怎么办。pi 的第一步是定义预算,第二步是定义触发,第三步是自动执行。
预算常量(compaction.ts:132-136,截至 v0.84.1):
| 常量 | 默认值 | 含义 |
|---|---|---|
reserveTokens | 16384 | 为系统提示、工具定义等预留的固定预算 |
keepRecentTokens | 20000 | 压缩后保留的最近消息预算 |
| 上下文窗口 | 128000 | 默认窗口(provider-composer.ts:160,模型定义可覆盖) |
触发公式 shouldCompact(compaction.ts:235-238)只有一行判断:
contextTokens > contextWindow - reserveTokens即「当前 token 数超过窗口减去预留量」就触发压缩。含义很明确:宁可提前压缩,绝不让请求触碰窗口上限。reserveTokens 不是一块物理预留区,而是触发公式里的安全常数——它的数量级对应「系统提示 + 工具定义」这些每轮必带的固定开销;当上下文膨胀到 窗口 − 16384,继续加消息就可能撞到窗口,与其等 Provider 报溢出,不如主动压缩。
自动压缩检查 _checkCompaction(agent-session.ts:1962-2053)在每次 assistant 回复后运行,分两个 Case:
- Case 1:溢出/长度截断(:1988-2022)。当响应因上下文溢出(或可恢复的长度截断)失败时,先移除最后那条失败的 assistant 消息,压缩,然后自动重试一次(compact-and-retry)。注意被移除的只是 agent 状态里的消息,会话历史(JSONL)仍完整保留这条失败记录(源码注释:It remains in session history,:2015-2016)——压缩重试不破坏审计线索。如果重试后仍然溢出,就放弃,不再无限循环(
_overflowRecoveryAttempted守卫,:2001-2012)。 - Case 2:达到阈值(:2024-2052)。上下文超预算就自动压缩,不自动重试——模型刚完成了一次正常回复,用户手动继续即可。
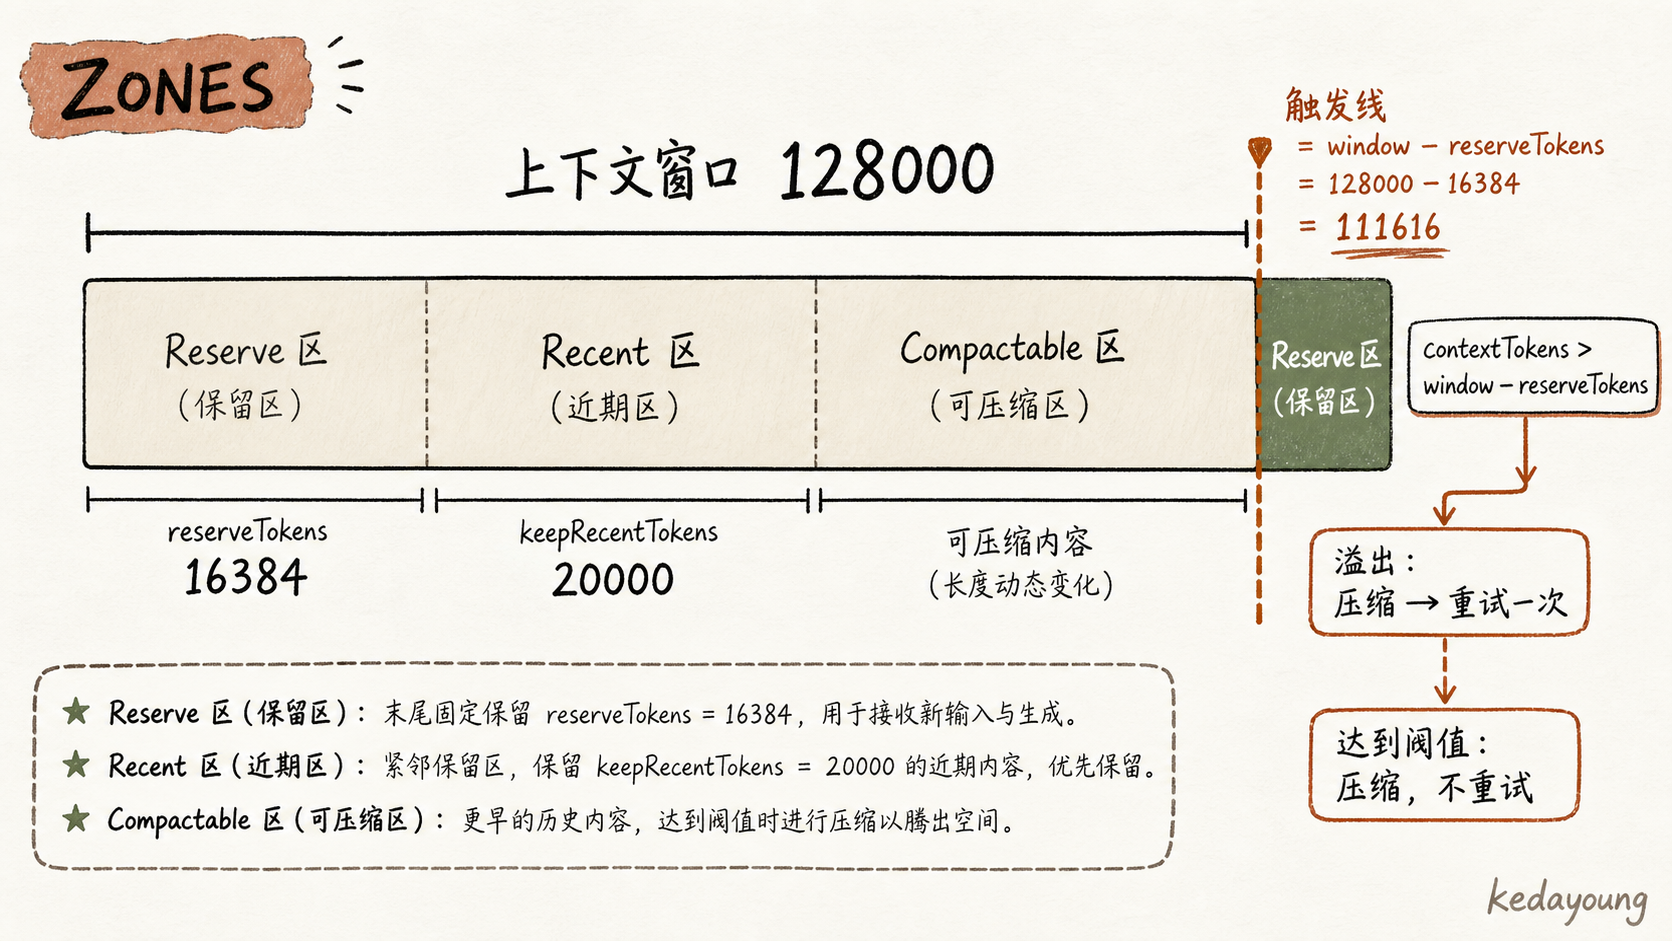
图 5|预算分配与触发图。压缩发生在触碰窗口之前;溢出路径上有一次「压缩后重试」的恢复机会。
防御细节值得单独列出(这正是「生产」二字的体现),_checkCompaction 一共做了三层防御:
- 跳过 aborted 请求(:1967):用户取消了就不该压缩;
- 跳过跨模型切换边界(:1971-1976):用户从 opus 切到 codex 时,旧模型的溢出错误不该触发新模型的压缩;
- 跳过压缩点之前的旧 usage(:1978-1986、:2034-2044):压缩刚完成时,历史里残留的旧 usage 数据会虚高,若用它判断会立刻再次触发压缩,所以凡是时间戳早于上次压缩边界的 usage 一律忽略。
token 估算是这套机制的信用基础。pi 的策略是「能用实报就不用估算」(compaction.ts:146-230、:246-306):
- 优先用 provider usage 实报:从消息列表里找最后一条有效的 assistant 消息,用它的
usage(totalTokens或各分量之和)作为上下文基数(calculateContextTokens:146-148、getLastAssistantUsage:172-181); - 其后消息用保守启发式:
estimateTokens按chars/4估算(:266-306),注释明确写着「This is conservative (overestimates tokens)」——宁可高估触发压缩,不可低估撞到窗口; - 图片按固定字符数估算:
ESTIMATED_IMAGE_CHARS = 4800(:244)。
对照 hello-agents:它的 _count_tokens 是纯本地启发式(中文 1 字符 ≈ 1 token、英文 1 词 ≈ 1.3,第九章:563-577),压缩触发靠配置的 max_tokens 上限兜底;pi 则把「估算准确性」当成预算机制可信度的前提——估算偏了,shouldCompact 的判断就偏了,压缩就不可预测。而且 pi 的压缩触发是自动的、主动的(assistant 回复后自动检查、自动执行),不是请求被拒后的兜底。从「被动兜底」到「主动预算」,是教学实现与生产实现的分水岭之一。
6. 压缩切点与结构化摘要:如何不破坏工具调用的完整性
压缩的核心难题不是「怎么总结」,而是从哪里切。pi 的回答是一条硬规则:绝不在工具结果处切。
切点选择由 findCutPoint 完成(compaction.ts:403-461)。算法:从最新消息往回累计估计 token 数,累计超过 keepRecentTokens(20000)预算时停下来,在最近的合法切点处切断——保留的正是最接近 keepRecentTokens 预算的那一段最近历史。什么算合法切点?findValidCutPoints(:351-363)只允许在「user 或 assistant 消息」处切,绝不在 toolResult 处切——源码注释原话是「Never cut at tool results (they must follow their tool call)」(:347)。注释紧接着解释原因:当我们在带工具调用的 assistant 消息处切,它的工具结果会跟在其后被保留(:348-349)。也就是说,切点保证「工具调用-结果」永远配对出现,模型不会看到一次没有结果的工具调用,也就不会产生幻觉或重复执行。
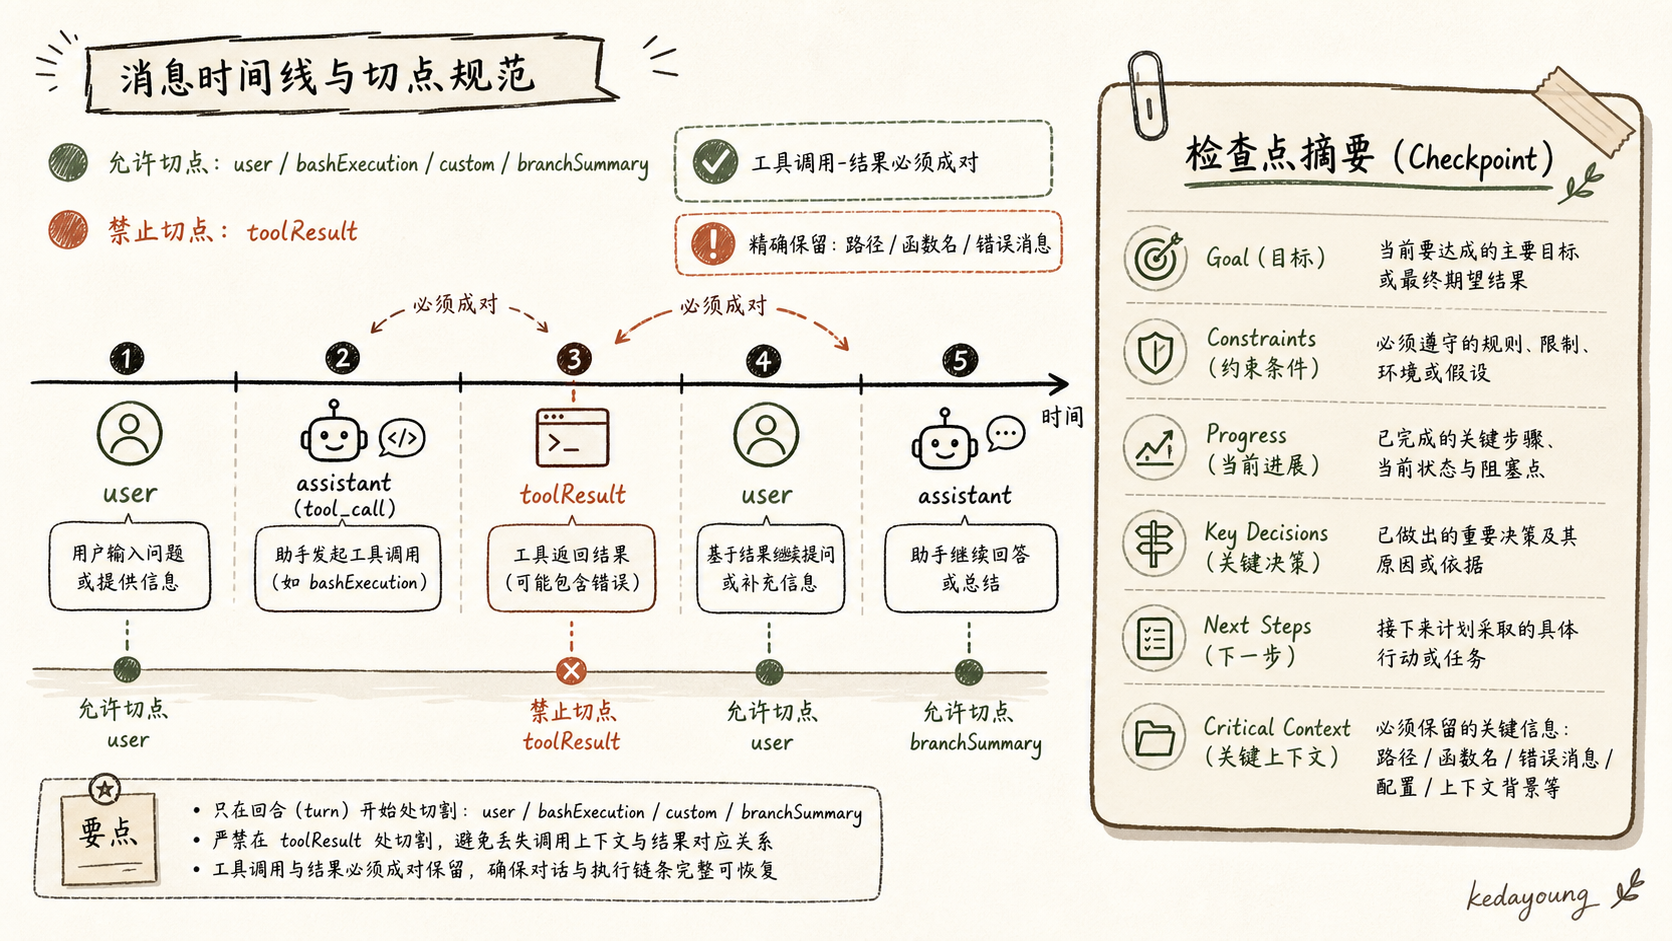
图 6|切点规则:所有 user 消息与带 tool call 的 assistant 消息均可切(图中标注对应位置;在 assistant 处切时,其后的 toolResult 随最近消息一起保留);禁止在 toolResult 处切。
实现里还有一层精细处理:当预算耗尽时,切点可能恰好落在一个 turn 的中间——不是 turn 起点的 user 消息,而是其后的 assistant 消息(该 turn 还未结束)。此时 findCutPoint 会返回 isSplitTurn(:451-460),把被切断的 turn 前缀单独总结成「Turn Context」(compact,:845-882、TURN_PREFIX_SUMMARIZATION_PROMPT,:795-808),与保留的后缀拼接——既保住了配对完整性,又不丢那个 turn 上半段的意图。
被截掉的部分不是被丢弃,而是被压缩成结构化 checkpoint 摘要。摘要模板 SUMMARIZATION_PROMPT(compaction.ts:467-498)强制使用固定格式,分六个区块:
## Goal
## Constraints & Preferences
## Progress
### Done / ### In Progress / ### Blocked
## Key Decisions
## Next Steps
## Critical Context
模板的最后一行是硬性要求:「Preserve exact file paths, function names, and error messages」(:498)——精确的文件路径、函数名、错误消息必须原样保留。这是「丢失就不可恢复」的高价值细节:路径猜错一步、函数名记错一个字符,恢复后继续工作就会走偏;而「我们讨论了哪些方案」这种过程性语义可以在摘要里模糊化,路径不能。
增量合并是摘要机制的第三个要点。UPDATE_SUMMARIZATION_PROMPT(compaction.ts:500-537)把「已有摘要(放在 <previous-summary> 标签里)+ 新增对话」合并成新摘要,规则是:保留已有信息、追加新进展、把「In Progress」推进到「Done」、更新「Next Steps」,同样强制保留精确路径/函数名/错误消息(:507)。对应地,prepareCompaction(:710-789)会从上次压缩边界(上一个 compaction entry 的 firstKeptEntryId)开始计算,把上次的摘要作为 previousSummary 传给这次(:726-733)。于是整条压缩链是层层折叠的:历史不是被一次次重写,而是被一次次合并——每次压缩都以上一次摘要为底稿。
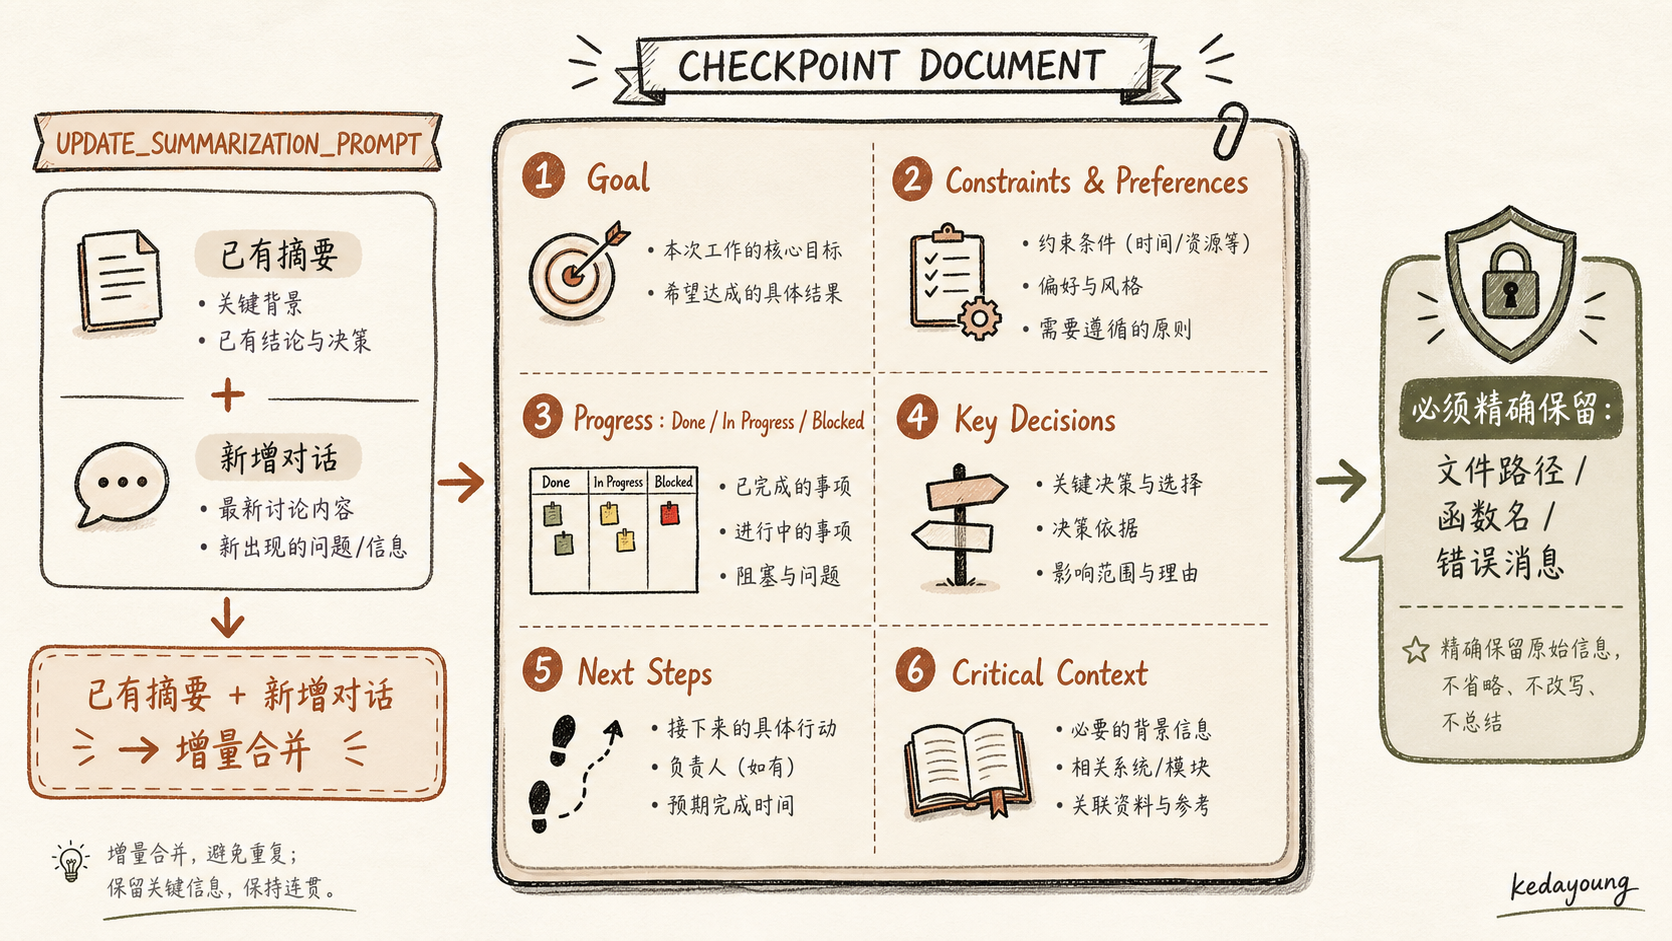
图 7|checkpoint 摘要模板:六个区块 + 增量合并规则,标注「必须保留精确值」的字段。
最后,压缩不是黑盒。session_before_compact 扩展 hook(agent-session.ts:2083-2109)在每次自动压缩前触发,扩展可以取消压缩(:2094-2103),也可以用自己的压缩结果替换默认结果(:2105-2108)。压缩是产品可干预点,不是埋在深处的内部动作——这对生产 agent 很重要:不同项目可能对「什么值得保留」有不同要求,hook 让产品逻辑可以插进压缩流程。
对照 hello-agents:它的 Compress 是分区截断——按 \n\n 切段、逐段填充、超限 break、剩余不足 50 tokens 就不再保留(第九章:519-544),保结构不保语义;pi 用摘要替代截断,并多了一层「工具配对完整性」的硬约束。这是两篇中最强的对照点:同一个「超限」问题,教学实现选择「删掉最旧的内容」,生产实现选择「把最旧的内容变成一份精心设计的摘要」。
7. 工具输出截断与「少而精」的上下文观
第 6 节处理的是「历史太长」,本节处理的是「单次输出太大」——工具输出在进入上下文之前先被截断。
默认值在 truncate.ts:11-13(截至 v0.84.1):
- 行数限制 2000 行(
DEFAULT_MAX_LINES = 2000); - 字节限制 50KB(
DEFAULT_MAX_BYTES = 50 * 1024); - 两个限制独立生效,先到先触发(文件头注释:「Truncation is based on two independent limits - whichever is hit first wins」,:4-6);
- 额外规则:grep 匹配行单行最长 500 字符(
GREP_MAX_LINE_LENGTH = 500,:13)。
位置比数值更重要:truncate.ts 被工具执行链调用,截断发生在工具输出写入会话历史之前——而不是模型拿到内容后再裁。这就把「不必要的信息」挡在上下文门外:50KB 的 ls -R 输出不会污染历史,模型看到的只是截断后的前缀,以及「完整输出存在哪」的提示(fullOutputPath)——超限部分从源头被挡在窗口之外。
这里可以归纳 pi 的上下文哲学(作者判断)。回头看三处机制,它们其实是同一个判断准则的三个实例——信息进入上下文之前先问它值不值得:
- 能按需读就不常驻(第 2 节:文档、SKILL.md 只给路径/摘要);
- 能在源头截断就不进窗口(本节:工具输出在进历史前限长);
- 能折叠就不堆叠(第 6 节:被压缩的历史变成摘要而非丢弃)。
一句话概括:pi 的上下文观是「少而精」。它不追求把窗口装满高价值信息,而是追求让进入窗口的每一块都经过一道「值得吗」的闸门——第 8 节第 5 条可迁移准则「截断发生在信息进入上下文之前」,正是从这条哲学里提炼出来的。
对照 hello-agents:它的 TerminalTool 也有输出截断(超过 10MB 截断,第九章:1718-1726),但阈值宽一个量级(10MB vs 50KB),目标是「防崩溃」——防止巨型输出撑爆内存,而不是「省上下文」。同一机制、不同设计意图:教学实现把截断当安全网,pi 把截断当预算手段。这是很好的对照素材——读代码时不能只看「有没有这个机制」,还要看「这个机制为谁服务」。
8. 与 hello-agents 对照:教学 vs 生产的两条路径 + 可迁移经验
把两篇合起来看,hello-agents 与 pi 在上下文工程的每个环节都做了不同选择。逐环节对照是理解两条路径的捷径:
| 环节 | hello-agents(教学) | pi(生产,截至 v0.84.1) |
|---|---|---|
| 上下文来源 | 统一入口流水线,Gather 五来源(第九章:225-304) | 短系统提示 + 层级 AGENTS.md + 按需加载(system-prompt.ts、resource-loader.ts) |
| 信息选择 | 相关性(Jaccard)+新近性加权、贪心填充(第九章:316-382) | 预算常量 + shouldCompact 阈值,进入即预算化(compaction.ts:235-238) |
| token 估算 | 本地启发式(第九章:563-577) | provider usage 实报优先 + 保守启发式(compaction.ts:146-230) |
| 超限处理 | 分区截断、保结构(第九章:519-544) | 切点保护 + 结构化摘要折叠(compaction.ts:403-461、:467-537) |
| 跨会话 | 同进程笔记/记忆检索恢复(codebase_maintainer.py:193-227) | JSONL 会话树/分支/恢复(session-manager.ts,配合分支摘要) |
| 可干预性 | 配置参数 + 断言校验(第九章:187-213) | hook(session_before_compact)扩展可替换压缩(agent-session.ts:2083) |
| 优先级 | 简单可读、可教学 | 可预测、可审计、可恢复 |
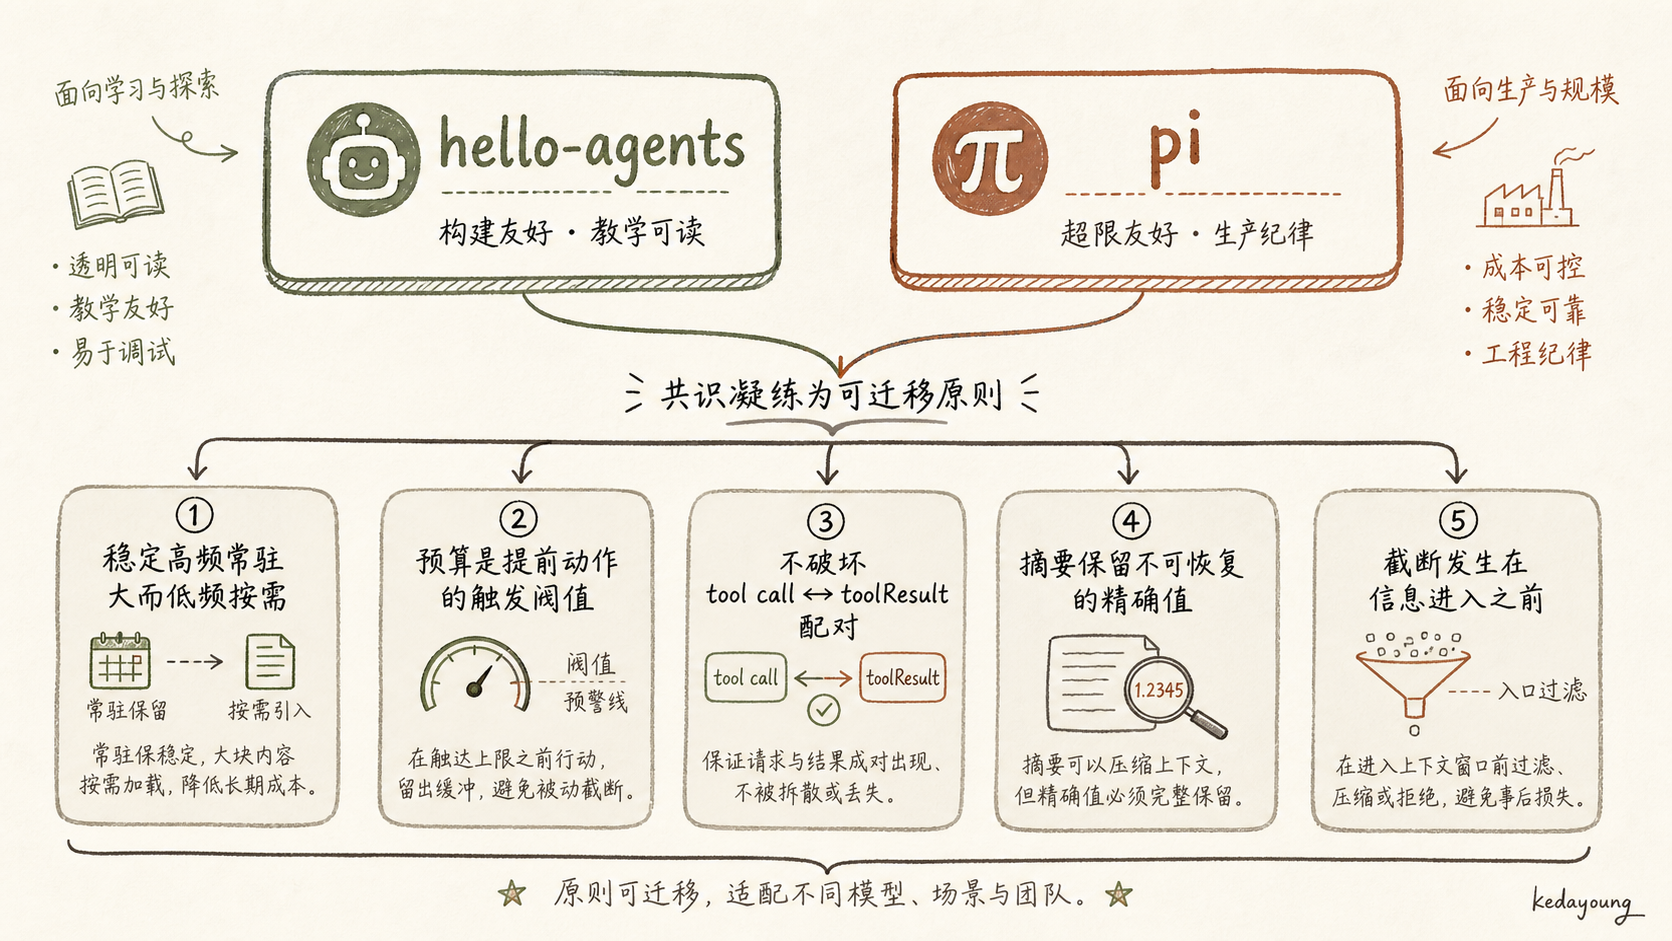
图 8|两个项目 → 五条可迁移准则:hello-agents 与 pi 分别代表「构建友好」与「超限友好」两条路径,合读后提炼出五条通用准则。
从对照表可以提炼出五条可迁移的工程准则(作者判断,每条对应的源码依据已在正文标注):
- 稳定且高频的信息常驻,体积大且低频的信息按需读取。项目约束进系统提示(第 3 节),文档全文按需读(第 2 节)——判断标准是「稳定×高频」与「体积×低频」的权衡,而不是「重要不重要」。
- 预算不是「上限」,是「触发提前动作的阈值」。
reserveTokens的存在意味着 pi 在窗口还空着 16384 token 时就动手压缩——提前压缩好过触碰窗口,因为窗口溢出是失败路径,提前压缩是优雅路径。 - 压缩永远不能破坏「工具调用-结果」配对。这是第 6 节最硬的一条约束,直接决定了切点规则;破坏配对的代价是模型幻觉或重复执行,比「丢掉一点历史」贵得多。
- 摘要必须保留不可恢复的精确值(路径、函数名、错误消息)。摘要可以模糊化讨论,但不能模糊化事实——
SUMMARIZATION_PROMPT的结尾要求就是这条准则的编码。 - 截断必须发生在信息进入上下文之前。源头治理好过事后清理:工具输出在进历史前限长(第 7 节),文档在进系统提示前只留路径(第 2 节)。
最后收束中心论点:两篇合读给出的完整答案是——上下文工程落地需要同时具备教学实现的可读性(hello-agents 让你看懂全貌:一条流水线、四个组件、一行公式)与生产实现的纪律性(pi 让你知道超限时刻怎么办:预算、切点、摘要、截断)。模式可迁移、实现需替换——「该常驻什么、该在哪切、该保留什么」这些判断是通用的,而「用什么工具、什么框架、什么数值」必须由你的产品约束重新决定。识别这层「模式与实现」的分界,是落地到具体产品时自己的任务。
附录 A:证据清单(写作时逐条核对)
以下断言均在 v0.84.1(commit 53fa77c)源码中核验:
| 断言 | 证据位置(20260803-pi-java-workflow/tmp/pi/,v0.84.1) |
|---|---|
| 系统提示组成、project_context 注入 | packages/coding-agent/src/core/system-prompt.ts:28、:55-60、:146-151 |
| 项目上下文候选与加载 | packages/coding-agent/src/core/resource-loader.ts:71、:118、worktree 阴影 :100-116 |
| 预算常量 | packages/coding-agent/src/core/compaction/compaction.ts:132-136 |
| 触发公式 | packages/coding-agent/src/core/compaction/compaction.ts:235-238 |
| 默认上下文窗口 | packages/coding-agent/src/core/provider-composer.ts:160 |
| 自动压缩检查与防御 | packages/coding-agent/src/core/agent-session.ts:1962-2053(失败消息保留在会话历史 :2015-2016) |
| token 估算策略 | packages/coding-agent/src/core/compaction/compaction.ts:146-230、:246-306 |
| 切点规则与「绝不在 toolResult 切」 | packages/coding-agent/src/core/compaction/compaction.ts:403-461、:347 注释 |
| checkpoint 摘要模板 | packages/coding-agent/src/core/compaction/compaction.ts:467-498 |
| 增量摘要合并 | packages/coding-agent/src/core/compaction/compaction.ts:500-537、prepareCompaction :710-789 |
| turn 前缀摘要(切分 turn) | packages/coding-agent/src/core/compaction/compaction.ts:795-808、:845-882 |
| 压缩扩展 hook | packages/coding-agent/src/core/agent-session.ts:2083-2109 |
| 工具输出截断 | packages/coding-agent/src/core/tools/truncate.ts:11-13 |
| 消息双轨与转换 | packages/agent/src/agent-loop.ts:60-62、:290-295、packages/agent/src/harness/messages.ts:19-59、:124-168 |
| skills 渐进披露 | packages/coding-agent/src/core/skills.ts:10-14、:335、:352-354 |
| JSONL 会话/分支/恢复 | packages/coding-agent/src/core/session-manager.ts(append-only 注释、:1044 _appendEntry、:1360 branch()、:890 恢复) |
| hello-agents 对照点 | 0-context-engineering/20260810-hello-agents/docs/chapter9/第九章 上下文工程.md(:246-254、:316-382、:501-577、:1718-1726)、code/chapter9/codebase_maintainer.py:137、:193-227 |
附录 B:素材缺口与待办
- [ ] 本文基于 GitHub 克隆的 v0.84.1(commit
53fa77c)核验;若后续 pi 仓库更新,行号可能漂移,重写前需重新核对。 - [ ]
findCutPoint的完整实现(compaction.ts:403-461)成文时已通读;分支总结(core/compaction/branch-summarization.ts)仅确认其职责(为 branch 生成摘要、以branchSummary消息进入对话流),未逐行通读;分支摘要如何参与后续轮次上下文(branch 切换后branchSummary注入 user 消息)仅引用messages.ts:12-17的转换规则,未展开 session-manager 的分支恢复流程细节。 - [ ] 第 8 节对照表中「跨会话」行关于 JSONL 会话树/分支/恢复的表述,依据
session-manager.ts的 append-only 注释、branch()与 resume 相关代码,未逐一列出源码行号;如需精确到行,需再通读session-manager.ts全文。 - [ ] 第 7 节「少而精」哲学归纳与第 8 节五条可迁移准则均为作者判断,文中已标注。