代码基线:所有
file:line引用均以 pi 源码克隆20260803-pi-java-workflow/tmp/pi/(v0.84.1,最近提交31b513e)为基准;凡是机制性判断,都标注为「作者判断」。
引言
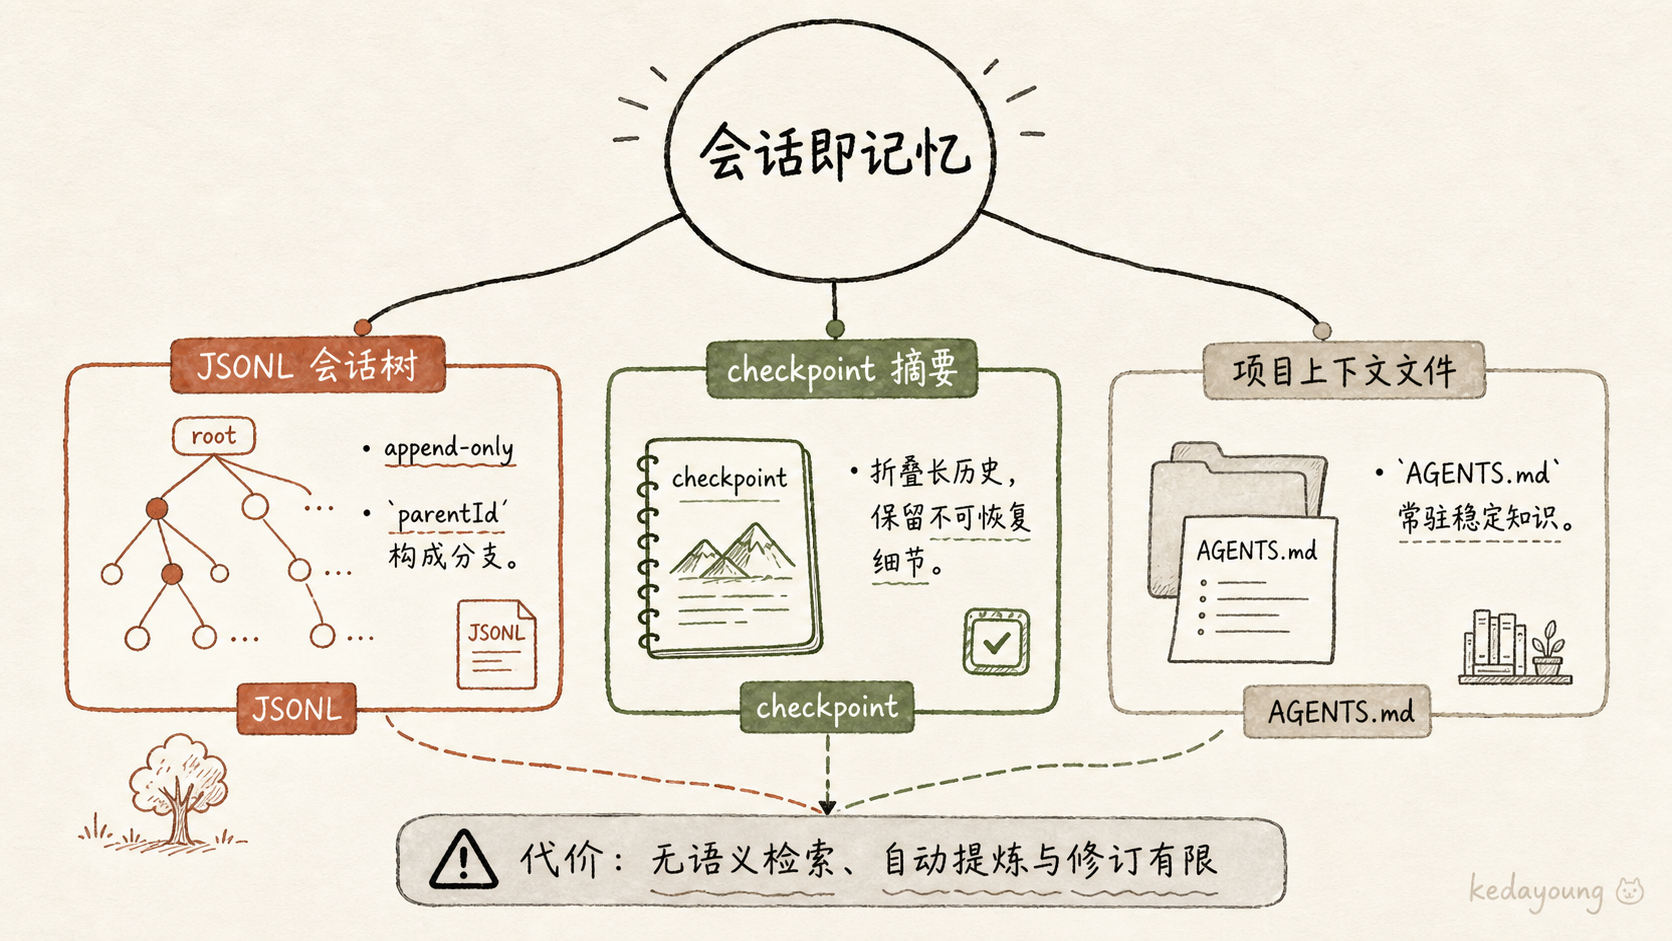
pi 没有独立的长期记忆模块,而是用「JSONL 会话树 + checkpoint 摘要 + 项目上下文文件」三件套承担记忆生命周期:会话是 append-only 的文件树(parentId 构成分支,恢复 = 沿树回溯重建上下文),跨会话的稳定知识由作者维护的 AGENTS.md 常驻,长历史的折叠靠结构化摘要(强制保留路径/函数名/错误消息等不可恢复细节)。这是「用文件与结构替代数据库」的记忆路线,代价是无语义检索、自动提炼与修订能力有限——与 mem0/letta 形成鲜明对照。
本文用真实代码回答一个问题:不建记忆库、只用文件与结构,能不能扛起记忆生命周期。路线:记忆观(§1)→ 会话树(§2)→ checkpoint 摘要(§3)→ AGENTS.md 层级加载(§4)→ 分支摘要与其它状态机制(§5)→ 对照与可迁移经验(§6)。
1. pi 的记忆观:会话即记忆
在动手读代码之前,先立一个判断坐标。上一篇系列文章把长期记忆定义为一条有生命周期的对象:采集 trace → 提炼候选 → 校验 → 带属性写入 → 按需检索 → 修订 → 退出使用。它强调「记住」不等于「保存」——把每轮消息、工具调用和模型回复按时间存下来只是 trace 留存,而 trace 同时包含事实、猜测、失败尝试和只在当时有效的状态,直接拿它当记忆,只是让旧对话有机会重新进入上下文,并没有把旧对话变成可信的长期资产。
pi 没有这样一个记忆模块。在 packages/coding-agent/src/ 里找不到 memory 目录、找不到向量库、找不到 add/search 接口;它有的是一套会话持久化设施,和若干「信息怎么进出上下文」的规则。但没有记忆模块,不等于没有记忆机制。把上一篇文章的生命周期环节逐个对照 pi 的实际设施,映射是这样的:
| 生命周期环节 | pi 的对应机制 | 证据 |
|---|---|---|
| 采集(trace) | JSONL 会话文件,append-only 追加每条消息 | session-manager.ts _persist(:1015-1042) |
| 提炼(折叠) | checkpoint 结构化摘要 + 增量合并 | compaction/compaction.ts:467-537 |
| 校验(准入) | 摘要必须走 EXACT 模板 + 长期知识只能由作者写 AGENTS.md | 见第 3、4 节;作者判断见下表后注 |
| 带属性写入 | 每条 JSONL 条目自带 type/id/parentId/timestamp | session-manager.ts:46-51 |
| 检索(恢复) | 沿会话树回溯 parentId 重建上下文 | session-manager.ts buildSessionContext(:461-470) |
| 修订(纠错) | 分支指针 + 分支摘要,历史不改不删 | session-manager.ts branch/branchWithSummary(:1360-1405) |
| 长期知识常驻 | 层级 AGENTS.md 项目上下文 | resource-loader.ts:118-156 |
| 退出(遗忘) | 「不恢复即遗忘」——无全局索引,不沿树走就看不到 | 作者判断,见第 2 节小结 |
| 扩展状态槽 | custom 条目,跨重启保存但不进 LLM 上下文 | session-manager.ts:104-108 |
表格里「校验」与「带属性写入」两行需要说明(作者判断):pi 没有显式的校验环节——它的准入靠两条结构性约束(摘要必须走 EXACT 模板、长期知识只能由作者维护),而不是运行时校验;「带属性写入」也不是额外一步,而是每条 JSONL 条目天然携带 type/id/parentId/timestamp 四个属性(第 2 节会展开)。这两个环节在 pi 里是「内嵌的」而非「独立的」,这是它与事实库路线(记忆作为独立实体校验后写入)的又一差别。
这张表是全文的骨架。它揭示 pi 的记忆观可以一句话概括:记忆的可靠性不来自模型自动提炼,而来自结构化——作者维护的 AGENTS.md 承载稳定知识,结构化摘要承载折叠历史,会话文件树承载完整 trace;三个都是显式、可读、可审计的文件。(作者判断)
由此可以回答开头的问题:pi 有没有「长期记忆」?严格说没有——没有独立于会话的、可检索的记忆实体。但它有「长期知识」(AGENTS.md,跨会话常驻)和「长期历史」(会话文件树 + 摘要,跨会话可恢复)。「长期记忆」这个概念在 pi 里被拆成了「知识」与「历史」两样东西,分别由不同的机制承载——这是比「有没有记忆模块」更有信息量的事实(作者判断)。换句话说,20260727 那篇文章里的七环节,pi 的答案分别是:采集 = 追加 JSONL 条目、提炼 = 模板化摘要、校验 = 结构性约束(EXACT 模板 + 作者维护)、写入 = 带属性的条目落盘、检索 = 沿树回溯、修订 = 分支指针、退出 = 不恢复——全部是文件操作,没有一个环节需要数据库。
这个选择与 mem0/letta 的路线分道扬镳:那边是「事实库/agent 状态」,记忆是独立于会话的实体,靠提取与检索读写;pi 是「会话即文件」,记忆的载体就是会话本身。分水岭的详细对照放在第 6 节,先看 pi 的三个机制各自怎么工作。
2. 会话树:JSONL v3 格式、分支与恢复
一次会话落盘成什么
pi 的每次会话是一个 JSONL 文件,当前格式版本 CURRENT_SESSION_VERSION = 3(core/session-manager.ts:30)。文件第一行是 SessionHeader(:32-39),记录会话 type/version/id/timestamp/cwd,以及一个可选的 parentSession 字段——它指向「这个会话是从哪个会话 fork 出来的」,是跨文件层面的血缘标记。
从第二行开始,每条记录是一个 JSON 对象,所有条目共享 SessionEntryBase(:46-51)的四个字段:
export interface SessionEntryBase {
	type: string;
	id: string;
	parentId: string | null;
	timestamp: string;
}
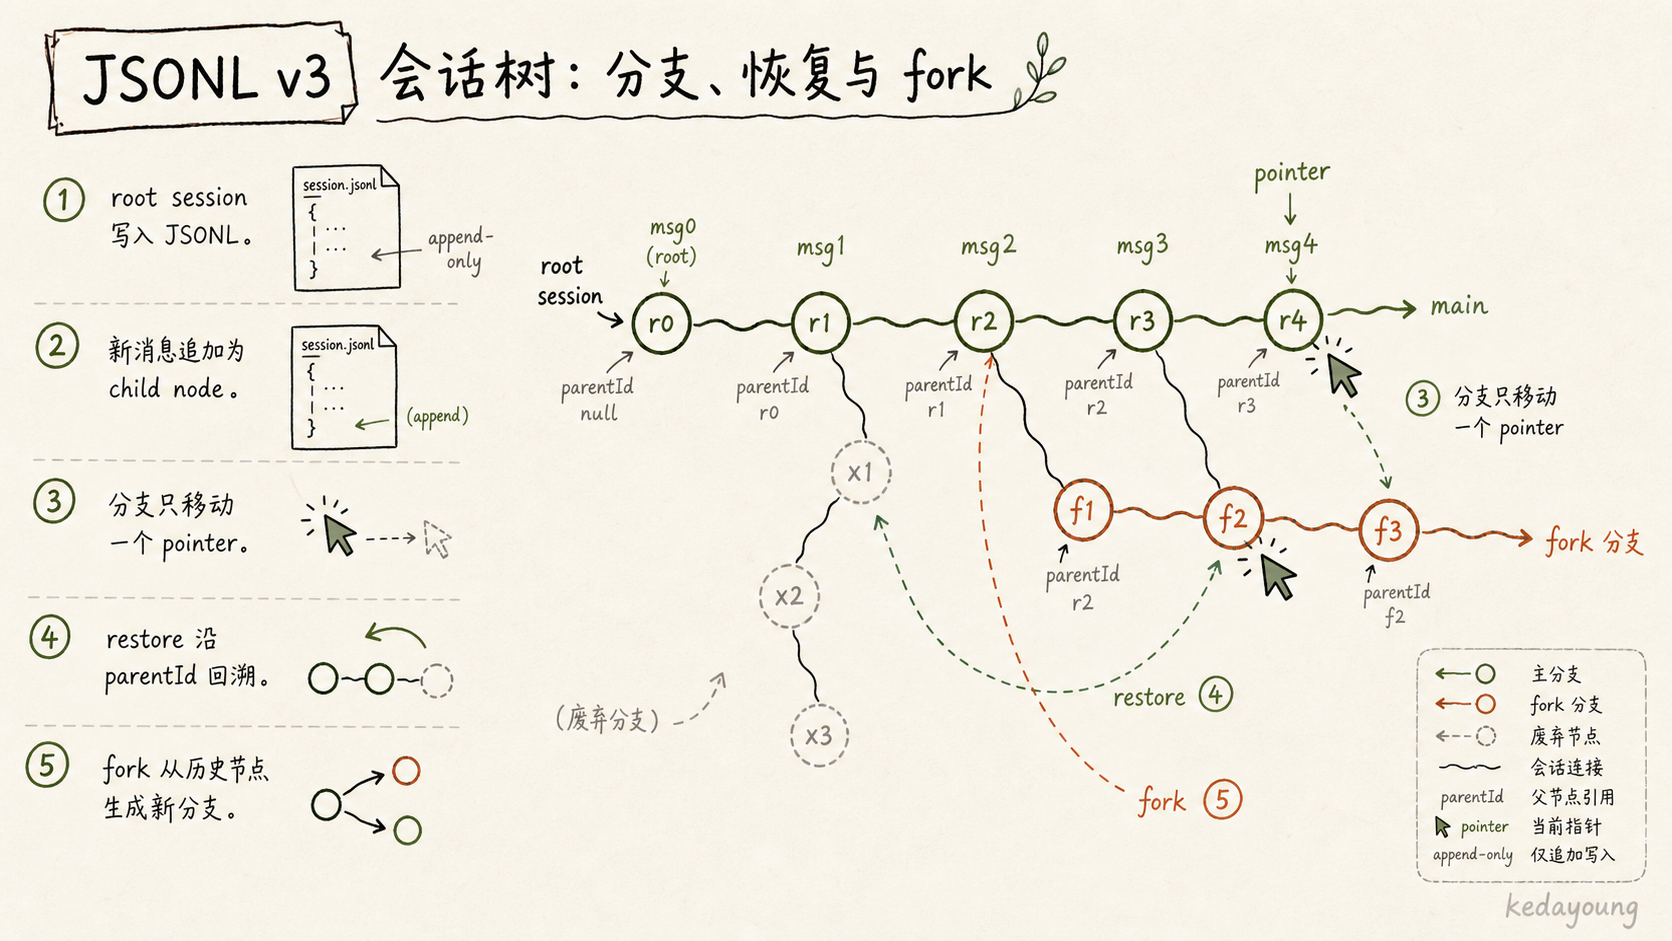
id + parentId 是理解 pi 记忆模型的关键:一个会话文件里所有条目构成一棵树,而不是一条线。parentId: null 的是根,其余条目各自挂在某个父条目下。条目类型共 9 种(:143-153):
message——普通对话消息;thinking_level_change/model_change——思考级别、模型的切换事件;compaction——checkpoint 摘要(第 3 节);branch_summary——被放弃分支的摘要(第 5 节);custom/custom_message——扩展状态槽,前者不进 LLM 上下文,后者进;label——书签(第 5 节);session_info——会话元信息。
文件路径形如 ~/.pi/agent/sessions/--<encoded-cwd>--/<timestamp>_<id>.jsonl(:476-481),cwd 被编码进目录名,同一个工作目录的会话聚在一起,按时间戳排序。记忆的第一层载体就是文件系统:会话文件是 append-only 的,_persist 只在首个 assistant 消息出现后才落盘(:1018-1027),之后每条记录追加写入,历史从不改写。这意味着任何一次会话的完整 trace 都可以事后原样读出——这是「可审计」的地基。
「首个 assistant 消息前不落盘」这个细节值得单独说一句(作者判断):它意味着「用户只问了半句话就被打断」的会话不会产生文件垃圾——落盘的门槛是「对话确实开始产出内容」。这与记忆生命周期里「采集要有准入」的精神一致:不是每个输入都值得成为 trace,至少要有第一条模型产出。反过来,一旦落盘,就只追加不修改,把「可审计」放在了「可整理」之前——宁可让文件里留着不再需要的旧分支,也不冒着破坏 trace 完整性的风险去改写历史。
分支:只移动一个指针
树形结构带来的第一个能力是分支。用户说「从这个地方重新来」时,pi 调 branch(branchFromId)(:1360-1365),它的全部逻辑是:
branch(branchFromId: string): void {
	if (!this.byId.has(branchFromId)) {
		throw new Error(`Entry ${branchFromId} not found`);
	}
	this.leafId = branchFromId;
}
只把 leafId 指针移到目标条目上。源码注释写得很直白:「Moves the leaf pointer to the specified entry. The next appendXXX() call will create a child of that entry, forming a new branch. Existing entries are not modified or deleted.」下一次 append 会挂在目标条目下,自然长出一条新分支——而旧路径的历史原封不动地留在文件里。resetLeaf(:1372-1374)则是把指针拨回 null,用于「重新编辑第一条 user 消息」的场景,下一次 append 会生成一个新的根条目。
getTree(:1310-1348)把平铺的条目重建为树视图:孤儿条目(父条目缺失)当根处理,按 timestamp 排序。树是 pi 会话的内部数据模型,不是展示层面的装饰——恢复上下文、分支摘要、标签导航全都建立在这棵树上。
图 1|会话树示意图
图注:据
session-manager.ts的parentId模型与branch/branchWithSummary/createBranchedSession行为绘制。原 leaf 在 A3(灰色,虚线边框 = 被放弃路径 U3→C→U4→A3 的末端);branch()把 leaf 指针移回 U3 后,历史不删不改,下一次 append 的branch_summary(绿色)挂在 U3 下,把被放弃路径的教训写进新分支(BS→U5→A4);createBranchedSession则可以把「root→A3」这条路径整体提取成独立的新会话文件(带parentSession血缘)。
分支不复制历史,只移动指针,这是 pi 记忆模型里最值得记的一个工程决策(作者判断):在一个几十万 token 的长会话上反复「回退再探索」,成本是 O(1) 的指针移动,而不是 O(历史) 的复制;代价是树会越走越密,第 5 节的分支摘要正是用来给导航「降噪」的——不是删除,而是把死胡同折叠成可读的教训。
恢复 / fork:沿树回溯
会话的「检索」就是恢复。三种入口:
static open(:1530-1550)——打开一个已有的会话文件;continueRecent(:1557-1565)配合findMostRecentSession(:635-656,按 mtime 找最新会话)——接着最近的会话继续;forkFrom(:1579-1630)——把当前会话复制成带parentSession的新会话文件(第 1618 行附近写parentSession: resolvedSourcePath),这是跨文件复制,与分支指针不同;createBranchedSession(leafId)(:1412-1512)则把「从根到某个 leaf 的一条路径」提取成一个独立的新会话文件——适合把一次成功的探索单独归档(作者判断)。
恢复的核心是重建上下文,链路是 buildSessionContext(:461-470) → buildContextEntries(:418-454) → sessionEntryToContextMessages(:383-408)。最关键的是 buildContextEntries 是 compaction-aware 的:它先从根到 leaf 找路径上最近的一次 compaction 条目,然后只保留 [compaction 摘要] + 从 firstKeptEntryId 起的旧条目 + compaction 之后的全部条目,把被折叠掉的旧消息排除在重建结果之外。也就是说:恢复 = 沿树回溯 + 用摘要顶替被折叠的历史——长会话恢复后的上下文里,压缩前的细节只剩摘要里强制保留的那些(第 3 节),这正是「折叠的记忆」落回上下文的方式。
图 2|恢复链路:沿树回溯 + 摘要顶替被折叠的历史
图注:恢复 = 沿树回溯 + 用摘要顶替被折叠的历史;
firstKeptEntryId是「从哪条旧消息开始保留」的锚点(由appendCompaction写入,见第 3 节)。
导航树(用户主动在会话树里跳转)的编排在 agent-session.ts:2905-3095 的 navigateTree():先记录旧 leaf,收集被放弃分支的条目(为生成分支摘要做准备),再决定新 leaf 落在哪里,最后用 buildSessionContext() 重建消息列表写回 agent.state.messages 并发射 session_tree 事件。整棵树的交互闭环——分支 → 摘要 → 恢复 → 回写——都在这一个方法里收口。
小结
pi 的「会话记忆」= 一个 append-only 的 JSONL 文件 + 一棵 parentId 树 + 一个 leaf 指针。采集靠追加,检索靠回溯,修订靠指针移动,退出靠「不恢复」(没有全局索引,不打开文件、不沿树走,旧分支就是不可见的)。
3. checkpoint 摘要:折叠与增量合并
会话树解决了「存得住、找得回」,但长会话必然超限,上下文工程篇讲了预算与切点(那边的事,本篇不重复)。这里只看折叠产物长什么样——pi 把被压缩掉的历史折成一份结构化 checkpoint 摘要,它要回答两个问题:保什么、丢什么。
摘要模板:六段式 EXACT 格式
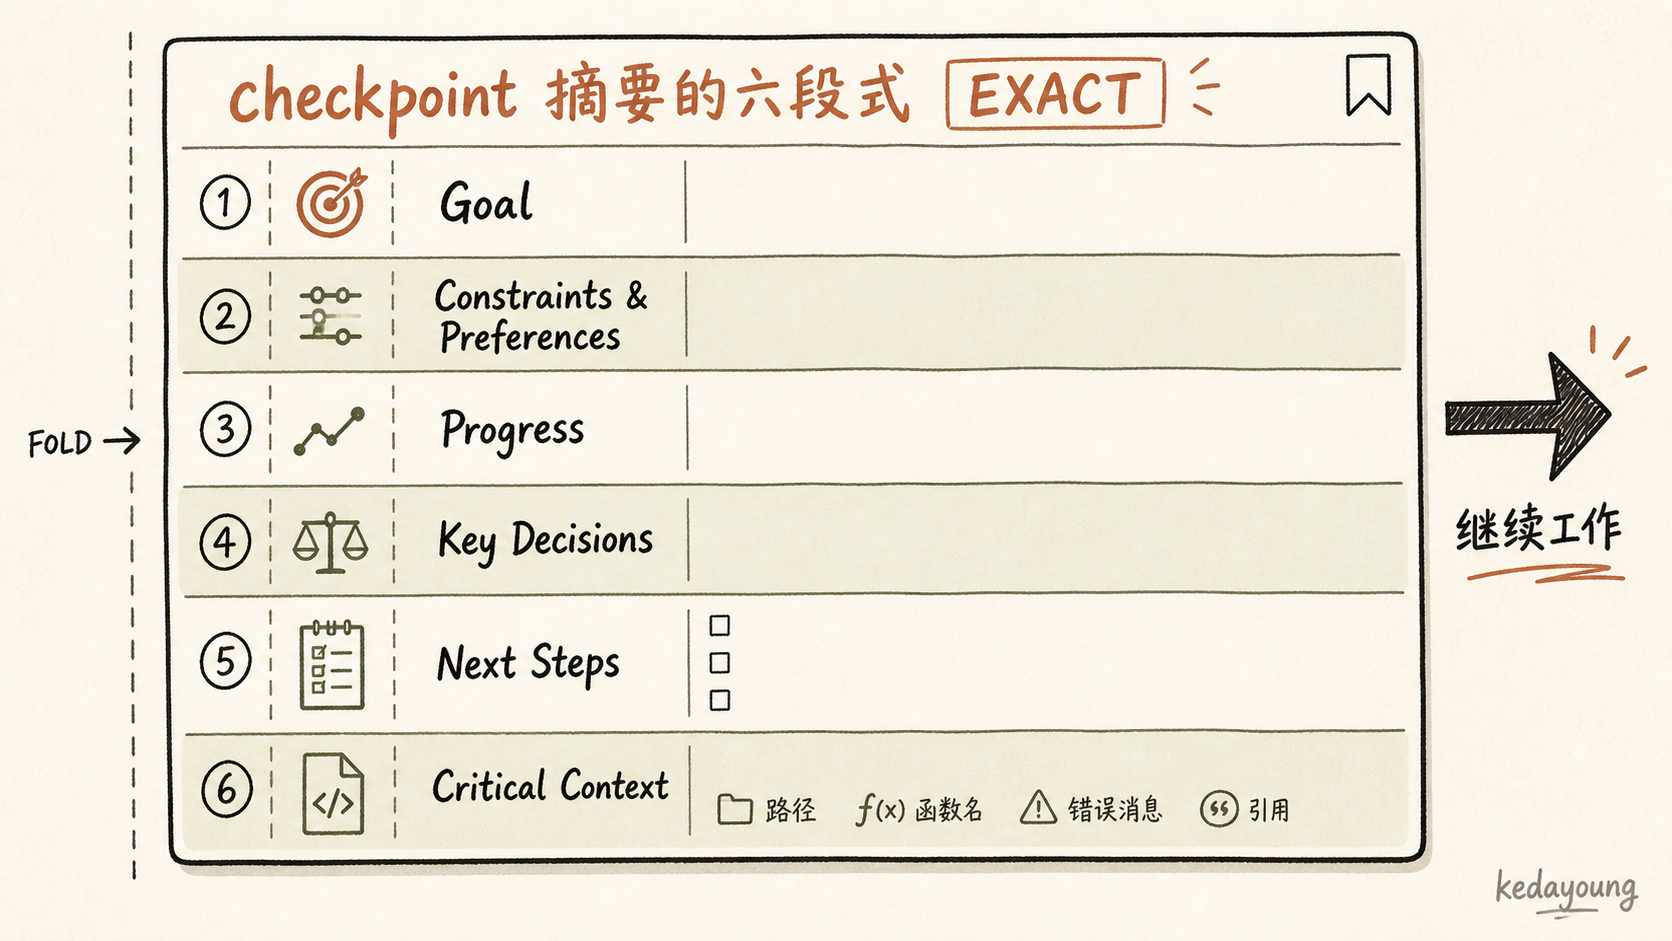
摘要由 SUMMARIZATION_PROMPT(core/compaction/compaction.ts:467-498)生成,提示词开头就要求「Use this EXACT format」,六段缺一不可:
## Goal                      —— 用户要完成什么(可多项)
## Constraints & Preferences —— 约束/偏好,没有就写 (none)
## Progress
  ### Done / In Progress / Blocked
## Key Decisions             —— [决策]: [理由]
## Next Steps                —— 有序的下一步列表
## Critical Context          —— 继续工作所需的数据/示例/引用
最后一行是全文最重要的规则(第 498 行):「Preserve exact file paths, function names, and error messages.」为什么这三样是硬性要求?因为它们丢失即不可恢复(作者判断):代码路径和函数名是模型继续动手的前提,错误消息是排查的依据,而对话里的措辞、推理过程、失败的中间尝试则是可再生的——丢了可以重推,顶多多花几轮。这是一个很明确的记忆取舍准则:摘要只保「不可恢复的精确值」,不保「可再生的过程」。
举一个具体的「丢什么」(作者判断):一次失败的构建尝试——错误消息和涉及的路径会保留下来(它们进了 Blocked 或 Critical Context),因为重跑一次构建才能再拿到;但当时完整的堆栈输出、模型排查的推理过程会被丢弃,因为那些是「再生成一次就能得到」的。折叠不是删掉细节,而是区分细节的再生成本:成本高(需要重新执行/重新发现)的保留,成本低(重新推理即可)的舍弃。
图 3|checkpoint 摘要模板卡片图
图注:按
SUMMARIZATION_PROMPT(compaction.ts:467-498)的结构绘制,标出「必须保留精确值」的字段——虚线表示精确值横切在多个段落之上,折叠时唯一不可妥协的就是这些不可恢复的精确值。
六段中,Goal/Constraints/Progress/Key Decisions/Next Steps 是「当前工作状态」,Critical Context 是「继续工作所需的数据」——而「精确值」横切在多个段落之上:文件路径可能出现在 Progress 里,函数名和错误消息可能出现在 Blocked 或 Critical Context 里。卡片图的要点是:折叠时唯一不可妥协的是这些精确值,其余内容可以省略到最小。(作者判断)
增量合并:摘要不是重写,是更新
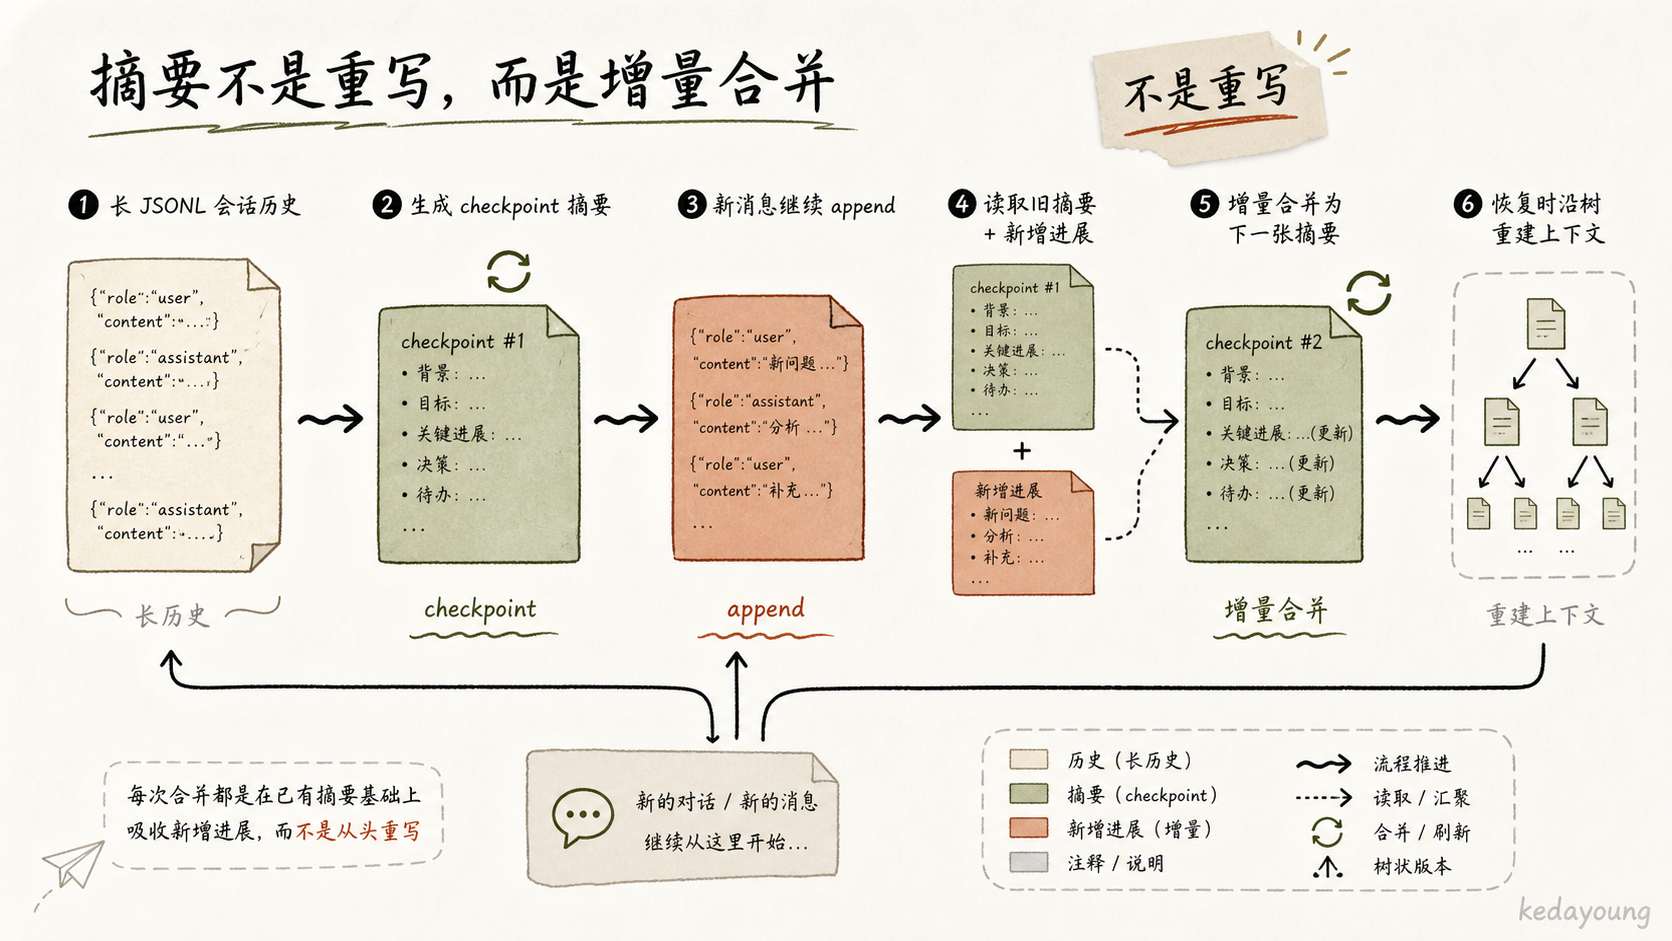
如果会话之前已经有过摘要,第二次压缩不会从头再来,而是走 UPDATE_SUMMARIZATION_PROMPT(compaction.ts:500-537)。选择逻辑在 :643:previousSummary ? UPDATE_SUMMARIZATION_PROMPT : SUMMARIZATION_PROMPT,旧摘要会被包进 <previous-summary> 标签(:655-657)一起送进去。更新规则三条:
- PRESERVE all existing information from the previous summary —— 旧信息不丢;
- ADD new progress, decisions, and context —— 新信息并入;
- UPDATE the Progress section:move items from "In Progress" to "Done" —— 状态推进。
也就是说,Progress 里的 In Progress → Done 是一次显式的状态迁移,由模型按规则执行,而不是让摘要像聊天记录一样无限堆积。多次压缩之后,摘要是一个不断被「合并+推进」的单一对象,而不是一串互相覆盖的摘要快照——这是「折叠」区别于「截断」的地方(上下文工程篇里与 hello-agents 的对照也讲过这一点)。
生成链路与文件记忆
摘要生成的完整链路(compaction.ts:622-686):generateSummaryWithUsage → serializeConversation(compaction/utils.ts:109-150,把对话序列化成 <conversation> 包裹的单一 user 消息,tool result 按 TOOL_RESULT_MAX_CHARS = 2000 截断,常量在 utils.ts:89)→ 统一走 completeSummarization(:562-581,内部经 retryAssistantCall 重试)。生成失败会重试,摘要写盘走 appendCompaction(session-manager.ts:1096-1119),条目携带 summary/firstKeptEntryId/tokensBefore/details/usage/fromHook——firstKeptEntryId 正是第 2 节 buildContextEntries 恢复时用的「从哪条旧消息开始保留」的锚点。
一个值得一提的细节是文件记忆(compaction 与文件操作挂钩):compaction/utils.ts 的 extractFileOpsFromMessage(:29-56)从 assistant 的 toolCall 里提取 read/write/edit 的文件路径,formatFileOperations(:72-82)把它们格式化成 <read-files>/<modified-files> 的独立 XML 块,追加在摘要文本的末尾(compaction.ts:905-906 处 summary += formatFileOperations(...),并不属于某个固定段落);结果存在 CompactionDetails{readFiles, modifiedFiles} 里(接口定义在 compaction.ts:34-37),下一次压缩时 extractFileOperations(compaction.ts:42-70)会把上一轮的文件操作合并进新摘要。这样,模型在超长任务里即使忘光了中间过程,至少知道「读过哪些文件、改过哪些文件」——文件级的工作足迹被当作不可恢复的精确值保留下来,和路径/函数名/错误消息同一待遇。这是把「工具的使用痕迹」纳入记忆的一个很实用的设计(作者判断)。
4. 项目上下文:AGENTS.md 层级加载
会话树 + 摘要解决的是「一次探索的记忆」;跨会话、跨分支的稳定知识存在哪?答案是项目文件,载体是 AGENTS.md。这对应生命周期里的「长期知识常驻」:它不是模型提炼出来的,而是作者维护的——这正是 pi 记忆路线与自动提炼路线的根本分歧之一。
候选顺序与层级加载
loadContextFileFromDir(core/resource-loader.ts:70-89)规定每个目录只取一个上下文文件,候选顺序:
AGENTS.override.md → AGENTS.md → AGENTS.MD → CLAUDE.md → CLAUDE.MDAGENTS.override.md 排在 AGENTS.md 前面,用于临时覆盖;CLAUDE.md 是兼容 Claude Code 的存量项目。loadProjectContextFiles(:118-156)把加载组织成层级:
- 先加载全局
~/.pi/agent/AGENTS.md(:128-132)——个人级常驻知识,所有项目共享; - 再从 cwd 逐级向上到根,每层目录取候选文件,unshift 进数组(:134-151),所以结果是「根目录的在最前、cwd 的在最后」——越靠近 cwd 的文件排在越靠后的位置(注入顺序即 LLM 看到的先后;是否构成「后者覆盖前者」取决于 prompt 拼接细节,属上下文工程篇范畴,本文不展开);
seenPaths去重(:126/143/145),同一文件不会注入两次;findShadowedContextFile(:100-116)处理 git worktree 遮蔽:嵌套 linked worktree 与主仓库共享逻辑仓库范围,若不处理,同一个文件会被加载两次,重复注入。
加载结果经 DefaultResourceLoader.reload()(方法签名在 :387,方法体内 :514-523 附近完成 agentsFiles/loadProjectContextFiles 调用)注入系统提示:system-prompt.ts 以 <project_context><project_instructions path="..."> 逐文件包裹(:54-61、:144-152,前者在 customPrompt 分支、后者在默认 prompt 分支)。每个注入的文件都带 path,模型能知道「这条规则来自哪个文件」——可追溯性从一开始就在。
图 4|AGENTS.md 层级加载:从全局到 cwd 的注入顺序
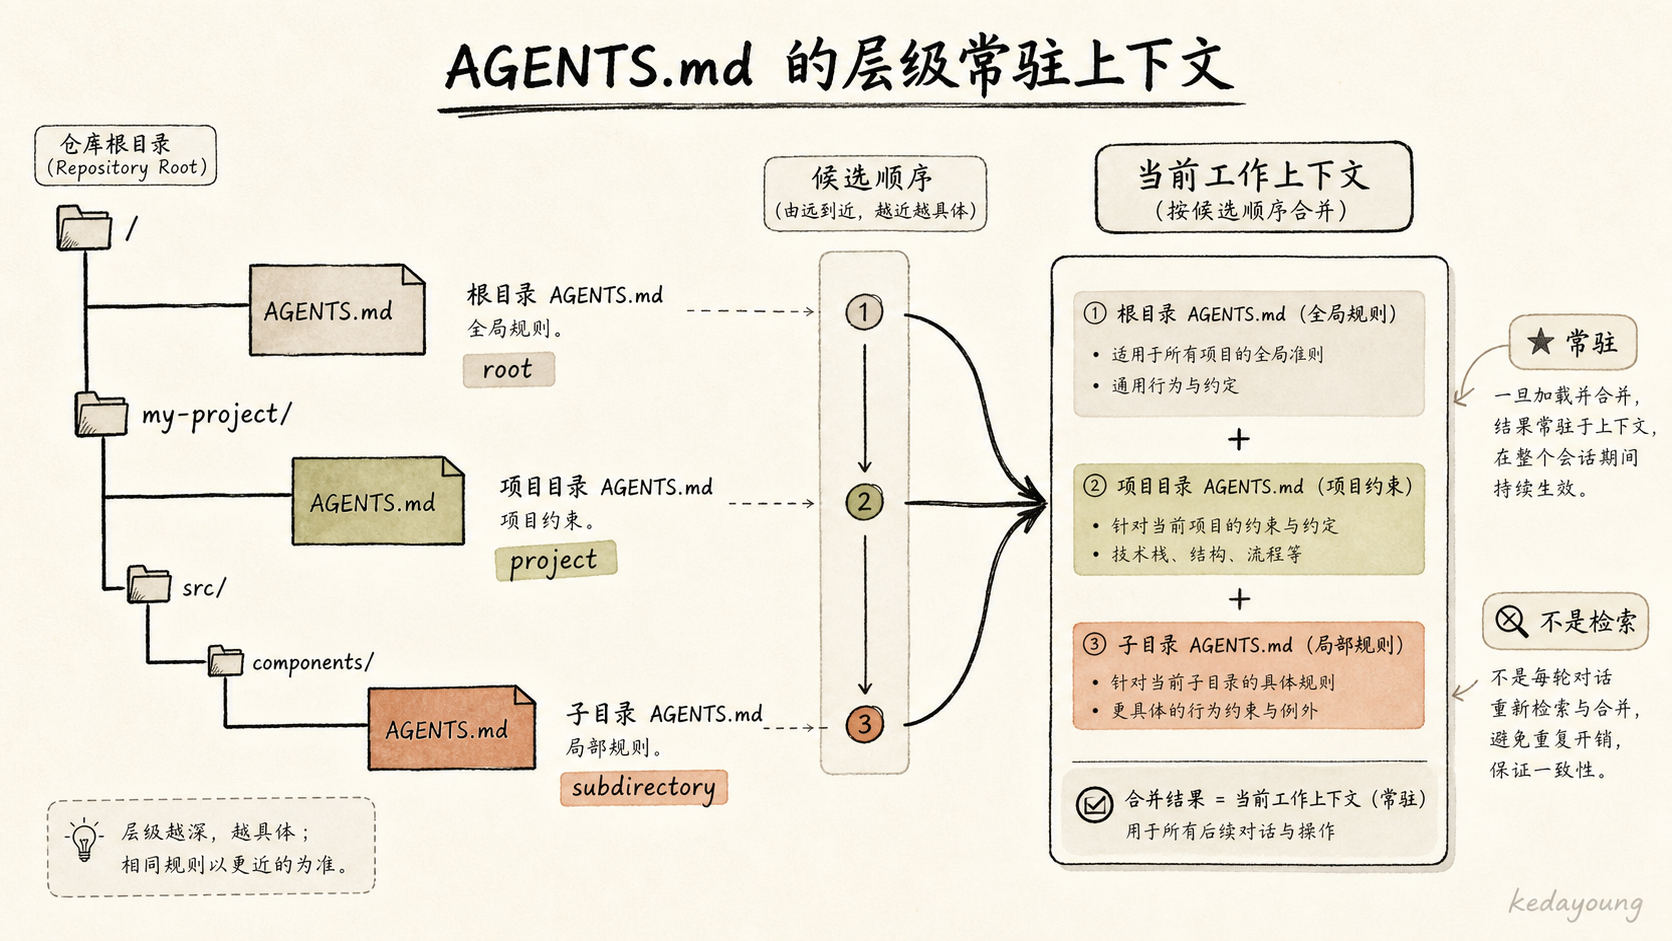
图注:
AGENTS.md是唯一一个跨会话、跨分支、不需要恢复动作就自动在场的记忆——每次会话启动时从文件系统重新读入,作者可控、模型不可改。
为什么是「常驻」而不是「检索」
上下文工程篇已经论证了「稳定且高频的信息常驻、体积大且低频的按需读取」这条准则。这里补充记忆视角的含义(作者判断):AGENTS.md 是 pi 记忆系统里唯一一个跨会话、跨分支、不需要恢复动作就自动在场的记忆——它不是从会话树里找回来的,而是每次会话启动时从文件系统重新读入的。这带来两个性质:
- 作者可控:写入什么、什么时候改、什么时候删,都是文件编辑,有 git 历史,可审计;
- 模型不可改:
AGENTS.md不在会话树里,会话中的模型无法通过对话「顺手改掉」它(要改得走文件工具),这天然防止了「模型把一次会话里的临时偏好写进长期记忆」的污染——上一篇文章讨论过的「哪些信息有资格成为长期记忆」的门禁问题,pi 用「长期记忆只能由人维护」这个极端的办法绕开了。
除 AGENTS.md 外,resource-loader.ts:1022-1048 附近还支持 .pi/SYSTEM.md / .pi/APPEND_SYSTEM.md 作为补充系统指令;而 custom 条目(session-manager.ts:104-108)是扩展的跨重启状态槽——扩展可以把任意结构化状态存进会话文件,但注释明确「Does NOT participate in LLM context」,它不进上下文,只作为扩展自己的持久化。这是「不进上下文的记忆」:数据活着,但不占用窗口。一个直觉的类比(作者判断):AGENTS.md 是给模型看的「员工手册」,custom 槽是给扩展自己用的「工作台抽屉」——两者都持久化,但前者进每轮上下文、后者永远只在需要时被扩展读回。这条「持久化 ≠ 进上下文」的分离,对设计 agent 扩展特别有用:不是所有需要跨重启保存的东西都值得花模型 token。
5. 分支摘要、标签与其它状态机制
被放弃的分支怎么「留痕」
会话树允许无限分支,但分支多了,人就没法导航了——这是树型记忆的代价。pi 的解法是分支摘要:离开一条分支时,把这条被放弃路径的要点折成一份摘要,追加进新分支,让「放弃」本身留下可读的痕迹,而不是留下一堆死胡同。
流程分两步。collectEntriesForBranchSummary(core/compaction/branch-summarization.ts:108-146)从旧 leaf 出发,回溯到与导航目标的公共祖先,收集这条被放弃分支上的条目——注意收集范围是「公共祖先以下、旧 leaf 以上」,公共祖先之前的共享历史不重复摘要。prepareBranchEntries(:195-247)按 token 预算筛选要送进摘要的条目,并累计文件操作。最后由 BRANCH_SUMMARY_PROMPT(:258-285)生成摘要——同样是六段式(Goal / Constraints & Preferences / Progress / Key Decisions / Next Steps),但没有 Critical Context:被放弃的路径不需要保留「继续工作的数据」,因为不会再继续了,只需留下「这条路探索过什么、为什么放弃」的导航信息。
写回动作是 branchWithSummary(session-manager.ts:1381-1405):它 = branch() + 追加一条 branch_summary 条目,fromId 记录被放弃路径的起点。navigateTree 的编排(agent-session.ts:2905-3095)里,摘要追加在导航目标位置(新 leaf 所在分支)而非旧分支——也就是说,新分支开头就带着「上一个分支的结论」,模型继续工作时天然知道前一条路已经试过。这比「把旧分支留在原地不管」多了一层:放弃不是消失,是折叠成可读的教训(作者判断)。
图 5|分支摘要留痕:放弃不是消失,是折叠成教训
图注:被放弃的分支不删除,而是折叠成可读的教训写进新分支;收集范围是「公共祖先以下、旧 leaf 以上」,公共祖先之前的共享历史不重复摘要。
标签:给树上的节点命名
分支多了还需要定位手段,label 条目就是书签:appendLabelChange(session-manager.ts:1232-1253)给任意条目命名一个标签,树导航时按标签跳转。标签是纯用户侧的书签,不参与模型推理——它是给人用的记忆索引。它和分支摘要正好互补:分支摘要是「机器可读的教训」(进模型上下文),标签是「人可读的地标」(只服务导航)——在树越来越密之后,「先按标签定位、再恢复/分支」是用户侧最顺的导航路径。(作者判断)
特殊消息角色:进入 LLM 之前先降维
分支摘要、compaction 摘要、自定义消息最终都要进 LLM 上下文,但它们不是普通对话。messages.ts:69-77 在消息系统里扩展了 bashExecution / custom / branchSummary / compactionSummary 等角色;convertToLlm(:148-195)在发送前把它们统一转成带标签的 user 消息(例如 <summary> 标签),降维到 user/assistant/tool 三种协议角色之内,保证多 Provider 兼容。细节属于上下文工程篇的消息双轨制,这里只需记住:记忆类条目进入模型时,都带着「我是摘要/我是分支教训」的显式标签,模型能区分「这是历史折叠物」和「这是本轮对话」。
演进预告:v4 后端(截至 v0.84.1 未进入运行路径)
最后说现状与演进。仓库里存在一个正在演进的 v4 会话后端,分两个包:
packages/agent(@earendil-works/pi-agent-core)定义了SessionRepo契约(src/harness/session/types.ts:361-373:create/open/list/delete/fork 五个方法,open注释明确「acquires any backend writer claim」)和LaneRecord操作日志(各记录类型定义在 :80-188,联合类型在 :203-212),后者是操作级日志:OperationStarted/StepAttempt/ToolStarted/WriteDeferred等记录用于崩溃恢复——把「写盘前先记操作意图」的账本思想带进了会话存储;packages/session-backends/sqlite-node(@earendil-works/pi-session-backend-sqlite-node)是 SQLite 实现:SqliteSessionRepository(src/sqlite/repo.ts:681)、writer leases(src/sqlite/storage/writer-leases.ts,acquire/renew/release)、FTS5 全文搜索(src/sqlite/search-backend.ts:42建session_search_fts虚拟表)、branch-cache 与 facts 等。
但截至 v0.84.1,packages/coding-agent 未引用这个 v4 后端
grep SessionRepo|sqlite-node|LaneRecord 在 coding-agent 源码无任何匹配,sqlite-node 也未出现在任何包的 package.json 依赖里;packages/agent 自身的默认实现是 src/harness/session/jsonl/repo.ts 的 JsonlSessionRepo(仍是 JSONL 文件后端)。所以当前运行路径是 v3 JSONL 会话树,本文通篇讲的机制就是 v0.84.1 实际在跑的东西;v4 是仓库里的演进方向(尤其 FTS5 搜索与 facts,意味着「无语义检索」这个边界正在被补上),写作时如实标注:本文描述的是 v0.84.1 运行路径,不包含未接线的 v4 能力。
6. 对照与可迁移经验
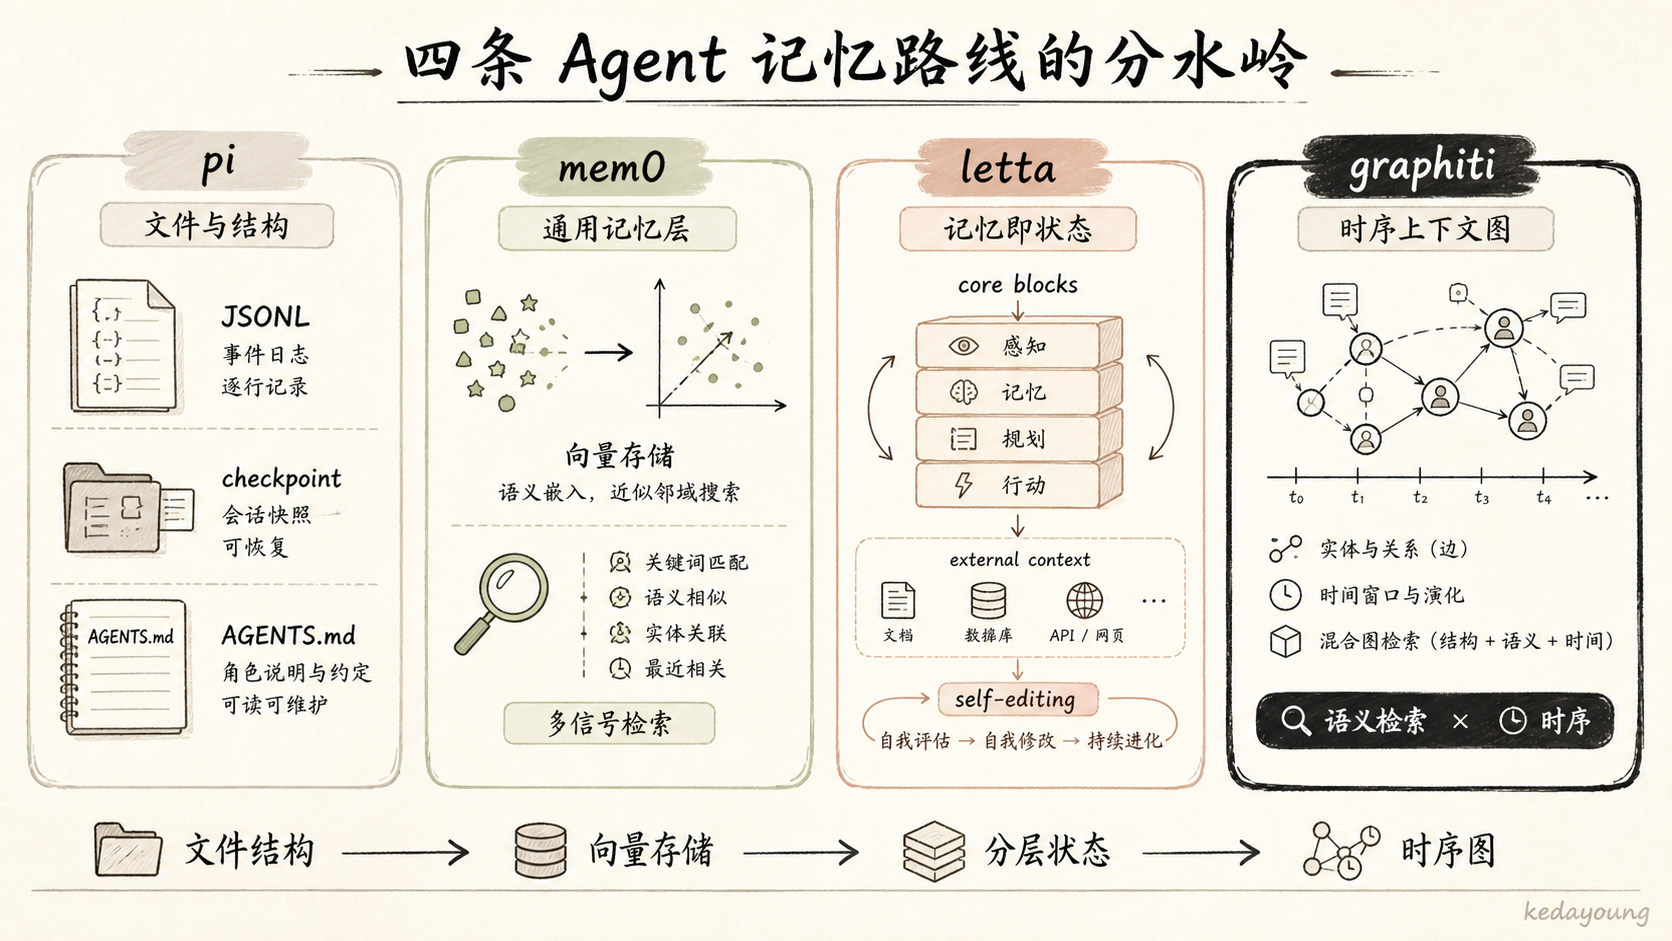
四条记忆路线的分水岭
把 pi 与另外三条路线并排看,分水岭立刻清楚。mem0(事实库路线)、letta(agent 状态路线)、TencentDB Agent Memory(分层符号库路线)与 pi(会话文件路线)在四个维度上各自做了不同的选择。对照口径说明:pi 一列以本文核实的源码为准;其余三列基于系列对应篇(20260810-mem0/、20260810-letta/、20260810-tencentdb-agent-memory/)的公开设计素材,细节见各篇,本文不做实现级断言。
| 维度 | pi(v0.84.1,会话文件) | mem0(外部事实库) | letta(agent 状态) | TencentDB Agent Memory(分层符号库) |
|---|---|---|---|---|
| 记忆归属 | 会话 JSONL 文件(树 + 指针) | 外部向量/图事实库 | agent 内部状态(block/内存) | 分层符号知识库 |
| 修改方式 | 分支指针 + 摘要折叠,历史不改不删 | add/search 提取写入 | 记忆工具自编辑(push/pop/替换) | 管线提炼 + 分层维护 |
| 检索 | 无语义检索,恢复 = 沿树回溯 | 多信号检索(向量/图/keywords) | 计数 + 检索工具 | hybrid RRF 混合检索 |
| 可追溯 | 文件可读,每条记录有 id/parentId | 靠 hash 关联原始会话 | 靠工具调用记录 | node_id 可下钻到原始证据 |
pi 是四条路线里最「朴素」也最「透明」的一条:它没有独立于会话的记忆实体,记忆就是文件;没有语义检索,恢复就是沿树走;没有自动提炼,提炼靠模型按模板生成摘要、靠作者写 AGENTS.md。它放弃的东西(检索能力、自动维护)换来的是三样别处难有的东西:文件可读可审计、分支代价 O(1)、记忆边界完全由人控制。(作者判断)
能带走的可迁移模式
- 会话即文件 + 分支指针,不复制历史。append-only 的日志天然可审计;「回退 = 移动指针」让探索性工作流的成本与历史长度解耦。任何 CLI agent 都可以用「文件 +
parentId+ leaf 指针」三样东西得到一棵会话树,不需要数据库(见第 2 节)。 - checkpoint 摘要只保不可恢复的精确值。路径、函数名、错误消息、文件操作足迹——这些是「丢了就得重新发现」的;措辞、推理过程是可再生的。这条取舍准则比「摘要要写多详细」更有指导意义(见第 3 节)。
- 稳定知识由作者维护、常驻注入。
AGENTS.md不进会话树、模型改不了,天然免疫「会话污染长期记忆」。如果你的场景里长期记忆的写入方必须是可信的(人或评审),这比自动提炼更可控(见第 4 节)。 - 折叠要增量,不重写。
UPDATE_SUMMARIZATION_PROMPT的 PRESERVE/ADD/UPDATE 三规则,让多次压缩收敛到一个持续推进的摘要对象,而不是一堆互相覆盖的快照(见第 3 节)。 custom槽:存状态但不进上下文。跨重启的扩展状态(UI 位置、配置、中间结果)与「给模型看的信息」解耦——不是所有持久化都必须消耗上下文预算(见第 4 节)。
边界:这套路线不适合谁
诚实地说清代价。无语义检索:你不能问「我上次在哪提过 X」,只能沿树走、靠标签定位;会话一多,树就变成迷宫。无自动提炼/修订:摘要质量依赖模板与单次生成,模型跑偏没有第二道工序兜底;AGENTS.md 不会自己更新。跨项目不可迁移:知识锁在 AGENTS.md 与 cwd 编码的会话目录里,换个项目一切归零。v4 的 FTS5 与 facts 正在补「检索」这一块,但那是演进中的能力,未进入 v0.84.1 运行路径。
所以 pi 的路线适合以探索为主、会话数量可控、可审计比可检索更重要的场景(比如工程开发、代码审查);如果你需要「知识沉淀出来、跨项目复用、模糊查询」,mem0/letta 那类事实库路线是更自然的选择。两条路线不是优劣关系,是「记忆归文件还是归库」的两种工程取舍。
最后重申与上下文工程篇(0-context-engineering/20260810-pi/)的分工:那篇讲系统提示、token 预算、findCutPoint 切点规则与消息双轨制的完整实现,是「超限时刻怎么办」的答案;本篇只从记忆/会话生命周期视角看同一套代码——compaction 在这里是「折叠记忆」的机制,预算与切点的工程细节都指向那边,不重复展开。两篇合读,才是 pi 在「信息如何进入上下文」与「信息如何被记住、找回、折叠、遗忘」两个问题上的完整答案。
结语
回到开头的对照:上一篇文章说记忆应该有生命周期,这篇文章展示了 pi 用三个核心机制 + 辅助槽把生命周期全部扛起来——会话树负责采集与检索,checkpoint 摘要负责提炼与折叠,AGENTS.md 负责稳定知识常驻;分支与标签负责修订与定位,custom 槽负责扩展状态,「不恢复即遗忘」负责退出。它没有记忆库,却有一整套记忆语义;代价是没有语义检索与自动维护,换来的是文件可读、分支廉价、边界可控。「用文件与结构替代数据库」不是偷懒,是一种把记忆的可靠性押在「可审计的显式结构」而非「模型的隐式提炼」上的路线选择——这是 pi 给我们的核心启发。
附录 A:证据清单(写作时逐条核对,截至 v0.84.1 / 31b513e)
| 断言 | 证据位置(20260803-pi-java-workflow/tmp/pi/packages/) |
|---|---|
| 会话版本与 Header | coding-agent/src/core/session-manager.ts:30、:32-39 |
| 条目树结构与类型 | coding-agent/src/core/session-manager.ts:46-51、:143-153 |
| 会话文件路径模板 | coding-agent/src/core/session-manager.ts:476-481 |
| 分支/恢复/fork | coding-agent/src/core/session-manager.ts:1360-1365、:1372-1374、:1381-1405、:1530-1550、:1579-1630、:1412-1512 |
| 树导航编排 | coding-agent/src/core/agent-session.ts:2905-3095 |
| 上下文恢复(compaction-aware) | coding-agent/src/core/session-manager.ts:383-408、:418-454、:461-470 |
| 摘要模板与增量合并 | coding-agent/src/core/compaction/compaction.ts:467-498、:500-537、:643、:655-657 |
| 生成链路与重试 | coding-agent/src/core/compaction/compaction.ts:562-581、:622-686;compaction/utils.ts:109-150 |
| 文件记忆 fileOps | coding-agent/src/core/compaction/utils.ts:29-56、:72-82;compaction.ts:34-37(CompactionDetails)、:42-70(extractFileOperations) |
| AGENTS.md 层级加载 | coding-agent/src/core/resource-loader.ts:70-89、:100-116、:118-156;reload() 签名 :387 |
| 项目上下文注入 | coding-agent/src/core/system-prompt.ts:54-61、:144-152 |
| 分支摘要 | coding-agent/src/core/compaction/branch-summarization.ts:108-146、:195-247、:258-285 |
| 标签/custom/消息角色 | coding-agent/src/core/session-manager.ts:1232-1253、:104-108;core/messages.ts:69-77、:148-195 |
| v4 演进(非运行路径) | agent/src/harness/session/types.ts:361-373(SessionRepo)、:80-188 各记录类型、:203-212(LaneRecord 联合);session-backends/sqlite-node/src/sqlite/repo.ts:681(SqliteSessionRepository)、storage/writer-leases.ts、search-backend.ts:42(FTS5);grep 无 coding-agent 引用、无包依赖 sqlite-node |
与大纲相比的核实修正
- v4 后端:大纲称「SQLite 实现 repo.ts 在 packages/agent」,核实后
packages/agent的默认实现是jsonl/repo.ts的JsonlSessionRepo,SQLite 实现在独立的packages/session-backends/sqlite-node包;两者均未被 coding-agent 引用。 CompactionDetails与extractFileOperations在compaction.ts:34-37、:42-70(大纲误标为utils.ts)。DefaultResourceLoader.reload()方法签名在resource-loader.ts:387(:514-523 是方法体内片段)。LaneRecord联合类型在types.ts:203-212(:80-188 是各记录类型定义)。
附录 B:素材缺口与待办
- [x] 成文前复核 pi 版本(v0.84.1 / 31b513e)与关键行号:已由子代理逐条核实,29 项精确匹配、4 处修正(见附录 A)。
- [ ] v4 后端未进入 v0.84.1 运行路径,若 pi 后续版本接线,本文第 5 节演进描述需更新。
- [x] 与上下文工程篇(
0-context-engineering/20260810-pi/)交叉检查:预算/切点/消息双轨细节均指向那边;本篇仅在「记忆折叠」环节提及 compaction,未重复叙事。 - [ ] 第 6 节对照表其余三列基于系列其他篇素材,发布前与 mem0/letta/tencentdb 篇核对口径。