证据说明:本文全部行号引用自本地克隆
0-agent-evaluation/20260810-promptfoo/repo/(main 分支快照,2026-08-11 克隆);成文时已对附录 A 所列关键段落逐一复核,行号未漂移。只讲机制、不写跑分结果。
中心论点
promptfoo 把评测建模为「config → TestSuite → 笛卡尔任务矩阵 → 并发执行 → 断言 → 报告」的流水线。一切评测对象(prompt、模型、agent 轨迹)都被压成「测试 × provider × 断言」的笛卡尔积;红队只是往同一流水线注入「由 LLM 合成的攻击用例 + 专用断言」的特殊模式;回归与 CI 则靠「退出码阈值、resume、缓存、filter-failing」四件套落地。它与 hello-agents 教学管线的本质差异是评测对象泛化 + 回归原生支持。
如果你写过脚本式评测,大概率经历过这样的循环:写一个 evaluate() 函数把 prompt 塞给模型,拿返回值跟期望结果比对,打印一个表格,然后……这个脚本就死在了那个仓库里。下次想跑新的 prompt、换一个模型、加一条用例,都要打开脚本改 if-else,跑完的结果既没有落盘也没有历史,更谈不上进 CI 当门禁。
promptfoo 换了一个问法:评测不是一段程序,而是一份声明。写配置文件,描述「用什么模型、喂什么 prompt、按什么标准判对错」,剩下的事——展开成任务、并发执行、逐条判定、汇总报告、落盘持久化——全部交给同一个引擎。脚本式评测里的每个环节(循环、并发、比对、输出)在 promptfoo 里都有对应的、可配置的机制:循环变成任务矩阵,并发变成有界并发执行器,比对变成断言注册表,输出变成多格式落盘加结果持久化。脚本的「一次性」由此变成基础设施的「可复用」。
本文用 promptfoo 源码讲清这条流水线的三个核心机制(配置即评测、任务矩阵展开、断言系统),再说明它如何把红队安全评测复用到同一条流水线上。
1. 评测工具化的起点:配置即评测
一份最小配置长什么样
下面这份配置只有三块,但足以定义一次完整评测:
# promptfooconfig.yaml
providers:
  - openai:gpt-4o
prompts:
  - "把下面的中文翻译成英文:{{input}}"
tests:
  - vars:
      input: "你好,世界"
    assert:
      - type: contains
value: "Hello"读法:providers 声明被测模型,prompts 声明模板({{input}} 是变量插槽),tests 声明用例——每条用例带 vars(变量值)和 assert(断言)。注意这里没有出现任何执行逻辑:没有 for 循环、没有 API 调用代码、没有 if-else 判定。providers 里的字符串 openai:gpt-4o 甚至不需要事先 import 任何库——它会在第 4 节介绍的 loadApiProviders 里被解析成真正的 provider 实例。
一次评测由什么定义?
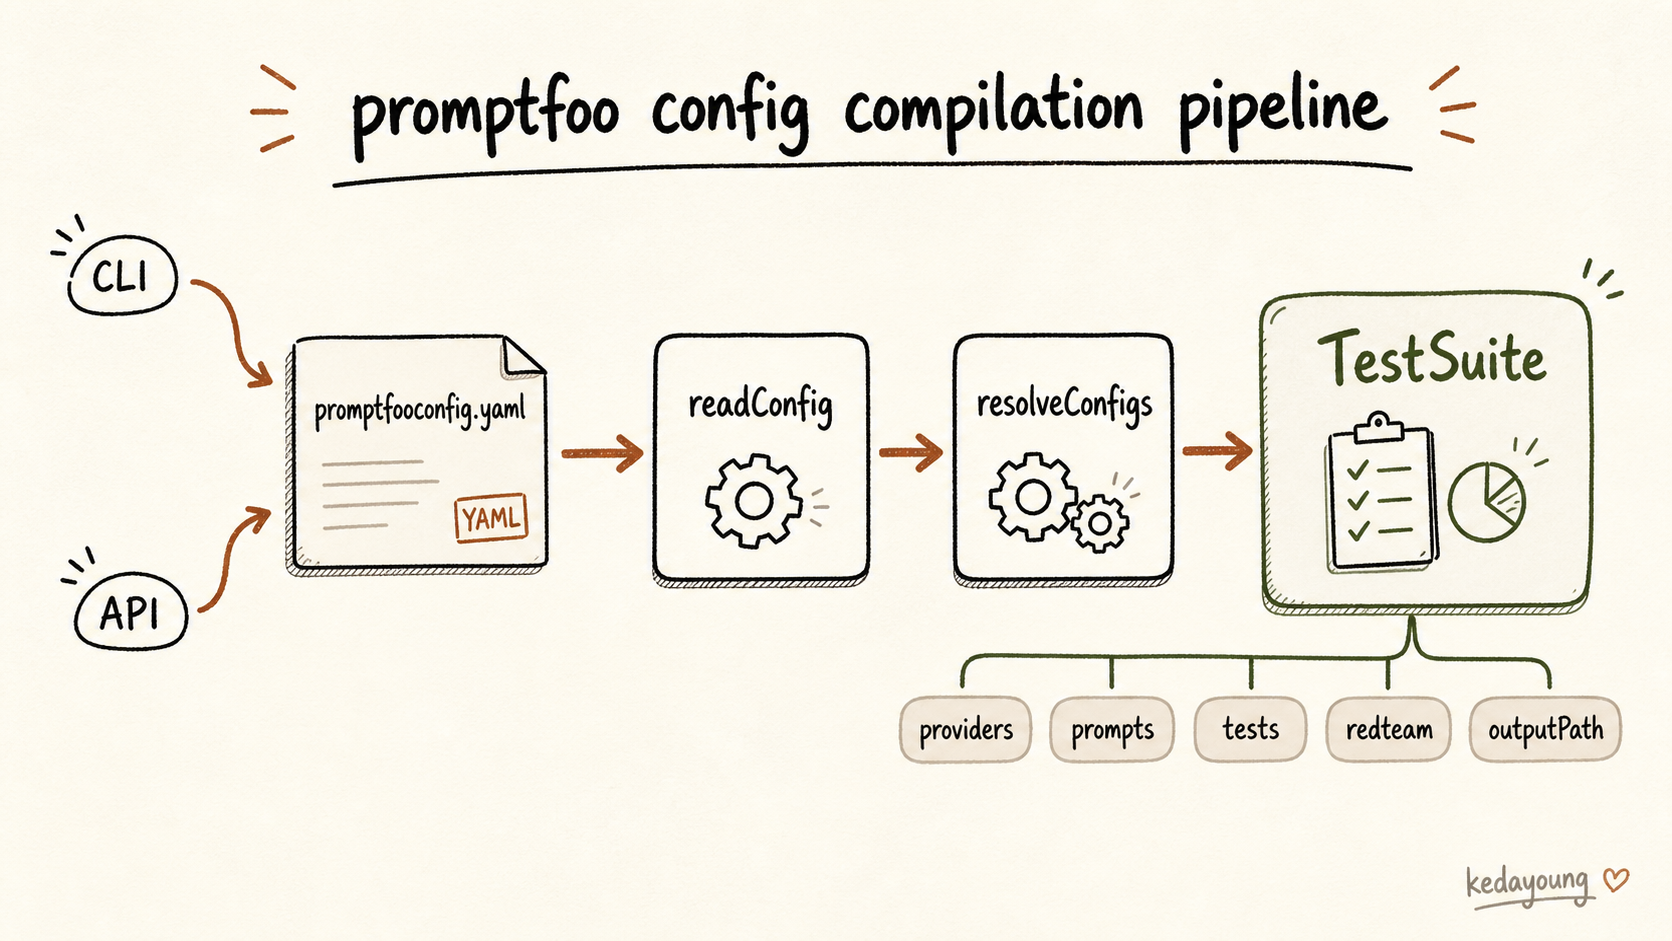
promptfoo 里,一次评测的完整定义落在配置文件里。CLI 入口 doEval(src/node/doEval.ts:224)启动后,会按 promptfooconfig.yaml、promptfooconfig.yml、promptfooconfig.json、promptfooconfig.js、promptfooconfig.cjs 等扩展名清单自动寻找配置文件(扩展名清单见 src/util/config/extensions.ts);找不到时给出提示:"Looked for promptfooconfig.{...}. Run promptfoo init or pass --config path/to/promptfooconfig.yaml"(src/node/doEval.ts:304-306)。也就是说,配置文件的缺席本身就是一个被显式处理的错误状态——评测必须有声明,而不是靠脚本里的魔法。
配置文件的处理链在 readConfig()(src/util/config/load.ts:328-443)里走完:读取 YAML/JSON/JS → dereferenceConfig 处理引用合并 → 环境变量模板渲染({{ env.VAR }} 这类占位符)→ Zod 校验。途中还做兼容改写(:404-420):旧字段 targets 自动映射成 providers、plugins 自动映射成 redteam.plugins。这看起来是小事,但它是「评测资产」能长期存活的前提——配置格式演进时,旧评测文件不会一夜之间全部失效。
配置结构由 TestSuiteConfigSchema(src/types/index.ts:1164-1316)定义,核心字段有七类:providers(被测模型)、prompts(提示词模板)、tests(测试用例与断言)、defaultTest(全部用例共享的默认断言/选项)、scenarios(批量变体)、redteam(红队专用配置)、outputPath(结果输出位置)。
从配置到运行时测试套件
配置不是直接执行的,它要先被 resolveConfigs()(load.ts:762-1103)"编译"成运行时形态 TestSuite(:1024-1053),内含四类 parsed 对象:parsedProviders(已实例化的 provider)、parsedTests(已渲染变量、已展开 scenario 的测试)、parsedPrompts(已渲染的 prompt 模板)、defaultTest,外加 providerPromptMap。随后做三处引用校验(:1057-1076):断言引用是否合法、provider 引用能否解析、prompt 引用是否存在——错误的配置在跑任何模型之前就被拦下,而不是跑到一半才报错。
值得注意的还有双入口设计:
- CLI:
src/main.ts:88注册evalCommand,参数定义在src/commands/eval.ts:18-245(--config、--grader、--resume、--filter-failing等都在这里声明); - 程序化 API:
src/node/evaluate.ts:65-67暴露evaluate(),内部走src/evaluate.ts:317-376的evaluateWithSource()——同一套评测引擎可以嵌进工具链、定时任务、CI 脚本。
评测既是命令也是库,这意味着上面那条「配置 → TestSuite」的编译链只有一份实现,两种入口共享。
设计含义
把评测「声明」进配置文件,评测就从脚本里的临时逻辑变成了可版本化、可评审、可继承的资产——它跟着代码走 git 历史,能在 code review 里被逐行评审,能被 defaultTest 机制复用到成百上千条用例上。这是「评测工具化」的第一块基石:先有可声明、可校验的评测对象,后面所有机制才有承载物。
图 1|配置 → TestSuite 流水线图
配置文件经 readConfig(校验/改写)与 resolveConfigs(引用解析)变成 TestSuite,双入口(CLI / API)共享同一编译链。
2. 任务矩阵:笛卡尔展开与并发执行
「测试 × 变量 × 模型 × prompt × 重复」如何变成可执行步骤?
一条评测指令背后是四层调用:doEval(src/node/doEval.ts:224-1206)→ evaluate()(src/evaluator.ts:4878-4906)→ Evaluator.evaluate()(:4760-4873)→ _runEvaluation()(:4490-4758)。真正干活的是最后一层。
_runEvaluation 的第一步是把测试套件展开成笛卡尔积:
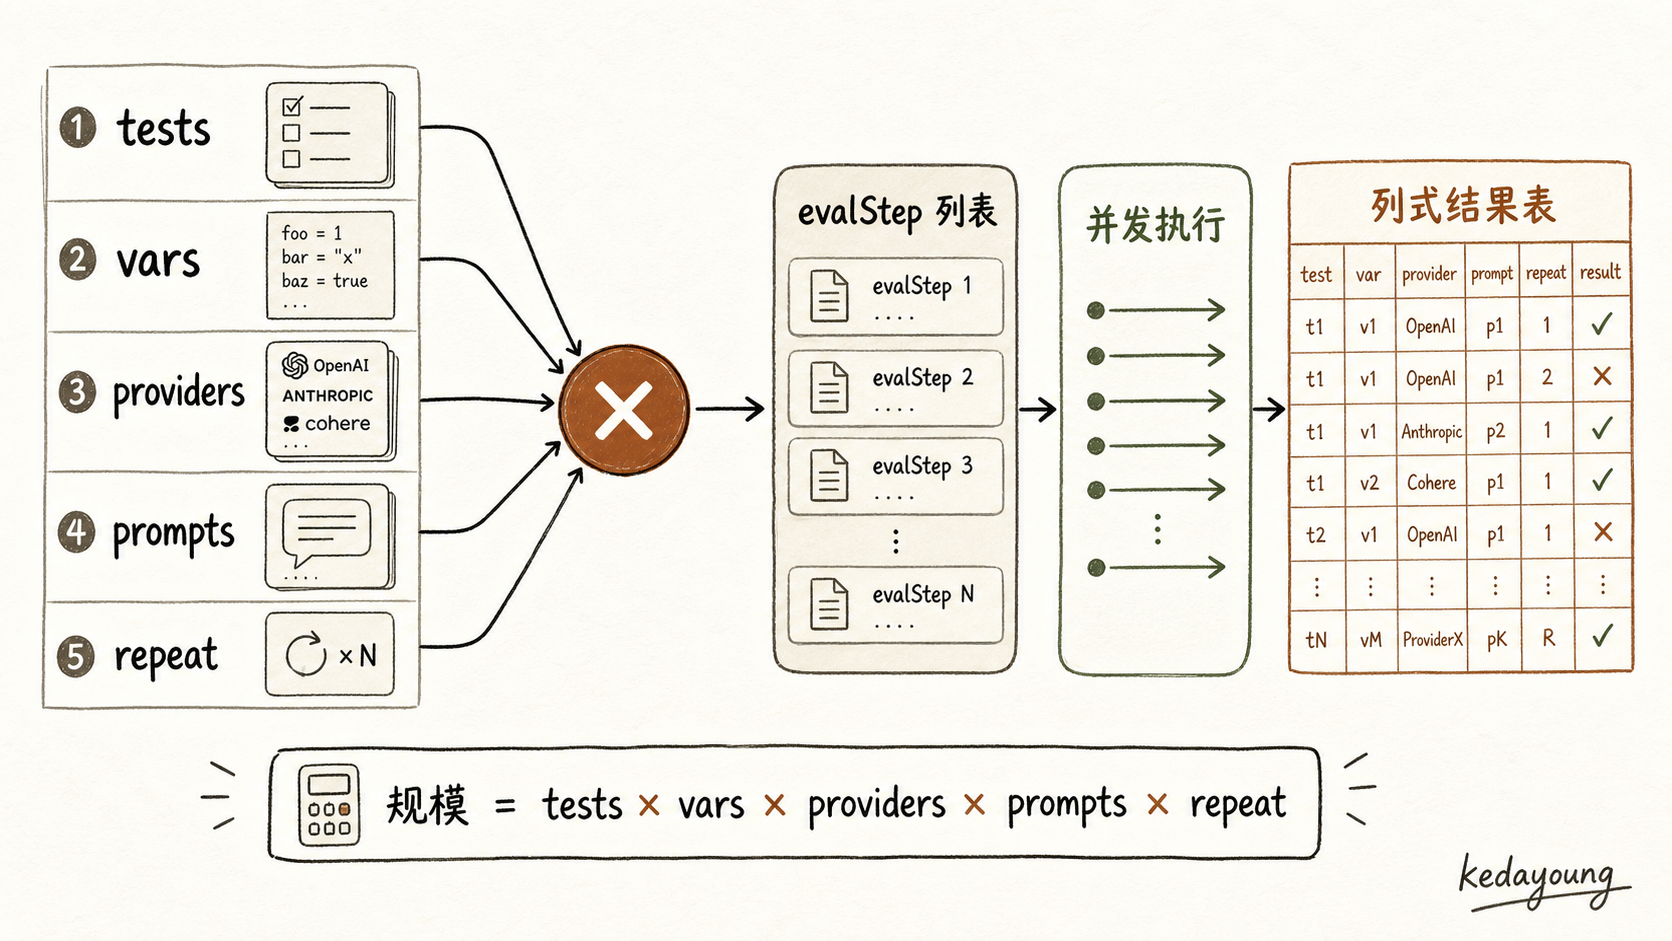
buildTestsFromSuite(调用点在 :4563,定义在 :2163)把套件里的测试、scenario 变体、defaultTest合并展平成原子测试列表;buildRunEvalOptions(调用点 :4574-4585,定义在 :2281)把「每个 (test × vars × provider × prompt × repeat)」压成一个evalStep——注意 repeat 重复次数也在这里展开,同一个测试可以跑 N 遍以观察随机性;appendRunEvalOptionsForProvider(:2526-2590)按 provider 逐列 push:每个 provider 会拿到它自己的完整步骤列,这就是后面「列式结果表」的来源。
展开完成后,每一个 evalStep 走 runEvalInternal(:1415-1619,函数体自 :1422):先渲染 prompt(把 vars 填进模板),再 callProviderForRunEval(:1493-1508)调被测模型,最后 gradeRunEvalResponse 跑断言(:1206-1300)。一条步骤 = 渲染 + 调用 + 判定,三步之间没有任何"分支"——这就是笛卡尔积能跑起来的前提:步骤之间彼此独立、可以并行。
这三步的职责分离也值得留意:渲染层只关心模板与变量,调用层只关心 provider 协议,判定层只关心断言——每一步都对应一个可替换的零件。模板语法变了只动渲染层,换了 provider 只动调用层,判定标准变了只动断言层。任务矩阵之所以能承载「多模型对比」「红队」这些不同场景,正是因为这层「步骤内部的三段式」没有被任何场景写死。
用一个具体数字感受展开规模:假设配置里有 2 条测试、2 组 vars 变体、2 个 provider、2 条 prompt,repeat 设为 2,那么 buildRunEvalOptions 会展开出 2 × 2 × 2 × 2 × 2 = 32 个 evalStep。写脚本时这 32 个步骤是你自己写出来的循环;在 promptfoo 里它们只是配置里的五个数字的笛卡尔积——评测规模由配置声明,不由代码行数决定。
并发如何控制?
展开出的步骤列表交给 runConcurrentEvalSteps(:3846-3877)执行,内部用 async.forEachOfLimit 做有界并发(限制同时进行的请求数,避免把 provider 打爆);针对「串行特性」(如 agent 轨迹类测试依赖前一步的上下文)有 adjustConcurrencyForSerialFeatures(调用点 :4590-4595,定义在 :2755)自动降并发;整个运行受 AbortController 管控(:4501-4529),支持超时与用户中止。
设计含义
「笛卡尔任务矩阵 + 列式结果表」是这套架构最核心的抽象。它让一次运行同时回答「多个模型、多个 prompt 在同批测试上谁更好」——这正是第 4 节多模型对比的基础。对写评测的人来说,它还有一个隐性收益:评测规模的思考被结构化。规模 = 测试数 × 变量组合 × provider 数 × prompt 数 × 重复次数,每一项都写在配置里、可以独立调参,而不是散落在脚本的循环里。「列式结果表」的具体形态在第 4 节展开。
图 2|任务矩阵展开示意
tests × vars × providers × prompts × repeat → evalStep 列表 → 并发执行 → 列式结果表。
3. 断言系统:从规则匹配到 LLM-as-judge
输出「对不对」由什么判定?
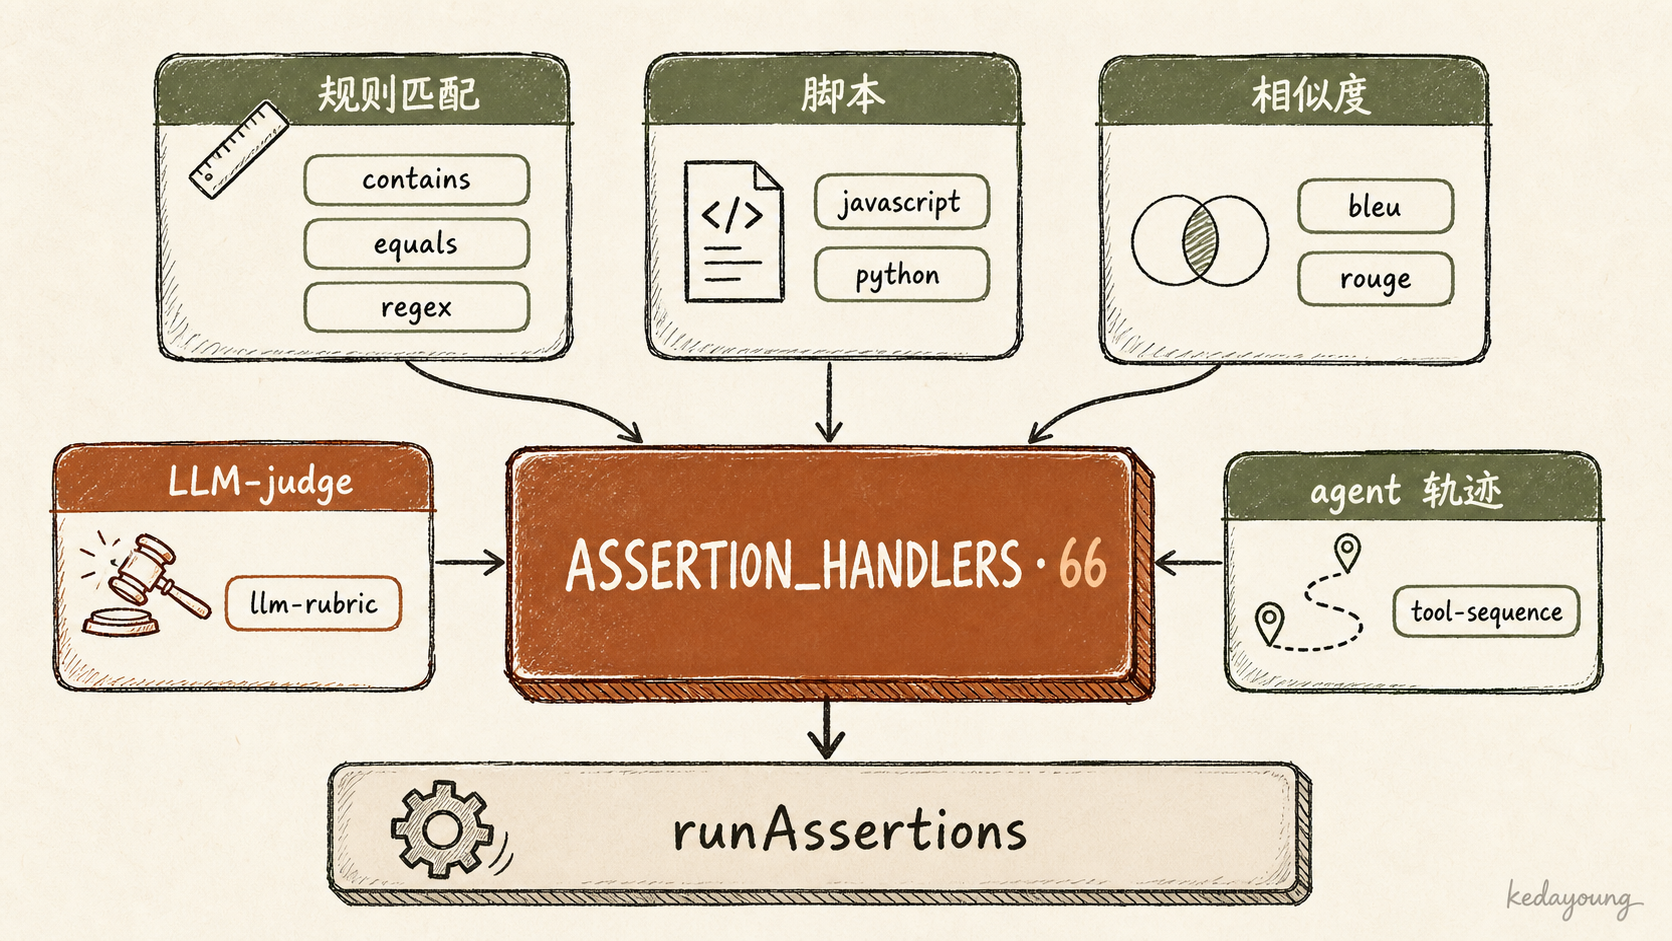
promptfoo 的判定不是写在 if-else 里的,而是一张可组合的断言注册表。核心是 ASSERTION_HANDLERS(src/assertions/index.ts:226-316)——按该注册表实际枚举,共 66 种断言。它们大致分五类:
| 类别 | 代表断言 | 判定方式 |
|---|---|---|
| 字符串 / 结构 | contains、equals、regex、is-json、contains-sql、starts-with | 对输出做规则匹配 |
| 脚本 | javascript、python、ruby、webhook | 把输出交给外部代码/服务判 |
| 文本相似度 | levenshtein、bleu、rouge-n、similar、meteor、gleu | 与参考答案算相似度 |
| LLM 打分 | llm-rubric、factuality、g-eval、answer-relevance、context-faithfulness | 用另一个模型当裁判 |
| agent 轨迹 | trajectory:goal-success、trajectory:tool-used、trajectory:tool-sequence、trajectory:tool-args-match、tool-call-f1 | 对 agent 的调用轨迹断言 |
模型评模型是一等公民
MODEL_GRADED_ASSERTION_TYPES(index.ts:122-134)显式列出 11 种走模型判分的类型(llm-rubric、factuality、g-eval、trajectory:goal-success 等),实现集中在 llmRubric.ts(:28-36,matchesLlmRubric 调 grader 模型;inverse 断言时取 1 - score)。对于开放式答案,规则匹配根本写不出来——「这个回答是否忠实于给定文档」没法用正则表达,只能用模型评模型。
断言在配置里长什么样
在配置里,断言长这样:
tests:
  - vars:
      question: "鲁迅的原名是什么?"
    assert:
      # 规则判:必须包含某个词
      - type: contains
        value: "周树人"
      # LLM 判:整体回答是否准确(开放式判法)
      - type: llm-rubric
        value: "回答要准确指出鲁迅原名,错误则失败"
      # 反向断言:不得出现推脱
      - type: not-contains
        value: "无法回答"
同一条输出可以同时挂规则断言、LLM 断言和反向断言——runAssertions 逐条执行后汇总成这条用例的最终 pass/fail。三种判法混用不是「高级玩法」,而是日常写法:能用规则的地方用规则(快、零成本),规则表达不了的地方交给 LLM judge。
判定路径与组合能力
单条判定走 runAssertion(:406-673),支持 file:// 引用外部断言文件、transform 预处理输出;批量判定走 runAssertions(:722-840),支持 assert-set 嵌套、weight(加权)与 threshold(阈值)。这些组合能力对应真实场景:assert-set 把一个维度(如"回答质量")的多个断言包成一组,组内部分失败不致命;weight 给核心断言加权,让"必须正确"的断言在汇总时占比更高;threshold 允许一组断言"达到多少比例就算过"——比如 5 条断言过 4 条即可,容忍边界情况。还有一个冷门但重要的细节:not- 反向前缀(:353-366)——isAssertionInverse / getAssertionBaseType 把 not-equals 拆成「取反 + 基础断言」,于是 contains、equals 这类规则断言的能力直接翻倍。
运行期的调用点很清晰:gradeRunEvalResponse 里先 runAssertions 再 applyGradingResult(evaluator.ts:1284-1298),把判定结果并回结果行;配置期则有 validateAssertions.ts:86-124 在跑之前校验断言写法。「校验前置 + 运行后置」保证了断言错误尽早暴露。
与 hello-agents 对照(架构层面):BFCL 把判定外置给官方工具、GAIA 用内置匹配(见 bfcl-gaia 篇第 3/4 节);promptfoo 则把判定做成了可组合的断言语言——规则、脚本、LLM 三种判法跑在同一套 runAssertions 机制里,只是 handler 不同。这意味着评测者不需要在「写死匹配」和「外挂裁判」之间二选一,而是按用例精度需求混搭。
设计含义
断言系统把「判对错」从评测脚本里彻底抽离成声明式资产——66 种断言 + not- 反转 + assert-set 组合,覆盖从精确匹配到开放主观判断的整个谱系。
图 3|断言五分类图
规则 / 脚本 / 相似度 / LLM-judge / agent 轨迹五类,汇入同一个 ASSERTION_HANDLERS 注册表(66 种),经 runAssertions 组合执行。
4. 多模型对比:providers 抽象与列式结果
同一组测试如何跑在多个模型上?
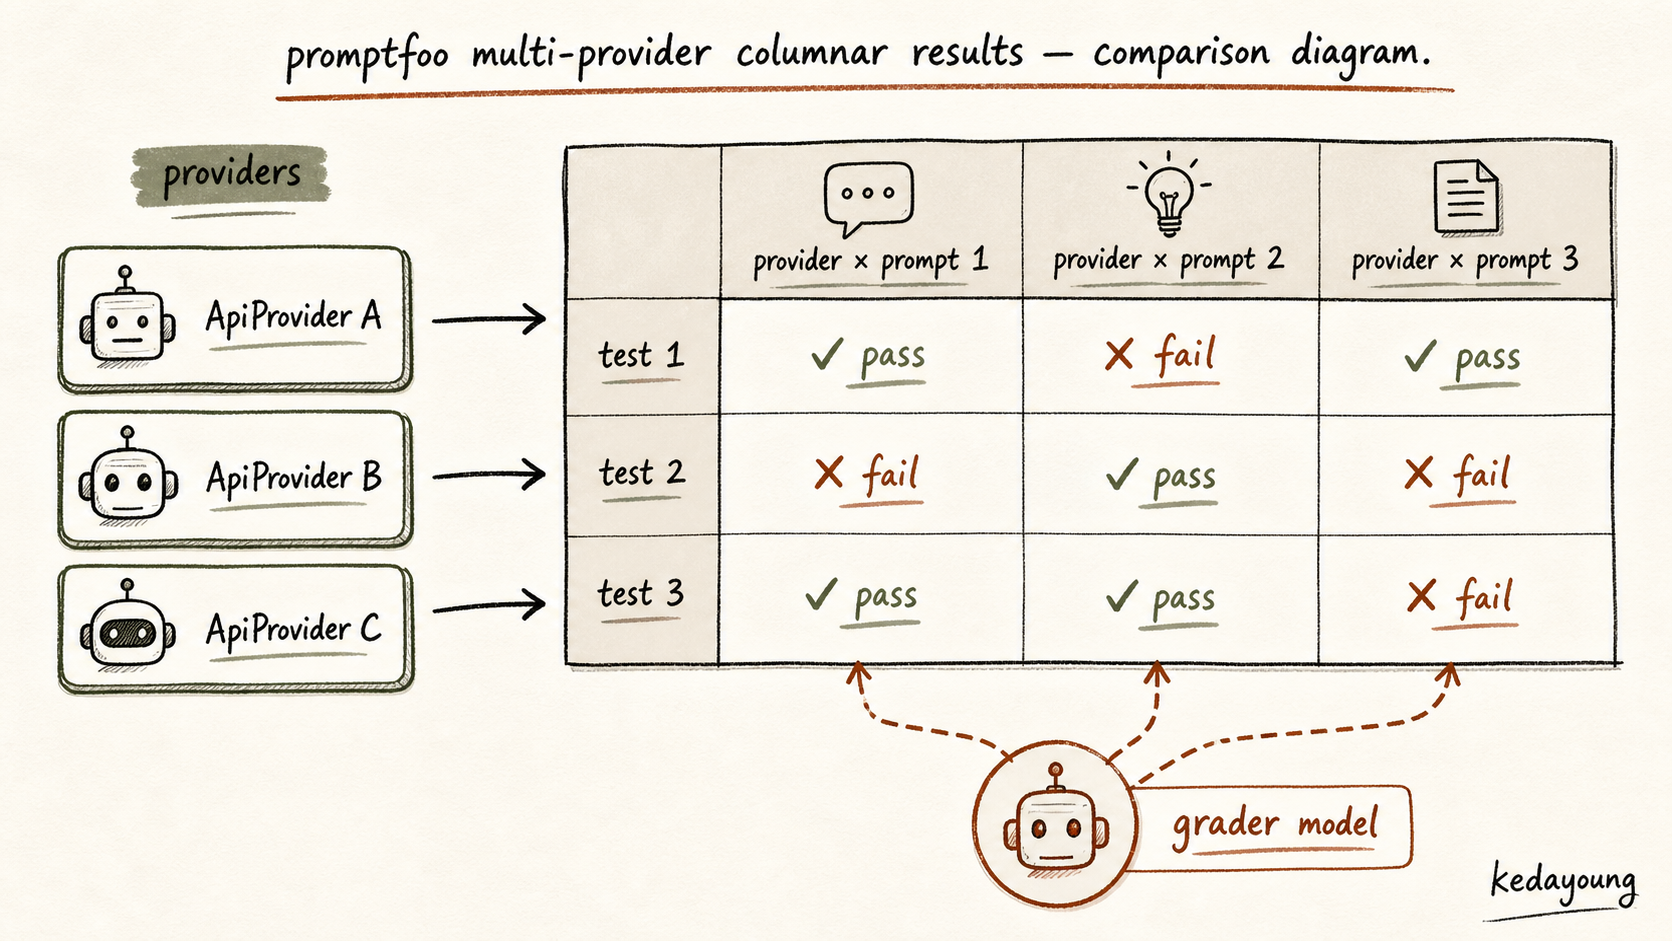
模型在 promptfoo 里被抽象成 ApiProvider 接口(src/types/providers.ts:123-140):一个 provider 只需要实现 id()(身份)、callApi()(发请求)、label()(展示名)、config(配置)。这个接口有多薄?薄到字符串就能声明一个 provider。
加载逻辑在 loadApiProviders()(src/providers/index.ts:370-442):它从配置的 providers 数组里逐个实例化——可以是 'openai:gpt-4o' 这样的字符串(通过 src/providers/registry.ts 的模型 ID 注册表解析)、可以是带参数的对象、可以是自定义函数、甚至可以是 file:// 引用的外部实现。换模型因此只是改配置数组里的一行字符串,测试集、断言、报告逻辑一概不动。
结果如何并排呈现?
执行完的任务矩阵按 (provider, prompt) 生成列:buildCompletedPrompts(src/evaluator.ts:2069-2112)把结果组织成「一列一个 provider×prompt」的结构,generateTable(src/table.ts:7-48)负责渲染成终端表格。行是测试用例,列是 provider×prompt,单元格是 通过/失败/分数——多模型对比不是事后手工拼表,而是任务矩阵展开方式的直接产物。
另一个关键细节:判分模型(grader)与被测模型可以分离。--grader 参数(doEval.ts:713-732)允许你指定「谁来当 LLM-judge」——被测模型和裁判模型分开指定,避免「让 gpt-4o 评测 gpt-4o」这类置信度问题。label() 用于结果表的列名展示;file:// 引用则允许把自定义 provider 写成独立文件(比如接团队内部模型服务)——加载逻辑与内置 provider 完全同一套。
对比一下两种换模型的方式。脚本式评测里,换模型意味着改 API 调用代码、改参数、重新验证;promptfoo 里则只是:
providers:
  - openai:gpt-4o
  # 换/加模型 = 改这一行,其余配置不动
  - anthropic:messages:claude-3-5-sonnet-latest
设计含义
多模型对比是「评测作为工程工具」的杀手级场景。换模型不改测试、不重写脚本、不手工拼表,只改 providers 数组——这正是评测对象泛化带来的红利:测试资产与模型解耦。
图 4|列式结果表示意
providers 数组实例化出多个 ApiProvider,结果按 provider×prompt 生成列,grader 模型可独立指定。
5. 回归与 CI:让评测成为可持续的工程资产
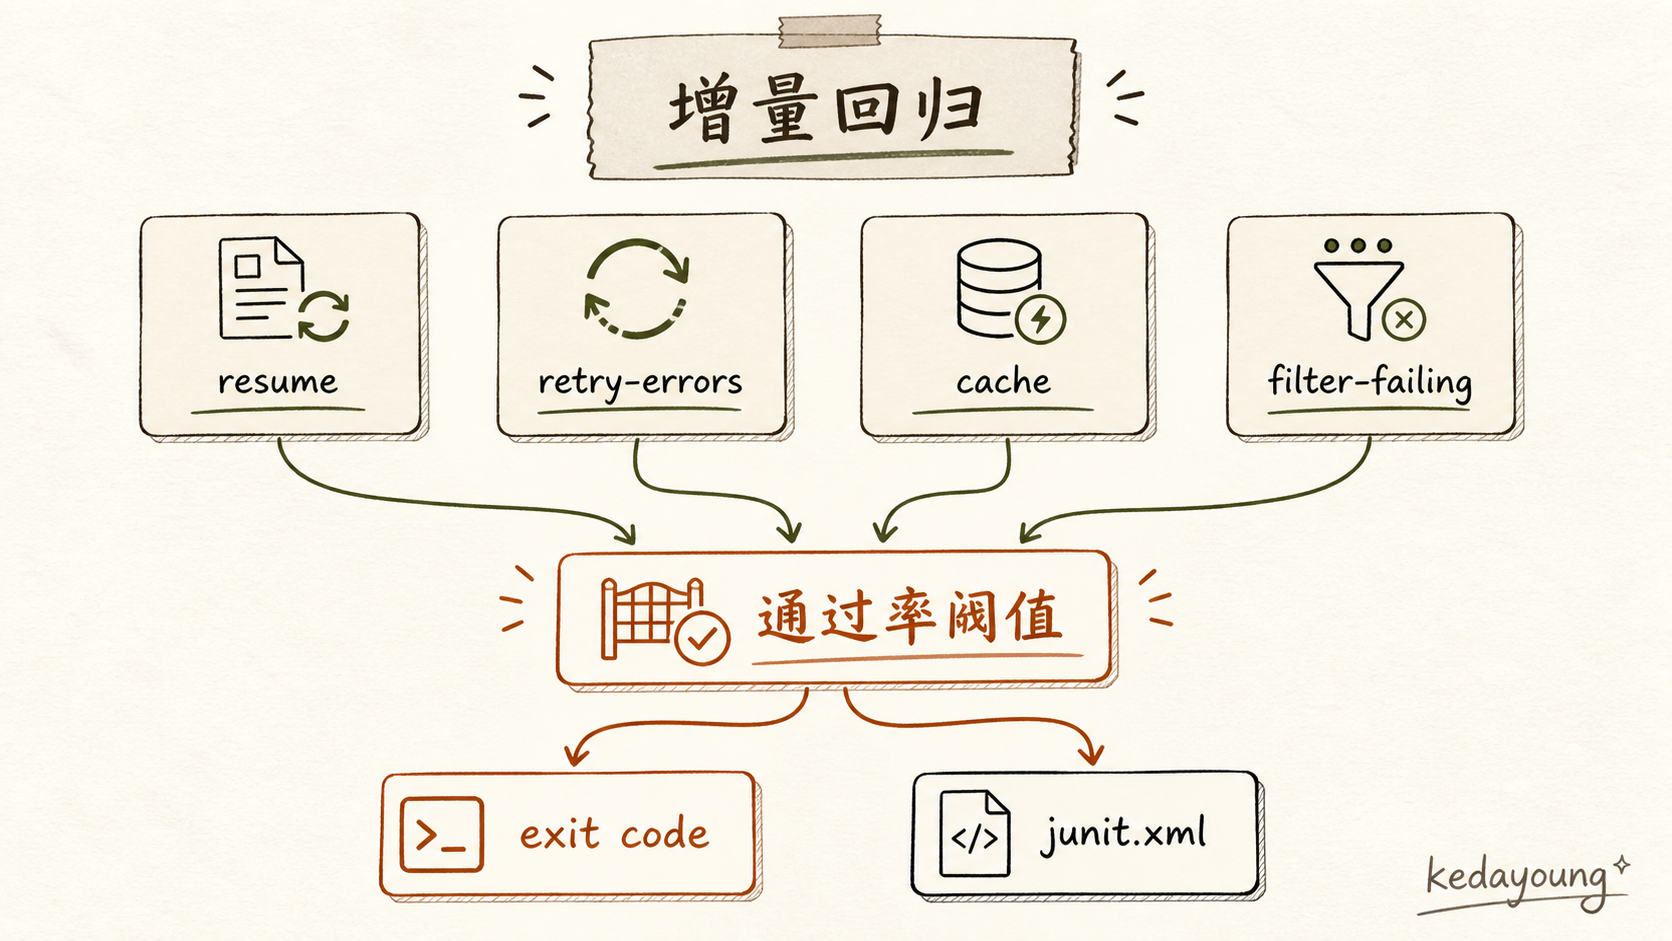
评测一旦接进研发流程,问题就从「怎么跑一次」变成「怎么一直跑」。promptfoo 的答案是四件套 + 一个门禁。
结果持久化
评测结果不只是一张终端表格。src/util/outputFormats.ts:9-16 定义了 9 种输出格式——csv(喂给表格工具)、json / jsonl(喂给脚本与数据管线)、html(人类可读报告)、junit.xml(喂给 CI 平台)等——writeOutput(src/util/output.ts:559-776)负责落盘;更重要的是 SQLite 持久化——Eval.create()(src/models/eval.ts:457)把每次运行存进本地库,配合 src/commands/view.ts:9-55 的 Web 查看器,每次评测都留痕、可回看、可比对。「跑完即忘」的脚本时代在这里结束:评测结果是有历史的。
增量回归:只跑变化的
--resume(doEval.ts:358-396):按 evalId(或latest)从数据库恢复,跳过已完成步骤——中断续跑;--retry-errors(:397-454):只重跑标记为 ERROR 的步骤(注意与--resume互斥,:337-343 有显式校验)——网络抖动导致的失败不必全量重跑;- 磁盘缓存(
src/cache.ts:71-105):缓存 provider 响应——同一个 prompt 发给同一个模型,结果直接复用,这是回归跑得快的前提; --filter-failing(:623-634):基于上次输出过滤,只跑上次失败的用例——CI 里常见的「先修红再补全」工作流。
进 CI:通过率阈值 → 退出码
回归的最终形态是门禁:PROMPTFOO_PASS_RATE_THRESHOLD(默认 100)与 PROMPTFOO_FAILED_TEST_EXIT_CODE(默认 100)两个环境变量(doEval.ts:1169-1185)把「通过率低于阈值」翻译成非零退出码;配合 junit.xml 输出(src/util/junit.ts)喂给 CI 平台,加上 CI 进度条(evaluator.ts:4625-4628),一条「promptfoo eval && 检查退出码」就变成了 merge 门禁。
一个典型的 CI 用法是:夜间回归任务跑全量(开着 cache 与 resume,中断可续),PR 合并门禁只跑 --filter-failing 的上次失败用例加新增用例,通过率阈值按分支收紧(示例阈值:主干 100%、功能分支 95%)。失败时 junit.xml 直接进 CI 平台的问题面板,开发不用再翻终端日志。这四件事(增量、门禁、留痕、可读报告)正是脚本式评测最缺、也最难自己补的工程能力。
设计含义
回归不是「重新跑一遍」,而是「只跑变化的 + 阈值判通过」。resume 管中断、retry-errors 管偶发失败、cache 管重复成本、filter-failing 管聚焦,退出码阈值管结论——四件套缺一不可,这正是 20260801-agent-evaluation-regression-research/ 主题要的工程答案。
图 5|回归四件套图
resume / retry-errors / cache / filter-failing 四条增量路径汇入通过率阈值,转成 CI 退出码门禁。
6. 红队:安全评测如何复用同一引擎
红队不是另一套系统
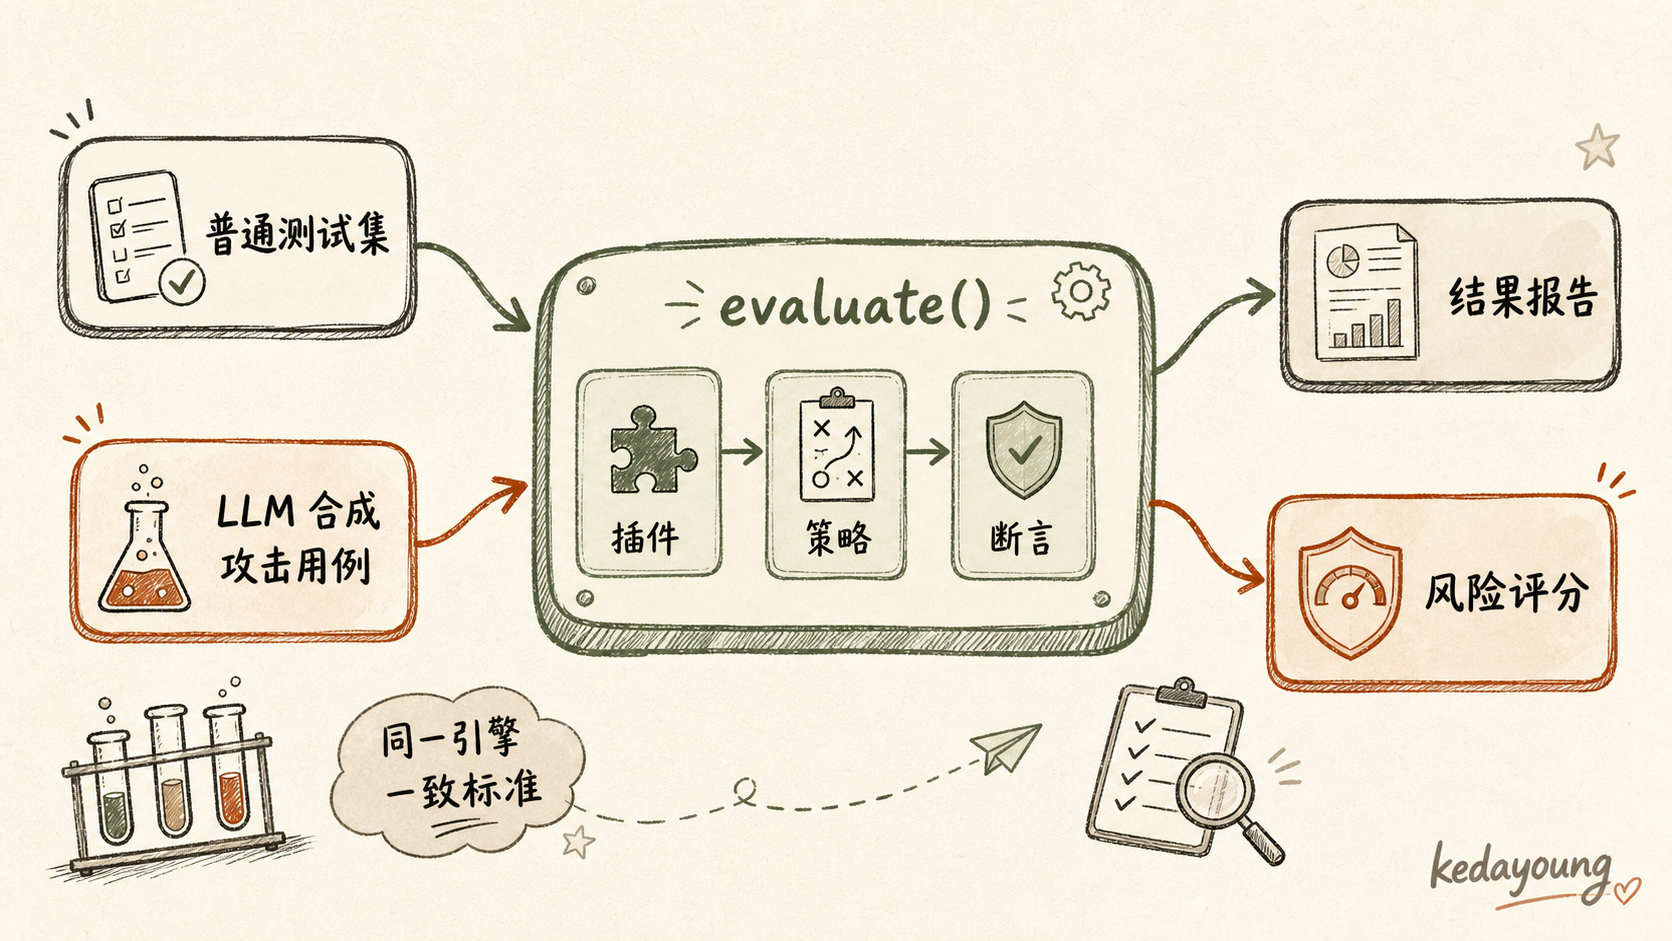
安全评测与功能评测在 promptfoo 里是同一套引擎:src/main.ts:125-129 把同一个 evalCommand 挂到 redteam 子命令下。这意味着第 2 节的任务矩阵、第 3 节的断言系统、第 5 节的报告与持久化,红队全部白拿。
攻击用例从哪来、怎么判?
- 用例生成:
synthesize()(src/redteam/index.ts:985起)按配置的plugins+strategies用 LLM 合成攻击测试用例。插件是「攻击目标」,70+ 个(src/redteam/plugins/index.ts:718,如sqlInjection、promptExtraction、dataExfil、pii、hallucination——这里写的是源码类名,配置 ID 为 kebab-case,如sql-injection);策略是「攻击手法」(src/redteam/strategies/,如jailbreak、crescendo、gcg、multilingual)。插件 × 策略又是一个笛卡尔积——与第 2 节的任务矩阵机制完全同构,只是测试来源从「手写用例」换成「LLM 合成」。 - 判定:合成用例带着
promptfoo:redteam:*断言走handleRedteam(src/assertions/redteam.ts:69-211),内部查GRADERS表(src/redteam/graders.ts:134)选对应的裁判逻辑——同样是「断言注册表 → handler」的既有路径。 - 风险评分:
calculatePluginRiskScore/calculateSystemRiskScore(src/redteam/riskScoring.ts:203-315)把 exploitability(可利用性)、complexity(复杂度)、severity(严重性)三个维度合成风险等级——这是安全场景特有的报告层增强,而不是新的执行路径。它的落地价值在于:一次红队运行可能产出大量失败用例,风险评分让团队能按"最需要修的高危项"排序处理,而不是面对一屏的失败无从下手。
红队配置的最小形态同样是一份声明:
redteam:
  plugins:
    - sql-injection
    - prompt-extraction
  strategies:
    - jailbreak
    - multilingual
promptfoo redteam run 之后,引擎会为 sql-injection × jailbreak、sql-injection × multilingual、prompt-extraction × jailbreak……逐个组合合成攻击用例,跑在同一条任务矩阵流水线上,最后产出带风险评分的报告。红队评测的「生成攻击用例」部分被 LLM 接管了——这是它和手写功能用例唯一实质不同的环节,而这一环节也被建模成了「配置驱动的笛卡尔积」。
设计含义
安全评测与功能评测共用「任务矩阵 + 断言 + 报告」,说明评测引擎是中性基础设施——功能与安全只是不同的测试来源。对工程团队来说,这意味着安全评测的接入成本约等于「写一份 redteam 配置」,而不是「再搭一套系统」。
图 6|红队复用示意
普通测试集与红队合成用例集汇入同一个 evaluate() 引擎;左侧为「插件 → 策略 → 断言 → 风险评分」的生成链。
7. 与教学管线的对照与可迁移经验
两条路线
hello-agents 教学管线与 promptfoo 工程工具代表了评测的两种取向,对照如下(架构层面,不涉及具体效果评价):
| 维度 | hello-agents 教学管线 | promptfoo 工程工具 |
|---|---|---|
| 评测对象 | 绑定 agent 实例(evaluate(agent)) | 泛化:prompt / provider / agent 轨迹都行 |
| 判定 | 外置官方工具(BFCL)/ 内置匹配(GAIA) | 可组合断言语言(66 种 + LLM judge) |
| 回归 | 脚本级(LLM Judge / WinRate) | 工程级(resume / cache / 退出码 / CI) |
| 多模型 | 无原生支持 | 列式对比一等公民 |
| 安全 | 无 | 红队内建 |
| 适合 | 理解评测原理、复现官方基准 | 把评测接进研发流程 |
读这张表要注意一点:两条路线不是竞争关系,而是分工。教学管线的价值在于把评测原理讲透——绑定 agent、外置判定、脚本级回归,每一步都可见可解释,适合入门和复现基准;promptfoo 的价值在于把评测成本降到可日常化——泛化对象、组合判定、工程级回归,适合把评测接进研发流程。一个团队完全可以在教学管线里理解原理,再用 promptfoo 落地日常回归;两者的取舍对象是「评测的工程化程度」,不是「谁更正确」。
可迁移的模式(作者判断,以下四条为本文的提炼而非源码结论)
以上对照描述的是 promptfoo 与 hello-agents 各自的设计取舍;下面四条则是从这套设计中提炼、可以脱离 promptfoo 单独迁移到任何评测项目的工程模式:
- 配置即评测:把测试声明成文件,可版本化、可评审、可继承——评测从「代码里的行为」变成「仓库里的资产」。落地动作:把第一个测试从代码断言改成配置文件里的
tests; - 任务矩阵:先展开笛卡尔积,再并发执行,最后列式呈现——用「规模 = 测试 × 变量 × provider × prompt × 重复」结构化思考评测规模,而不是写循环。落地动作:先画一张这样的表格,算清规模再动手;
- 判定与评测对象解耦:断言可组合,规则 / 脚本 / LLM 三种判法并存——判定能力是独立的、可替换的层,不绑定具体被测对象。落地动作:把判对错的逻辑抽成独立的函数或断言模块;
- 增量回归四件套:resume + 缓存 + 只跑失败 + 阈值门禁,缺一不可——回归的成本控制与结论判断同样重要。落地动作:先补结果落盘和失败重跑,再谈 CI 门禁。
这四步都不需要引入 promptfoo 就能做——它们是从本文源码分析里提炼的、与具体工具无关的工程模式。
系列内定位
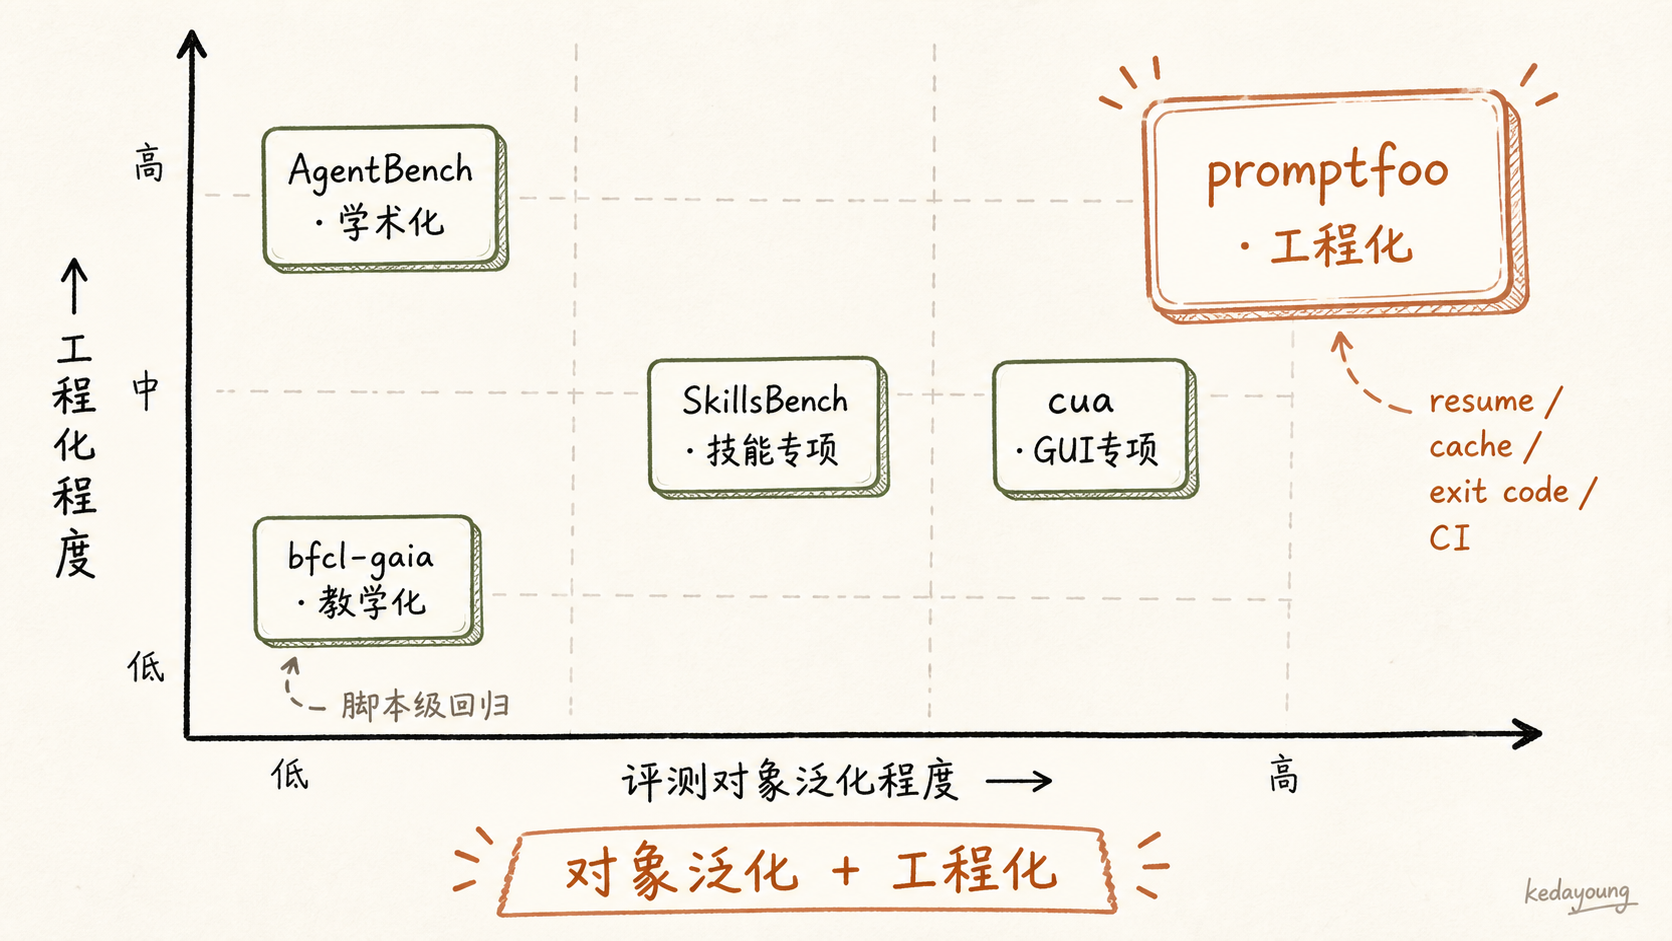
本系列评测主题至此已有四条路线:教学化(bfcl-gaia)、学术化(agentbench)、技能专项(skillsbench)、GUI 专项(cua)。promptfoo 是「工程化」的代表,是前几篇在生产侧的延伸——教学管线回答「评测原理是什么」,promptfoo 回答「评测怎么变成日常基础设施」。
收束中心论点:评测工具化的本质,是把「判定与执行」变成可组合的流水线。promptfoo 用「config → TestSuite → 笛卡尔任务矩阵 → 并发执行 → 断言 → 报告」证明了一件事:当判定(66 种断言 + LLM judge)与执行(并发、缓存、resume)都被拆成可组合的零件,功能评测与安全红队就能共享同一条流水线。回到开头那个「脚本死在仓库里」的循环,这里的结局不同了:评测声明进了配置文件、结果落进了数据库、门禁挂进了 CI——评测终于从「一次性脚本」变成了「有仓库、有历史、有门禁」的工程资产。
图 7|四条评测路线定位示意
横轴为评测对象泛化程度、纵轴为工程化程度;promptfoo 处于「对象泛化 + 工程化」的双高位置。
附录 A:证据清单(写作时逐条核对)
所有路径相对
0-agent-evaluation/20260810-promptfoo/repo/。成文日(2026-08-11 克隆快照)已对加粗项复核行号,未漂移。
| 断言 | 证据位置 |
|---|---|
| 配置读取与校验 | src/util/config/load.ts:328-443 |
| TestSuite 结构与校验 | src/util/config/load.ts:762-1103、src/types/index.ts:1164-1354 |
| 主流程与任务矩阵 | src/evaluator.ts:4490-4758、:2304-2328(备查)、:2526-2590 |
| 单步执行 | src/evaluator.ts:1415-1619、:1206-1300 |
| 并发控制 | src/evaluator.ts:3846-3877、:4501-4529 |
| 断言注册表与判定 | src/assertions/index.ts:226-316(实测 66 种)、:406-673、:722-840 |
| LLM-as-judge | src/assertions/llmRubric.ts:28-36、src/assertions/index.ts:122-134(11 种) |
| providers 抽象与加载 | src/types/providers.ts:123-140、src/providers/index.ts:370-442 |
| 列式结果表 | src/evaluator.ts:2069-2112、src/table.ts:7-48 |
| 输出格式与持久化 | src/util/outputFormats.ts:9-16、src/util/output.ts:559-776、src/models/eval.ts:457 |
| 回归四件套 | src/node/doEval.ts:358-454、:555-558(备查)、:623-634、src/cache.ts:71-105 |
| CI 退出码与 junit | src/node/doEval.ts:1169-1185、src/util/junit.ts |
| 红队复用与生成 | src/main.ts:125-129、src/redteam/index.ts:985、src/redteam/plugins/index.ts:718 |
| 红队判定与风险评分 | src/assertions/redteam.ts:69-211、src/redteam/graders.ts:134、src/redteam/riskScoring.ts:203-315 |
附录 B:素材缺口与待办
- [x] 复读
src/evaluator.ts主流程关键段(4490-4758、1415-1619),行号未随仓库更新漂移(克隆日 2026-08-11,成文日复核); - [x] 断言数量实测:
ASSERTION_HANDLERS注册表(src/assertions/index.ts:226-316)实际枚举 66 种,本文正文采用 66,未沿用大纲初版的「约 80」; - [ ] 未实际运行评测(本文只讲机制、不写跑分,符合写作边界);
- [ ] 红队部分未逐插件通读(
sqlInjection/promptExtraction等),仅描述「插件 → 策略 → 断言」机制,未涉及具体插件行为细节。