中心论点:Ratel(
ratel-ai/ratel,Rust)把「上下文工程」收敛为「工具与技能的选择」:完整 catalog 不进上下文,模型只拿到search_capabilities / invoke_tool / get_skill_content三个能力工具,按需检索出与当前轮相关的 top-K 能力并注入;检索以短文本调优的 BM25 为默认、语义检索可选、混合时用 RRF 融合,再用「自适应使用排名」让高频工具上浮。 证据说明:本地克隆0-context-engineering/20260810-ratel/repo/(main 分支快照,2026-08-11 克隆)。文中引用的行号均以该克隆为准,附录 A 给出逐条证据表。 成熟度声明:Ratel 是一个极新的项目(核心 0.7.0,2026-08-07 发布,src/core/CHANGELOG.md:9)。文中所有「已实现」与「宣称/未实现」均按仓库代码与 ADR 文档区分,引用前请自行复核。
摘要
Ratel(ratel-ai/ratel,Rust)把「上下文工程」收敛为一个具体问题——工具与技能的选择,并以此做成一个专注「模型每轮看到哪些工具和技能」的检索层。它的主张直白:系统提示里的每个工具 schema、每个 skill 都是每轮付费的 token;目录一旦膨胀,模型就会选错工具。它的解法是渐进式披露(progressive disclosure):完整 catalog 不进上下文,模型只拿到 search_capabilities / invoke_tool / get_skill_content 三个能力工具,按需检索出与当前轮相关的 top-K 能力并注入;检索以短文本调优的 BM25 为默认、语义检索可选、混合时用 RRF 融合,再用「自适应使用排名」让高频工具上浮。
这是一个「机制聚焦、设计有 ADR 背书、代码量适中但项目极新」的实践——适合作为「新项目如何系统性设计上下文工程」的案例。它的价值一半在机制(渐进式披露 + 短文本检索),一半在方法(用 ADR 记录每一步检索设计决策)。但对它的效果宣称要保留怀疑:仓库内没有任何实测数据,README 指向的外部 benchmark 才是数字的来源。
1. 一个问题:工具目录是上下文里最贵的常驻内容
工具过载是上下文工程问题,不是调度问题
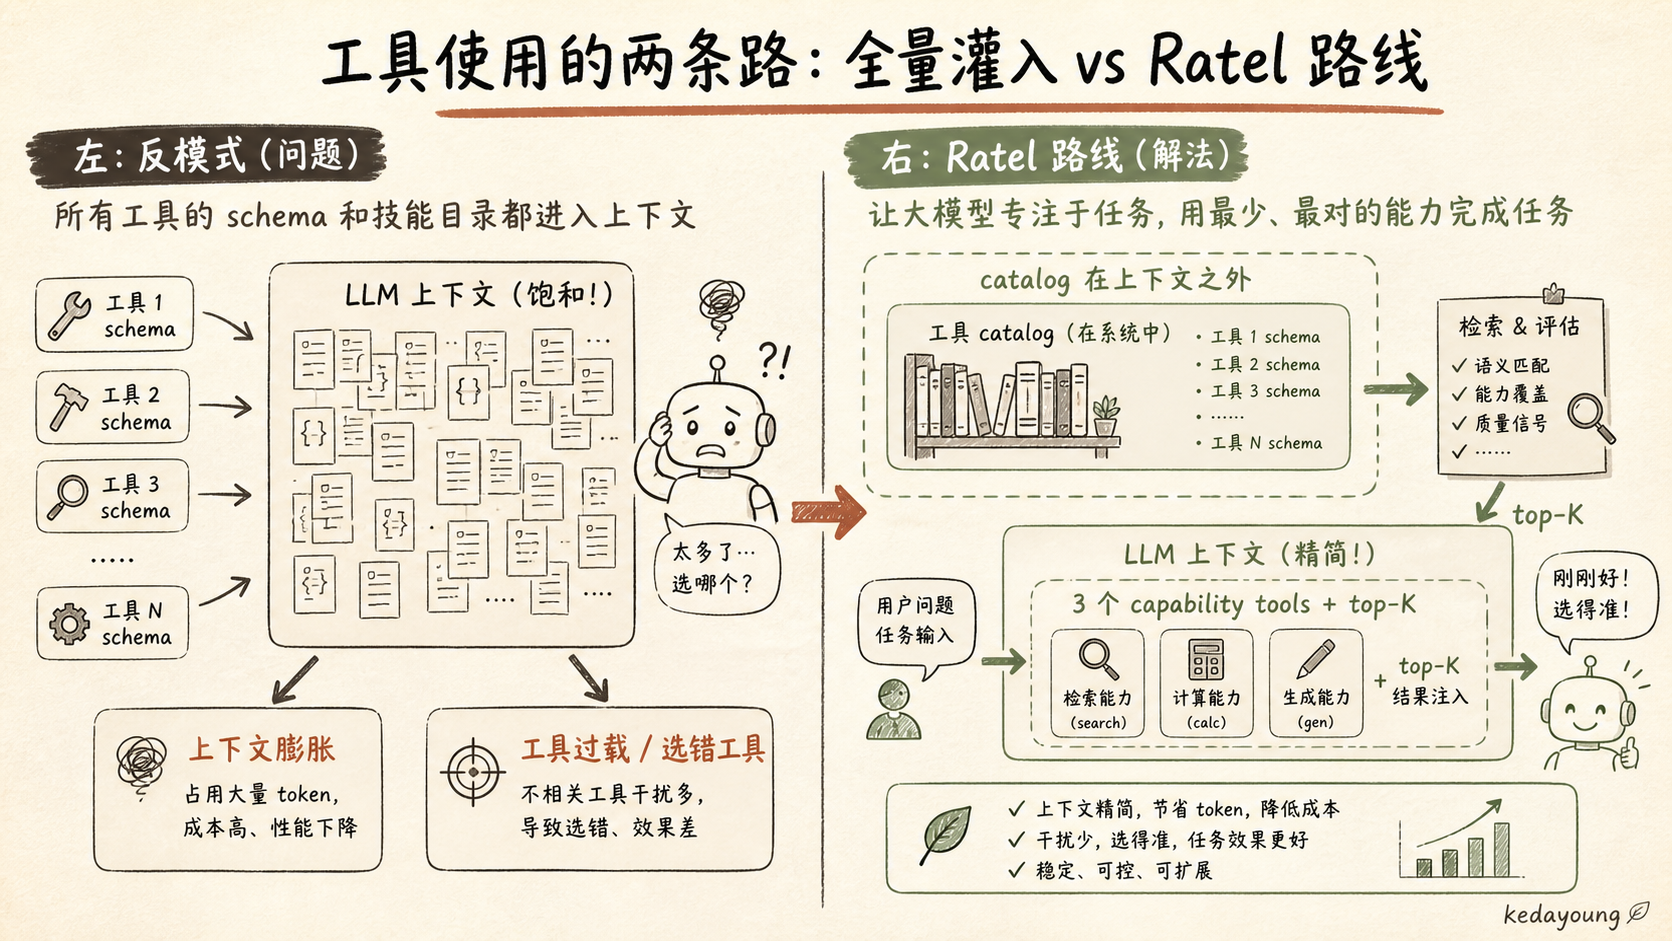
做过 Agent 的人都有这个体验:工具从 5 个涨到 50 个,模型开始「挑错工具」——它明明该调用 send_email,却去调了 create_issue(示意例子)。Ratel 的 README 把这个问题定义得很清楚(README.md:31-33):
- 成本:系统提示里每个工具 schema、每个 skill、每一条指令,都是你在每一轮都要付费的 token。全量发上去,就每轮全量付费。
- 准确率:上下文越长模型越差。把一轮用不到的工具、技能、指令塞满上下文,模型就会选错选项、偏离任务。
两个问题同源:工具目录常驻,上下文就得为「可能用到的能力」付费,而不是为「本轮用到的能力」付费。Ratel 称模型在工具过多时「选错选项并漂移离题」为 tool overload——工具过载(README.md:27,32)。历史对话可以截断、压缩、遗忘,工具目录却没有「暂时不需要」的形态——它是结构性的每轮常驻,这正是标题说它「最贵」的原因。
定位:一个检索层,不是一个框架
Ratel 给自己的定位是一句话(README.md:27):
The context engineering layer for AI agents.
上下文工程层——不是 agent 框架、不是向量库、不是 RAG。它回答的问题是「模型每轮看到哪些工具和技能」,而不是「agent 怎么跑循环、怎么调度」。它把自己的边界划得很清楚(llms.txt:22-28):
- 不是向量数据库:默认检索是确定性的 BM25,语义/混合模式用进程内模型或配置的 embedding 端点,始终没有要运维的向量库。
- 不是 RAG 管道:它检索的是工具,不是文档;别把它当文档 RAG 用。
- 不是 agent 框架:它不跑工具循环、不管理记忆、不调度轮次,只是把一个
ToolCatalog和三个能力工具交给你,包装进你自己框架的工具类型。 - 不是路由层:它决定模型看到哪些工具;模型仍然自己决定调用哪一个。检索不是分发。
这个「是什么/不是什么」的自我界定,是全文理解 Ratel 的钥匙:它刻意不做一个大而全的平台,而是只做「决定每轮可见能力」这一件事。
核心机制一句话
Ratel 的机制可以压缩成一句(README.md:33):
把工具和技能索引成一个 catalog,agent 对它渐进式披露——按需检索注入,而不是启动时全量加载。
「渐进式披露」不是 Ratel 发明的词,但它把这件事从设计原则落成了可运行的引擎:完整 catalog 永远在上下文之外,每一轮只把检索到的相关条目注入。这也让系列里其他项目的分工清晰起来:hello-agents / pi / Continue / opencode 管理「历史与证据」,Ratel 管理「能力面(tools/skills)」——一个此前没有被单独处理过的对象。一个 Agent 的上下文里,「过去说了什么」和「现在能做什么」是两类完全不同的信息,后者此前常常被简单粗暴地全量塞进去。
什么时候值得用
Ratel 的 llms.txt 对适用场景有明确划分(llms.txt:30-43),这本身就是一种边界意识,值得借鉴:
- 强适配:10+ 个工具、向数百个规模扩展的 mid-to-large catalog,且你能在 trace 里看到上下文膨胀或选择漂移;正在跑 MCP host(Claude Code、Cursor、ChatGPT)且挂了多个上游 MCP server、想要一个统一工具面;在 TS/Node 或 Python 里构建 agent;想要进程内检索、零基础设施。
- 弱适配:只有 3-5 个工具、模型本来就用得很好——Ratel 的开销不值得;想要向量库或文档 RAG——产品类别就错了;想要「今天就可用」的托管多租户 SaaS——那还只是方向(ADR-0002),不是能注册的产品。
这段「什么时候别用」写进面向 agent 的文档,避免了「检索层万能」的过度承诺——对工具选择问题,阈值是存在的,且被显式承认。
2. 渐进式披露:模型只见 3 个能力工具
引擎的承诺:catalog 在上下文之外
Ratel 的 Rust 核心对引擎定位写得非常直白(src/core/src/lib.rs:4-9):
Agents degrade when every tool definition is stuffed into the context window. This crate keeps the full catalog outside the context and retrieves only the entries relevant to the task at hand.
引擎不承诺「更好的调度」,它承诺「catalog 不进上下文」
工具和技能注册一次,之后每轮按需搜索。两个 registry 分别持有语料:ToolRegistry 索引可调用的 Tool(名字、描述、JSON schema),SkillRegistry 索引 Skill(可复用的指令 playbook,body 按需分派)。
模型面:三个硬编码的能力工具
在 SDK 的模型工具面上,模型实际看到的工具列表恰好是三个(src/sdk/ts/src/ratel.ts:381-391,modelTools() 只返回这三个):
| 能力工具 | 作用 |
|---|---|
search_capabilities | 用自然语言查询 catalog,返回 top-K 工具/技能命中 |
invoke_tool | 按 toolId 执行某个已披露的工具 |
get_skill_content | 按 skillId 取回某个技能的完整 body |
这是整个系统最关键的一步:模型永远有「入口」,但永远看不到「全集」。它想知道能做什么,就去搜;想用,就去调;想看某个技能的细节,再去取。工具目录从「每轮常驻的负担」变成了「按需可达的资源」。
对应地,仓库的 llms.txt 里有一条醒目的反模式警告(llms.txt:89-103):把全部 catalog 工具 wire 进 agent 的工具列表,就等于击败了这个系统。文档给出的正确姿势是只暴露三个能力工具(或「top-K 预过滤 + 能力工具」),让 catalog 通过检索可达,而不是全量展开:
// ❌ 反模式——把每个工具的全量 schema 都交给模型
const agentTools = catalog.tools;

// ✅ 正确——只暴露能力工具;catalog 经 search_capabilities / invoke_tool 按需可达
const agentTools = [searchCapabilitiesTool(catalog), invokeToolTool(catalog)];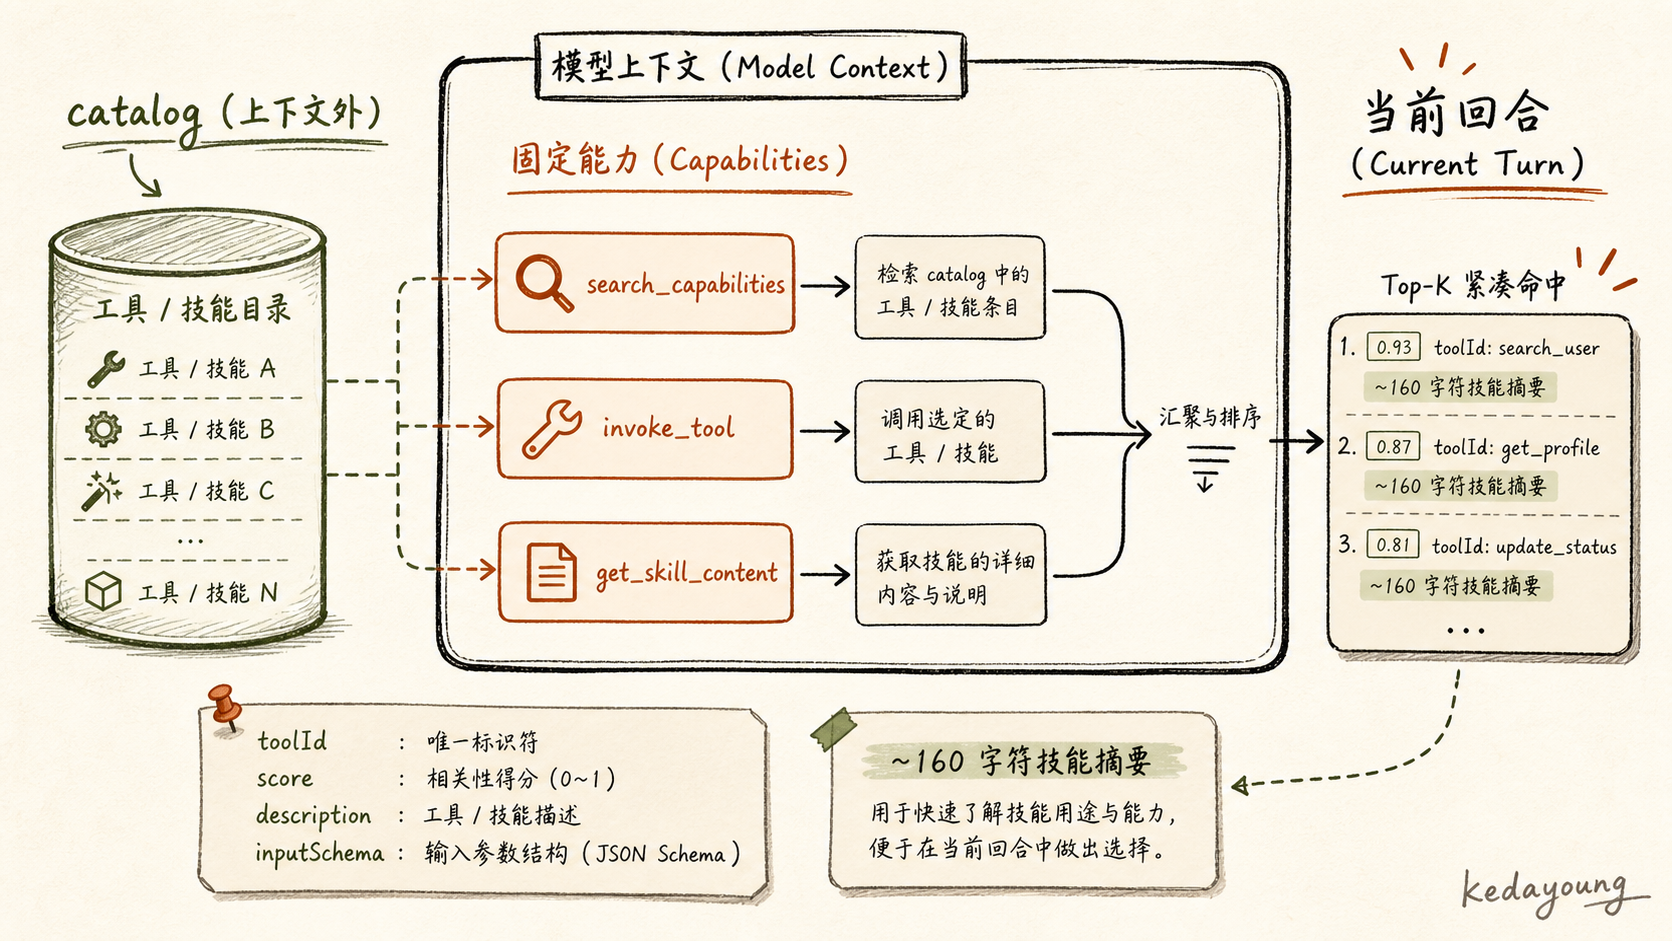
命中结果:结构化的精简形状
披露给模型的不是完整工具定义,而是一个刻意精简的结构(src/sdk/ts/src/capabilities.ts:92-106)。每个工具命中只带四样东西:
toolId——交给invoke_tool用的 catalog id;score——检索得分;description——注册时的描述;inputSchema——输入 JSON Schema,让模型不需要再查一次就能调用。
技能命中更精简(capabilities.ts:129-136):只有 skillId / score / description;描述还会被压缩到约 160 字符(src/sdk/ts/src/compact.ts:1-15,MAX_DESCRIPTION_LEN = 160)——空白折叠、词边界截断、补上省略号。技能正文(body)不会出现在命中里——那是 get_skill_content 的事。
search_capabilities 的结果形状:双桶与交叉授粉
search_capabilities 的结果不是一列扁平命中,而是两个独立排名的桶(capabilities.ts:143-151):tools(可执行工具,按上游服务器分组)与 skills(playbook)。每个桶有各自的 top-K 预算({ query, topKTools?, topKSkills? },默认 5 与 3,超过 50 封顶,capabilities.ts:185-190)。这样,相关技能不会被大量匹配工具挤出结果,也避免了跨两种文本形状比较 BM25 分数——工具与技能的索引形态不同,分数本不可比。
工具桶按上游服务器分组(capabilities.ts:114-126):每个 group 带服务器名与可选的描述/指令元数据,服务器按其最佳命中的排名位置出现。search_capabilities 的 tool description 甚至会动态嵌入上游服务器清单(- name — description (n tools) (auth required),capabilities.ts:162-176),让模型知道自己搜索的范围。
还有一个细节值得单独说——交叉授粉(cross-pollination):命中技能的声明依赖工具会被附加拉进工具桶:score 0、超出 topKTools 预算、与查询命中去重(capabilities.ts:188-190;e2e/scenario.json:42-49 有一条专门断言:查询与工具描述零词法重叠时,工具只能通过交叉授粉进入桶,且 score 必为 0)。这表示披露不是纯检索:技能与工具的依赖关系是一条显式的边,比「文本相似」更强的信号。
设计含义:把固定成本换成检索成本
渐进式披露的本质,是把「每轮固定成本(全量 schema)」换成「每轮检索成本(top-K)」。这个结构与系列里 pi 的 skills 渐进披露是同构的(见 20260810-pi/outline.md 第 2 节)——但 Ratel 把它引擎化、独立化了:不是某个 agent 顺手做的披露,而是一个专门的检索引擎,把「披露什么」变成可配置、可观测、可测试的产品能力。工具命中里的 inputSchema 值得注意:它没有被裁掉,因为「披露一个工具却让模型还要再查一次参数结构」会引入额外一轮往返——精简有度,不是越省越好。
3. 检索算法:为短文本调优的 BM25 与混合路线
为什么 BM25 要调参
工具和技能是短文本:一段描述几十个词,加上参数名和枚举值。这跟网页全文检索(长文档、高频词、强长度差异)是两种分布。Ratel 的 BM25 超参因此被刻意调低(src/core/src/search.rs:5-7):
// Tuned for short tool/skill descriptions; see ADR-0004.
pub(crate) const BM25_K1: f32 = 0.9;
pub(crate) const BM25_B: f32 = 0.4;
k1 = 0.9、b = 0.4 都比 bm25 crate 的默认值低。ADR-0004 给出了理由(docs/adr/0004-retrieval-and-tool-selection.md:37-42):工具描述短,词频饱和更快(所以降低 k1 让多命中仍能加分),长度归一化不那么重要(所以降低 b)。这组数字被当作「固定调优」而非公开旋钮——它写在 ADR 里、注释里,但不在公共 API 上。调参(k1/b)本身就是「上下文工程」的细节证据:检索质量不只是选什么算法,还包括为语料形态调过的每一个常数。
索引:检索什么,决定了披露什么
索引的输入不是原始工具定义,而是一个扁平化的「可检索文本」(src/core/src/indexing.rs,ADR-0004:26-35):按顺序拼接工具名、描述、每个 JSON Schema 属性(key、description、enum 字符串值),递归进入嵌套对象和数组 items;结构化 token(type、required、$ref、花括号、引号)被剔除。searchable_text 是契约:遥测、建议、一切检索层都构建在它之上,改它就是破坏性变更。
对技能(src/core/src/skill_indexing.rs:12-30),可检索文本只包含名字(整词 + 标识符拆分)、描述和 tag——body 被有意排除:
The
bodyis intentionally excluded — it is the dispatch payload, not a ranking signal (a 15 KB body would otherwise drown the description's term weights).
一个 15 KB 的技能正文如果进索引,会淹没描述的词权重;正文是 get_skill_content 的分派负载,不是排序信号。这里藏着 Ratel 的一个关键原则:索引面 = 披露面。索引里有什么,模型才搜得到什么;索引刻意不含的东西,就永远不会因为「长得像」而被误披露。对照工具侧:工具索引参数名与枚举值,技能索引 name/description/tags——共同点是结构化 payload 不参与排名(工具侧剥掉 JSON 结构 token,技能侧排除 body)。
三种检索方法与 RRF 融合
检索引擎可切换三种方法(src/core/src/method.rs:16-24,ADR-0011):
Bm25(默认):纯词法,不需要模型,永不失败,无模型可加载;Semantic:稠密余弦相似度,用可配置的进程内模型(默认bge-small-en-v1.5,src/core/src/lib.rs:26-27)或 OpenAI 兼容端点;Hybrid:BM25 与稠密两路排名用 RRF(Reciprocal Rank Fusion) 融合(src/core/src/fusion.rs:3-7),RRF_K = 60(Cormack et al. 2009 的领域标准值,fusion.rs:9-12),每路先取RETRIEVE_DEPTH = 100再融合(fusion.rs:14-16),深度大于top_k,是为了让两路排名不同的工具仍有排名信号可供融合。
RRF 融合的是排名位置而非原始分数,因此对 BM25(无界)与余弦([-1, 1])的量纲差异免疫。语义与混合搜索依赖一个预构建的 embedding 缓存——搜索本身永远不会实时 embedding 语料、不会下载模型(lib.rs:31-33)。
语义路径同样刻意照顾了复现性:零配置默认模型被钉在固定 commit(src/core/src/embedding_config.rs:23-27),保证 embedding 可复现;查询侧使用 bge 的非对称检索前缀指令("Represent this sentence for searching relevant passages: ",:26-27);pooling 模式(CLS / mean)从模型仓库的 1_Pooling/config.json 自动检测,避免用错模式静默劣化排名。
值得注意的实现细节:BM25 索引在全语料上构建一次并缓存,仅当 catalog 变更时重建(src/core/src/search.rs:9-14,CHANGELOG 0.7.0);每次查询对全语料排序后再截断到 top-K,并以 (score desc, id asc) 打破平分,保证跨进程的确定性(search.rs:55-81)——因为 bm25 crate 用 HashSet 收集候选,平分时可能因哈希种子不同而让 top-K 成员不稳定。
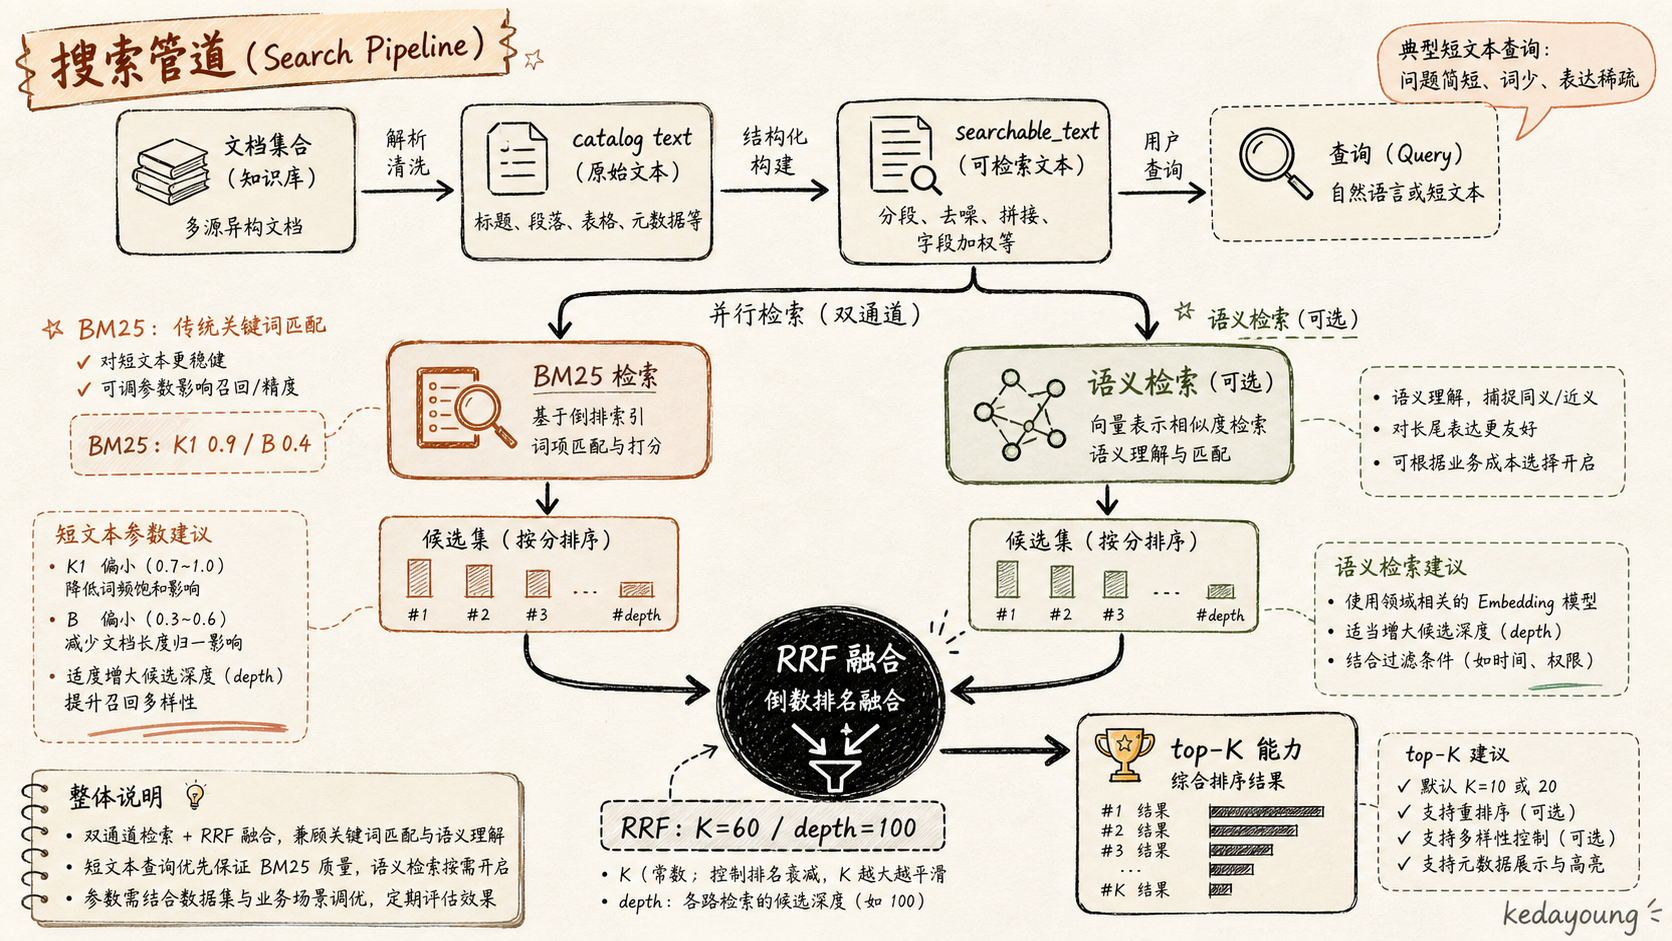
图 3|检索流水线:catalog 文本 →
searchable_text(标识符拆分)→ BM25/语义/RRF → top-K;标注调参点与 ADR 引用(ADR-0004 调参、ADR-0011 方法选择)。
设计含义:不是「向量库优先」
Ratel 的检索路线刻意不是「向量库优先」:短文本场景下 BM25 足够好、还便宜(无模型、无基础设施),语义是可选项。这一取舍与大多数「先进向量检索」叙事相反,但对工具选择这个具体问题,词法匹配往往已经命中了要害——用户的意图短语与工具描述的重叠词,正是最强的相关性信号。把 BM25 调参、方法选择、融合常数都写进 ADR,让「为什么这么调」成为可引用的设计记录——这是这套实践里方法论的亮点。
4. 自适应使用排名:让高频工具自然上浮
问题:除了相关性,还有什么信号?
注意:本节描述的功能目前标注 experimental,且其 Cloud 侧依赖尚未实现(见节末「状态警告」)。
BM25 是静态的:同样的查询永远返回同样的排名。但真实使用中,「最近常用的工具」比「历史上相关、却从未用过的工具」更可能是本轮想要的。Ratel 的 ADR-0014 增加了一个第三个 RRF arm(docs/adr/0014-adaptive-usage-ranking.md:32-35):
A third RRF arm, ranked by what users actually invoked after semantically similar queries, learned online.
即:第三个融合臂按「语义相似的查询之后用户实际调用了什么」来排序,且在线学习。它回答的是「除相关性外,什么信号决定该给模型哪些工具」——答案是使用历史。
意图图与打分
实现的核心是「意图图」(src/core/src/usage.rs):查询被聚成簇,每个簇带有指向「该簇成员之后被调用的能力」的加权边。打分进入 RRF 融合(ADR-0014:84-93):
score(id) = Σ_arms w_arm · 1 / (RRF_K + rank_arm(id))其中 w_bm25 = w_dense = 1,而 w_usage = W · min(1, support/3),且 W < 1(usage.rs:42-49,USAGE_WEIGHT = 0.5)。W < 1 是刻意的:同排名下,当前查询词法匹配上的能力,排在只有使用历史支持的能力前面;但亚单位权重仍然能让一个排名很深的能力越过另一臂的 rank-0 命中——因为它的 id 从两臂累积。亚单位阻尼了该臂,但没有禁用该臂。
support 缩放(support/3,SUPPORT_FULL = 3,usage.rs:36-40)也很关键:一个观察只轻轻推动排名,三个及以上观察才给满权重——一次误点不能成为策略。此外还有簇的 recency 衰减(90 天宽限期后每 90 天减半,ADR-0014:73-79),让过时话题淡出;ADR 自己注明这些常数是未经系统调参的默认值(unswept defaults,adr/0014:79)。
在线学习:只有「真实调用」才是证据
学习器(src/core/src/usage_learner.rs:19-27)有一条铁律,写在源码最显眼的位置:
Only invocations become edges. What retrieval returned is the ranker's own guess; recording it would teach the graph what it already believes and reinforce its mistakes. A search nobody acts on teaches nothing and is dropped.
只有调用成为边。 检索返回了什么,是排名器自己的猜测——把它记进去,等于教图去相信自己已有的错误。配对机制(usage_learner.rs:177-192)是:一次 Search 记下「待确认的查询」,一次 InvokeStart 与之配对,构成一条确认观察。一次搜索后调用三个工具,记三条边但只算一次观察(search_capabilities 一次查询会扇出到工具与技能两个 catalog,credit 放在共享图上避免重复计数,ADR-0014:62-72)。
语义/混合注册表还有一个「免费」的增强:查询 embedding 是检索时算好的,顺手存在图上,于是学习器能长出真正的簇质心,聚合同无词法重叠的表述(「delete a path」与「remove something」);纯 BM25 注册表不加载模型,只能聚到重复与近似重复(usage_learner.rs:33-43)。簇匹配按逐成员 Jaccard 打分而非成员并集(usage.rs:464-490)——并集只增不减,会让成熟的簇吸收无关请求;逐成员打分才能触及重复与近似重复。
融合路径
实际融合发生在注册表的搜索路径里(src/core/src/tool_registry.rs:587-640):先解析 usage arm(tool_registry.rs:327-377,未挂图则静默走原 BM25 路径,分数逐字节不变),命中则把检索深度提到 RETRIEVE_DEPTH = 100,再以 [BM25(1.0), usage(arm.weight())] 两臂做加权 RRF。「模型最常用什么」成为上下文的隐式信号——这是比纯相关性排序更进一步的设计:相关性是静态的文档属性,使用频率是动态的系统状态。
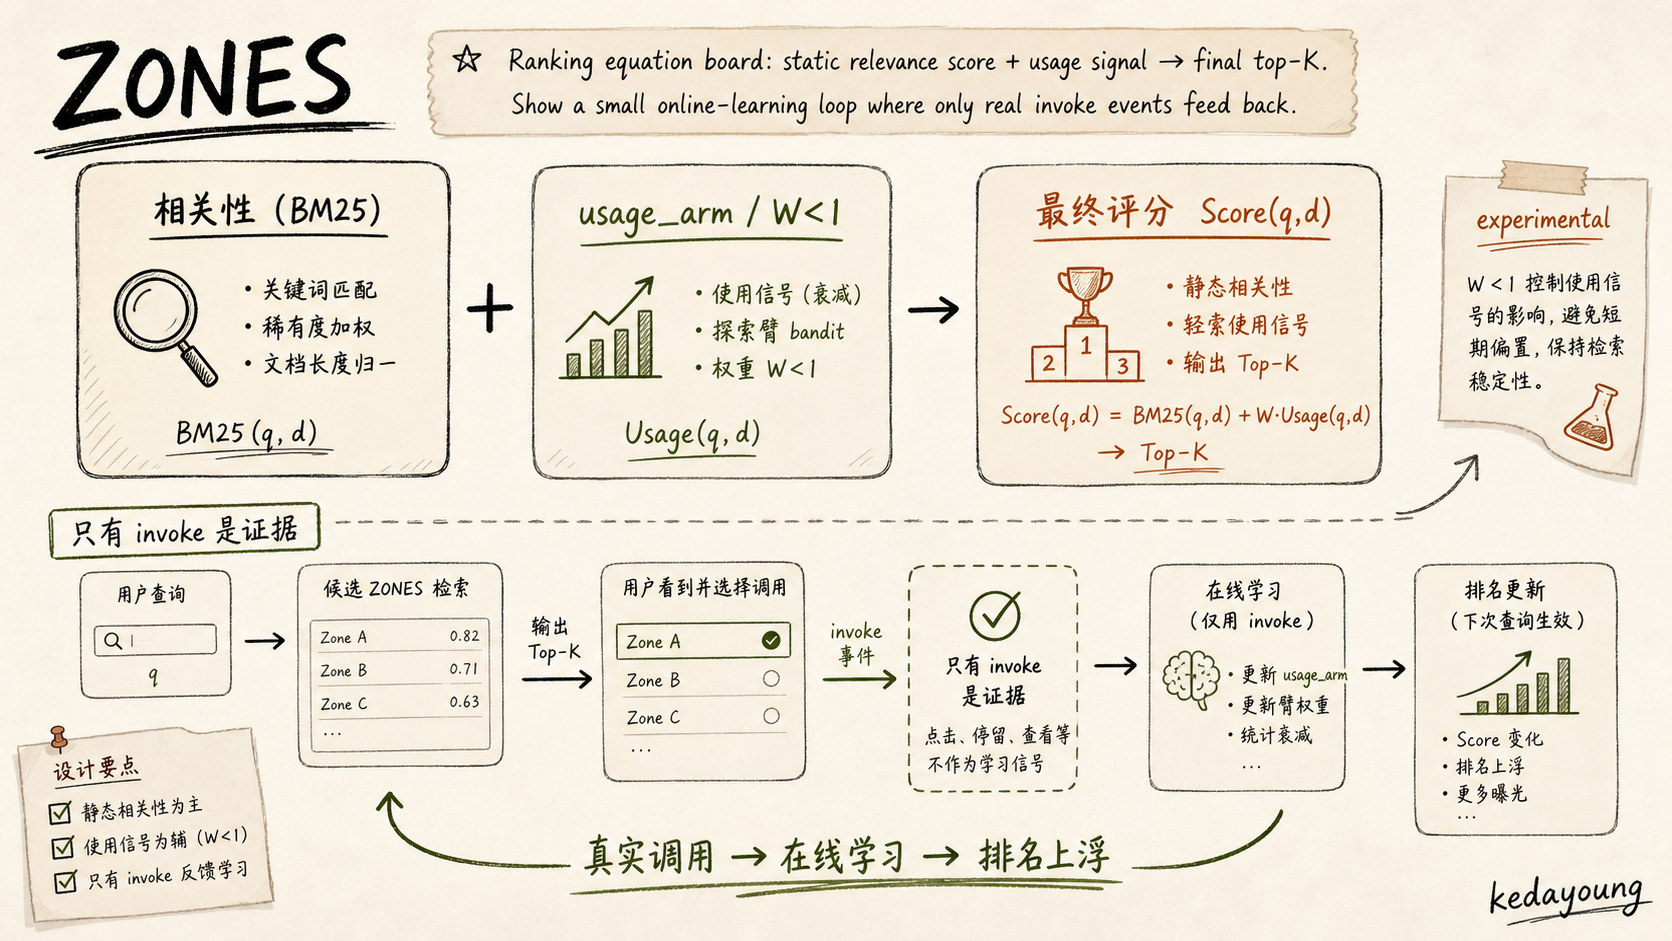
状态警告:experimental
还有一个值得借鉴的工程细节:usage arm 在「未命中」时是 absent(缺席)而非零权重——未匹配的查询与未挂图的注册表排名逐位一致(ADR-0014:87-88,tool_registry.rs:593-597 的无图路径)。语义/混合模式下,若图上质心所属模型与当前 embedding 指纹不符,arm 会被暂停而不是用错误向量空间硬算余弦(tool_registry.rs:331-346,UsageModelMismatch trace 事件)。「新机制永远不打扰默认路径」——这保证了渐进式披露的回退路径就是原始 BM25,任何时刻撤掉新机制都不改变行为。
ADR-0014 末尾明确交代了现状(docs/adr/0014-adaptive-usage-ranking.md:278-280):
...no
RATEL_URLorCatalogSourceexists insrc/— the seam is specified, not built.
即:suggest 模式与 Cloud/catalog-source 属于文档宣称而非代码现实——seam 被规格化但没有实现。自适应排名本身已实现且带测试,但它仍被标注为演进中的 experimental 功能。引用它时,必须带上这层标注。
5. 与 LLM 的交互:适配器、召回与合成消息
适配器:把能力检索嵌入框架的语言
Ratel 不要求你改框架。它提供 adaptTo 适配器(ADR-0013),已发布适配器的框架只有两个:Vercel AI SDK 与 Mastra(llms.txt:26)。以 Vercel AI SDK 适配器为例(src/adapters/ts-vercel-ai-sdk/src/aisdk.ts),它做三件事:
ingest(:85-132):把框架的工具翻译进 catalog——描述、input/output schema 归一化成 JSON Schema;无法被通用能力漏斗表达的工具(provider-defined、无execute、dynamic)直通(passthrough),不进 catalog。expose(:134-149):把 catalog 的能力工具翻译回框架的Tool形状;invoke_tool的 schema 会特殊包装,并透传框架的完整执行选项。recallMessages(:151-176):把一次检索结果合成为一轮特殊的对话消息——一条assistant的tool-call(调search_capabilities,带查询)+ 一条tool的tool-result(带序列化的检索结果)。对模型来说,能力检索看起来就是一次普通的工具调用回合。
SDK 与 MCP 双入口
除了适配器,Ratel 还有两个入口(src/sdk/ts/src/ratel.ts:326-476):ratel(config) 工厂返回带 modelTools() 的会话对象;adaptTo 接框架适配器。另有 MCP 面(src/sdk/ts/src/mcp.ts:175-214):registerMcpServer(catalog, {name, transport}) 连接上游 MCP 服务器 → tools/list → 把每个工具以 <server>__<toolName> 的命名空间 id 注册进 catalog——Ratel 在这里是 MCP 客户端,把别家服务器的工具收编进自己的目录。
注意方向:
@ratel-ai/mcp-server(sibling 仓库)的createMcpServer才是把 catalog 暴露成 MCP 服务器——Ratel 是 MCP 客户端(摄入),还是 MCP 服务器(暴露),方向相反,文档专门提醒不要混淆(llms.txt:105-121)。
遥测:每次披露都可观测
渐进式披露的每一次检索都有遥测可查。Ratel 的遥测就是 OpenTelemetry(src/telemetry/README.md:3-41):LLM 调用是 gen_ai. span,能力漏斗是 ratel. overlay,两个流(本地 JSONL trace + 远程 OTel)。SDK 发出的五种 span 形状里,与本文最相关的是:
ratel.search——检索本身(target / top_k / hit_count / origin,query 受内容门控);execute_tool <name>——工具执行(唯一的混合形状,同时带gen_ai.与ratel.属性);ratel.skill.load——技能正文加载。
在 TypeScript 里宿主自己持有 OpenTelemetry provider,SDK 只往已注册的 provider 上发射,不注册任何 provider(llms.txt:133-145)。换句话说:没有 provider 就没有遥测,而披露的行为也因此完全可审计——ratel.search 的每次 top-K 注入都能在追踪里看到。
文档还警告了一个很实际的陷阱(llms.txt:145):vendor span processor 可能在到达后端之前就静默丢弃大部分 Ratel 信号。例如 LangfuseSpanProcessor 只保留带 gen_ai.* 属性或来自已知 scope 的 span,而 @ratel-ai/sdk 不在其名单上——于是工具执行 span 幸存、每次 ratel.search / ratel.skill.load 检索 span 被无声丢弃。修复方法是按 instrumentation scope(@ratel-ai/sdk / ratel-ai)而不是按 ratel. 前缀配置 vendor。对「披露可观测」的承诺来说,这是最容易被环境破坏的一环。
行为契约:可验证的端到端承诺
仓库里有一份 e2e/scenario.json(:3-49),是跨 SDK 端到端测试的单一事实来源:Python 与 TypeScript 两个 runner 加载同一份 catalog + skills fixture,断言同一批行为——BM25 检索的 top-1、search_capabilities 的 top-K、get_skill_content、以及交叉授粉(cross-pollination,score 0 进工具桶,机制见第 2 节)。这是一份「可验证的披露行为契约」:渐进式披露不是口头设计,而是有跨语言测试钉死的行为。
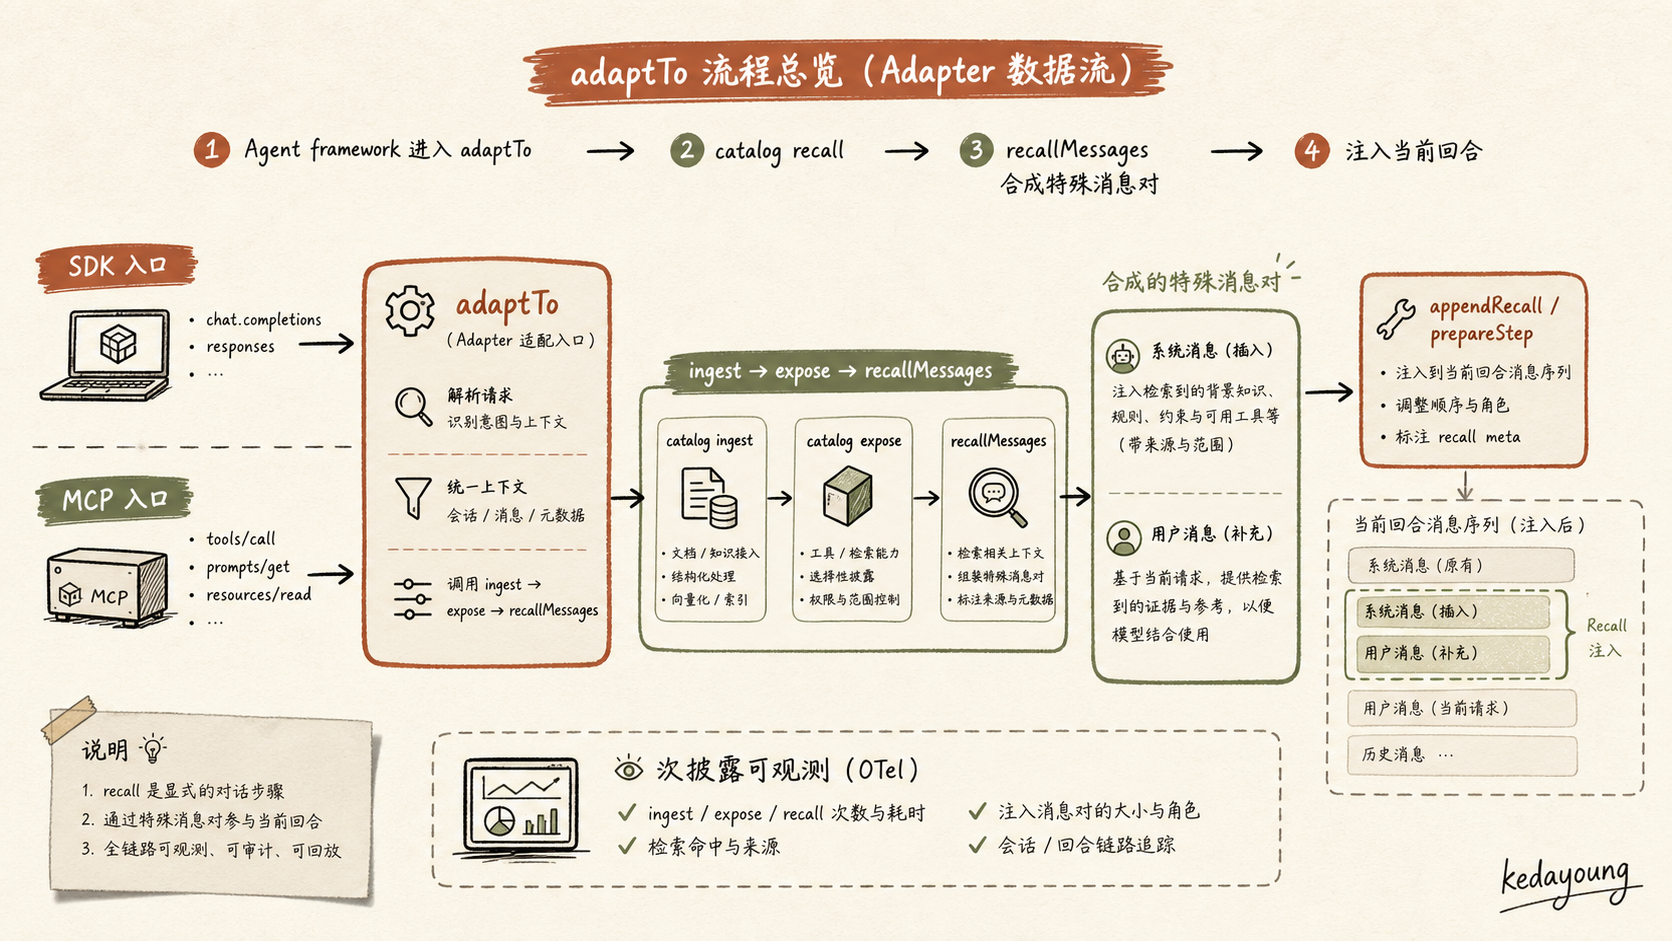
设计含义:披露是对话中的显式步骤
把「能力检索」做成对话中的显式步骤(recall),而不是启动时的隐式注入,是 Ratel 的一个关键选择。隐式注入发生在你看不见的地方,出了问题无从排查;显式 recall 让披露的时机与方式都可审计——模型先搜、再看结果、再决定调什么,每一步都在消息历史里。appendRecall / prepareStep(aisdk.ts:181-214)进一步把 recall 变成框架步骤里的可重复动作:每轮根据最后一条用户消息触发 recall,把合成消息对插回消息流;prepareStep 还会记住插入位置,在后续步骤重建 prompt 时把 recall 对原样放回,避免重复或丢失。
顺带说清一个容易混淆的点:工具注入的两种模式里,replace 是默认——每轮 agent 的工具列表就是 top-K 命中,整个 catalog 被替换掉;suggest 是 opt-in——catalog 留在工具列表里,Ratel 只提示该考虑哪些(llms.txt:147-153,ADR-0004:49-56)。replace 是「渐进式披露」的完整形态:token 削减直接且可归因;suggest 是给「改不了框架工具列表」的场景留的后门——但按附录 A 的成熟度核对,它属于文档宣称而非代码现实,以代码为准。
6. 成熟度评估、可迁移经验与系列定位
成熟度清单(诚实标注)
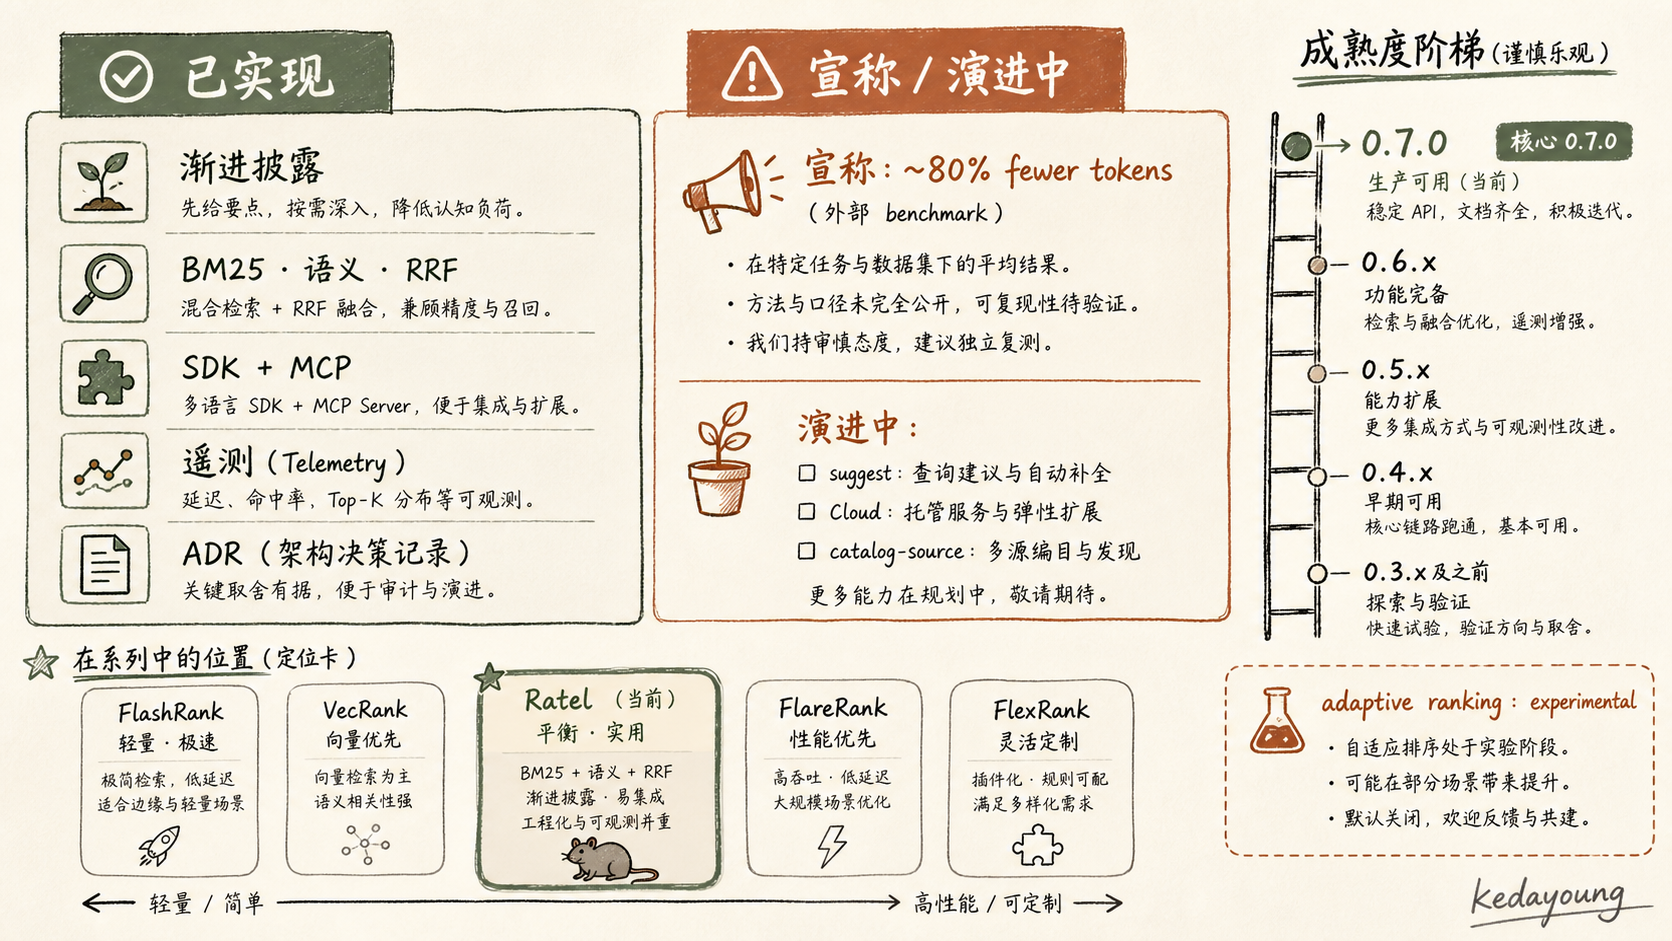
已实现(代码 + 测试可见):
- 渐进式披露引擎(catalog 在上下文外,按轮检索注入);
- BM25(短文本调参)/ 语义 / RRF 混合三种检索方法,BM25 索引缓存;
- 模型面三个能力工具(
search_capabilities / invoke_tool / get_skill_content); - 精简 hit 形状与技能描述压缩(~160 字符);
- SDK(TypeScript + Python)+ 两个框架适配器(Vercel AI SDK、Mastra)+ MCP 摄入(
registerMcpServer); - OTel 遥测与本地 trace 双流;
- ADR 文档体系(检索、方法、embedding、适配器、产品拆分……);
- 跨 SDK 端到端行为契约(
e2e/scenario.json)。
宣称 / 未实现(文档写了,代码里没有):
- token 削减与准确率恢复的具体数字:README 指向外部 benchmark(
benchmark.ratel.sh,README.md:35外链),仓库内没有任何实测数据——引用外部数字时需声明其非仓库内实测; suggest模式:ADR-0004 里是「opt-in」模式(llms.txt:147-153),但src/下仅有注释提及(src/core/src/trace/mod.rs:2、usage_learner.rs:9),无实现代码——文档宣称而非代码现实,需以代码为准;- Cloud / catalog-source:ADR-0014 明说
RATEL_URL/CatalogSourceseam 是规格化但未构建(adr/0014:278-280);Ratel Cloud 未公开(llms.txt:28)。
阶段判断: 核心 0.7.0(2026-08-07),共 23 个 Rust 源文件、约 1.4 万行(本次快照统计,含测试);自适应使用排名标注 experimental、仍在演进。这是一个机制清晰但非常新的项目——把它当「设计案例」读,比当「生产依赖」选,更符合它的实际成熟度。
可迁移模式(作者判断,非仓库声明)
- 把「能力面」从「历史与证据」中分离出来单独治理。工具/技能目录是上下文里一种独特的常驻内容,值得一个独立的检索层,而不是塞进记忆或对话历史的通用机制里。
- 3 个能力工具 + 按需披露。模型永远有入口(search / invoke / get content),但永远看不到全集;入口工具固定、内容按需取,披露本身变成对话中的一个显式、可审计的步骤。
- 短文本检索用 BM25 调参,而不是无脑向量化。工具描述是短文本,词法信号强;语义是可选项而非默认。调参(k1/b)写在 ADR 里,成为可引用的设计记录。
- 用 ADR 记录检索设计决策。BM25 调参、方法选择、自适应排名、为什么
W < 1、为什么只有 invoke 计入学习、为什么 arm 缺席而非零权重——「设计过程」本身成为项目的可引用资产。对一个检索引擎来说,可信度来自「每个数字都有出处」:k1=0.9不是因为随手,而是因为短文本的词频饱和特性;W=0.5不是因为好看,而是因为「一次误点不能成为策略」。这套 ADR 体系(0004 检索、0011 方法、0012 embedding、0013 适配器、0014 使用排名……)让接入方不必信任作者的结论,只需核对作者引用的理由。 - 只把「真实被调用」的放进使用学习。检索返回值是排名器自己的猜测,记它会强化已有错误;只有真实调用才进入学习,避免噪音污染排名。
系列定位
0-context-engineering 主题下,Ratel 是第五条路线:「能力面渐进式披露」的聚焦路线。与 pi 的 skills 披露呼应(同构机制),但独立成一个引擎;它也是本主题里唯一的 Rust 实现、唯一以「工具选择」为第一问题的实践。系列前四篇(hello-agents / pi / Continue / opencode)治理的对象是「历史与证据」,Ratel 治理的是「能力面」——这是两类互补的上下文治理维度。
收束中心论点
Ratel 证明了一件事:上下文工程可以聚焦到一个狭窄问题(工具/技能选择),并做出可运行、可审计的引擎。它的价值一半在机制(渐进式披露 + 短文本检索 + 使用学习),一半在方法(ADR 背书的系统性设计、明确的边界声明、跨语言测试钉死的行为契约)。但对它的效果宣称——尤其是 token 削减数字——要保留怀疑,以代码与 ADR 为准。对一个 0.7.0 的项目,最值得带走的不是它的结果数字,而是它把「上下文工程」拆成一个可设计、可实现、可验证的窄问题的过程本身。
附录 A:证据清单(写作时逐条核对)
| 断言 | 证据位置(0-context-engineering/20260810-ratel/repo/) |
|---|---|
| 定位与成本主张 | README.md:27、:31-35 |
| 边界声明(不是什么) | llms.txt:22-28、llms.txt:3 |
| 反模式警告 | llms.txt:89-103 |
| replace/suggest 模式 | llms.txt:147-153、docs/adr/0004-retrieval-and-tool-selection.md:49-56 |
| 引擎定位(catalog 在上下文外) | src/core/src/lib.rs:4-9 |
| 3 个能力工具 | src/sdk/ts/src/ratel.ts:381-391 |
| 精简 hit 形状与技能压缩 | src/sdk/ts/src/capabilities.ts:92-106、:129-136、compact.ts:1-15 |
| 索引面 = 披露面(searchable_text 契约) | docs/adr/0004-retrieval-and-tool-selection.md:21-47 |
| BM25 调参与实现 | src/core/src/search.rs:5-7、:28-81、:92-130 |
| 检索方法与 RRF | src/core/src/method.rs:16-24、src/core/src/fusion.rs:9-16、:37-53 |
| 索引内容控制(body 排除) | src/core/src/skill_indexing.rs:12-30 |
| 自适应使用排名 | src/core/src/usage.rs:36-62、:464-490、docs/adr/0014-adaptive-usage-ranking.md:32-93 |
| 在线学习(只有 invoke) | src/core/src/usage_learner.rs:19-27、:92-108、:177-192 |
| usage 融合路径 | src/core/src/tool_registry.rs:327-377、:587-640 |
| 适配器与合成消息 | src/adapters/ts-vercel-ai-sdk/src/aisdk.ts:85-214 |
| SDK/MCP 双入口 | src/sdk/ts/src/ratel.ts:326-476、src/sdk/ts/src/mcp.ts:175-214 |
| 遥测 span 清单 | src/telemetry/README.md:3-41 |
| 行为契约 | e2e/scenario.json:3-49 |
| 成熟度(0.7.0/experimental/Cloud 未公开) | src/core/CHANGELOG.md:9、docs/adr/0014-adaptive-usage-ranking.md:278-280、llms.txt:28 |
| 外部 benchmark(仓库无实测) | README.md:35(外链 benchmark.ratel.sh) |
附录 B:素材缺口与待办
- [ ] 成文前已核对
tool_registry.rs(1,843 行)与usage.rs(2,595 行)核心路径;skill_registry.rs(1,596 行)仅间接核对(经skill_indexing.rs与 scenario.json),如需深写第 2 节技能披露细节建议再通读。 - [ ] 已核实
suggest模式在src/下仅存于注释(src/core/src/trace/mod.rs:2、usage_learner.rs:9),无实现代码——第 6 节「文档宣称而非代码现实」的结论由此成立。 - [ ] 「~80% fewer tokens」类数字在仓库内未出现(仅
README.md:35外链 benchmark);若最终成文需要具体数字,须从benchmark.ratel.sh获取并声明「外部 benchmark,非仓库内实测」。 - [ ] 若要运行示例(
examples/),需 Node/Rust 环境 + 模型 key;运行则记录环境与日期。 - [x] 图 1–5 已替换为正式 PNG 图示。