证据来源:本地克隆
benchflow-ai/skillsbench(main 分支快照,2026-08-11 克隆,下称repo/)。文中所有repo/xxx:行号标注指向该快照,可按该快照核对。 阅读约定:本仓库是「任务集 + 编排/接入层」,Rollout 等执行细节由外部 BenchFlow SDK(uv.lock锁定 benchflow 0.6.3)承担;涉及 SDK 的部分只描述本仓库的调用面,不猜测其内部行为。
中心论点
评测对象不是 skill 文件本身,而是「把 skill 作为可复用程序知识加载进环境、完成专精任务的 agent」;同一任务的两个镜像(with-skill / no-skill)做对照,判定只看产物不看过程,并靠一套把任务版本、镜像、资源都钉死的工程机制保证可复现与防作弊。
~/.claude/skills/ 里放了十几个精心写的 skill,agent 也确实会加载它们——但换个问法就答不上来了:这些 skill 到底让 agent 变强了多少? 没有对照,只有「装了感觉有用」的体感,没有「不装就过不了」的证据。这正是 SkillsBench(benchflow-ai/skillsbench)要回答的问题:把「技能是否有效」从一个体感问题,落成一个可复现的对照评测。
SkillsBench 自称为 第一个评测「AI agent 使用 skills 能力」的基准(repo/README.md:8)。
下文按评测链路逐层拆开:先讲评测问题(第 1 节),再看任务怎么定义(第 2 节)、agent 怎么被执行与出分(第 3 节)、对照怎么做(第 4 节)、结果怎么锁进可复现链(第 5 节),最后对照其它评测路线提炼可迁移的模式(第 6 节)。
1. 评测问题:技能是否真的有用
一个容易混淆的评测对象
先说清楚 SkillsBench 不评测什么。它评测的不是某个 skill 文件写得好不好——不是「这份 markdown 指令是否清晰、这个脚本能否跑通」,而是「一个 agent 在拿到可复用的程序性知识后,能否把它们用起来完成专精任务」。
README.md:8 的定位语是 "The first benchmark for evaluating how well AI agents use skills"——注意动词是 use。紧接着第 14 行给出评测口径:We evaluate both skill effectiveness and agent behavior through gym-style benchmarking,即同时评测「技能有效性」和「agent 行为」。这里 "gym-style" 借的是强化学习「环境-动作-奖励」的交互模式:agent 在一个可控环境里行动,verifier 按产物给奖励,每次评测就是一次 episode——这正是第 3 节 Rollout 的由来。
这两个概念对应两种完全不同的评测设计:
- 评测技能本身:把 skill 当作被测对象,单独喂给某个 agent,看它能不能按 skill 的指令产出正确结果——skill 是变量,agent 是常量。
- 评测 agent 用技能的能力:agent 是变量,skill 是可用的环境资源;测的是 agent 在「知道有这些技能、但 prompt 里一个字都不提」的情况下,会不会发现它们、调用它们、并把它们组合起来完成任务。
SkillsBench 走的是后者。这从它的任务设计约束就能看出来:AGENTS.md:43-44 明确要求 prompt 里永不提及技能名("Never mention skill names in the task prompt"),且技能必须「通用可复用、非任务定制」("Skills must be generalizable and reusable, not task-specific")。也就是说,任务描述对被测 agent 而言就是一个普通任务,技能的存在只能靠 agent 自己去环境里发现——评测的是 agent 的技能感知与调用能力,而不是「照着 prompt 里写明的技能名去执行」的阅读理解能力。
仓库里其实并存着两种评测入口:AGENTS.md:16 列了 bench skills eval <skill-dir>(针对某个 skill 目录自身的 evals 判它质量如何),而 bench eval run --skill-mode with-skill(AGENTS.md:13-14)才是评测 agent 在任务里使用技能。前者是「技能质量」评测,后者是「技能使用能力」评测;SkillsBench 的 87 个默认可跑任务全部走后者。
研究问题与设计约束
仓库的分类学文档把这一设计收敛成一个正式研究问题(repo/taxonomy.md:7):
Do reusable procedural Skills improve agent performance across different domains of expertise?
「可复用的程序性技能,是否能在不同的专业领域里提升 agent 表现?」——这是一个可以做成对照实验的问题,因为它自带两个可比较的状态:有技能 / 没技能。
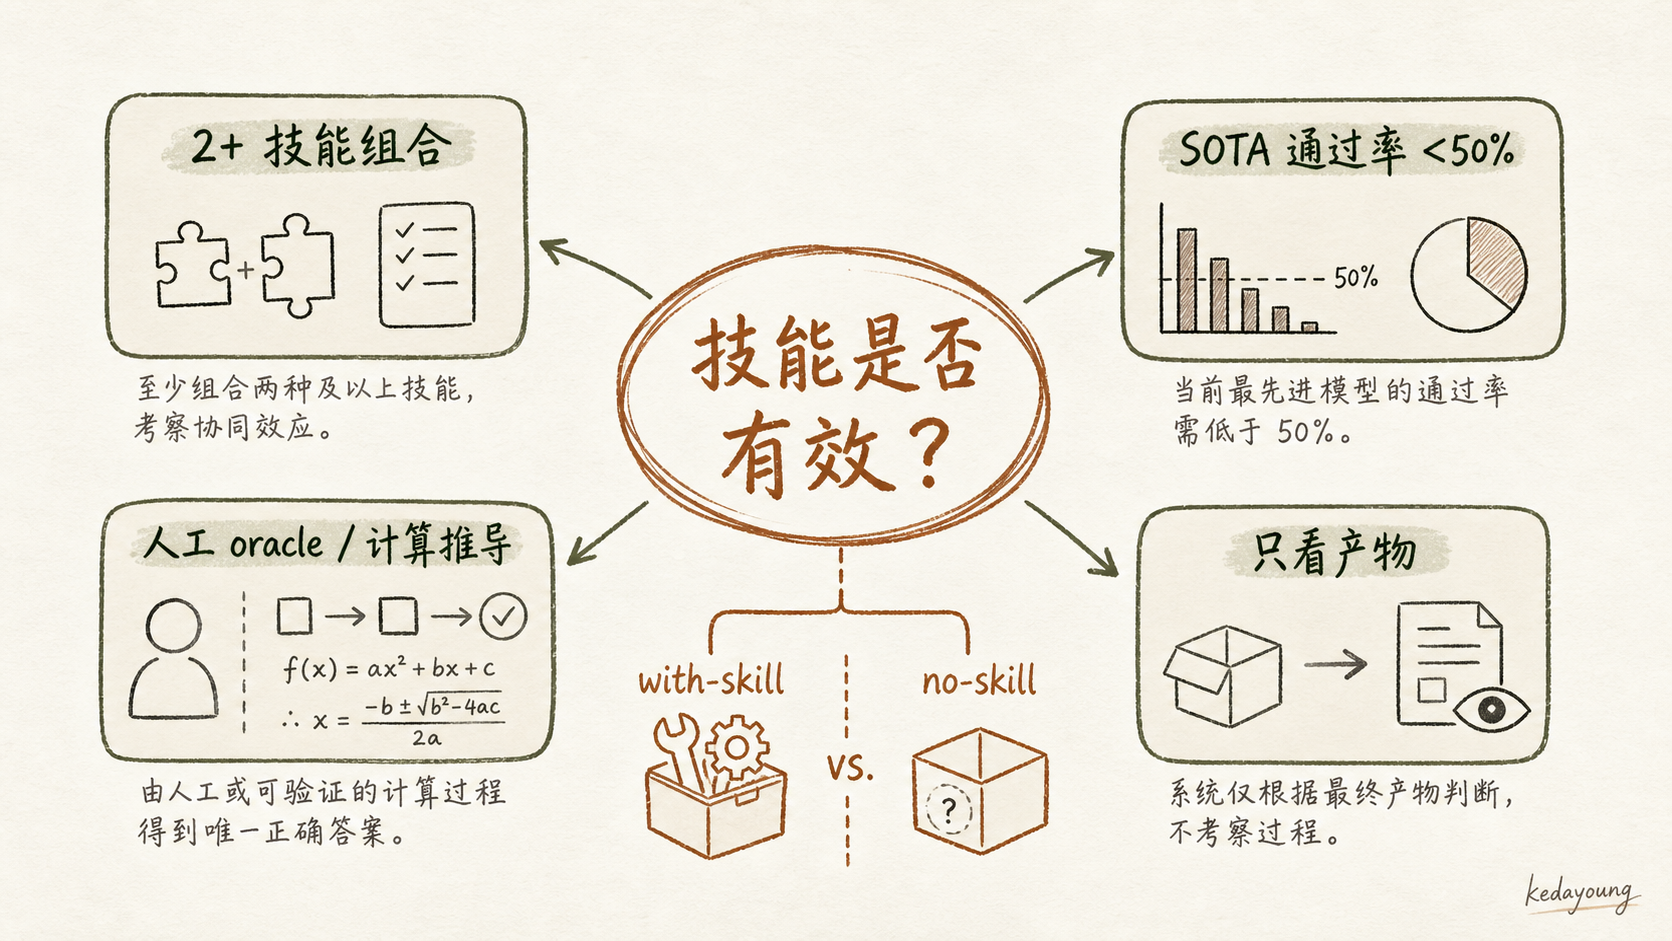
围绕这个问题,README.md:18 和 AGENTS.md:42-47 立了四条硬约束:
- 任务必须要求 2+ 技能组合,且目标 SOTA 通过率 <50%(
README.md:18)——保证任务足够难、足够「组合」,不是单技能点一下就能过的玩具题; - 技能必须通用可复用,prompt 不透露技能名(
AGENTS.md:43-44); - oracle 必须人工编写、通过计算推导答案、不硬编码(
AGENTS.md:42、:46)——参考答案本身不能被生成式模型「编」出来,也不能写死; - 判定只看产物不看过程(
AGENTS.md:45:"Tests verify outcomes, not process — don't check which tools were used")——这是整条评测链的判分哲学,与「轨迹打分」路线形成鲜明对照。
第 4 条值得单独强调:它意味着 verifier 不关心 agent 用了哪个工具、走了几步、有没有调用 skill——只关心最终产物对不对。产物对了,哪怕 agent 全程没用 skill 也判过;产物错了,哪怕它把 skill 用得出神入化也判不过。这把「技能是否有效」的度量完全押在了「是否更容易产出正确结果」上,从而与第 4 节的对照实验设计互为表里。
图 1|评测问题与设计约束图
研究问题拆出四条设计约束,其中「只看产物」决定了整套判分哲学。
2. 任务定义:一个 task.md 包长什么样
自包含的任务包结构
要把「技能是否有效」做成对照实验,前提是每个任务都能被完整地、独立地描述——环境、技能、参考答案、判分器全都要自带。SkillsBench 的任务正是这样打包的(repo/README.md:90-103、AGENTS.md:19-34):
tasks/<task-id>/
  task.md                 # YAML frontmatter + 人工写的 prompt 正文
  environment/
    Dockerfile            # 容器环境
    skills/               # 领域技能(通用可复用,非任务定制)
    ...数据文件...
  oracle/
    solve.sh              # oracle:人工编写,通过计算推导答案
  verifier/
    test.sh               # pytest 运行器,通过即写 reward
    test_outputs.py       # 基于产物的断言
图 2|task.md 包结构树
task.md 描述任务给被测 agent 看;environment/ 提供含技能在内的运行环境;oracle/ 是参考答案(人工推导);verifier/ 是判分器(只看产物)。四者打包在一起,任务才能被镜像复制出 with/no-skill 两个版本(第 4 节)。
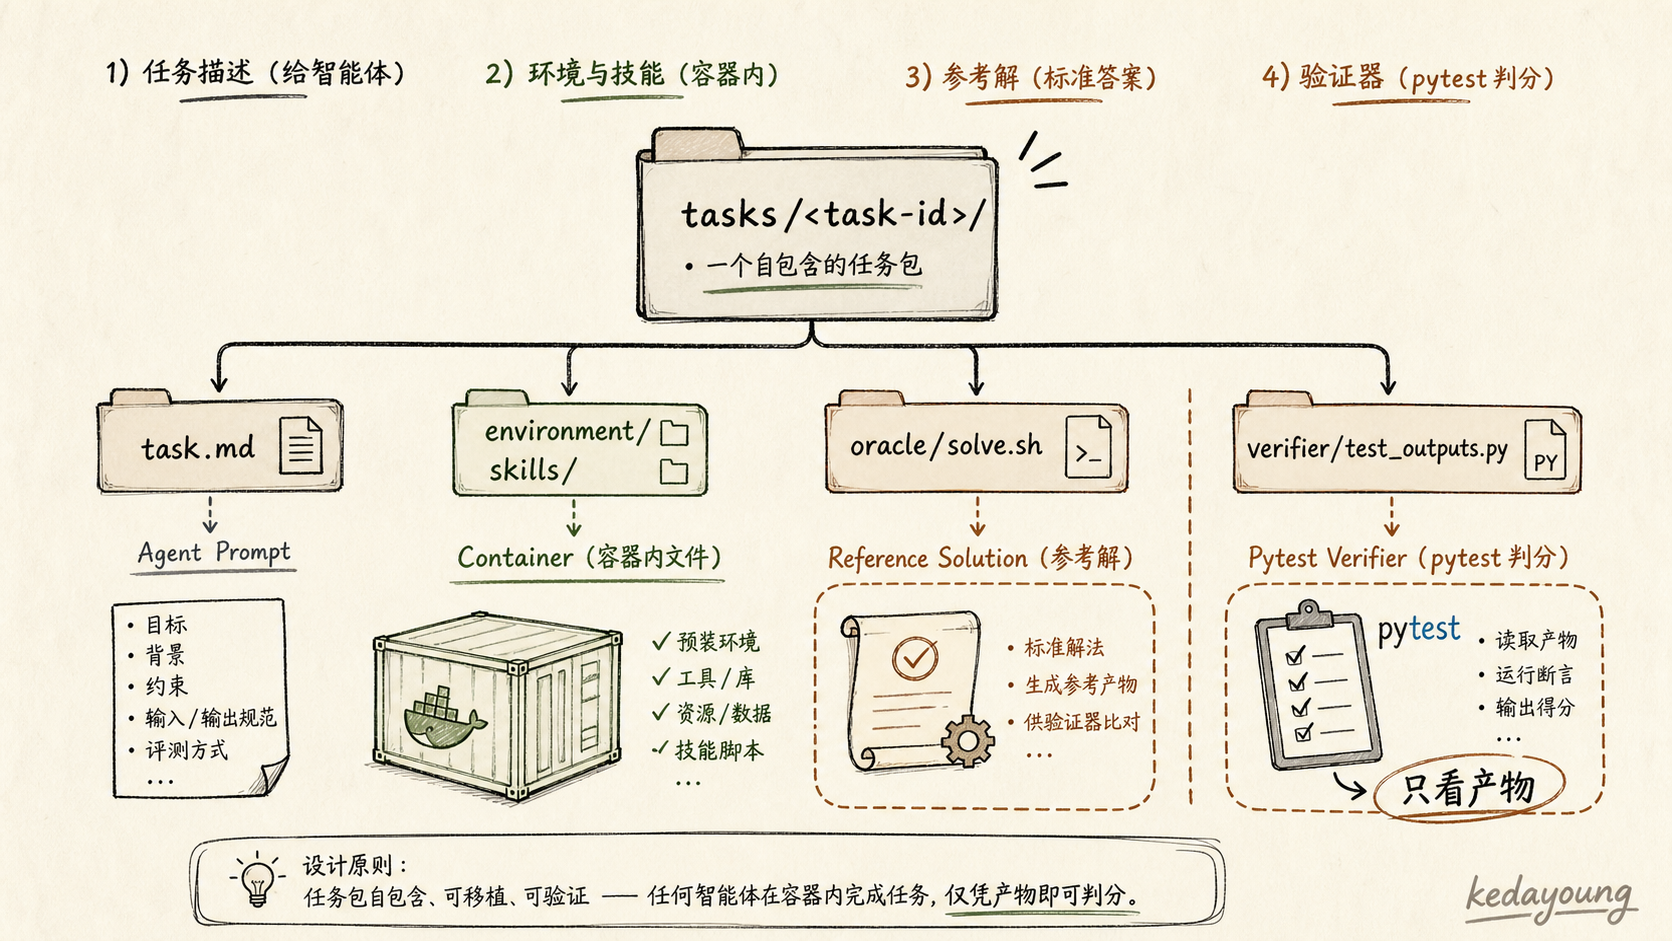
一个包内的四个部分各司其职:
| 部分 | 角色 | 谁消费它 |
|---|---|---|
task.md | 任务描述(frontmatter 元数据 + prompt 正文) | 被测 agent |
environment/Dockerfile + skills/ + 数据 | 运行环境与技能注入点 | 容器 |
oracle/solve.sh | 参考答案(人工编写、计算推导) | 校验/参考 |
verifier/ | 产物判分器 | 评测器 |
其中 oracle/solve.sh 的角色常被误解:它是任务作者侧的参考答案实现——人工编写、通过计算推导出正确产物、绝不硬编码(AGENTS.md:42、:46)。它的作用是「证明任务可解、给出标准答案供人工核对」;在评测运行中,被测 agent 只看到 task.md 的 prompt 正文,看不到 oracle 也看不到 verifier——否则「抄答案」就无法避免了。
task.md:给 agent 看的,不是给评测器看的
task.md 的正文是人工写就的自然语言任务描述(AGENTS.md:42 强制要求 human-written)。以 offer-letter-generator 为例(repo/tasks/offer-letter-generator/task.md:1-50):
- YAML frontmatter 承载元数据:
metadata里的 taxonomy 字段(category/subcategory/task_type/modality/interface/skill_type)必须通过taxonomy.yaml受控列表校验——CI 会在每个改动tasks/**/task.md的 PR 上跑lint_taxonomy.py(AGENTS.md:46-49); - frontmatter 还有运行参数:
verifier.timeout_sec、agent.timeout_sec与sandbox(网络模式、CPU/内存/存储/GPU 配额)。注意sandbox声明的资源既是环境描述,也是第 5 节「资源钳制」的对照基准——任务声明多少资源,评测器就能钳制多少; - 正文才是关键:只描述任务本身,例如「按 Word 模板
offer_letter_template.docx填充占位符、把结果存到/root/offer_letter_filled.docx、处理条件段{{IF_RELOCATION}}...{{END_IF_RELOCATION}}」——不出现任何技能名(AGENTS.md:43)。
这个「frontmatter 给机器、正文给 agent」的拆分是刻意的:正文保持纯净,才保证 with/no-skill 两个版本喂给 agent 的 prompt 逐字相同(两个版本的差异只发生在 Dockerfile 和 skills 目录,task.md 一字不改,第 4 节详述)。
verifier:pytest 断言产物
判分器是标准的 pytest 断言脚本(verifier/test_outputs.py),断言对象是 agent 产出的文件产物——检查文件是否存在、格式是否正确、内容是否满足约束;通过则写 reward(AGENTS.md:25 描述 test.sh 为 "Pytest runner, writes reward.txt")。典型断言形态是「读产物文件 → 逐条校验字段/结构 → 全部满足才判过」,比如 offer-letter 任务会去解析 /root/offer_letter_filled.docx 并检查占位符是否都被真实数据替换、条件段是否按 RELOCATION_PACKAGE 取舍。这类断言完全不知道 agent 中间经历了什么——这正是「只看产物」的执行形态。
产物判定还有一个「专业领域版」值得一提:PDDL 任务的验证方式。GitHub 上把仓库标记为 PDDL 项目是个误导:代码主体是 Python(skillsbench_agentbeats/、experiments/scripts/,见 pyproject.toml:1-14),PDDL 只是 pddl-airport-planning、pddl-tpp 两个任务的领域数据(如 repo/tasks/pddl-airport-planning/environment/airport/*.pddl)。这两类任务的 verifier 不自己写规划器,而是调用 unified_planning 的 PlanValidator 校验 agent 产出的 plan 是否合法可达(repo/tasks/pddl-airport-planning/verifier/test_outputs.py:56-63)——仍然是「产物对不对」,只是这个「对」由专门的领域验证器来判定。
设计含义:自包含是镜像的前提
任务包之所以要自包含,不是为了整洁,而是为了第 4 节的对照实验:只有把环境、技能、裁判、参考答案全部打包进一个目录,才能对同一任务做「有技能/没技能」两个镜像版本,且保证两个版本唯一差异就是技能本身。这是「任务包」与「评测工具」的分水岭——后续所有环节,都是围绕这个自包含单元展开的。
3. 评测主流程:worker → purple harness → verifier → reward
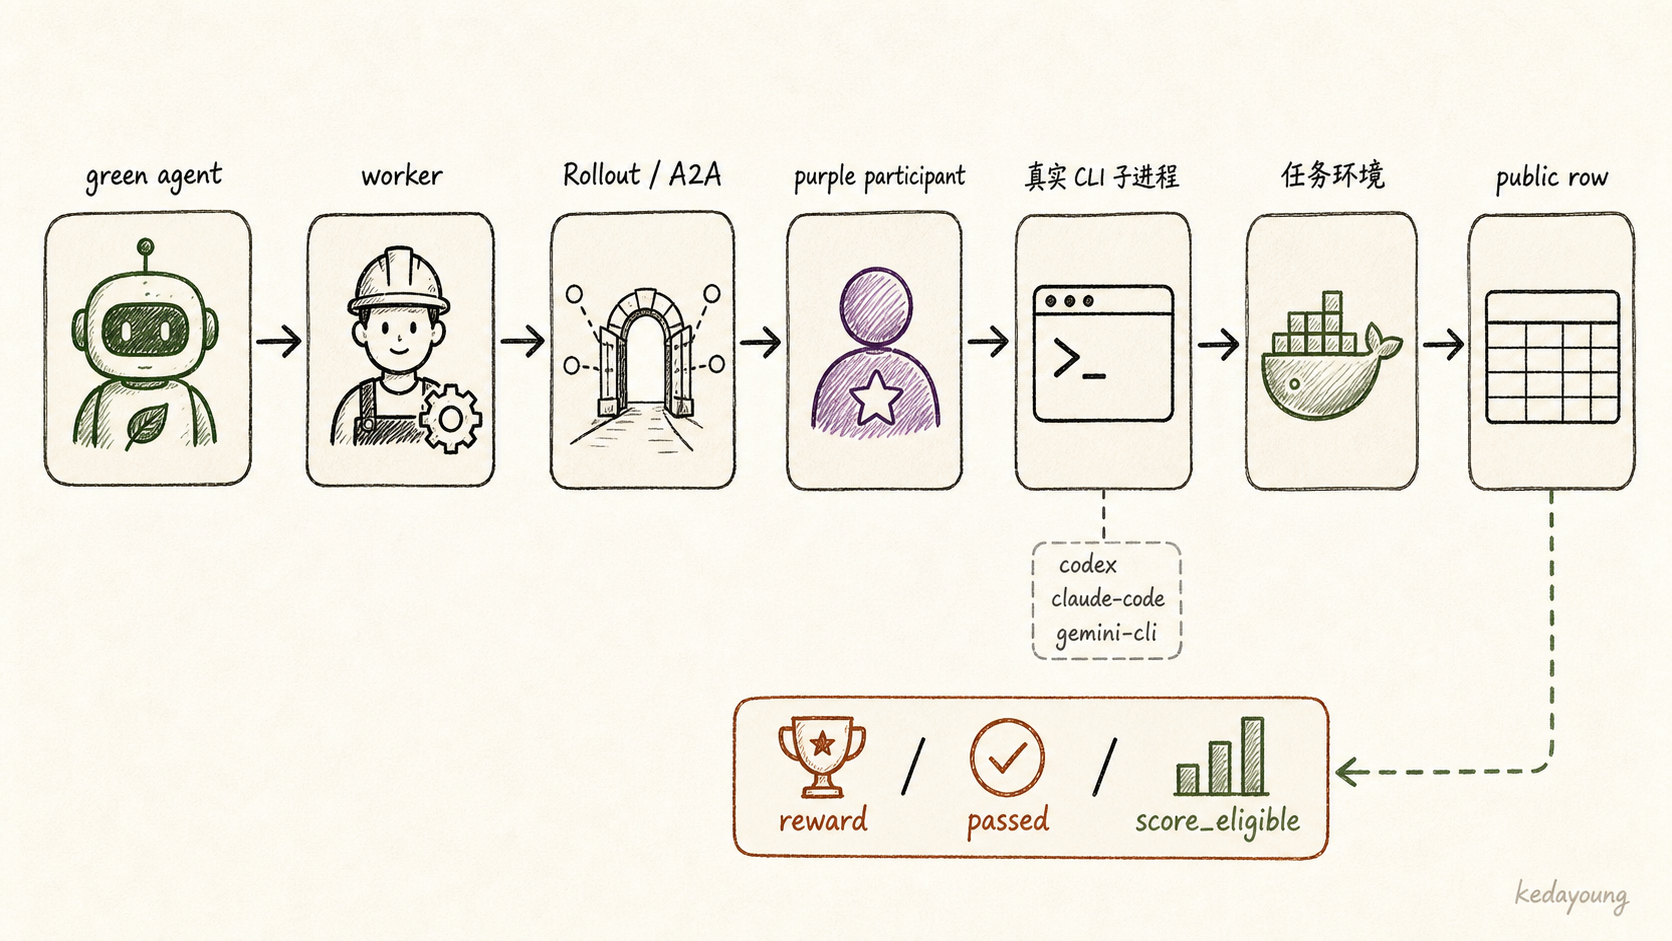
有了任务,评测如何跑起来?从任务选择到出分,代码路径是:配置解析 → worker 编排 → Rollout(A2A)→ purple harness(真实 CLI 子进程)→ verifier → reward → public row。
配置与任务选择
入口配置是 AssessmentConfig(repo/skillsbench_agentbeats/config.py:22-127):它校验任务选择器(tasks / task_ids 二选一)、task_set(默认 smoke)、condition、分片参数(shard_index/num_shards,支持把任务集切片到多实例并行)、mock_rewards 等。
任务选择由 resolve_task_selection 完成(config.py:129-161):读 tasks/ 目录、查 registry、按 task_set manifest 解析出 ResolvedTask 列表(每个元素携带 task_id、path、task_digest——第 5 节会看到它如何参与可复现链)。
worker 编排:把任务变成一次 Rollout
BenchFlowWorkerRunner.run(repo/skillsbench_agentbeats/worker.py:247-282)是编排中枢。它做的事包括:解析任务列表 → 校验每个任务的预构建镜像必须存在且 digest-pinned(_validate_required_prebuilt_images)→ 生成 task_set_manifest 及其 digest(task_set_digest)→ 对每个任务调用 _run_task → 汇总 public rows 与 private proof refs → 写私有 proof bundle。
_run_task(worker.py:284-341)把每个任务包转成一个 BenchFlow Rollout(一次「环境-动作-奖励」的执行轮次):RolloutConfig 里只有一个 Scene(场景),场景中只有一个 role——名为 agent、transport 为 a2a(Agent-to-Agent 消息协议)的参与者(worker.py:302-319)。这里借用 BenchFlow SDK 的 Rollout 机制执行任务:环境、turn、参与者的运行细节由 SDK 承担,本仓库只负责构造配置与接入(这正是阅读约定里「外部 SDK 行为不猜测」的落地——我们能确证的,就是仓库把单 role「agent」、单 turn 的场景交给了 Rollout)。
purple harness:被测 agent 是真实 CLI
被测 agent 是怎么被执行的?worker.py:302 为 role 设置的 AGENTBEATS_A2A_ENDPOINT_ENV 指向一个 A2A participant——这就是 agent_under_test.py 里的 purple agent(代码注释原文:Configurable purple agent-under-test A2A participant,agent_under_test.py:1)。
调用链是:AgentUnderTestExecutor.execute(agent_under_test.py:274-307)收到 A2A 消息后,把用户输入转交给 CommandHarnessRunner.run(:162-196);后者把 prompt 写入临时 task.txt,再按 HARNESS_SPECS 起一个真实 CLI 命令的子进程(_command_from_env,:59-95、:406-442)。
支持的被测 harness 有 7 个(:49-57):openhands、opencode、claude-code、codex、gemini-cli、terminus、pi。每种 harness 的调用模板各不相同,例如:
claude-code:claude -p --model "{model}" --output-format json < task.txt(shell 模板,stdin 喂 prompt);codex:codex exec --model ... --json -(prompt_stdin=True);pi:pi --model ... --print @task.txt。
这是整个设计里最关键的一个决定
被测对象不是封装好的 agent API,而是用户真正会在终端里敲的那个 CLI。评测在容器里起一个真实子进程,喂给它与用户日常使用完全相同的 prompt 文本。这样测出来的「agent 用技能的能力」,就是用户在自己机器上能复现的能力——技能加载路径(如 ~/.claude/skills/、/root/.config/opencode/skills)也正是这些 CLI 原生的技能目录。
还有两个值得注意的包装细节:
- prompt 会再包一层:
CommandHarnessRunner把任务 prompt 包成一段固定的 purple participant 系统指令——"You are a SkillsBench AgentBeats purple participant. Configured harness: {harness}.",并要求产物按任务指定的相对路径落在当前工作目录、不得泄露 API key 与环境变量(_agent_prompt,agent_under_test.py:502-512)。这层包装对所有 harness 一视同仁,保证「任务描述 + 被测者身份」在各 harness 间逐字一致。 - harness 命令可被环境变量覆盖:
_command_from_env(agent_under_test.py:406-442)优先读SKILLSBENCH_AGENT_COMMAND,没有才落到HARNESS_SPECS默认模板——部署方可以在不改代码的前提下替换某个 harness 的调用方式,默认模板只是兜底。
从部署视角看,这套链路被拆成 green / worker / purple 三个组件、各自发布独立镜像(deploy_bundle.py:20-29:green = skillsbench-agentbeats-green,purple = skillsbench-agentbeats-purple):AgentBeats 网关把评测请求发给 green agent(agent.py 的 SkillsBenchGreenAgent,负责校验 EvalRequest 并选择本地 mock 或远程 worker 适配器),worker 负责编排 Rollout,purple 才是真正的被测 CLI 容器(integrations/agentbeats/README.md:8-50 的 scope 清单列出了 green server 9009 端口、worker server 9010 端口与 mock/remote adapter 等实现面)。「被测 agent」在架构里是一个独立的、可替换的组件,这正是对照实验可操作化的前提。
出分:reward 与 infra 失败分离
Rollout 结束后,_row_from_rollout_result(worker.py:388-426)把结果转成一行公开数据:取 result.rewards["reward"](_reward_value,:429-435)作为分数,passed 定义为「score_eligible 且 reward > 0」。
这里有一个评测严谨性的细节:infra 失败与真实失败被显式分离。score_eligible = reward is not None and error is None and verifier_error is None(:404),而 error / verifier_error 会被归类为 infra_failure_type / error_type(:471-487)。也就是说,agent 没跑完、环境崩了、verifier 报错,都不算「答错」,而算「不可计分」——排行榜只对 eligible 的样本算通过率(第 5 节的 SQL 会看到)。
图 3|评测主流程
AgentBeats 网关把评测请求交给 green agent,worker 把每个任务包交给 Rollout(A2A 单 role 场景),purple participant 把 prompt 喂给真实 CLI 子进程,产物经 verifier 判分,最终以 public row 形式进入排行榜。Rollout 的具体执行由外部 BenchFlow SDK 承担,细节不在本仓库内。
设计含义:测的是用户真会用的工具
把「评测 agent」实现为「把 prompt 喂给真实 CLI harness 子进程」,带来的直接后果是:评测结果对用户的日常使用有迁移性。如果某个能力只在封装好的 agent API 里存在、在 CLI 里用不上,SkillsBench 就测不到它;反过来,用户在 CLI 里能用的技能加载方式,评测里就是被测对象本身。这也解释了为什么技能注入要落到 Dockerfile 的目录复制上(第 4 节)——因为 CLI 就是从这些目录加载技能的。
4. 对照实验设计:with-skill 与 no-skill 的镜像
核心设计:同一任务的两个版本
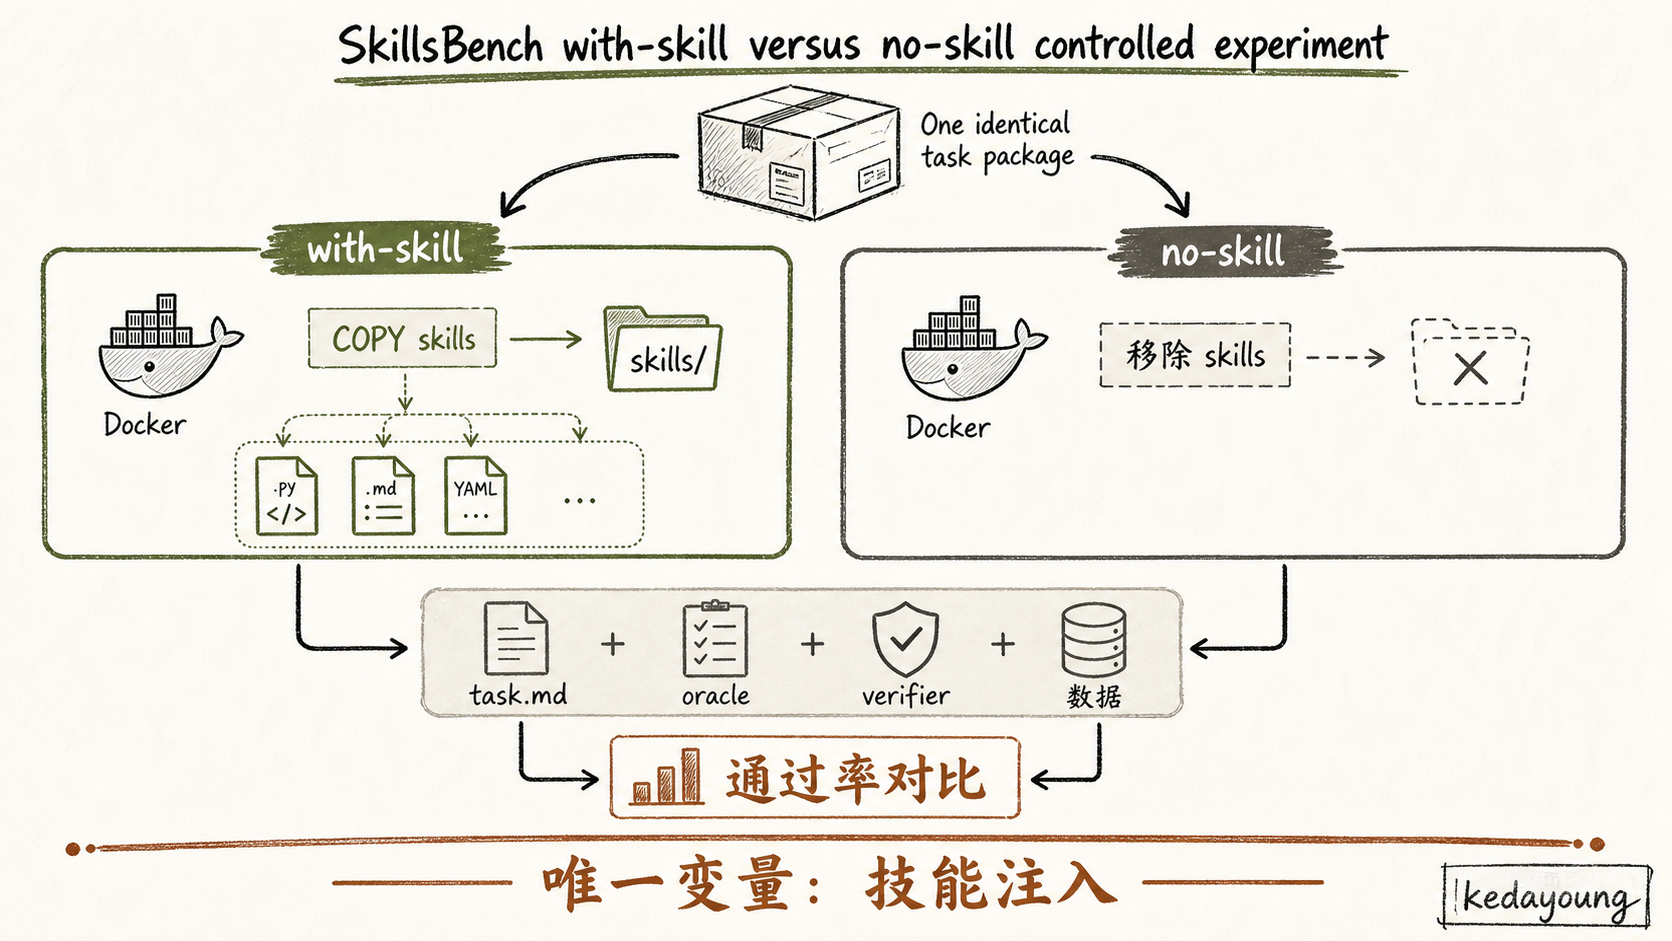
第 1 节的研究问题「技能是否有效」要成立,必须能回答「如果没有技能,同样的 agent 做同样的任务会怎样」。SkillsBench 的做法是:同一个任务包,产出两个镜像版本——with-skill(环境里带 skills 目录)与 no-skill(环境里没有 skills),其余(task.md、oracle、verifier、数据)逐字相同,然后对比两个版本的通过率。
这就是「对照实验」而非「单组跑分」:技能是被操纵的自变量,通过率是被测的因变量,其余一切是控制变量。
技能怎么注入 / 移除:镜像在 Dockerfile 层面完成
对照实验成败全在「除技能外一切相同」这一条上,而 SkillsBench 把这一条落实到了 Dockerfile 层面。镜像变换的参考实现是 experiments/scripts/gcp_setup/run_opencode_gcp_docker_ablation.py:
with-skill 版本(:334-348)在 Dockerfile 追加两行:
COPY skills /skills
COPY skills /root/.config/opencode/skills
第一行把技能放进容器工作区,第二行放进 opencode CLI 的原生技能目录——这样被测 CLI 会「自己发现」这些技能,而不是靠 prompt 告知。no-skill 版本(:351-379)做对称操作:删除 environment/skills 目录与 _deps/skills,并移除 Dockerfile 中所有与技能相关的 COPY 行——覆盖 /skills 与 opencode / claude / codex / gemini 等主流 CLI 的技能目录路径(正则匹配,:360-375),保证两个版本在任何技能加载路径上都等价。
正式入口:--skill-mode
镜像变换是内部实现,用户可见的正式入口是 BenchFlow CLI 的 --skill-mode 参数(repo/README.md:61-67、AGENTS.md:13-14):
# 带技能跑
bench eval run --tasks-dir tasks/<task-id> --agent claude-agent-acp \
  --model <model> --skill-mode with-skill \
  --skills-dir tasks/<task-id>/environment/skills/

# 不带技能跑(对照)
bench eval run --tasks-dir tasks/<task-id> --agent claude-agent-acp \
  --model <model> --skill-mode no-skill
同一个任务、同一个 agent 配置,只切换 --skill-mode,就得到一对可比的样本。
值得点明的是 --skill-mode 与 4.2 的镜像变换脚本是同一设计的两个面:ablation 脚本是实验端手工/批量构造镜像的参考实现,--skill-mode 是 BenchFlow CLI 对用户暴露的正式开关;无论走哪条路,落到 Dockerfile 上的差异都只有「技能的 COPY」这一处。
另外,论文把「技能」这个变量进一步拆成三个来源——curated / self-gen / distractor。需要说明的是:这只是论文声明的实验条件,本文不作实测(证据见 repo/docs/paper-figures/README.md:56 附近对论文图表的说明);就本仓库代码能确证的范围而言,镜像机制本身是通用的——它不关心技能内容来自哪里,只负责「带 / 不带」的注入。
图 4|with/no-skill 镜像对照图
唯一变量是技能注入——with 版本加两行 COPY,no 版本删目录并清掉所有技能路径的 COPY;verifier 与判分口径完全一致。
对照的效度检查
「镜像对照」听起来简单,做扎实很难——难点全在堵住变量泄漏。no-skill 清理之所以要扫掉 /root/.claude/skills、/root/.codex/skills、/root/.gemini/skills 等一串路径(run_opencode_gcp_docker_ablation.py:360-375),就是为了防止「任务包里没写技能,但基础镜像自带的 CLI 技能目录泄漏进来」——那样两个版本的差异就不只是技能了。同理,with 版本的两行 COPY 必须落在同一份 Dockerfile 上,task.md 正文在两个版本间逐字相同。这些约束共同保证:如果最终 with 的通过率显著高于 no-skill,唯一能解释差异的变量就是技能。
设计含义:评测与实验的分水岭
「评测实验设计」与「评测工具」的分水岭就在这里:promptfoo 这类工具也能跑 agent,但跑出来的是「这个 agent 在 prompt X 下得几分」;而 SkillsBench 跑出来的是「技能这个变量的边际贡献」。要做到后者,靠的不是更聪明的判分器,而是镜像级的变量隔离——这也是把「评测」做成「实验」的关键一步。
5. 报告与可复现性:AgentBeats、digest 锁链与资源钳制
结果如何对外呈现
评测结果上报给 AgentBeats 排行榜(repo/integrations/agentbeats/README.md:8-94),仓库自带 DuckDB 分析层。上报面不是「跑完就算」:integrations/agentbeats/README.md 的 scope 清单里,green 与 worker 各有一个常驻 server(分别承载 A2A 评测入口与 create/status/cancel API)、任务集 manifest 固定钉死(task_sets/smoke.json 与 task_sets/skillsbench-v1.1.json),且全模式强制预构建镜像(SKILLSBENCH_WORKER_REQUIRE_PREBUILT_IMAGES)——排行榜背后是一整套服务与校验前置。
排行榜的核心 SQL(integrations/agentbeats/leaderboard/queries/overall.sql:64-91)按定义计算通过率:
100.0 * SUM(CASE WHEN score_eligible AND passed THEN 1 ELSE 0 END)
      / NULLIF(SUM(CASE WHEN score_eligible THEN 1 ELSE 0 END), 0) AS pass_rate
公式本身值得拆解:分子分母都限定 score_eligible——infra 失败的样本不进分母,也不进分子,只以 infra_failed_tasks 单独列出。排行榜查询族分三份:overall.sql 出总榜,按 agent 分区去重、每个取 pass_rate 最优的一行;另有 by_category.sql / by_difficulty.sql 分别按领域与难度切片(同目录下)。网站端 website/src/components/Leaderboard.tsx 用双列同时展示 with-skills / no-skills 两组数据——视觉上直接呈现对照结果。
对外公开的数据字段受白名单约束:REQUIRED_PUBLIC_ROW_FIELDS 与 ALLOWED_PUBLIC_ROW_FIELDS(repo/skillsbench_agentbeats/public_readiness.py:69-92)明确列出哪些字段可以公开——REQUIRED 集合里有 task_id、task_digest、trial_id、task_set、task_set_digest、category、condition、difficulty、score_eligible、passed、reward、max_score、time_used;ALLOWED 在其上追加 agent_transport、artifact_refs、error_type、has_skills、infra_failure_type、participant_role、tags。白名单之外的一切(比如 raw 的 rollout 目录、环境变量、日志)不进入公开行——评测原始结果被脱敏后才对外可见。注意 condition 与 has_skills 都在公开字段里:排行榜的每一行都自带「这是 with 还是 no-skill 条件下的结果」这个标签,字段标签与网站双列展示(website/src/components/Leaderboard.tsx)互为印证。
可复现链:digest 锁链
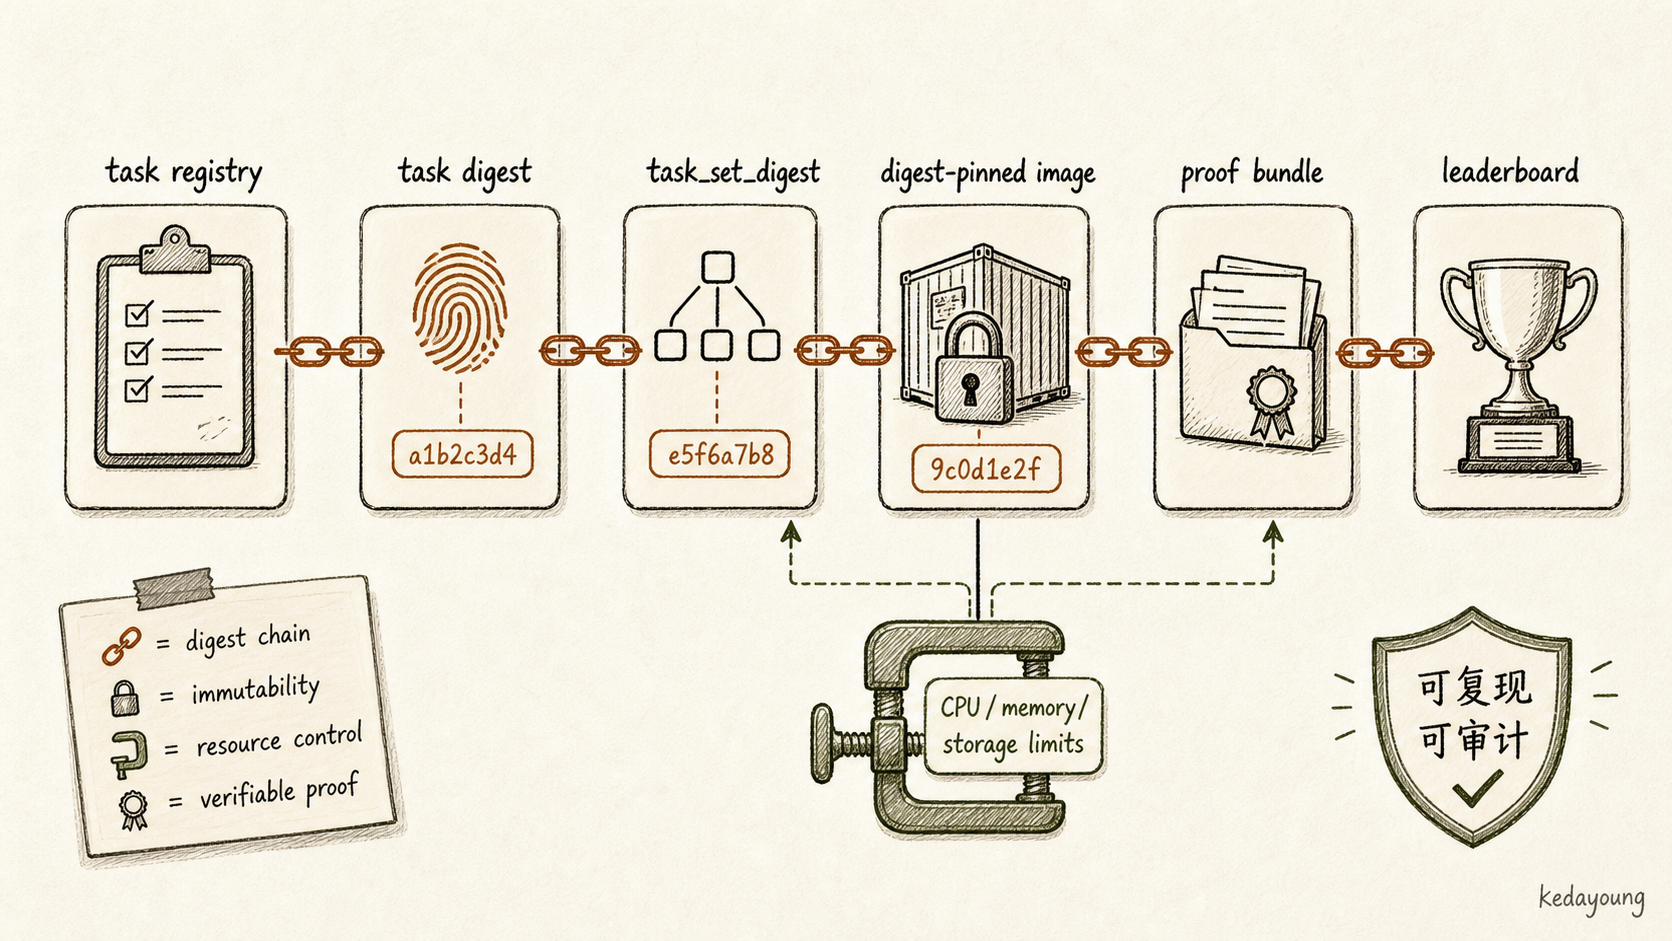
「这次跑的分,下次能不能复现?」SkillsBench 的答案是:把评测的每一个可漂移元素都锁进 digest。可复现链分四层:
- registry 层:
registry.json:1-15记录每个任务对应的 git commit 与任务目录的 sha256 digest(如git_commit_id+digest: sha256:...)——任务集版本被钉死; - task_set 层:
task_sets.py:146-151对 task_set manifest 的公开字段做规范化 JSON 排序后取 sha256(digest_task_set_manifest),生成task_set_digest——「跑的是哪一组任务」被钉死; - 镜像层:worker 要求每个任务必须有预构建镜像,且镜像引用必须是 digest-pinned(
worker.py:572-589:镜像缺失、引用可变 tag、或无法解析,都直接报错拒绝运行)——「在什么环境里跑」被钉死; - 证明层:
_write_private_proof_bundle(worker.py:1057-1130)把 public rows、task_set_manifest、proof refs(rollout 目录、预构建镜像引用、runtime policy)打包成私有 proof bundle——「这次确实这么跑的」被存档。bundle 的 manifest 自带proof_id、created_at、参与方、task_set 与task_set_digest、public_rows、private_proof_refs、copied_artifacts以及保留期(retention)字段(:1069-1090),并把 rollout 产物文件复制进 bundle 目录——证明不是「声称」,而是「可查」的。
图 5|digest 锁链图
registry 锁任务版本 → task_set_digest 锁任务组 → digest-pinned 镜像锁环境 → proof bundle 存档证明。每一层锁住一个「评测版本」的可漂移维度。
防作弊 / 防超卖:资源钳制
可复现的另一半是防作弊。_worker_runtime_caps(worker.py:892-977)实现资源钳制:默认开启(SKILLSBENCH_WORKER_CLAMP_TASK_RESOURCES 默认 true),把每个任务的 CPU/内存上限钳制到 worker 检测或配置的额度——防止任务包在 Dockerfile 里声明超大资源(「评测超卖」的一种形态——例如任务声明要 64 核 256G 的资源、实际却跑在共享集群上;数字为示意)。结合 5.2 的预构建镜像校验,评测环境从「任务声明的任意环境」收敛为「registry 认可的、资源受控的环境」。
设计含义:可复现即版本资产
学术基准的「可复现」在这里被升级了:不是固定 seed、固定随机数这么简单,而是把任务集版本、镜像、资源上限全部锁进 digest 链,让「评测版本」本身成为一个可追溯、可审计的资产。task_set_digest 甚至进了排行榜的公开行——一行分数能确切对应到它的任务集、镜像与环境的版本。
6. 与其它路线的对照与可迁移经验
五条路线的定位差异
SkillsBench 不是第一个 agent 评测,但它选了「技能专项 + 对照实验」这条别人没走的路。把它与四条常见路线并排看:
| 维度 | bfcl-gaia(教学) | promptfoo(工程工具) | AgentBench(学术综合) | cua(端到端 UI) | SkillsBench(技能专项) |
|---|---|---|---|---|---|
| 评测对象 | agent 实例 | prompt / provider / 轨迹 | 多环境 LLM-as-Agent | 操作真实界面的 agent | 用 skill 的 agent |
| 核心问题 | 复现官方基准 | 回归与 CI | 跨任务泛化 | 跨界面任务完成 | 技能是否有效 |
| 实验设计 | 单组跑分 | 多模型对比 | 多任务矩阵 | 多步任务跑分 | 对照实验(with/no-skill) |
| 判分方式 | 外置脚本 | 可组合断言 | 确定性规则 | 界面状态断言 | 产物 pytest(只看产物) |
| 可复现 | 脚本级 | resume / cache | 断点续跑 | 脚本级 | digest 锁链 + 镜像 |
图 6|评测五条路线定位
五条路线在「评测对象 × 实验设计」两个维度上各占一位;SkillsBench 的独特坐标是「以技能为变量的对照实验」。注:cua 非本仓库内容,其单元格为宽泛归类,仅作谱系定位。
区别的本质在「评测对象」和「实验设计」两列:bfcl-gaia 关心「能不能复现官方基准的分数」,promptfoo 关心「回归与 CI」,AgentBench 关心「跨任务泛化」,而 SkillsBench 关心的是「单一变量(技能)的因果效应」——所以它必须用对照实验,而不是单组跑分。
可迁移的模式
以下为作者基于本仓库的观察判断,非 SkillsBench 官方结论。
SkillsBench 提供了四个可独立搬走的对照实验模式:
- 用对照实验回答「某能力是否有效」,而不是单组跑分。单组跑分只能回答「强不强」,对照实验才能回答「是哪个变量让它强」。技能、工具、指令模板——任何「加载进环境的可复用知识」都可以用 with/no 镜像来测。
- 判定只看产物,避免过程打分的主观性与不可复现。轨迹打分需要定义「什么是好的过程」,这在 agent 行为日益多样化的今天几乎不可维护;产物断言(pytest 检查文件)客观、可复现、实现成本低。
- 任务包自包含(环境/裁判/参考答案)+ 镜像复制,让对照的唯一变量化。自包含是镜像的前提,镜像复制是「除变量外一切相同」的工程实现——把变量隔离从「实验设计原则」变成「可执行的构建步骤」。
- digest 锁链,把「评测版本」变成可追溯资产。任务 digest、task_set digest、镜像 digest、proof bundle 四层锁链,让「这次评测」与「下次评测」可严格比较,也让排行榜上的数字可审计。
系列内定位与收束
在评测系列里,SkillsBench 代表「专项 + 对照实验」路线,与 0-agent-skills 主题直接相关:如果说「技能怎么加载」那类内容回答的是机制(技能如何被 agent 发现与装载进上下文),SkillsBench 回答的则是「技能加载后有没有用」——前者是机制,后者是度量。
回到中心论点,SkillsBench 最大的启示其实是一句反直觉的话:技能评测的难点不在「判分」,而在「把技能这个变量隔离出来」。判分是标准 pytest;真正难的是让两个镜像之间只有技能这一个差异——所以它把技能注入做进 Dockerfile、把技能目录路径清干净、把环境锁进 digest 链。把「技能有没有用」从体感变成可复现的数字,靠的不是更聪明的模型或更精细的过程分析,而是老老实实的实验设计。这份工程化,是所有「验证新增能力是否有效」的评测设计可以直接照抄的范本。
附录 A:证据清单(写作时逐条核对)
所有路径相对
repo/(本地克隆benchflow-ai/skillsbench,main 分支快照,2026-08-11)。
| 断言 | 证据位置 |
|---|---|
| 基准定位(first benchmark for evaluating how well AI agents use skills) | README.md:8、:14(gym-style 口径) |
| 评测对象为「agent 使用技能的能力」,prompt 不透露技能名 | AGENTS.md:43-44 |
| 两种评测入口(skill evals 与 skill-mode eval) | AGENTS.md:16、:13-14 |
| 研究问题与四条设计约束 | taxonomy.md:7、README.md:18、AGENTS.md:42-47 |
| 任务包结构(task.md / environment / oracle / verifier) | README.md:90-103、AGENTS.md:19-34 |
| task.md 元数据校验(taxonomy 受控列表 + CI lint) | AGENTS.md:46-49 |
| verifier 为 pytest 断言脚本,写 reward | AGENTS.md:25、verifier/test_outputs.py |
| PDDL 任务验证(unified_planning PlanValidator) | tasks/pddl-airport-planning/verifier/test_outputs.py:56-63 |
| 配置与任务选择 | skillsbench_agentbeats/config.py:22-127、:129-161 |
| worker 编排与镜像 digest-pinned 校验 | skillsbench_agentbeats/worker.py:247-282、:572-589 |
| purple harness(真实 CLI 子进程,7 种 harness) | agent_under_test.py:274-307、:162-196、:59-95、:49-57、:406-442、:502-512 |
| reward 与 infra 失败分离 | worker.py:388-426、:429-435、:471-487 |
| with/no-skill 镜像变换 | experiments/scripts/gcp_setup/run_opencode_gcp_docker_ablation.py:334-348、:351-379、:360-375 |
正式入口 --skill-mode | README.md:61-67、AGENTS.md:13-14 |
| AgentBeats 排行榜与公开字段白名单 | integrations/agentbeats/README.md:8-94、skillsbench_agentbeats/public_readiness.py:69-92 |
| 排行榜 SQL(pass_rate 仅计 score_eligible) | integrations/agentbeats/leaderboard/queries/overall.sql:64-91 |
| digest 锁链(registry / task_set / 镜像 / proof bundle) | registry.json:1-15、task_sets.py:146-151、worker.py:1057-1130 |
| 资源钳制 | worker.py:892-977 |
附录 B:素材缺口与待办
- 语言勘误:GitHub 标记 PDDL 系误导;代码主体是 Python(
pyproject.toml:1-14),PDDL 仅为 airport/tpp 两个任务的领域数据,验证由unified_planning的PlanValidator完成(tasks/pddl-airport-planning/verifier/test_outputs.py:56-63)。 - 外部依赖边界:评测执行依赖 BenchFlow SDK(
uv.lock,benchflow 0.6.3);本仓库是任务集 + 编排/接入层,本文对 Rollout 的描述仅到本仓库调用面为止。 - 数字边界:本文不提供任何 pass rate / Δpp 实测值;第 4 节关于技能来源条件(curated / self-gen / distractor)的描述仅作为「论文声明」引用(
docs/paper-figures/README.md),不作实测。 - [ ] 第 6 节可迁移模式为作者判断,非仓库官方表述——如需对外引用,建议先对照仓库
AGENTS.md与论文声明复核。 - [ ] 未实际运行评测(需 BenchFlow CLI + 预构建镜像);机制描述以源码为准。