代码基线:全部代码引用以克隆 commit
0a568c3为准,路径相对MemoryCore/。
引言
长任务里工具调用的参数与结果动辄上万 token:全部塞回上下文,下一轮对话的预算就烧掉大半;全部丢进向量库,只能拿回模糊的相似度召回,说不清一条记忆是真是假、从哪来;任务进行到第 20 轮时,模型自己都忘了前 15 轮排查过的死胡同,于是把踩过的坑再踩一遍。
TencentDB Agent Memory 的答案不是更聪明的向量检索,而是一套组合拳:短时记忆把工具日志卸载到文件、上下文只留高密度的 Mermaid 符号图(省 token);长时记忆用 L0→L3 金字塔做渐进披露(下层存证据、上层存结构)。两者共享同一条设计底线——每一层都保留通往下钻原始证据的确定性路径(node_id / result_ref / record_id),核心价值因此是「可审计、可恢复、可下钻」的记忆治理,而非检索精度。本文用 MemoryCore/src/ 的真实代码讲清这两个并行子系统:设计理念(§1)、长时金字塔与触发调度(§2)、短时符号 offload(§3)、检索与注入预算(§4)、存储与插件形态(§5)、评测与对照(§6);所有代码引用按克隆 commit 0a568c3 逐行核实,证据清单见文末附录。
1. 设计理念:拒绝扁平存储
1.1 扁平向量库的问题:盲搜,且没有宏观引导
README 的立论很直接:传统记忆方案把数据碎片化地塞进 flat vector store,召回退化成「拿当前问题去相似度搜索」,缺两条东西——宏观引导与证据链。一个只存了 2000 条零散事实的向量库,能回答「用户之前提过什么偏好」,但回答不了「我现在这个任务进行到哪一步了、哪些路已经走死」。前者是点状记忆,后者是结构与过程记忆,扁平存储天然表达不了后者。
以 mem0 为代表的「外部事实库 + 扁平向量」方案,还有一个隐蔽的问题:命中不等于可信。一条向量召回「用户偏好简洁代码风格」,但它是从哪条对话提炼的、提炼时模型有没有误解、后来用户有没有改口——扁平存储里全都查不到。对不重要的闲聊这无所谓,但 Agent 一旦把这条记忆当真拿去做了决策,错误就会被放大。换句话说,扁平方案的失败不在召回率,在问责性:没有证据链,就没有办法验证、修正、回滚一条记忆。这个「记忆治理」视角是理解本文后续所有设计的关键。
1.2 两个支柱:记忆分层 + 符号记忆
项目的应对是两个并行支柱:
- 记忆分层(渐进披露 + 异构存储):下层用数据库存原始证据(对话、原子记忆),上层用 Markdown 文件存结构化结论(场景、画像)。平时只把上层轻量结构注入上下文,需要细节时再下钻。
- 符号记忆(最少符号承载最大语义):短时记忆不存原始日志,而把它浓缩成一张 Mermaid 状态图——节点、状态、连线本身就是语义。README 的原话是「让形状替你说话,省略冗余的文字描述」。
1.3 代码里的印证:两个平行抽象,不是替代关系
src/core/storage/types.ts:15-18 的注释把这两条支柱落成了两个平行接口:
//   - IMemoryStore  = database abstraction (L0/L1 structured data → VDB/SQLite)
//   - IStorageBackend = file storage abstraction (L2/L3 Markdown files → COS/local-fs)
//   Both are parallel, not replacements of each other.
IMemoryStore 管 L0/L1 的结构化数据(对话记录、原子记忆),落向量库或 SQLite;IStorageBackend 管 L2/L3 的 Markdown 文件(场景块、persona),落本地 fs 或 COS。两层抽象刻意并存——这说明作者认为「向量库 vs 文件」不是二选一,而是各自擅长不同记忆形态。这个设计判断贯穿全文,后面第 5 节还会看到它落成一套具体的 StoragePaths。
图 1|flat vector vs 分层金字塔:盲搜与可下钻的对比
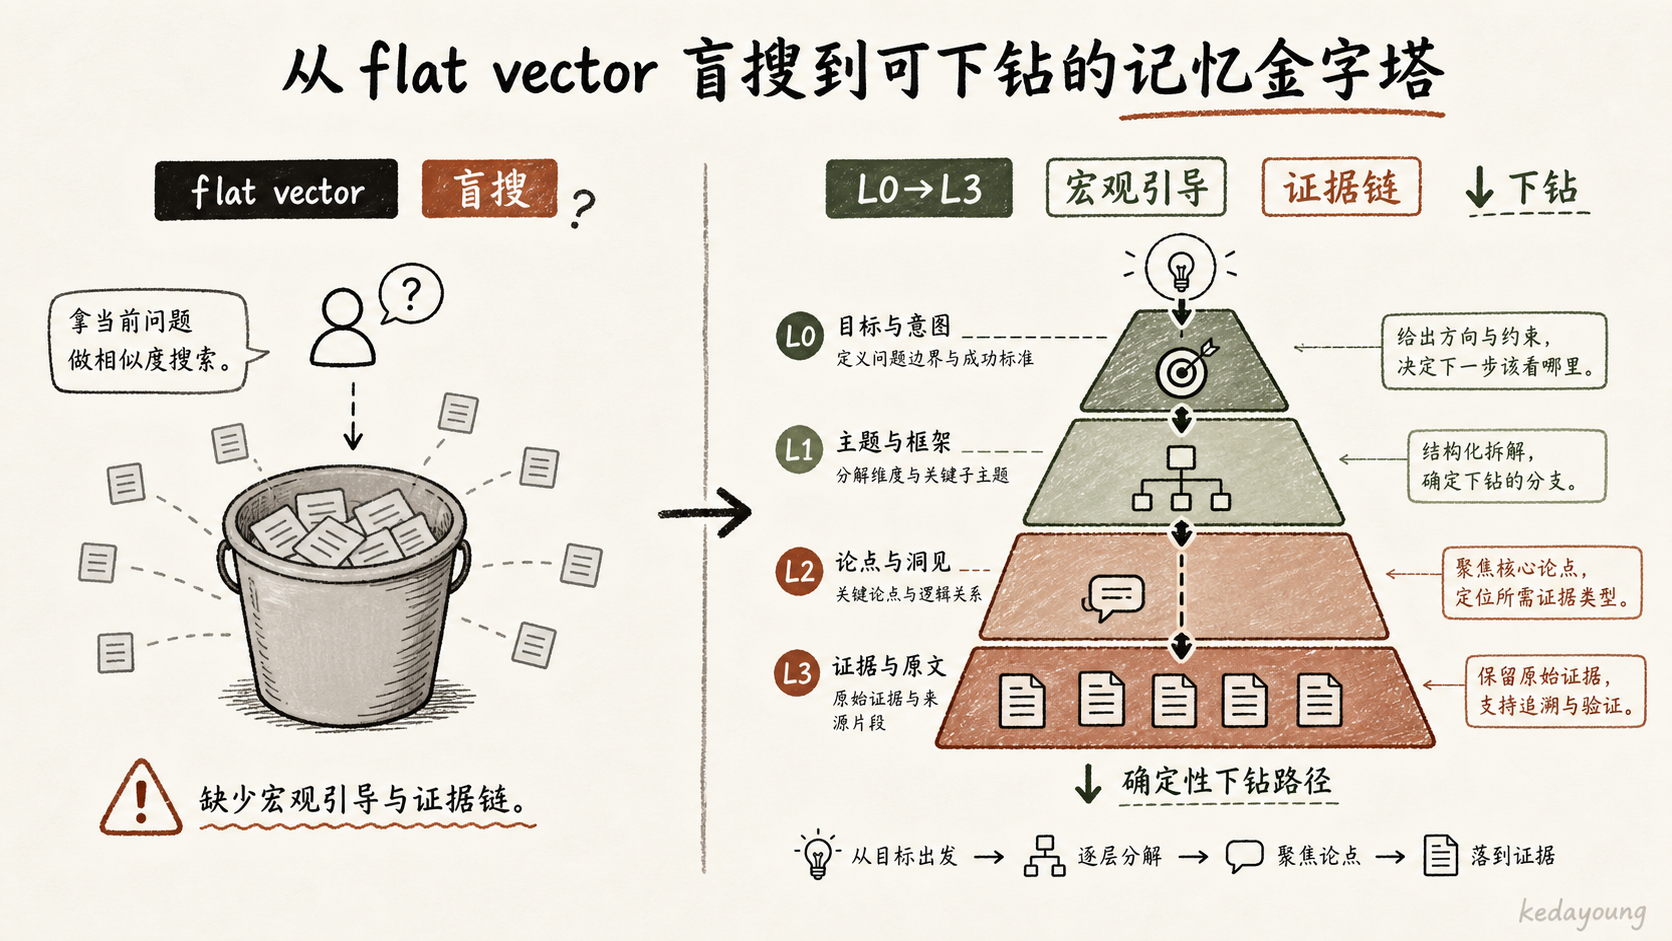
图注:flat vector 的召回退化成「拿当前问题去相似度搜索」的盲搜(缺宏观引导与证据链);分层金字塔把证据留在下层、只把结构送上层,且每层都有通往下钻原始证据的确定性路径(结合 README 的 memory-pyramid 图与
IMemoryStore/IStorageBackend两个接口重绘)。
2. 长时记忆 L0→L3:四层提炼与触发调度
长时记忆的任务是跨会话的:把一次次的对话沉淀成越来越浓缩的知识。它分四层,每层的「提炼度」和「存储形态」都不同。
2.1 L0:原始对话(证据层)
src/core/conversation/l0-recorder.ts:93 的 recordConversation() 在 agent_end 时触发(插件注册点见第 5 节):清洗消息、过滤噪声(心跳、失败轮等),然后追加写到 conversations/YYYY-MM-DD.jsonl——按天分文件、一行一条。这一层不做任何语义提炼,它的价值是完整的原始证据:之后任何一层的结论,最终都能回溯到这里。
L0 的写入有两条工程保障值得注意。一是增量游标:用 afterTimestamp 只保留时间戳比上次记录更新的消息(:154、:168),避免重复写入,还带一道 safety valve(:184-188)——万一游标失效把所有历史都放行了,会告警而不是静默产生重复数据。二是写盘与提炼分离:记录本身不需要 LLM,只做清洗和过滤,所以 L0 是最便宜、最可靠的一层——它永远先于任何提炼存在。
2.2 L1:原子记忆 Atom(提取层)
src/core/record/l1-extractor.ts:79 的 extractL1Memories() 只做一次 LLM 调用(JSON mode),同时完成两件事:场景切分 + 记忆提取(头注释 :5-6 明示「scene segmentation + memory extraction in one call」)。提取结果分三类(prompt 在 src/core/prompts/l1-extraction.ts:15):persona / episodic / instruction——用户画像类、事件类、指令类。
提取后还有两道工序:l1-dedup.ts 做冲突检测,l1-writer.ts 把结果写 records/*.jsonl 并同时写入向量库。L1 是「既存证据又进向量库」的分水岭——向量检索主要作用在这一层。
L1 的冲突检测值得一提(l1-dedup.ts 头注释):它分两阶段,且尽量省 LLM 调用——先对每条新记忆做候选召回(向量 cosine 优先,FTS5 BM25 降级,两者都不可用就整段跳过冲突检测直接入库),再把「所有新记忆 + 各自的候选池」打包成单次批量 LLM 判定,让模型一次性裁决哪些是重复、哪些是冲突、哪些要合并。这里的设计取舍很清楚:把昂贵的 LLM 判断集中到一次调用,用便宜的检索先缩小候选集,是「预算敏感」的典型写法。
2.3 L2:场景块 Scene(导航层)
src/core/scene/scene-extractor.ts 的 SceneExtractor.extract() 让 LLM 扮演 agent:*用文件工具读写 scene_blocks/.md**,把 L1 的原子记忆归并成「围绕一个项目/场景组织」的知识块。代码里有个值得注意的安全设计(scene-extractor.ts:7-9):LLM 的工作目录被沙箱限定在 scene_blocks/,checkpoint、scene_index、persona.md 等系统文件对 LLM 物理不可见。输出是 -----META-START----- 分隔的 Markdown 场景块(scene-format.ts:18-19)。
L2 的意义是「快速恢复一个工作场景」:新会话开始时,注入场景导航比注入几百条零散记忆便宜得多。
2.4 L3:Persona(画像层)
src/core/persona/persona-generator.ts:74 的 generateLocalPersona() 用 CleanContextRunner + 文件工具把全部场景浓缩成一份 persona.md——长期画像、稳定模式、高层认知。这是金字塔的塔尖:跨会话不变的稳定部分,可以放心缓存。
四层的关系可以概括为:下层存证据、上层存结构,L0 最全最原始,L3 最浓缩最稳定。
2.5 触发调度:每一层都有自己的节拍
分层只是骨架,什么时候跑哪一层是调度问题,实现在 src/utils/pipeline-manager.ts:
- L0 → L1:
notifyConversation()(:399)按轮数阈值触发(:429)。默认pipeline.everyNConversations=5(src/config.ts:563),攒够 5 轮才批量跑一次 L1(省 LLM 调用)。新会话有 Warm-up 模式:阈值从 1 开始,每成功跑一次 L1 翻倍,1 → 2 → 4 → 8 → … → 稳态值(:362-387)——新会话先密集学习,稳定后放松。用户停止对话时还有 idle 超时兜底(:438):低于阈值的残留消息也会在超时后被 L1 捡走,不丢证据。 - L1 → L2:用 downward-only timer(:815)——L1 完成后延迟
l2DelayAfterL1Seconds触发,但绝不提前,且受l2MinIntervalSeconds最小间隔保护(默认 900s,config.ts:566-568)。只允许往后推、不允许往前赶,天然限流。 - L1 → L3:由
PersonaTrigger.shouldGenerate()(persona-trigger.ts:35)按 5 个优先级条件判定: - P1 显式请求(Agent/用户主动要求更新画像);
- P2 冷启动(首次提取完成、还没有 persona、已有场景文件);
- P2.5 恢复(persona.md 正文丢失或为空,重新生成);
- P3 首次场景块提取完成;
- P4 阈值:
memories_since_last_persona >= interval(:85),默认persona.triggerEveryN=50(config.ts:555)。
这套调度把「提炼」做成渐进式后台任务:对话在跑,L1 攒批、L2 限流、L3 慢速沉淀,各层互不阻塞、各有兜底。设计上很务实的一点是每一层都有「哪怕不触发也不丢数据」的机制——L1 有 idle 兜底、L2 有最小间隔保护、L3 有恢复触发,证据只可能迟到,不会丢失。
支撑这套调度的基础设施是 checkpoint(.metadata/checkpoint.json,见第 5 节 StoragePaths):每层跑完都推进一个记录「已处理轮数 / 已提取记忆数 / 上次 persona 时间 / 上次 L2 时间」的游标。调度器的所有判定(PersonaTrigger 读 memories_since_last_persona、scenes_processed,:38-41)都基于这个文件,而不是在内存里记状态。好处是进程重启后调度续跑:新会话加载 checkpoint,能精确知道「上次提炼到哪了」,不会因为一次重启就把已提炼的对话重新跑一遍,也不会漏掉没提炼的。这也是为什么 L3 有专门的 P2.5「恢复」触发——checkpoint 说生成了 persona 但 persona.md 正文空了,就重新生成(persona-trigger.ts:61-73)。
图 2|L0→L3 金字塔与触发链路
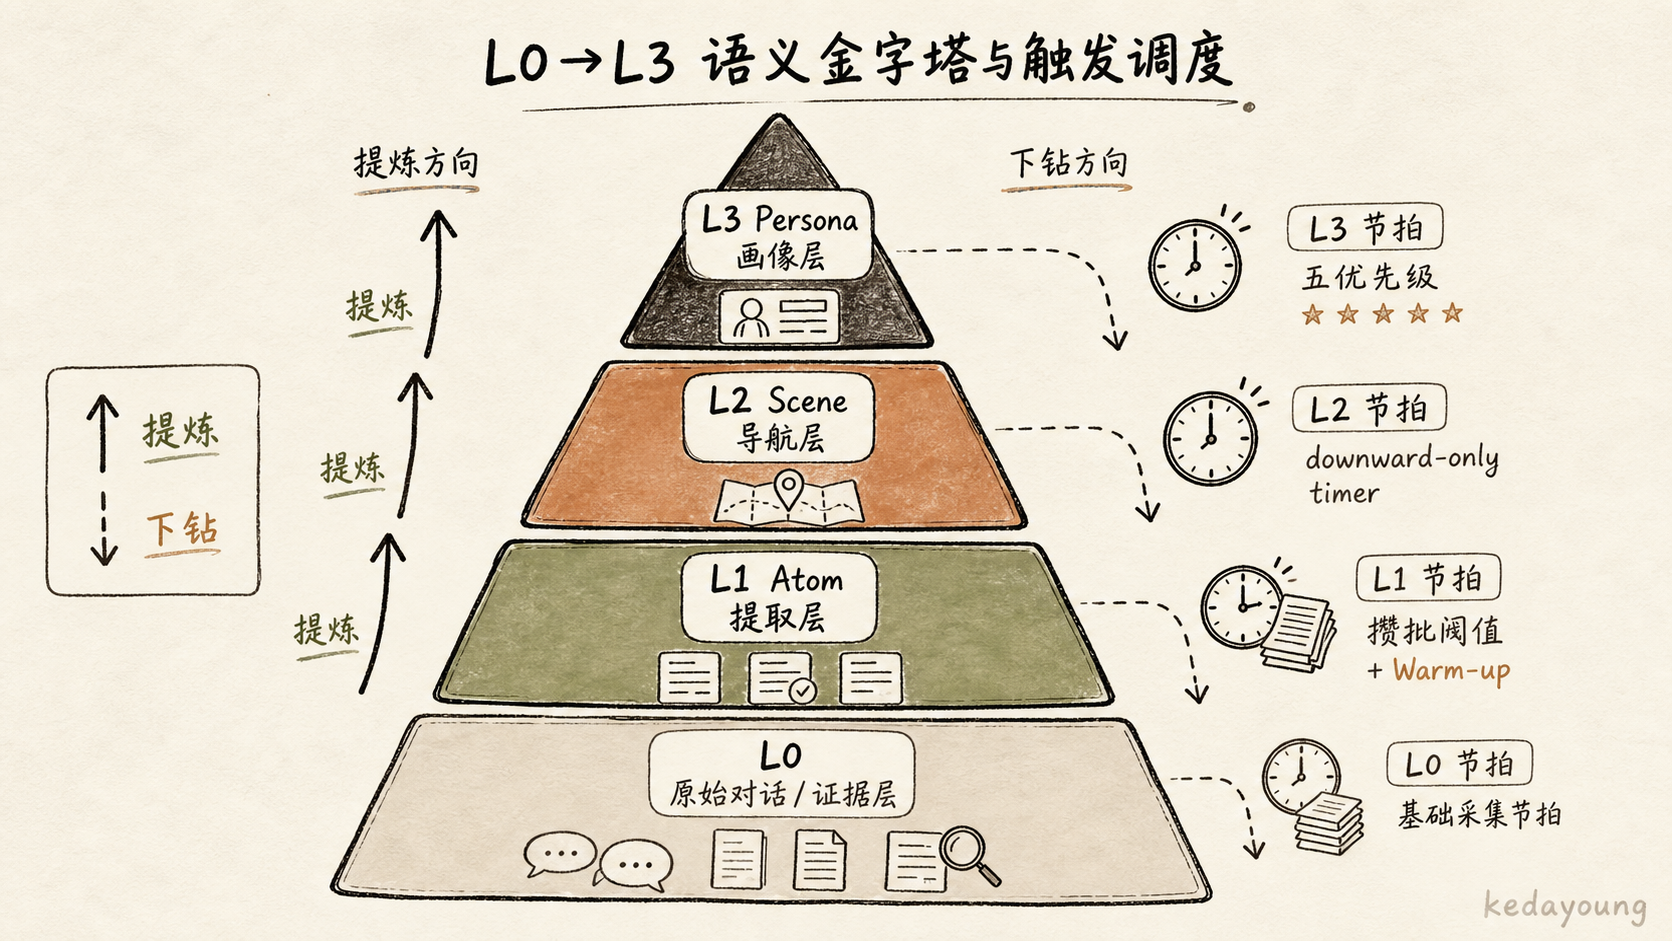
图注:实线是提炼方向(L0 最全最原始 → L3 最浓缩最稳定),虚线是下钻方向;每一层都有自己的触发节拍(L1 攒批阈值 + Warm-up、L2 downward-only timer、L3 五优先级),且各有「哪怕不触发也不丢数据」的兜底。
3. 符号短时记忆:context offload 与 Mermaid canvas
长时记忆解决「跨会话记得住」,但任务内还有一个更痛的 token 问题:一轮长任务里,工具调用的参数和结果在上下文里进进出出,几轮下来就是几万 token。短时记忆子系统(src/offload/)专门压这个。
3.1 卸载管线:工具日志先落盘,上下文只留摘要
流程在 src/offload/index.ts:408-530 的 flushL1():
- 收集:
after-tool-call.ts把一次次的工具调用攒成 toolPairs(调用参数 + 结果 + tool_call_id + 时间戳)。 - 触发:pending 数 ≥
forceTriggerThreshold(默认 4)就触发一次 flush。 - L1.1 写证据:先把完整工具结果写成本地 Markdown 文件
refs/{timestamp}.md(storage.ts:532-544),返回相对路径作为result_ref——原始证据先落盘,一个字不丢。 - L1.2 生成摘要:调用后端
l1Summarize把每个工具调用浓缩成一条摘要 entry,包含summary + result_ref + node_id,追加写offload-{sessionId}.jsonl。失败有重试(最多 3 次)和本地降级兜底。
关键在顺序:先落盘、后压缩。摘要丢了可以重新生成,原始结果丢了就再也找不回来。
flushL1 还有几个工程细节(:400-440 一带的常量与注释):工具对按 L1_BATCH_SIZE = 5 分批打给后端(对齐后端的 toolPairs 上限 1-5),每批失败独立重试 MAX_L1_CHUNK_RETRIES = 3,批次内按首个 tool_call_id 跟踪失败计数,重试耗尽则降级生成本地摘要兜底——单个工具调用的失败不会拖垮整次 flush。另外还有个很细的过滤:心跳类工具调用(HEARTBEAT.md)会在 flush 前被剔除(:426-433),不让它污染摘要与 Mermaid 图。落盘的 ref 文件本身是带头的 Markdown(storage.ts:532-544):# Tool Result: {toolName} + 时间戳 + 完整结果,返回 refs/{timestamp}.md 这样的相对路径作 result_ref——相对路径意味着整个 offload 目录可以整体迁移,证据链不因搬家而断。
3.2 Mermaid canvas:把任务画成一张状态机
摘要只是第一步,真正的「符号化」是 Mermaid canvas——把整段任务浓缩成一张高密度流程图。实现在 src/offload/pipelines/l2-mermaid.ts:
- 触发:
checkL2Trigger()(:96)按l2NullThreshold(node_id 为空的条目数,默认 4)与l2TimeoutSeconds触发。 - 回填:
backfillNodeIds()(:220)把已生成的tool_call_id → node_id映射回写到 offload 条目——这是下钻链的第一环:每条 offload entry 都能对应到图上的某个节点。 - Prompt 约束(
src/offload/local-llm/prompts/l2-prompt.ts:9-54)很能体现「符号即语义」的设计意图: - 节点格式
NodeID["阶段名...status: done|doing|paused|blocked"](:28)——状态本身就是信息; node_mapping强制每一个 tool_call_id 都必须归属到某个节点(:29)——不允许丢调用,保证图可审计;- MMD 文件控制在 4000 字以内(:30);
- 节点 summary ≤150 字,结论导向(「发现死锁」「依赖冲突」「已修复」),不记流水账;
- 弹性聚合:连续同一意图的调用合并成宏观节点,但保留关键转折点;死胡同标记
status: blocked作为「认知墓碑」,防止重蹈覆辙。
3.3 注入与下钻:上下文只留一张图,细节按需取回
生成好的 canvas 不是存起来就完,它要回到上下文。src/offload/mmd-injector.ts:320-370 的 buildActiveMmdBlock() 把活跃任务图以 <current_task_context> 块注入,并在注入文本里显式写下下钻方法:
「可通过 node_id 在 offload.{sessionid}.jsonl 中查找对应的工具调用记录。如需查看某个节点对应的原始工具调用与完整结果,请在 offload.{sessionid}.jsonl 中找到对应条目的 result_ref 并读取该文件。」
同时,压缩替换(src/offload/l3-helpers.ts:184、:224)把历史消息里的 tool_use 参数和工具结果替换成占位符:{_offloaded, node_id, tool_call} / [Offloaded Tool Result | node: xxx]。
注入还有一个配套的防抖机制:mmd-injector.ts 在注入前对 MMD 内容做指纹(computeFingerprint,内容长度 + 前 64 字符),只有指纹变化才重新注入(setInjectedMmdVersion,:325-328)——图没变就不重复刷屏,避免每轮都把一个相同的 <current_task_context> 塞进上下文浪费 token。
更妙的是 before_message_write hook(index.ts:772-800)的配合:自动召回把 <relevant-memories> 块前缀在用户消息上(见第 4 节),而这个 hook 会在消息真正写入历史前把它剥掉。为什么?如果不剥,带着召回记忆的用户消息会被当成正常输入写回记忆库,造成「记忆污染记忆」的自我强化——召回的东西又变成新记忆的来源。剥掉之后,召回记忆只存在于当轮上下文、不落盘、不参与下一轮提炼。这个细节把「注入」和「写入」两个通道彻底分开,是防止记忆系统自激振荡的关键一环。
于是任务内的上下文格局变成:一张 Mermaid 图(约 4k 字)+ 每条工具调用的摘要占位,而不是几万字的原始日志。模型看到的是「任务全貌 + 每个节点的去向」,需要细节时按 node_id → offload.jsonl → result_ref → refs/*.md 主动取回。证据没有消失,只是被压缩并留下确定的取回路径。
3.4 目录布局
src/offload/storage.ts:38-54:~/.openclaw/context-offload/{agentName}/{refs, mmds}/offload-{sessionId}.jsonl + state.json。refs 存原始结果、mmds 存 Mermaid 文件、jsonl 存摘要链、state.json 存进程状态——职责清晰,彼此独立。
图 3|短时记忆闭环:卸载 → 符号化 → 注入 → 按需下钻
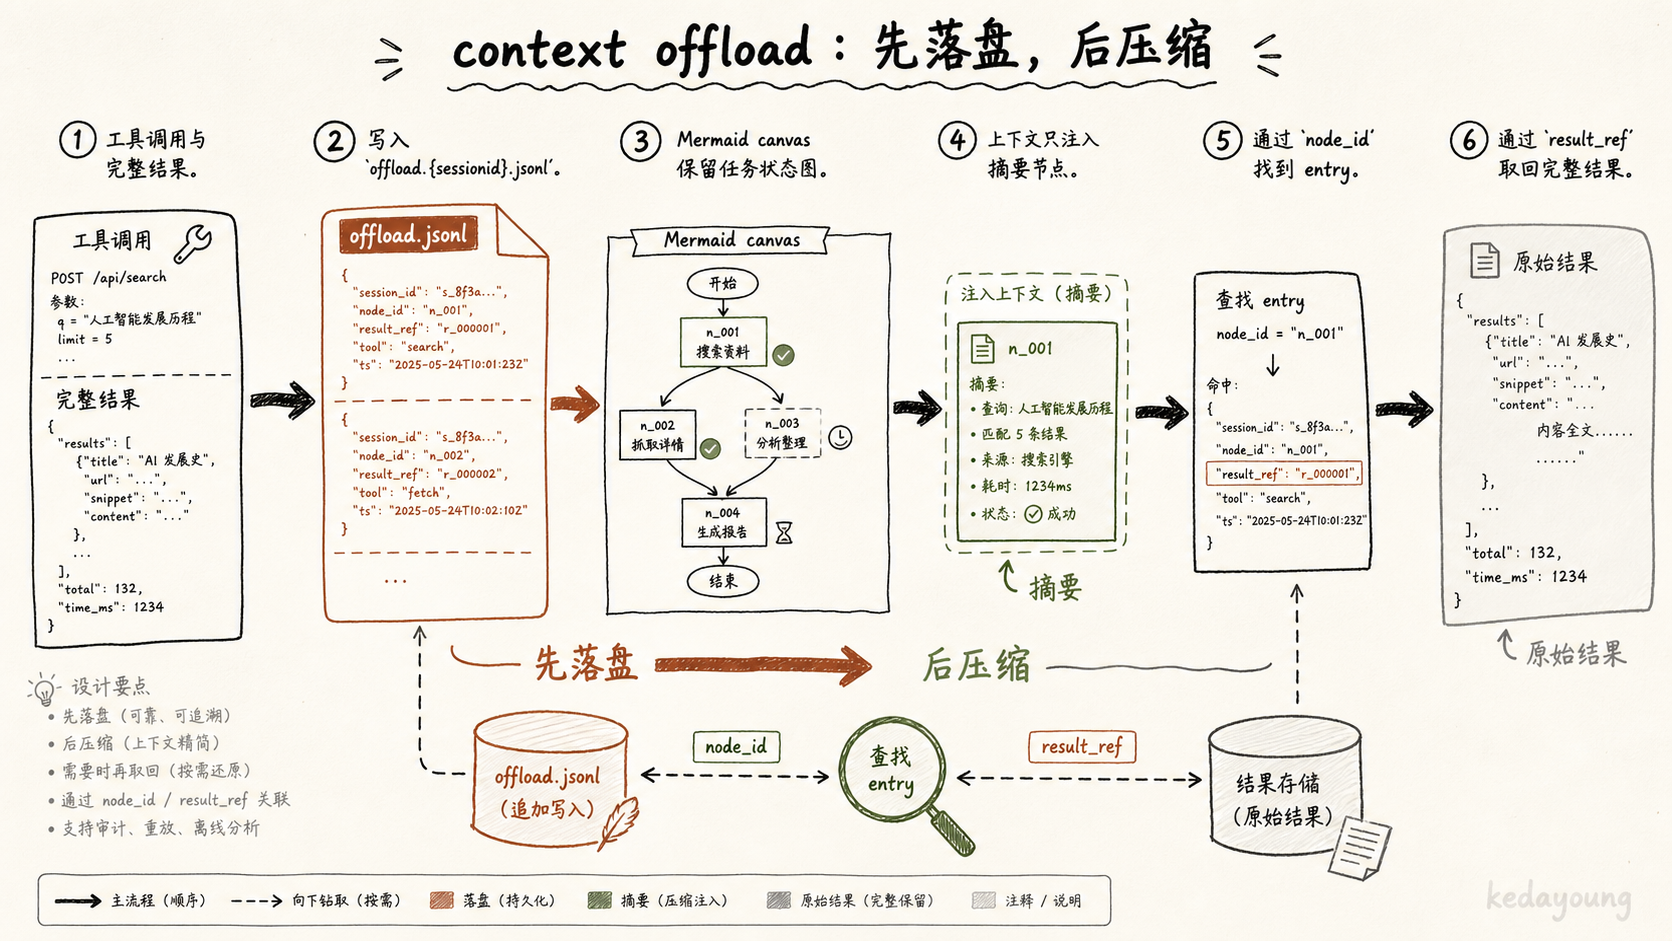
图注:关键顺序是「先落盘、后压缩」——摘要丢了可以重新生成,原始结果丢了就再也找不回来;
node_id/result_ref是下钻链的第一环,每条 offload entry 都能对应到图上的某个节点。
4. recall 检索与注入预算
记忆写进去之后,怎么在合适的时机回到上下文?这分三件事:用什么策略检索、注入多少、注入到哪。
4.1 三策略分派与 RRF 融合
src/core/hooks/auto-recall.ts 提供三种策略:keyword 走 FTS5 BM25(:488)、embedding 走向量 cosine(:494)、hybrid 并行跑两种后在客户端用 RRF(Reciprocal Rank Fusion) 融合(:642-766):RRF_K=60(:727,来自 RRF 论文的常用常数),每条命中的分数是 1/(60 + rank + 1)(:736/:749),两个列表里都出现的结果分数叠加。有个工程细节:如果后端向量库(TCVDB)原生支持 hybrid,则单次请求短路返回(:500-510),不再客户端二次融合——能省一次往返就省。
为什么用 RRF 而不是给两种分数加权平均?RRF 只看排名不看分数,天然规避了 BM25 分数与 cosine 相似度量纲不可比的问题——加权平均需要先做归一化,归一化系数本身又依赖数据分布,是个脆弱的超参数;而 RRF 只需一个常数 K,两条命中的 rank 各算一份分叠加即可。代价是丢掉分数绝对值(相关性强度信息),但融合场景下「两个独立信号都命中」本身就是很强的信号。另外 hybrid 还会放大候选池再融合:candidateK = maxResults * 3(:643),先多取三倍,融合后再截到 maxResults——防止单策略的前 N 名恰好都在对方的列表里垫底。
4.2 注入预算:防止记忆反噬上下文
检索结果不是全塞回去,applyRecallBudget()(:837-894)做预算控制,默认值在 config.ts:573-578:maxResults 5 条、maxCharsPerMemory 单条截断、maxTotalRecallChars 总预算、scoreThreshold 0.3、timeoutMs 5000。预算的执行是逐条收敛:单条超限先截断(truncateRecallLine),总预算仍超就按排名丢弃后续条目,并分别计数 truncatedCount / droppedCount 供日志诊断——被丢被截都有记录,召回不是黑盒。检索本身还有 5 秒超时兜底,超时就返回已有结果,绝不阻塞主对话。记忆是外部信息,超过预算宁可丢也不挤占主对话——README 的原话是「避免记忆反过来占满上下文」。
图 4|recall 检索与注入预算:三策略 → RRF 融合 → 分层注入
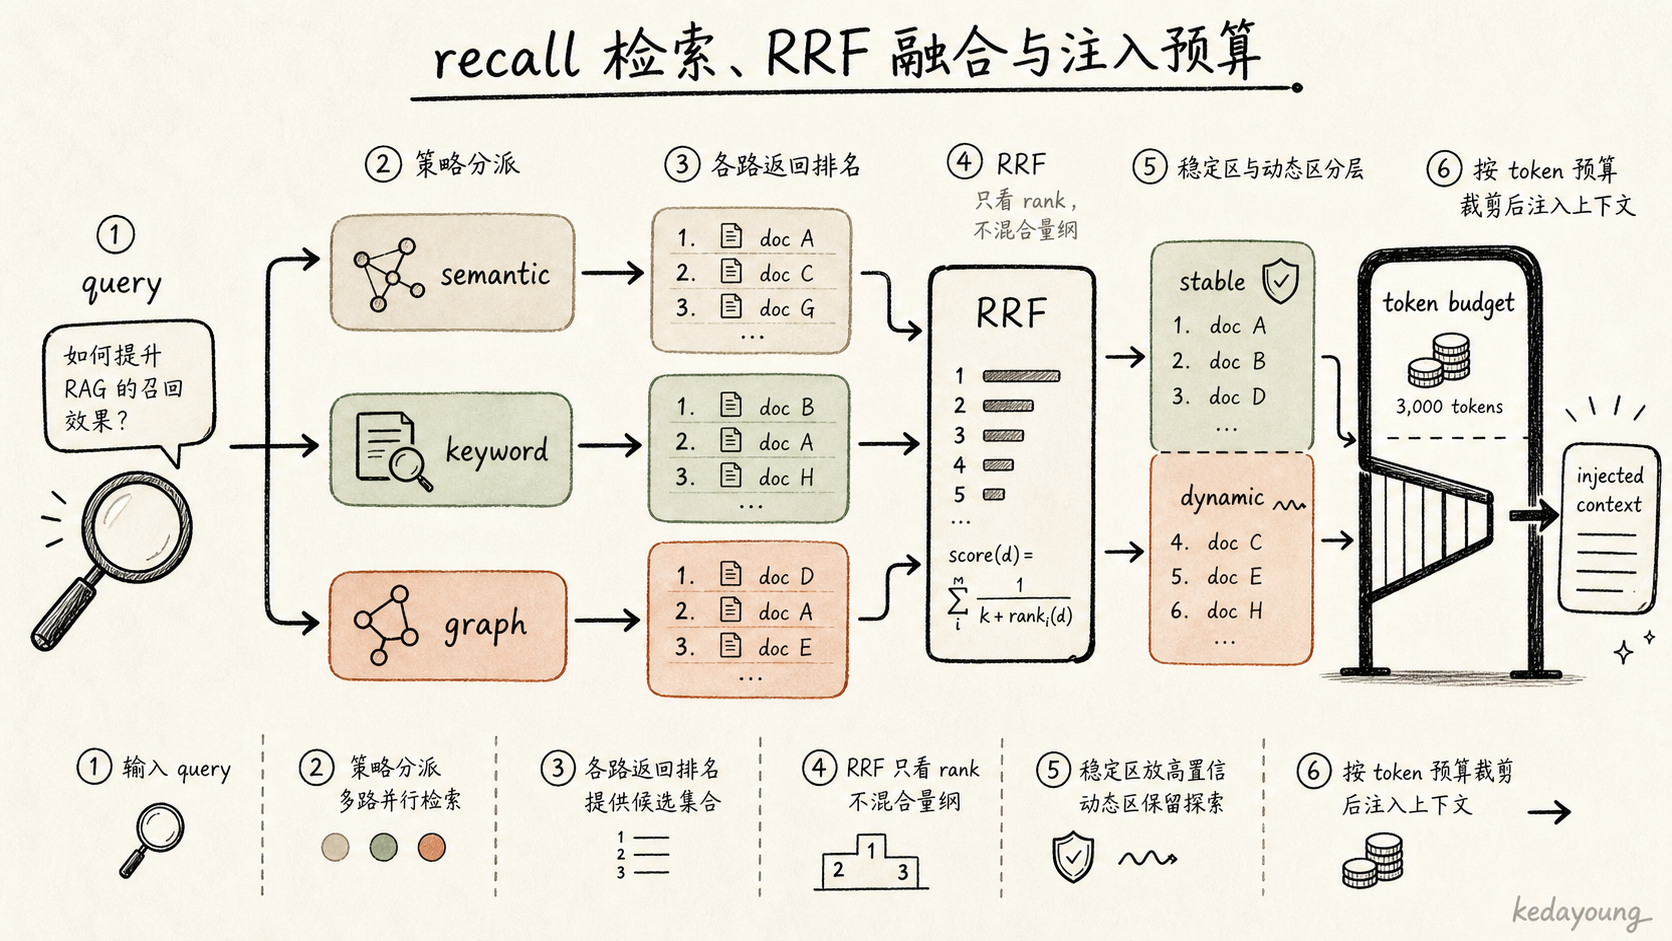
图注:RRF 只看排名不看分数,规避 BM25 与 cosine 量纲不可比;稳定/动态分层注入不只是语义设计,还直接服务 prompt caching 的 token 账单——稳定区被缓存、动态区每轮轮换。
4.3 稳定 / 动态分层注入:配合 prompt caching
召回内容被拆成两部分(:258-260、:277-279 的注释写得很清楚),并分别用 XML 风格的标签包裹:
- 稳定部分:L3 persona(
<user-persona>)+ L2 场景导航(<scene-navigation>)——跨轮几乎不变,追加到系统提示末尾(appendSystemContext:258-260),命中 Anthropic/OpenAI 的 prompt caching,稳定区被缓存、不再重复计费; - 动态部分:L1 相关记忆(
<relevant-memories>,且明确注明「不代表当前任务进程,仅作为参考」)——每轮都不同,放到用户提示前缀(prependContext:277-279),让它别把系统提示的缓存区搞失效。
这是个容易被忽略但很值钱的工程细节:分层不只是为了语义清晰,还直接服务于 token 账单。稳定与动态分离 = 缓存区与非缓存区分离。缓存命中时,几千字 persona 的成本可以近似忽略;如果混在一起,每一轮召回都会让整个系统提示重新计费。
细节检索还有两个工具:src/core/tools/memory-search.ts(查 L1)与 conversation-search.ts(查 L0),同样用 RRF,但返回 record_id 供下钻——record_id 是长时记忆侧的 node_id,把「检索命中」和「原始记录」钉在一起。
5. 存储与插件形态
5.1 SQLite:一个文件里同时住着向量库和全文索引
src/core/store/sqlite.ts(约 3400 行)用 Node 内置 node:sqlite(Node 22+)+ sqlite-vec 扩展(:14、:500),在一个 SQLite 文件里同时建了两种虚拟表:
vec0向量表:l1_vec/l0_vec,USING vec0(embedding float[N] distance_metric=cosine)(:668-673 / :791),KNN 检索searchL1Vector(:1400+);FTS5全文表:l1_fts/l0_fts(:1002 / :1025),BM25 分数有专门转换(:299)。
「一个文件、两套索引」的好处是部署简单——不需要单独起向量数据库服务,本地单机就能跑;要上生产再切远端向量库(TCVDB,tcvdb.ts:866-939 有适配)。两张表的列设计也带着检索路线的印记:vec0 表主键就是 record_id(向量命中的第一件事是拿到可下钻的标识符),fts5 表把 content 建索引、其余字段全部 UNINDEXED(只用来过滤和展示,不参与评分)——索引只落在真正要搜索的文本上,避免全文表膨胀。整个 SQLite 后端与前面提到的降级路线一一对应:向量可用走 cosine,向量不可用退 FTS5 BM25,两个都没有就跳过检索直接走其它路径——每一档都有明确定义,不会静默失败。
5.2 异构存储:什么形态住什么数据
src/core/storage/types.ts:249-277 的 StoragePaths 把第 1 节的两个抽象落成一张路径表:
| 层级 | 路径 | 形态 |
|---|---|---|
| L3 | persona.md | Markdown |
| L2 | scene_blocks/ | Markdown |
| L1 | records/{date}.jsonl | JSONL(+ 向量/FTS 索引) |
| L0 | conversations/{date}.jsonl | JSONL |
| 元数据 | .metadata/scene_index.json、.metadata/checkpoint.json | JSON |
后端可切本地 fs / COS;结构化的(L0/L1)进数据库、半结构的(L2/L3)进文件——这与第 1 节 types.ts:15-18 的接口设计一一对应。Markdown 层的好处很实际:persona 和场景块是给人看的,可以直接编辑、审查、版本管理;向量层负责机器检索。
5.3 插件形态:hooks + 统一门面,宿主无关
MemoryCore 本身是 OpenClaw 插件(index.ts,register() 注册四个 hook:before_prompt_build :681、before_message_write :772、agent_end :808、offload 注册 :982-1000)。但真正的关键设计是中间那层门面——src/core/tdai-core.ts:1-20:
TdaiCore — Host-neutral facade for TDAI memory capabilities. This is the single entry point that both OpenClaw and Hermes/Gateway call to perform recall, capture, search, and pipeline management. It depends only on abstract interfaces (HostAdapter, LLMRunner), never on a specific host.
也就是说,OpenClaw 和 Hermes 都调 TdaiCore.handleBeforeRecall / handleTurnCommitted,各自的差异被收敛进 HostAdapter。插件形态因此有三种落地方式:
- OpenClaw 插件:进程内直连(
OpenClawHostAdapter)——pluginregister()时挂四个 hook,其中before_prompt_build做自动召回、agent_end做自动捕获(L0 记录 + 触发 L1/L2/L3 调度)、before_message_write剥召回标签、offload 注册挂短时记忆管线; - Gateway sidecar:
src/gateway/server.ts(:8420 行级规模)起 HTTP 服务,Hermes 复用为 sidecar(StandaloneHostAdapter)——宿主进程与记忆引擎解耦,更新记忆插件不用重启 Agent; - Hermes 插件:
hermes-plugin/memory/memory_tencentdb/,plugin.yaml挂on_memory_write/on_session_endhooks。
这套「能力进核心、接入走适配器」的形态,让记忆引擎的消费方和宿主解耦——换框架只换适配器,不重写记忆逻辑。从产品形态看,它同时具备库(OpenClaw 进程内)、服务(Gateway sidecar)、插件(Hermes 原生)三种打包方式,同一个 TdaiCore 内核反复复用。
图 5|存储形态与插件门面:一个 TdaiCore 内核,三种宿主,两张存储
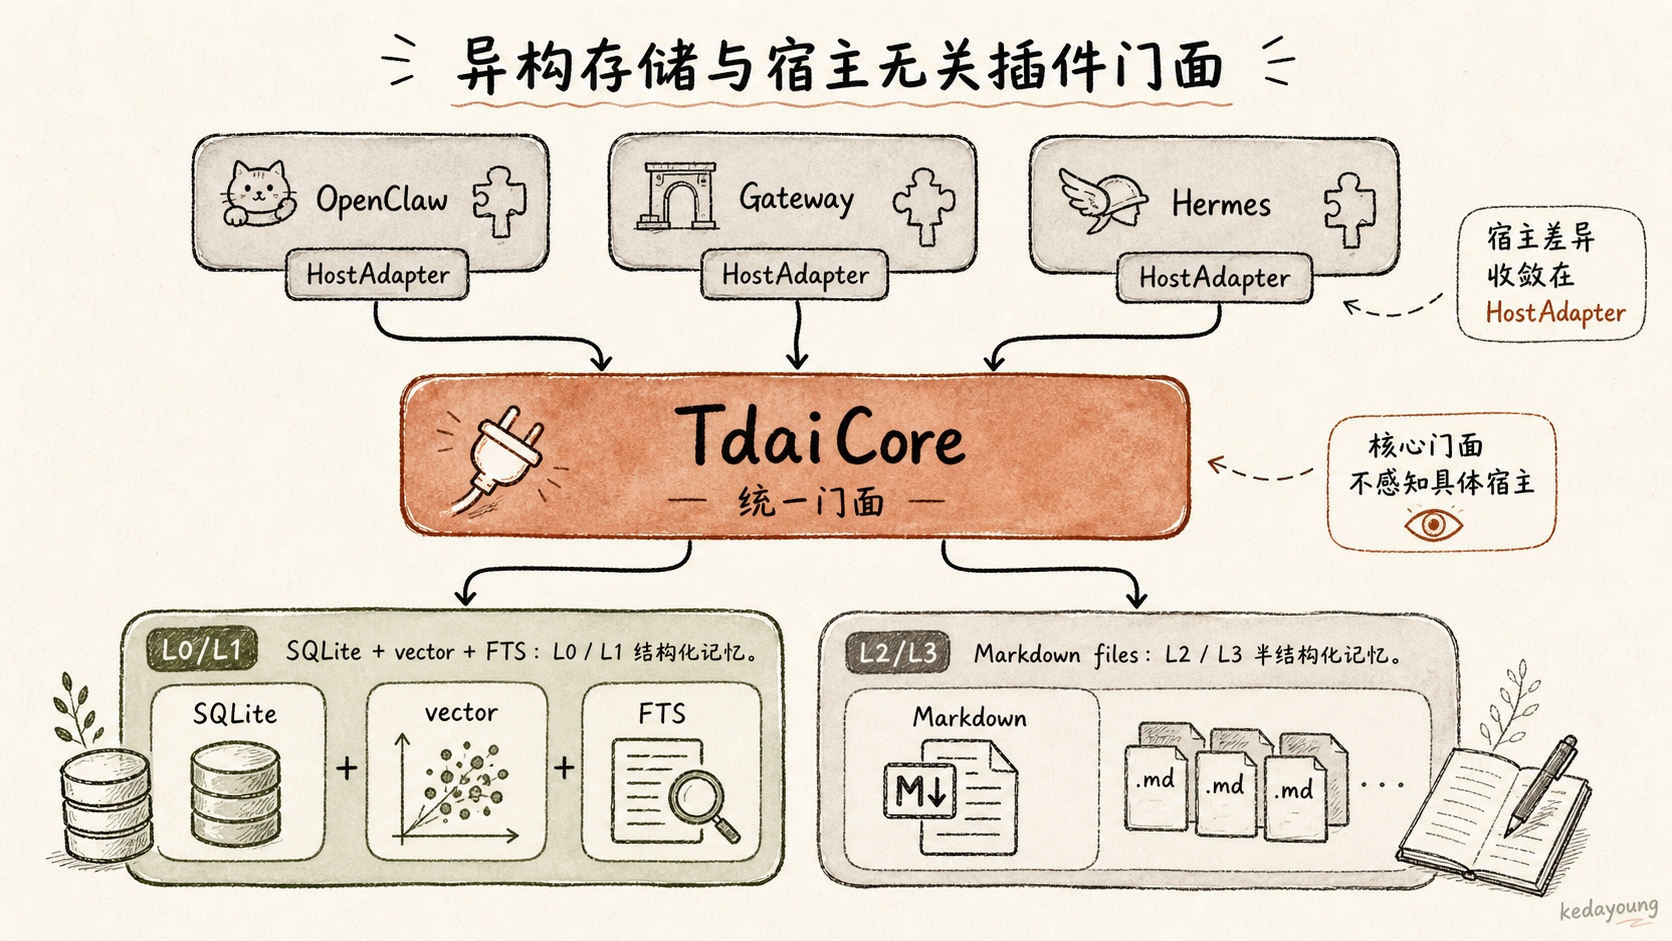
图注:结构化的 L0/L1 进数据库(向量 + 全文索引),半结构的 L2/L3 进 Markdown 文件(可编辑、可审查、可版本管理);OpenClaw / Gateway / Hermes 都只面对
TdaiCore门面,差异被收敛进HostAdapter。
6. 评测、对照与可迁移经验
6.1 评测数字怎么看
README 中英文都只给出了一个可直接复核的 Benchmark(README_CN.md:250-254 与英文版同一表格):PersonaMem 从 48% 提升到 76%(+59%)——检验 Agent 在长期交互后能否正确理解和运用用户信息。按项目文档口径,这是官方自测,且绑定 OpenClaw 插件场景;引用时不宜与其它项目做横向排名。理性看待这个数字:48% 的基线意味着「无记忆的 Agent 在长交互后基本记不住用户信息」,76% 说明记忆系统确实把跨会话的用户理解抬上来了,但单一 benchmark、单一场景,说明不了通用性——这也是下文边界小节要强调的。
需要透明说明的是:大纲素材中提及的另外两个数字(token 节省约 61%、SWE-bench 提升约 9.93%)未在本仓库任何 README(中英文)中找到原始出处,本文遵循证据规则不予引用。如果你想在文中使用它们,需要先从项目方渠道拿到带口径的原文,再决定是否补充。
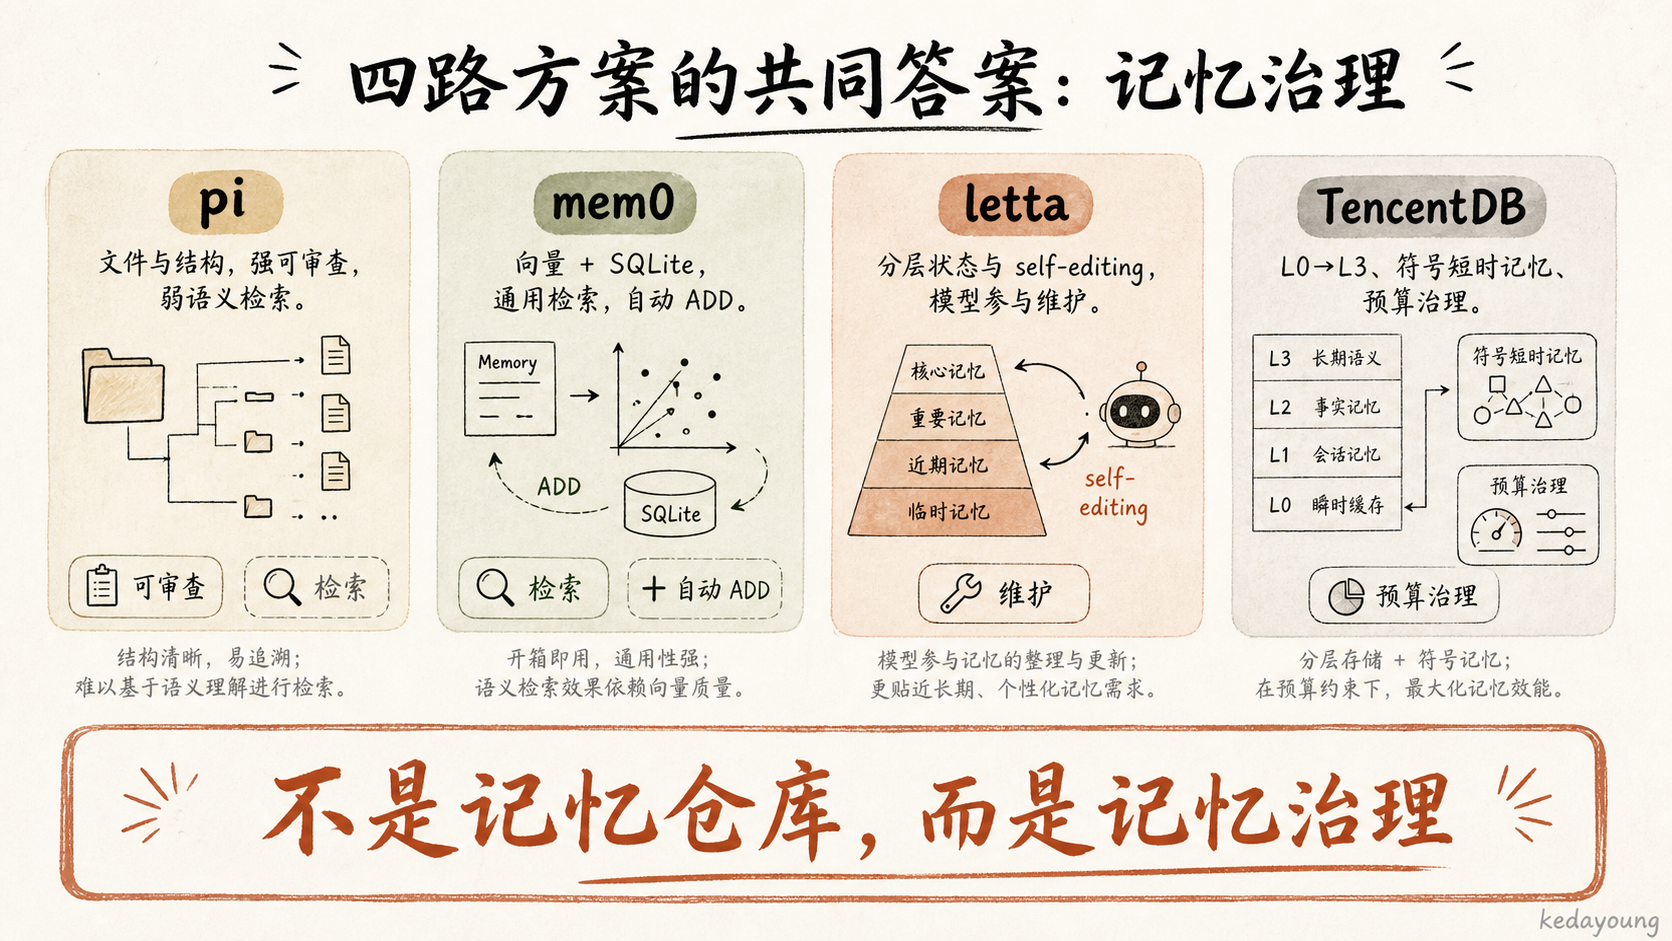
6.2 四路对照:TencentDB 的独特位置
放在 agent 记忆方案谱系里看(以下为系列内的定性对照,非 benchmark 排名):
| 维度 | mem0 | letta | graphiti | TencentDB Agent Memory |
|---|---|---|---|---|
| 记忆归属 | 外部事实库 | Agent 自身状态 | 知识图谱 | 外部事实库 + 任务过程 |
| 短时处理 | 无专门处理 | 状态内自编辑 | 无专门处理 | 符号化 offload(Mermaid + 摘要 + result_ref) |
| 长时结构 | 扁平向量(ADD-only) | 状态向量 | 时序知识图 | L0→L3 语义金字塔 |
| 修订方式 | 追加为主 | 工具自编辑 | 边保留失效 | 冲突检测 + 分层重提炼 |
| 可追溯性 | 弱(只有向量命中) | 弱 | 弱 | 强:每层保留 node_id / result_ref / record_id 下钻链 |
mem0 是「扁平向量 + 追加写入」的典型代表,检索快但不可追溯——它把记忆当作独立于任务的外部事实库,写入靠提取、召回靠相似度,短时任务过程它根本不碰。letta 把记忆做成 Agent 自身状态的一部分,能通过工具自编辑,但记忆和状态耦合在一起,没有独立的证据层可供审计。graphiti 用带失效保留的时序知识图表达演化,图结构比扁平向量强得多,能回答「这个关系是什么时候建立的、后来怎么变的」,但过程性工具日志的符号化压缩仍是空白——它记录的是知识演化,不是任务进行时。
TencentDB 的独特卖点不在检索精度,而在「记忆治理」:每层都可读、可审计、可恢复到原始证据。具体说有三点别人没有的:一是过程记忆(短时 offload 的 Mermaid 图 + 下钻链),其它方案基本不做任务内的符号化压缩;二是证据链贯穿(node_id / result_ref / record_id 三种标识符分别钉住短时工具调用、短时原始结果、长时记忆记录);三是分层即产品形态(稳定注入 vs 动态注入直接落到 prompt caching 的账单上)。这是「记忆系统」与「记忆仓库」的分野——仓库只负责存取,系统还负责治理。
6.3 可迁移的经验(作者判断)
以下四条是从这个实现里提炼、可以搬到其它项目去的模式(属作者判断,非代码声明):
- 符号化压缩替代 verbose 日志:Mermaid / 高密度表示不是「把日志变短」,而是换一种语义承载方式——状态、归属、结论都在结构里,模型一眼能读到任务全貌,还省了逐行读日志的推理开销。适用判据很简单:工具调用密集、单轮结果很长、跨轮强依赖的任务收益最大。
- 分层提炼 + 渐进披露:稳定信息(画像、场景导航)与动态信息(相关记忆)分开注入,既服务语义又服务 prompt caching——这是唯一一条「同时优化质量与成本」的模式,别的方案常常顾此失彼。
- evidence chain 下钻:
node_id/result_ref/record_id三个标识符贯穿全文,让「高层结论 → 原始证据」永远有一条确定性路径。这条最值得抄:实现成本是「写摘要时顺手记下来源 id」,收益是整条记忆链可审计、可修正、可回滚。 - 插件化接入:能力进核心、接入走
HostAdapter门面,一个引擎服务多个宿主;配套 checkpoint 落盘让调度可恢复,配套「注入/写入通道分离」防止记忆自激振荡。
6.4 边界与适用性
也要说清边界:评测绑定 OpenClaw 场景,跨框架表现需自行验证;短时符号化对工具调用密集的任务收益最大(纯对话场景的 offload 价值有限);实现依赖宿主框架版本与 Node 22+(node:sqlite);L1 提取是单次 LLM 调用,长上下文的切分质量依赖 prompt 与模型能力。
结语
回到开头的两个问题。省 token 靠的是双管齐下:短时记忆把工具日志卸载成「文件证据 + 上下文摘要图」,长时记忆用金字塔把证据留在下层、只把结构送上层。可追溯靠的是同一条铁律——每一层都留下到下钻原始证据的确定性路径。这两件事不是两个独立的优化,而是一个整体的两面:正因为证据没有丢,压缩才是安全的;正因为每一层都可下钻,高层结论才敢被模型当真。
这个项目最值得借鉴的,不是某一个检索技巧,而是把记忆当成需要治理的基础设施:证据不丢、结论可查、每层可审计、接入可移植。对于正在给自己的 Agent 设计记忆层的工程师,三个动作可以直接带走:先定义你的 evidence chain(用什么标识符把结论钉回证据),再决定哪些信息稳定可缓存、哪些动态要轮换,最后把工具日志的符号化压缩做进任务循环——而不是继续往向量库里堆碎片。
记忆系统没有标准答案,但有一条底线是共通的:你可以让 Agent 忘记细节,但不能让它失去找回细节的能力。 TencentDB Agent Memory 的价值,就是把这句口号落成了 node_id、result_ref、record_id 三条看得见、查得到、断不了的路。
附录:本文引用的关键证据位置
(全部以克隆 commit 0a568c3 为准,路径相对 MemoryCore/)
| 断言 | 位置 |
|---|---|
| 两个平行抽象(IMemoryStore / IStorageBackend) | src/core/storage/types.ts:15-18 |
| L0 记录 | src/core/conversation/l0-recorder.ts:93(写 conversations/YYYY-MM-DD.jsonl;增量游标 :154/:168、safety valve :184-188) |
| L1 提取(单次 LLM:场景切分+提取) | src/core/record/l1-extractor.ts:79(头注释 :5-6) |
| L1 冲突检测(候选召回 + 单次批量 LLM 判定) | src/core/record/l1-dedup.ts(头注释) |
| L2 场景提取(LLM 沙箱到 scene_blocks/) | src/core/scene/scene-extractor.ts(:7-9);scene-format.ts:18-19 |
| L3 persona | src/core/persona/persona-generator.ts:74 |
| 触发调度与 Warm-up(1→2→4→8) | src/utils/pipeline-manager.ts:362-387、:399、:429、:438 |
| L2 downward-only timer | src/utils/pipeline-manager.ts:815 |
| L3 五优先级触发 | src/core/persona/persona-trigger.ts:35、:85 |
| 配置默认值(everyN=5 / triggerEveryN=50 / L2 间隔 / recall 预算) | src/config.ts:555、:563、:566-568、:573-578 |
| 卸载管线(refs 先行、摘要+result_ref+node_id) | src/offload/index.ts:408-530;src/offload/storage.ts:532-544、:38-54 |
| Mermaid canvas 触发与回填 | src/offload/pipelines/l2-mermaid.ts:96、:220;prompt local-llm/prompts/l2-prompt.ts:9-54 |
| 注入与下钻说明、压缩替换 | src/offload/mmd-injector.ts:320-370;src/offload/l3-helpers.ts:184、:224 |
| recall 三策略与 RRF(K=60) | src/core/hooks/auto-recall.ts:488、:494、:642-766、:727、:736 |
| 注入预算与稳定/动态分层 | src/core/hooks/auto-recall.ts:258-260、:277-279、:837-894 |
| SQLite + vec0 + FTS5 | src/core/store/sqlite.ts:14、:500、:668-673、:791、:1002、:1025、:1400+ |
| 异构存储路径 | src/core/storage/types.ts:249-277 |
| 插件 hooks 与 TdaiCore 门面 | index.ts:681、:772、:808、:982-1000;src/core/tdai-core.ts:1-20 |
| PersonaMem 48%→76%(+59%) | README_CN.md:250-254(英文 README 同表) |