面向把 M-Agent 嵌入 Python 应用的工程师。前提是已经理解 Durable Run 的 create/start/resume/resolve、Checkpoint、Lease 与有界恢复语义;本文不重讲 整套 Core,而是回答:一次 Run 可以恢复之后,连续客服对话还缺什么?
分析日期:2026-09-08。固定源码提交:
48a011e2f950287735bce1c12eca50b1cdaad4e7。下文源码和测试链接全部指向 这个完整 SHA,不随分支或“最新版”移动。前篇为本地文章 《Durable Run 源码解析》, 已收录于本站技术栏目。证据标记:“设计决策”指领域文档 CONTEXT 与已接受的架构决策记录(ADR); “实现事实”指固定修订中的源码控制流;“作者推断”指基于这些事实的应用解释; “本次结果”指文末列出的离线执行。历史规范与旧文章中的测试数量不是本次运行结果。遇到设计与实现 不一致,分别陈述,不以注释或测试通过代替实现核对。
开场:用户的第二句话应该接在哪里
用户先问:“订单还没送到,能查一下吗?”Agent 查询物流并给出最终答复。 用户接着说:“那帮我联系一下客服,通知我处理结果。”
前篇已经解决第二次执行内部的一类事故:通知可能已经发送,Tool Checkpoint 却没落盘,Run 应进入 WAITING,由应用核实并处置。现在把镜头拉远,会遇到 另外四个问题:
- 第二句话如何带上第一轮答复,而不把全部工具轨迹塞进历史?
- 等待通知确认时,第三句话能不能抢先开始另一个 Run?
- 物流条款、工单状态和长上下文怎样进入请求,恢复时能否重新取一份?
- 判断另一个模型更便宜或更合适的证据从哪里来,什么时候允许它影响下一轮?
这些问题共享一条主线,却不是同一份状态。作者推断: 如果把它们都命名为 “Agent Memory”,系统就很难区分“用户已经听见的答复”“本次执行看见的数据” 和“下一次选择模型时可使用的证据”。Companion 的价值正是区分这些事实,再让应用显式组合。 Session 与 Run 分库、创建前冻结历史、单一 Claim、成功 Turn 的决策依据分别为 ADR-0018、0019、0020、0021。
1. 先看四份账,不把 Companion 当成另一个 Runner
设计决策: Runtime Companion 建立在稳定运行时契约上,不通过 hook 改写 Runner 的核心循环。Session、Routing、Eval 属于组合层;Context 的执行声明、 触发与恢复事实属于 Core,算法能力的归属与是否已经交付还要分开核对。 领域定义见 CONTEXT,Context、Routing、Eval 的决策分别见 ADR-0040、0041、0029。
| 边界 | 权威保存什么 | 不负责什么 |
|---|---|---|
| Run Store | 单 Run 输入、冻结 Definition、Conversation History、状态、Step/Attempt/Checkpoint、Lease、预算消耗 | 不拥有会话授权、历史追加、模型选择与评估报告 |
| Session Store | scoped Session、历史版本、有序成功 Turn、当前 Run Claim | 不保存中间模型响应和工具执行轨迹,不判断外部效果是否发生 |
| Routing Store | 不可变 Decision、所用 Evidence snapshots、后续追加的 Run binding | 不启动 Run,不修改已冻结模型,不提供跨 Store 事务 |
| Eval Store | Execution、Observation、Evaluator Result、Report revision、Baseline、Recommendation | 不把评估结论写回生产 Run 或自动发布新 Policy |
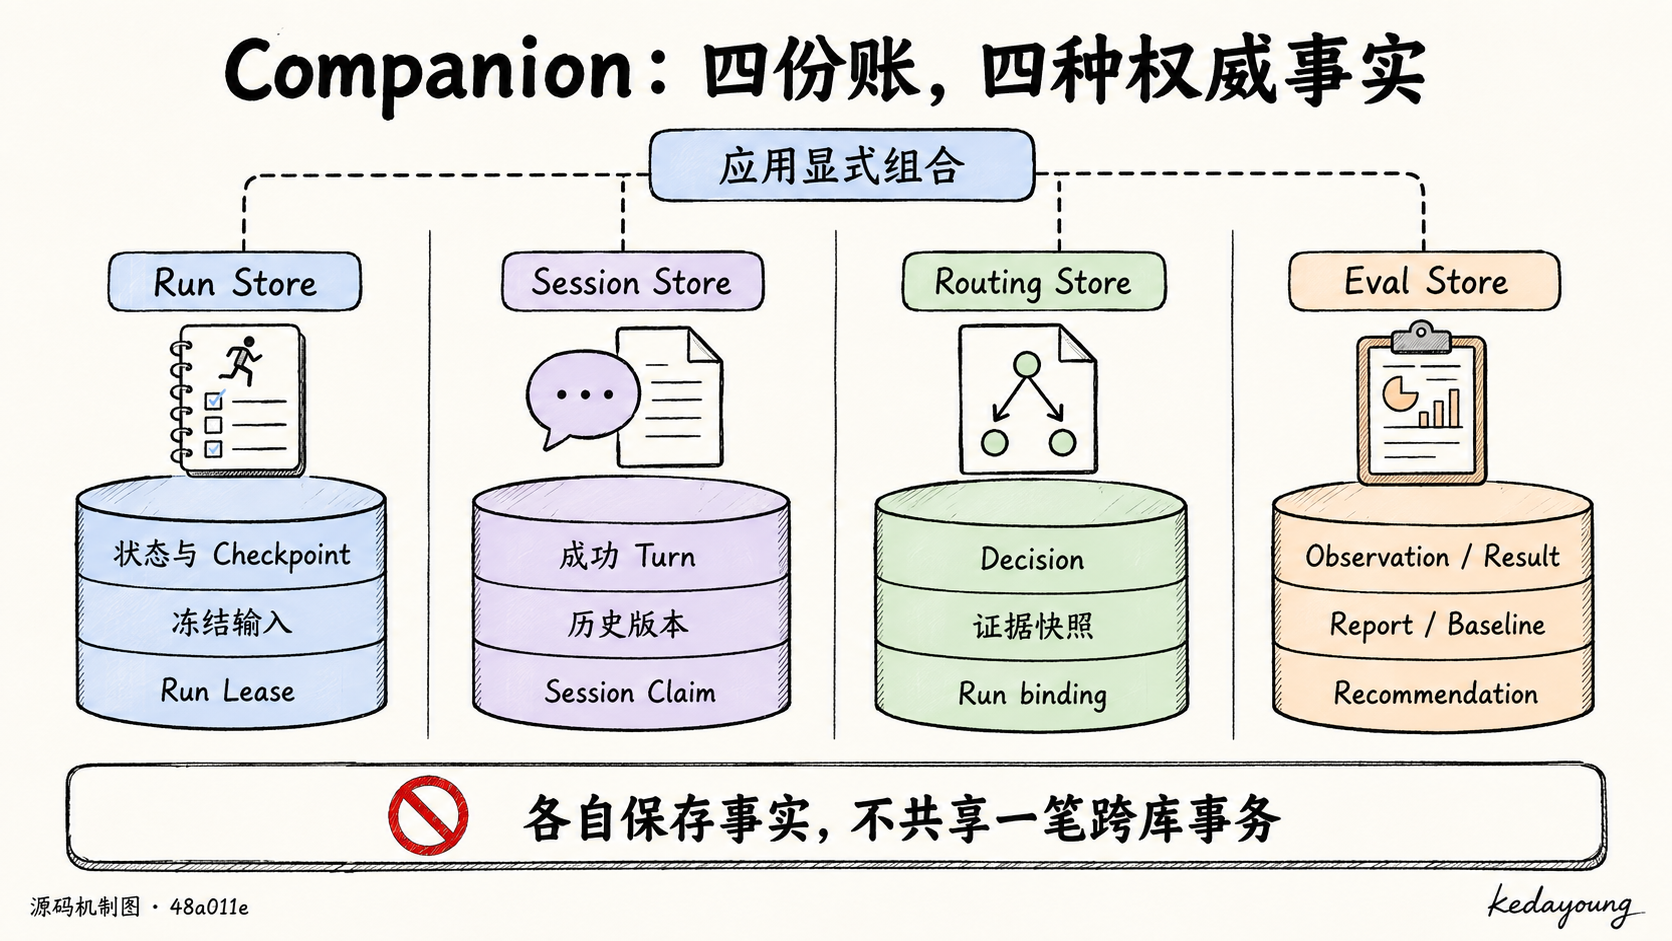
图 1:四份账分别回答不同问题。本文配图与微动画均为固定修订的机制说明,不是运行录屏。
表中的 Session、Routing、Eval Store 都有进程内和 SQLite 实现。SQLite 提供各自的 本地持久化边界,并不因为名字都叫 Store 就共享一笔事务。接口与实现分别见 SessionStore、Routing Store、EvalStore。
公开入口可以先记成下面几条,而不是一个万能的 agent.chat():
SessionStore.create_session
  -> SessionRunner.submit
  -> SessionRunner.commit_status / resume

ModelRouter.select
  -> 应用接受 SELECTED、保存 Decision
  -> Runner.create_run
  -> bind_decision_to_run / RoutingStore.attach_run_binding
  -> Runner.start_run

EvalObserver.observe_selection                  # 已有 Run,只读
EvalExecutionEngine.run_suite / resume_execution # 隔离受控执行
  -> build_report_revision / record_report
  -> record_baseline / compare_report_revisions
  -> record_recommendation
  -> 应用另行批准并发布新 Policy / Variant
这是几条可组合的公开路径,不是一条框架自动执行的总流水线。尤其不要把 SessionRunner.submit() 与 Routing 的底层示例接成“两次 create_run”: 前者内部已经创建并启动 Run。S1 R1 E1
2. 第一轮成功之后,Session 究竟留下什么
2.1 五个相似名称,回答五种不同问题
实现事实: SessionRunner.submit() 只在创建前读取一次完整 Snapshot, 每条 Turn 展开成一对 USER/ASSISTANT 消息,再交给 Core 冻结。S1
| 对象 | 客服例子中的意义 | 保存位置与寿命 |
|---|---|---|
| Session Snapshot | 提交第二句话前看到的全部成功轮次与历史版本 | Session Store 读取结果;不是 Run 的动态依赖 |
| Conversation History | 第一轮用户问题和最终答复组成的有序消息 | 创建时复制到受保护 Run Payload,此 Run 恢复继续使用 |
| Session Turn | 一次成功 Run 的用户输入、最终输出、Run 与 Definition 身份、时间 | Session Store 追加事实;不是完整 transcript |
| Session Run Claim | “这段会话当前由这个 run_id 占用,基于历史版本 v” | Session Store 持久化,不设固定 TTL |
| Run Lease | “这个 Runner 目前有权推进该 Run” | Run Store 中带有效期的排他推进权 |
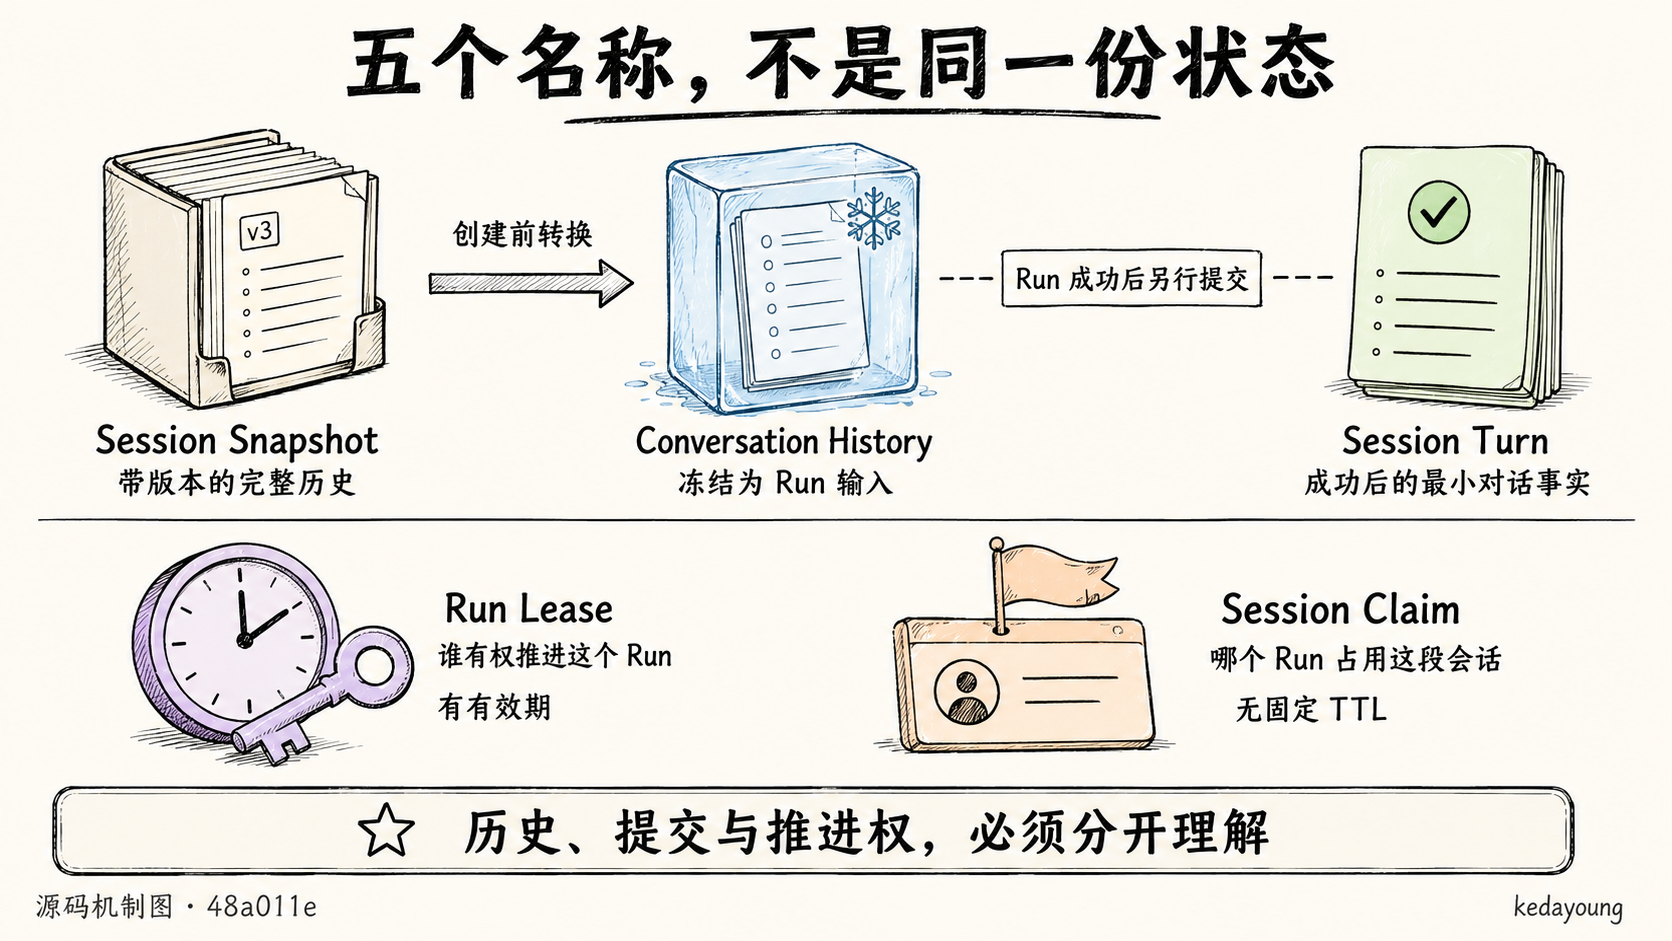
图 2:历史输入、成功提交和推进权限是三类不同事实。
Snapshot 有版本和 Session 身份,History 没有这些字段;Turn 不包含 Context Item、 system/tool 消息或任意 metadata。Claim 的 session_version 是成功提交时 比较并交换(CAS)的版本依据,不是 Run 自身的进度版本。精确字段见 Session 数据模型;History 冻结与最小 Turn 字段由共享会话测试验证。
作者推断: 第一轮查询过十次物流工具,不代表下一轮需要重播十段工具结果。 下一轮需要的“对话连续性”与运维追查需要的“执行证据”应分别读取 Session Store 和 Run Store。代价是调查一个投诉时可能需要关联两份记录,而不能只打开聊天表。
2.2 从公开 API 提交两句话
下面是组合片段,不包含 Adapter、凭据和 Store 的部署初始化。runner 已注册 精确的 support@1,sessions 是新 Store,scope 由应用授权层提供:
from m_agent.companion import SessionCommitStatus, SessionRunner


async def two_turns(runner, sessions, scope):
    await sessions.create_session(scope, "support-42")
    conversation = SessionRunner(runner=runner, session_store=sessions)
    first = await conversation.submit(
        scope, "support-42", "support", "1", "Where is my order?"
    )
    if first.commit_status is not SessionCommitStatus.COMMITTED:
        return first
    return await conversation.submit(
        scope, "support-42", "support", "1", "What can I do next?"
    )
本文配套 验证脚本 用确定性 Adapter 实际验证了同样的两轮顺序: 历史版本为 2,第二个 Run 冻结两条历史消息,Claim 在提交后清除。英文输入只是 离线 fixture,不代表真实客服模型理解能力。生产应用还必须分别处理 Run 状态、 Session 提交状态和调用异常,不能只判断返回文本非空。
2.3 submit 内部真正的时间顺序
沿 [SessionRunner.submit]S1 追踪:
read_snapshot(scope, session_id) -> Snapshot(version=v, turns)
turns -> immutable Conversation History
预分配 run_id
claim_run(..., expected_version=v)
Runner.create_run(definition_id, definition_version, input,
                  run_id=run_id, history=history)
Runner.start_run(run_id)
依据 Run Store 终态提交 Turn / 释放 Claim / 保留 Claim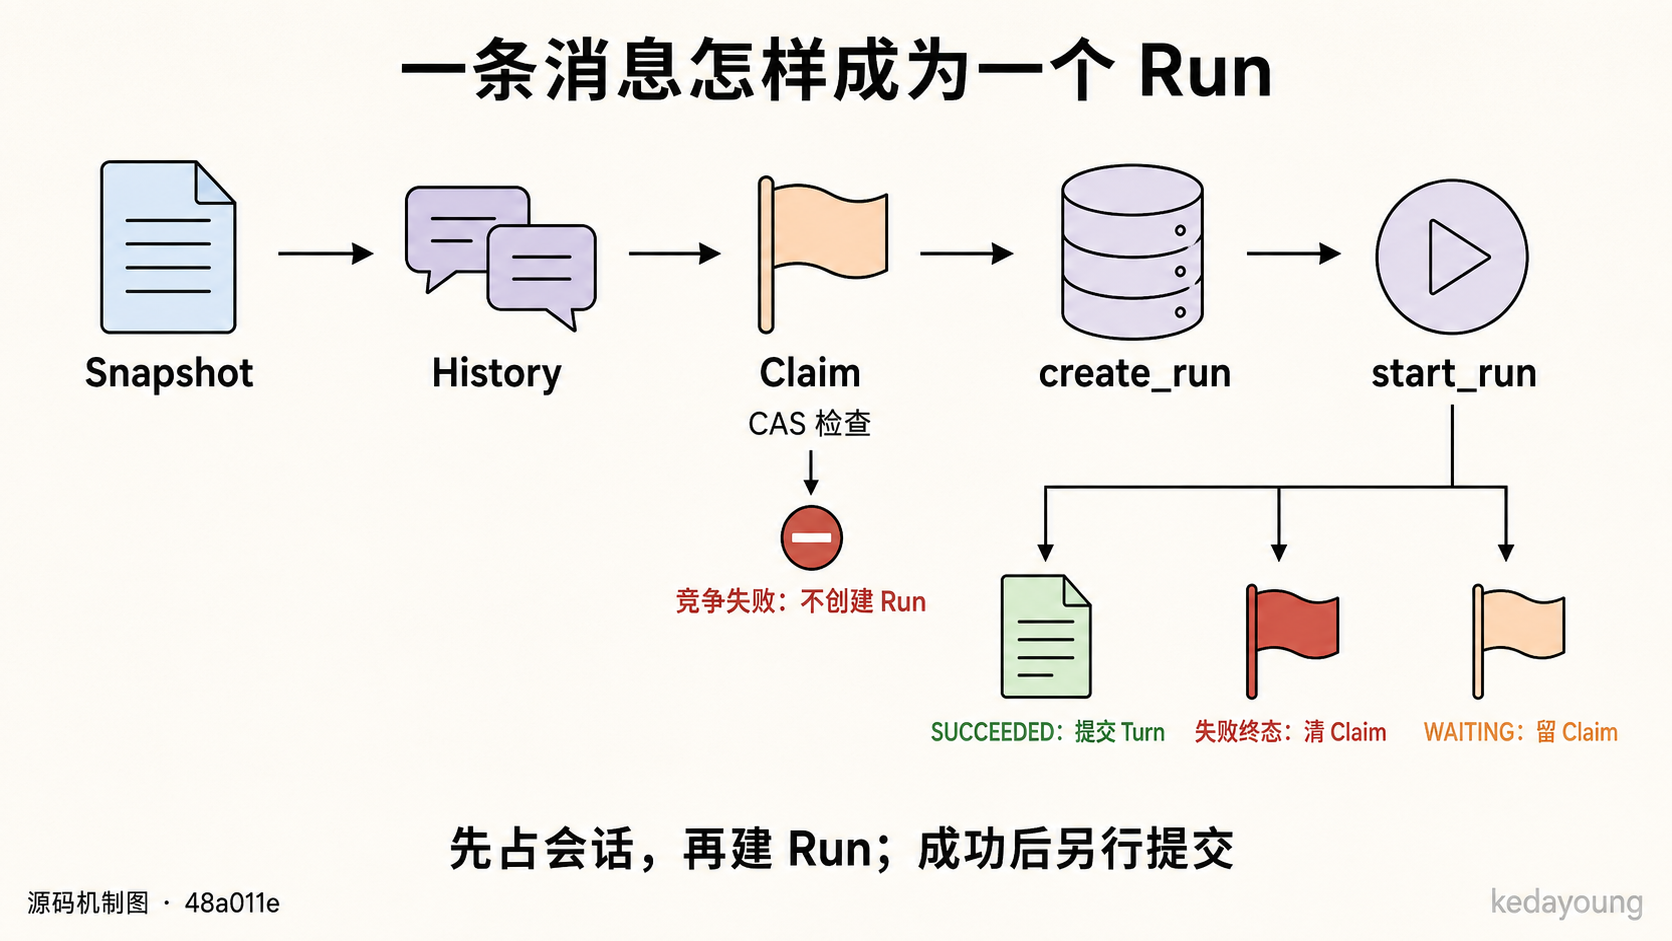
图 3:竞争失败发生在创建 Run 之前;成功后的 Turn 提交是另一个持久化动作。
Claim 先于 Run 创建,目的是让并发的第二次 submit() 在创建执行记录和调用模型前 失败。claim_run 会同时检查 active Claim、已提交 Run 身份和历史版本。 读取 Snapshot 后如果历史版本已经推进,CAS 会失败,不能再用旧历史启动 Run。 SQLite claim 实现与并发公共 API 测试分别给出事务条件和调用计数。
Runner.create_run() 保存 History 后,后续 Model Step 和恢复不重新读取 Session 的对话正文。但“Core 不重读 Snapshot”不等于“整个 Session 恢复完全不读 Session Store”:SessionRunner.resume() 必须读取 scoped metadata 和 Claim, 才能知道要恢复哪一个 Run。S1 ST1
2.4 Scope 是应用传入的隔离条件,不是模型上下文
SessionScope.token 是不透明字符串,Store 做相等性比较,不替应用实现登录、 RBAC 或租户关系。跨 Scope 和不存在的 Session 对调用方表现一致;同一个 session_id 在不同 Scope 下可以是不同会话。Scope 不进入 Conversation History。 见 SessionScope 与 Store 契约及跨 Scope 共享测试。
SQLite Session Store 将 Turn 正文交给自己的 Payload Codec。Run Store 中另一份 History 也需要它自己的 Codec;只加密其中一库并不能保护另一库中的副本。 默认明文 Codec 不提供保密性。SQLite Session payload 测试检查了元数据 不含对话正文,以及使用错误密钥时读取失败;这些测试不构成对生产密码学方案的认证。
3. Run 已成功,为什么客服历史里还没有它
3.1 两个状态不能压成一个“成功”
设计决策: 只有 Run Store 中的权威状态进入 SUCCEEDED 才追加 Turn。Session 提交 失败不改写 Core 终态,也不会为了补历史而重发通知。D21
| Run 状态 | Session 动作 | 可观察提交状态 |
|---|---|---|
SUCCEEDED,提交完成 | 追加 Turn、清 Claim、历史版本 +1 | COMMITTED |
SUCCEEDED,提交调用抛普通异常 | 返回待对账结果,不重写 Run | PENDING |
SUCCEEDED,Claim/CAS 不匹配 | 拒绝合并或覆盖历史 | CONFLICT |
REJECTED / FAILED / CANCELLED | 只清 Claim,不追加 Turn | NOT_READY |
WAITING 等非终态 | 不追加,不清 Claim | NOT_READY |
具体分支见 [_complete 与成功提交路径]S4。第二行的 PENDING 是本次调用未 收到提交确认,并不证明 Store 一定没有提交:如果“提交后返回前”出错,Claim 可能已清除。这时应查询 commit_status() / find_turn_by_run() 重新确认事实, 而不是直接再次 submit()。
演示限定在 Turn 尚未写入、Claim 仍完整的补提交窗口;PENDING 本身并不证明未提交。以下动画均为源码机制说明,不是运行录屏。
3.2 commit_turn 原子的是 Session 内部,不是两库之间
SQLite commit_turn() 在一笔 BEGIN IMMEDIATE 事务内先检查同 Run 的既有 Turn。已经提交时直接返回原 Turn,即使调用方重试时重新生成了 turn_id。 没有既有 Turn 时,才检查 Claim 与 expected_version,编码正文、插入 Turn、 删除 Claim、递增历史版本并提交事务。Codec 或写入异常会使事务回滚。S5
run_id 因此是 Session 内“只追加一次”的幂等键。但 Session Store 自身不查 Run Store,也不独立证明这个 Run 已经成功;成功条件由 SessionRunner 读取 权威 Run 后保证。应用直接调用 commit_turn() 时必须承担这部分前置检查。 不能把这个底层原语理解成无需前置检查的“追加消息”。S2 S4 S5
3.3 三个崩溃窗口,应当怎样对账
| 中断窗口 | 重启后可见事实 | 正常公开处理 |
|---|---|---|
| Claim 已写,Run 从未创建 | Claim 指向不存在的 Run | SessionRunner.resume 经 get_run 确认不存在后释放 Claim,抛 RunNotFoundError |
| Run 已创建,执行中断或正在等待 | Claim + 非终态 Run | resume 委托 Core resume_run;Lease/Resolution 规则继续成立 |
| Run 已成功,Turn 尚未确认 | 成功 Run + 尚未提交的 Claim,或已提交 Turn | 先查 commit_status;仍有 Claim 则 resume 幂等提交,已提交则不再推进 |
Run Store 暂时不可读并不是“Run 不存在”。resume() 只对 RunNotFoundError 清 Claim,其他读取异常保留占用并传播。这个区别由 缺 Run、暂时读取失败测试覆盖。表中的“不存在”处理也依赖应用确保原创建 请求已经停止,不能把“此刻查不到”当成并发创建者永远不会继续写入的证明。
成功后提交前故障的公共测试断言:Core 仍是 SUCCEEDED,第一次返回 PENDING,恢复提交后只有一条 Turn。人工清 Claim 并让后来者先提交的反例, 会把旧成功 Run 的提交判为 CONFLICT,不会自动合并历史。ST6
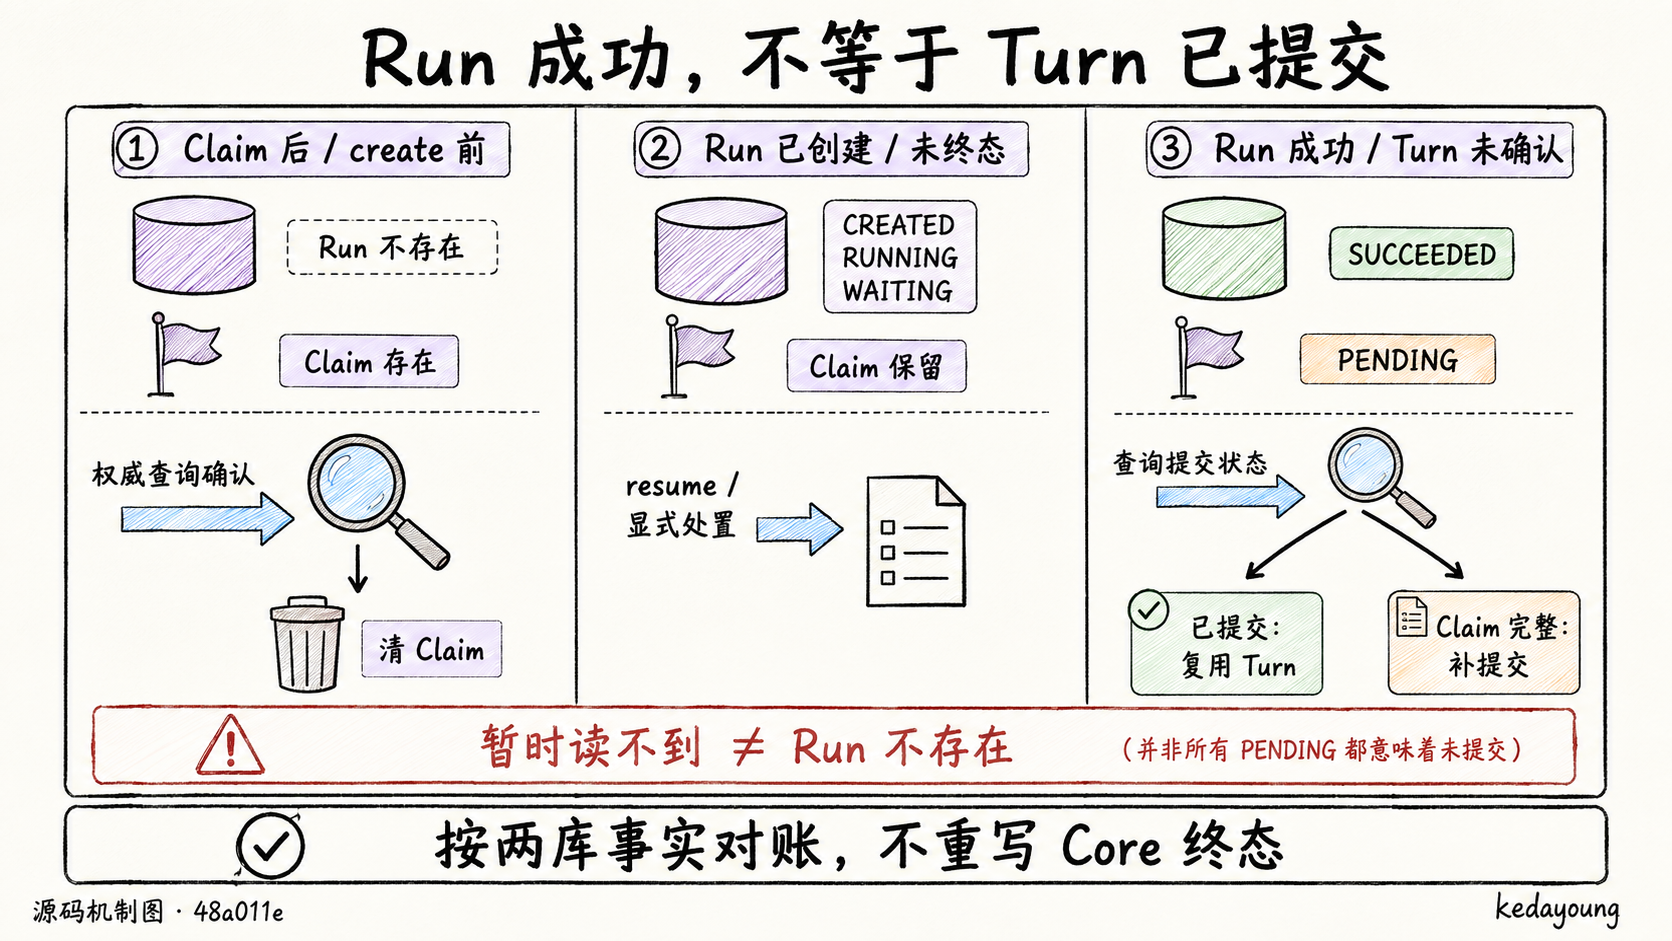
图 4:暂时读不到不等于不存在,PENDING 也不等于一定没有提交。
3.4 通知仍在 WAITING 时,第三句话必须等
Claim 没有 TTL。Run Lease 到期只允许另一个 Runner 接管同一个 Run,不能让新 消息越过待确认通知。长期 WAITING 也是非终态,会话仍被该 Run 占用。 无 TTL 的重开测试和第二条消息不能越过等待测试分别核对持久化与准入。
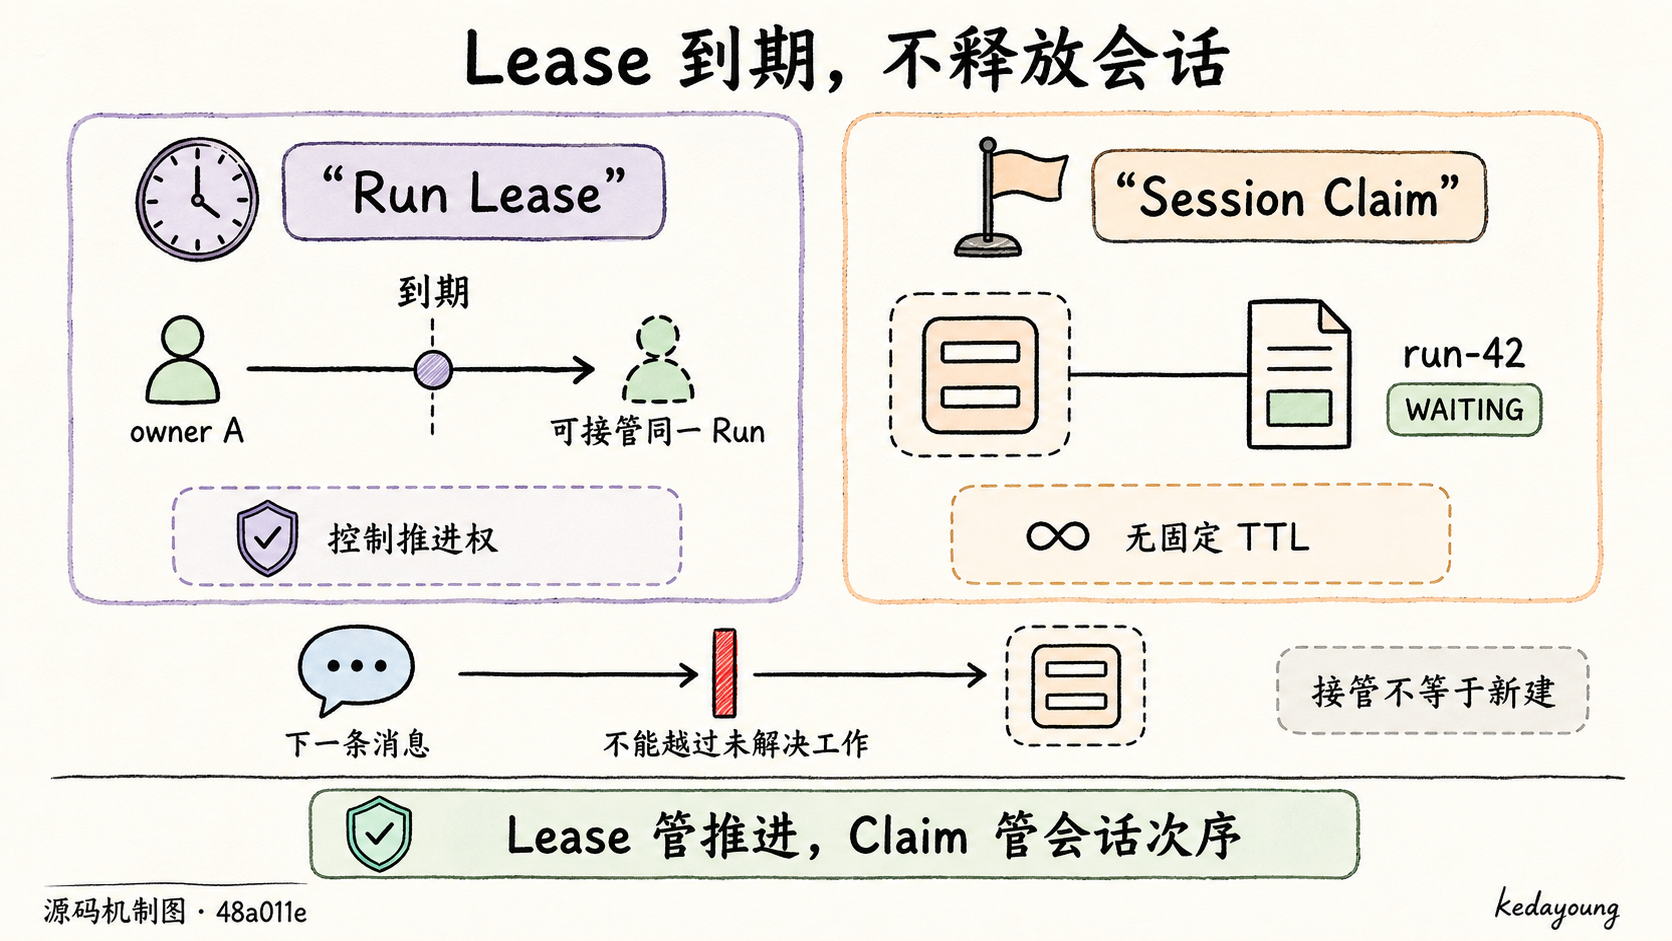
图 5:Lease 管同一 Run 的推进权,Claim 管会话次序;接管不是新建。
应用核实通知确实已经发送后,顺序是:
Runner.get_run(claim.run_id)
-> 检查 waiting_reason / waiting_step_id / allowed_resolutions
-> Runner.resolve_run(run_id, RunResolution.confirm_step(result=...),
                      expected_version=observed_version)
-> SessionRunner.resume(scope, session_id)
最后一步不可省略:Core 的 Resolution 不负责向 Session 写 Turn。 SessionRunner.resume 看到成功终态后只补做会话提交,不再要求 Core 恢复该 Run。 这条组合由确认后提交 Turn 测试验证。
3.5 本次复现:创建调用报错,不一定意味着 Run 从未创建
实现偏差,不是推荐行为: 当前 submit() 用 except BaseException 包围 Runner.create_run(),异常后直接释放 Claim,没有先查询权威 Run。 注释把这类异常解释为“Run 从未创建”,但控制流没有证明这一点。S1
本次结果: 配套脚本包装公开 RunStore.create_run(),让它先完成写入,再抛 一次“确认丢失”异常。随后通过公开 API 读到:
first Run: CREATED
Session Claim: None
model calls before followup: 0
next submit: admitted and SUCCEEDED
first Run afterwards: still CREATED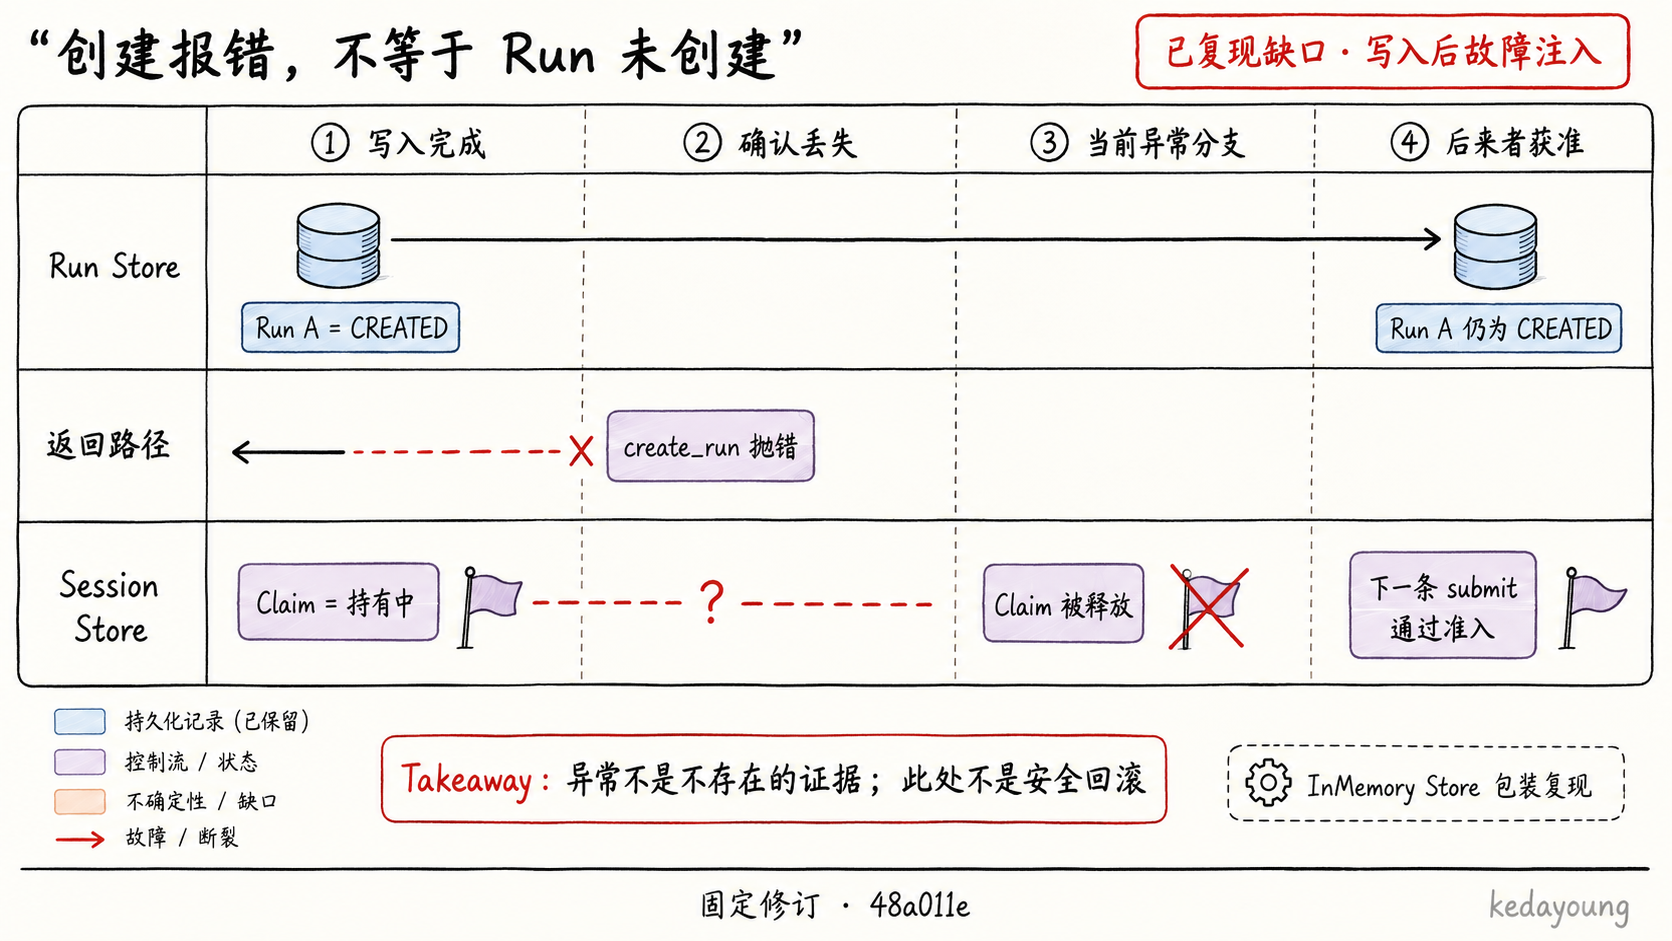
图 6:已复现的创建确认丢失缺口,不是推荐的恢复流程,也不是安全回滚证明。
这说明跨 Store 创建失败窗口尚不能概括为“所有异常都安全回滚”。它是一个 注入 Store 确认丢失的离线反例,不是声称内置 SQLite 在本次发生了真实网络故障。 既有“定义不存在时释放 Claim”的测试仍通过,但覆盖的是创建前失败。ST5 本文只分析与记录,不修复上游;生产集成不能依靠这个捕获所有异常的分支推断 Run 不存在。
这里展示的是故障注入复现的实现缺口,不是推荐的异常恢复流程。
4. 对话历史之外,Context 怎样进入这一次请求
第一轮答复是 History,物流政策是 Context Item,刚查回的工单状态是 Tool Outcome。把三者分开后,可以解释“同一次 Run 为什么应该继续看旧数据”,同时 不把“下一次 Run 可以看新数据”误认为恢复漂移。
4.1 先说明当前交付范围
设计决策: ADR-0040 把 Provider、筛选、排序、去重、机械裁剪与预算选择的 透明算法放在 Context Companion,把 Stage/Frame、Scope 与恢复事实放在 Core。
实现事实: 在本文固定修订,_run_context_stage 只执行 PROVIDE 并调用 Definition 的 context_provider。SELECT、TRIM、BUDGET_SELECT 虽有类型 声明,进入执行路径仍以 CONTEXT_STAGE_UNSUPPORTED 失败;缺 Provider 的 PROVIDE 也失败。不能把枚举值列表写成已经交付的算法库。C1
SELECT 负向测试明确检查 Provider 和业务模型均未调用。本文因而不虚构 m_agent.companion.context 的可用 Stage 组合 API;能实际使用的是公共 m_agent.runtime 的 ContextPlan/ContextStage 声明与 ContextProvider, 由 Core 调度。这是设计目标与当前可执行能力之间的交付缺口,不能通过重新解释 ADR 来消除。
4.2 三种 Scope 决定触发位置,不是通用缓存 TTL
| Scope | 本次客服 Run 中可对应的工作 | Frame 聚合方式 |
|---|---|---|
RUN_INPUT | 本次执行开始时提供适用的物流政策 | 保留基础项 |
TOOL_OUTCOME | 已完成 Tool 边界后补充外部数据 | 累积不晚于当前 Tool 边界的项 |
MODEL_STEP | 当前业务 Model Step 的工作项 | 只取当前 Model 边界的项,不累积旧工作项 |
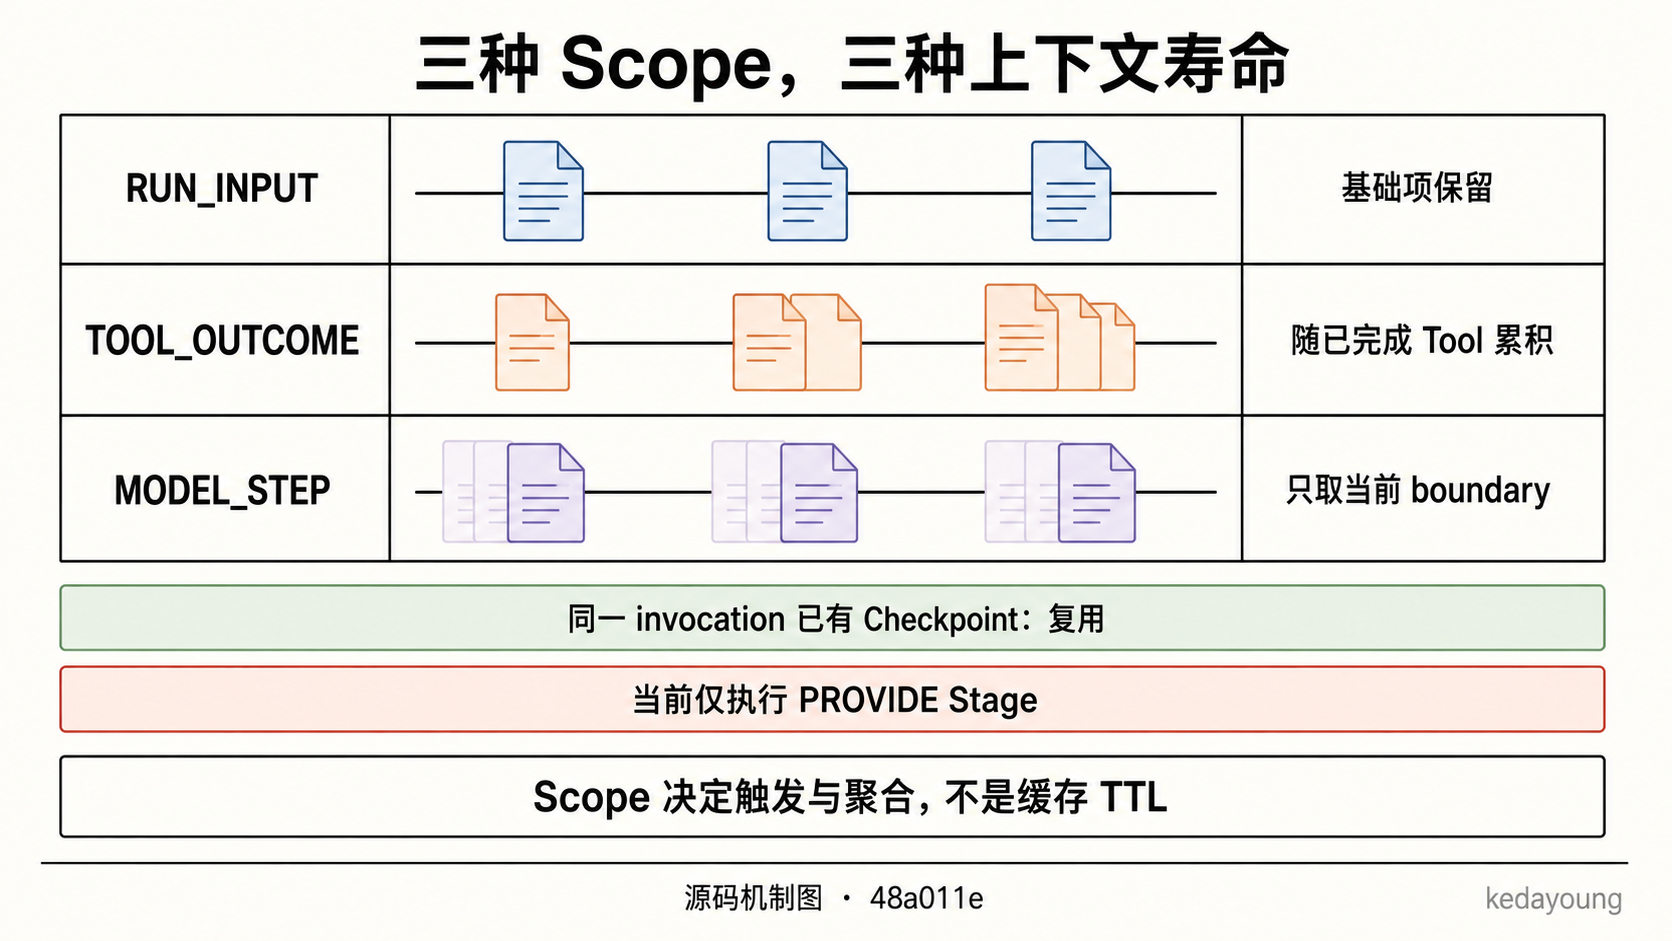
图 7:三条带表示各类上下文项的聚合范围,不是三种缓存 TTL;当前可执行 Stage 仍只有 PROVIDE。
这是应用用途示意,不代表框架会自己实现物流检索。Core 从已确认的 Model/Tool Checkpoint 计算 boundary;Stage invocation 用 ctx:{stage_id}:{scope}:{boundary} 定位,Plan 的顺序与声明随 Definition 冻结。 同一 invocation 已有完整 Stage Checkpoint 就复用,否则继续执行。 Stage identity 与聚合、动态准备控制流以及三 Scope 公共测试 共同说明这个机制。
公开配置顺序是:实现 Provider,声明有稳定 identity/config 的 Stage,组装 ContextPlan,把 Plan 和 Provider 放入 Agent Definition,注册精确版本,再 通过 create_run -> start_run 执行。不是启动后临时向 Runner 注入一个新 Stage。
4.3 Stage Result 冻结的是一次读取事实
Provider 调用前已有 CONTEXT Step 与 Attempt;返回后保存结构化 ContextStageResult,包含 Stage、Scope、boundary、输出项及 provenance、 decisions、measurement 等字段,再写 Context Checkpoint。C1 C2
但当前 PROVIDE envelope 中一些变换证据是空元组。数据结构能够表达来源与决定, 不等于已执行筛选算法或自动生成完整变换链。Context Item 本身的核心字段也是 item_id/content/source/metadata;不能把 CONTEXT 中所有规范字段一概写成该模型 当前已强制验证的独立字段。C4
恢复边界与前篇一致:Checkpoint 保存后不会重新查物流政策;保存前中断则 可能再次调用 Provider,看到更新后的外部内容。对应这两种情况的测试分别是 Checkpoint 后复用与Checkpoint 前重读。这是一次 Run 内的恢复 事实,不是全局检索缓存,更不是跨 Run 的长期记忆。
4.4 Frame 是完整请求视图,不只是检索片段
业务模型请求发出(dispatch)前,Core 构造 ContextFrame,把 instructions、run input、 History、Context Items、Tool Outcomes、Tool schema 以及输出/usage 模式放在 相应字段中。Tool Outcome 没有变成 Context Item,外部数据也没有被升级为 system instruction。C5
Context Budget 的计算还包括预留输出,因此删掉检索文档不一定让请求合格: 连续客服历史、工具 schema 或已有 Tool Outcomes 同样占据空间。当前 Runner 从冻结 Model Limits 推导 Budget,执行检查后才预留 Model Attempt。 判定超限则写失败 Step,并以 CONTEXT_BUDGET_EXCEEDED 结束 Run,不隐式裁剪、 不隐式压缩,也不等待模型替它解决。C5 CT5
重要实现限制: 这条“超限零 dispatch”的控制流存在,但真实 token 上界保证 尚不能由当前实现直接推出。ModelInputSizer.for_contract() 只根据 input_sizer_id 生成基类并设置 mode;estimate_text() 实际使用 max(1, len(text) // 4),非 legacy/deterministic ID 甚至会标为 EXACT。 这里并没有据 ID 查找实际供应商 tokenizer 的实现。C6
因此,“计量所有主要通道并拦截估算超限”是当前行为,“与实际请求协议 一致,且计量精确或保证不低估”是 ADR 的目标,二者不能等同。上述测试只证明 fixture 估算下的门槛,不证明任意语言、协议编码或供应商请求都不会低估。
另一个证据差异是:这条路径把 Frame 和 sizing 放在局部变量中;预算通过后进入 Attempt reservation,没有在这里保存 ADR 所描述的独立候选 Frame 证据和可 dispatch Frame Checkpoint。C5 恢复使用已有 Stage/Model/Tool 证据重建请求。 本文不把内存中的 ContextFrame 对象画成已经独立落库的一张表。
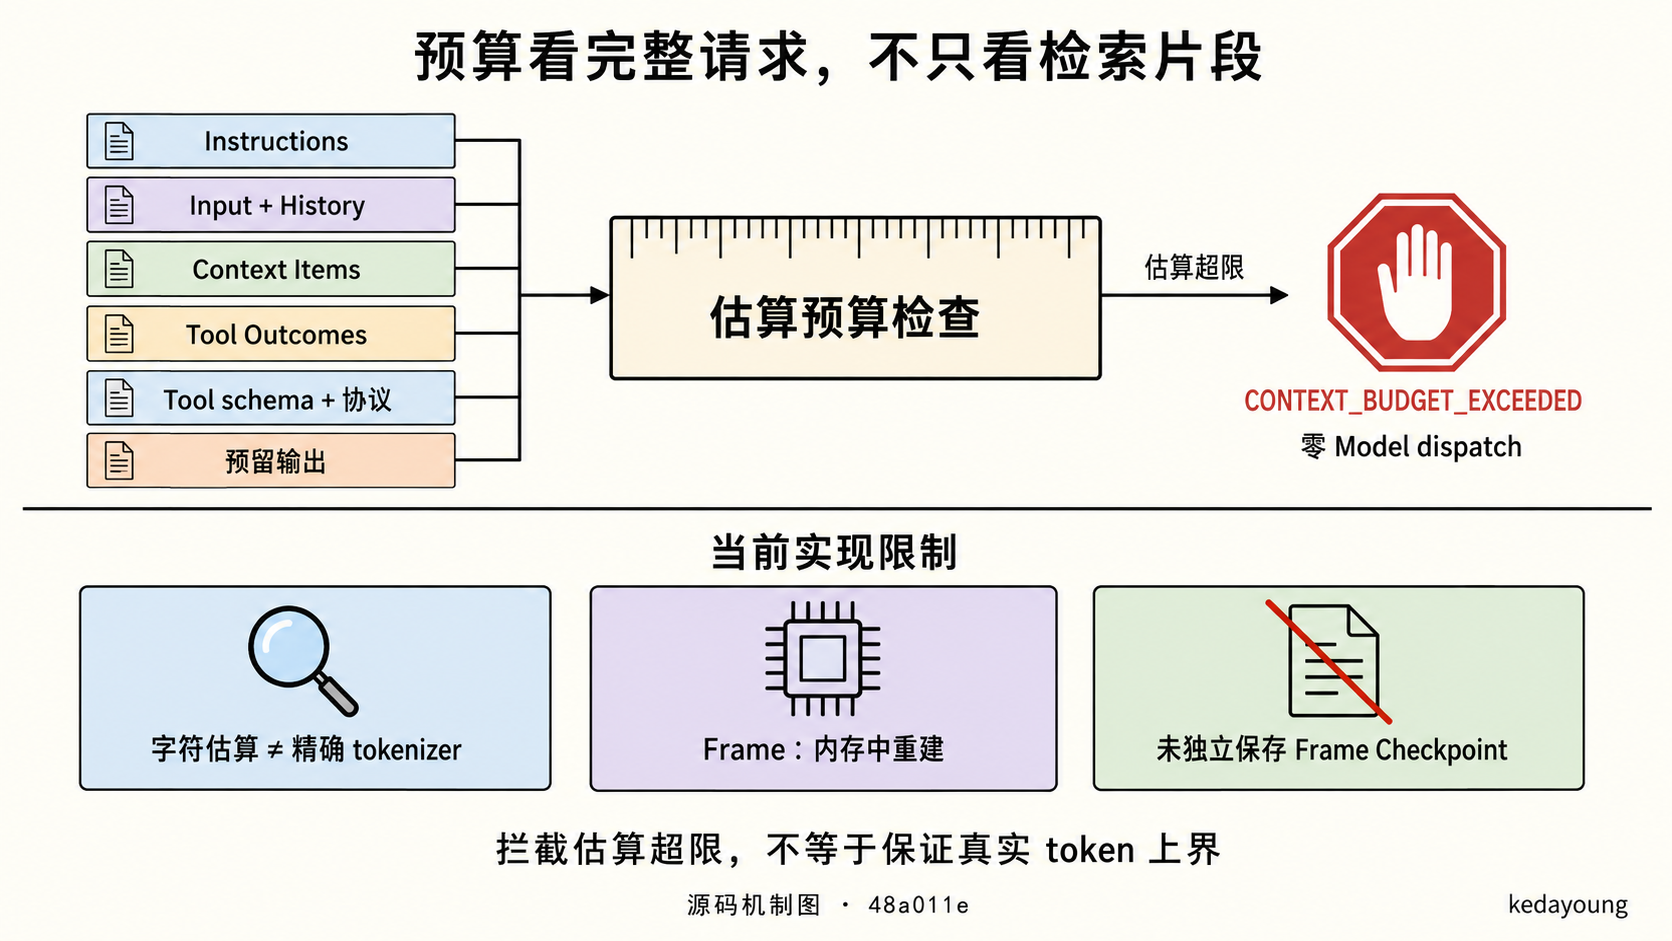
图 8:拦截估算超限已经实现;真实 token 上界和独立 Frame 持久化不能由此推出。
4.5 Compression 是另一个 Model Step,不是偷偷改聊天历史
若显式配置 Compression Contract,启动路径先跑 RUN_INPUT Stages,再跑 purpose=CONTEXT_COMPRESSION 的独立 Model Step,最后进入 PRIMARY 循环。 压缩只选择允许的 RUN_INPUT Context Items,不带业务 History、Tool Outcomes 和业务 Tools,也不递归触发同一 Pipeline 或 Output Repair。C7
输出保留 source_item_ids、派生项与压缩 provenance,原始项仍在 Context Checkpoint。Contract 身份漂移、未知来源、输出项冲突或未满足缩减要求会以 COMPRESSION_CONTRACT_VIOLATION 拒绝;框架的结构检查并不证明摘要在语义上 没有遗漏重要事实,后者需要 Eval。C8
恢复仍要区分两种情况:已有压缩 Model Checkpoint 则复用;dispatch 后但 Checkpoint 前中断,则按冻结 Retry Policy 和 Model Execution Budget 决定有界重放或失败。 压缩用途的 Attempt 同样计入预算,未确认消耗也不会在恢复后退回预算。见 独立压缩 Step 测试、压缩恢复配对测试。
回到客服问题:这个实现不会自动总结越来越长的 Session 历史。History 是受保护 输入通道,压缩的作用对象是选中的 Context Items。如果历史本身成为瓶颈,应用 需要显式重新设计输入策略,不能把 Session Store 默默改成“只存最新摘要”。
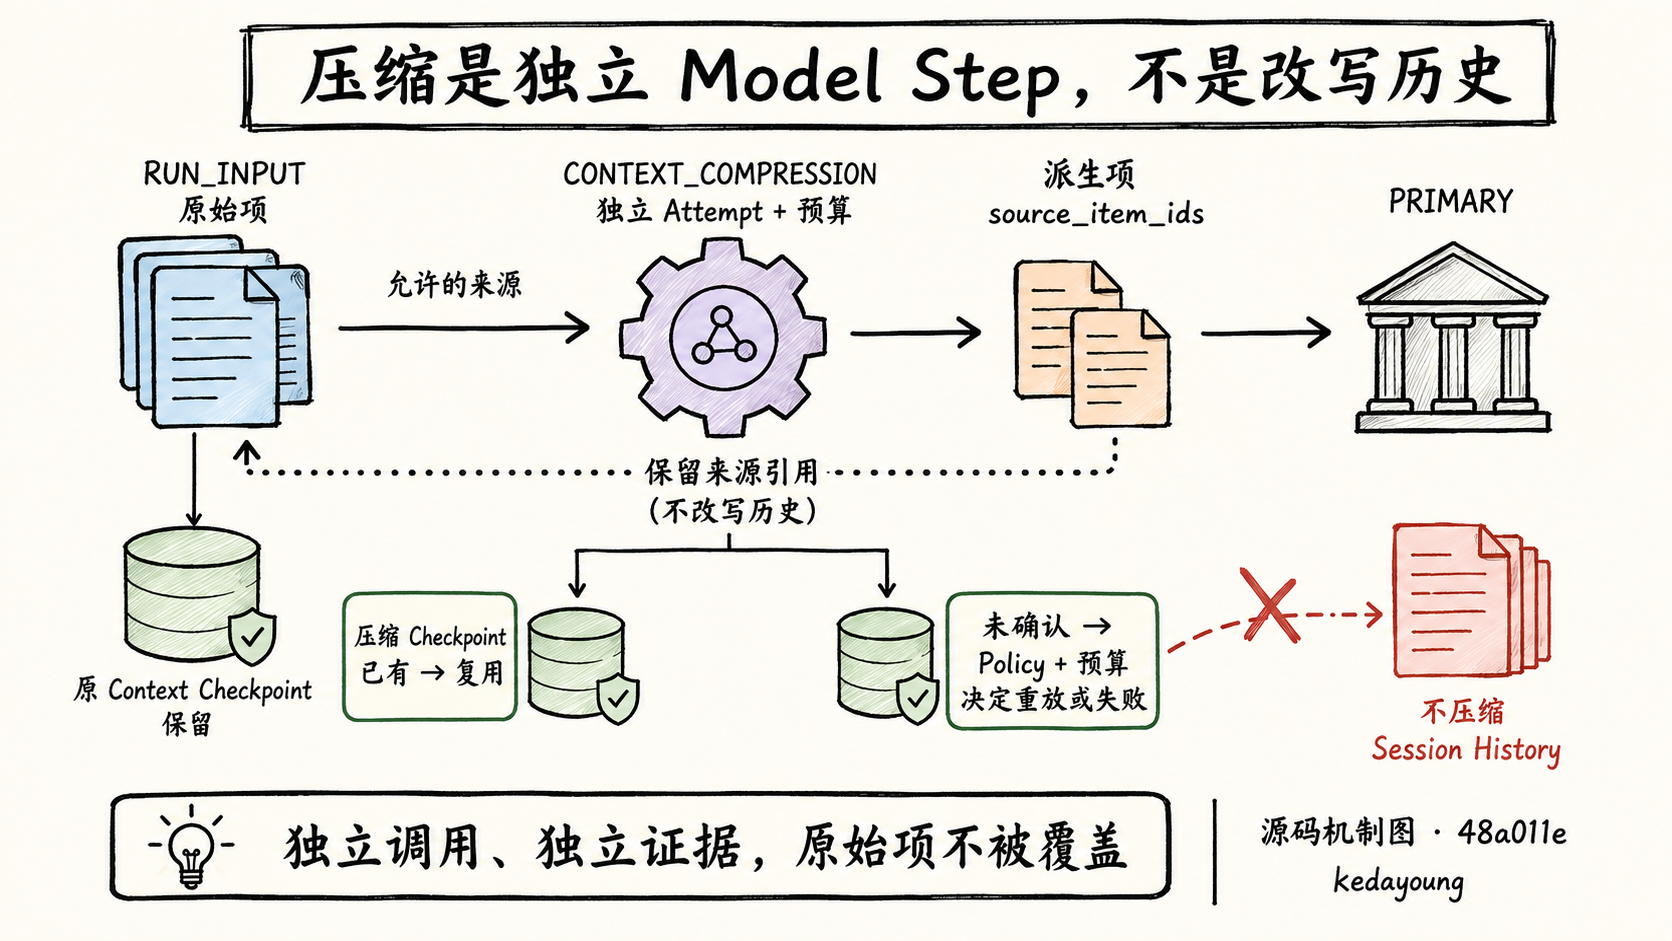
图 9:压缩有自己的 Attempt、预算和恢复边界,不改写 Session History。
5. 下一轮用哪个 Variant,为什么要在 Claim 前决定
5.1 能力和质量不是一回事
客服准备处理下一轮时,应用可以在两个完整 Agent Variant 中选择:一个成本较低, 另一个在特定任务上有更好的质量证据。Routing 选择完整 Definition/Binding, 不只是一个模型名。Model Contract 描述静态能力和限制;价格、质量、可用性和 动态额度属于有版本、有适用范围的 Evidence,不由 Adapter 自称。D41 R1
ModelRouter.select(catalog=..., policy=..., evidence=..., as_of=...) 是无 I/O 的 确定性选择,不接收用户正文、History、run_id,也不做隐式健康探测。 Catalog 不是 Definition Registry:Catalog 保存选择视图,Registry 才能在创建 Run 时按精确 Definition 身份解析 Python 实现。R1 R2
5.2 硬过滤、证据检查、字典序排序
Router 的顺序不是给模型打一个混合总分:
Policy 结构检查 -> Catalog identity/fingerprint 冲突检查
-> 候选范围 / Policy 注册 / 各用途 Requirements / 部署硬条件
-> hard gate 所需证据与价格、质量、可用性等门槛
-> 按声明顺序、方向、缺失值策略做字典序排序
-> 用 (variant_id, version) 稳定打破并列
-> SELECTED 或结构化失败
部署硬条件未知不能当作满足,硬证据过期不能当作候选“只是差一点”。 特别是某个兼容候选缺硬价格证据时,即使另一候选有合格价格,当前实现也会返回 整体 EVIDENCE_UNAVAILABLE,而非悄悄收窄范围继续。这一反直觉行为有专门 契约测试。软偏好则可以按规则带 warning 继续;不能把两者统称为 fallback。 R1 R4
| Routing Outcome | 意义 | 此时是否创建 Run |
|---|---|---|
SELECTED | 已选择完整 Variant,产出 Decision | 否,由应用下一步创建 |
NO_COMPATIBLE_VARIANT | 没有候选满足兼容性/部署硬条件 | 否 |
POLICY_UNSATISFIED | 兼容候选不满足硬策略门槛 | 否 |
EVIDENCE_UNAVAILABLE | 必需证据不可用、过期或无效 | 否 |
CATALOG_CONFLICT | 不可变身份或 Contract 指纹冲突 | 否 |
INVALID_POLICY | 策略结构不合法,无法进行确定性选择 | 否 |
在先路由、后创建的组合顺序下,这里的失败不会创建 Session Claim,也不会调用模型, 更不会生成一个 Core REJECTED Run。 公共集成测试检查这些边界;成功选择阶段同样是零 dispatch。
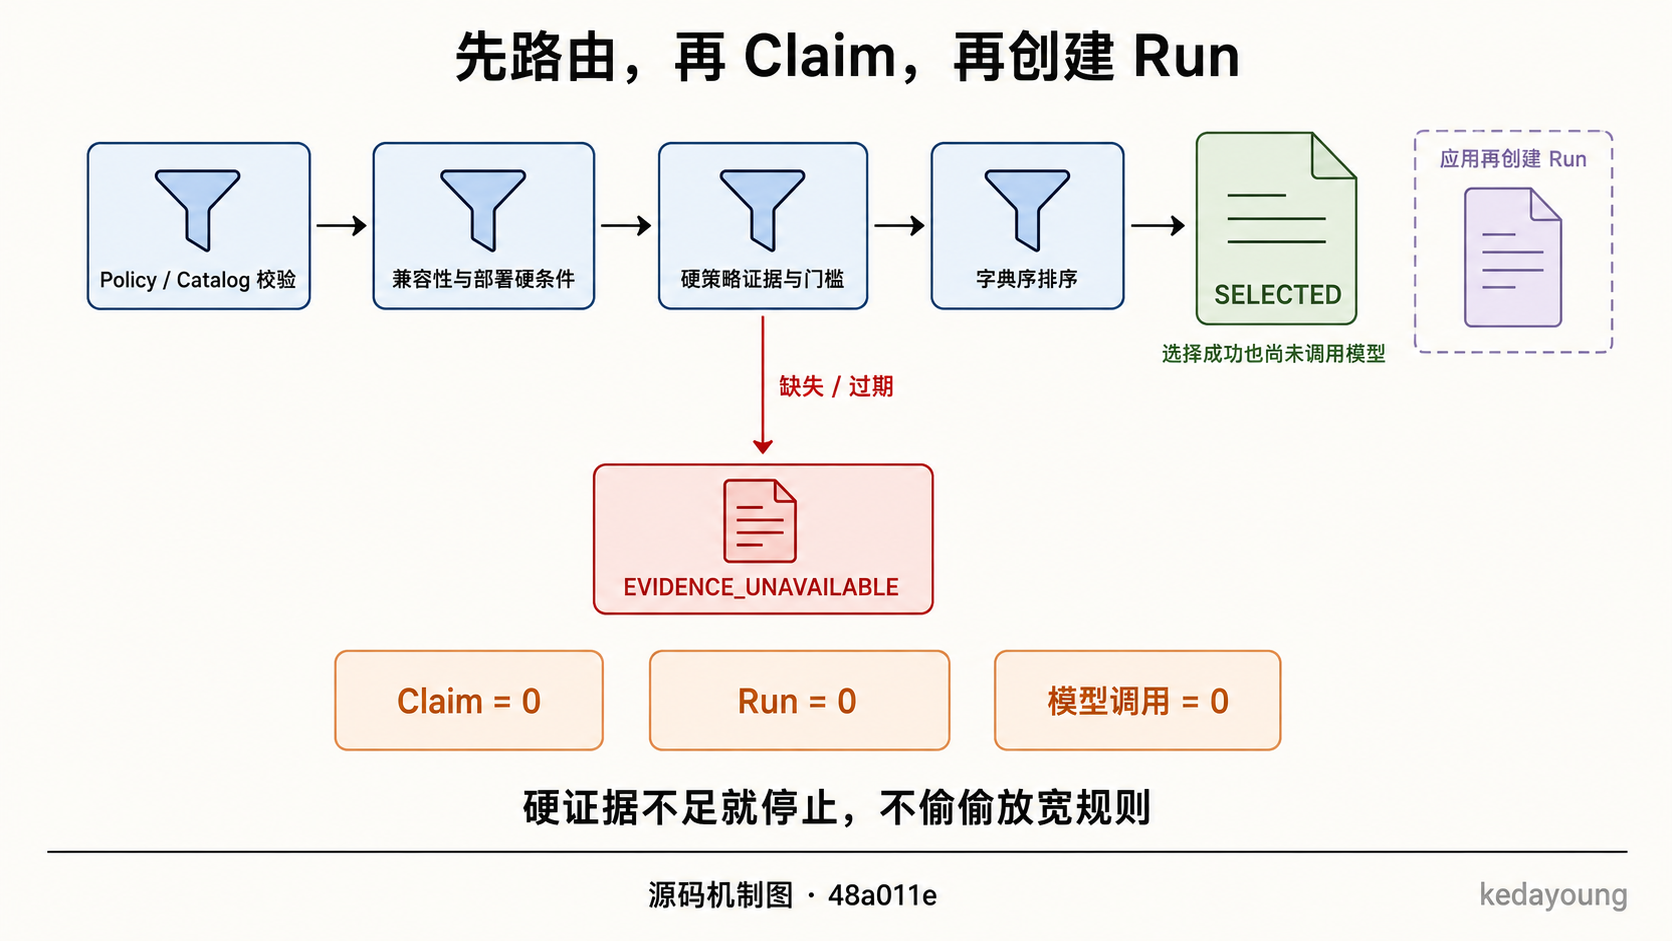
图 10:SELECTED 只是选择结果,Run 仍须由应用另行创建;失败也不生成 Core REJECTED Run。
5.3 Decision 与 Run binding 分两步保存
以下是无 Session 的公开组合片段,参数由应用初始化。同步的 Routing Store 方法不要误写成 await:
from m_agent.companion.routing import (
    ModelRouter,
    RoutingOutcome,
    bind_decision_to_run,
)


async def start_selected(runner, routing_store, catalog, policy, evidence, now, text):
    result = ModelRouter().select(
        catalog=catalog, policy=policy, evidence=evidence, as_of=now
    )
    if result.outcome is not RoutingOutcome.SELECTED:
        return result
    decision = result.decision
    routing_store.save_decision(decision, evidence=evidence)
    variant = decision.selected_variant
    run = await runner.create_run(
        variant.definition_id, variant.definition_version, text
    )
    binding = bind_decision_to_run(decision, run)
    routing_store.attach_run_binding(decision.decision_id, binding)
    return await runner.start_run(run.run_id)
这是 API 顺序示例,不是生产级异常补偿实现。Decision 保存后,Run 创建或 binding 保存都可能失败;应用需要保留身份、查询已有事实、幂等重试,不能重新路由后把新 Decision 当成旧 Run 的原选择依据。SQLite Routing Store 中的 Decision 保存和 binding 追加各有本库事务,但不覆盖 Run Store。R3
bind_decision_to_run() 校验 Definition 身份和冻结 PRIMARY Contract 指纹, 返回 binding 对象,不修改 RunRecord。在此修订,完整关联由 Routing Store 持有; 不能把“Core 只需关联标识摘要”的设计措辞扩写成 RunRecord 已经保存 Decision 字段。核心 create_run 签名也没有路由参数。R5 S6
对于 Session,有两条应用组合方式:
- 先
select,再把选定 Definition 身份交给SessionRunner.submit;它负责历史、
Claim 与 Turn。若需保存 Decision binding,应用须显式关联返回的 Run。
- 若必须在
start_run前持久化 binding,按公开 Store/Runner 原语组合
Snapshot -> history -> Claim -> create -> bind/attach -> start -> Turn 对账。 这时应用必须完整处理 SessionRunner 已展示的失败分支,不能把这条组合路径当作一体化 API。
路由到 Session Claim 的公共测试验证 select -> claim -> create -> bind -> start,但它使用空历史,且没有完成 Turn 回写;不能说该测试单独证明完整 多轮客服和路由已经端到端自动集成。
5.4 Fallback、Retry、Replacement Run 分别发生在哪
Pre-Run Fallback 按显式冻结的 Policy 顺序调用纯 Router,找到 SELECTED 即停; 它不是失败后偷偷放宽同一 Policy。创建以后,瞬态故障只能按冻结 Retry Policy 重试同一 Contract。确实需要换模型时,应用建立另一完整 Variant 的 Replacement Run,并显式关联前后身份,不能继承旧 Run 的 Checkpoint 或预算。 R6 RT4
因此新价格、新可用性与新 Eval 只影响后续选择。即使用户还在同一个 Session, 当前 Run 也不会随证据变化换模。已创建 Run 不换模测试 同一会话不同成功 Turn 可以来自不同 Definition 版本,Turn 的精确身份字段 正是解释这种变化的依据,而不是让当前 Run 变成可变配置。
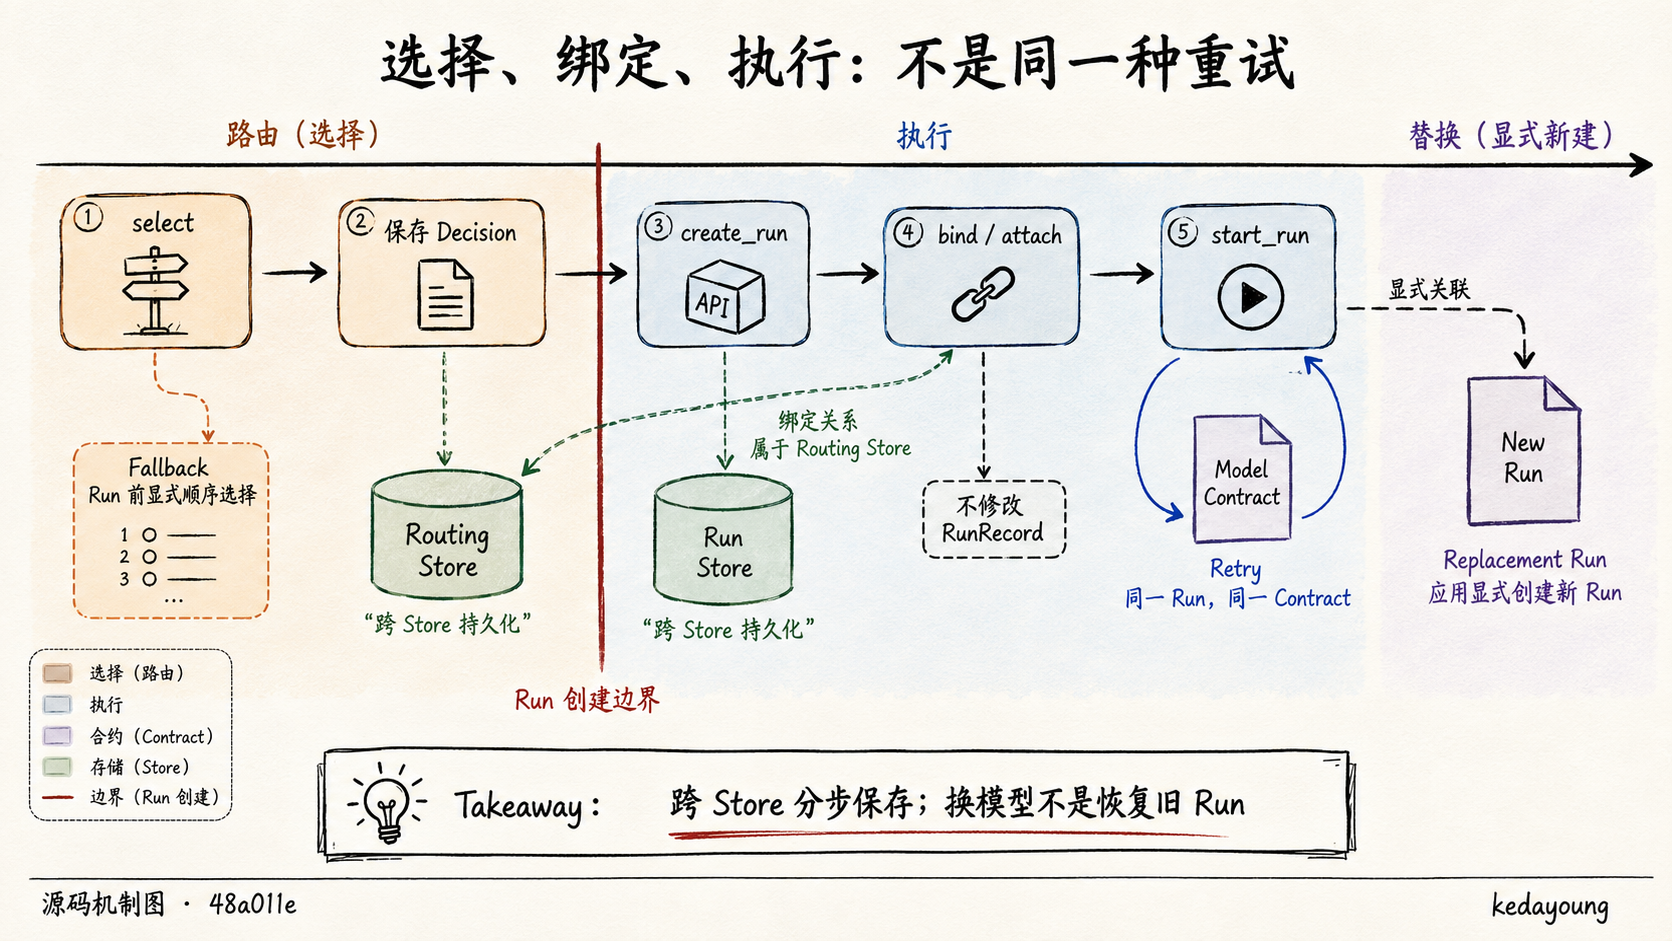
图 11:Routing 与 Run 分步持久化;binding 属于 Routing Store,换模型需要显式新 Run。
6. 客服 Run 已经完成,Eval 怎样评估它而不再次通知用户
6.1 OBSERVE 与 EXECUTE 是不同入口
设计决策: Eval 是 Companion,不是生产 Run Policy。它既能观察应用选定 的既有 Run,也能在隔离环境中执行固定用例;两者归一化为 Observation。D29
下文用 subject 指被评估的 Run,用 Judge 指执行模型评判的独立 Run。
| 模式 | 公开顺序 | 对被评估 Run 的权限 |
|---|---|---|
| OBSERVE | ObservationSelection(run_ids=...) -> EvalObserver.observe_selection | 只读 inspection,不创建、恢复、取消或处置 |
| EXECUTE | EvalSuite.expand -> EvalExecutor.execute_item,或由 EvalExecutionEngine.run_suite 编排 | 只推进应用传入的隔离 subject Run Store 中的 Run |
OBSERVE 不扫描“所有生产对话”,只读明确选择的有序 Run ID 列表。缺 Run 归 UNAVAILABLE,非终态归 INCONCLUSIVE,抽样时保留抽样说明(sampling disclosure),不把 样本结果冒充全量结论。E2 ET1
EXECUTE 固定 Case 输入、Variant、Fixture Bundle、Execution Protocol、 Evaluator 版本和重复次数。当前实现要求模型 Adapter 的 deterministic 为真; 非只读或非确定性的 Tool 必须在 fixture 的外部效果声明内,否则创建 Run 前失败。 静态能力缺失返回 UNSUPPORTED,不会靠真实调用探测。E3 ET2
边界限制: “传入隔离 Store + 受控 fixture”是集成者责任,不是框架自动克隆 生产库。工具声明也不是操作系统沙箱,不能阻止一个不守声明的 Python callable 私自访问网络。测试证明的是受控装配中生产 Store 无额外读写,不是任意用户代码 都被强制隔离。当前离线 EXECUTE/Judge 路径也不能包装成已验证的 live provider 质量基准。
6.2 Projection 决定评估器能看见什么
通知是否真的发送,Run Store 未必知道;外部执行日志或业务系统证据需要通过 EvidenceAdapter.collect(subject_ref) 只读收集为带来源、schema 与 digest 的 EvidenceArtifact。返回 None 表示没有可用证据,不表示通知没有发生。E4
接下来不是把整份 Run Payload 交给 Evaluator,而是:
EvalObservation
  + Evaluator 的 EvidenceRequirements
  + 版本化 ObservationProjectionPolicy
  -> project_observation
  -> 仅包含授权且所需字段的 Projection
  -> run_evaluator
未授权字段记为 denied,授权但缺失字段记为 unavailable;两者都会阻止需要 这些证据的 Evaluator 执行,归为 INCONCLUSIVE。业务输出不匹配是 FAIL, Evaluator 自己异常是 ERROR,不能混成一个“模型质量差”。E5 ET3
Projection 只约束交给 Evaluator 的视图;Observer 已授权读取的完整 Observation 仍可能含敏感内容,Eval Store 的保留与访问策略必须单独设置。不能因为 Judge 收到的是最小输入,就宣布所有 Eval 持久化内容都已最小化。
6.3 Judge 的意见不能覆盖确定性安全失败
Judge 使用自己的 Definition 和专用 Run Store,输入是序列化后的最小 Projection, 没有业务 Tools。当前 Judge 同样要求确定性 Adapter,已完成 Judge Run 按稳定 身份复用;非法 verdict 归为 Evaluator ERROR,不伪造 PASS。E6 ET4
引擎会拒绝 Judge 与 subject 使用同一个 Store 实例。这个检查只比较对象身份, 不是自动证明两个不同 SQLite 连接指向不同物理数据库;物理隔离仍需应用正确 配置。E1 Judge result 的 hard=False,质量分数不能覆盖 required hard/safety failure。聚合保留分数,最终 gate 仍按明确结果判断。ET3
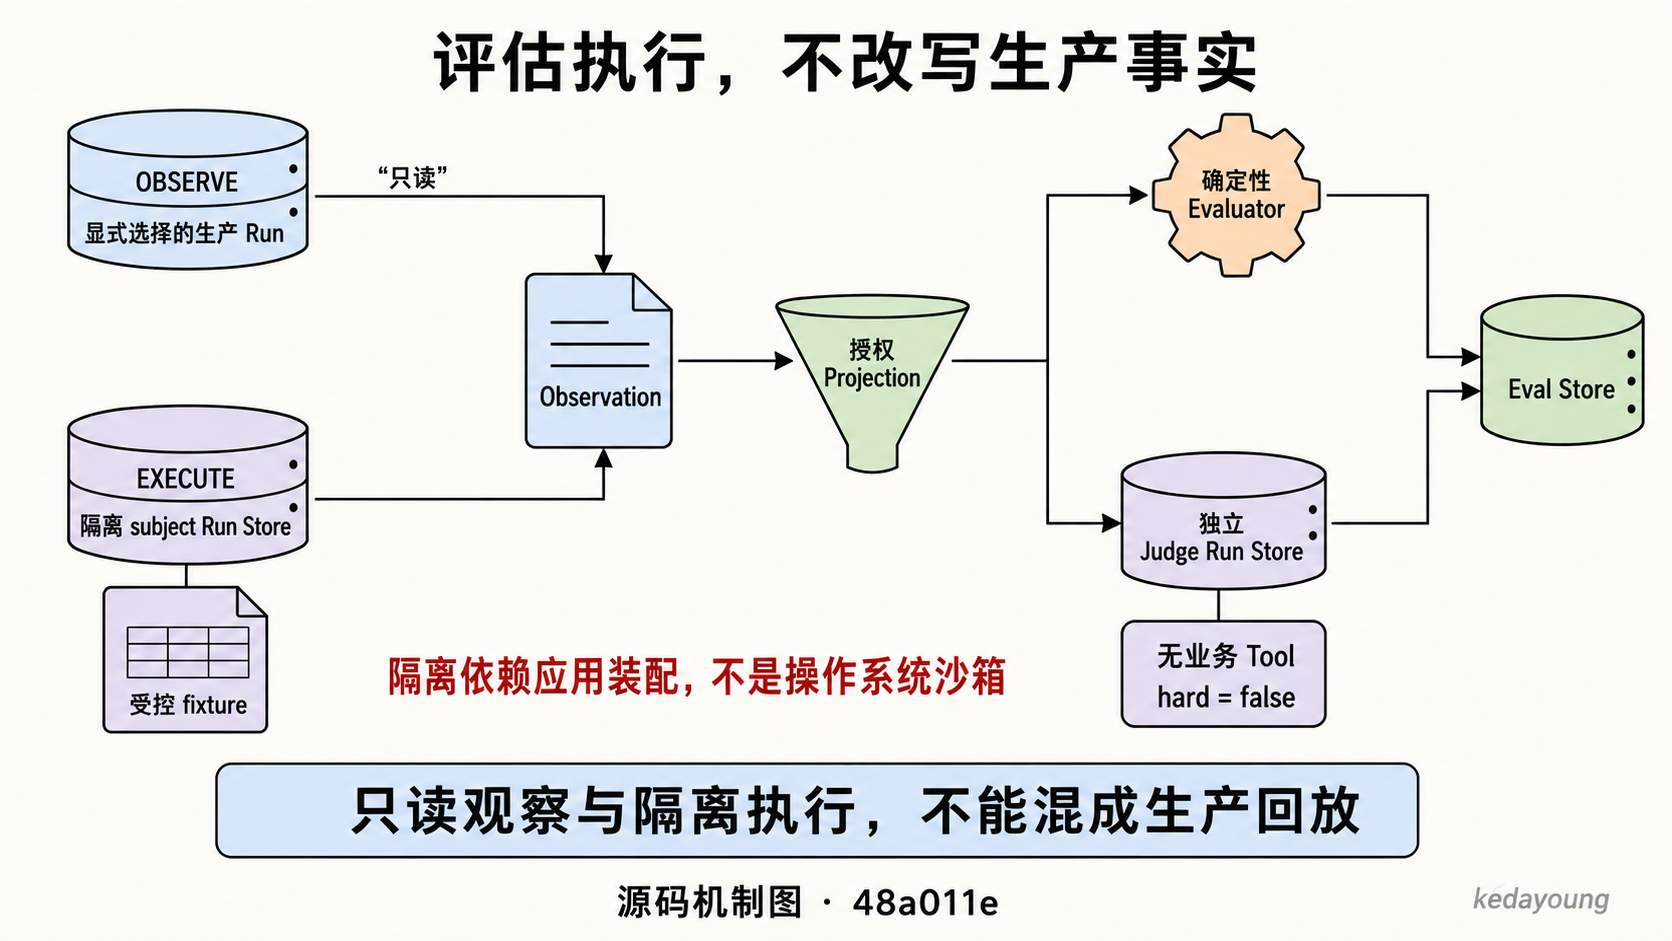
图 12:Judge 没有业务 Tool,hard 为 false;物理隔离仍依赖应用装配,不是操作系统沙箱。
7. Eval 自己中断了,哪些事实可以接着用
7.1 Eval Execution 不是新的 Run Status
EvalExecutionEngine.run_suite() 先保存固定 Suite digest 与展开 item IDs 的 Execution,再逐 item“先查 Observation,缺失才运行;先查 Evaluator Result, 缺失才计算”。默认 execution identity 由 Suite identity、内容 digest 和模式 派生;重复运行同一 Suite 默认是恢复同一执行,不是自动采集一个新的独立样本。 新的独立执行需要应用显式选择身份与重复协议。E1 ET5
subject run_id 也由 execution/item 稳定派生。当 Eval Store 尚无 Observation 而 subject Run 已存在时,Executor 先读 Run Store:
Run 不存在 -> create_run -> start_run
Run 非终态 -> resume_run
Run 已终态 -> 直接读取,不再次调用 subject 模型
-> inspection -> Observation -> Eval Store
这段顺序见 [_drive_subject_run]E7,它连接了两个独立 Store。不是把 Eval Execution 状态塞进 Core 的七状态机,也不是通过“结果没有保存”推断“业务还没跑”。
7.2 按中断点恢复,而不是整套重跑
| 中断位置 | 已保存的事实 | 继续时的动作 |
|---|---|---|
| Execution 后、subject 前 | 固定 Suite/item 计划 | 校验 digest,再创建缺失 subject |
| subject 已终态、Observation 前 | subject Run Store 有完整事实 | 读取终态 Run,重新归一化 Observation,不新增 subject 模型调用 |
| Observation 后、Evaluator Result 前 | 固定评估输入 | 只重算未保存的确定性评估结果,或复用独立 Judge Run |
| Result 后、Report 前 | 各 item 结果完整或部分存在 | 显式 build/record Report;不重跑已保存结果 |
如果 subject 仍非终态,持久化评估引擎不会把临时 INCONCLUSIVE Observation 永久写进只追加、不覆盖的 Store,而是抛错要求先处置 subject 再恢复;否则该记录身份 之后永远只能读到未完成结论。E1
这里的“先查后跑”也不是 Eval 层全局并发 Lease。顺序重试可以复用结果,并不 自动证明两个并发引擎没有重复 Evaluator 计算;Run 自身的推进仍靠 Core Lease。 本文不把恢复测试扩大为分布式调度认证。
这里还要区分存储重开与跨进程恢复:test_sqlite_store_persists_across_engines 关闭并重开 Eval Store,使用内部 helper 准备部分完成状态,然后走公共 run_suite() 恢复; 它不是独立进程被杀死的测试,不能只因测试类叫 CrossProcessRecoveryTests 就把它记作跨进程 HOST 验收证据。ET5 本次运行结果仅按实际方法与断言分类。
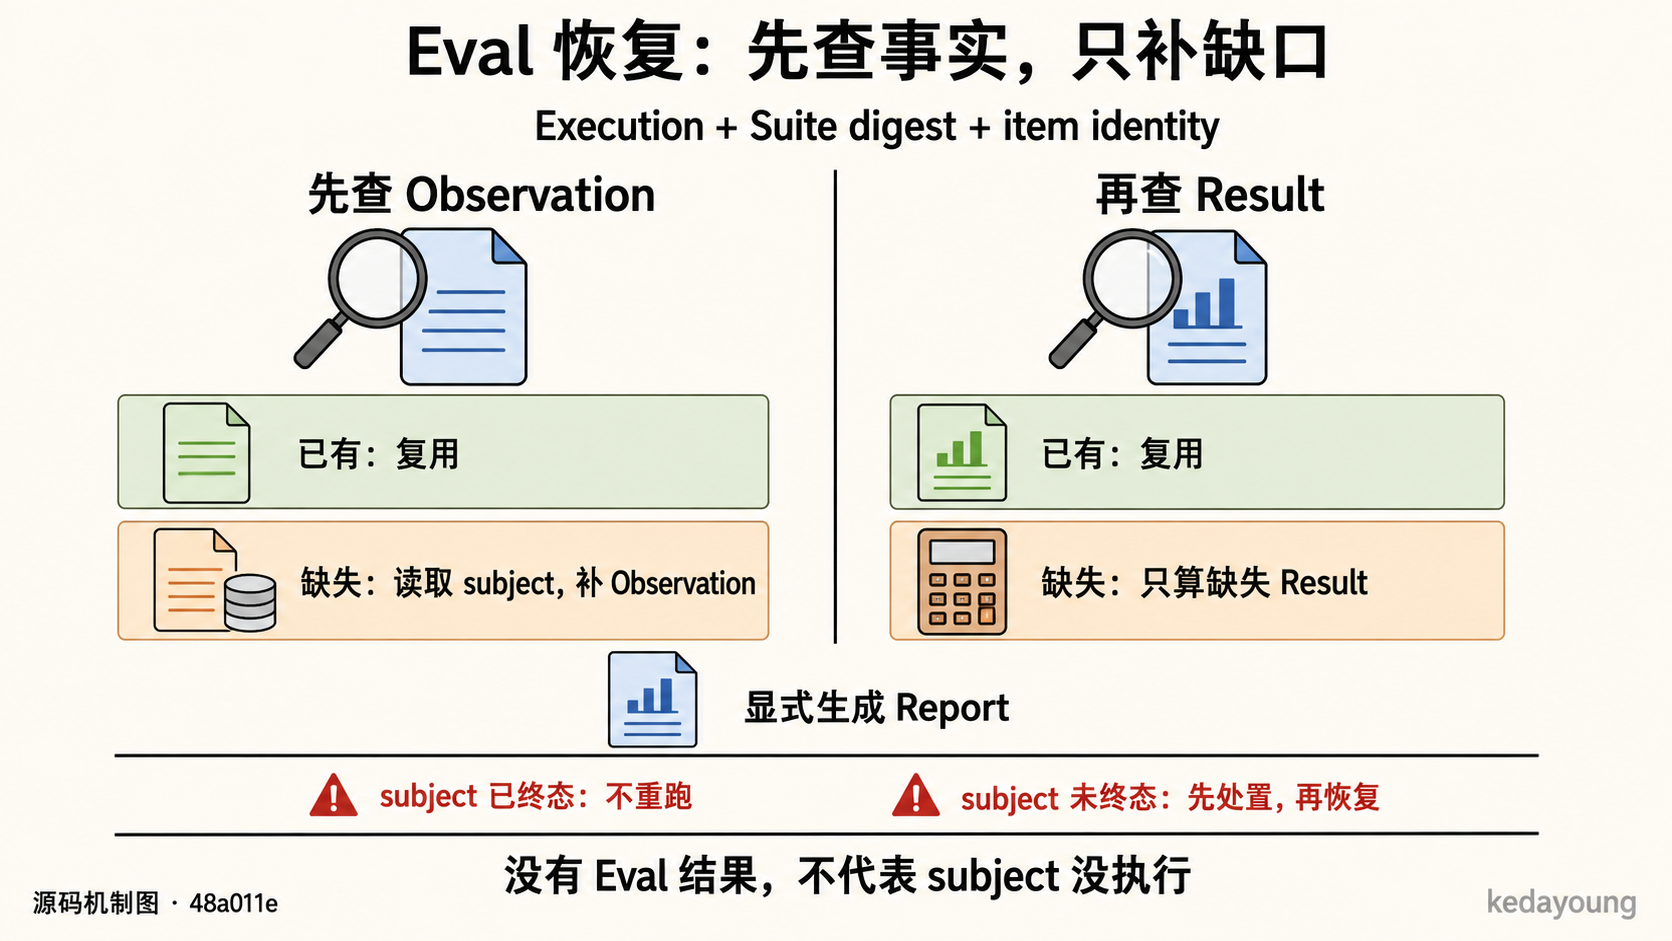
图 13:缺评估结果不是 subject 未执行的证据;非终态 subject 要先处置,再恢复评估。
7.3 Report、Baseline、Recommendation 分别怎样版本化
| 对象 | 固定的引用 | 变化时怎样保存 |
|---|---|---|
| Report | Suite digest、Case/Variant/repetition 结果、execution、gate 与分数统计 | 同 report_id 新 revision;旧 revision 不改 |
| Baseline | 精确 report_id + report_revision、Suite 与比较 Policy | 新 Baseline identity;不是“最新报告指针” |
| Recommendation | Report revision、可选 Baseline、目标及其版本、gate、confidence、digest、有效期字段 | 新记录身份与 version;不覆盖旧建议 |
实现细节: Eval Store 对 Baseline 和 Recommendation 按各自 ID 去重,而不是 自动用 (id, version) 覆盖旧项。因此只改 Recommendation 的 version、 却复用同一个 ID 写入不同内容,会得到 EvalRecordConflictError。Report 则明确 以 report_id + revision 查询。同身份同内容重写幂等,同身份异内容拒绝。 E8 ET6
Report 聚合以 Suite 展开为分母,缺失 repetition 归 INCONCLUSIVE;分数只做 统计,不抵消 gate 失败。注意当前字段名 pass_at_k 的实现要求全部 repetition PASS,含义接近此项目所称的 pass^k,不能解释成“k 次里至少成功一次”。E9
以下是执行后保存报告和基线的公开 API 片段。engine 已正确装配独立 subject Run Store、Eval Store、Evaluator 与 Projection Policy:
from m_agent.companion.eval import (
    ComparisonPolicy,
    EvalBaselineRecord,
    build_report_revision,
)


async def evaluate_and_pin(engine, suite, eval_store):
    result = await engine.run_suite(suite)
    report = build_report_revision(
        report_id="support-report",
        revision=1,
        execution_id=result.execution.execution_id,
        suite=suite,
        results=result.results,
    )
    await eval_store.record_report(report)
    baseline = EvalBaselineRecord(
        baseline_id="support-baseline-1",
        report_id=report.report_id,
        report_revision=report.revision,
        suite_id=report.suite_id,
        suite_version=report.suite_version,
        comparison_policy=ComparisonPolicy(policy_id="support-regression", version="1"),
    )
    await eval_store.record_baseline(baseline)
    return report, baseline
这是首次保存报告和基线的片段,不是可以任意重复构建同一 revision 的幂等发布器: 重试时应先读已保存对象,避免新 created_at 使同 identity 内容冲突。调用 compare_report_revisions(current=..., baseline=..., baseline_report=...) 时, 必须提供 Baseline 精确引用的旧 Report,不能临时换成最新报告。E10 ET7
7.4 推荐到下一轮路由,中间必须有应用发布动作
ModelRecommendationRecord 是建议数据,没有 apply() 或自动修改 Catalog、 Definition 的执行入口;当前 Eval record 甚至允许 valid_until=None。 它不等于 Routing 能直接消费的 RecommendationPublication:后者需要明确目标 Variant 版本、gate 和有效期,由应用核对并构造。E11 R7
实际发布可以遵循公共发布测试的顺序:
核对 Report/Baseline/Recommendation 与应用准入要求
-> register_variant_for_policy(..., new_version=...)
-> 构造指向该新 Variant revision 的 RecommendationPublication
-> publish_recommendation_as_policy(..., new_version=..., as_of=...)
-> 应用发布新的 Catalog/Policy/Evidence 组合
-> 下一次 select
Variant revision 和 publication 的目标版本必须一致。发布 helper 拒绝 hard/ quality gate 未通过、已过期建议以及覆盖 base Policy 版本;它返回新 Policy 数据, 不是替应用部署服务或完成权限审批。旧 Policy、Decision、Run Snapshot 和 Session Turn 都保持原事实。R7 RT6
另一个容易混淆的 API 细节是:m_agent.companion.eval.AgentVariant 与 m_agent.companion.routing.AgentVariant 是不同公开模型。前者是 Eval Case 的 Definition 引用,后者包含 Routing 的完整 Binding/Policy 声明;同时使用时应用 应显式别名导入,不把名字相同理解成可以直接互换。E12 R2
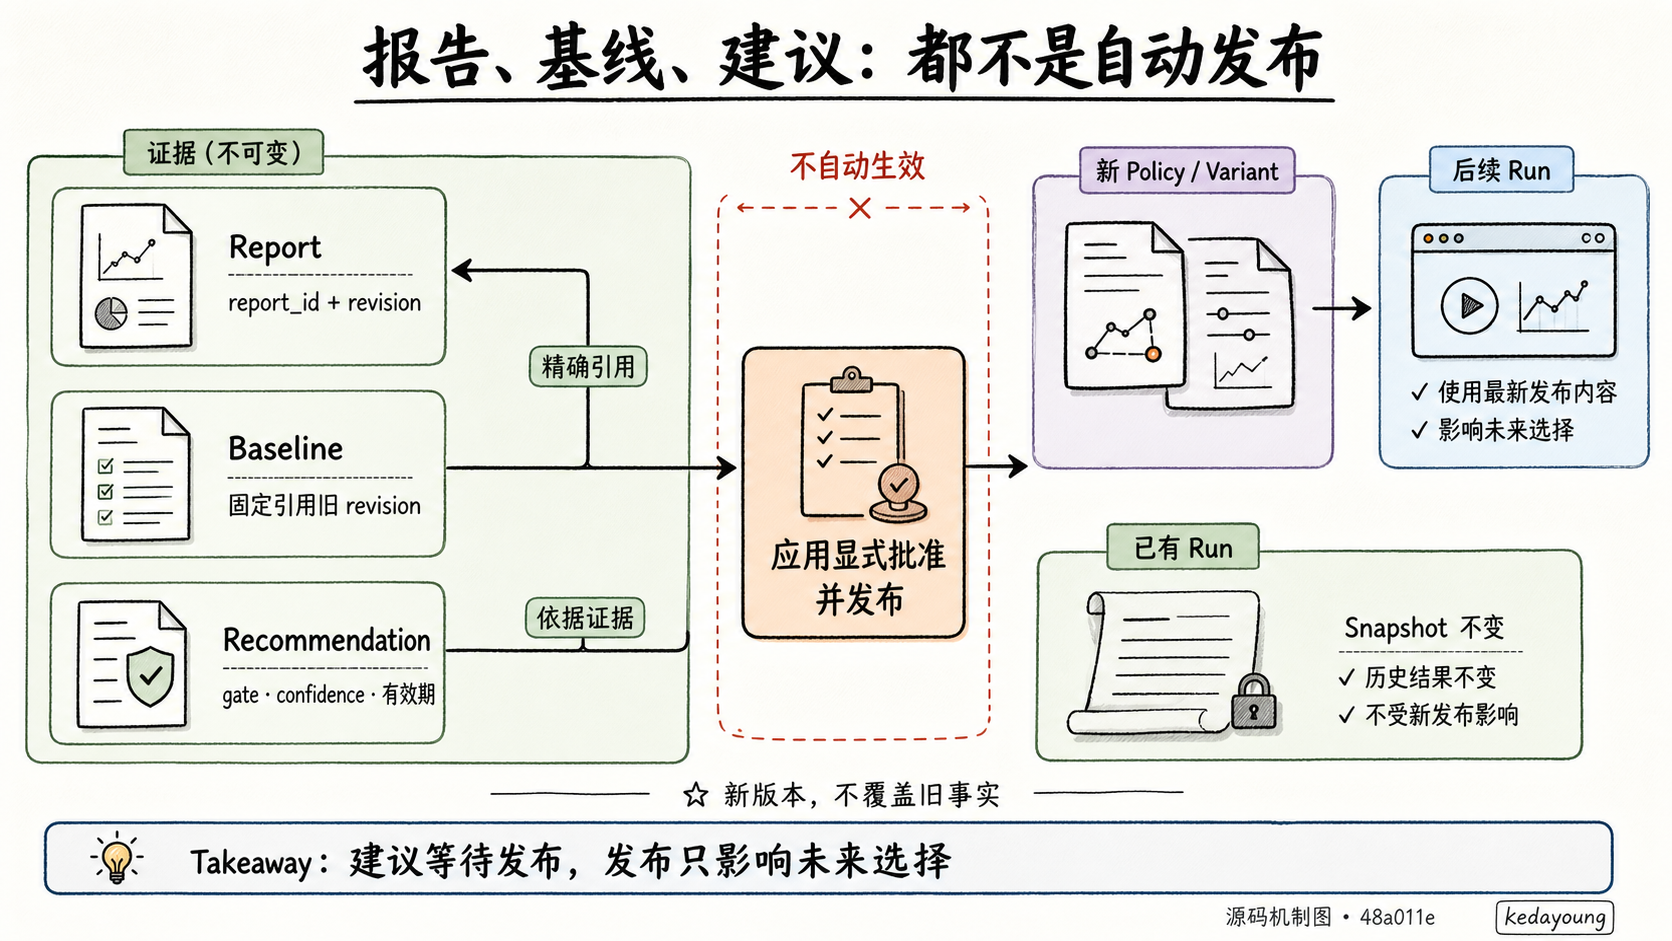
图 14:建议不是发布;新版本只影响后续选择,不覆盖已有事实。
8. 回到连续客服:哪些动作由谁收尾
现在可以完整解释这条对话,而不把四个 Companion 问题混成一个全局状态机:
- 第一轮成功且 Turn 已提交后,第二轮将 Session Snapshot 中的 Turn 转换为 History,并在创建 Run 时冻结。
- 如果启用 Routing,应用先完成确定性选择;失败不产生 Claim 或 Run。
- Claim 保护会话次序,Run Lease 保护单次推进,两者都不是自动后台 worker。
- Context Stage 保留本次读取证据,Compression 单独计费与恢复;预算路径的
当前实现限制必须明确保留。
- 通知待确认时保留 Claim,应用处置 Core Run 后,再由 SessionRunner 对账 Turn。
- Eval 只读这次执行,或用隔离 fixture 重跑受控用例,不再次执行生产通知。
- Report 固定证据,Baseline 固定比较参照,Recommendation 等待应用明确发布,
才能影响未来 Run。
作者推断: Companion 的组合成本就是显式对账:调用方需要分清“哪个 Run 还在执行”“哪个成功 Turn 还没确认”“哪个路由决定尚未绑定”“哪个 Eval item 还没形成结果”。它换来的不是跨库原子成功,而是能根据各自保存的事实恢复和 解释状态;未被实现或证据未覆盖的窗口也必须保留在集成判断中。
以 Session 为主线,Context、Routing、Eval 分别补齐请求输入、执行前选择与执行后 评估。集成时最重要的不是记住所有类型名,而是明确每一步读取哪份事实、写入哪份 记录,以及中断后应从哪里继续。
9. 本次验证与证据边界
9.1 本次实际执行
在上游本地 checkout 的现有 .venv 中执行,无真实模型请求、无凭据访问、 无上游源码修改。测试使用临时存储与确定性 fixtures:
| 测试组 | 本次结果 |
|---|---|
| Session / SQLite Session / Session scenario,3 个文件 | 118 passed,38 subtests passed |
| Context、Compression、Routing 与 Eval 核心路径,15 个文件 | 287 passed,25 subtests passed |
| Eval Store/Report 与 Routing snapshots/cost,5 个文件 | 70 passed |
| 配套两轮公开 API smoke | PASS,版本 2、第二 Run 两条 History |
| Store 创建确认丢失故障注入 | 复现 Claim 已释放但旧 Run 仍 CREATED,后续 submit 获准 |
共 475 个测试项通过,另有 63 项 subtests 通过;不是把子测试再次加进测试项总数。 命令清单与复核说明见同目录 验证记录。 正文三个 Python 片段为参数化组合示例;语法检查与端口签名核对不等于它们在真实 应用配置中已经执行;实际运行范围以本节测试结果和配套验证记录为准。
9.2 没有被本次结果证明的事
- 没有证明任意创建异常都能安全释放 Session Claim;本次反例恰好说明此处存在缺口。
- 没有证明 SELECT/TRIM/BUDGET_SELECT 已可执行,也没有证明实际供应商 token
计量精确或不低估、Frame 独立证据链已落库。
- 没有把只读 OBSERVE、隔离 fixture EXECUTE 说成操作系统级安全沙箱。
- 没有运行 live provider 对比、生产外部系统验收、吞吐容量测试或完整 wheel
HOST 发布验收;不从离线通过推导 PROVIDER/FIELD 结论。
- 没有建立跨 Session/Run/Routing/Eval Store 的分布式事务、自动调度、Run 内换模
或 Recommendation 自动采纳。
9.3 源码与测试索引
以下链接是固定修订的导航。正文相应段落已经说明每项测试证明的具体条件; 不是把“文件里有测试”当作所有设计承诺已成立。