面向第一次阅读 M-Agent 源码、但具备 Python 与分布式系统基础的工程师。
本文固定以
v0.5.1(提交99dd386b6f2c93645334ec81c9791f3b0333d597) 为源码基线,采用 API-first 的方式,从Runner.create_run()一路追踪到启动、步骤执行、崩溃恢复、人工处置、 流式输出、取消与 Lease 接管。文中的“当前实现”均指这一版本,不随主分支变化; “实现事实”来自该版本源码与测试; “设计决策”来自已接受 ADR;超出两者的解释会明确标记为“作者推断”。
配套图示: 本文已嵌入 11 张章节配图和 5 段精修动画,原有 Mermaid 保留为可编辑的结构源。动画合计 52 秒,按需播放、不自动循环;每段下方均有 MP4、结论静帧和手机竖版图入口。也可打开 动画合集或 配套视觉规格。
阅读提示: 首次阅读可先沿第 1-5 章理解执行,再读第 7-11 章理解恢复与 控制;第 6 章用于核对持久化条件,第 12 章和附录用于查证。 文中的 dispatch 指发起外部调用,reservation 指调用前的预算预留, replay 指恢复时重新执行,fail closed 指证据或授权不足时拒绝继续。 代码块若标注“简化摘录”或“伪代码”,只用于说明控制流,不是可直接运行的示例。
精校发现的实现边界: 下文的非幂等安全故事覆盖的是 Tool Step/Attempt 仍为
RUNNING的既有故障注入窗口,不覆盖所有 Checkpoint 前的退出位置。v0.5.1在“Tool Step 已提交SUCCEEDED、Tool Checkpoint 尚未提交”的 窗口存在恢复缺口:补充实验复现了非幂等通知被再次调用。另一个待核验边界是 跨 Model Response 重用call_id。详见第 7.6、12.8 节;不能将本文解读为 对该版本任意崩溃位置的安全认证。
开场:这条通知到底发送了几次
先从 Durable Run 最难的一类事故开始。
一个客服 Agent 调用通知工具,外部通知服务已经接受请求,短信或邮件也可能 已经发出。就在工具返回成功之后、M-Agent 把 Tool Outcome 写入 Checkpoint 之前,进程被 SIGKILL、机器掉电,或者直接执行了 os._exit(17)。
重启后,运行时能看到下面这些事实:
- Run 仍是
RUNNING; - 最后一个 Model Checkpoint 明确要求执行通知工具;
- 对应 Tool Step 和 Attempt 已经是
RUNNING,说明这次 Attempt 的执行身份已经
持久化;但仅凭这两个状态不能判断 tool.invoke() 是否已经发生;
- 没有 Tool Checkpoint;
- 独立外部 journal 进一步证明通知效果已经发生;Run Store 自身无法确认这一点。
此时最诱人的实现是“没有 Checkpoint,所以再执行一次”。但对非幂等通知, 这可能让用户收到两条消息。另一种看似保守的实现是“把 Run 标记为失败或 取消”,但若不保留待查证原因,应用就可能把终态误读为“通知没有发生”。 失败或取消本身并不证明外部效果不存在。M-Agent 选择 第三条路:保留不确定性,将 Run 转入 WAITING,并用机器可读原因 UNCERTAIN_NON_IDEMPOTENT 表示“非幂等 外部效果无法确认”。此时由应用根据外部证据提交显式 Resolution,而不是由模型 或 Runner 自行猜测。
这也是理解整个 Durable Run 设计的钥匙:
Durable Run 的目标不是消灭不确定性,而是把已经知道的事实持久化, 把不知道的事实分类,并阻止运行时在证据不足时替应用猜测。
图解结构源稿
sequenceDiagram
    autonumber
    participant R as Runner A
    participant S as Run Store
    participant T as Notification Tool
    participant E as External System
    participant R2 as Runner B
    participant A as Application

    R->>S: persist Tool Step/Attempt RUNNING
    R->>T: invoke(notification)
    T->>E: send notification
    E-->>T: accepted
    T-->>R: ToolOutcome.SUCCESS in memory
    Note over R,S: crash before Tool Checkpoint
    R-xS: process exits
    R2->>S: resume_run(run_id)
    S-->>R2: RUNNING + inflight Attempt + no Tool Checkpoint
    R2->>S: WAITING(UNCERTAIN_NON_IDEMPOTENT)
    A->>R2: resolve_run(CONFIRM_STEP, result)
    R2->>S: write Tool Outcome Checkpoint
    R2->>S: continue Run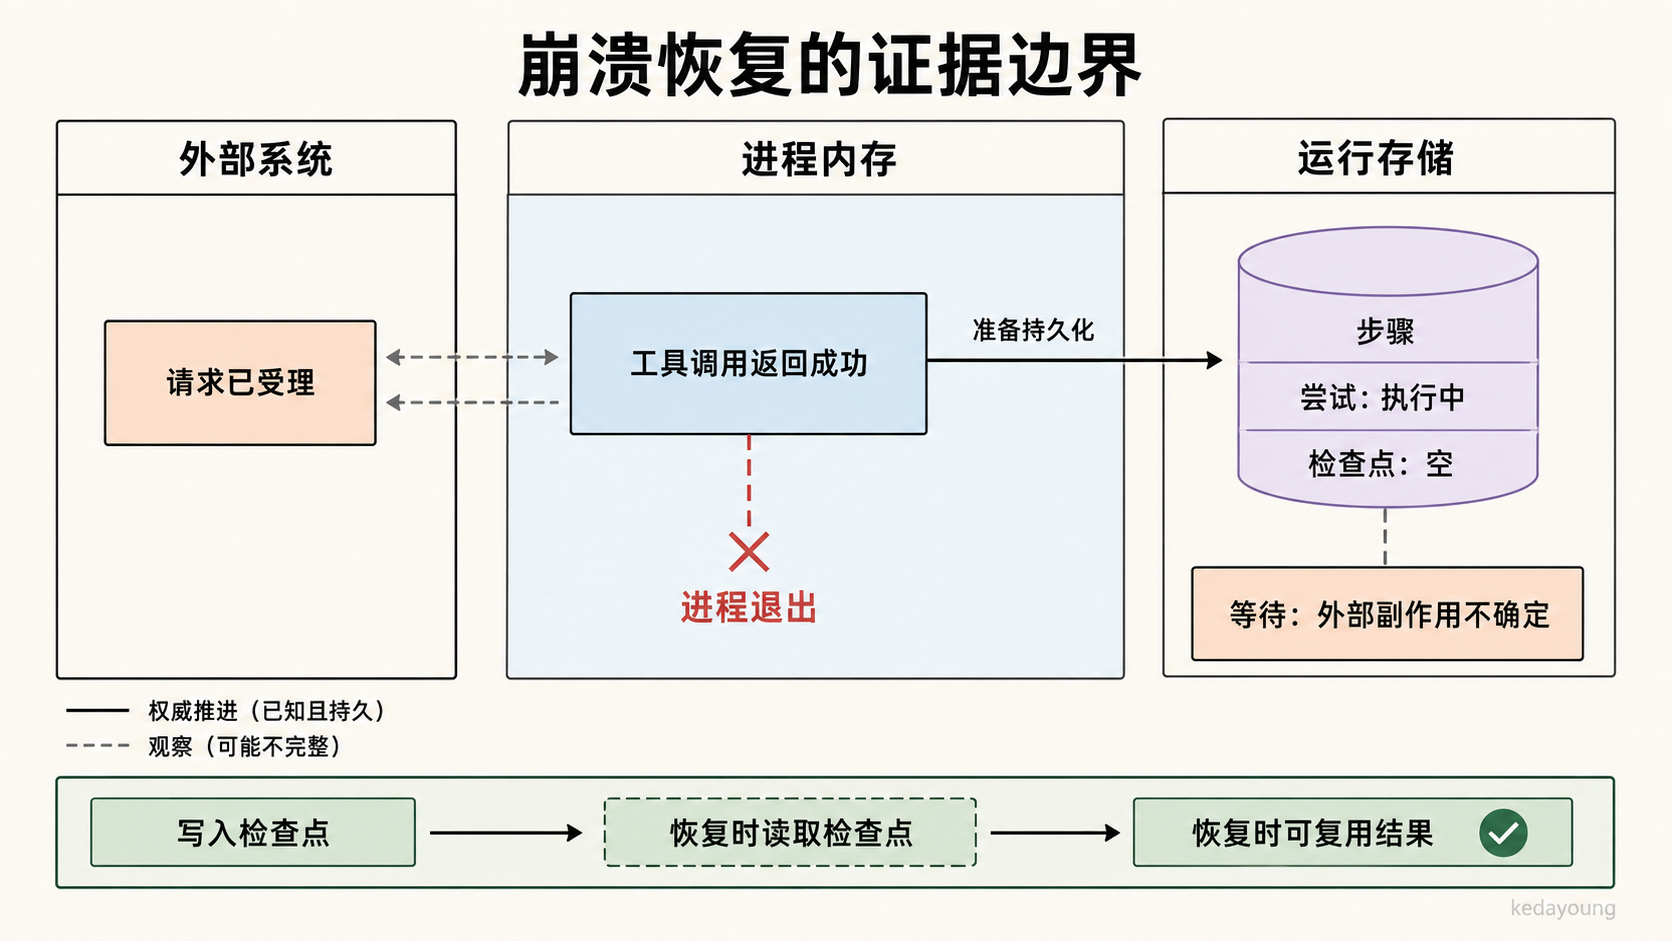
图 M01:调用返回不等于持久化确认,缺少 Checkpoint 也不等于外部效果未发生。
外部系统接受请求是独立系统中的事实;Tool 在内存中返回成功与 Tool Checkpoint 提交之间,仍存在无法合并为单一事务的崩溃窗口。
动画 A01:Checkpoint 前后的崩溃分界(9 秒)
播放 / 下载 MP4 · 结论静帧 · 手机竖版图
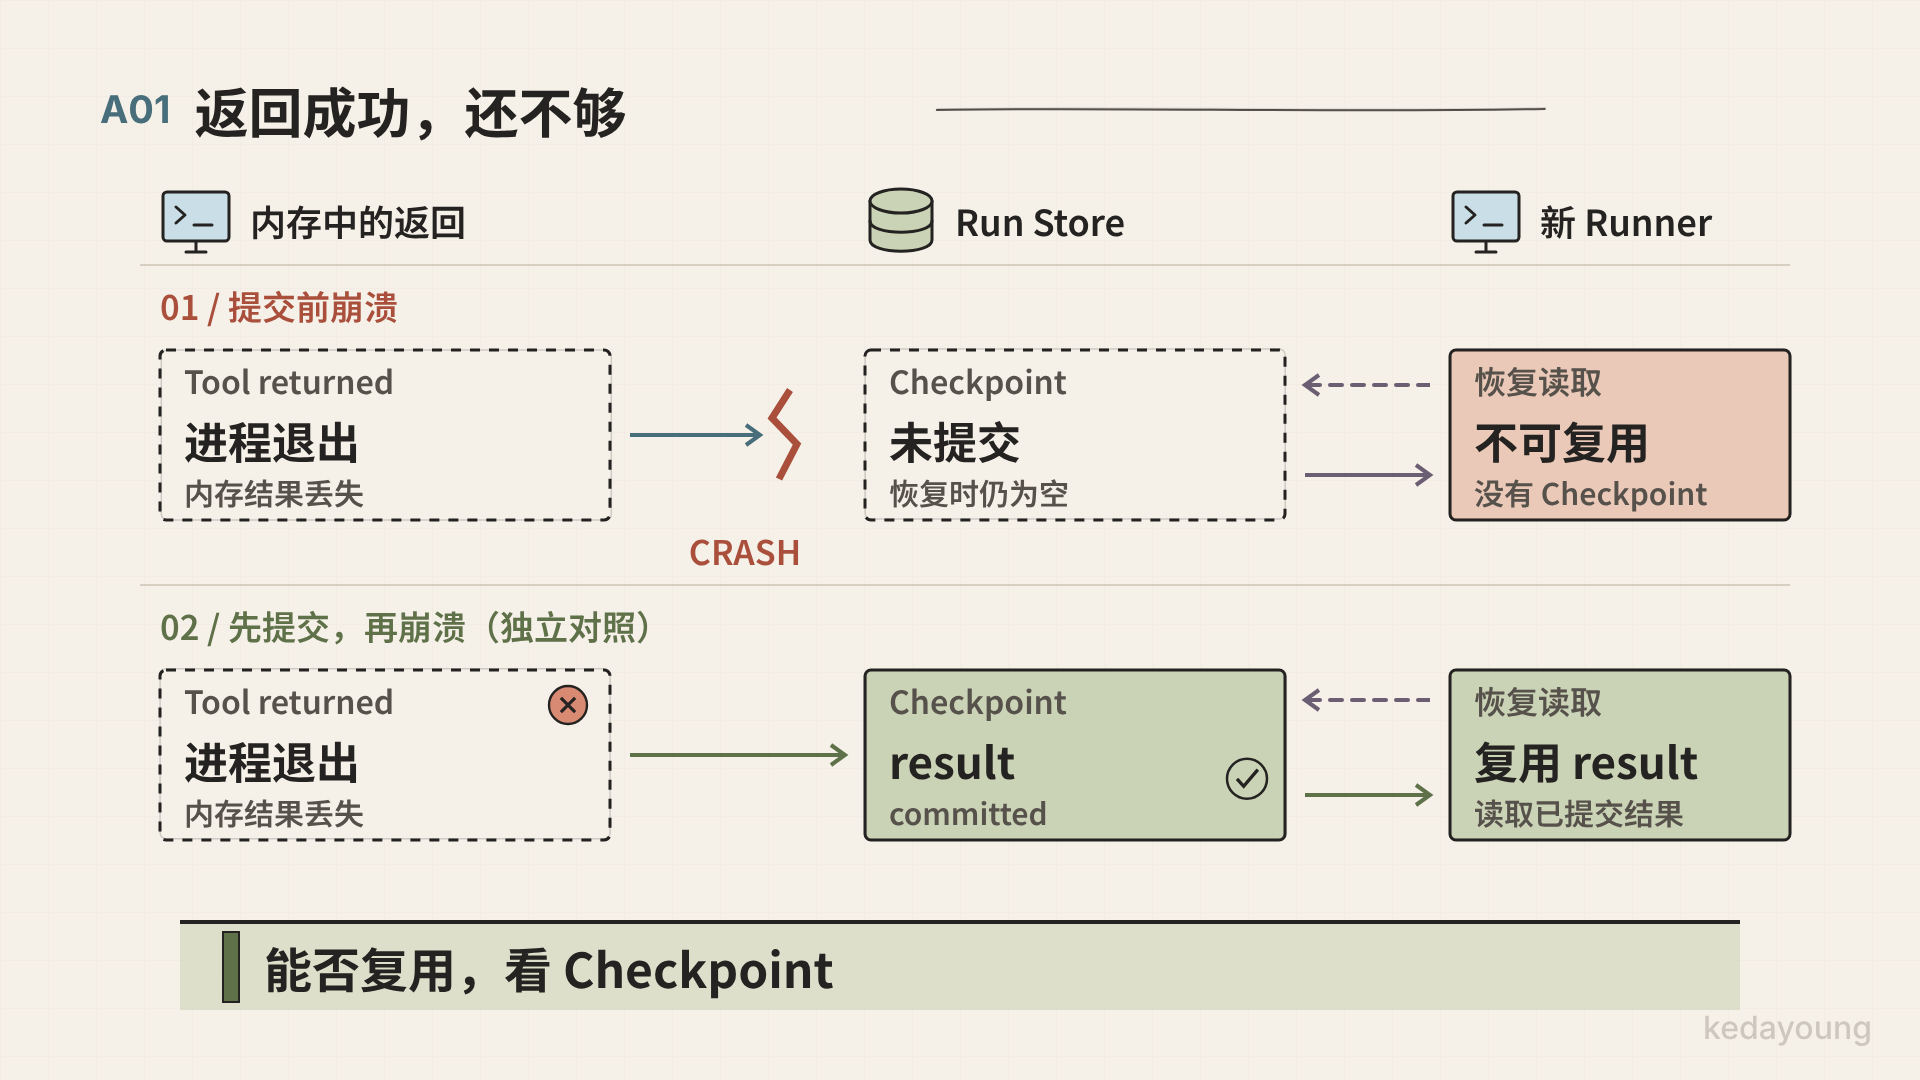
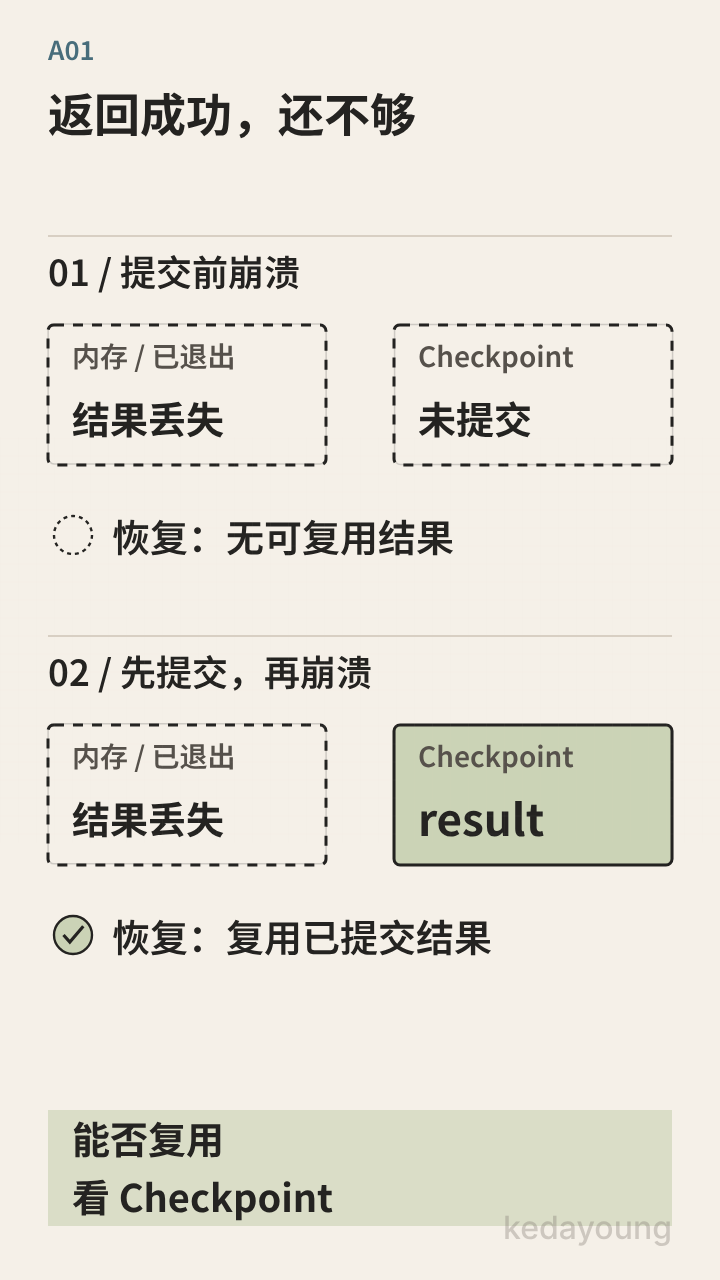
两条独立时间线对照提交前后:恢复能直接复用的是 Store 中已确认的完整结果, 不是旧 Runner 曾经收到的内存返回。
这段场景不是思想实验。仓库中的 tests/test_m_agent_resolution.py 用独立外部 journal 记录通知效果,并在 journal 已有记录、但 Tool Checkpoint 尚未提交时硬退出。它分别验证了两层证据:外部效果已经发生,而 Run Store 仍 缺少确认;恢复因此不重复调用工具,并进入 WAITING,再由应用通过 CONFIRM_STEP 完成 Run。
第 1 章:先建立阅读地图
1.1 Runtime 的边界
设计决策: M-Agent 是嵌入 Python 应用的 Agent Application Runtime, 不是 Agent Platform,也不是任务调度系统。Runner 只推进调用方明确交给它的 Run;进程部署、队列、任务发现、后台扫描、worker 编排和自动 takeover 都属于 上层应用。这个边界由 ADR-0001、 ADR-0009 以及 SQLiteRunStore 模块说明 共同定义。
图解结构源稿
flowchart LR
    App[Application / Service] -->|create, start, resume, resolve, cancel| Runner
    App -->|register exact definition| Registry[Definition Registry]
    Runner --> Registry
    Runner --> Store[(Run Store)]
    Runner --> Context[Context Provider]
    Runner --> Model[Model Adapter]
    Runner --> Tool[Tools]
    Runner -. metadata events .-> Telemetry[Telemetry Sink]
    Runner -. live-only updates .-> UI[Application UI / Transport]

    Queue[Queue / Scheduler] -. application owned .-> App
    Workers[Worker deployment] -. application owned .-> App
    Secrets[Credentials / Secret Store] -. adapter owned .-> Model
    Secrets -. adapter owned .-> Tool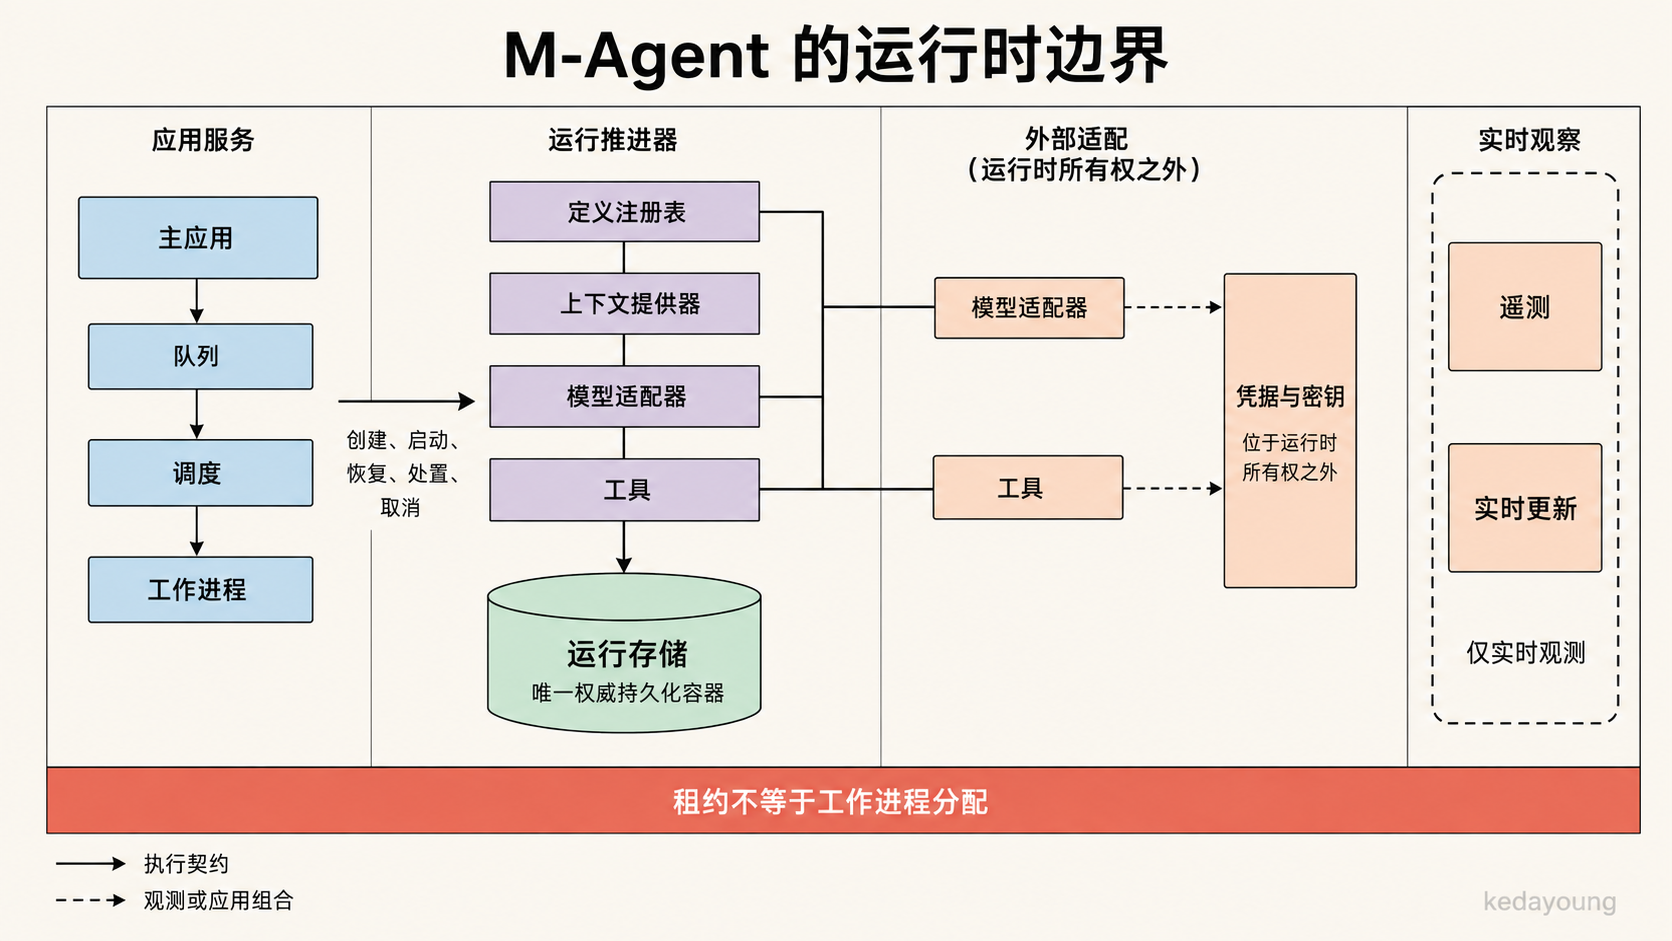
图 M02:Runtime 推进 Run;队列、worker 部署和自动接管编排属于应用。
图中实线表示执行路径上的必需契约,虚线表示不影响 Run 权威状态的可选观测或 应用组合关系。Telemetry 虽由 Runner 直接发出,但只用于观测,不参与恢复或 状态推进。 尤其需要注意:Run Lease 是单个 Run 的推进权,不等于 worker assignment; Run Update 是实时通知,不等于持久化事件总线;Run Store 是 Runner 恢复 Run 状态、步骤边界和已确认结果时读取的权威持久化来源,不等于 Trace Store, 也不证明 Store 事务之外的外部副作用。
1.2 五个必须分开的对象
第一次读代码时,最容易把 Run、Step、Attempt、Checkpoint 和 Update 混成 “执行日志”。它们实际上承担完全不同的职责。
| 对象 | 回答的问题 | 是否权威 | 是否影响恢复 |
|---|---|---|---|
RunRecord | Run 的顶层身份、冻结语义、状态、版本与 Lease 是什么 | 是 | 是 |
StepRecord | 一个逻辑 Context/Model/Tool Step 最终怎样 | 是 | 是 |
StepAttempt | 这个 Step 具体尝试过几次,每次怎样 | 是 | 是 |
StepCheckpoint | 哪个完整结果已经确认持久化,可直接复用 | 是 | 是 |
RunUpdate | UI 此刻应该显示什么实时进度;断线后可能丢失 | 否 | 否 |
实现事实: 当前 Step 类型只有 MODEL、CONTEXT、TOOL;Step 与 Attempt 状态只有 RUNNING、SUCCEEDED、FAILED。每次重试创建新的 attempt_id,但保持同一个逻辑 step_id。Checkpoint 关联一个被确认完成的 Attempt,并携带恢复所需的完整输出;该 Attempt 可以来自实际执行,也可以来自 应用提交 CONFIRM_STEP 后由 Runner 记录的确认结果。见 src/m_agent/_steps.py。
class StepAttempt(BaseModel):
    attempt_id: str
    step_id: str
    run_id: str
    status: StepStatus
    output: str | None = None
    error: str | None = None
    classification: FailureClassification | None = None
    error_code: str | None = None
    model_purpose: ModelPurpose | None = None
    usage: ModelUsage | None = None
上面的片段摘自 StepAttempt。它揭示了两个重要决定:
StepRecord表示逻辑工作单元,StepAttempt表示该工作单元的一次具体执行
尝试及其持久化身份;
- 失败分类和机器可读错误码是数据,而不是从异常字符串临时推断的结论。
图解结构源稿
erDiagram
    RUN ||--o{ STEP : owns
    STEP ||--o{ ATTEMPT : retries_as
    STEP ||--o| CHECKPOINT : confirms
    ATTEMPT ||--o| CHECKPOINT : produces

    RUN {
        string run_id PK
        string definition_id
        string definition_version
        string status
        int version
        string lease_owner
        datetime lease_expires_at
    }
    STEP {
        string run_id PK
        string step_id PK
        string step_type
        string status
    }
    ATTEMPT {
        string run_id PK
        string attempt_id PK
        string step_id
        string status
        string classification
        string error_code
    }
    CHECKPOINT {
        string run_id PK
        string step_id PK
        string attempt_id
        string step_type
    }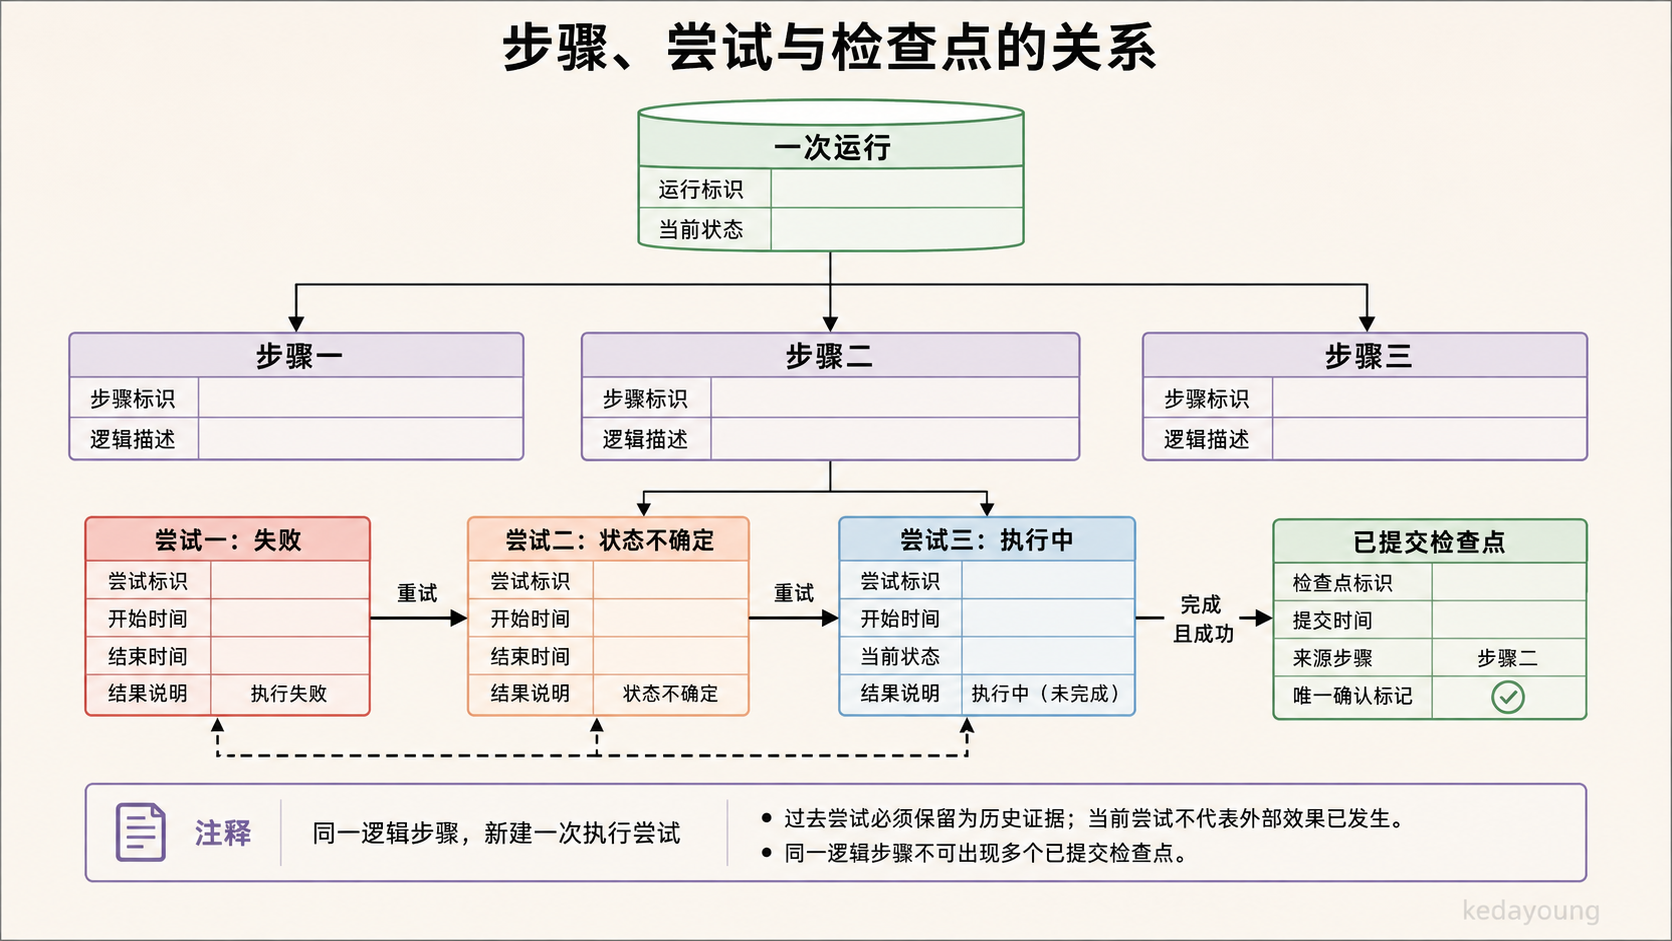
图 M03:重试增加 Attempt,不更换逻辑 Step,也不删除旧的失败证据。
这张图只表示归属关系,不表示写入顺序。实际顺序通常是先持久化 Step/Attempt, 外部执行完成后再写 Checkpoint,因此存在“有 RUNNING Attempt、无 Checkpoint”的恢复窗口。
“一个 Step 至多一个 Checkpoint”并不表示它只能尝试一次。它表示同一逻辑 Step 的多次顺序尝试最终至多有一个已确认完整结果;失败 Attempt 全部保留,最终被 确认完成的 Attempt 才成为 Checkpoint 的来源。Lease 约束有效推进者,但不终止 已发出的外部请求;接管后新旧 Attempt 的外部执行仍可能在时间上重叠。这里的 多次尝试表示同一逻辑 Step 的历史,而不是由多个结果竞争决定最终输出的机制。
1.3 七状态 Run 状态机
实现事实: 当前公开 Run 状态为:
CREATED -> 尚未开始任何执行
RUNNING -> 已进入执行状态;正常情况下由有效 Lease owner 推进,也可能因崩溃遗留
WAITING -> 需要外部条件或应用决定,不是失败
SUCCEEDED / REJECTED / FAILED / CANCELLED -> 终态
RUNNING 本身不等于当前调用方拥有推进权;恢复或继续推进仍必须重新通过 Lease 校验。源码中的合法转换表是最终依据;旧的“六状态” ADR-0005 已由 ADR-0027 取代,新增 REJECTED 用于区分策略拒绝与执行失败。见 src/m_agent/_status.py。
图解结构源稿
stateDiagram-v2
    [*] --> CREATED
    CREATED --> RUNNING
    CREATED --> WAITING
    CREATED --> REJECTED
    CREATED --> FAILED
    CREATED --> CANCELLED

    RUNNING --> SUCCEEDED
    RUNNING --> REJECTED
    RUNNING --> FAILED
    RUNNING --> WAITING
    RUNNING --> CANCELLED

    WAITING --> RUNNING
    WAITING --> FAILED
    WAITING --> CANCELLED

    SUCCEEDED --> [*]
    REJECTED --> [*]
    FAILED --> [*]
    CANCELLED --> [*]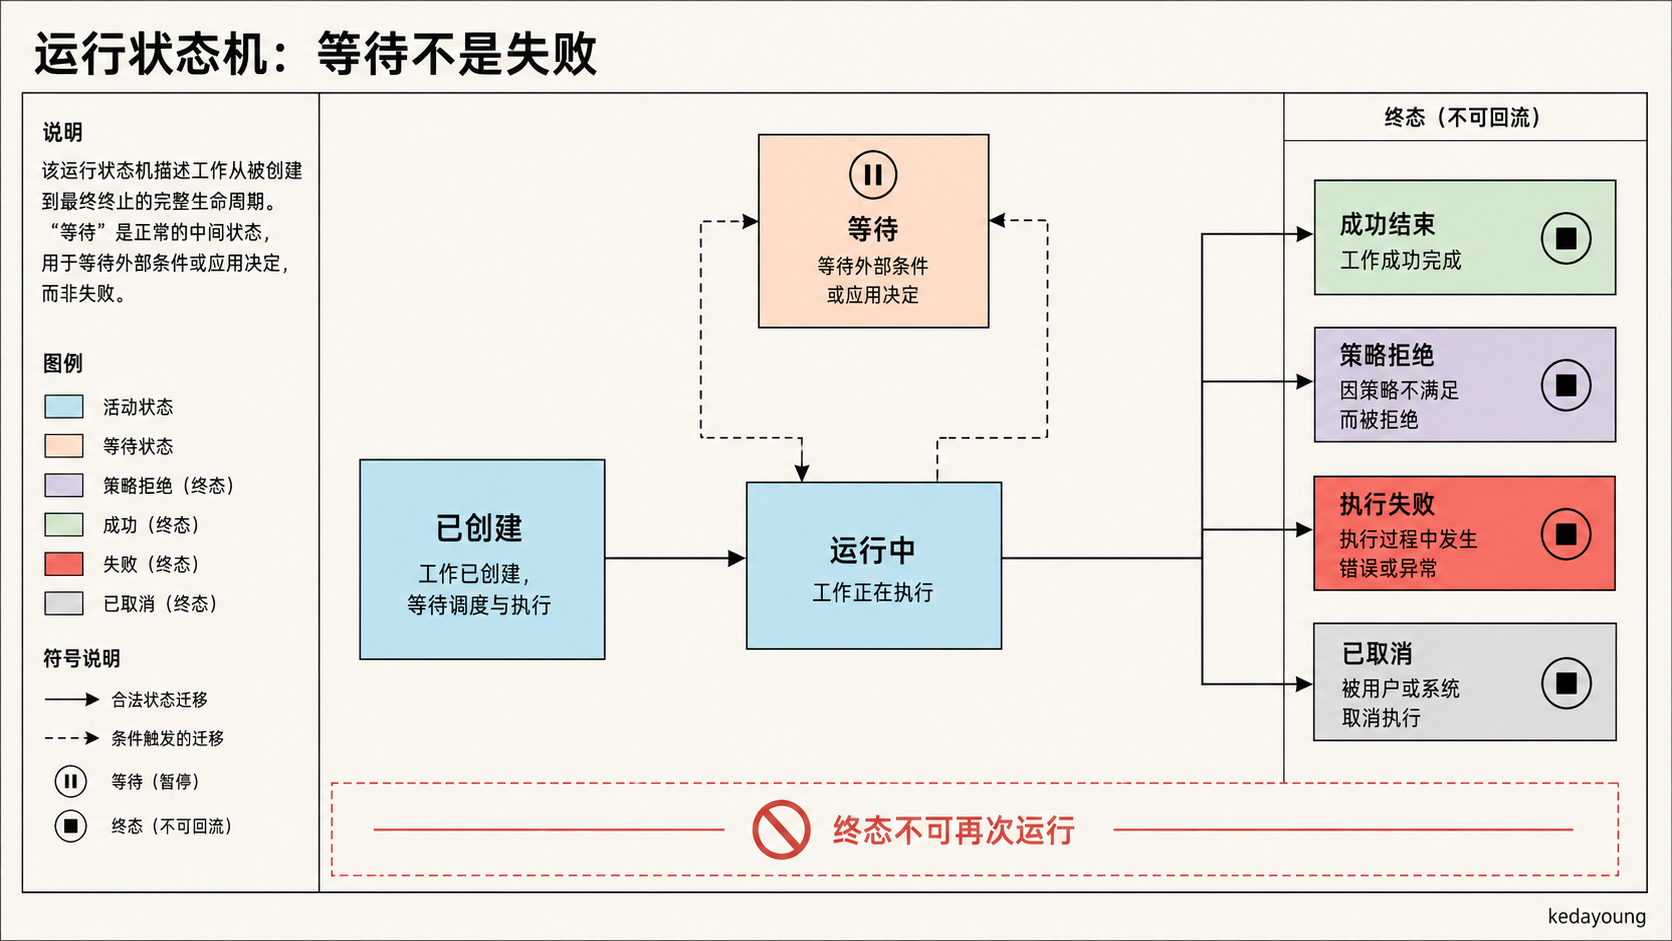
图 M04:WAITING 保留待处置事实,与执行失败和其他终态分开。
WAITING 是可恢复的中间态,不代表失败。它把“为什么不能继续”保存为结构化 waiting_reason,必要时以 waiting_step_id 指向待处置步骤;应用据此查证 外部事实、补回旧 Definition 或提交允许的 Resolution。第 9 章会展开具体命令。
1.4 Definition Snapshot:恢复的是原执行语义
设计决策: Agent Definition 有稳定 definition_id 和不可变 version。 Run 创建时冻结 DefinitionSnapshot;恢复时必须按 definition_id + version 精确找到可执行实现,不能悄悄换成“最新版本”。 见 ADR-0022 与 ADR-0023。
Snapshot 是纯数据,不序列化 Python callable。以下字段是源码导航,不要求在 本节一次掌握;后文会按 Context、Model、Tool 和 Policy 路径分别展开。Snapshot 冻结:
- 指令与 Model Binding Set;
- Model Contract 指纹与 Model Execution Budget;
- 是否声明 Context Provider;
- Tool 名称及
ToolEffect; - Retry Policy;
- Run Policy identity;
- Output Contract、Context Plan 与 Compression Contract。
创建 Snapshot 的实现集中在 AgentDefinition.frozen_snapshot。
文档差异: v0.5.1 的 CONTEXT.md 和 ADR-0022 仍使用“首次开始/启动时 冻结”的表述,start_run() 的 docstring 也沿用了这一说法;实际控制流在 create_run() 中调用 frozen_snapshot() 并持久化。本文按实现描述冻结时点, 同时保留这一待同步的设计文档差异,不将两种说法视为完全一致。
继续一个既有 Run 时,进程仍需重新注册旧版本的 Python 对象。Registry 先按 definition_id + version 精确解析,Runner 再校验当前 Adapter 的 Contract 和能力指纹是否与 Snapshot 一致。resume_run() 找不到精确版本时进入 WAITING(DEFINITION_UNAVAILABLE);对尚未启动的 CREATED Run, start_run() 找不到精确定义则直接报错。两条路径都不会静默换用最新版。
1.5 阅读顺序
后续章节沿公开 API 垂直追踪:
create_run
  -> start_run
     -> acquire_lease
     -> INPUT policy
     -> _execute_steps
        -> Context Steps
        -> optional Compression Model Step
        -> PRIMARY Model / Tool loop
        -> final output

resume_run
  -> rebuild from Run + Steps + Attempts + Checkpoints
  -> reuse, replay, WAITING, or fail closed

resolve_run / cancel_run / subscribe_run
  -> application control and presentation boundaries
对应的最小模块地图如下:
| 模块 | 首次阅读时要回答的问题 |
|---|---|
src/m_agent/_run.py | 一次 Run 的权威顶层字段是什么,version 与 Lease 放在哪里 |
src/m_agent/_steps.py | Step、Attempt、Checkpoint 如何区分,失败分类保存在哪里 |
src/m_agent/_status.py | 当前七状态和合法转换是什么 |
src/m_agent/_store.py | Store 协议、Run-scoped identity 与 Payload 拆分是什么 |
src/m_agent/_runner.py | 所有 API 在什么时间点检查、dispatch、Checkpoint 和转换状态 |
src/m_agent/adapters/_sqlite_store.py | 协议如何落到 SQL、事务、commit 与迁移 |
不要从 SQLite 表开始读。表结构只能告诉你“存了什么”,不能告诉你“为什么在 这个时间点存”。先理解 Runner 的时序,再回到 Store,字段和事务边界才会有 意义。
第 2 章:create_run 先持久化身份,再允许执行
公开入口位于 Runner.create_run:
下面只截取创建阶段的核心数据流;方法签名、持久化成功后的 telemetry 和异常 处理省略。
if run_id is not None and not run_id.strip():
    raise ValueError("run_id must be a non-blank identifier")
definition = self._registry.resolve(definition_id, version)
run = RunRecord(
    run_id=run_id if run_id is not None else new_id(),
    definition_id=definition.definition_id,
    definition_version=definition.version,
    input=input,
    history=tuple(history),
    status=RunStatus.CREATED,
    snapshot=definition.frozen_snapshot(),
)
result = await self._store.create_run(run)
2.1 为什么创建和启动要拆成两个 API
create_run() 不 dispatch Model、Context Provider 或 Tool。它的四项核心 生命周期职责是:
- 确定 Run identity;
- 精确解析 Definition;
- 冻结执行语义与输入;
- 持久化一个可查询的
CREATED记录。
Store 成功后,它还会尝试发布一条不参与恢复的 CREATED telemetry。 frozen_snapshot() 也不是保存 Definition 对象引用,而是把可序列化执行声明 展开成 DefinitionSnapshot;callable、凭据和运行时对象仍留在 Registry 或 Adapter 边界。
作者推断: 这个拆分让“执行意图”先成为权威事实,再进入任何昂贵或有 副作用的操作。上层应用可以先把 Session claim、业务任务、审计记录或队列项 与 run_id 绑定,再单独调用 start_run()。若 create_run() 已从 Store 成功返回,随后进程在调用 start_run() 前崩溃,恢复面对的是一个明确的 CREATED Run;若崩溃发生在 Store 提交前,Run 是否存在仍由 Store 的事务 结果决定。
这也解释了为什么允许调用方预分配 run_id。上层应用可以在调用 create_run() 前自行生成并登记 identity,把它与 Session claim、HTTP 幂等键、业务工单或外部编排记录关联。M-Agent 只负责持久化该 identity,并由 Store 以 DuplicateRunError 拒绝重复创建;这些跨边界绑定不属于 Runner 本身。
2.2 Snapshot 在创建时冻结,而不是恢复时重算
对内置 SQLiteRunStore,definition.frozen_snapshot() 与 CREATED Run 的 metadata、input、history 等 Payload 在同一次提交中落库。对抽象 RunStore 协议,调用方应把 create_run() 视为创建边界,具体事务保证由 Adapter 实现负责。这样即使 start_run() 晚几个小时执行,或进程重启后才 启动,运行时仍知道这次 Run 原本声明了哪些工具、预算、策略和模型契约。
这里有一个值得强调的边界:
- Snapshot 保存“执行语义数据”;
- Registry 保存“当前进程可调用的 Python 实现”;
- 恢复要求二者精确匹配;
- 凭据既不属于 Snapshot,也不属于 Run Payload;具体 Adapter 从应用提供的
外部配置或凭据边界读取,Runtime Core 不负责密钥管理。
如果把 callable 直接序列化进数据库,恢复就必须承担代码对象的加载与执行 风险;如果只保存 Definition ID 而不冻结版本语义,恢复又会随当前配置漂移。 M-Agent 选择的是“纯数据快照 + 精确代码注册”的组合。
2.3 CREATED 已经可观测,但还没有执行证据
create_run() 在 Store 成功后尝试发布 CREATED telemetry。它不承载 Payload,也不是恢复来源;由于事件在 Store 提交后独立发送,可能因进程退出 或 Sink 故障而缺失,不能把它视为与持久化记录原子一致。
在没有并发启动者、且 create_run() 已成功返回的前提下,通常应该满足:
- 有
RunRecord; status == CREATED;version为初始版本;- 有冻结 Snapshot、输入和可选 Conversation History;
- 没有 Step、Attempt、Checkpoint;
- 没有外部调用。
这个“空执行轨迹”很重要。未进入活跃推进循环的 CREATED Run 可以由 cancel_run() 在取得 Lease 后终结为 CANCELLED,并明确证明模型和工具 调用数为零;若启动已经并发进行,取消则遵循第 10 章的协作式语义。
第 3 章:start_run 先取得推进权
start_run() 的主干很短,却集中了 Durable Run 的三个基本条件:正确状态、 正确 Definition、排他 Lease。
以下为源码节选;非法状态分支的完整错误消息被省略:
run = await self._get_existing_run(run_id)
if run.status is not RunStatus.CREATED:
    raise IllegalRunTransitionError(...)
definition = self._registry.resolve(
    run.definition_id, run.definition_version
)
self._assert_adapter_contract_matches_snapshot(run, definition)
lease = await self._store.acquire_lease(
    run.run_id,
    self._owner,
    self._lease_ttl,
    expected_version=run.version,
)
return await self._start_with_lease(run, definition, lease)
摘自 Runner.start_run。
3.1 状态检查:避免把 start 当作幂等 resume
start_run() 只接受 CREATED。已经 RUNNING 的 Run 即使由同一个应用再次 提交,也不能把 start 当成“继续执行”;恢复必须走 resume_run()。这让 API 语义与并发错误保持清晰:
start_run:第一次启动;resume_run:依据权威证据重建位置;resolve_run:处理 WAITING 中需要应用决定的事实;cancel_run:提交协作式停止意图。
把四者合并成一个“run()”入口会减少 API 数量,却会迫使内部通过猜测当前状态 来解释调用意图,错误也难以区分。
3.2 Contract 校验为什么在 Lease 前后都出现
Runner 在获取 Lease 前校验一次 Snapshot/Adapter Contract,进入 _start_with_lease() 后又校验一次。后续真正 dispatch 前还会继续校验。
实现事实: 这不是为了证明远端模型永远不漂移,而是为了校验当前注册的 Adapter、Binding 与这次 Run 冻结的本地契约一致。对 PROVIDER_ALIAS 一类 远端身份,M-Agent 不虚假承诺供应商背后的权重永不变化。
作者推断: 多次校验把长执行链中的配置漂移窗口压缩到每个外部调用边界。 尤其 telemetry、Policy、Store 操作都可能执行应用代码或发生等待;在它们之后 再做最终 guard,能避免“检查时合法,dispatch 时已经换配置”的竞态。
3.3 Lease 不是普通进程锁
acquire_lease() 接收 expected_version,并把 owner 与过期时间持久化到 Run Store。Lease 有三个特征:
- 排他: 有效期内其他 owner 不能推进同一 Run;
- 可过期: 崩溃不需要 finally 释放,超时后可由新 Runner 接管;
- 受版本保护: 调用方观察到的 Run 版本过期时,不能基于旧事实取 Lease。
它只约束单个 Run 的推进,并不发现任务、选择 worker 或发起重试。上层应用 必须明确调用 resume_run() 才会发生 takeover。
3.4 INPUT Policy 在 RUNNING 之前
这里的 Run Policy 是冻结在 Definition Snapshot 中的确定性约束; PolicyGate.INPUT 是它介入生命周期的位置。策略返回结构化 Policy Decision, 动作只能是 ALLOW、REJECT 或 REQUIRE_RESOLUTION。Policy Gate 本身不是 Run Step,也不代表一次外部调用。
拿到 Lease 后,_start_with_lease() 先执行 PolicyGate.INPUT。只有 ALLOW 才把 Run 从 CREATED 转为 RUNNING:
gated = await self._enforce_policy(
    run, definition, lease, PolicyGate.INPUT, {"input": run.input}
)
if gated.status is not RunStatus.CREATED:
    return gated
running = await self._store.transition_run(
    run.run_id,
    expected_version=run.version,
    status=RunStatus.RUNNING,
    lease_owner=lease.owner,
)策略可以返回 ALLOW、REJECT 或 REQUIRE_RESOLUTION。Policy Decision 会先持久化,再发生受保护的状态变化。Policy Gate 不是 Run Step:它拥有独立 的 PolicyDecisionRecord,避免把授权判断和外部执行尝试混为一谈。
第 4 章:_execute_steps 是一条受检查的循环
4.1 顶层顺序
下面展示的是 CREATED -> RUNNING 后、尚无既有执行证据时的正常启动路径。 resume_run() 不会无条件重走这段循环;它先由 _resume_running() 读取已有 Step、Attempt 和 Checkpoint,再决定复用、重放、进入 WAITING 或失败。 _execute_steps() 的实现刻意保持简单:
cancelled = await self._maybe_cancel(run, lease)
if cancelled is not None:
    return cancelled
run = await self._run_input_context_stages(run, definition, lease)
if run.status is not RunStatus.RUNNING:
    return run
run, _ = await self._run_compression_step(run, definition, lease)
if run.status is not RunStatus.RUNNING:
    return run
return await self._run_agent_loop(
    run, definition, lease, prior_tool_outcomes=()
)执行顺序是:
- 在新 Step 前检查协作取消;
- 执行
RUN_INPUTScope 的 Context Stages; - 如果声明 Semantic Compression,将其作为独立
CONTEXT_COMPRESSION Model Step;
- 进入业务
PRIMARYModel / Tool 循环。
因此,这四步描述的是正常主路径;恢复会在相同业务顺序中插入 Checkpoint 复用 和未确认 Attempt 处置。
Context 必须先 Checkpoint,再允许依赖它的 Model Step dispatch。语义压缩也 不是内部字符串处理,而是独立、可计费、可恢复的 Model Step。这样恢复时能 区分“原始上下文已冻结”“压缩结果已完成”“业务模型尚未调用”三个边界。
4.2 正常执行时序
图解结构源稿
sequenceDiagram
    autonumber
    participant App
    participant Runner
    participant Store
    participant Policy
    participant Context
    participant Model
    participant Tool

    App->>Runner: create_run(definition_id, version, input)
    Runner->>Store: create CREATED + frozen snapshot
    App->>Runner: start_run(run_id)
    Runner->>Store: acquire lease(expected_version)
    Runner->>Policy: INPUT
    Policy-->>Runner: ALLOW
    Runner->>Store: CREATED -> RUNNING

    opt RUN_INPUT Context
        Runner->>Store: Context Step/Attempt RUNNING
        Runner->>Context: provide()
        Context-->>Runner: ContextStageResult
        Runner->>Store: Context Step/Attempt/Checkpoint SUCCEEDED
    end

    opt Semantic Compression
        Runner->>Store: reserve CONTEXT_COMPRESSION attempt
        Runner->>Model: dispatch compression request
        Model-->>Runner: complete ModelResponse
        Runner->>Store: Model Step/Attempt/Checkpoint
    end

    loop until response has no tool_calls
        Runner->>Store: reserve PRIMARY Model attempt
        Runner->>Model: generate or stream
        Model-->>Runner: complete ModelResponse
        Runner->>Store: Model Step/Attempt/Checkpoint
        alt tool_calls exist
            loop each ToolCall in original order
                Runner->>Policy: TOOL_REQUEST
                Runner->>Store: Tool Step/Attempt RUNNING
                Runner->>Tool: invoke()
                Tool-->>Runner: ToolOutcome
                Runner->>Policy: TOOL_OUTCOME
                Runner->>Store: Tool Step/Attempt/Checkpoint
            end
        else final response
            Runner->>Policy: FINAL_OUTPUT
            Note over Runner,Policy: success path: Policy ALLOW and Output Contract valid
            Runner->>Store: RUNNING -> SUCCEEDED(output)
            Runner->>Store: release lease
        end
    end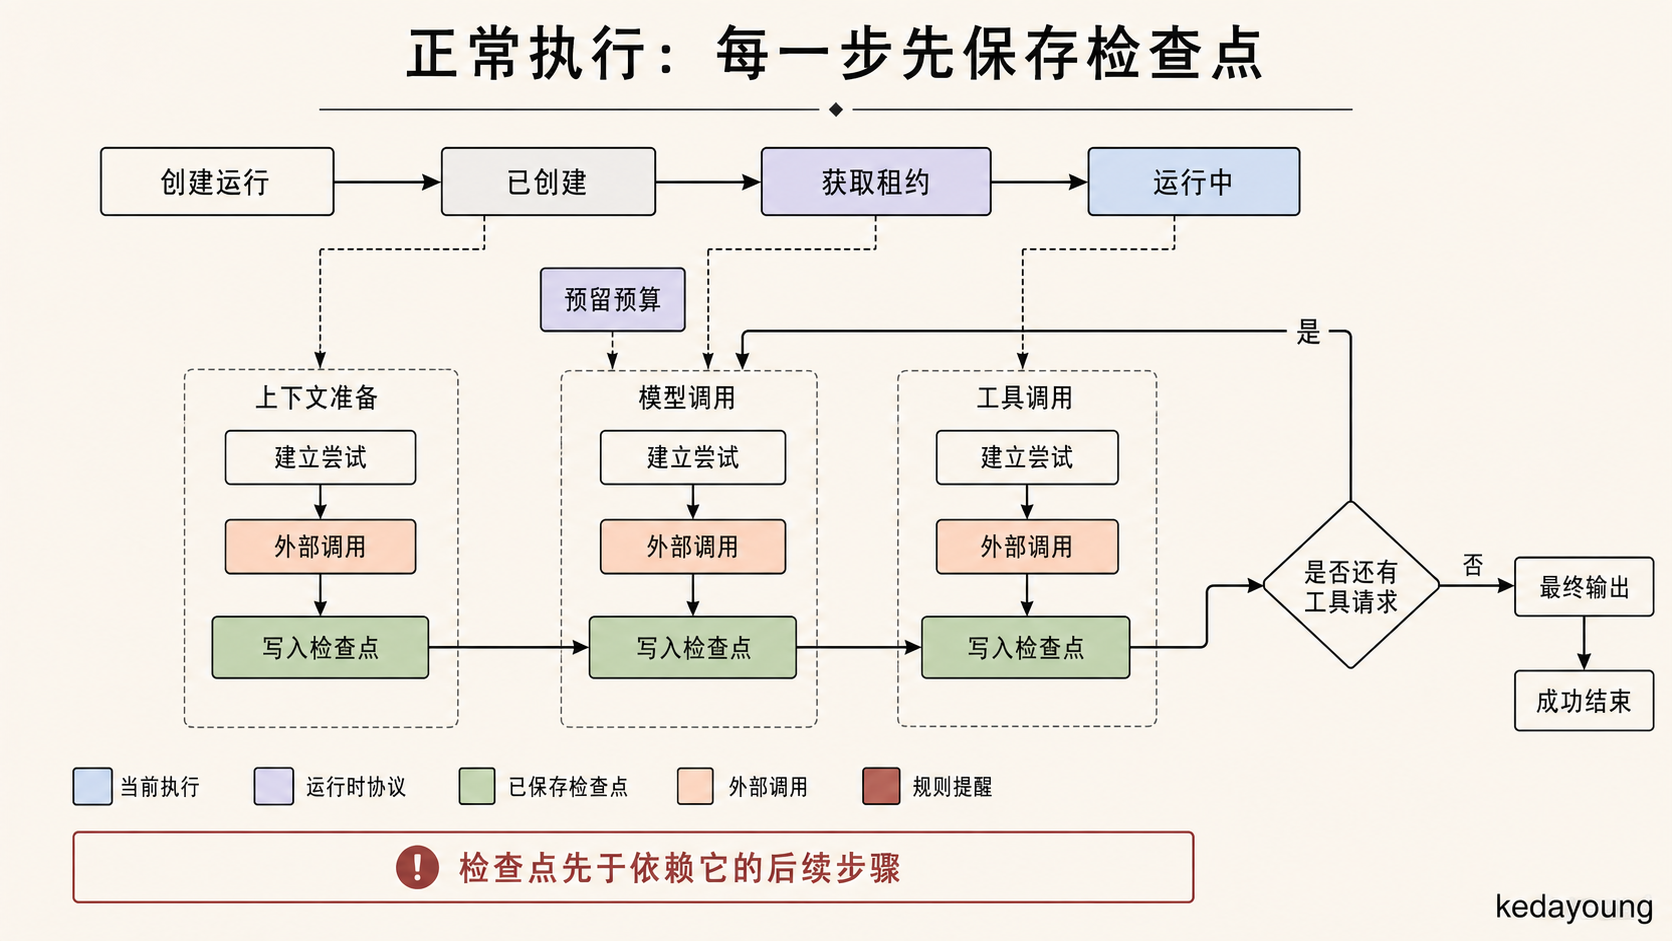
图 M05:正常主循环先确认当前完整结果,再 dispatch 依赖它的下一步。
4.3 _run_agent_loop 为什么严格顺序执行 Tool Calls
业务循环位于 Runner._run_agent_loop。每轮:
- 检查取消;
- 根据已完成 Tool/Model 边界准备 Context Frame;
- 运行一个完整 Model Step;
- Model Checkpoint 完成后再次检查取消;
- 无
tool_calls则进入最终输出; - 有
tool_calls则按模型给出的顺序逐个执行,每个 Tool Outcome
Checkpoint 后才开始下一个。
严格顺序牺牲了并行工具调用的吞吐,但显著简化了恢复:最后一个 Model Checkpoint 给出有序调用列表,Tool Checkpoints 给出已确认的前缀,恢复只需从 第一个缺失 Outcome 继续。如果并行执行,就需要表达部分完成集合、多个同时 in-flight 的不确定副作用,以及更复杂的 join/取消语义。
顺序约束只发生在同一个 Run 内。不同 Run 各自拥有独立 Lease、version 与 Run-scoped 记录,可以由不同 Runner 并发推进;当前设计没有用一个全局执行锁 把所有 Agent Run 串行化。
作者推断: 这是一种有意的语义收敛。M-Agent 当前优先提供可解释、 可检查的 Durable Runtime,而不是把工作流 DAG 或并行调度器塞进 Runner。
4.4 Context Frame 不是一个全局字符串
每次业务 PRIMARY Model Step 前,_run_agent_loop() 通过 _prepare_model_step_context() 根据 Context Scope 触发 Stage:
RUN_INPUT:整次 Run 的基础上下文;TOOL_OUTCOME:随着已完成 Tool Checkpoint 数变化;MODEL_STEP:随着已完成 Model Checkpoint 数变化。
Stage invocation 的 step_id 由 stage identity、scope 与 boundary 确定性派生。已有相同 invocation Checkpoint 时跳过 Provider,直接聚合已持久化 Items。见 Runner._prepare_model_step_context。 CONTEXT_COMPRESSION 和 OUTPUT_REPAIR 是受限的辅助 Model Step,不经过同一 业务 Context Stage 触发路径。
这里的 Context Item 是外部数据,不是 Agent Instruction。ModelRequest 中 instructions、context_items、tool_outcomes 分字段构造,Runtime 不会 把检索内容提升为 system 指令。这个边界能保留来源与权限层级,但不等于模型 天然免疫 prompt injection。
第 5 章:三类 Step 的持久化协议
Context、Model、Tool 都遵循一个总原则:
在外部调用前建立可查询的 Attempt 事实;只有完整结果写入 Checkpoint 后, 后续工作才可以把它视为已完成。
但三类 Step 面对的风险不同,因此协议细节也不同。
5.1 Context Step:冻结一次外部读取
Context Provider dispatch 前,Runner 先写:
StepRecord(RUNNING)
StepAttempt(RUNNING)
然后再次校验 Lease、取消与 CONTEXT final authorization,才调用 provider.provide()。完整结果被包装为 ContextStageResult,其中包括:
- stage identity、scope、transform type 与 boundary;
- 输入 Item 引用;
- 输出 Context Items;
- provenance;
- decisions;
- measurement。
成功后的写入顺序是:
StepRecord(SUCCEEDED)
StepAttempt(SUCCEEDED, output=serialized ContextStageResult)
StepCheckpoint(CONTEXT, output=serialized ContextStageResult)
STEP_COMPLETED update
关键实现见 Runner._run_context_stage。
为什么不只保存 Item 列表?因为恢复与 Eval 不仅需要内容,还需要知道这些内容 由哪个 Stage、在哪个 boundary、基于哪些输入产生。Context Checkpoint 是一次 Stage invocation 的证据包,不是临时缓存。
5.2 Model Step:先原子预留预算
Model Step 和 Context/Tool 最大的不同,是它在 dispatch 前通过 Store 原子预留 Attempt 与 Model Execution Budget:
以下节选保留完整的两级预算表达式,省略 reserve() 调用之后的崩溃注入分支:
reserved = await reserve(
    StepRecord(
        step_id=step_id,
        run_id=run.run_id,
        step_type=StepType.MODEL,
        status=StepStatus.RUNNING,
    ),
    StepAttempt(
        attempt_id=attempt_id,
        step_id=step_id,
        run_id=run.run_id,
        status=StepStatus.RUNNING,
        model_purpose=purpose,
    ),
    run_max_attempts=(
        budget.run_max_attempts if budget is not None else None
    ),
    purpose_max_attempts=(
        budget.maximum_for(purpose) if budget is not None else None
    ),
    expected_version=run.version,
    lease_owner=lease.owner,
)
摘自 Runner._reserve_model_attempt。
一次 Model Attempt 成功完成 reservation 后,即使随后取消、超时、Adapter 失败,或者结果是否返回不可确认,该 Attempt 的 Model Execution Budget 也已经 消费,恢复不会退款。reservation 表示 Runtime 已授予一次 dispatch 配额,不等于 供应商已经收到请求,因为最终 guard 或准备阶段仍可能阻止实际 Adapter 调用。 若恢复时返还已预留额度,反复在响应落库前崩溃就可能绕过 Run 级调用次数上限。 这里限制的是 Model Attempt 数,不是货币金额;实际费用还依赖供应商用量、 价格与应用侧结算。
真正调用模型前,Runner 已经完成:
- 从 Snapshot 选择固定 purpose 的 Adapter/Binding;
- 读取同 Step 的历史 Attempts;
- 构造完整
ModelRequest; - 校验 Model Capability 与 Contract;
- 用冻结的 Model Limits 和 Input Sizer 检查完整 Context Budget;
- 生成新
attempt_id; - 重新校验 Lease、取消与 Contract;
- 原子预留执行预算;
- 在最终 dispatch 边界再次校验 Contract 和 Lease。
只有这之后才执行 adapter.generate(request) 或消费 adapter.stream(request)。
成功时,Runner 序列化完整 ModelResponse,再依次写 Step、Attempt、Checkpoint:
以下为保留写入顺序的简化摘录;... 只省略对象构造参数与重复的 expected_version / lease_owner 实参:
payload = serialize_model_response(response)
self._maybe_crash(CrashPoint.BEFORE_MODEL_CHECKPOINT, run.run_id)
await self._store.record_step(StepRecord(..., status=StepStatus.SUCCEEDED), ...)
attempt = StepAttempt(
    attempt_id=attempt_id,
    step_id=step_id,
    run_id=run.run_id,
    status=StepStatus.SUCCEEDED,
    output=payload,
    model_purpose=purpose,
    usage=response.usage,
)
await self._store.record_attempt(attempt, ...)
await self._store.record_checkpoint(
    StepCheckpoint(..., attempt_id=attempt.attempt_id, output=payload), ...
)
见 Runner._run_single_model_step。
这里的 Checkpoint 保存完整 ModelResponse,包括 content、tool_calls 以及 Adapter 实际提供的 usage;字段不可用时保持缺失,Runtime 不伪造精确 计量。流式 delta 从不进入 Checkpoint。恢复才能准确回答模型是否明确请求过 哪些工具,而不是把若干字符片段拼成一个从未存在的响应。
5.3 Tool Step:先留下 dispatch identity
Tool Step 在 effect 发生前写入 RUNNING Step/Attempt:
await self._store.record_step(
    StepRecord(
        step_id=step_id,
        run_id=run.run_id,
        step_type=StepType.TOOL,
        status=StepStatus.RUNNING,
    ),
    expected_version=run.version,
    lease_owner=lease.owner,
)
await self._store.record_attempt(
    StepAttempt(
        attempt_id=attempt_id,
        step_id=step_id,
        run_id=run.run_id,
        status=StepStatus.RUNNING,
    ),
    expected_version=run.version,
    lease_owner=lease.owner,
)这两条记录不能证明工具已经完成,也不能单独证明 tool.invoke() 已经发生; 它们证明一次具有稳定身份、进入待 dispatch 状态的 Attempt 已被持久化。进程若 在最终 guard 或 invoke() 前消失,恢复仍需按这份 Attempt 证据处理,不能把 它误判成“工具从未被安排执行”。
工具必须显式返回 ToolOutcome.SUCCESS 或 ToolOutcome.REJECTED。两者都是 结构化、模型可见的业务结果;只有 TOOL_OUTCOME Policy Gate 返回 ALLOW 时,才形成 SUCCEEDED Tool Step 和 Checkpoint。策略若返回 REJECT 或 REQUIRE_RESOLUTION,则进入 REJECTED 或 WAITING,不把该 Outcome 直接 当作成功 Checkpoint。未捕获异常形成失败 Attempt,绝不包装成自然语言 Tool Result 交给模型。
成功工具调用和 CONFIRM_STEP 共用 _checkpoint_tool_outcome:
以下是顺序导向的伪代码,... 省略已经在前文展示的 identity 与 Store guard 参数;其中的省略写法不是合法的完整 Python 调用:
payload = serialize_tool_outcome(outcome)
self._maybe_crash(CrashPoint.BEFORE_TOOL_CHECKPOINT, run.run_id)
await self._store.record_step(... SUCCEEDED ...)
attempt = StepAttempt(..., status=StepStatus.SUCCEEDED, output=payload)
await self._store.record_attempt(attempt, ...)
await self._store.record_checkpoint(
    StepCheckpoint(
        run_id=run.run_id,
        step_id=step_id,
        attempt_id=attempt.attempt_id,
        step_type=StepType.TOOL,
        output=payload,
    ),
    ...
)
这意味着恢复后,后续 Model Step 不需要知道结果来自“工具正常返回”还是“应用 查证后确认”;二者都被归一成相同的 Tool Outcome 证据。
5.4 崩溃窗口矩阵
| Step | 崩溃位置 | Store 中可见事实 | 默认恢复 |
|---|---|---|---|
| Context | Provider 前 | 无或仅准备事实 | 重新执行 |
| Context | Provider 后、Checkpoint 前 | 未确认 Attempt;可能已有成功状态或完整 output,但无 Checkpoint | at-least-once 重新读取 |
| Context | Checkpoint 后 | 完整 Stage Result | 复用,不再读取 |
| Model | reservation 前 | 无 Attempt | 可正常 dispatch |
| Model | reservation 后、Checkpoint 前 | 已消费预算的未确认 Attempt | 标记 UNCERTAIN;冻结 Retry Policy 允许且新 reservation 仍有预算时才重放 |
| Model | Checkpoint 后 | 完整 ModelResponse | 复用,不再调用模型 |
| Tool | Attempt 持久化后、Checkpoint 前 | 已有 Attempt,无 Checkpoint;可能尚未 dispatch,也可能已有成功状态、output 或未确认 effect | RUNNING Step 按 Effect 分流;成功 Step 无 Checkpoint 存在实现缺口,见第 12.8 节 |
| Tool | Checkpoint 后 | 完整 ToolOutcome | 复用,不再调用工具 |
动画 A02:三类 Step 的恢复分流(11 秒)
播放 / 下载 MP4 · 结论静帧 · 手机竖版图
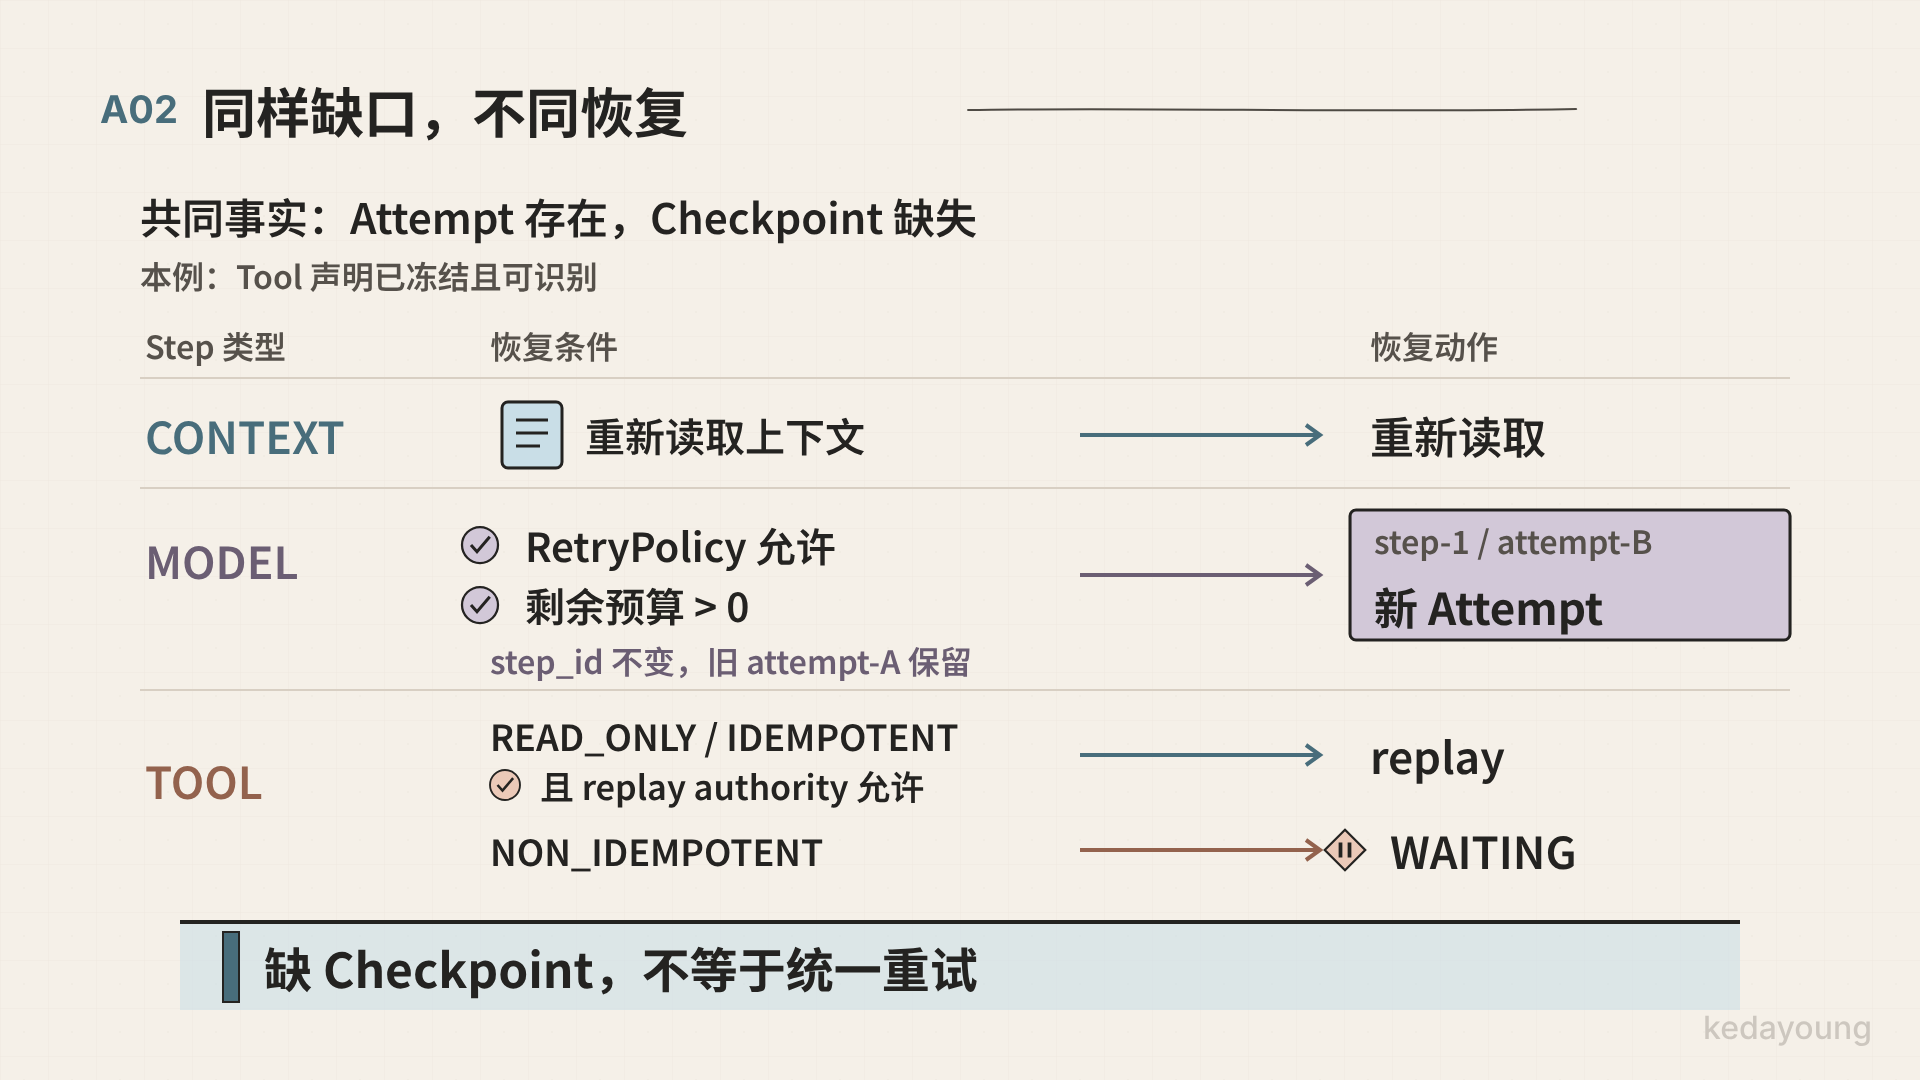
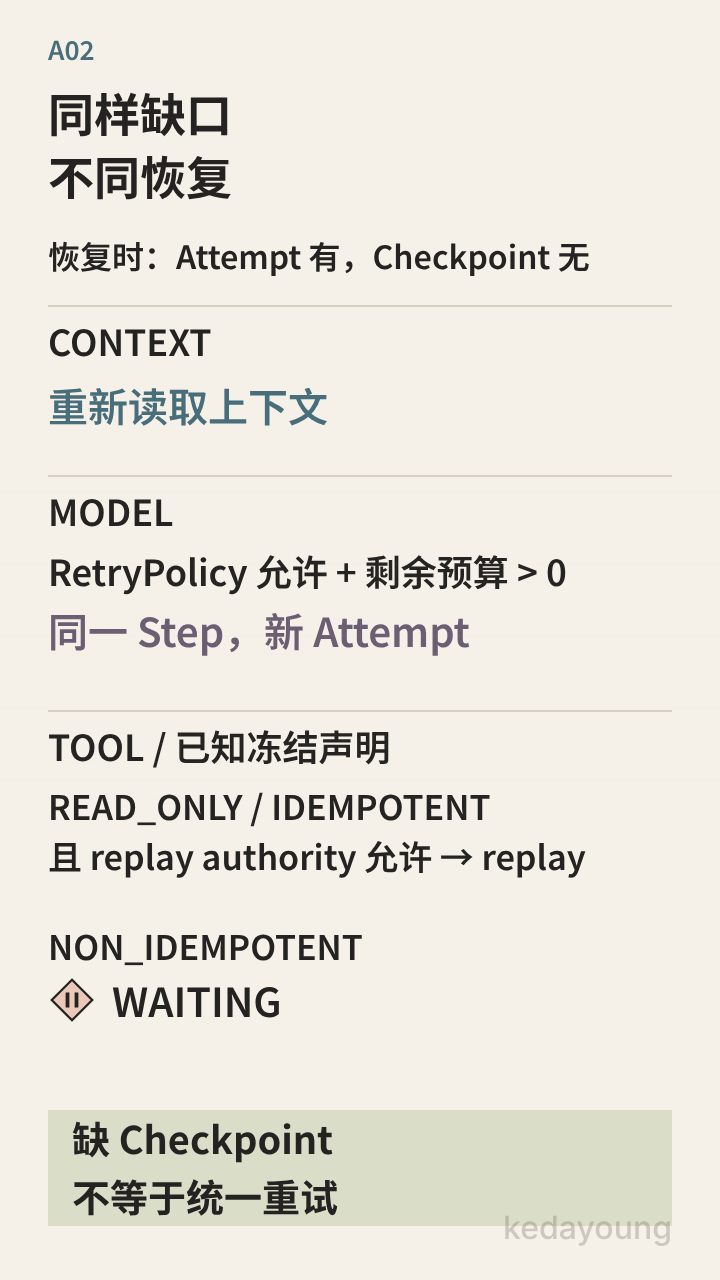
同样缺少 Checkpoint,Context、Model 和 Tool 的恢复条件并不相同。 Model 重放必须同时通过冻结 Retry Policy 与预算约束,Tool 还要区分冻结 Effect。
5.5 Retry Policy 与 Execution Budget 不是同一个东西
Retry Policy 回答:“这个失败分类是否允许在同一 Step 下再尝试一次?”
Model Execution Budget 回答:“整个 Run 以及这个 Model purpose 还允许 dispatch 多少次 Model Attempt?”
一次 Model retry 必须同时通过两层约束。TRANSIENT 可能满足 Retry Policy, 但如果 Run 级预算已经耗尽,仍会以 MODEL_EXECUTION_BUDGET_EXCEEDED 确定性失败。反过来,预算有余量也不代表 PERMANENT 或 UNCERTAIN 失败可以按普通失败路径自动重试。恢复未确认 reservation 时对 UNCERTAIN 的特殊处理见第 7.3 节,不能与普通 retry 混用。
第 6 章:SQLiteRunStore 是权威持久化边界
6.1 Metadata 与 Payload 为什么分表
设计决策: Run Store 把可查询 Metadata 与包含内容的 Payload 分离。 Metadata 保存状态、版本、时间、步骤类型、错误码、用量、Lease 等;输入、 输出、指令、模型响应、Context Items、工具参数/结果和诊断正文经 PayloadCodec 编码后进入 payload 区。见 ADR-0033。
图解结构源稿
flowchart TB
    Public[RunRecord / StepAttempt / Checkpoint]
    Split[Shared split/restore helpers]
    Codec[PayloadCodec]
    Meta[(Queryable metadata tables)]
    Payload[(run_payloads encoded BLOB)]

    Public --> Split
    Split -->|status, ids, version, classification, usage| Meta
    Split -->|input, output, instructions, errors, checkpoint body| Codec
    Codec --> Payload
    Meta --> Restore[Restore public objects]
    Payload --> Codec
    Codec --> Restore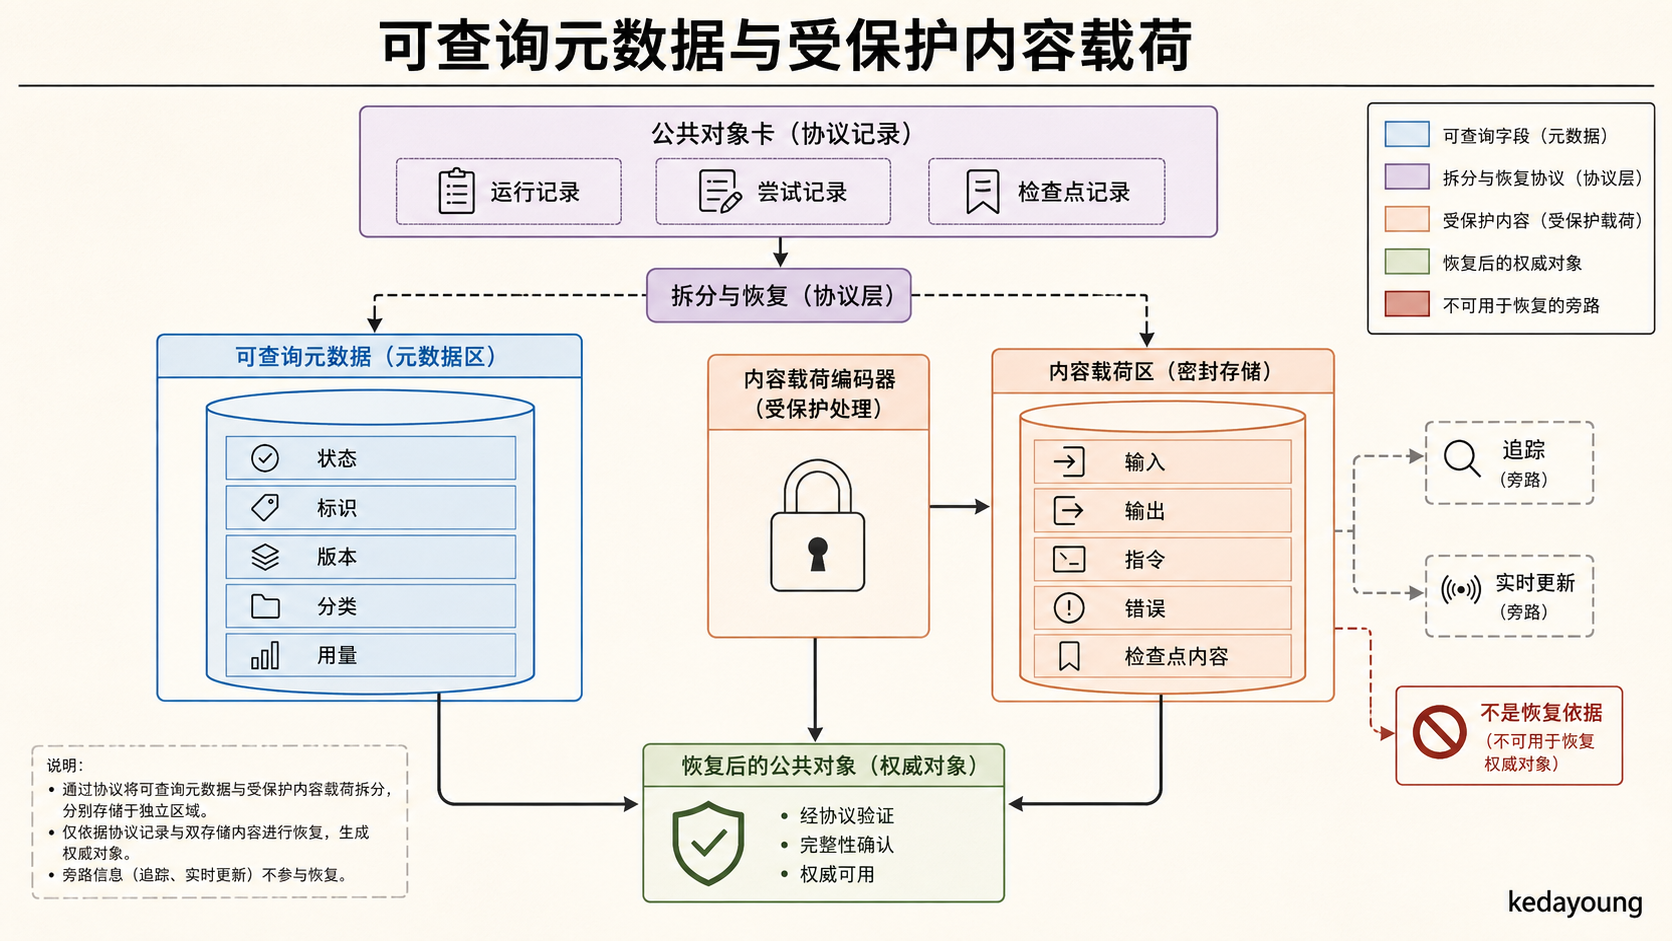
图 M06:metadata 用于查询,完整内容经 Codec 保存与恢复;Trace 和 Update 不参与重建。
共享拆分逻辑位于 src/m_agent/_store.py:
payloads: dict[str, bytes] = {FIELD_RUN_INPUT: codec.encode(run.input)}
if run.output is not None:
    payloads[FIELD_RUN_OUTPUT] = codec.encode(run.output)
if run.snapshot is not None:
    payloads[FIELD_RUN_SNAPSHOT] = codec.encode(
        run.snapshot.model_dump_json()
    )
if run.history:
    payloads[FIELD_RUN_HISTORY] = codec.encode(
        _serialize_history(run.history)
    )
stored = _StoredRun(
    run_id=run.run_id,
    definition_id=run.definition_id,
    definition_version=run.definition_version,
    status=run.status,
    snapshot=_snapshot_metadata(run.snapshot),
    version=run.version,
    # 省略 waiting、error、Lease 与 timestamp metadata 字段
)
Snapshot metadata 会排除 instructions;Attempt metadata 会把人类可读 error 留空,只保留净化后的 error_code、classification、purpose 和 usage;Checkpoint metadata 只保留 identity、类型和时间,完整 output 进入 payload。
PlaintextPayloadCodec 只用于开发和测试。它有明确前缀,却不提供静态加密或 保密性。生产环境需要由应用配置满足自身安全要求的 Codec。Codec 也不是 Secret Store:API Key 和访问令牌根本不应进入 Snapshot 或 Run Payload。
6.2 表结构映射了领域 identity
SQLite 的核心表如下:
CREATE TABLE IF NOT EXISTS runs (
    run_id             TEXT PRIMARY KEY,
    definition_id      TEXT NOT NULL,
    definition_version TEXT NOT NULL,
    status             TEXT NOT NULL,
    snapshot_json      TEXT,
    version            INTEGER NOT NULL,
    waiting_reason     TEXT,
    waiting_step_id    TEXT,
    error_code         TEXT,
    lease_owner        TEXT,
    lease_expires_at   TEXT,
    created_at         TEXT NOT NULL,
    updated_at         TEXT NOT NULL
);

CREATE TABLE IF NOT EXISTS run_payloads (
    run_id  TEXT NOT NULL,
    field   TEXT NOT NULL,
    encoded BLOB NOT NULL,
    PRIMARY KEY (run_id, field)
);
Step 相关表使用 Run-scoped composite key:
PRIMARY KEY (run_id, step_id)      -- steps
PRIMARY KEY (run_id, attempt_id)   -- step_attempts
PRIMARY KEY (run_id, step_id)      -- step_checkpoints
见 src/m_agent/adapters/_sqlite_store.py。
为什么不能只用 step_id?因为有些 Context/compression identity 是根据稳定 语义确定性派生的,不同 Run 可以合法出现相同 ID。真正的所有权边界是 Run。 因此公共契约明确规定:
- Step / Checkpoint identity 是
(run_id, step_id); - Attempt identity 是
(run_id, attempt_id); - Payload identity 是
(run_id, field)。
这不是租户授权边界,但它保证一个 Run 的写入永远不能替换另一个 Run 的记录。
6.3 Checkpoint 返回意味着已经 commit
SQLite adapter 的部署契约明确声明:写操作同步执行,并在返回前 commit。 Runner 传入 lease_owner 时,record_checkpoint() 先通过带 version/Lease 条件的 INSERT ... SELECT ... WHERE EXISTS 写 metadata,再写 encoded payload,最后提交;不带 owner 的底层 Store 调用只执行 version guard:
INSERT INTO step_checkpoints (
    step_id, run_id, attempt_id, step_type, created_at
)
SELECT ?,?,?,?,?
WHERE EXISTS (
    SELECT 1 FROM runs
    WHERE run_id=? AND version=?
      AND lease_owner=? AND lease_expires_at > ?
)
对应实现见 SQLiteRunStore.record_checkpoint。
实现事实: “Checkpoint 已返回”是一个可依赖的持久化确认;之后即使 os._exit,第二进程重开同一文件也应看到它。反过来,如果进程在该方法返回 前消失,恢复不能根据内存对象推断提交成功。
还要区分两个事务层级:一次 record_checkpoint() 中的 metadata 与 Payload 共同提交,并不意味着前面的 record_step()、record_attempt() 和它组成 一个大事务。三次调用分别提交,因而可能出现 Step/Attempt 已为 SUCCEEDED、 甚至 output 已落库,但 Checkpoint 尚不存在的窗口。恢复仍以 Checkpoint 为 完整结果的确认边界,不能只看成功状态。
6.4 主要权威写入使用原子 Lease 条件
SQLite 获取 Lease 的关键条件是:
UPDATE runs
SET lease_owner=?, lease_expires_at=?
WHERE run_id=? AND version=?
  AND (
      lease_owner IS NULL
      OR lease_owner=?
      OR lease_expires_at <= ?
  )
见 SQLiteRunStore.acquire_lease。
允许的只有:
- 当前无 Lease;
- 同 owner 续约;
- 旧 Lease 已过期,由新 owner 接管。
Step、Attempt、Checkpoint 和 Run 状态转换都在实际 mutation 中检查当前 Run version;Runner 发起的写入还检查 owner 和 lease_expires_at > now。如果 影响行数为零,Store rollback 并重新读取权威记录,以区分 StaleRunVersionError 和 LeaseNotHeldError。PolicyDecisionRecord 是一个 需要单独看待的实现例外:当前 SQLite adapter 先读取并校验 version/Lease,再 执行 INSERT,没有把 guard 与 INSERT 合并成同一条条件 mutation。
对权威状态 mutation,这比“先查 Lease,再写数据”的两条 SQL 更重要。两条 独立语句之间存在竞态: 旧 owner 可能在检查后失去 Lease,却仍完成迟到提交。把 guard 放进 mutation 本身,才使“验证所有权”和“写权威事实”成为同一原子条件。
6.5 Model Budget reservation 为什么使用 BEGIN IMMEDIATE
reserve_model_attempt() 必须同时完成:
- 检查 Run version 和有效 Lease;
- 统计这个 Run 已持久化的 Model Attempts;
- 统计指定 purpose 的 Attempts;
- 判断 Run/purpose 两级硬预算;
- 写入
RUNNINGModel Step 与新 Attempt; - commit。
关键片段:
self._conn.execute("BEGIN IMMEDIATE")
model_attempts = self._conn.execute(
    "SELECT COUNT(*) FROM step_attempts WHERE run_id=? "
    "AND model_purpose IS NOT NULL",
    (attempt.run_id,),
).fetchone()[0]
purpose_attempts = self._conn.execute(
    "SELECT COUNT(*) FROM step_attempts WHERE run_id=? "
    "AND model_purpose=?",
    (attempt.run_id, attempt.model_purpose.value),
).fetchone()[0]
见 SQLiteRunStore.reserve_model_attempt。
BEGIN IMMEDIATE 让并发 reservation 串行化,防止两个推进者都看到“还剩最后 一个名额”并同时 dispatch。reservation 不递增 Run progress version;它通过 事务内的 Attempt 行计数消耗预算,而状态转换仍由 Run version 表达。
6.6 迁移为什么 fail closed
当前 schema version 是 1。打开数据库时,SQLite adapter 在一个 BEGIN IMMEDIATE 事务中:
- 确保基础表存在;
- 读取并校验
PRAGMA user_version; - 执行旧 metadata/payload 兼容迁移;
- 验证历史 Run/Step/Attempt/Checkpoint ownership;
- 将旧单列主键表重建为 Run-scoped composite key;
- 写入 schema version;
- 原子 commit。
如果发现孤立 Step、跨 Run Attempt、缺失 Checkpoint payload、未知 schema version 或不支持的主键布局,迁移抛 RunStoreIntegrityError 并整体 rollback。 对确实需要从旧单列主键重建的 identity 表,若发现自定义列、非主键 index、 trigger 或 hidden/generated column,也会拒绝内置迁移。它不会:
- 从 output 猜一个缺失 Step;
- 借用另一个 Run 的 Attempt;
- 删除损坏记录后继续;
- 假装历史执行成功;
- decode/re-encode 与 identity 修复无关的 payload bytes。
设计决策: 数据迁移的职责是保持已有证据,不是制造不存在的历史。完整的 兼容性与运维边界见 docs/run-store-compatibility.md。
6.7 SQLite 参考实现的明确非目标
SQLiteRunStore 不提供:
- 后台扫描与自动恢复;
- queue、scheduler 或 worker service;
- 跨外部系统事务;
- exactly-once Tool effect;
- 通用密钥管理;
- 多租户授权边界;
- 任意部署规模下的通用生产后端保证。
它提供的是一个适用于本地和单服务场景、支持跨进程恢复的参考 Run Store,并用 真实 SQLite 事务验证版本、Lease、身份归属、Checkpoint 落盘和 Model 预算预留 等持久化不变量。更换 Store 实现时,不能只复制方法签名;还必须保持这些行为 契约。
第 7 章:resume_run 从事实重建执行位置
resume_run() 不是“再次调用 start”,也不是“寻找最后一条日志”。它先读取 Run 状态,再根据权威 Step、Attempt 和 Checkpoint 重建执行位置。公开入口见 Runner.resume_run。
7.1 第一层决策:Run 当前是什么状态
入口分支可以先压缩为一棵树:
图解结构源稿
flowchart TD
    Start[resume_run(run_id)] --> Load[load authoritative RunRecord]
    Load --> Terminal{terminal?}
    Terminal -->|yes| Reject[IllegalRunTransitionError]
    Terminal -->|no| Waiting{WAITING?}

    Waiting -->|yes| DefWait{reason = DEFINITION_UNAVAILABLE?}
    DefWait -->|no| ReturnWaiting[return unchanged WAITING]
    DefWait -->|yes| ResolveOld{exact definition available?}
    ResolveOld -->|no| ReturnWaiting
    ResolveOld -->|yes| Acquire1[acquire lease + contract guard]
    Acquire1 --> ToRunning[WAITING -> RUNNING]
    ToRunning --> ResumeFacts[_resume_running]

    Waiting -->|no| Created{CREATED?}
    Created -->|yes| Acquire2[acquire lease]
    Acquire2 --> ExactCreated{exact definition available?}
    ExactCreated -->|no| WaitDefinition[WAITING DEFINITION_UNAVAILABLE]
    ExactCreated -->|yes| StartPath[_start_with_lease]

    Created -->|no: RUNNING| GuardIfAvailable[guard exact definition if available]
    GuardIfAvailable --> Acquire3[acquire or take over lease]
    Acquire3 --> ResumeFacts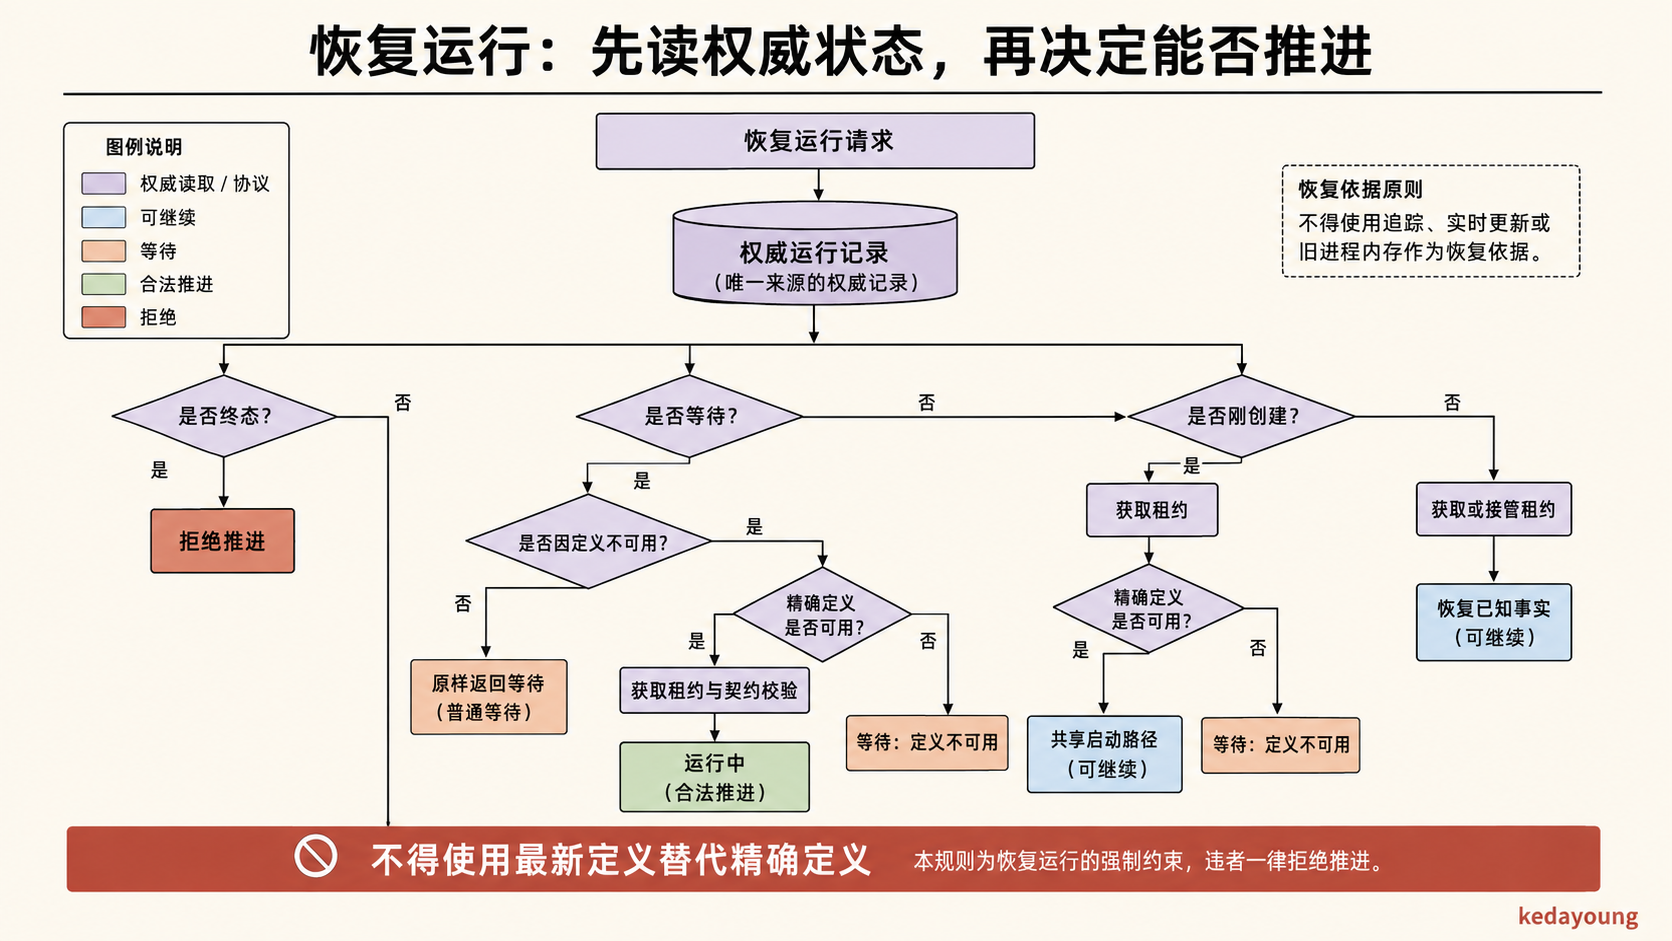
图 M07:resume_run 先分流,再重建执行位置;重复调用不能绕过普通 WAITING。
几个分支值得单独解释。
终态拒绝恢复。 SUCCEEDED、REJECTED、FAILED、CANCELLED 都不接受 再次推进。终态不是“当前没有工作”,而是生命周期结论。
普通 WAITING 原样返回。 UNCERTAIN_NON_IDEMPOTENT 和 POLICY_RESOLUTION_REQUIRED:* 都需要显式应用命令。重复调用 resume_run() 不会绕过等待原因。
DEFINITION_UNAVAILABLE 是特殊 WAITING。 精确旧 Definition 仍不存在时, 方法原样返回,甚至不获取 Lease;旧版本重新注册后,才允许 WAITING -> RUNNING 并进入普通恢复。
CREATED 走共享启动路径。 这使“创建后、启动前崩溃”的恢复等价于首次 start。但与直接 start_run() 不同,恢复发现旧 Definition 缺失时会进入 WAITING,而不是把它当作调用参数错误抛出。
RUNNING 先接管 Lease。 进程崩溃不会自动把 Run 改成 FAILED。新的 Runner 必须等旧 Lease 过期,或证明自己是同 owner 续约,才能进入 _resume_running()。
7.2 第二层决策:读取全部权威证据
_resume_running() 一开始读取:
checkpoints = await self._store.get_checkpoints(run.run_id)
model_checkpoints = [
    c for c in checkpoints if c.step_type is StepType.MODEL
]
tool_checkpoints = [
    c for c in checkpoints if c.step_type is StepType.TOOL
]
persisted_steps = await self._store.get_steps(run.run_id)
persisted_attempts = await self._store.get_attempts(run.run_id)它没有读取 Trace,也没有读取 Run Update 历史,更不会问旧进程“执行到哪里”。 旧进程已经不存在,内存状态不具备恢复价值。恢复算法只承认 Store 中已经提交 的事实。
接下来它先处理 policy-held Tool Outcome、未确认的 Model reservation 和已经 失败的 Model Step,再重建或复用 RUN_INPUT Context Stage。若 compression reservation 未确认,则按 CONTEXT_COMPRESSION purpose 重放;若 compression Checkpoint 已存在,则不会把它当成业务 Model 响应,而是在后续 Context Frame 聚合时重新校验并应用。最后才根据业务 Model Checkpoint 决定完成最终输出、恢复 Tool Calls,或重新进入 Model 循环。
这个顺序不是偶然。例如在恢复业务 Model Checkpoint 之前,必须先处理未确认 Model reservation,否则一个旧的 RUNNING Attempt 可能被遗漏;在重放 Context Provider 之前,必须先看是否已有 Context Checkpoint,否则外部数据变化会改写 同一 Run 的输入事实。
7.3 未确认 Model Attempt:保留预算,再决定是否重放
Model Attempt 在 dispatch 前已经 reservation。如果某个 Attempt 没有对应 Checkpoint,Runner 不能确定 provider 是否收到请求、是否完成推理、响应是否 只是在返回途中丢失。
恢复先构造所有 Model Checkpoint 的 attempt_id 集合,再寻找没有 Checkpoint 覆盖的最新 Attempt。若同一 Step 已经有更新 Attempt 产生 Checkpoint,旧的未 确认 reservation 不会推翻更新的完整结果。
找到真正的 in-flight Attempt 后,Runner 将其规范化为:
status         = FAILED
classification = UNCERTAIN
error_code     = model_checkpoint_unconfirmed
然后根据冻结 Retry Policy 和该 Step 已持久化的 Attempt 数决定:
- 仍有 retry authority:保持同一
step_id,创建新attempt_id重放; - 已无 authority:记录 FAILED Step,Run 进入
FAILED; - 无 Retry Policy:不自动重放。
这段逻辑位于 src/m_agent/_runner.py。
这里要避免一个常见误读:Model 的 UNCERTAIN 与非幂等 Tool 的 UNCERTAIN 后果不同。模型调用可能产生费用或供应商侧记录,但它不直接被 Runtime 当作业务外部副作用;M-Agent 在冻结预算允许时采用有界 at-least-once 重放。非幂等 Tool 则可能改变订单、付款、通知等业务状态,默认必须停下。
7.4 Context Checkpoint:冻结“这次 Run 看见了什么”
恢复依据 Snapshot 中冻结的 Context Plan。对每个 RUN_INPUT Stage:
- 已存在与
stage_id、scope和当前boundary完全匹配的 Checkpoint:
复用完整 ContextStageResult;
- 没有匹配证据:在精确定义仍提供该 Stage 所需能力时重新执行;
- 对旧版隐式 legacy Provider,
has_context_provider继续控制兼容路径; - Snapshot 声明 Provider,而精确注册的 Definition 缺少它:fail closed。
仓库测试 test_second_process_reuses_context_items_without_provider_call 让第一进程在 Context Checkpoint 后、Model Step 前退出。第二进程的 Provider 调用数为零,Model 收到的仍是 Checkpoint 中原始的 item_id、content、 source 和 metadata。相对地, test_crash_before_context_checkpoint_reinvokes_provider 证明 Checkpoint 前崩溃会再次读取 Provider,模型能看到第二次读取时已经变化的 外部内容。
这是一条重要语义:
Context Checkpoint 冻结的是“该 Run 已确认观察到的外部上下文”,不是给 Provider 做通用缓存。
7.5 Model Checkpoint:完整响应是恢复锚点
在排除并处理未确认 Model Attempt 后,如果没有业务 Model Checkpoint,Runner 才回到 _run_agent_loop();若存在未确认 reservation,则先保留其预算消耗, 并依据冻结 Retry Policy 决定同一 step_id 的新 Attempt 重放或终止失败。若 存在业务 Checkpoint,Runner 反序列化最后一个完整 ModelResponse:
- 没有
tool_calls:重新执行FINAL_OUTPUTPolicy 与 Output Contract,
验证通过才提交 SUCCEEDED;验证失败则进入 Output Repair 或 FAILED;
- 有
tool_calls:重建已确认 Tool Outcomes,从第一个缺失调用继续。
为什么已经 Checkpoint 的最终响应还要再次通过 FINAL_OUTPUT?因为崩溃可能 发生在 Model Checkpoint 之后、Run SUCCEEDED 状态提交之前。Checkpoint 证明 模型完整返回,不证明最终 Policy 和 Output Contract 已经完成。恢复必须重走 尚未形成权威终态的后半段。
7.6 Tool Checkpoint:按 call_id 重建完成前缀
Runner 将所有 Tool Checkpoint 反序列化为 prior_outcomes,再按最后一个 ModelResponse 的 tool_calls 原顺序扫描:
以下源码节选省略了缺失调用的 Effect/Retry 分支主体:
confirmed_call_ids = {o.call_id for o in prior_outcomes}
for call in last_response.tool_calls:
    if call.call_id in confirmed_call_ids:
        continue
# 省略:按 frozen ToolEffect 进入 replay、WAITING 或 fail-closed实现会跳过 call_id 已在确认集合中的调用。对第一个缺失 Outcome,Runner 先依据冻结 ToolEffect 和是否存在 in-flight Step/Attempt 选择 WAITING 或恢复重放路径。 可重放的旧 Attempt 会先保留不确定失败证据,再由 _run_tool_step(recovery_replay=True) 按冻结 Retry Policy 和已用 Attempt 数 决定是否创建新 Attempt。后续尚未 dispatch 的调用使用全新的 Step/Attempt identity。
作者推断: 在“同一 Model Response 的 Tool Calls 严格串行、每个完成调用 先写 Checkpoint”的不变量成立时,按 call_id 跳过已确认调用,等价于从第一 个缺失调用继续。代码使用的是已确认 ID 集合,并不显式计算或验证“最长前缀”; 串行协议使两者在正常历史中得到相同结果。
实现限制: 这里还有两个不能由时序图代替核验的前提:
confirmed_call_ids汇总的是整个 Run 的 Tool Checkpoints,判断时没有同时
校验所属 Model Response 或 tool_name。而 ToolCall.call_id 的类型文档只 声明“模型响应内的稳定标识”。因此跨响应重用 ID 时,存在把新调用误认成旧 调用的风险;不能只凭“单个响应内唯一”推导全 Run 恢复正确。这一项是源码 风险判断,本文未补充复现实验。
- in-flight Tool 的识别只选最新的
RUNNINGTool Step,再找该 Step 下最新的
RUNNING Attempt,并非“凡是没有 Checkpoint 的 Tool Step”。工具调用与该 Step 的对应关系依赖串行执行位置,Step/Attempt 本身不保存 call_id。 如果 Tool Step 已提交 SUCCEEDED,但 Checkpoint 尚未提交,该记录不会被 选入此分支;第 12.8 节复现了由此导致的非幂等重复调用。
上述限制对应 inflight_step 筛选、 confirmed_call_ids 判断 以及 ToolCall 字段契约。
7.7 恢复不是 exactly-once
恢复语义可以用一句更精确的话表达:
Checkpoint 之后复用;Checkpoint 之前按 Step 类型、冻结策略和 Effect 分类,以按类型受约束的 at-least-once、WAITING 或失败处理。
它不保证模型、Provider 或外部工具只被调用一次。已确认的完整结果会被复用; 未确认的 Model 和可安全重放的 Tool Step 受冻结 Retry Policy 约束,Model 还受 Execution Budget 约束。Context 缺少 Checkpoint 时走重新读取路径, 当前实现没有用同一套 Retry Policy 限制这条恢复路径;反复中断并恢复时, 不能承诺 Context 总读取次数有相同的硬上限。不确定的非幂等 Tool Effect 转入 WAITING,等待应用显式处置。旧 owner 的迟到写不能覆盖新 owner 的事实,则由第 6 章的 version/Lease mutation guard 保证。
第 8 章:Tool Effect 定义恢复安全性
8.1 Effect 与 Outcome 是两条正交轴
ToolEffect 描述调用对外部状态的影响和重放安全性:
READ_ONLY
IDEMPOTENT
NON_IDEMPOTENT
ToolOutcome 描述一次已完成调用的业务结果:
SUCCESS
REJECTED
两者不能混用,但它们也不是恢复决策的全部信息。失败 Attempt 还带有独立的 TRANSIENT、PERMANENT 或 UNCERTAIN 分类。一个 NON_IDEMPOTENT Tool 可以显式返回 SUCCESS;一个 READ_ONLY Tool 也可能 抛出 TRANSIENT 异常。Effect 描述外部影响及未确认时的重放安全性,Outcome 只描述工具显式完成后的业务结果;未捕获异常不会变成 Outcome,而会作为失败 Attempt 记录,再由失败分类与冻结 Retry Policy 决定后续处理。
Effect 定义见 src/m_agent/_tools.py,Outcome 定义见同文件 的 ToolOutcome。
8.2 默认 Effect 与冻结声明缺失要分开
定义工具时未显式声明 Effect,默认按 NON_IDEMPOTENT 处理;这与恢复时 Snapshot 中缺失声明或同名声明不唯一,是两个不同问题。前者有保守的默认值, 后者意味着无法唯一恢复原 Run 的声明,不能直接补上当前工具的配置。
恢复只读取 Snapshot 中唯一匹配的 Tool Declaration:
declarations = [
    declaration
    for declaration in run.snapshot.tool_declarations
    if declaration.name == tool_name
]
if len(declarations) != 1:
    return None
return declarations[0].effect声明缺失或歧义时,Runner 不读取当前 callable 的 effect 来猜测。因为当前 代码可能已经升级:原 Run 启动时是发送付款,今天同名工具也许改成了查询付款; 反过来也可能从只读变成写操作。恢复必须使用原 Run 冻结的声明。
无法唯一得到冻结 Effect 时,若 Run Store 中存在当前恢复算法识别的 RUNNING Tool Step,Runner 保留这份可能已 dispatch 的证据并进入 WAITING。 它根据串行执行位置将该 Step 对应到第一个缺失 Outcome 的调用,不是通过 Step/Attempt 中的 call_id 字段关联。若没有这样的工具执行证据,就 无法安全确认等待对象,以 FROZEN_TOOL_DECLARATION_UNAVAILABLE fail closed。
8.3 恢复矩阵
图解结构源稿
flowchart TD
    Missing[Model requested ToolCall but no Tool Checkpoint] --> Frozen{unique frozen ToolEffect?}
    Frozen -->|no| Evidence{RUNNING Tool Step?}
    Evidence -->|yes| PreserveWait[WAITING preserving evidence]
    Evidence -->|no| DeclarationFail[FROZEN_TOOL_DECLARATION_UNAVAILABLE]
    Frozen -->|yes| Inflight{RUNNING Tool Step?}
    Inflight -->|no| Fresh[first-dispatch path; see commit-gap caveat]
    Inflight -->|yes| Effect{frozen effect}
    Effect -->|READ_ONLY| Preserve1[preserve old Attempt if still RUNNING]
    Effect -->|IDEMPOTENT| Preserve2[preserve old Attempt if still RUNNING]
    Effect -->|NON_IDEMPOTENT| Wait[WAITING UNCERTAIN_NON_IDEMPOTENT]
    Preserve1 --> Budget1{frozen retry authority remains?}
    Preserve2 --> Budget2{frozen retry authority remains?}
    Budget1 -->|yes| Replay1[new Attempt, same Step, replay]
    Budget2 -->|yes| Replay2[new Attempt, same Step, replay]
    Budget1 -->|no| Fail1[FAILED]
    Budget2 -->|no| Fail2[FAILED]
    Wait --> Resolution[application Resolution]
    Resolution --> Retry[RETRY_STEP]
    Resolution --> Confirm[CONFIRM_STEP]
    Resolution --> FailRun[FAIL_RUN]
    Resolution --> CancelRun[CANCEL_RUN]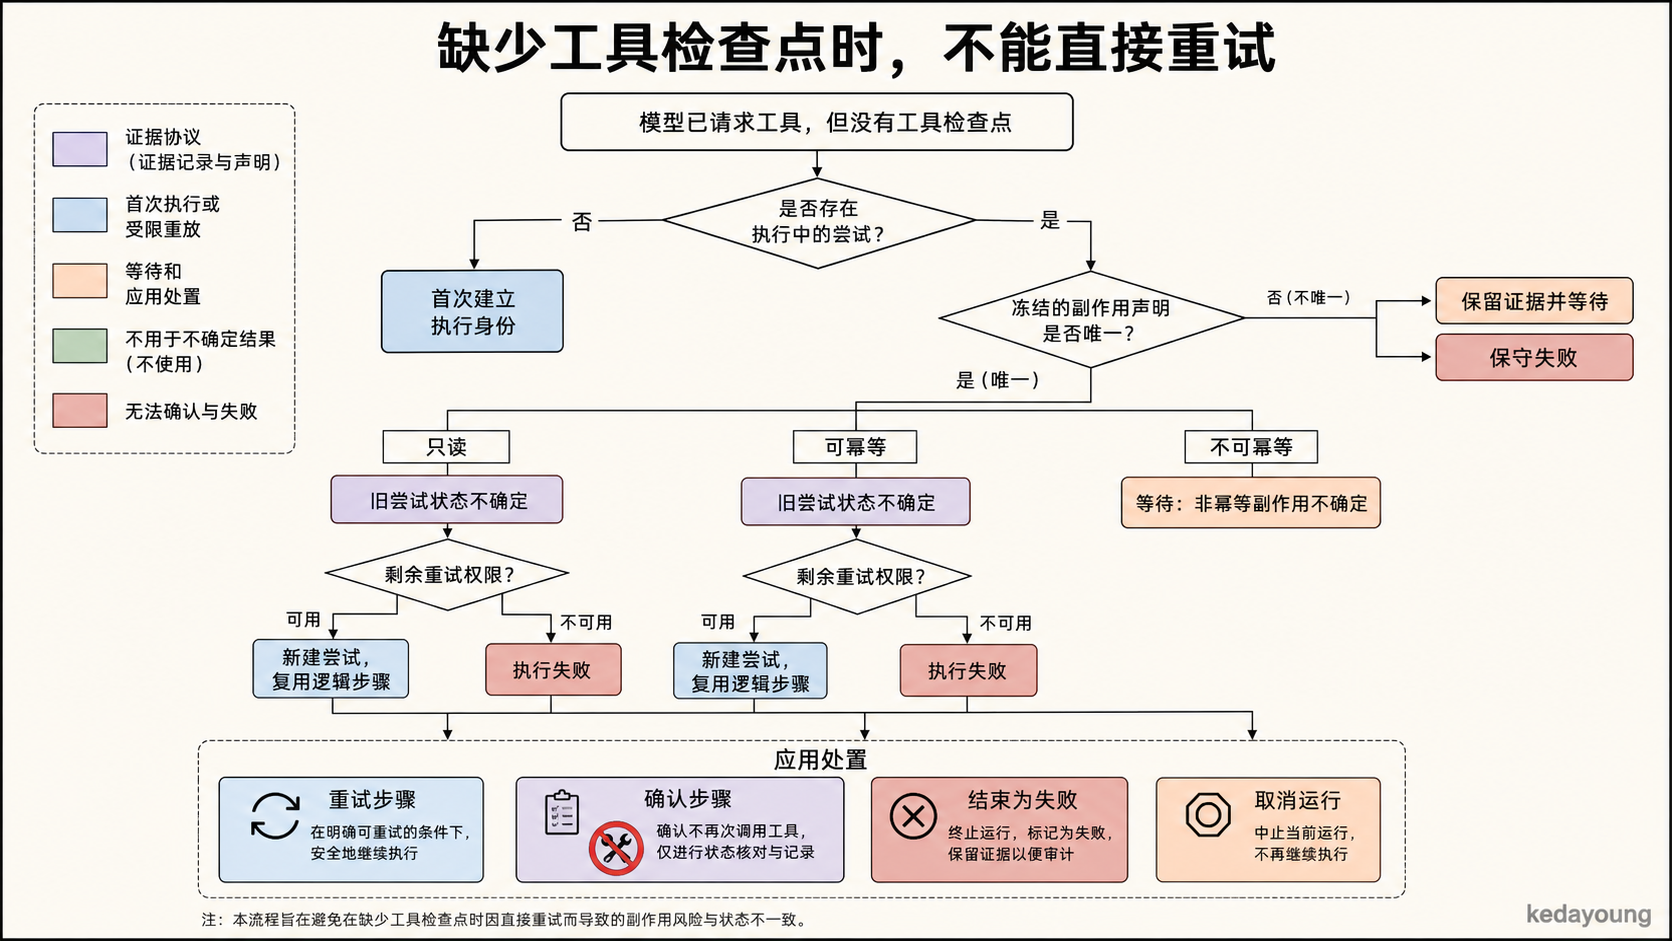
图 M08:Effect 描述重放安全性,冻结策略授予重试权限;两者不能互相替代。
上方 Mermaid 补明了冻结声明检查的先后顺序;PNG 保留原配图,概括的是通常 故障窗口。这里的“无 in-flight”只表示算法未找到 RUNNING Tool Step,不足以 证明工具从未执行;它遗漏成功状态先于 Checkpoint 提交的窗口,见第 12.8 节。 此外,有 RUNNING Step 但没有 RUNNING Attempt 时,源码不会启用 recovery_replay=True,不能简单等同于已有 Attempt 的有界恢复重放。
对于 READ_ONLY 和 IDEMPOTENT,恢复仍需要冻结 Retry Policy 的授权。 “Effect 安全”不等于“无限重试”。被中断的 Attempt 已经计入同一 Step 的 Attempt 数,新的 replay 使用新 attempt_id。
这张矩阵只描述“调用可能已经 dispatch,但 Tool Checkpoint 尚未提交”的恢复 情形,不表示所有 UNCERTAIN 失败都能自动重试。正常执行中的自动重试仍要求 失败分类为 TRANSIENT 且冻结 Retry Policy 允许;UNCERTAIN 不会仅因工具是 READ_ONLY 就被转换成 TRANSIENT。
对于 NON_IDEMPOTENT,存在 in-flight Step 且没有 Checkpoint 时,Runner 直接进入 WAITING,不调用工具。原 Attempt 被记录或保留为 UNCERTAIN/effect_unconfirmed,目标 step_id 写入 waiting_step_id。
8.4 幂等性通常必须在外部系统实现
M-Agent 的 IDEMPOTENT 声明不是魔法。工具本身必须把稳定业务 identity 传给外部系统,例如:
ticket_id + normalized update;- payment intent ID;
- notification request ID;
- object version + mutation ID;
- 外部系统原生 idempotency key。
旗舰示例中的 ticket update 使用独立 JSONL ledger、文件锁、read-before-write、 flush 和 fsync。第一进程在外部更新后、Checkpoint 前崩溃,第二进程可以 重放工具;外部 ledger 对稳定 identity 做原子去重,保存首次结果,并在后续 相同请求中返回该结果。测试见 tests/test_durable_support_agent_idempotency.py。
这说明:
Runtime at-least-once dispatch
        +
External atomic idempotency constraint
        =
One effective business mutation in that specific integration
这个等式还要求工具每次都传入同一稳定 identity,且外部系统能持久化并复用 首次结果。它是该工具与外部系统协作后的集成级性质,不是 M-Agent 对任意外部 系统提供的 exactly-once,也不是 IDEMPOTENT 声明单独提供的保证。
8.5 非幂等通知为什么必须 WAITING
假设通知工具没有外部幂等键:
12:00:00.100  Store: Tool Attempt RUNNING
12:00:00.210  Provider: notification accepted
12:00:00.220  Process: exits
12:00:00.230  Store: no Tool Checkpoint
Run Store 能证明 dispatch identity 存在,却不能证明 provider 是否接受通知。 再次调用可能重复发送;直接失败可能掩盖已发送;直接成功又缺少结果证据。 WAITING 不表示通知已发送,也不表示通知未发送;它只表示 Runtime 无法从自身 持久化证据判定外部效果。该状态保留不确定性,并把确认、重试、失败或取消的 责任交给上层应用。
动画 A03:非幂等效果的查证与确认(12 秒)
播放 / 下载 MP4 · 结论静帧 · 手机竖版图
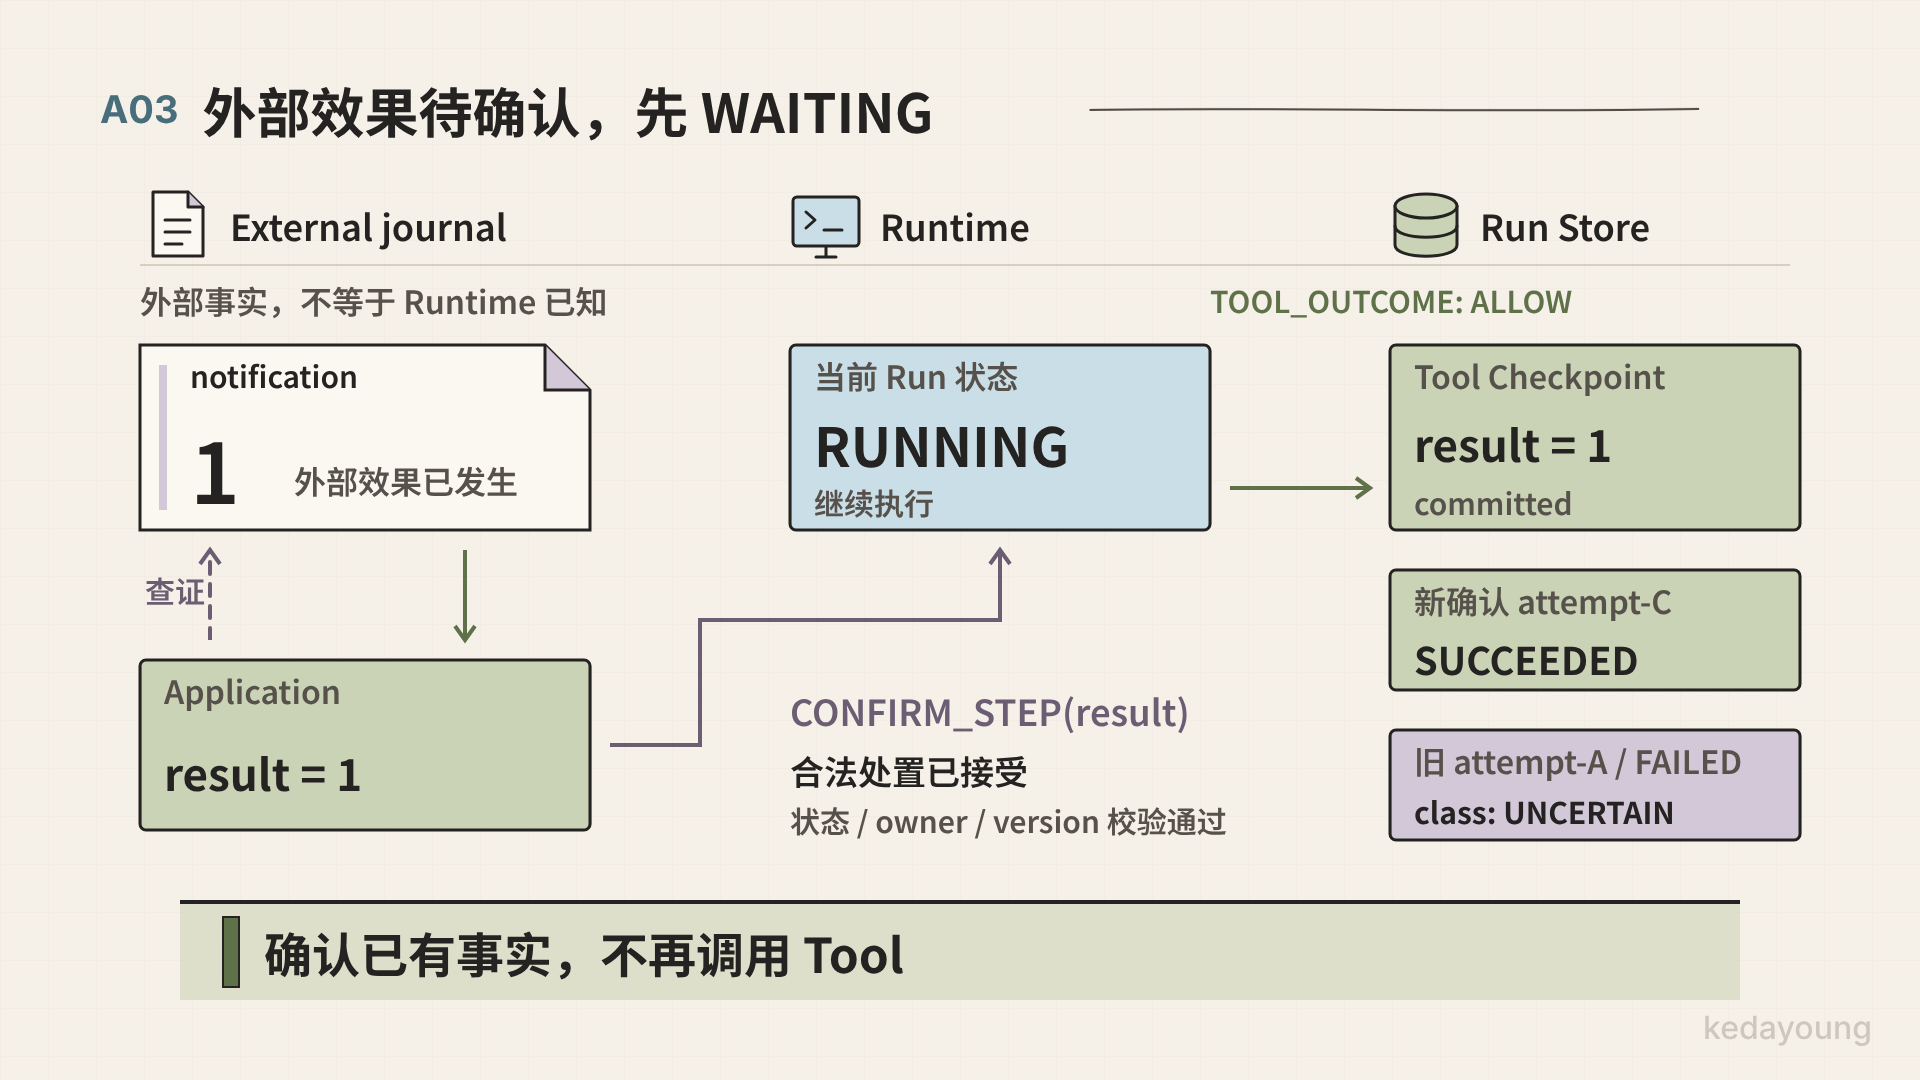
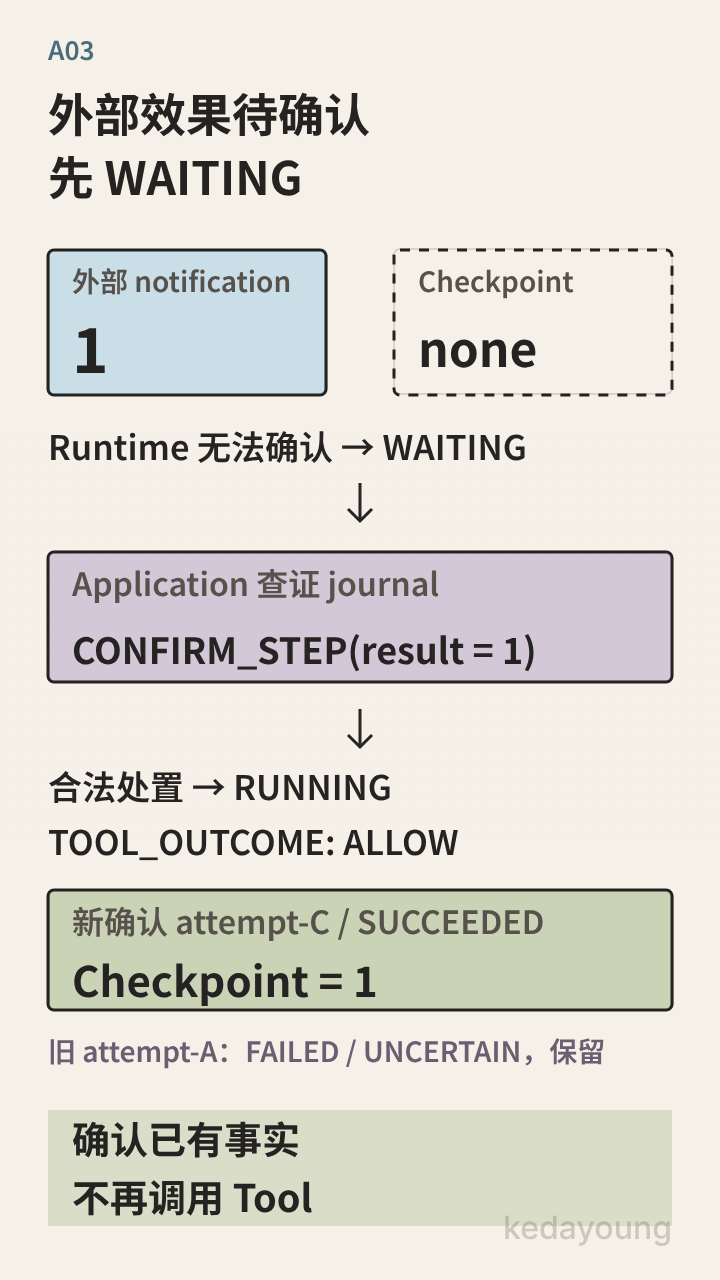
应用查询独立外部证据,再提交 CONFIRM_STEP。确认路径仍经过 TOOL_OUTCOME Policy,并保留旧 Attempt 的不确定历史;通知计数始终为 1。
第 9 章:resolve_run 把不可知事实交回应用
9.1 Resolution 是控制命令,不是模型输出
RunResolution 只出现在 Runner.resolve_run() 的公开应用控制入口。 ModelRequest、ModelResponse、Context Item 和 Tool Outcome 中都没有 Resolution 通道。模型不能决定“这次付款应该视为成功”。
对 UNCERTAIN_NON_IDEMPOTENT,resolve_run() 允许四种处置动作:
| Action | 应用表达的判断 | Runtime 行为 |
|---|---|---|
RETRY_STEP | 已核实重复执行安全 | 同一 Step,新 Attempt,再调用 Tool |
CONFIRM_STEP(result) | 已核实外部效果发生 | 不调用 Tool,写确认 Outcome Checkpoint |
FAIL_RUN(reason) | 无法安全恢复,应作为失败结束 | 直接 FAILED |
CANCEL_RUN(reason) | 应用放弃这次 Run | 直接 CANCELLED |
ResolutionAction 还包含 CONTINUE_RUN,但它只适用于 Policy WAITING, 不是不确定 Tool Effect 的第五种处置方式。DEFINITION_UNAVAILABLE 只允许 FAIL_RUN、CANCEL_RUN,因为没有待重试或确认的 Tool Step。Policy WAITING 则允许 CONTINUE_RUN、FAIL_RUN、CANCEL_RUN。合法集合由 allowed_resolutions 统一计算。
FAIL_RUN(reason) 和 CANCEL_RUN(reason) 的 reason 只是本次命令的可选 说明,当前版本不会把它写入 Run Store。需要审计理由的上层应用必须自行保存 操作者、观察版本、提交时间和命令内容。
9.2 命令先在 Lease 外校验,再在 Lease 内重验
resolve_run() 的校验顺序是:
load Run
-> must be WAITING
-> action allowed for current waiting_reason
-> optional waiting_step_id must match
-> CONFIRM_STEP requires result
-> expected_version must match
-> continuing action requires exact Definition
-> acquire Lease
-> reload authoritative Run
-> repeat state/action/target/version validation
-> execute command为什么获取 Lease 后还要重新读取?因为第一次检查与 Lease acquisition 之间, 另一个应用实例可能已经完成 Resolution。若不重验,旧命令可能基于过期 WAITING 事实覆盖新状态。
expected_version 是调用方观察版本的显式条件。它使“我确认的是刚才看到的 那个等待状态”成为机器可检查的前提。若命令在 Lease 获取前就发现版本过期, Run、Step、Attempt、Checkpoint 和外部系统都不会改变;若已经获取 Lease, 随后在 Lease 内重验才发现过期,Runtime 会释放本次 Lease,但仍不会执行 Resolution 对应的业务写入或工具调用。Lease 获取/释放是并发控制元数据,不应 与业务历史混为一谈。
9.3 CONFIRM_STEP 不执行工具
CONFIRM_STEP(result) 要求提供非空字符串结果(入口使用 not resolution.result 拒绝 None 或空字符串),并表示应用已经确认目标外部效果发生。 它不能注入任意 Outcome,也不能提交 REJECTED;确认路径先保存 waiting_step_id,再将 WAITING -> RUNNING,固定构造 ToolOutcome.SUCCESS:
outcome = ToolOutcome.success(
    target_call.call_id,
    target_call.tool_name,
    result=resolution.result,
)
run = await self._enforce_policy(
    run,
    definition,
    lease,
    PolicyGate.TOOL_OUTCOME,
    {
        "tool_name": outcome.tool_name,
        "call_id": outcome.call_id,
        "status": outcome.status.value,
        "confirmed_by_application": True,
    },
)
if run.status is not RunStatus.RUNNING:
    return run
await self._checkpoint_tool_outcome(
    run, lease, target_step_id, outcome
)
摘自 Runner._resolve_uncertain_continue。
确认结果仍需通过 TOOL_OUTCOME Policy Gate。随后复用普通 _checkpoint_tool_outcome(),产生与真实 Tool 返回相同形状的 SUCCEEDED Step、Attempt 和 Checkpoint,再把全部 Tool Outcomes 交给下一 Model Step。
仓库测试 test_sqlite_confirm_after_crash_completes_run 用外部 journal 证明:崩溃前通知次数是 1,恢复 WAITING 后仍是 1, CONFIRM_STEP 完成 Run 后仍是 1。
9.4 RETRY_STEP 是显式承担风险
RETRY_STEP 将同一个 waiting_step_id 传回 _run_tool_step(),并设置 explicit_resolution=True。Runner 创建新 Attempt,再执行 Tool。旧 Attempt 不会被覆盖。
这并不是 Runtime 判断工具变得幂等,而是应用已经基于 Runtime 无法访问的外部 证据作出决定。例如应用可能查到供应商根本没有收到请求,或者业务人员批准 重复发送。Resolution 将这项责任清晰留在应用边界。
9.5 FAIL 与 CANCEL 都不改写历史
FAIL_RUN 和 CANCEL_RUN 共用 _terminate_run():只转换 Run 状态并释放 Lease,不调用工具,也不会删除不确定 Attempt。两者表达不同业务结论:
FAILED:这次执行无法完成;CANCELLED:应用选择放弃继续执行。
它们都不表示外部副作用被回滚。历史 Attempt 仍然保留为检查证据。 传入的 reason 不会写入当前 Run Store schema;需要保留处置理由时,由应用 另行审计。
第 10 章:取消、Streaming 与非权威更新
10.1 RunUpdate 只服务实时呈现
应用通过 subscribe_run(run_id) 获取 live-only RunUpdate:
STATUS_CHANGED
STEP_STARTED
MODEL_DELTA
ATTEMPT_FAILED
STEP_COMPLETED
RunUpdate 整体是 live-only、可丢失的通知流,不是恢复权威来源。Step 级 Update 带 run_id、step_id 和 attempt_id;其中 STEP_COMPLETED 表示 Runner 已完成该 Step 的 Checkpoint 写入,但这条通知本身仍可能丢失。 订阅不回放历史,断线或需要核实时必须通过 get_run() 或 inspect_run() 读取 Run Store。
订阅者退出、消费失败或处理缓慢只影响自己的队列,不改变 Run。Runtime 不在 这里实现 SSE、WebSocket 或持久事件总线;上层应用可以把纯数据 Update 映射到 自己的传输层。
10.2 流式 delta 为什么不能 Checkpoint
流式 Model Adapter 可能依次产生:
下列内容是事件形状示意,不是项目源码的逐字摘录:
ModelDelta("A")
ModelDelta("B")
ModelDelta("C")
ModelResponse(content="ABC", ...)
只有 Adapter 显式产出的完整 ModelResponse 可以成为 Checkpoint。Runtime 不会在流结束时自行把 delta 拼成权威响应;如果流没有产出完整响应,该 Attempt 按 Model Contract 失败处理。部分 delta 可能来自最终失败的 Attempt,也可能在 tool call JSON、structured output 或协议帧尚不完整时结束。如果把它们持久化 为恢复结果,第二次 Attempt 的输出可能和第一次部分输出拼接,形成模型从未 返回过的响应。
_stream_model() 对每个 delta 只发布:
RunUpdate(
    run_id=run.run_id,
    update_type=RunUpdateType.MODEL_DELTA,
    step_id=step_id,
    attempt_id=attempt_id,
    step_type=StepType.MODEL,
    content=event.content,
)
见 Runner._stream_model。流结束后,完整 ModelResponse 返回给普通 Model Step 成功路径,再写 Step/Attempt/Checkpoint。
10.3 Attempt replacement 是 UI 必须理解的协议
图解结构源稿
sequenceDiagram
    autonumber
    participant R as Runner
    participant U as Update Consumer
    participant S as Run Store
    participant M as Model Adapter

    R->>U: STEP_STARTED(step-1, attempt-A)
    R->>M: stream attempt-A
    M-->>R: delta A
    R-->>U: MODEL_DELTA(attempt-A, A)
    M-->>R: delta B
    R-->>U: MODEL_DELTA(attempt-A, B)
    M-xR: TRANSIENT failure
    R->>S: Attempt-A FAILED
    R-->>U: ATTEMPT_FAILED(attempt-A)

    R->>U: STEP_STARTED(step-1, attempt-B)
    R->>M: stream attempt-B
    M-->>R: delta A, B, C
    R-->>U: MODEL_DELTA(attempt-B, A/B/C)
    M-->>R: complete ModelResponse ABC
    R->>S: Attempt-B SUCCEEDED + Checkpoint ABC
    R-->>U: STEP_COMPLETED(attempt-B)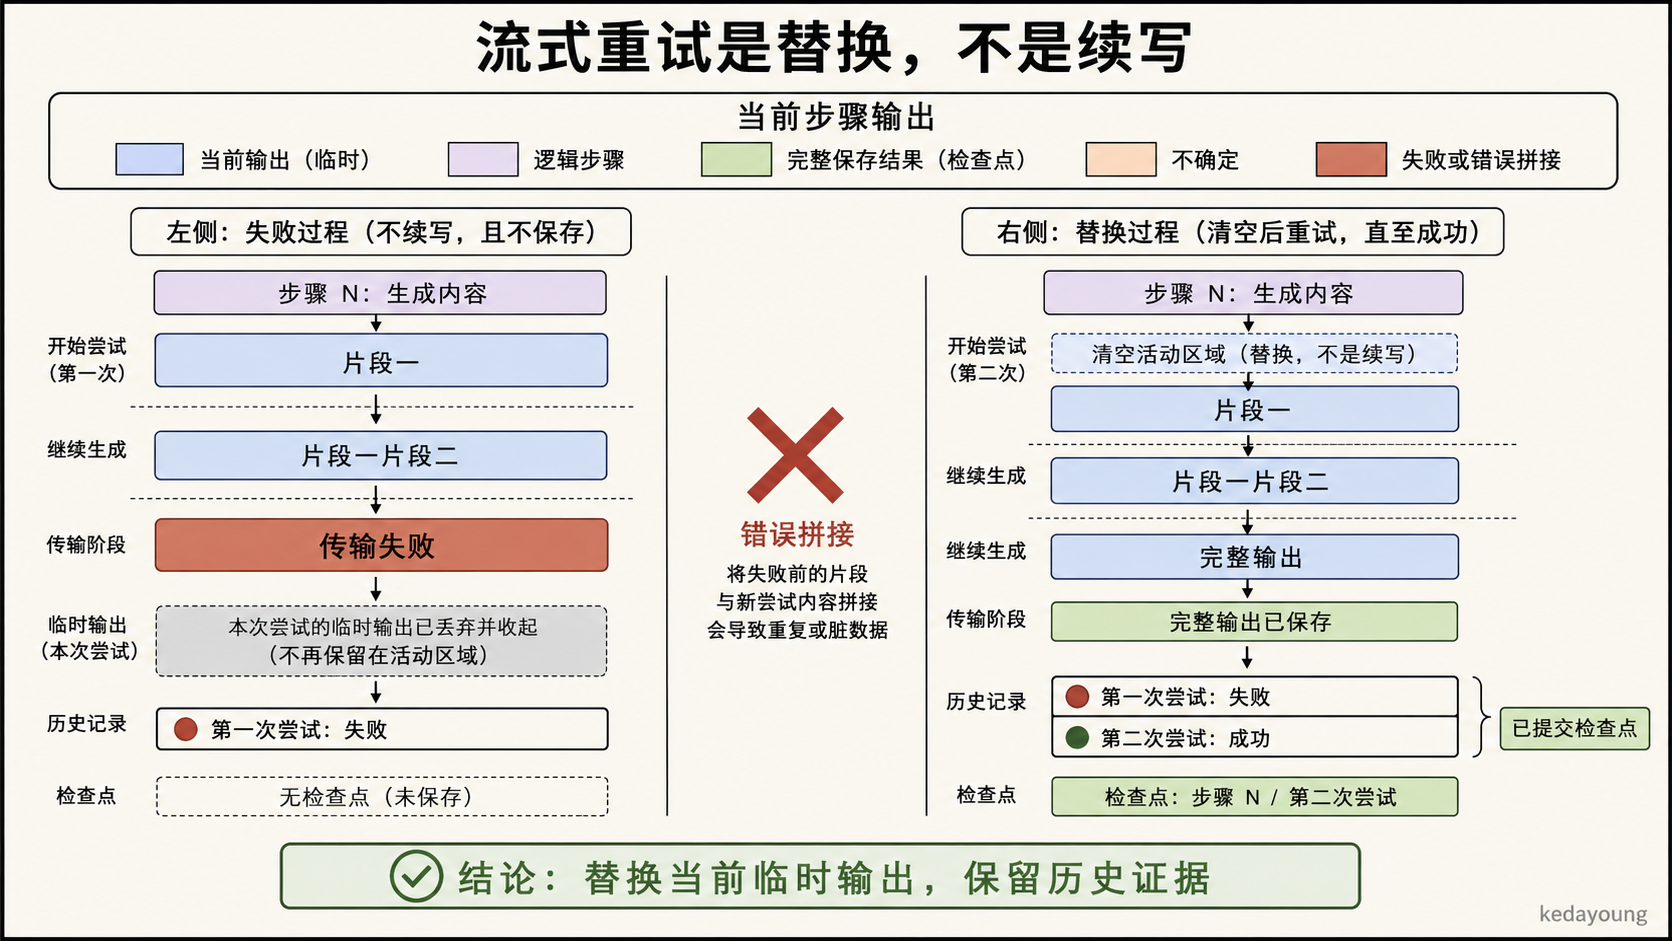
图 M09:UI 替换的是活动 Attempt 的临时文本,Store 保留的是不同 Attempt 的执行证据。
消费者应该按 attempt_id 分组显示。收到同一 step_id 的新 STEP_STARTED 时,可以在界面上用新 Attempt 的临时输出替换旧 Attempt,而 不是追加;这不表示删除或覆盖旧历史。旧 Attempt 的 FAILED 状态以及可能的 UNCERTAIN 失败分类仍保留在 Run Store,权威最终内容只来自成功 Attempt 的 完整 Checkpoint。
测试 test_partial_stream_retry_new_attempt_replaces_output 构造 Attempt A 输出 A, B 后失败,Attempt B 输出 A, B, C 后成功。最终 Run output 是 ABC,只有 Attempt B 有 Checkpoint,Attempt A 的部分输出没有 进入 Store。
动画 A04:Streaming Attempt 替换(9 秒)
播放 / 下载 MP4 · 结论静帧 · 手机竖版图
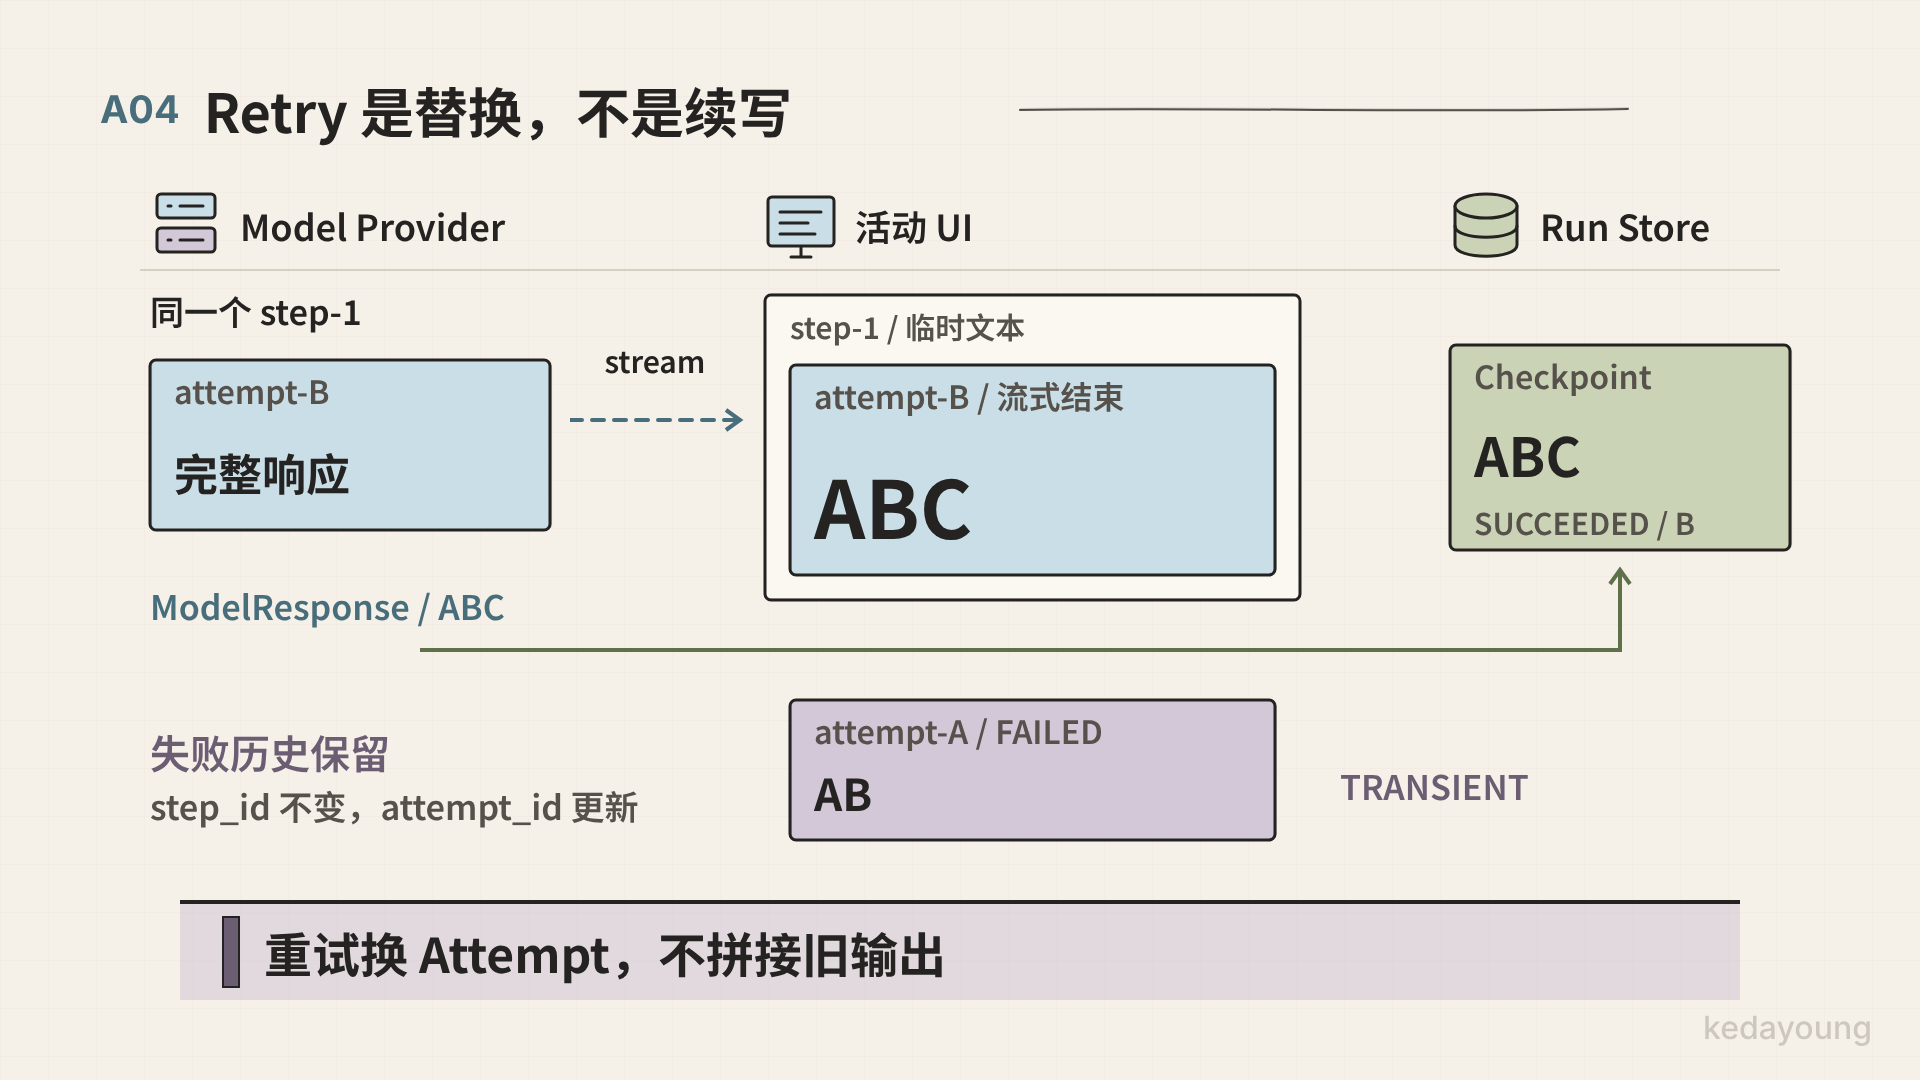
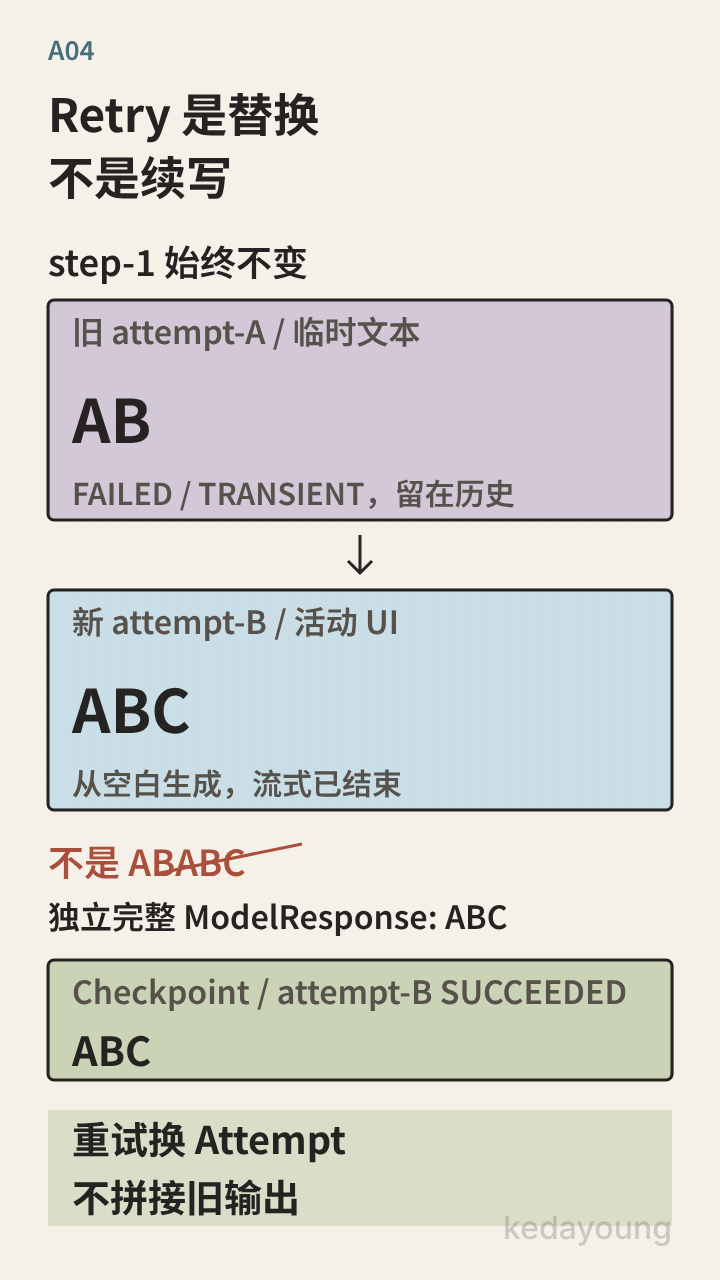
新的 Attempt 从空白开始,旧的 AB 留在对应历史中,不拼成 ABABC。 动画将完整 ModelResponse 与 UI delta 分开展示;后续 Checkpoint 只接受完整响应。
10.4 Cancellation Request 不等于 CANCELLED
cancel_run() 表达停止继续推进的意图,不承诺强杀已发出的调用。不同状态的 行为不同:
| 当前状态 | 行为 |
|---|---|
CREATED 且没有并发启动 | 取得 Lease 后直接 CANCELLED,零外部调用 |
WAITING | 转为 resolve_run(CANCEL_RUN) |
RUNNING 且本 Runner 有活跃推进循环 | 设置进程内 cancellation event |
RUNNING 但本 Runner 不掌握推进循环 | 拒绝,不能凭 Lease 过期猜测安全 |
| 终态 | IllegalRunTransitionError |
取消事件由 asyncio.Event 保存,只能被同一个 Runner 实例中的推进循环看到。 跨进程取消消息、持久命令总线和 worker 协调属于上层应用。
CREATED 若已被并发启动者占用,不能套用第一行的零调用结论。同实例已有 活跃推进循环时会登记本地事件;其他实例持有 Lease 时,当前实现的冲突分支 也只登记本实例事件并返回记录,不能据此保证另一个实例会响应取消。 RUNNING 且没有本地推进循环则在获取 Lease 前直接抛出 LeaseNotHeldError。见 cancel_run() 的分支顺序。
对正在本 Runner 中推进的 RUNNING Run,cancel_run() 只是登记取消事件并 返回当前记录;返回时 Run 仍可能是 RUNNING。推进循环随后在安全边界观察该 事件,才把 Run 转为 CANCELLED。应用不能把取消请求登记成功等同于终态已经 持久化。
10.5 安全边界
推进循环在这些位置调用 _maybe_cancel():
- 新 Context/Model/Tool Attempt 前;
- Model Checkpoint 后、开始 Tool 前;
- 每个 Tool Step 前;
- 流式 delta 之间;
- 已 dispatch 调用返回,并完成 Outcome 或失败记录之后。
_maybe_cancel() 在安全边界将 Run 转为 CANCELLED、释放 Lease、清除事件并 发布状态。见 src/m_agent/_runner.py。
普通 Model 或 Tool 调用一旦发出,取消不会强杀它们。调用返回后,Runner 先按 事实记录 Outcome 或失败,再阻止后续 Step。测试 test_cancel_between_steps_blocks_next_step 证明 Tool 仍完整执行并 Checkpoint,而下一 Model Step 从未启动。
Streaming 是少数可以在 delta 间协作关闭的调用。_stream_model() 在看到取消 后返回 None,并在 finally 中调用 async generator 的 aclose(),让 Adapter 执行清理。这是尽力中断,不是假装强杀 provider。未完成响应不会 Checkpoint, 对应 Attempt/Step 记录为失败,Run 再进入 CANCELLED。
10.6 取消不能覆盖不确定副作用
如果取消恰好在 NON_IDEMPOTENT Tool in-flight 时到达,而工具以 UNCERTAIN 结束,Runner 优先进入 WAITING(UNCERTAIN_NON_IDEMPOTENT),并清除 cancellation event。否则 CANCELLED 会让应用误以为副作用没有发生。
这是“状态诚实性”高于“取消请求即时满足”的例子。Cancellation Request 是意图; Run Status 是基于证据得出的结论,两者不能强行等同。
第 11 章:Lease、乐观版本与接管
11.1 两种并发问题,需要两种机制
Lease 和 Run version 解决不同问题:
- Lease:当前谁有权继续发起新外部调用和提交 Runner mutation;
- version:调用方的命令是否基于最新 Run 生命周期事实。
只有 Lease 没有 version,旧客户端仍可能基于过期 WAITING 状态提交 Resolution。 只有 version 没有 Lease,两个 Runner 可能在同一版本上同时 dispatch 外部 调用,再由一个写入获胜。两者组合才能同时约束“谁能推进”和“基于什么事实 推进”。
11.2 Dispatch guard 与 mutation guard
Runner 的 _assert_step_dispatch() 调用:
await self._store.assert_lease(
    run.run_id,
    expected_version=run.version,
    owner=lease.owner,
)SQLite assert_lease() 检查:
row.version == expected_version
row.lease_owner == owner
lease_expires_at is not None
lease_expires_at > now
它阻止过期 owner 启动新 Step。但仅有 dispatch guard 仍不够:Lease 可能在 外部调用期间过期并被接管,所以成功后的 Step、Attempt、Checkpoint 和状态 mutation 也必须在 Store 的原子条件中重新检查 owner、expiry 和 version。 SQLite adapter 使用带条件的 SQL 实现;其他 Store 必须提供等价失败语义,而 不要求采用 SQL。旧 owner 的迟到提交会得到 LeaseNotHeldError 或 StaleRunVersionError。
11.3 Takeover 时序
图解结构源稿
sequenceDiagram
    autonumber
    participant A as Runner A
    participant S as SQLite Run Store
    participant P as Provider
    participant B as Runner B

    A->>S: acquire lease(owner=A, expected_version=v)
    A->>S: CREATED to RUNNING, version becomes v+1
    A->>S: reserve Attempt-A
    A->>P: dispatch
    Note over A,P: A stalls or process becomes unreachable
    Note over S: lease expires
    B->>S: resume_run + acquire expired lease(owner=B, current_version)
    S-->>B: lease granted
    B->>S: mark Attempt-A UNCERTAIN
    B->>S: reserve Attempt-B
    B->>P: replay if frozen policy permits
    P-->>B: complete response
    B->>S: Checkpoint Attempt-B
    B->>S: Run to SUCCEEDED using current version

    P-->>A: late response
    A->>S: late Checkpoint Attempt-A
    S--xA: reject stale version / lease owner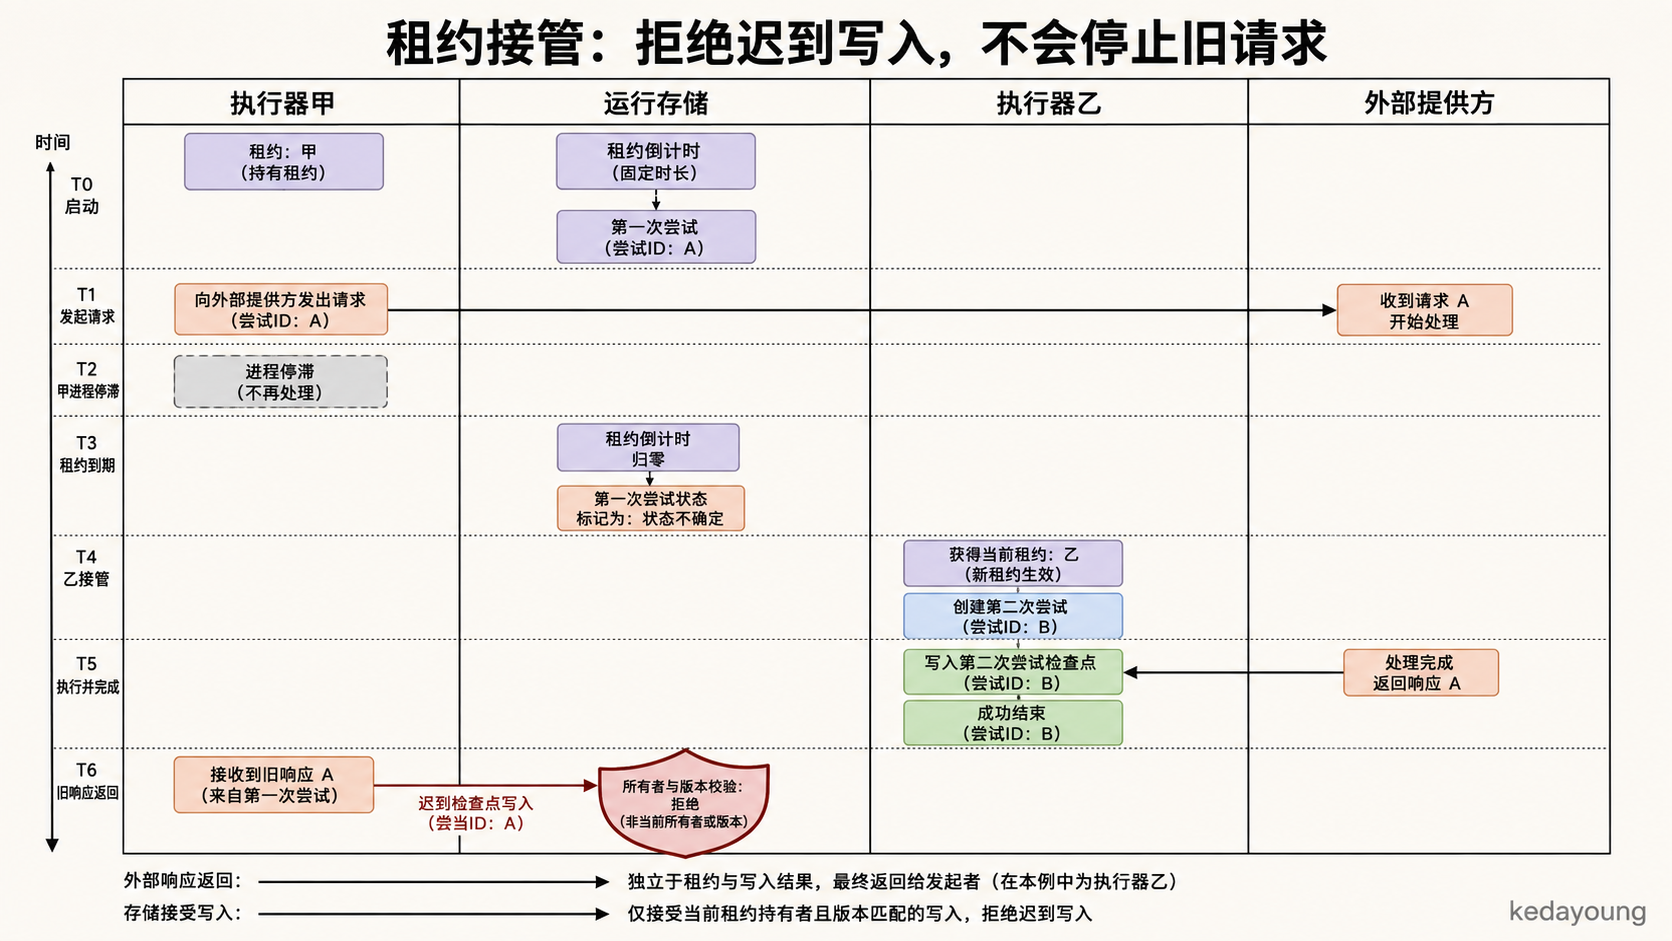
图 M10:Lease 约束推进与提交权限,不负责停止旧进程或撤销外部请求。
这张图展示了一个容易混淆的事实:Lease 过期允许新 owner 接管,但不能阻止旧 外部调用稍后返回。M-Agent 能阻止的是旧 owner 将迟到结果写成权威事实。 外部调用是否会产生重复效果,仍需由 Step 类型、Tool Effect 和幂等协议处理。
动画 A05:Lease 接管与迟到写入拒绝(11 秒)
播放 / 下载 MP4 · 结论静帧 · 手机竖版图
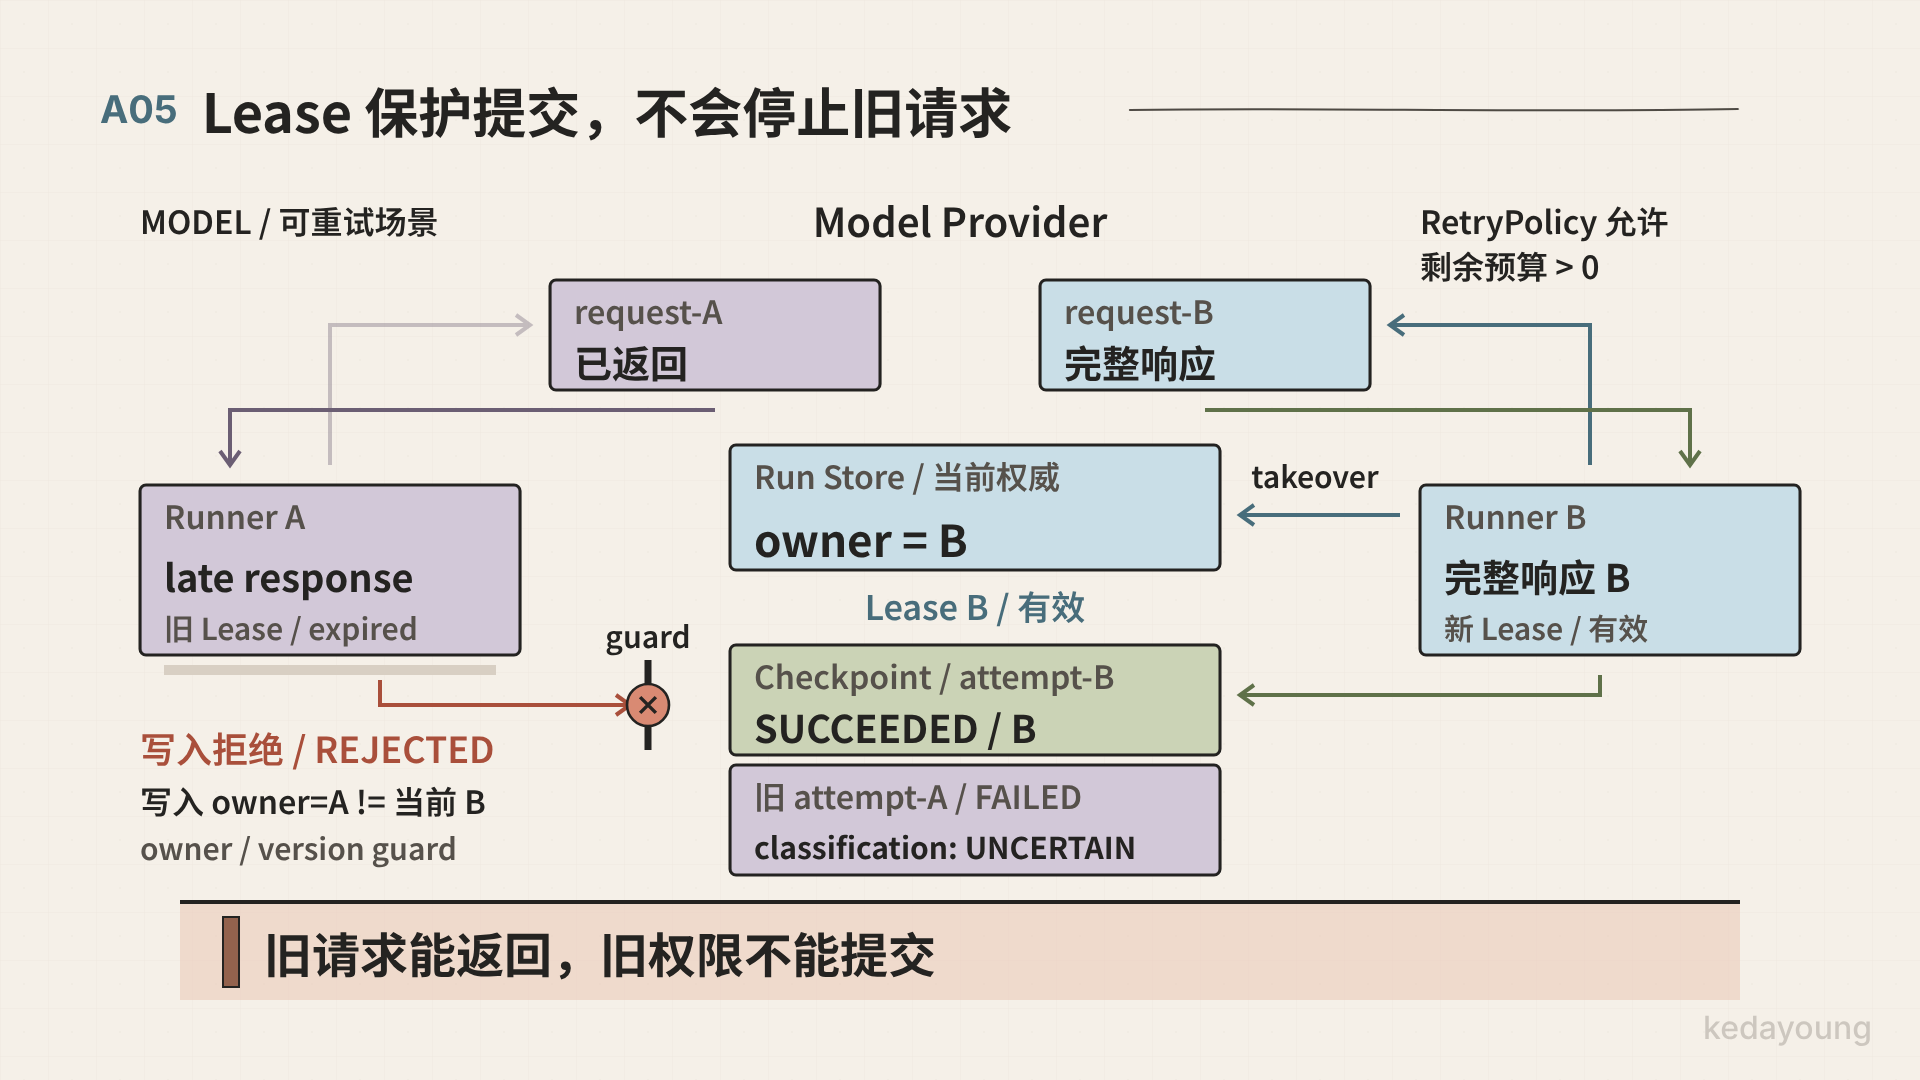
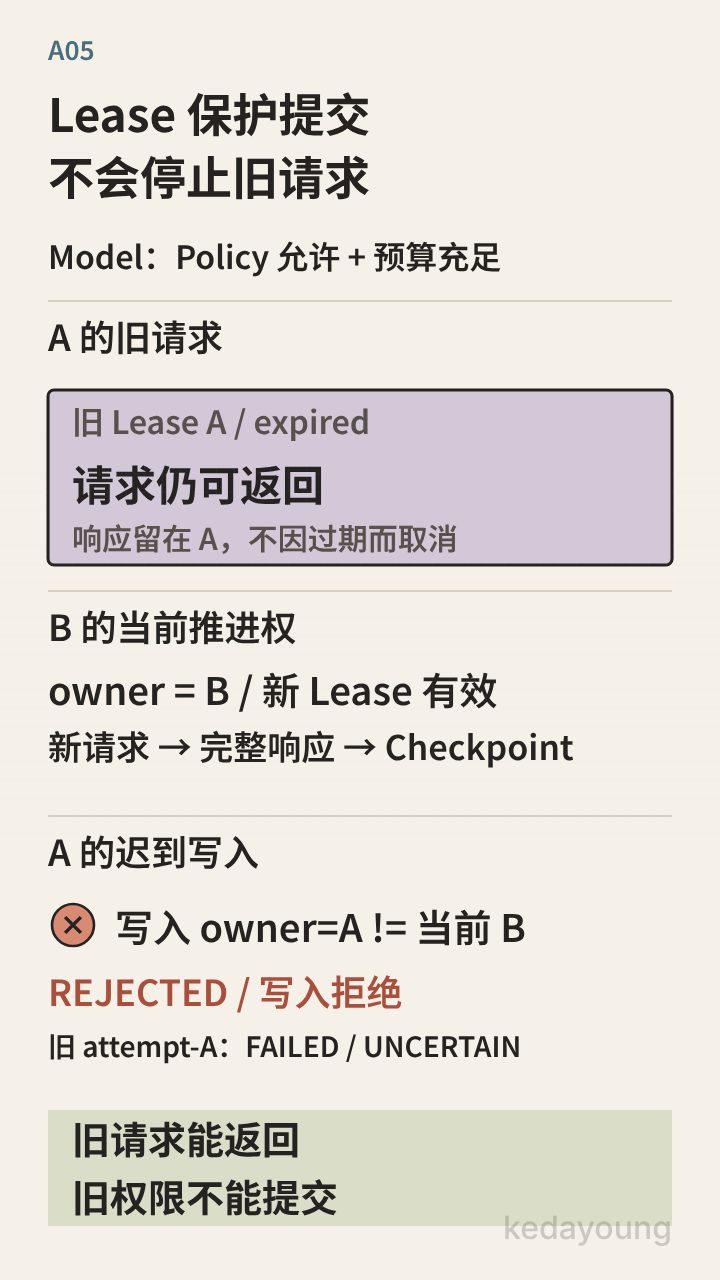
A 的旧请求不会随 Lease 过期消失。B 取得有效 Lease 后按冻结规则推进, Store 拒绝 A 的迟到提交,但不撤销已经返回的外部响应。
11.4 Lease 变化为什么不递增 Run version
Lease acquisition/release 只改变 owner 与 expiry,不改变 Run progress version。Run version 在状态转换时递增,用来表达生命周期事实变化。
作者推断: 将 Lease epoch 与 Run progress version 合并会让续约频繁制造 业务版本冲突,也会使应用观察到的 expected_version 因纯运维心跳失效。当前 实现用 owner/expiry 条件识别推进权,用 version 识别状态进展,职责更清楚。
代价是 mutation 必须同时检查两组条件;实现 Store adapter 时不能误以为 expected_version 已经包含 Lease 所有权。
11.5 为什么不自动续租或后台 takeover
当前 Runner 不启动后台心跳,也不会在外部调用期间隐式自动续租;但 Run Store 的 acquire_lease() 原语允许调用方显式以同一 owner 续租。Lease TTL 应至少 覆盖一次预期的“dispatch + 结果提交”窗口。若外部调用期间 Lease 过期,调用 本身可能已经发生,但后续 dispatch 或权威 mutation 会被拒绝;上层随后显式 调用 resume_run(),由 Attempt、Checkpoint、Effect 和 Retry 规则决定复用、 重放或进入 WAITING。TTL 过短会增加这类冲突,过长则增加崩溃后的接管等待。
这是嵌入式 Runtime 边界的直接结果。自动续租意味着后台生命周期、线程/任务 管理、进程关停协议和故障检测;自动 takeover 又意味着任务发现与调度。M-Agent 把这些选择留给部署它的服务,而 Core 只提供一致的协调原语。
11.6 并发测试证明了什么
test_two_runners_contend_for_same_run_single_effective_owner 用两个 SQLite connection 和两个 Runner 竞争同一 Run。Runner B 的 resume_run() 被 LeaseNotHeldError 拒绝,最终模型只调用一次。
test_expired_lease_takeover_and_stale_owner_rejected 推进 FakeClock 越过 TTL,让 B 接管并恢复;A 的迟到写入被拒。最终一个逻辑 Step 下保留两个 Attempts,只有 B 的结果形成 Checkpoint。
test_takeover_resumes_from_latest_checkpoint 让 A 在 Model Checkpoint 后、终态前崩溃;B 接管后完全不调用 Model,直接 复用 Checkpoint 完成 Run。
这些测试证明的是 Store/Runner 协议在受控竞争下保持权威事实,不是证明 SQLite 是任意规模分布式部署的通用后端。
第 12 章:测试是可执行的 Durable Invariant
Durable Runtime 最危险的错误往往不会在普通 happy path 单元测试中出现: 它们存在于“外部效果与本地提交之间”“Lease 刚好过期”“流输出一半后失败” 等窗口。因此本仓库的高价值测试不只断言返回值,而是按故障场景组合检查四类 证据:
- Run Store 中的 Run/Step/Attempt/Checkpoint;
- 新进程中 Adapter 的调用计数;
- 跨进程共享的独立 journal;
- 非权威 Run Updates 的 identity 与顺序。
单个测试只覆盖与其风险相关的证据组合;测试集整体才形成对 Durable invariant 的证明边界。
12.1 真实进程退出,而不是模拟异常
跨进程恢复测试启动子进程,并在确定性 CrashPoint 调用 os._exit。这不会 执行 Python finally、atexit 或对象析构,因此更接近进程被杀死:
图解结构源稿
flowchart LR
    Test[Test process] --> Spawn[spawn worker process]
    Spawn --> DB[(SQLite Run Store)]
    Spawn --> Journal[(independent call/effect journal)]
    Spawn --> Crash{os._exit at CrashPoint}
    Crash --> Probe[Test reopens DB]
    Probe --> Clock[advance FakeClock beyond lease TTL]
    Clock --> Resume[new Registry + Store + Runner]
    Resume --> DB
    Test --> Journal
    Resume --> Inspect[inspect_run + external counts]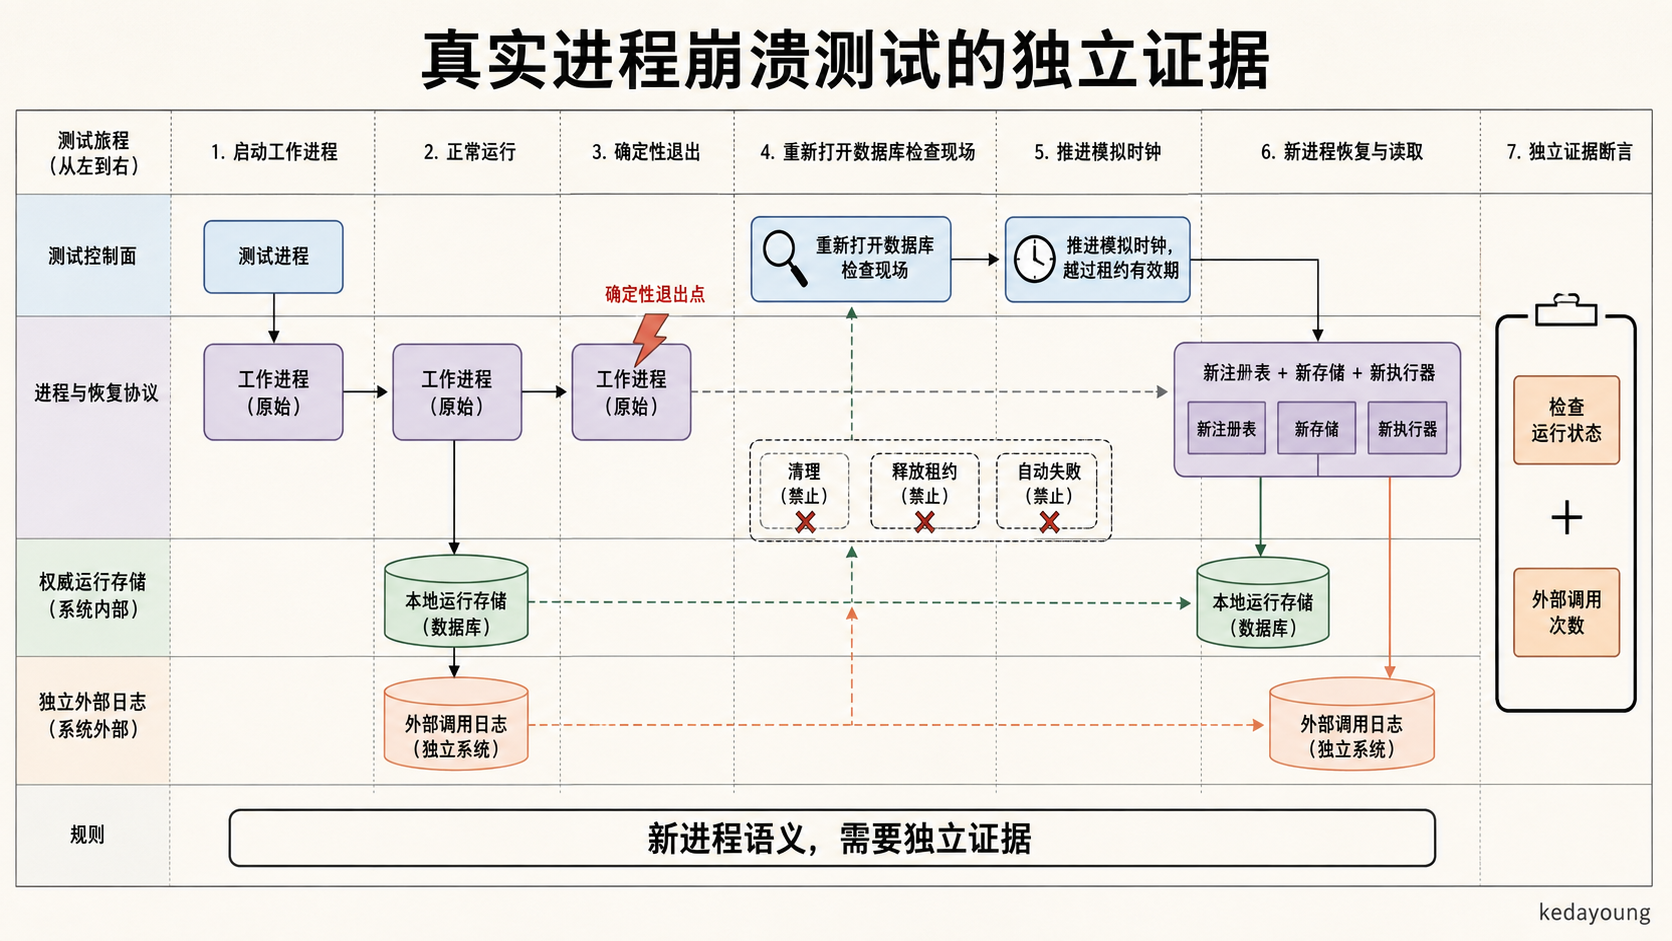
图 M11:独立核对 Store 状态与外部计数,避免旧进程内存或 finally 清理帮助恢复。
这样的测试避免一个假阳性:如果只在同进程抛异常,旧 Runner 的内存对象、 取消事件、Registry、连接状态或 finally 清理可能意外帮助恢复。真正的新进程 只能依赖持久化 Run Store、外部 journal、重新注册的精确 Definition,以及 满足 Lease takeover 条件的时间或调度安排。崩溃遗留 Lease 在 TTL 内仍有效, 恢复方必须等到过期点,才能通过公开 resume_run() 接管。
12.2 Checkpoint 前后是一对测试
Model:
Checkpoint 后崩溃,第二进程 Model 调用数为零;
reservation 后、Checkpoint 前崩溃,恢复产生新 Attempt,跨进程模型调用数 从 1 变为 2。
Context:
- Checkpoint 后复用原始 Items,Provider 不再调用;
- Checkpoint 前重新调用 Provider,外部内容可以变化。
Tool:
- Checkpoint 后 Outcome 直接复用;
- Checkpoint 前根据 Effect 分流;
- 非幂等通知进入 WAITING;
- 幂等 ticket update 可以重放,但外部 ledger 仍只有一次 effect。
成对测试比单独测试“能恢复”更有信息量,因为它们直接验证 Checkpoint 边界 两侧的语义不同。
12.3 Attempt 历史和预算不能因重启消失
test_transient_failure_recovers_with_new_attempts 证明两次 TRANSIENT 失败、第三次成功时,同一 Step 保留三个不同 Attempts。 test_retry_stops_at_explicit_bound 证明 max_attempts=3 时持续失败只调用三次。 test_tool_recovery_does_not_exceed_frozen_budget_after_dispatch_crash 证明 Tool dispatch 后崩溃的未确认 Attempt 仍占用冻结 retry budget,恢复进程 不能用更宽松策略扩大原 Run 的预算。 test_model_resume_uses_persisted_attempt_budget_and_step 证明 Model 恢复沿用持久化 Step identity,并从已保存的 Attempt 数继续。
这些测试防止把 retry budget 写成进程内循环计数器。Durable 的预算必须和执行 证据一样持久,否则重启本身就会成为绕过限制的手段。
12.4 WAITING 必须机器可读
test_waiting_record_is_machine_readable 断言:
waiting_reason == UNCERTAIN_NON_IDEMPOTENT;waiting_step_id指向失败 Tool Step;allowed_resolutions()返回精确四种动作;- 失败 Attempt 是
UNCERTAIN/effect_unconfirmed; - 没有 Tool Checkpoint;
- WAITING 不是终态。
这保证上层应用不需要解析异常文本或日志来构造处置 UI。它可以直接展示目标 Step、等待原因和合法命令,并携带当前 version 提交乐观并发受控的 Resolution。
12.5 Streaming 测试同时检查 UI 与 Store
test_deltas_are_not_checkpointed_while_streaming 在第一条 delta 发布后、完整响应前检查 Store,确认已有 Attempt 但没有 Model Checkpoint。
test_partial_stream_retry_new_attempt_replaces_output 同时断言:
- 两次流使用不同
attempt_id; - 第一次 delta 是
A, B; - 第二次 delta 是
A, B, C; - 失败 Attempt 与失败 delta 使用同一 identity;
- 只有第二次 Attempt 有完整
ABCCheckpoint。
这让 Run Update 的非权威语义和 Checkpoint 的权威语义在同一个测试里互相 校验。
取消边界还由 test_cancel_after_non_streaming_tool_request_never_dispatches_tool 覆盖:完整 Model Response 已经请求 Tool,但取消在 Tool dispatch 前被观察到, 因此 Tool 调用数保持为零,避免把“模型已提出调用”误当作“工具已经执行”。
12.6 Flagship 示例把协议组合成一条旅程
examples/durable_support_agent 的顺序是:
Context Items with provenance
-> READ_ONLY order lookup
-> IDEMPOTENT ticket update
-> NON_IDEMPOTENT notification
-> notification effect
-> os._exit before Tool Checkpoint
-> second process resume
-> WAITING(UNCERTAIN_NON_IDEMPOTENT)
-> application CONFIRM_STEP
-> final Model Step
-> SUCCEEDED structured result
worker 中的崩溃点见 examples/durable_support_agent/worker.py, 恢复和确认见同文件 resume-and-confirm。 旗舰验收测试 test_flagship_acceptance_passes 同时检查通知次数、最终状态、结构化结果和 Context provenance。
这个示例的价值不在于业务场景本身,而在于它把每个独立协议组合起来: Context 的读取事实、幂等写入的外部去重、非幂等效果的不确定性、真实进程退出、 Lease 过期接管、WAITING、应用确认和最终输出都通过公共 API 完成。
12.7 测试没有证明什么
这些测试没有证明:
- live provider 在所有网络故障下的行为;
- 生产吞吐、延迟和容量;
- SQLite 的多主分布式能力;
- 任意工具的幂等性;
- 外部系统 exactly-once;
- 多租户授权与数据隔离;
- 跨平台发行物已经通过认证。
高质量 Durable 测试的意义不是扩大宣称,而是把每条宣称精确绑定到可重复的 证据窗口。
12.8 精校补充实验:Tool 成功状态与 Checkpoint 之间的缺口
既有 BEFORE_TOOL_CHECKPOINT 注入点位于成功 Step 写入之前,不能覆盖成功 写入序列中的每个位置。源码在 _checkpoint_tool_outcome() 依次提交 Step、Attempt、Checkpoint;恢复却只把 RUNNING Tool Step 识别为 in-flight。
本次精校增加了独立的 复现脚本:使用真实 SQLite 和 子进程,在非幂等通知写入独立 journal、Tool Step 的 SUCCEEDED 提交后, 立即 os._exit(17);父进程重开数据库、推进 FakeClock 越过 Lease TTL, 再通过公开 resume_run() 恢复。实验不修改 M-Agent 源码,也不调用真实通知服务。
恢复前 Tool Step       = SUCCEEDED
恢复前 Tool Attempt    = RUNNING
恢复前 Tool Checkpoint = 无
恢复前 journal 计数    = 1
恢复后 journal 计数    = 2
恢复后 Run             = SUCCEEDED
实验结论: 这个窗口下,恢复未识别已有非幂等执行证据,而是重新调用工具。 这是 v0.5.1 的实现缺口,不是允许重复通知的新设计决策。它与开场所用 RUNNING Step/Attempt 窗口的测试结果并不矛盾,但说明后者不能推广为 “任意 Tool Checkpoint 前崩溃都会安全进入 WAITING”。本次只修订解析文章并 保留证据,未修复上游实现。
结论:Durable Runtime 是一套不确定性管理协议
M-Agent Durable Run 的核心不是“把一次调用恢复回来”,而是把每个无法原子化 的边界变成可检查的持久协议:Run Store 保存 identity、Attempt、Checkpoint、 预算、Lease 与 version;Runner 只在当前 Lease 和版本条件成立时推进;恢复则 依据已确认 Checkpoint 与冻结的 Effect/Retry 规则决定复用、重放或进入 WAITING。
因此它的设计目标是可检查的 at-least-once 执行边界,而不是 exactly-once:
- 已确认的本地事实可以在重启后复用;
- 未确认的外部效果应保留为不确定证据,不从缺少结果反推效果未发生;
- 自动重放只发生在冻结规则明确允许的位置;
- 被恢复算法识别的未确认非幂等效果以机器可读 WAITING 交回应用;
- 并发旧 owner 不能覆盖新的权威历史。
这些设计目标不能直接等同于全部实现路径都已兑现。第 12.8 节复现的分步提交 缺口,以及第 7.6 节的 call_id 作用域风险,必须与正常路径和既有验收结果 一起阅读;尤其不能把第 3、4 点扩大为对任意崩溃窗口的无条件保证。
这套保证有明确前提。应用需要保留精确 Definition 版本,选择 Payload Codec, 配置合适的 Lease TTL,声明 Tool Effect,提供有界 Retry Policy,并负责任务 发现、恢复调度、外部幂等协议和非幂等效果处置。Runtime 不提供后台自动续租、 无人触发的 takeover、生产调度、分布式事务或外部系统 exactly-once。
工程结论:证据先于便利。 对外集成时,重要的不是隐藏这些限制,而是让每 个限制都对应可查询的 Run Store 证据和明确的应用动作。模型调用与工具副作用 天然跨越不同系统;可靠 Runtime 首先要准确表达自己已经确认了什么,以及仍然 不能证明什么。
附录 A:关键源码导航
| 主题 | 入口 |
|---|---|
| Run 状态机 | src/m_agent/_status.py |
| Run 数据模型 | src/m_agent/_run.py |
| Step / Attempt / Checkpoint | src/m_agent/_steps.py |
| Definition Snapshot | src/m_agent/_definition.py |
| Definition Registry | src/m_agent/_definition.py |
| Runner 创建 | create_run() |
| Runner 启动 | start_run() |
| Runner 恢复 | resume_run() |
| Resolution | src/m_agent/_runner.py |
| 取消 | cancel_run() |
| Run Update 订阅 | subscribe_run() |
| Context 执行 | src/m_agent/_runner.py |
| Model 执行 | src/m_agent/_runner.py |
| Tool 执行 | src/m_agent/_runner.py |
| Policy Gate | src/m_agent/_runner.py |
| RunStore Protocol | src/m_agent/_store.py |
| SQLiteRunStore | SQLiteRunStore |
| Run Update | src/m_agent/_updates.py |
| Tool Effect / Outcome | src/m_agent/_tools.py |
附录 B:按事故现象定位代码
| 现象 | 优先检查 | 源码入口 |
|---|---|---|
| 恢复后模型被再次调用 | 是否缺 Model Checkpoint;是否只有 reservation Attempt | _resume_running() |
| 恢复后 Context 变化 | 对应 Stage 的 stage_id/scope/boundary 是否已有 Checkpoint | _stage_checkpoint() |
| 工具可能重复执行 | Snapshot Tool Effect、可关联 in-flight Attempt、Retry Policy | _frozen_tool_effect() |
| Run 一直 WAITING | waiting_reason、waiting_step_id、合法 Resolution | allowed_resolutions() |
| Resolution 被拒 | Run version、WAITING reason、目标 Step、Lease owner | resolve_run() |
| 旧 Runner 返回后写入失败 | Lease 是否已过期/被接管,Run version 是否推进 | assert_lease() |
| UI 出现重复流文本 | 是否按 attempt_id 替换失败 Attempt 的临时输出 | RunUpdate |
| 断线后看不到历史 Update | live-only 契约;改读 Run Store | inspect_run() |
| 重启后 retry 次数重置 | 是否持久化全部 Attempts,并按 Run/Step 查询 | get_attempts() |
| 数据库打开时 integrity error | migration、identity、payload 校验;先保留原文件 | _migrate()、_migrate_run_scoped_identities()、_read_payload() |
附录 C:实现新 RunStore Adapter 的检查表
一个替代 Store 至少需要保持以下语义:
- [ ] Run 创建不可覆盖重复
run_id; - [ ] Run、Step、Attempt、Checkpoint 查询都以
run_id为所有权边界; - [ ] Step/Checkpoint key 为
(run_id, step_id); - [ ] Attempt key 为
(run_id, attempt_id); - [ ] Payload key 为
(run_id, field); - [ ] 所有权威 mutation 校验
expected_version; - [ ] Runner mutation 原子校验有效 Lease owner 与 expiry;
- [ ] Checkpoint 写入与 Payload 写入在返回前完成持久化提交;
- [ ] 失败 mutation 不留下半写 metadata/payload;
- [ ] 对使用 typed Model Contract / Model Execution Budget 的 Run,Model
Attempt budget 的“检查 + 占用”原子完成;
- [ ] 对使用 typed Model Contract 的 Run,未确认 Model reservation 在恢复后
仍计入冻结预算;
- [ ] 若保留 0.2 兼容 Store,明确其可不实现
prepare_model_dispatch()/
reserve_model_attempt(),但不得对新 typed Run 暴露不完整语义;
- [ ]
record_policy_decision()/get_policy_decisions()按run_id
持久化并保持顺序;
- [ ] Policy Decision 写入校验
expected_version,传入lease_owner时也校验
有效 Lease;若实现采用先读后写,必须理解其原子性弱于条件 mutation;
- [ ]
inspect_run()所需的 Run、Step、Attempt、Checkpoint、Policy Decision
证据都能从 Store 独立重建;
- [ ] metadata 不包含受保护内容字段;
- [ ] 所有 Payload 路径都经过配置的
PayloadCodec; - [ ] 读取缺失的必需 Snapshot/Checkpoint payload 时 fail closed;
- [ ] 并发失败能区分 stale version 与 Lease conflict;
- [ ] 旧 owner 的迟到 Step/Attempt/Checkpoint/transition 被拒;
- [ ] Store 不依赖 Trace 或 Run Update 才能恢复。
仅让方法“能跑通”不足以实现 Durable Run。真正的兼容性位于事务、identity、 失败原子性和返回时持久化保证中。
附录 D:明确的 Non-claims
本文和当前实现不主张:
- 不主张 exactly-once。 当前恢复是 at-least-once;跨外部系统的一次性
效果需要具体幂等协议或应用 Resolution。
- 不主张内置 scheduler 或后台自动恢复。 Runner 不扫描 Store、不发现
任务、不分配 worker,也不会无人触发 resume_run();应用显式调用 resume_run() 时,Runner 可以在 Lease 过期后接管 Run。
- 不主张强制取消。 Cancellation 是协作式意图,已 dispatch 调用可能继续。
- 不主张分布式事务。 Run Store Checkpoint 与外部 Model/Tool 系统不在
同一事务中。
- 不主张 SQLite 是通用生产后端。 它是本地/单服务持久化参考实现和
可验证协议载体。
- 不主张 Trace 或 Run Update 是恢复权威来源。 恢复只读取 Run Store;
Trace 可能被采样或丢弃,Run Update 是 live-only。若应用要将它们用于审计, 必须另行定义保留、完整性和缺失语义。
- 不主张 Plaintext Codec 提供保密性。 生产 Payload 保护由应用配置。
- 不主张 Run-scoped identity 是租户授权。 它是记录所有权和隔离契约。
- 不主张 Runtime 能判断任意外部副作用。 不可知事实通过 WAITING 交回
应用。
- 不主张 Lease 能停止旧进程。 Lease 只决定谁能继续 dispatch 和提交
权威 mutation。
附录 E:Run 状态转换表
| 当前状态 | 合法目标 | 入口/触发条件 |
|---|---|---|
CREATED | RUNNING | INPUT Policy 允许后首次启动 |
CREATED | WAITING | INPUT Policy 要求 Resolution;恢复时精确 Definition 不可用 |
CREATED | REJECTED | INPUT Policy 拒绝 |
CREATED | FAILED | 启动前确定性失败 |
CREATED | CANCELLED | 尚未执行时取消 |
RUNNING | SUCCEEDED | 最终响应通过 Policy 与 Output Contract |
RUNNING | REJECTED | 生命周期 Policy Gate 拒绝 |
RUNNING | FAILED | Step 失败且不可继续 |
RUNNING | WAITING | 恢复到未确认 NON_IDEMPOTENT Tool Effect;Policy Gate 要求 Resolution;resume_run() 发现精确定义不可用 |
RUNNING | CANCELLED | 在已知安全边界观察到取消请求 |
WAITING | RUNNING | resume_run() 找回精确定义;RETRY_STEP / CONFIRM_STEP;仅对 POLICY_RESOLUTION_REQUIRED:* 使用 CONTINUE_RUN |
WAITING | FAILED | FAIL_RUN |
WAITING | CANCELLED | CANCEL_RUN |
| 任意终态 | 无 | 后续推进命令全部拒绝 |
权威转换表见 src/m_agent/_status.py。进程崩溃本身不新增 状态转换;一个崩溃 Run 可以继续保持 RUNNING,等待 Lease 过期后恢复。
附录 F:Run、Step、Attempt 与 Checkpoint 字段索引
RunRecord
| 字段 | 类型/用途 | 恢复意义 |
|---|---|---|
run_id | Run identity | 所有子记录的所有权边界 |
definition_id / definition_version | 精确 Definition 引用 | 禁止恢复时静默升级 |
input / history | 冻结输入 Payload | 重启后不重新读取 Session |
status | 七状态之一 | 决定 API 入口分支 |
snapshot | DefinitionSnapshot | 冻结模型、工具、策略、预算与上下文语义 |
output | 最终结果 Payload | 只在成功终态形成 |
waiting_reason | 机器可读等待原因 | 决定合法 Resolution |
waiting_step_id | 等待中的目标 Step | 防止处置错误 Step |
error_code | 稳定终态错误标识 | 查询与自动化分流 |
version | 乐观并发版本 | 拒绝陈旧状态命令 |
lease_owner / lease_expires_at | 当前推进权 | 拒绝并发推进与迟到提交 |
created_at / updated_at | 时间证据 | 运维与检查 |
StepRecord
| 字段 | 含义 |
|---|---|
step_id | 同一逻辑 Step 的稳定身份 |
run_id | 所属 Run |
step_type | CONTEXT、MODEL 或 TOOL |
status | RUNNING、SUCCEEDED 或 FAILED |
error_code | 无 Attempt 的预 dispatch 失败等稳定错误 |
created_at | Step 身份首次建立时间 |
StepAttempt
| 字段 | 含义 |
|---|---|
attempt_id | 每次实际尝试的唯一身份 |
step_id / run_id | 逻辑 Step 与所有权 |
status | RUNNING、SUCCEEDED 或 FAILED;不表示外部效果是否已确认 |
output | 成功 Attempt 的完整结果;特定 Policy-held pending Tool Outcome 也可保留结果证据 |
error | 受保护的人类可读诊断 Payload |
classification | 失败分类:TRANSIENT、PERMANENT、UNCERTAIN;成功 Attempt 通常为 None |
error_code | 净化后的机器可读错误 |
model_purpose | Model Attempt 的 PRIMARY、CONTEXT_COMPRESSION、OUTPUT_REPAIR |
usage | Adapter 实际提供的 Model usage metadata |
created_at | 尝试时间证据 |
StepCheckpoint
| 字段 | 含义 |
|---|---|
run_id / step_id | 所属 Run 与已确认逻辑 Step |
attempt_id | 被 Runner 确认为完整结果来源的 Attempt |
step_type | CONTEXT、MODEL 或 TOOL;决定 output 的反序列化类型 |
output | 公共对象中的完整结果字符串:Context 为 Stage Result,Model 为完整 Model Response,Tool 为 Tool Outcome;持久化时经 PayloadCodec 编码,读取时解码 |
created_at | Checkpoint 时间 |
字段定义见 src/m_agent/_run.py 和 src/m_agent/_steps.py。
附录 G:恢复决策矩阵
Run 级入口
| Run 状态 / reason | 精确 Definition | 默认 resume_run 结果 |
|---|---|---|
| 终态 | 任意 | 拒绝恢复 |
CREATED | 可用且 Contract 匹配 | 获取 Lease,走首次启动路径 |
CREATED | 不可用 | WAITING(DEFINITION_UNAVAILABLE) |
RUNNING | 可用且 Contract 匹配 | 获取/接管 Lease,从证据重建 |
RUNNING | 不可用 | 获取 Lease 后进入 WAITING(DEFINITION_UNAVAILABLE) |
WAITING(DEFINITION_UNAVAILABLE) | 不可用 | 原样返回 |
WAITING(DEFINITION_UNAVAILABLE) | 可用且匹配 | 获取 Lease,转 RUNNING 并恢复 |
WAITING(UNCERTAIN_NON_IDEMPOTENT) | 任意 | 原样返回,等待 Resolution |
WAITING(POLICY_RESOLUTION_REQUIRED:*) | 任意 | 原样返回,等待 Resolution |
Step 级证据
本表是常见路径索引,不穷尽中间提交窗口。Tool 行中的 in-flight 特指恢复算法 识别出的 RUNNING Step/Attempt;SUCCEEDED Step 缺少 Checkpoint 的情况见 第 12.8 节。Run 若已是终态,不能仅凭 Step 行选择重新执行。
| Step | Attempt 状态 | classification / reservation | Checkpoint | 其他条件 | 结果 |
|---|---|---|---|---|---|
| Context | 无 | 无 | 无 | invocation 应执行 | 首次调用 Provider |
| Context | RUNNING 或 FAILED | 任意 | 无 | 精确 Stage 能力可用 | at-least-once 重新调用 |
| Context | 任意历史 | 任意 | 有 | Stage Result payload 完整且 identity 匹配 | 复用 |
| Model | 无 | 无 reservation | 无 | Contract 与预算允许 | 首次 dispatch |
| Model | RUNNING | reservation 存在 | 无 | 精确定义/Contract 匹配;冻结 Retry Policy 与预算允许 | 旧 Attempt 归一为 FAILED + UNCERTAIN,新 Attempt 重放 |
| Model | RUNNING | reservation 存在 | 无 | 无 retry authority 或预算耗尽 | Step/Run FAILED |
| Model | 历史失败 | 旧 reservation 已由更新 Attempt 覆盖 | 有 | 同一 Step | 以更新 Checkpoint 为准 |
| Model | SUCCEEDED | 无失败分类 | 有 | 响应无 Tool Calls | 重走 FINAL_OUTPUT,再成功、修复或失败 |
| Model | SUCCEEDED | 无失败分类 | 有 | 响应有 Tool Calls | 重建已确认 Tool Outcomes |
| Tool | 无 | 无 | 无 | 冻结声明可用,且确实尚未建立执行证据 | 正常首次执行 |
| Tool | RUNNING | 恢复时归一为 UNCERTAIN | 无 | RUNNING Step;READ_ONLY / IDEMPOTENT,冻结 Retry Policy 允许 | 保留旧证据,新 Attempt replay |
| Tool | RUNNING | 效果未确认 | 无 | RUNNING Step;NON_IDEMPOTENT | WAITING |
| Tool | RUNNING | 效果未确认 | 无 | Step 已为 SUCCEEDED | 当前实现可能按首次调用路径重复执行,见第 12.8 节 |
| Tool | 任意历史 | 任意 | 有 | Tool Outcome 可反序列化 | 复用,不调用 Tool |
Tool Effect、失败分类与预算
| Effect | 失败分类 / 场景 | Checkpoint | 冻结 Retry Policy / 剩余预算 | 自动行为 |
|---|---|---|---|---|
| 任意 | TRANSIENT,已知失败 | 无 | Policy 允许且预算未耗尽 | 新 Attempt |
| 任意 | TRANSIENT,已知失败 | 无 | Policy 缺失、上限耗尽或任一条件不满足 | FAILED |
READ_ONLY | 恢复到中断未确认 Attempt | 无 | Policy 允许且预算未耗尽 | recovery replay |
READ_ONLY | 恢复到中断未确认 Attempt | 无 | 无 authority | FAILED |
IDEMPOTENT | 恢复到中断未确认 Attempt | 无 | Policy 允许且预算未耗尽 | recovery replay;外部系统负责去重 |
IDEMPOTENT | 恢复到中断未确认 Attempt | 无 | 无 authority | FAILED |
NON_IDEMPOTENT | 恢复到中断未确认 Attempt | 无 | 任意 | WAITING,不自动 replay |
| 任意 | UNCERTAIN,普通执行中的已知失败 | 无 | 任意 | 不按普通 retry 自动重放 |
| 任意 | PERMANENT | 无 | 任意 | FAILED,不自动 retry |
| 任意 | 任意 | 有 | 任意 | 复用已确认 Tool Outcome |
| 冻结声明缺失/歧义 | 有可关联 in-flight Tool 证据 | 无 | 任意 | WAITING,保留证据 |
| 冻结声明缺失/歧义 | 无可关联 Tool 证据 | 无 | 任意 | FROZEN_TOOL_DECLARATION_UNAVAILABLE fail closed |
恢复 replay 是针对“可能已 dispatch、但未形成 Checkpoint”的特殊路径;普通 失败的自动重试只接受 TRANSIENT。Effect 本身从来不是 retry authority。 表中的自动恢复结论以算法已识别相应 in-flight 证据为前提,不覆盖第 12.8 节 的成功 Step 提交缺口。
附录 H:SQLite 表与主键索引
| 表 | 主键/identity | 内容 | Payload 情况 |
|---|---|---|---|
runs | run_id | Definition 引用、Snapshot 可查询 metadata、status、version、WAITING、Lease、时间 | 不含 input/output/instructions 正文;snapshot_json 排除 instructions |
run_payloads | (run_id, field) | Codec 编码后的完整内容,包括 Snapshot | 唯一内容区,读取需通过 PayloadCodec |
policy_decisions | 无业务主键;当前 SQLite 按 rowid 保留插入顺序 | gate、action、reason、policy identity、输入摘要 | 不保存原始 policy input;替代 Store 也应保持 Run 内顺序 |
steps | (run_id, step_id) | Step 类型、状态、错误码、时间 | 无内容 |
step_attempts | (run_id, attempt_id) | Step 归属、状态、分类、错误码、purpose、usage | output/error 由 run_payloads 保存 |
step_checkpoints | (run_id, step_id) | 成功 Attempt、Step 类型、时间 | output 由 run_payloads 保存 |
固定 Payload field:
| field 形状 | 内容 |
|---|---|
run:input | Run 输入 |
run:output | Run 最终输出 |
run:snapshot | 完整 Definition Snapshot |
run:history | 冻结 Conversation History |
attempt:{attempt_id}:output | Attempt 完整输出 |
attempt:{attempt_id}:error | 受保护诊断 |
checkpoint:{step_id}:output | Checkpoint 完整结果 |
当前 schema 和 split helper 分别见 _sqlite_store.py 与 _store.py。
附录 I:ADR 与代表性测试索引
ADR
| ADR | 主题 | 本文中的作用 |
|---|---|---|
0001 | Runtime 边界 | 不扩张为平台 |
0002 | Agent Run 生命周期 | Run 是状态归属边界 |
0003 | at-least-once | 明确非 exactly-once |
0004 | Step 粒度 | 一次模型/工具调用一个 Step |
0006 | Store 与 Trace | 恢复只信 Run Store |
0007 | Tool Effect | 非幂等不确定时停下 |
0008 | 外部处置 | 应用拥有 Resolution |
0009 | Embedded Runner | 不拥有 worker/scheduler |
0010 | Run Update | live-only 通知 |
0011 | Model Checkpoint | 只持久化完整响应 |
0012 | 取消 | 协作式,不伪装回滚 |
0013 | Lease/version | 单 Run 排他推进 |
0014 | Context Provider | 外部上下文通用边界 |
0015 | Context Step | Provider 调用可恢复 |
0016 | 结构化 Context Item | provenance 与恢复 |
0017 | 外部 Context 是数据 | 与 instructions 分离 |
0022 | 不可变 Definition | Run 内语义冻结 |
0023 | 精确解析 | 缺旧版本则 WAITING |
0024 | Tool Outcome | 异常不伪装结果 |
0025 | Retry Policy | 有界、冻结、fail closed |
0026 | 确定性 Run Policy | Policy Gate 与 WAITING Resolution |
0027 | REJECTED | 与执行失败分开 |
0030 | Model Capabilities | Contract 能力匹配 |
0031 | Output Contract | 最终输出验证 |
0032 | Output Repair | 修复是新的 Model Step |
0033 | Payload 保护 | metadata/content 分离 |
0040 | Context Pipeline | Stage、预算、压缩恢复 |
0041 | Model Contract/Budget | dispatch 前原子预留 |
0042 | 参考验收包 | Flagship 示例的发布边界 |
代表性测试
附录 J:证据优先级与阅读建议
当问题是“当前版本实际做什么”时,本文采用以下优先级:
- 当前源码中的公开模型与实际控制流;
- 通过公共 API 驱动且可重复的测试;
- 旗舰示例与参考验收包。
当问题是“系统承诺什么”时,优先级为:
- 根目录
CONTEXT.md; - status 为
accepted的 ADR; - 当前源码与测试作为实现核对。
若实现与 accepted ADR 或 CONTEXT.md 冲突,应明确记录为实现偏差或文档待更新, 不能用“源码优先”静默覆盖设计契约。被 supersede 的 ADR 只用于解释历史。
建议读者先运行以下“恢复主路径测试集”,观察数据库和调用计数,而不只阅读 断言:
以下命令须在 M-Agent v0.5.1 源码仓库根目录、已安装项目测试依赖的 Python 环境中执行,不是在本文章资料包或 per-web 根目录中执行。
pytest -q \
  tests/test_m_agent_resume.py \
  tests/test_m_agent_lease.py \
  tests/test_m_agent_resolution.py \
  tests/test_m_agent_stream_cancel.py \
  tests/test_durable_support_agent_idempotency.py
再按主题补充 Policy、Payload、迁移、Contract 与 Compression:
pytest -q \
  tests/test_m_agent_retry.py \
  tests/test_m_agent_run_policy.py \
  tests/test_m_agent_payload_security.py \
  tests/test_m_agent_store_migration.py \
  tests/test_m_agent_model_contracts.py \
  tests/test_m_agent_compression.py
测试数量较多时,可先聚焦本文引用的具体 test method。阅读顺序仍建议保持: 先看 Runner 的时间顺序,再看 Store 的原子条件,最后看测试如何在每个 Checkpoint 前后制造崩溃。这样看到的不是一组零散功能,而是一套完整的 Durable Runtime 协议。