面向把 M-Agent 嵌入应用、需要判断验收结论能否用于当前发行物的工程师。 固定源码为
v0.5.1对应提交ae85d4d1a4a96b6b0fab35122bc63f4d79150406。 初稿读取的本地 HEAD 为48a011e2f950287735bce1c12eca50b1cdaad4e7;当时已通过 Git diff 核对 Testing、相关测试、公开客服示例、CONTEXT 和 ADR-0042 在两者间没有差异。 下文分别标记设计决策、实现事实、作者推断与历史记录。所有执行片段均为复查入口, 写作与精校均未运行上游测试、验收 CLI 或示例,未访问凭据、调用真实模型或执行部署。
1. 通知已经发出,绿色测试还欠我们什么
设想一次客服通知:工具已经产生外部效果,但 Tool Checkpoint(工具检查点)尚未提交, 进程就退出了。重启后,Run Store 中有 Attempt(执行尝试)记录,却没有已确认的工具结果; 独立 journal(外部效果日志)才记录着那次效果。若恢复时直接重发,Run 最后仍可能 SUCCEEDED,用户却收到了两条通知。只看最终回复或运行终态,就可能漏掉这个错误。exampledurable
这里用“通知”说明故障窗口,不表示本文调用了真实通知服务。公开客服示例用本地 通知 journal 模拟外部系统;Testing 的 Durable 场景则使用名为 durable-effect 的通用非幂等测试工具。下文配图与动画沿用通知意象,均为机制图示,不是验收记录。exampledurable
因此,仅问“最后是否成功”还不够:崩溃是否发生在指定窗口?新进程是否依据持久化 事实恢复?非幂等效果不确定时是否停在 WAITING?应用确认后,外部效果记录是否 仍只有一条?这些事实又是否属于正在准备发布的那个 wheel(Python 预构建发行包)?
设计决策: ADR-0042 用 Reference Acceptance Pack(参考验收包,下文简称 Pack) 回答这组问题。它不取代单元测试,而是把多个公开契约组合成可重复的 Reference Scenario(参考场景,下文简称 Scenario),再把场景、发行物身份、环境、 必需检查和证据边界冻结为 Acceptance Manifest(验收清单,下文简称 Manifest)。 一个场景失败不能被另一个场景成功覆盖,离线场景成功也不能变成生产认证。adr
后文还会反复出现两个名称:Harness 是负责执行、观测和汇总的测试程序; Bundle 是绑定场景结果与证据引用的证据包。它们分别回答“怎样测”和“留下什么记录”, 不应与被测业务 Run 混为一谈。adrbundle
作者推断: 测试套件帮助开发者定位“哪个行为坏了”;验收包额外要求交代 “这份结论究竟证明哪个发行物,在什么环境中,经过哪些检查”。两者的价值不同, 不是把测试数换成场景数就自动得到了更强的结论。
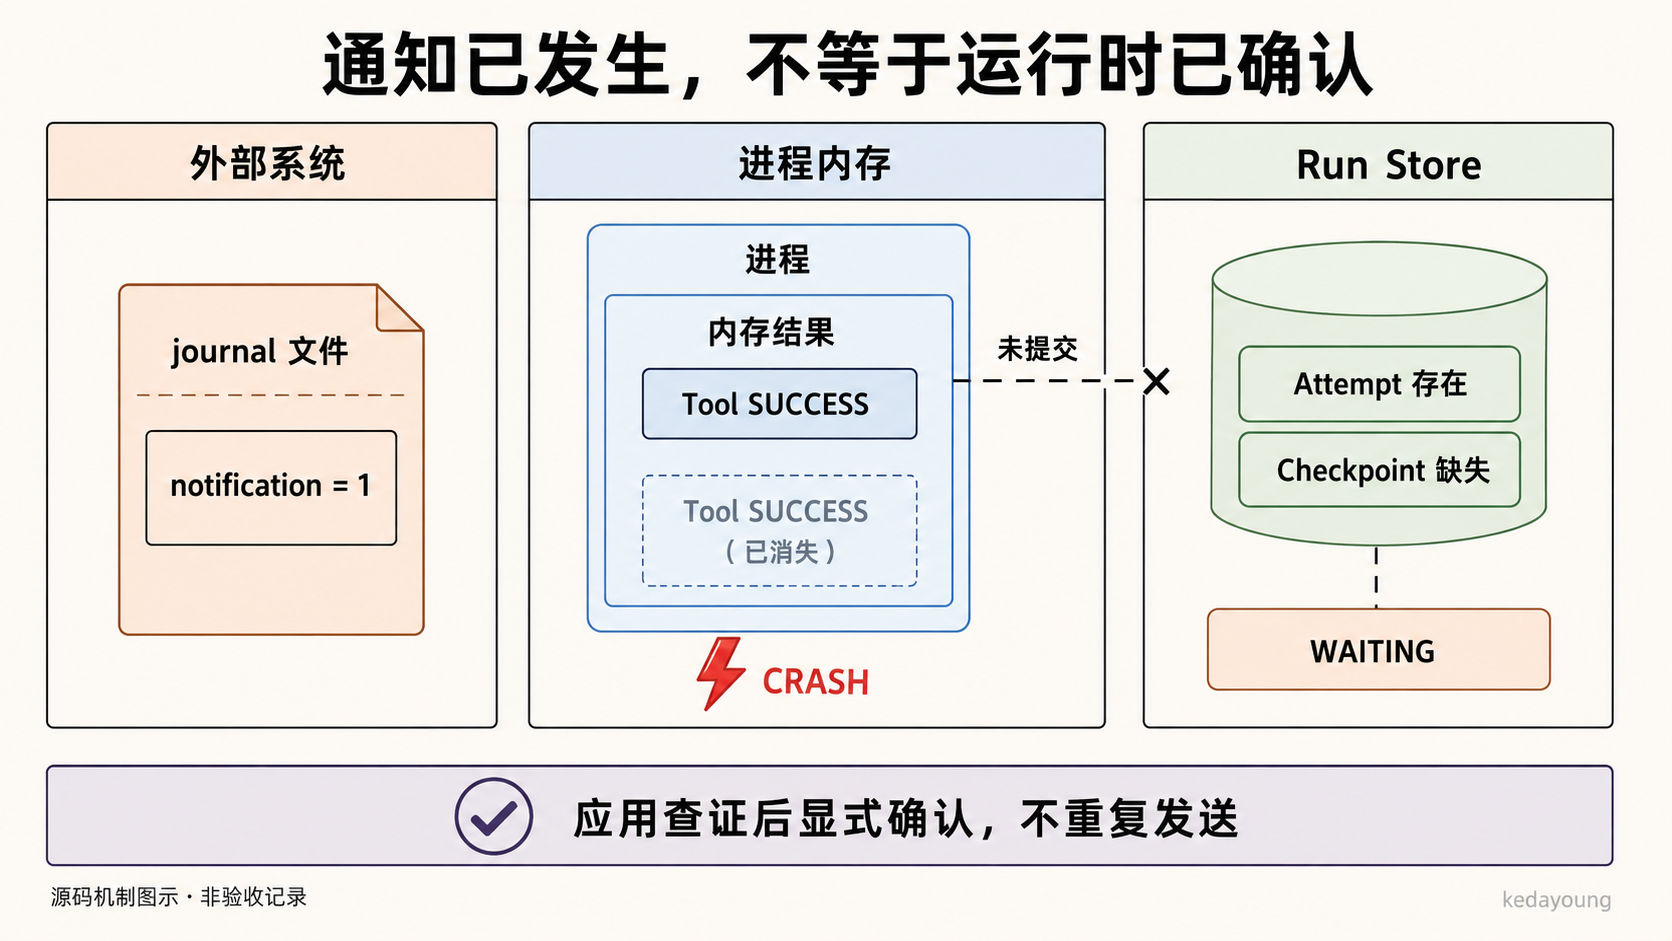
图 1:外部效果已发生不等于 Checkpoint 已提交;WAITING 指该非幂等场景恢复后的处置。
动画 1(10 秒,静音):两类持久化事实在进程退出后仍然保留;本段中的 WAITING 出现在恢复之后。 打开视频
2. 先冻结问题,再运行程序
foundation_release_0_5_manifest(...) 是公开构造入口。它冻结 foundation-release-0-5 Profile(预定义验收配置)的六个场景顺序:Core lifecycle、Durable effects、 Session conversation、Context budget compression、Model routing、Eval regression。 该配置保留前四个既有场景,并加入 Model routing 与 Eval regression; 六者都在同一候选身份下运行,不沿用旧候选的结果。manifest
Manifest 的关键字段可以按三个问题阅读:
| 问题 | 字段 | 归属与作用 |
|---|---|---|
| 测谁 | source_commit、artifact_digest、sdist_digest、fixture_digest | 精确源码、wheel、源码发行包与固定测试夹具(fixture)的身份 |
| 在哪测 | environment | distribution/version、Python、OS、架构、安装方式、源码状态、构建工具和依赖摘要 |
| 测什么 | schema_version、pack_version、profile、scenarios、required_checks、required_cli_commands | 格式版本、场景顺序、检查门槛与公开命令映射 |
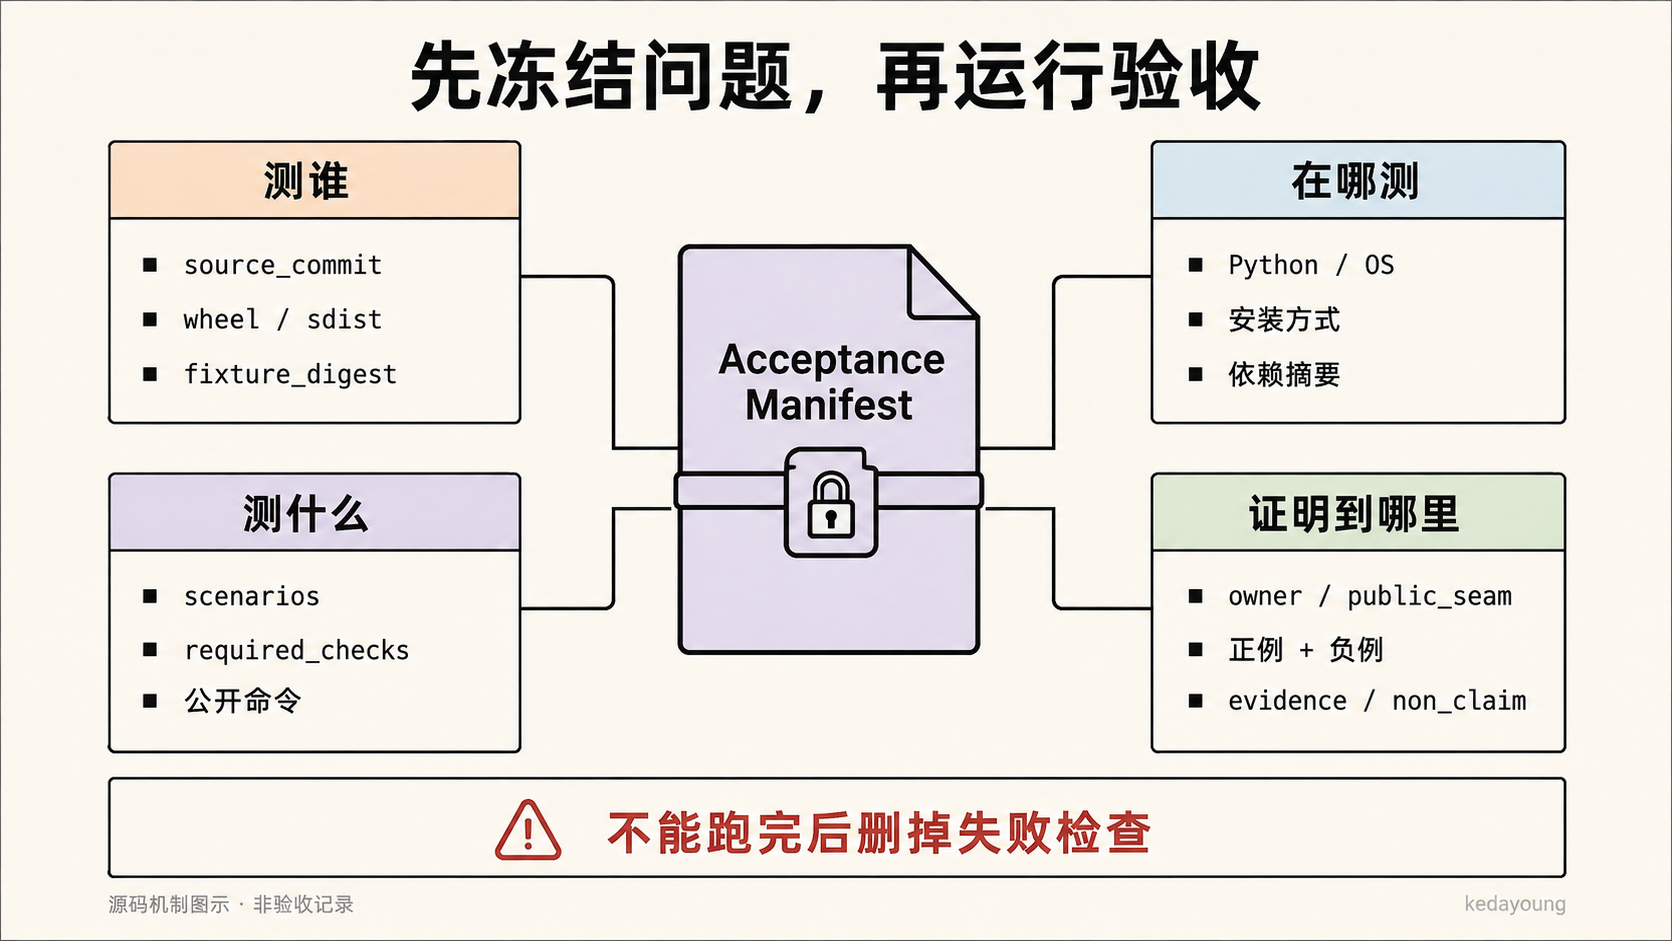
图 2:先固定验收对象与声明范围,再解释结果。
每个 AcceptanceCheck 又冻结 check_id、scenario、owner、public_seam、 positive_check、negative_check、两类证据键、evidence_level、milestone、 non_claim 与 required。例如 Durable recovery 的 owner 是 Runtime Core, 公开入口是恢复与运行检查(inspection),独立证据来自 journal 和故障标记文件(sentinel), exactly_once_external_effect 则明确属于不能宣称的内容。manifest
这就是 Coverage Matrix(验收覆盖矩阵)的用途:把结论的责任、操作、正负路径与证据对应起来。 检查数量和覆盖百分比只是导航信息,不能补偿必需检查(required)的映射缺口。 CLI 还会用同一身份重新构造受支持的冻结 Profile,与输入 Manifest 完整比较, 不能先删掉失败检查再把缩减后的清单当正式验收。coveragecli
这里必须区分设计语言和当前数据结构(schema)。设计决策说 optional 成功不能覆盖 required 失败;实现事实是 Manifest 只有 required_checks,拒绝其中任何 required=False 声明,并没有 optional_checks 容器。额外塞一个未声明的 optional.extra-check: PASS 会被判为 Harness ERROR,不是合法 optional 检查。 相关负例是 test_manifest_rejects_non_required_declarations 和 test_undeclared_passing_results_cannot_rescue_required_failure。aggregation-tests
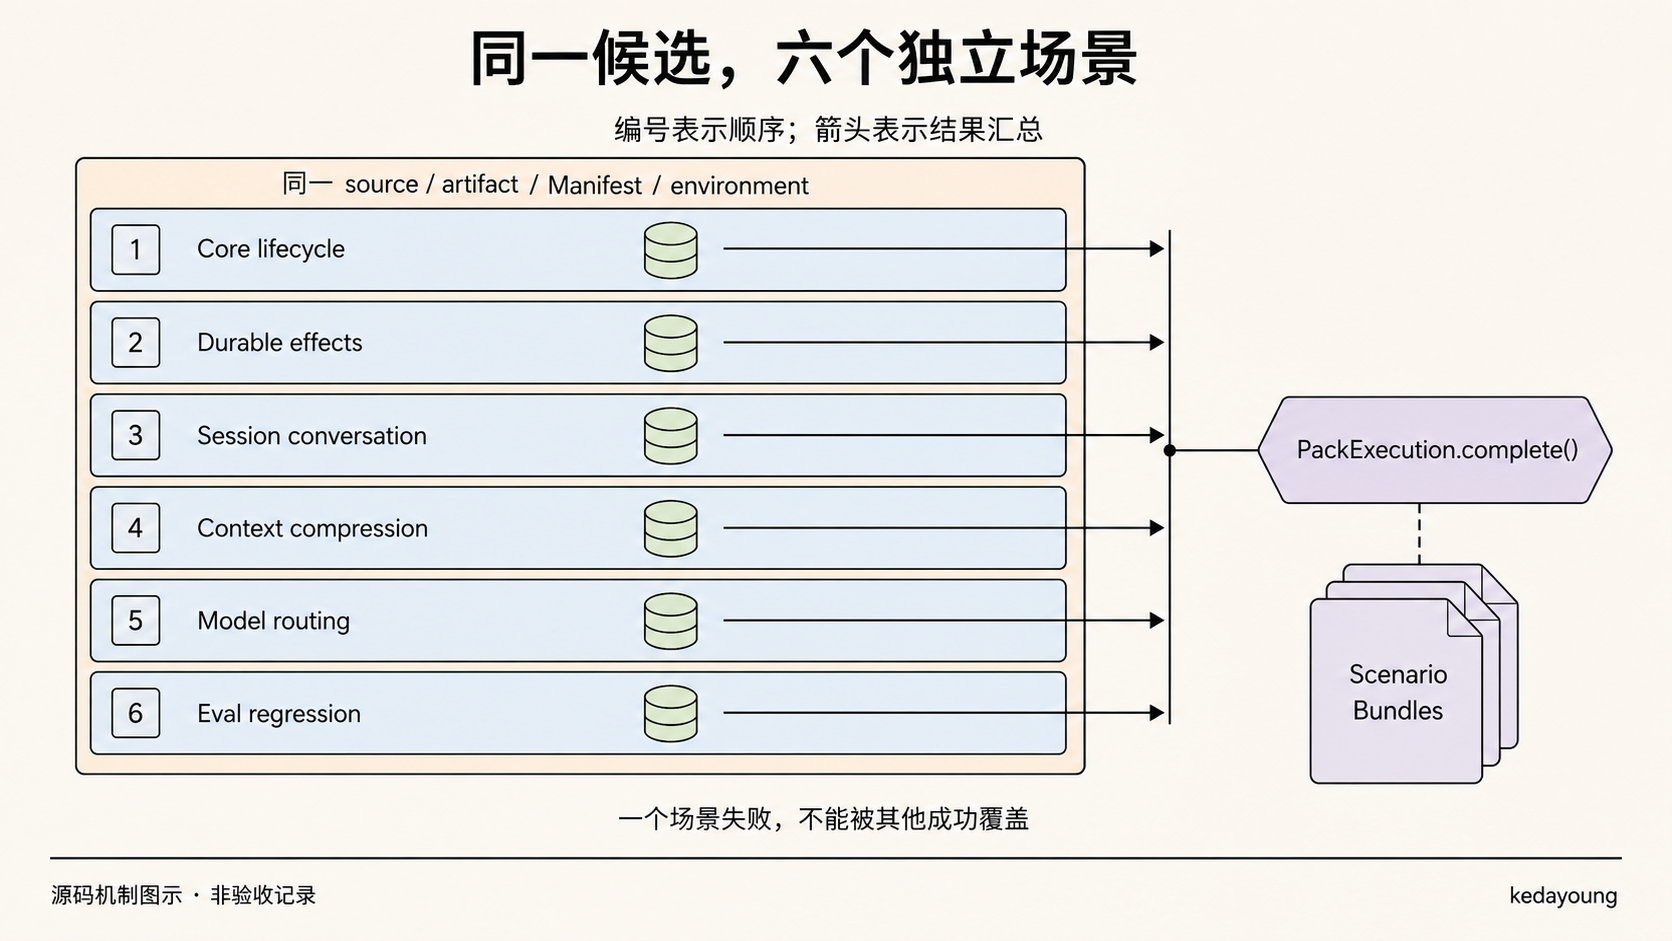
图 3:六个场景共享候选身份,不共享成一个业务 Store;连线表示结果归属。
3. 公开调用路径:Manifest 到 wheel,再到 Bundle
正式 HOST(主机环境验收,见第 10 节)的起点,是从干净源码检出构建的 wheel 和 sdist(源码发行包),而不是通过 PYTHONPATH=src 恰好能导入的源码。 installed_identity() 测量安装身份;validate_installed_identity() 检查 Manifest 是否与当前安装一致。后者要求仓库外的虚拟环境、wheel 安装、干净源码状态和受支持系统, 并拒绝 m-agent 及其允许依赖之外的发行包。它检查的是环境位置与已安装内容,不独立判断该 虚拟环境是否“刚刚创建”。对候选 wheel,校验也不止于版本号,还比较安装成员集合 与实际文件字节。identity
sdist 的检验也不只是“有这个压缩包”。Harness 通过 uv build --offline --wheel 重建它,然后比较候选 wheel 与重建 wheel 的产品成员。这里比较的是产品内容, 不应改写成“两个 zip 容器必须逐字节相同”。缺少 uv 或无法观测构建属于 Harness 问题;构建命令返回失败,或重建产品不匹配,则属于候选失败。identity-build
以下是未执行的 Linux Python 3.11 HOST 复查模板。前置条件是:已经从指定干净 修订构建候选 wheel/sdist,已在仓库外全新 venv 安装该 wheel 的 testing extra, uv 在 PATH,离线构建依赖已缓存。PY、WHEEL、SDIST、MANIFEST、OUT 由复查者设为该次候选的绝对路径;OUT 使用新的证据目录。不要填入历史归档的 digest 冒充新候选,也不要在共享业务目录运行。
"$PY" -I - "$WHEEL" "$SDIST" "$MANIFEST" <<'PY'
import sys
from pathlib import Path
from m_agent.testing import foundation_release_0_5_manifest, installed_identity

wheel, sdist, target = map(Path, sys.argv[1:])
identity = installed_identity(artifact=wheel, sdist=sdist)
manifest = foundation_release_0_5_manifest(**identity)
with target.open("x", encoding="utf-8") as output:
    output.write(manifest.model_dump_json(indent=2) + "\n")
print(manifest.digest)
PY
"$PY" -I -m m_agent.testing run \
  --manifest "$MANIFEST" --wheel "$WHEEL" --sdist "$SDIST" --output-dir "$OUT"
这段代码只从公共 m_agent.testing 导入;Manifest 创建后不随结果变化。 run 预期执行离线场景、进行 HOST 观测和变异自检,在完成汇总后输出内容寻址的 JSON Bundle 文件,再按检查结果返回对应退出码。环境或身份在入口被拒绝时, 可能尚未生成 Bundle,因此并非每种 CLI 失败都有一份完整报告。cliidentity
在内部,_run_foundation_release_0_5() 顺序调用六个场景函数,收集 checks / evidence_view / independent_evidence,补齐 HOST 结果,执行 Bundle 变异验证,调用 PackExecution.complete(),最后按 Scenario 生成 Bundle。 各场景的业务 Store 不合并使用,但最终 Bundle 带同一次 Pack execution(包执行)的 汇总结果。单个 Durable 函数返回的 durable.effects.host-wheel 初始为 NOT_RUN; 直接调用该函数不能自行宣称已经完成 HOST。release-runnerdurable
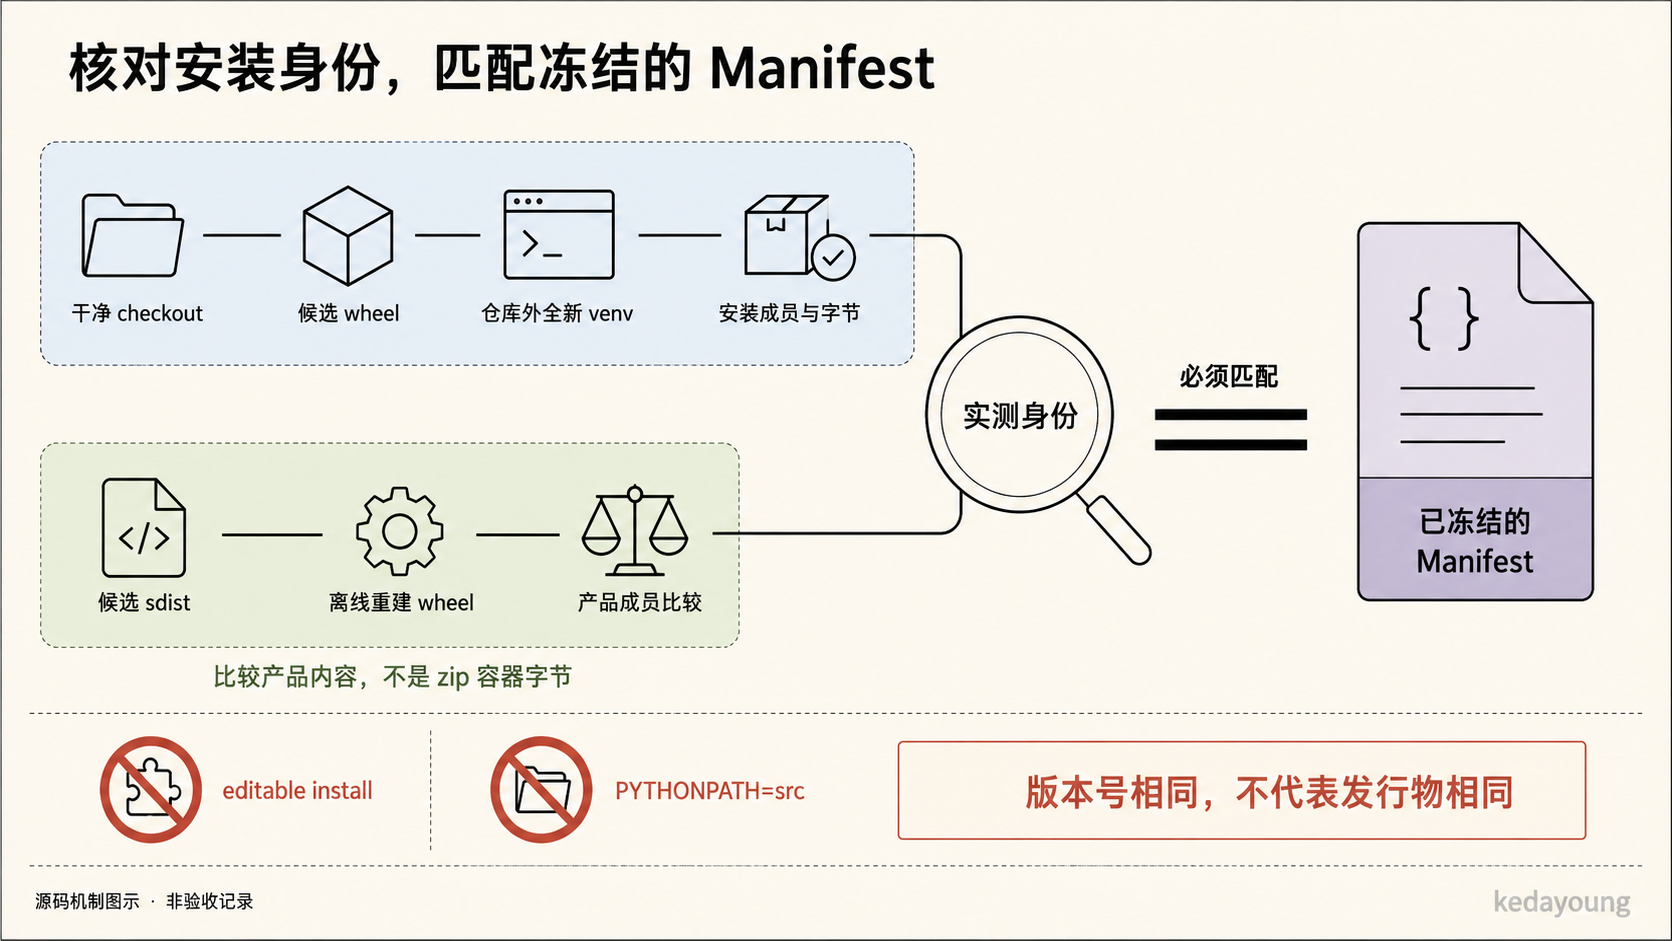
图 4:身份验证对照已冻结的 Manifest;sdist 重建比较产品内容。
动画 2(8 秒,静音):旧 PASS 保留原候选归属,不能用于身份不同的新候选。 打开视频
4. Failure Script:在确定的窗口硬退出
现在沿六个场景中的 durable-effects-recovery 看故障脚本(Failure Script)如何工作。 run_durable_effects_recovery() 建立临时 SQLite、journal、sentinel 和 run-id 文件, 为三个确定性窗口各运行三次:durable
| Failure Script 窗口 | 硬退出前已经发生什么 | 恢复要核对什么 |
|---|---|---|
after_model_reservation | Model Attempt 已保留,测试 Adapter 已记录一次模型分派(dispatch) | 持久化的 Model Attempt 数不能少于独立 journal 中的模型分派条目数 |
after_effect_dispatch | 非幂等测试工具已追加并 fsync 外部效果 journal | 恢复后应先进入 WAITING;显式确认后,effect 条目仍只有一条 |
before_final_model_checkpoint | 工具已完成;测试 Adapter 已记录最终模型分派,但尚未返回最终响应 | 恢复重试不能造成重复工具效果,Model Attempt 数不能少于独立模型分派数 |
子进程通过公开 Runner 创建并启动 Run。测试模型 Adapter 或工具处理器在对应边界写 sentinel, 随后执行 os._exit(86);父进程检查退出码及文件,再等待旧 Lease 到期, 重开 SQLite,创建新的 Registry/Runner,并调用 resume_run(run_id)。 这不是保留内存对象后捕获异常,也不是修改数据库强制接管。durable
在 after_effect_dispatch 窗口中,工具声明为 NON_IDEMPOTENT。恢复若进入 WAITING,Harness 以测试 应用的角色提交 RunResolution.confirm_step("recorded", waiting_step_id=...), 同时提供 expected_version。随后 inspect_run() 读取持久化事实,独立 journal 负责外部效果计数。确认是应用显式接受结果,不是 Runner 从 journal 自动推断后 擅自成功,更不是再发一次通知。durable
这些窗口名称不表示使用了同名 Runner hook。例如 before_final_model_checkpoint 是在测试 Adapter 的 generate() 中、返回最终 ModelResponse 之前硬退出。durable
这里的 86 是 Testing 子进程约定。公开客服示例的 worker.py 则在 CrashPoint.BEFORE_TOOL_CHECKPOINT hook 中确认通知 journal 已有一条记录,再以 退出码 17 结束进程。它与 after_effect_dispatch 都说明“效果已发生、工具检查点 尚未提交”的问题,但分别从 Runner hook 和测试工具处理器注入,不能混写。exampledurable
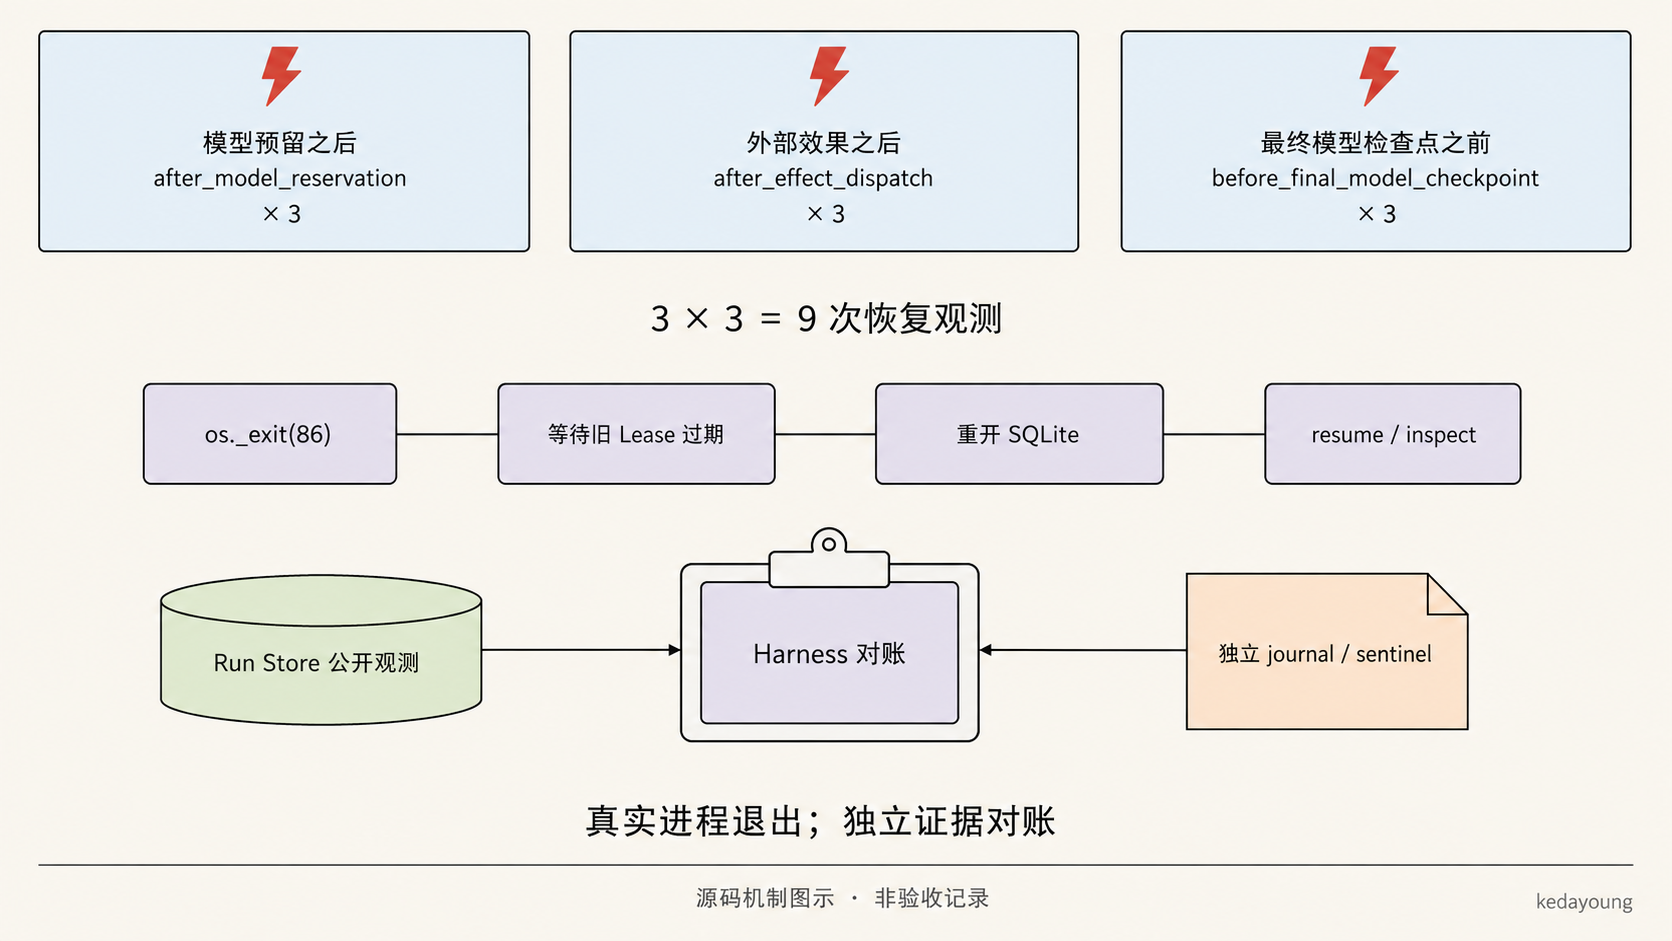
图 5:硬退出、等待 Lease 到期、重开 SQLite 与恢复共同构成观测路径。
5. 双源证据怎样从现场进入 Bundle
_recover_once() 从公开 inspection 提取 status、attempt_statuses、 model_attempts、tool_attempts,并额外记录 window、terminal、 error_code、waiting_seen 和对账 problems。其中,模型 Attempt 数取自 model_purpose is not None 的持久化记录;effect 与 model dispatch 条目则取自 Run Store 之外的 journal,交给对账器比较数量与唯一性。durable
证据摘要分两层形成:_recover_once() 返回结构化观测,以及该轮 journal/sentinel 文件的摘要;外层 run_durable_effects_recovery() 汇总九轮结果,再分别计算观测集合 与独立摘要集合的摘要。它们随后进入下面的检查结果与 Bundle 字段。durable
| 层面 | 代表字段 | 能推出什么 | 不能推出什么 |
|---|---|---|---|
| 权威运行观测 | recovery_window_repetitions、waiting_semantics_observed、recovery_windows_authoritative_digest | 此次受控恢复中的次数、WAITING 检查和运行观测归属 | 真实短信服务的发送记录 |
| 独立测试证据 | recovery_windows_journal_digest、waiting_resolution_journal_digest | 本地模拟外部系统记录的摘要归属 | 任意第三方账本的完整性或 exactly-once |
| 单项结论 | check_id、status、evidence_level、reason_code、evidence_digest | 哪项声明在何种证据层级得到何种结果 | 未声明能力或全包通过 |
| 包执行 | execution_id、manifest_digest、status、exit_code | 同一个候选清单上的汇总结论 | 别的候选、平台或真实部署 |
| 场景 Bundle | scenario、checks、execution_checks、evidence_view、independent_evidence、content_digest | 本场景结果与完整 Pack 汇总之间的绑定 | 原始数据库备份或可无限重放的现场 |
ScenarioEvidenceBundle 还嵌入 Manifest 与其 digest。checks 必须精确匹配该 Scenario 的声明,execution_checks 必须匹配整个清单,两个集合中的同项结果必须 一致。对于 PASS,声明的权威证据键所对应的值必须等于该结果的 evidence_digest; 独立证据键必须存在,其值须符合 sha256: 加 64 位小写十六进制字符的格式。 这里校验的是引用格式,不是重新读取外部原始记录并计算其哈希。缺少引用表示证据绑定 不完整,不能据此推断“外部效果没有发生”。bundle
脱敏不是事后删几个词:结果拒绝非空自由文本 detail;证据映射只接收稳定键以及 布尔、数字、空值或 SHA-256 引用,不接收任意 prompt、异常正文或凭据字符串。 这缩小了报告的泄露面,也意味着 Bundle 不是原始观测档案。当前 Durable 场景使用 临时目录;离开该目录的上下文后,完整 journal 不会作为 Bundle 附件保留。bundledurable
作者推断: 哈希能校验“给定内容是否与这个摘要一致”,不能独立认证内容最初 是否真实,更不能仅凭一个摘要重建已经删除的 journal。这里的“双源”指运行状态与 独立测试外部系统来源分开,不等于第三方审计签名。Bundle verifier 验证结构、 身份、引用和内容摘要,不重新访问业务系统测量效果。bundle
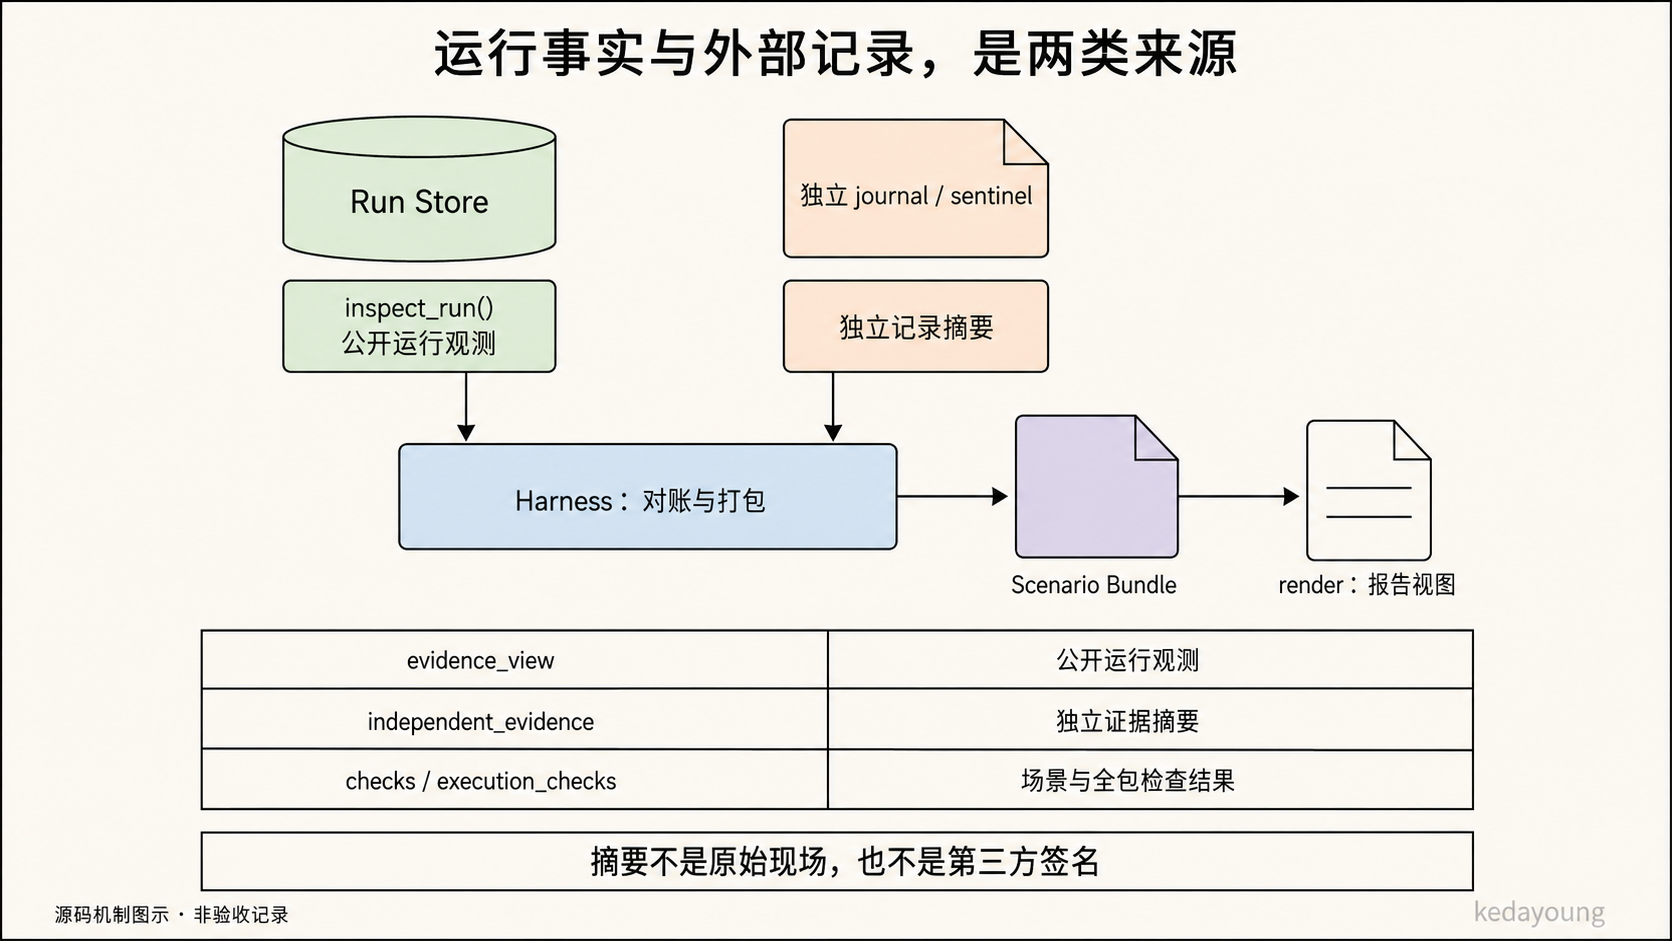
图 6:Run Store 与外部 journal 分别提供事实;Bundle 保存绑定与摘要,不保存完整现场。
6. 负向路径:故意多出一条通知
如果验证器只在正确样本上通过,我们仍不知道它能不能看出错误。 Durable Scenario 的受控 mutation(变异自检)在内存中构造两条相同的 effect, 再交给公开 reconcile_recovery_window();它不改写外部系统或现存 journal。 下面是同类的未执行纯内存负例,适用于已安装匹配版本的 Python 环境, 不创建 Run、不读凭据、不调用模型:reconciledurable
from m_agent.testing import reconcile_recovery_window

problems = reconcile_recovery_window(
    {
        "status": "SUCCEEDED",
        "attempt_statuses": ["SUCCEEDED"],
        "model_attempts": 1,
        "tool_attempts": 1,
    },
    effects=["notice-1", "notice-1"],
    model_dispatches=["model-1"],
)
assert "duplicate_or_missing_external_effect" in problems
预期是即使终态为 SUCCEEDED,重复 effect 仍令对账失败。另一个负例让独立 dispatch 数大于持久化 model Attempt 数,预期得到 model_execution_budget_reset。 这条实现路径会比较两类记录,而不是靠末尾的 PASS 文本作决定。相关正负测试在 test_m_agent_runtime_baseline.py,本文依据源码和断言解释预期行为,未重跑测试。reconcile-tests
公开客服示例的负向测试则真的修改了本地 journal:先运行工单崩溃与重放、通知崩溃 与确认,以及 Eval;再向通知 journal 追加第二条记录,单独重跑只读 Eval。 test_eval_fails_on_duplicate_notification 要求 notification_once 检查项的 passed 为 false,报告顶层的 passed 也为 false,且退出码非零。 它检验的是外部记录能否否定“仅凭成功终态就判定验收通过”的结论, 并不改写原 Run 的终态。example-tests
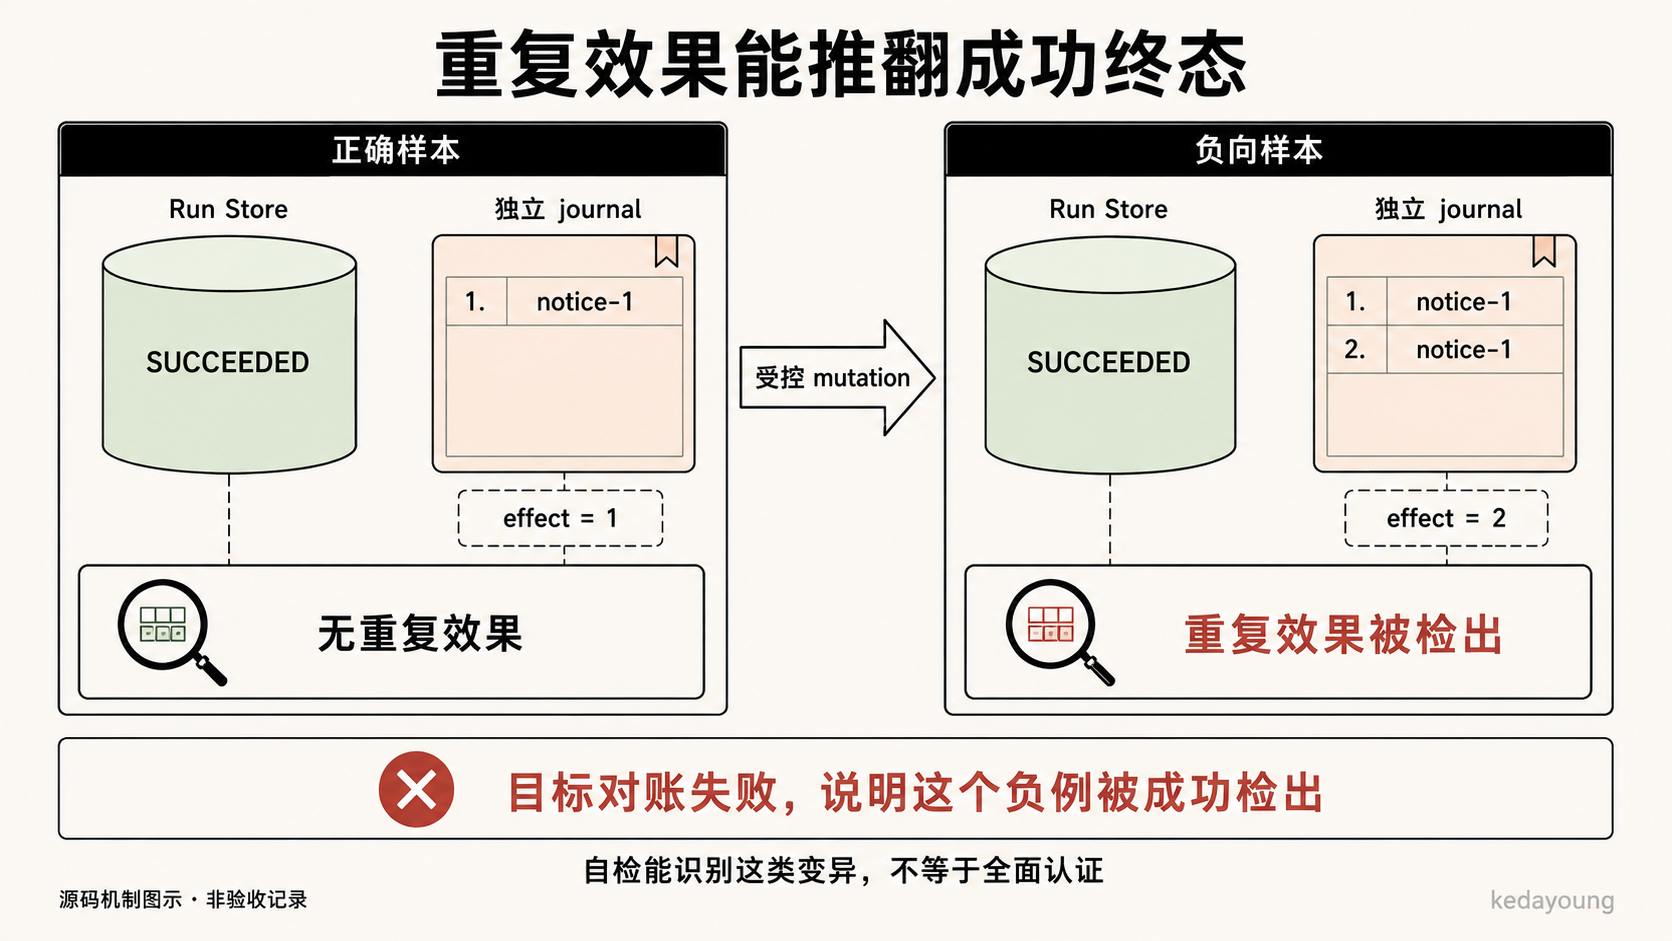
图 7:负例的对账失败说明自检检出了重复效果,不等于整个 Pack 已经通过。
动画 3(8 秒,静音):受控负例中,成功终态不变,第二条相同记录仍被检出。 打开视频
这条路径还有两个实现边界。首先,budget_fail_closed_observed 直接复用 整体 clean,对应预算摘要复用 recovery 摘要;budget_fail_closed_repetitions 则固定填为 3。 从这条 Scenario 路径能看到恢复与 dispatch/Attempt 数对账,不能只凭字段名宣称 又完成了三个独立“达到上限后零 dispatch”的实验。durable
其次,ADR 要求未检出的 mutation 是 Harness ERROR,CLI 的 Bundle mutation 未检出确实会抛异常;但 Durable 自身通过统一 result() 构造器把 mutation_detected=False 映射为 FAIL。这是设计要求与该处实现分类的差异, 应当保留这一区别,不能把该处实现写成已经符合设计分类。adrdurablecli-mutation
7. 五种检查结果,怎样汇成四种终态
单项结果是 PASS / FAIL / ERROR / NOT_RUN / INCONCLUSIVE; Pack 从 CREATED、RUNNING 走向终态。PackExecution.complete() 的判断不是 通过率,而是以下优先顺序:aggregate
| 条件,按先后判断 | Pack 终态 | 退出码 |
|---|---|---|
有未声明结果、证据层级错配,或 required ERROR | ERROR | 3 |
没有上述错误,但有 required FAIL | FAILED | 1 |
| 没有 ERROR/FAIL,但缺 required 结果,或 required 层级不是 CONTRACT/HOST | INCOMPLETE | 4 |
没有以上情况,但有 required NOT_RUN 或 INCONCLUSIVE | INCOMPLETE | 4 |
| 所有 required CONTRACT/HOST 都是 PASS | PASSED | 0 |
重复 check_id 等非法输入先抛 ValueError,不属于上表的合法结果聚合。 CLI 将非法调用映射到退出码 2,Bundle 完整性问题另用退出码 5; 因此“非零就是被测系统失败”同样不成立。aggregatecli
混合结果尤其重要:有 FAIL 又有 NOT_RUN 时,终态是 FAILED,不会用“没跑全” 掩盖已观察到的失败;有 ERROR 又有 FAIL 时,单个 Pack 的终态是 ERROR, 所有单项结果仍须保留。发行物测试还明确区分缺少 uv 的 Harness ERROR 与被测候选构建失败的 FAIL。aggregateidentity-tests
设计决策: Release/Milestone 上层可以将 required FAIL 或 ERROR 投影为发布 aggregate FAILED,意思是不能发布;但不能回写子 Pack 为 FAILED 或把其退出码 3 改成 1。这一层和 PackExecution.complete() 的职责不同。adr
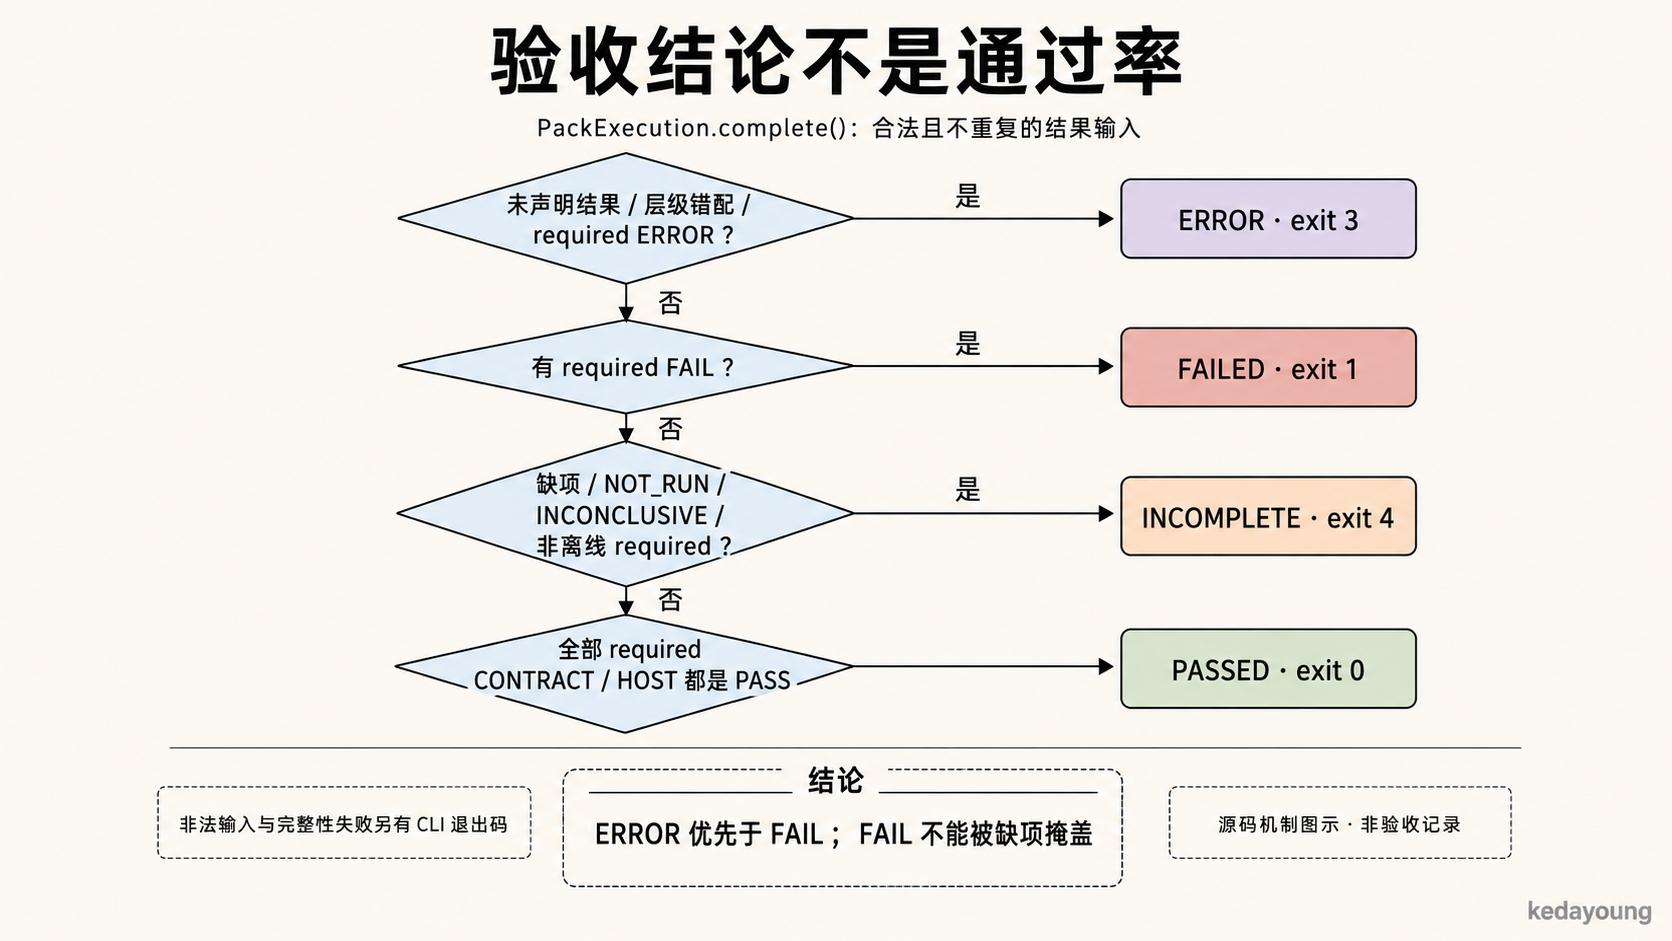
图 8:终态由必需检查及优先级决定,不由通过率投票产生。
动画 4(10 秒,静音):本段只讨论合法、同候选的 CONTRACT/HOST 必需结果。没有 ERROR/FAIL 时,一项 NOT_RUN 仍使 Pack 为 INCOMPLETE。 打开视频
8. verify 的 PASS 不是验收的 PASSED
Bundle 用排序、紧凑 JSON 计算内容摘要。verify() 重新校验 Manifest、execution、 场景结果集合、双源证据引用和最终 digest。CLI 还核对内容寻址文件名及当前安装身份; inspect、verify、render 共用这一入口。bundlecli
以下为未执行的后处理模板,沿用第 3 节同一 HOST 环境及候选身份。 BUNDLE 必须是该次 run 实际输出的一个完整 JSON 路径,而非手工命名的报告:
"$PY" -I -m m_agent.testing inspect \
  --manifest "$MANIFEST" --wheel "$WHEEL" --sdist "$SDIST" --bundle "$BUNDLE"
"$PY" -I -m m_agent.testing verify \
  --manifest "$MANIFEST" --wheel "$WHEEL" --sdist "$SDIST" --bundle "$BUNDLE"
"$PY" -I -m m_agent.testing render \
  --manifest "$MANIFEST" --wheel "$WHEEL" --sdist "$SDIST" --bundle "$BUNDLE"
inspect 预期输出公开 JSON,verify 校验完整性,render 输出含 execution 状态和退出码的文本。verify 实现打印的 Bundle integrity: PASS 只属于 完整性检查:一个合法、内容一致的 FAILED Bundle 不会因此变成 PASSED。 相反,发布演示 render_release_demo() 额外要求 PASSED,并拒绝失败或篡改 Bundle。cli-renderdemo-tests
命令顺序还防止一个循环证明:Bundle 不会预先证明自己后来已经成功被 inspect、 verify 或 render。Manifest 的 required_cli_commands 声明这些入口, 它们由 wheel 契约测试在 run 之后验证,不伪造为 Bundle 内先发生的检查。coverage
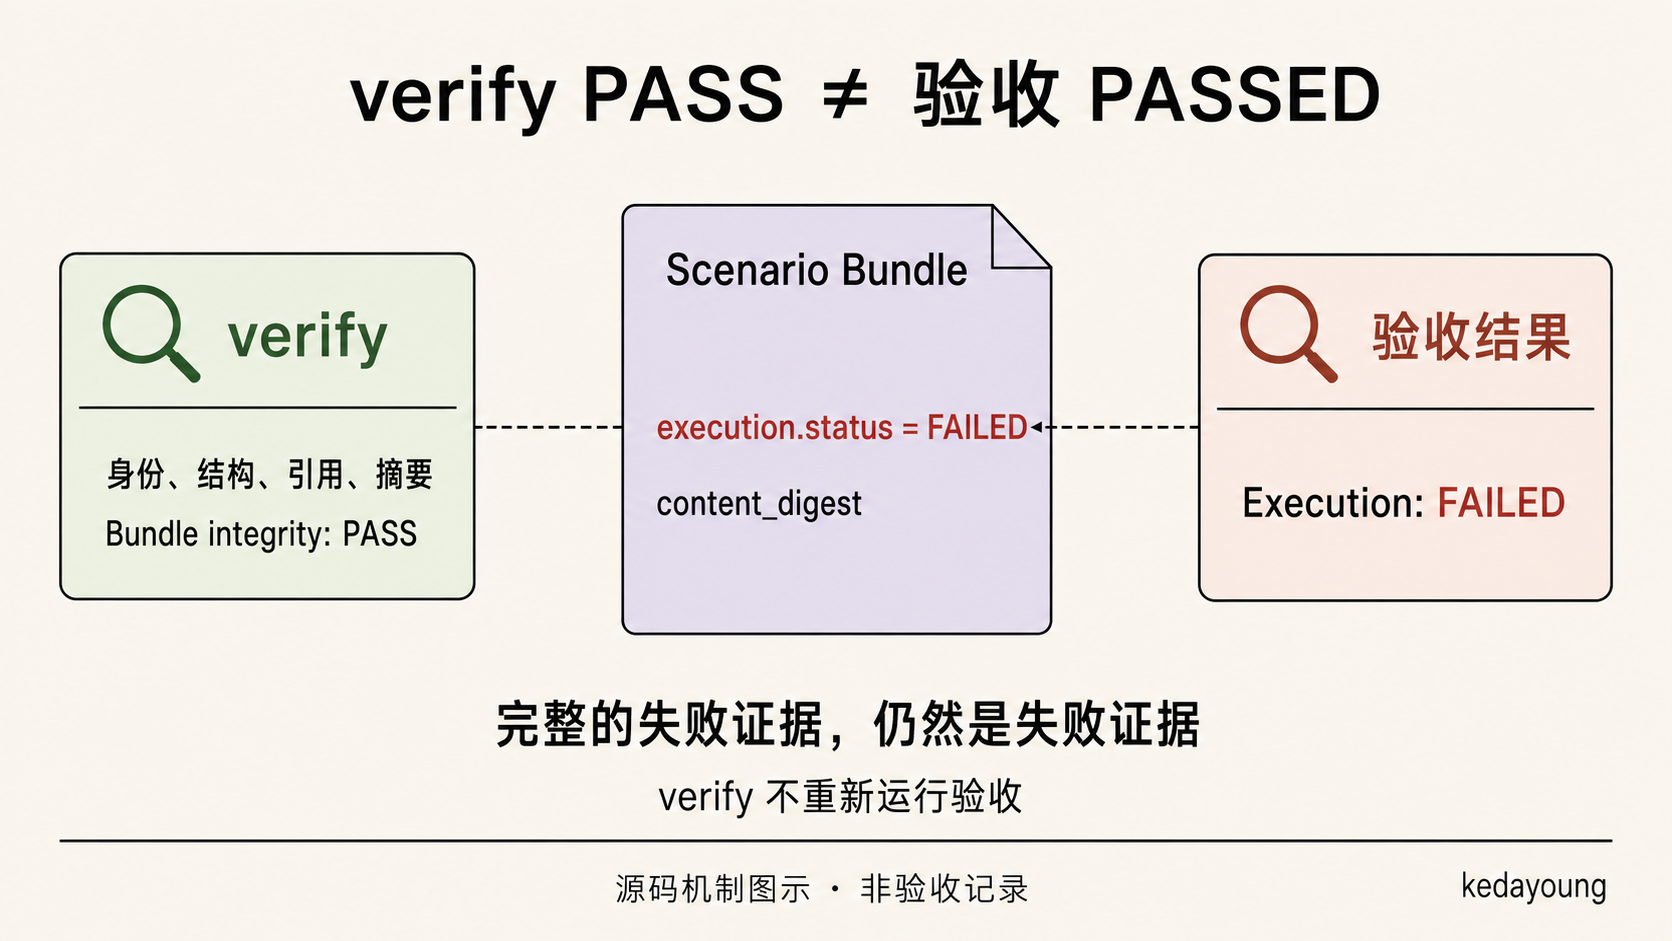
图 9:verify 的 PASS 不会改写 execution 的 FAILED。
动画 5(8 秒,静音):图中把完整性校验结果放在文件外,强调它不会改写文件保存的 FAILED 执行状态。 打开视频
9. 中断后恢复的是哪一种进度
业务 Run 恢复靠 Run Store;Pack 中断恢复靠输出目录的 .core-lifecycle-running.json。后者保存 Manifest、digest、execution 和可选 Bundle, 有自己的内容摘要。加载时要核对 schema、Manifest 完全相同、execution 绑定以及 已有 Bundle 的完整性;候选变了或状态损坏就拒绝,不能靠删掉字段继续拼结果。resume
内容寻址输出由临时文件、flush、fsync、os.replace 发布。已有相同字节则复用; 当有效状态里保存了完整 Bundle 时,可以修复截断的派生文件。这叫重新发布已有 证据,不是从截断 JSON 猜回原结果。test_resume_after_interruption_reuses_execution_and_repairs_truncated_bundle 覆盖的是这条 core-lifecycle 恢复路径。resume-tests
设计与实现必须分开: ADR 规定只续跑未完成 Scenario、半成品 Scenario 重跑。 但当前六场景 _run_foundation_release_0_5() 在恢复到 RUNNING execution 后, 仍顺序调用全部六个 Scenario;状态文件没有逐场景完成清单,最终逐个发布的 Bundle 也没有在这里被读回作为跳过依据。因此不能把 core-lifecycle 的修复测试扩写成 “foundation-release 已支持逐场景断点续跑”。adrrelease-runnerresume
同候选重跑也不同于新候选验收。恢复同一个 execution 必须身份完全一致; 一次执行完成后重新发起验收,则应使用新的 execution。修复产生新的源码、 发行物或 Manifest 身份后,旧 Bundle 只能为新候选提供诊断线索, 不能用其中一部分 PASS 补足新 RC(发布候选)的验收。adraggregation-tests
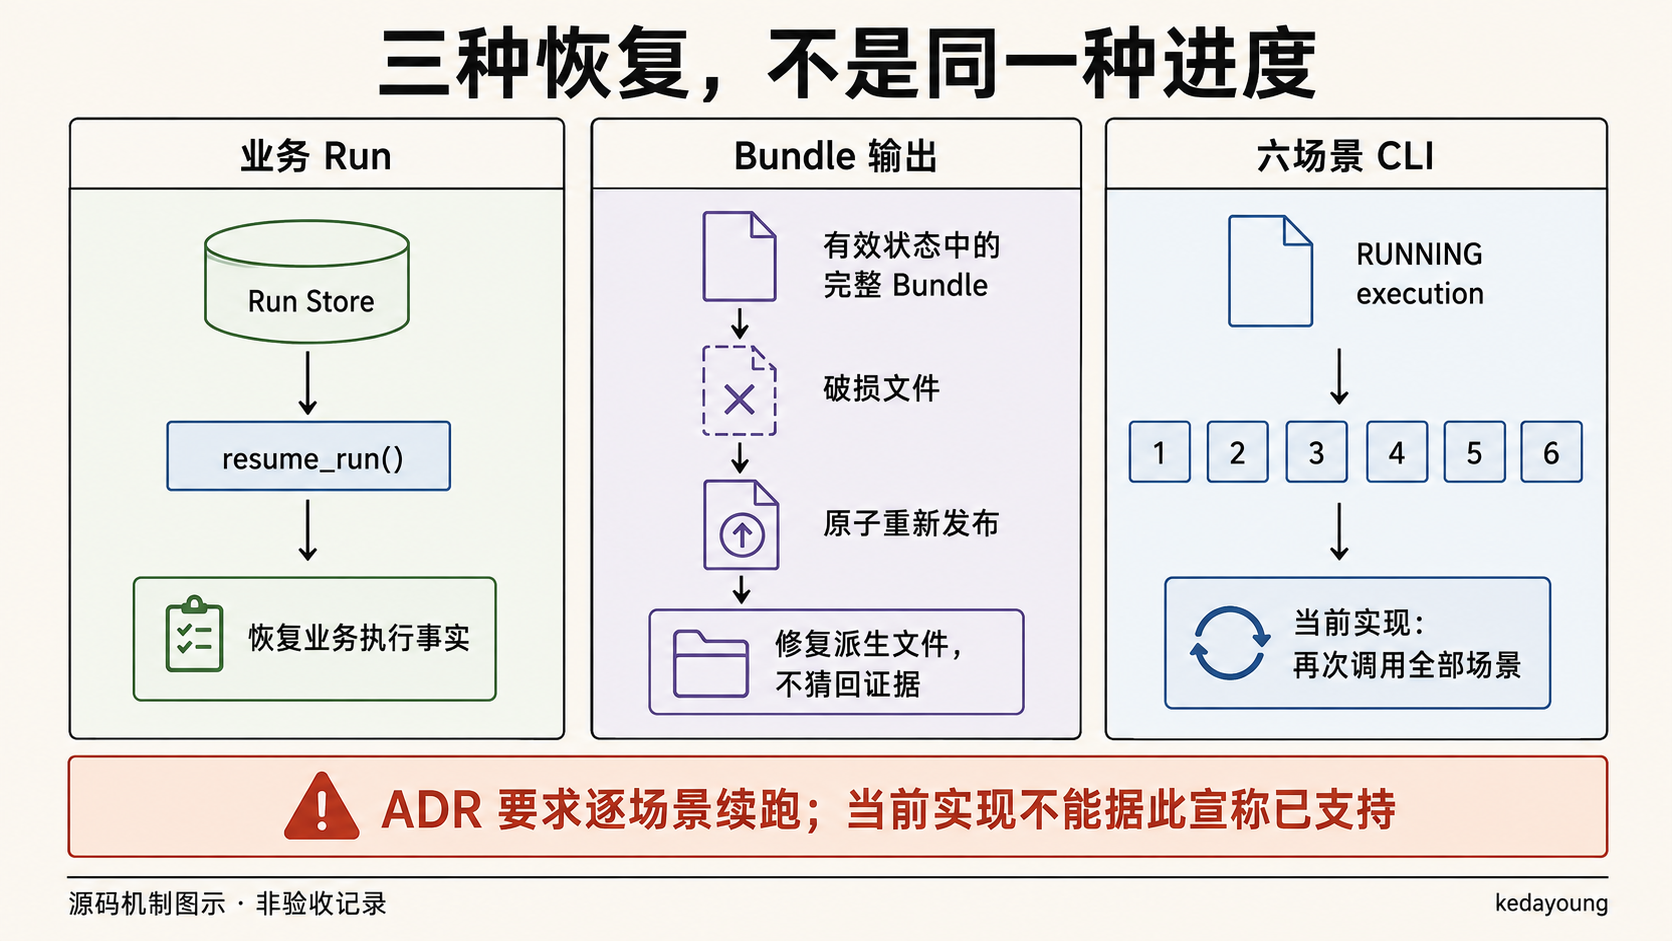
图 10:三种进度边界不能互换;当前六场景实现不是逐场景断点续跑。
10. 四层证据和历史结果不能互借身份
| 层级 | 回答的问题 | 不成立的推论 |
|---|---|---|
| CONTRACT | 确定性测试夹具下公开契约能否组合、是否拒绝负例 | 模拟模型通过,所以真实端点兼容 |
| HOST | 干净外部环境安装精确 wheel 后,真实进程、SQLite 与重启能否工作 | 一台主机通过,所以所有部署均可用 |
| PROVIDER | 显式授权的具体端点、契约与能力组合在记录时间是否兑现 | 一个端点通过,所以所有供应商长期可靠 |
| FIELD | 应用团队在真实权限、数据和外部系统下的部署验收 | 通用库的离线报告已经是生产认证 |
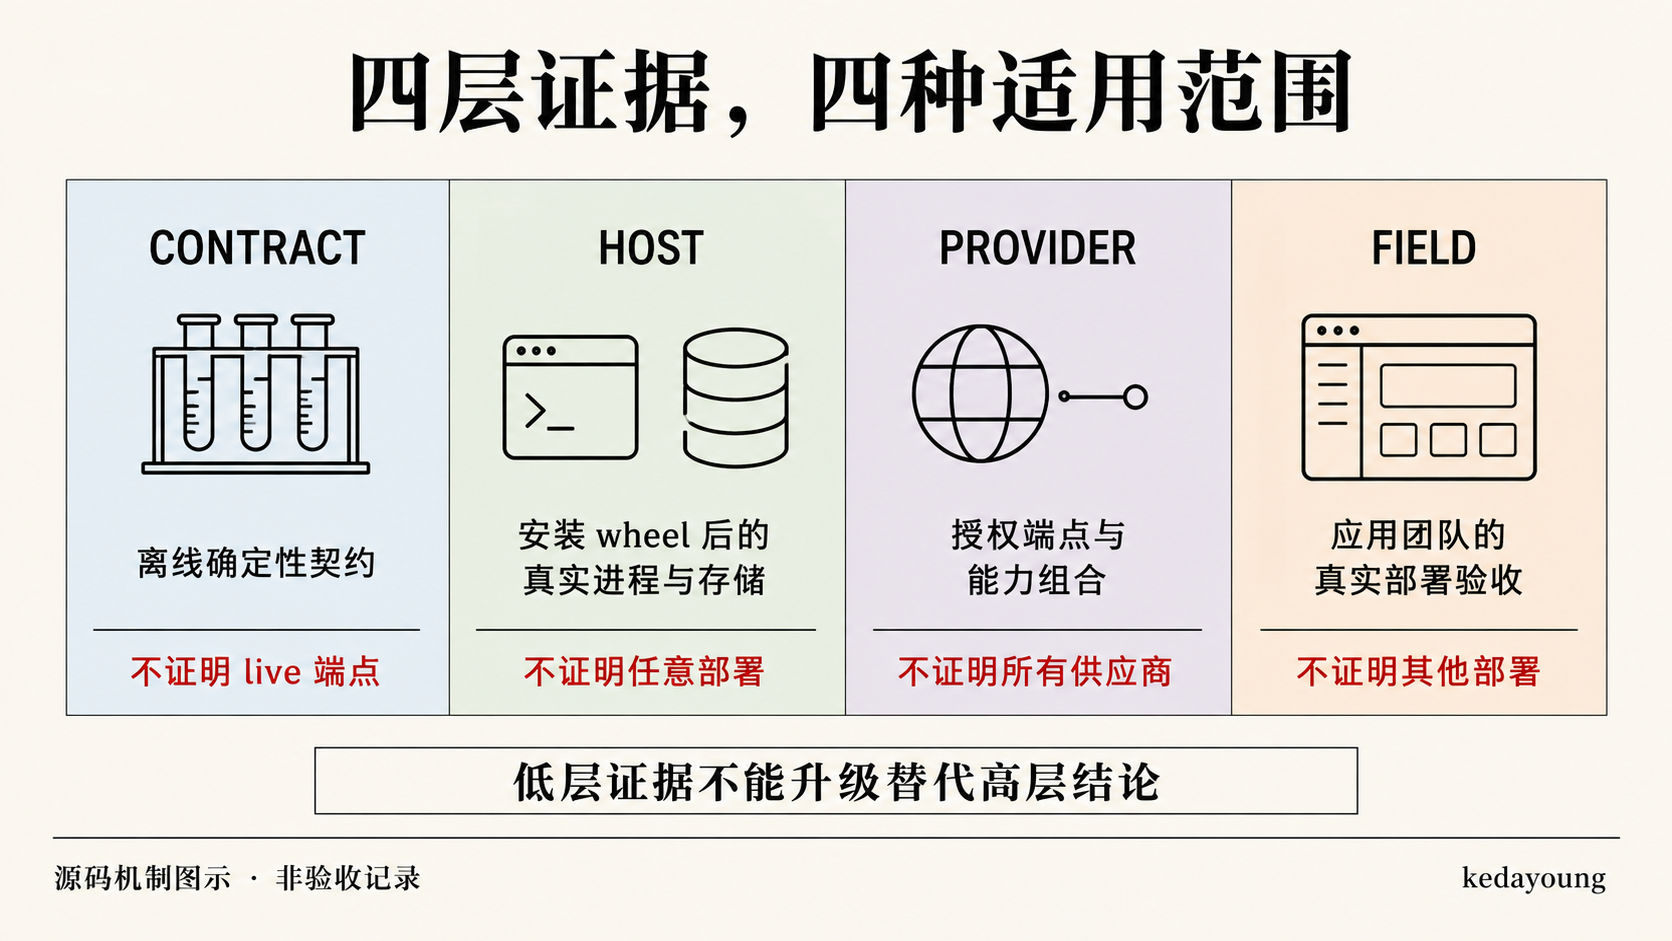
图 11:四层证据回答不同问题,不会自动升级成生产认证。
这四层划分的是适用范围,不是能逐级自动升级的置信分数。0.5 的平台矩阵另外冻结 Linux 3.11–3.14 CONTRACT、Linux 3.11 primary HOST、macOS 3.11/3.14 secondary HOST; 一个 Linux Pack 的 PASSED 不能证明整个平台矩阵都已验收,Windows 不在该矩阵中。adrcoverage
PROVIDER 使用独立 verify-provider 入口和显式 --allow-live 授权;归档按 execution/Manifest/artifact 绑定并追加 revision,不把后来的 live 证据写回原 Bundle。 ADR 还规定 fingerprint、配置漂移与最多 30 天的证据有效范围。未授权、缺凭据、 配额不足、供应商失败、契约失败与 Harness 错误必须保留原因,不能换成 CONTRACT PASS。本文不提供 live 执行命令,也没有读取相关环境变量。adrprovider
历史记录: rel05-evidence 自述的原候选是 ed7177d047a528070c23bc06c84fb10c7817d2fb,不是本文分析的 v0.5.1。 归档中的六份 Bundle、平台记录、演示与 benchmark 保留当时环境、身份和日期。 其中 as-run scripts 含发布主机绝对路径,原文已说明不是可直接移植的 runner; 本文没有重新认证归档 PASS。archive
性能 workload 也不是功能 Scenario 的加分项。ADR 要求先检查完整性,再报告该环境 下的 throughput、分位数和开销;Durable Run、Session、Context、Eval 应保留各自 样本、基线和计时范围,不能合成“生产 QPS”。adr
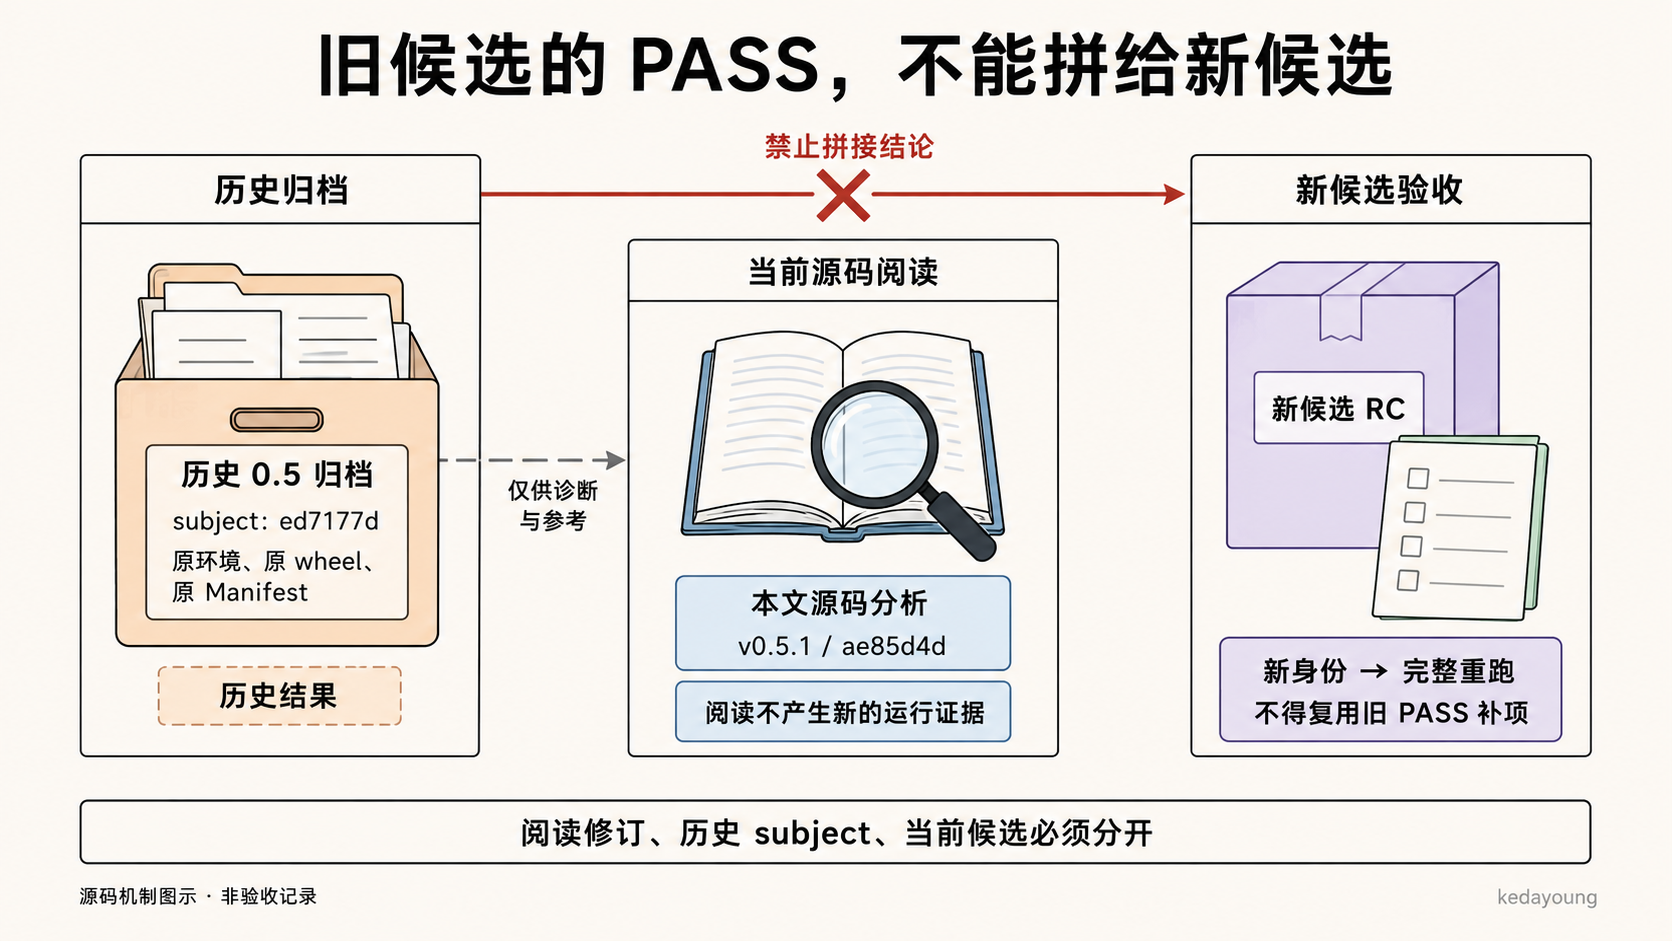
图 12:历史 PASS 保留原候选身份;新候选需要自己的验收记录。
11. 怎样继续复查,而不偷换结论
复查源码时可以先定位下面几组正负测试;以下名称是测试源码入口,不是本次结果:
| 要复查的主张 | 固定修订中的测试入口 |
|---|---|
| 重复通知否定仅凭成功终态得出的验收结论 | tests/test_durable_support_agent_example.py 的追加 journal 后 Eval 失败路径 |
| 九次恢复、WAITING 与重复效果 mutation | tests/test_m_agent_runtime_baseline.py |
| 全 PASS、单项 FAIL、ERROR、NOT_RUN、缺项与额外 PASS | tests/test_m_agent_release_0_5.py 的 Pack 聚合测试 |
| 外候选、错误场景、篡改内容不能成为当前证据 | 同文件的 Bundle 校验测试 |
| 外部 wheel、CLI 后处理与中断状态恢复 | tests/test_distribution_identity.py |
在匹配修订且已装开发依赖的上游源码环境,可使用以下未执行命令复查聚合和 Durable 场景测试;预期检查离线契约断言,不单独产生整个发行物的 HOST 或发布结论:
pytest -q tests/test_m_agent_runtime_baseline.py tests/test_m_agent_release_0_5.py完整客服示例另可在匹配源码与依赖环境执行 python examples/durable_support_agent/run_acceptance.py,预期串联工单重放、 通知 WAITING/确认与只读 Eval。它是离线示例,不替代第 3 节的 wheel 验收路径。 该命令本次同样未执行。example
回到开场,通知是否重复,不由最终回复、测试数量或报告标题裁定,而由有身份的 故障实验、公开运行事实与独立效果记录共同支撑。Testing 的价值还包括承认 “未跑全”“Harness 出错”和“这项证据证明不到那里”。把这些边界留在报告里, 才让下一位集成者知道该继续测什么。
来源索引
以下实现与测试链接全部固定到同一提交。ADR 是设计依据,源码是实现依据,测试文件 提供预期行为的断言,不代表本文已执行这些测试;历史归档则单独标记其原候选。 引用路径、内容及行号依据本地固定提交的 Git 对象核对,在线链接可访问性未获确认。
参考资料
故障窗口与非幂等工具;子进程恢复与公开 inspection;字段派生及 mutation 结果分类。 ↩ ↩ ↩ ↩ ↩ ↩ ↩ ↩ ↩ ↩ ↩ ↩ ↩ ↩
ScenarioEvidenceBundle schema、双源绑定与 verify;Result 脱敏约束。 ↩ ↩ ↩ ↩ ↩
0.5 历史归档及原候选身份,阅读修订为 v0.5.1,归档 subject 仍为原
ed7177d...。 ↩